【参考:2111.09881 Restormer: Efficient Transformer for High-Resolution Image Restoration】
注意点:
所有橙色 Transformer Block 都包含有 MDTA 和 GDFN。
注意力多头:每个头学习一个特征,多个头学习多个特征!
学习点
MDTA:根据全图信息,动态组合不同特征通道。
- 怎么做 :通过 1 × 1 卷积和 3 × 3 深度卷积生成 Q、K、V,再利用全部空间位置的响应,计算通道注意力
A = softmax(t · Q̄ · K̄ᵀ),最后用O = A · V加权组合特征。 - 主要作用:建立通道之间的依赖关系,让特征组合方式随输入内容变化;同时结合局部邻域信息和全图统计信息。
- 复用场景:希望网络利用全图信息,又不想建立巨大的像素 × 像素注意力矩阵时。
- 注意点 :每头注意力矩阵是
d × d,不是HW × HW;输入通道数必须能被头数整除。
GDFN:通过局部处理和乘法门控,进一步变换特征。
- 怎么做 :先扩张通道并执行深度卷积,再拆成两条分支,计算
G = GELU(Z₁) ⊙ Z₂,最后将通道投影回原大小。 - 主要作用:引入局部空间信息和非线性,让一条分支调制另一条分支,对特征进行抑制、放大或其他调整。
- 复用场景:需要增强普通前馈网络或卷积模块的特征变换能力时,可以用它替换简单的"两层投影 + 激活"结构。
- 注意点 :门控没有 sigmoid,数值不限于
[0,1],因此不是概率开关。
| 模块 | 方便记忆的作用 | 核心操作 |
|---|---|---|
| MDTA | 决定不同通道如何协同 | 全图响应计算通道关系,再加权混合 |
| GDFN | 对混合后的特征进一步加工 | 局部卷积、非线性、逐元素门控 |
复用接口:两者都能保持 [B,C,H,W] → [B,C,H,W]。 在你的可读版代码中,它们本身不包含 LayerNorm 和残差相加;组合成完整 Block 时使用 X₁ = X + MDTA(LN₁(X)),再使用 X₂ = X₁ + GDFN(LN₂(X₁))。
Restormer 模型
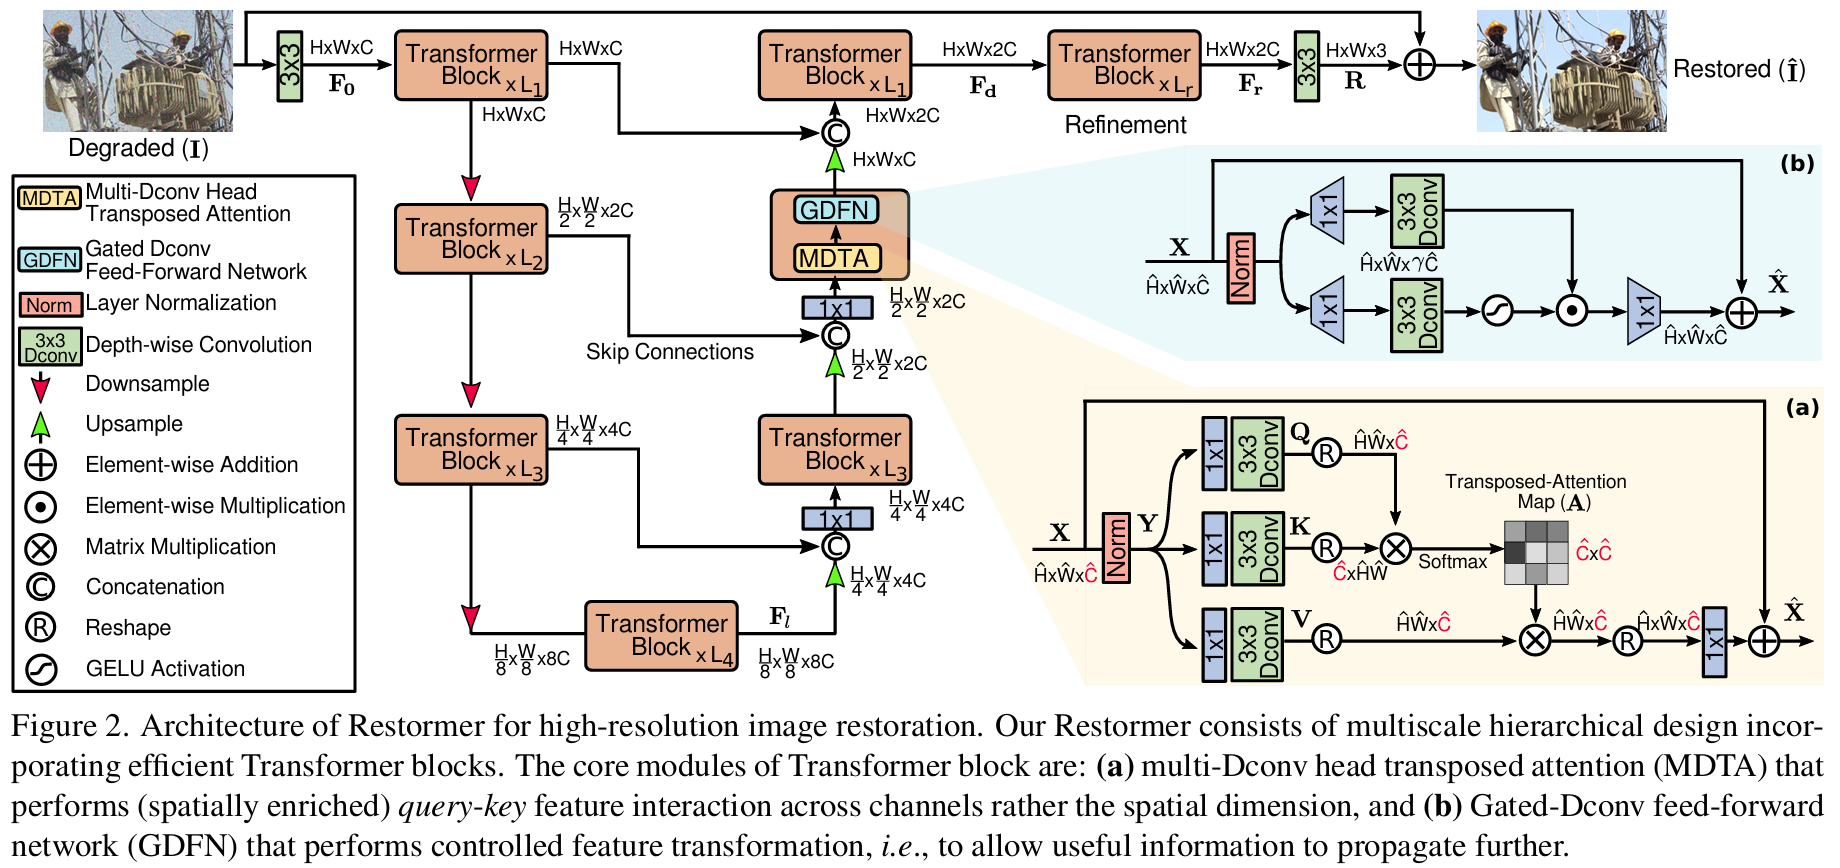
图中的 Restormer 是一种用于图像恢复的四级编码器---解码器网络。它将退化图像转换为特征,通过不同分辨率的 Transformer Block 提取信息,再逐级恢复分辨率,预测图像残差,得到清晰图像。
它的主要特点是:使用 MDTA 建立由全图信息决定的通道注意力,使用 GDFN 对特征进行门控变换,同时通过多尺度结构与跳跃连接保留图像细节。
下面按图中的数据流详细解释。公式使用行内代码和 Unicode 符号,避免 LaTeX 渲染问题。具体计算对应项目中的 .../basicsr/models/archs/restormer_arch.py
第 1 步:先找到输入和输出,确定读图方向
图左上角的照片,下面写着 Degraded(I),是输入图像。"Degraded"表示图像存在退化,例如模糊、噪声或者雨纹。I 是这张输入图像的符号。
图右上角的照片,旁边写着 Restored(Î),是网络输出的恢复图像。Î 表示网络对清晰图像的预测。
中间的大部分结构,就是将左边的退化图像转换为右边恢复图像的处理过程。
整张图的主要路线是:从左上角进入,沿左侧向下,到达底部,再沿中间偏右的位置向上,最后向右输出。
你可以先把它想成一条 U 形路线。左边向下的部分负责提取特征,右边向上的部分负责恢复图像。
第 2 步:明确哪里是编码器,哪里是解码器
你问的"哪里是解码器",先直接定位:
编码器在图的左侧。 从最上方第一个橙色 Transformer Block × L₁ 开始,沿红色向下箭头,经过 Transformer Block × L₂、Transformer Block × L₃,最后到图底部的 Transformer Block × L₄。
解码器在图的中间偏右,沿绿色向上箭头排列。 从底部的 L₄ 模块输出开始,经过绿色上采样箭头、圆圈 C、1 × 1 卷积和橙色 Block,逐级向上,直到最上方中间的 Transformer Block × L₁。
具体来说,解码器的三个处理层,从下往上是:
- 中间偏下的
Transformer Block × L₃。 - 中间位置被展开为 MDTA + GDFN 的橙色 Block。它代表二级解码器中的 Transformer Block,内部结构被画出来了。
- 最上方中间的
Transformer Block × L₁,它是一级解码器。
最上方更靠右、下面写着 Refinement 的 Block 是后续精炼阶段。
图底部的 Transformer Block × L₄ 是连接编码器和解码器的最低分辨率部分,通常叫作瓶颈层 。项目代码将它命名为 latent。
所以,读这张图时可以先划出四块:左侧编码器、底部瓶颈层、中间偏右解码器、右上方精炼与输出。
第 3 步:理解"编码"和"解码"在这里是什么意思
这里的"编码"不是把图片压缩成 JPEG 文件,也不是加密。
编码器做的是:将图片转换成网络内部的特征表示,并逐步在更低分辨率上处理这些特征。
解码器做的是:将低分辨率特征逐步恢复到原始分辨率,并融合编码器保留下来的信息,为生成恢复图像做准备。
还有一点很重要:解码器的中间输出通常仍然是"特征",不是可以直接显示的 RGB 图片。直到最后一个输出卷积,网络才把这些特征转换成 3 通道图像。
第 4 步:先搞懂 H、W、C,后面才能看懂每条箭头
图中反复出现 H × W × C:
- H:特征图的高度。
- W:特征图的宽度。
- C:特征图的通道数。
输入 RGB 图像有三个通道,即红、绿、蓝,所以图中的输入和输出都是 H × W × 3。
经过网络卷积后,通道数可以变成 48、96、192、384。这些通道已经不是红、绿、蓝了,而是网络学习得到的不同特征响应。
例如,一些通道可能对边缘变化比较敏感,一些可能对某种纹理或颜色组合比较敏感。不过每个通道的意义由训练决定,并没有人为规定"第一个通道必须检测边缘"。
你可以把一个通道想成一张二维数值图。48 个通道,就是 48 张高度为 H、宽度为 W 的数值图叠在一起。
图中采用 H × W × C 的写法;代码采用 [B,C,H,W]。其中 B 是一次同时输入多少张图像。如果只输入一张,B = 1。
比如一张 256 × 256 的 RGB 图片,在代码中就是 [1,3,256,256]。后面我们一直用这张图作为例子。
第 5 步:看懂图左侧的图例
图中的符号分别表示:
| 图中符号 | 含义 | 对数据做什么 |
|---|---|---|
3 × 3 方框 |
普通卷积 | 从局部邻域计算新特征 |
1 × 1 方框 |
点卷积 | 在每个位置混合不同通道 |
3 × 3 Dconv |
深度卷积 | 分别处理每个通道的局部邻域 |
| 红色向下箭头 | 下采样 | 降低空间分辨率 |
| 绿色向上箭头 | 上采样 | 提高空间分辨率 |
| 圆圈 C | Concatenation,拼接 | 将两份特征沿通道接起来 |
| 圆圈 R | Reshape,重排 | 改变数据的维度组织方式 |
| 圆圈加号 | 逐元素相加 | 对应位置的数值相加 |
| 实心点乘号 | 逐元素相乘 | 对应位置的数值相乘 |
| 圆圈叉号 | 矩阵乘法 | 按矩阵规则进行加权组合 |
| Norm | Layer Normalization | 归一化特征 |
| 弯曲符号 | GELU 激活 | 对数值进行非线性变换 |
先记住两个容易混淆的操作:
拼接会增加通道数。 两份 [1,48,256,256] 特征沿通道拼接,得到 [1,96,256,256]。
相加不会增加通道数。 两份 [1,48,256,256] 特征逐元素相加,结果仍是 [1,48,256,256]。
第 6 步:输入先经过第一个 3 × 3 卷积
从左上角的输入照片出发,向右遇到一个绿色的 3 × 3 方框。这个卷积负责生成浅层特征 F₀。
什么是卷积?可以先理解为:在图像上取一个局部窗口,使用一组可学习的权重进行加权求和,计算出一个新的数值,再移动窗口继续计算。
3 × 3 表示窗口的空间大小。对于 RGB 输入,实际计算还会使用输入的三个通道。
这个模块默认生成 48 个输出通道。因此,输入 [1,3,256,256] 经过它后,变成 [1,48,256,256]。
计算可以写成 F₀ = Conv₃×₃(I)。
这里高度和宽度没有变化。代码中卷积的步长为 1,并在边缘进行 padding,所以输出空间尺寸仍为 256 × 256。
代码将这个模块叫作 OverlapPatchEmbed。它先把原始像素转换成后续网络可以处理的特征。
第 7 步:进入第一级编码器
F₀ 向右进入图左上方第一个橙色方框:Transformer Block × L₁。
这里的"× L₁"表示连续执行 L₁ 个 Transformer Block。默认 L₁ = 4,所以这个方框实际上包含四个连续的 Block。
这里的 L₁ 表示 Block 数量,不是 L1 损失。
每个 Block 都会改变特征中的数值,但保持高度、宽度、通道数不变。所以一级编码器输入是 [1,48,256,256],输出仍是 [1,48,256,256]。
把它的输出叫作 E₁,计算为 E₁ = Encoder₁(F₀)。
E₁ 的输出分成两条路线:
一条沿红色箭头向下,继续进入更深的编码器。
另一条沿横向黑线向右,保留给最上层解码器使用 这条横向路线就是跳跃连接,后面会详细讲。
第 8 步:第一次下采样,进入二级编码器
从一级编码器向下,遇到第一个红色箭头。这个箭头表示下采样。
默认情况下,这一步把 [1,48,256,256] 变成 [1,96,128,128]。
可以分开看:
- 高度:256 → 128。
- 宽度:256 → 128。
- 通道:48 → 96。
因此,图中写的是 H/2 × W/2 × 2C。
代码里的下采样不是直接缩放图片,而是两步操作。
第一步,用普通 3 × 3 卷积将通道从 48 减少到 24,得到 [1,24,256,256]。
第二步,使用 PixelUnshuffle(2),把每个 2 × 2 空间块中的四个位置搬到通道维。空间尺寸减半,通道乘以 4 ,因此得到 [1,96,128,128]。
整个过程是 [1,48,256,256] → [1,24,256,256] → [1,96,128,128]。
PixelUnshuffle 只是重排元素,没有可训练参数;前面的卷积负责学习特征变换。
随后,特征进入 Transformer Block × L₂。默认 L₂ = 6,连续处理六个 Block,输出仍为 [1,96,128,128]。把这份输出叫作 E₂。
E₂ 同样分成两路:一路继续向下,一路横向保留给二级解码器。
第 9 步:第二次下采样,进入三级编码器
从二级编码器继续沿红色箭头向下。
这次输入为 [1,96,128,128],经过下采样得到 [1,192,64,64]。
变化规律和上一步一致:空间尺寸减半,通道数翻倍。
图中对应 H/4 × W/4 × 4C。因为已经连续下采样两次,所以高度和宽度都变成最初的四分之一。
随后进入 Transformer Block × L₃。默认 L₃ = 6,经过六个 Block 后,shape 仍为 [1,192,64,64]。把输出叫作 E₃。
E₃ 也保留一条横向跳跃连接,供三级解码器使用。
第 10 步:第三次下采样,到达底部瓶颈层
继续沿红色箭头向下,输入 [1,192,64,64] 变成 [1,384,32,32]。
图中对应 H/8 × W/8 × 8C。
接下来进入图底部的 Transformer Block × L₄。默认 L₄ = 8,所以这里连续执行八个 Block。
输出叫作 Fₗ,代码将这组 Block 命名为 latent。它的 shape 为 [1,384,32,32]。
到这里,编码路径已经完成。
原始图像有 256 × 256 个空间位置,现在只有 32 × 32 个空间位置,但每个位置拥有更多通道。网络在这样的特征表示上继续进行信息处理。
需要注意:低分辨率特征并不是一张简单缩小的照片,它是经过多层卷积、注意力和前馈变换得到的数值表示。
第 11 步:从瓶颈层向上,正式进入解码器
现在从图底部的 Fₗ 出发,沿线向右,再沿第一个绿色箭头向上。
这就是解码器的起点。
绿色箭头表示上采样。第一次上采样将 [1,384,32,32] 变成 [1,192,64,64]。
空间尺寸翻倍,通道数减半。
代码里的上采样也有两步。
第一步,用普通 3 × 3 卷积将通道从 384 扩展到 768,得到 [1,768,32,32]。
第二步,使用 PixelShuffle(2),将每四个通道重新组织成一个 2 × 2 空间区域,得到 [1,192,64,64]。
完整过程是 [1,384,32,32] → [1,768,32,32] → [1,192,64,64]。
PixelShuffle 本身是重排操作,不是凭空生成新信息。上采样前的卷积会学习如何生成适合重排的通道特征。
第 12 步:在圆圈 C 处,与三级编码器特征拼接
第一次上采样后,向上会遇到一个圆圈 C。
这里有两条输入:
一条从下面来,是刚上采样得到的 [1,192,64,64]。
另一条从左边来,是三级编码器之前保留的 E₃,shape 同样为 [1,192,64,64]。
圆圈 C 将它们沿通道拼接,得到 [1,384,64,64]。
可以写成 Z₃ = Concat(Up(Fₗ), E₃)。
为什么要把编码器的特征拿过来?
因为编码器在这个分辨率上已经提取过信息。解码器恢复到相同分辨率时,可以直接使用这些保留下来的特征,不必完全依赖底部特征重新构造所有细节。
这条横向路线叫作 skip connection,跳跃连接。它跨过了更深的处理路径,将某一级的信息直接送到对应的解码级。
第 13 步:通过 1 × 1 卷积,再进入三级解码器
拼接后向上,会遇到一个蓝色的 1 × 1 方框。
这是一个 1 × 1 卷积,负责将通道从 384 压缩回 192,shape 从 [1,384,64,64] 变成 [1,192,64,64]。
1 × 1 卷积虽然不直接查看周围像素,但会在每个位置混合全部输入通道。可以把它理解为:在一个位置上,将 384 个特征数值重新组合成 192 个数值。
随后进入橙色 Transformer Block × L₃。这就是三级解码器,默认包含六个 Block。
经过处理后,输出 D₃ 为 [1,192,64,64]。
把刚才三个操作连起来,就是:上采样 → 与编码特征拼接 → 1 × 1 压缩通道 → Transformer Block。
第 14 步:继续上采样,进入二级解码器
D₃ 向上经过第二个绿色箭头。
shape 从 [1,192,64,64] 变成 [1,96,128,128]。
随后在第二个圆圈 C 处,与二级编码器保留的 E₂ 拼接。E₂ 的 shape 为 [1,96,128,128],因此拼接结果为 [1,192,128,128]。
再通过上面的 1 × 1 卷积,将通道从 192 压缩到 96,得到 [1,96,128,128]。
随后进入图中间那个内部写着 MDTA 和 GDFN 的橙色方框。
这个方框属于二级解码路径。画图时,作者把一个 Transformer Block 展开,让你看到里面的两个核心模块。
并不是只有这里才有 MDTA 和 GDFN。前面所有橙色 Transformer Block 都包含它们。
项目实际的二级解码器默认仍然堆叠六个 Block,输出 D₂ 为 [1,96,128,128]。
第 15 步:最后一次上采样,进入一级解码器
D₂ 继续沿第三个绿色箭头向上。
shape 从 [1,96,128,128] 变成 [1,48,256,256],恢复到原始图像的空间尺寸。
随后在最上方圆圈 C 处,与一级编码器保留的 E₁ 拼接。两份特征都是 [1,48,256,256],拼接后得到 [1,96,256,256]。
这里与前面两级不同:拼接后没有再通过 1 × 1 卷积将通道压回 48。
网络直接使用 96 个通道进入最上方中间的 Transformer Block × L₁。这就是一级解码器,默认包含四个 Block。
输出是图中标记的 Fᵈ,shape 为 [1,96,256,256]。
这时解码器已经完成了三次上采样。空间尺寸回到了原始的 256 × 256,但数据仍然是 96 通道的特征,不是最终图片。
第 16 步:进入右上方的 Refinement
Fᵈ F d F_d Fd 向右进入下方写着 Refinement 的橙色方框。
Refinement 可以理解为"精炼阶段":在已经恢复到原始分辨率的特征上,继续进行处理。
默认包含四个 Transformer Block。它不再上采样,也不再下采样,输入输出都是 [1,96,256,256]。
输出叫作 Fʳ,可以写成 Fʳ = Refinement(Fᵈ)。
这一阶段处理的是已经融合浅层编码信息和深层解码信息的特征。
第 17 步:将特征转换成三通道残差图像
Fʳ 继续向右,通过最后一个绿色的 3 × 3 方框。
这个普通卷积将 96 个特征通道转换为 3 个输出通道,shape 从 [1,96,256,256] 变成 [1,3,256,256]。
图中把这份三通道输出叫作 R,可以写成 R = Conv₃×₃(Fʳ)。
R 是网络预测的图像残差,也就是"输入图像需要怎样修改"。
它还不是右侧最终的恢复图像,因为后面还要进行一次相加。
第 18 步:与原始输入相加,得到恢复结果
注意图最上方有一条很长的黑线。它从输入 I 出发,跨过几乎整个网络,最终进入输出前的圆圈加号。
这个圆圈加号有两个输入:
一个是原始退化图像 I。
另一个是刚才预测的残差 R。
它们逐元素相加,得到 Î = I + R。
例如,某个像素的输入数值是 0.4,网络预测该位置的修正量是 0.1,那么输出就是 0.5;如果修正量是 −0.1,输出就是 0.3。
这表示网络学习在原图基础上进行调整。R 可以为正,也可以为负。
这里的输入残差相加,与编码器和解码器之间的通道拼接不同。 最后相加不会改变 shape,所以恢复结果仍为 [1,3,256,256]。
到这里,整张图的外部路线已经走完。
第 19 步:现在再打开橙色 Transformer Block
前面我们把 Transformer Block 当作一个"输入输出尺寸不变、但会处理特征"的盒子。
现在打开这个盒子。
每个 Block 按顺序包含两个主要处理阶段:
- LayerNorm → MDTA → 加回输入。
- LayerNorm → GDFN → 加回该阶段输入。
对于输入 X,第一个阶段计算 X₁ = X + MDTA(LN₁(X))。
第二个阶段接着计算 X₂ = X₁ + GDFN(LN₂(X₁))。
这里的 X、X₁、X₂ shape 都相同。
为什么要"加回输入"?因为模块输出可以作为对原特征的修正,而输入本身能够直接保留下来。这就是特征层面的残差连接。
它与最终的图像残差连接原理相似,但这里相加的是网络内部特征,而不是 RGB 图像。
第 20 步:先理解 LayerNorm
MDTA 和 GDFN 前面都有 Norm,它表示 Layer Normalization。
在这个项目中,LayerNorm 对每个像素位置的通道向量进行处理。
假设某一层有 48 个通道,那么在一个空间位置上,就有 48 个特征数值。LayerNorm 根据这 48 个数值计算均值和方差,再进行归一化。
它不是把整张图所有位置混在一起归一化。
代码先将 [B,Cᵢ,Hᵢ,Wᵢ] 重排成 [B,N,Cᵢ],其中 N = Hᵢ × Wᵢ,再沿最后的通道维处理。
普通 WithBias 版本的计算是 y = γ ⊙ (x−μ)/√(σ²+ε) + β。
这里:
- μ 是当前位置的通道均值。
- σ² 是当前位置的通道方差。
- ε 是一个很小的数,用来保持数值稳定。
- γ 是可学习的缩放参数。
- β 是可学习的平移参数。
项目还提供 BiasFree 版本,计算为 y = γ ⊙ x/√(σ²+ε)。它没有 β,并且分子不减均值,但仍然计算方差。
Block 中前后两次 LayerNorm 使用各自独立的参数。
第 21 步:找到右下角的 MDTA 展开图
右下角浅黄色区域,标记为 (a),就是 MDTA 的内部结构。
从左到右看,它的主线是:
输入 X → Norm → 生成 Q、K、V → reshape → 计算注意力 → 与 V 做矩阵乘法 → reshape → 1 × 1 卷积 → 加回 X。
MDTA 的全称是 Multi-DConv Head Transposed Attention。
可以先不记全称,先记它要做的事情:根据整幅特征图的响应,决定不同特征通道之间如何相互组合。
第 22 步:Q、K、V 是什么,从哪里来
Norm 的输出在图中叫作 Y。
Y 分成三条路线,每条路线都有一个 1 × 1 卷积和一个 3 × 3 深度卷积,分别生成 Q、K、V。
Q 是 Query,通常翻译为查询;K 是 Key,通常翻译为键;V 是 Value,通常翻译为值。
它们不是额外输入的图片,也不是人为指定的数据。它们都是同一份输入特征 Y,经过三组不同的可学习变换生成的。
可以写成 Q = DWConvQ(PWConvQ(Y)),K、V 的生成方式相同,但使用不同参数。
Q 和 K 用来计算通道之间的关系,V 提供后面被加权组合的特征数值。
为什么先用 1 × 1 卷积?
因为它在每个空间位置混合通道,把已有通道转换成适合 Q、K、V 的表示。
为什么再用 3 × 3 深度卷积?
因为它让每个通道的响应包含附近像素的信息。
"深度卷积"与普通卷积的区别是:深度卷积分别处理各个通道,不在这一步混合不同通道。 通道间的混合主要由前后的 1 × 1 卷积完成。
代码为了方便,将三条路线合并计算:先生成 3Cᵢ 个通道,再进行深度卷积,最后拆成三份。因此 Q、K、V 各自都有 Cᵢ 个通道。
第 23 步:理解"多头"
假设当前特征有 96 个通道,设置两个注意力头。
网络就把通道分成两组,每组 48 个通道,各自计算自己的注意力矩阵。
这里 a = 2,d = 96/2 = 48。
多头不是把图片切成左右两半,也不是每个头负责图像中的一个区域。这里是沿通道维分组,每个头仍然使用当前特征图的全部空间位置。
不同头可以在不同通道子空间中学习不同的组合关系。最后将各头输出重新合并,并用输出卷积继续混合信息。
因此要求 Cᵢ 能够被 a 整除。
第 24 步:理解 reshape 后的数据长什么样
Q、K、V 最初都是 [B,Cᵢ,Hᵢ,Wᵢ]。
代码将通道分成 a 个头,并把二维空间展开,变成 [B,a,d,N]。
例如,在二级编码器中,shape 为 [1,96,128,128],头数为 2,则 reshape 后得到 [1,2,48,16384],因为 128 × 128 = 16,384。
对于一个头中的某个通道,现在可以把它看成一个长度为 16,384 的向量。这个向量包含了该通道在所有空间位置上的响应。
Reshape 没有学习新权重,也没有改变这些数值本身,只是换一种方式组织它们,方便后面的矩阵运算。
随后,代码还会对 Q 和 K 的每个空间响应向量进行 L2 归一化,即 Q̄ᵢ = Qᵢ/max(‖Qᵢ‖₂,ε),K̄ 同理。
这一步与前面的 LayerNorm 不同:LayerNorm 在每个像素位置沿通道处理;这里沿每个通道的全部空间位置处理。
第 25 步:计算通道之间的关系
接下来,Q̄ 与转置后的 K̄ 做矩阵乘法,计算 S = t · Q̄ · K̄ᵀ。
shape 变化是 [B,a,d,N] @ [B,a,N,d] → [B,a,d,d]。
这里 K̄ᵀ 表示交换最后两个维度。这样 Q̄ 和 K̄ 相乘时,空间位置维 N 被求和,留下两个通道维。
对于矩阵中的一个元素,计算为 Sᵢⱼ = t · Σn(Q̄ᵢₙK̄ⱼₙ)。
它的含义是:取第 i 个查询通道和第 j 个键通道,比较它们在全部空间位置上的响应,再把比较结果汇总成一个分数。
因此,S 中的每一个元素描述的是两个通道之间的相关关系。
t 是可学习的温度乘子,每个头有自己的 t。它调整 softmax 前分数的幅度。
第 26 步:Softmax 将关系分数变成权重
图中 Q、K 矩阵乘法之后有 Softmax。
它将每一行的分数转换成权重,计算为 Aᵢⱼ = exp(Sᵢⱼ)/Σk exp(Sᵢₖ)。
同一行的所有权重都为正,并且总和为 1。
例如,某一行最后得到 [0.1,0.7,0.2],可以理解为:这一输出通道在组合 value 特征时,对三个通道分别使用 0.1、0.7、0.2 的权重。
图中的灰色方格就是注意力矩阵 A。
这个矩阵的大小是每头 d × d,不是像素数量 N × N。
第 27 步:用注意力权重组合 V
图中注意力矩阵 A 向下,与 V 在圆圈叉号处进行矩阵乘法,得到 O = A · V。
shape 为 [B,a,d,d] @ [B,a,d,N] → [B,a,d,N]。
对于空间位置 n,输出通道 i 的计算是 Oᵢₙ = Σj(AᵢⱼVⱼₙ)。
也就是说:在同一个空间位置,把不同 V 通道的响应按权重组合起来,生成新的通道响应。
注意力矩阵 A 是根据整幅特征图计算得到的,所以它包含当前图像的全局信息;随后,这组权重应用于各个空间位置的通道组合。
这也解释了它的特点:权重的生成使用全图响应,而输出阶段主要进行通道混合。
最后,O 经过 reshape 合并各个头,恢复成 [B,Cᵢ,Hᵢ,Wᵢ],再通过 1 × 1 输出卷积。
图最右侧的加号将这份变换结果与原始 X 相加,得到第一个残差子层的输出 X₁。
第 28 步:为什么 MDTA 没有建立巨大的像素关系矩阵
如果对每个像素与其他全部像素建立关系,那么 N 个位置需要 N × N 的注意力矩阵。
对于 256 × 256 的特征图,N = 65,536,N × N 约有 42.9 亿个元素。
MDTA 改为建立通道关系。如果 Cᵢ = 48、a = 1,那么注意力矩阵只有 48 × 48,共 2,304 个元素。
这只是在比较注意力矩阵的规模,不代表整个模型只需要这么少的计算或显存。Q、K、V 仍然包含全部空间位置,计算它们的相关性也需要遍历这些位置。
但它避免了显式保存一个巨大 N × N 矩阵。这是其能够处理高分辨率特征的重要原因。
第 29 步:接着进入右上角的 GDFN
MDTA 子层得到 X₁ 后,接下来执行 GDFN 子层。
图右上角浅蓝色区域,标记为 (b),就是 GDFN 的展开结构。
主线是:输入 → Norm → 两条卷积分支 → 一条分支执行 GELU → 两条分支逐元素相乘 → 1 × 1 输出卷积 → 加回输入。
GDFN 的全称是 Gated-DConv Feed-Forward Network,可以理解为"包含深度卷积和门控操作的前馈网络"。
这里的"前馈"表示特征继续向前经过一组变换。"门控"则表示一条特征分支的数值会调制另一条分支。
第 30 步:GDFN 先增加内部通道
设 GDFN 的输入通道为 Cᵢ,扩张因子为 r,内部每条分支的通道数为 D = int(Cᵢ·r)。
默认 r = 2.66。比如 Cᵢ = 48 时,D = int(127.68) = 127。
代码先使用一个 1 × 1 卷积,将输入通道从 Cᵢ 扩展到 2D。
因此,对于 [B,48,Hᵢ,Wᵢ] 的输入,这一步得到 [B,254,Hᵢ,Wᵢ]。
接着执行 3 × 3 深度卷积,shape 保持不变。
再沿通道拆成两份 Z₁ 和 Z₂,每份都有 127 个通道,即 [B,127,Hᵢ,Wᵢ]。
图中把这两份数据画成两条并行路线。代码用一次扩张卷积、一次深度卷积和一次通道拆分完成它们。
第 31 步:GELU 和逐元素乘法形成门控
在图中的两条路线里,一条经过 GELU,另一条不经过激活。随后两条路线在实心点乘号处相乘。
计算为 G = GELU(Z₁) ⊙ Z₂。
GELU 是一种非线性函数,其形式为 GELU(z) = z·Φ(z),Φ 是标准正态分布的累积分布函数。学习这张结构图时,先把它理解为"对输入数值进行平滑的非线性调整"即可。
⊙ 表示逐元素乘法。例如,两条分支在某个相同位置的数值分别为 0.5 和 2,那么乘积就是 1;如果其中一条接近零,乘积也会接近零。
因此,一条分支的响应可以抑制、放大或改变另一条分支的响应,这就是"门控"的含义。
这里没有 sigmoid,所以门控数值不限定在 [0,1]。它不是只能"打开或关闭"的开关。
乘法前后 shape 不变,两份 [B,D,Hᵢ,Wᵢ] 相乘,得到一份 [B,D,Hᵢ,Wᵢ]。
第 32 步:GDFN 恢复通道,并完成第二次残差相加
乘法得到的 G 经过最后一个 1 × 1 卷积,将通道从 D 压回 Cᵢ。
对于刚才的例子,就是 [B,127,Hᵢ,Wᵢ] → [B,48,Hᵢ,Wᵢ]。
于是 GDFN 的变换结果与输入 shape 相同,可以进行残差相加。
第二个子层的输出为 X₂ = X₁ + GDFN(LN₂(X₁))。
到这里,一个完整 Transformer Block 执行结束。
前面所有橙色方框中的每个 Block,都会执行这两次特征更新:先用 MDTA 处理通道关系,再用 GDFN 进行门控特征变换。
第 33 步:将所有位置与默认代码参数对应起来
默认网络的各层配置如下。这里"每头通道数"决定了注意力矩阵的大小。
| 位置 | 通道数 | 注意力头数 | 每头通道数 | Block 数量 |
|---|---|---|---|---|
| 一级编码器 | 48 | 1 | 48 | 4 |
| 二级编码器 | 96 | 2 | 48 | 6 |
| 三级编码器 | 192 | 4 | 48 | 6 |
| 底部瓶颈层 | 384 | 8 | 48 | 8 |
| 三级解码器 | 192 | 4 | 48 | 6 |
| 二级解码器 | 96 | 2 | 48 | 6 |
| 一级解码器 | 96 | 1 | 96 | 4 |
| Refinement | 96 | 1 | 96 | 4 |
一级解码器有 96 个通道,是因为它与一级编码特征拼接后,没有再压缩通道。
所以,虽然四级编码器每头都是 48 个通道,但一级解码器和 refinement 每头是 96 个通道。
第 34 步:把一张图的完整 shape 路线再走一遍
对于输入 [1,3,256,256],每个关键位置如下:
| 顺序 | 图中位置 | shape |
|---|---|---|
| 1 | 左上角退化图像 I | [1,3,256,256] |
| 2 | 第一个 3 × 3 卷积输出 F₀ | [1,48,256,256] |
| 3 | 左上方一级编码器 E₁ | [1,48,256,256] |
| 4 | 第一次红色箭头下采样 | [1,96,128,128] |
| 5 | 左侧二级编码器 E₂ | [1,96,128,128] |
| 6 | 第二次红色箭头下采样 | [1,192,64,64] |
| 7 | 左侧三级编码器 E₃ | [1,192,64,64] |
| 8 | 第三次红色箭头下采样 | [1,384,32,32] |
| 9 | 底部瓶颈层 Fₗ | [1,384,32,32] |
| 10 | 第一次绿色箭头上采样 | [1,192,64,64] |
| 11 | 与 E₃ 在圆圈 C 处拼接 | [1,384,64,64] |
| 12 | 1 × 1 卷积压缩 | [1,192,64,64] |
| 13 | 三级解码器 D₃ | [1,192,64,64] |
| 14 | 第二次绿色箭头上采样 | [1,96,128,128] |
| 15 | 与 E₂ 在圆圈 C 处拼接 | [1,192,128,128] |
| 16 | 1 × 1 卷积压缩 | [1,96,128,128] |
| 17 | 二级解码器 D₂ | [1,96,128,128] |
| 18 | 第三次绿色箭头上采样 | [1,48,256,256] |
| 19 | 与 E₁ 在圆圈 C 处拼接 | [1,96,256,256] |
| 20 | 一级解码器输出 Fᵈ | [1,96,256,256] |
| 21 | Refinement 输出 Fʳ | [1,96,256,256] |
| 22 | 最后的 3 × 3 卷积输出 R | [1,3,256,256] |
| 23 | 与输入 I 相加,得到 Î | [1,3,256,256] |
这张表对应的就是图中从左上进入、向下编码、向上解码、向右输出的完整路线。
第 35 步:这些卷积和注意力为什么能学会恢复图像
图中卷积的权重、LayerNorm 的缩放和平移参数、注意力的温度参数等,都是通过训练学习的。
训练时,网络接收退化图像 I,生成恢复结果 Î,再与对应的清晰图像 GT 比较。
项目常用 L1 损失,可以理解为 Loss = mean(|Î−GT|),即计算预测图像与清晰目标在所有像素和通道上的平均绝对误差。
通过反向传播,程序计算哪些参数影响了误差,再由优化器调整这些参数。经过大量退化图像和清晰图像对的训练,网络逐渐学会合适的特征提取、通道组合、门控变换和残差预测方式。
图中没有人为指定"这一层删除雨滴"或者"那个通道补充边缘"。这些处理方式由训练数据与损失共同决定。
第 36 步:图中的输出路线与双像素任务有什么不同
图中展示的是普通单图 RGB 恢复:输入是 3 通道,输出残差也是 3 通道,所以能够执行 Î = I + R。
项目中的双像素去散焦任务输入不同。它将左右两张 RGB 图像沿通道拼接,形成 6 通道输入,最终仍生成 3 通道恢复图像。
6 通道输入不能直接与 3 通道输出逐元素相加。因此,代码在这个任务中改为使用浅层特征跳跃连接:先将 F₀ 从 C 通道投影到 2C 通道,与 refinement 特征 Fʳ 相加,再通过输出卷积生成 RGB 图像,计算为 Î = Convout(Fʳ + Convskip(F₀))。
它仍然使用前面讲过的编码器、瓶颈、解码器、MDTA 和 GDFN,只是输入通道与最后的跳跃连接方式发生了变化。