字幕文件能打开,不一定意味着内容对应正确。例如源文有三个片段,译文返回顺序换了;如果按数组位置拼接,时间戳仍像是对的,字幕却已经配错。
Vimorph 的转写导出以源片段时间轴为基准,译文按索引匹配。本文做一个独立 TypeScript 示例,把这条对应关系和导出边界拆开:生成原文 SRT、原文 WebVTT 和双语 SRT。输入校验与版本匹配是本次教学增强,样本为手写数据,不代表当前产品已具备全部校验。
源片段索引与字幕文件序号
当前业务的原文导出支持 TXT/SRT/WebVTT,译文和双语导出支持 TXT/SRT。源片段有 index、开始和结束毫秒、文本;译文只需要关联索引与文本。时间范围继续由源片段提供。下面是示例的完整 src/types.ts,与配套工程一致:
typescript
export type Segment = {
  index: number;
  startMillis: number;
  endMillis: number;
  text: string;
};
export type Transcript = { sourceId: string; revision: number; segments: Segment[] };
export type Translation = {
  sourceId: string;
  sourceRevision: number;
  segments: { index: number; text: string }[];
};
export type SubtitleFormat = "srt" | "vtt";
sourceId 标识同一个任务或源文,revision 和 sourceRevision 则标识这份源文的版本。三者都是示例约定,真实接入时需要由应用维护;只有来源和版本同时相同,才能按片段索引配对。
这两种编号要分开:segment.index 用于找译文,SRT 文件序号表示输出顺序,从 1 重新编号。源索引即使是 10、20、99,文件中仍然输出 1、2、3。不能按两个数组的相同位置配对,也不能把业务索引原样当作文件序号。
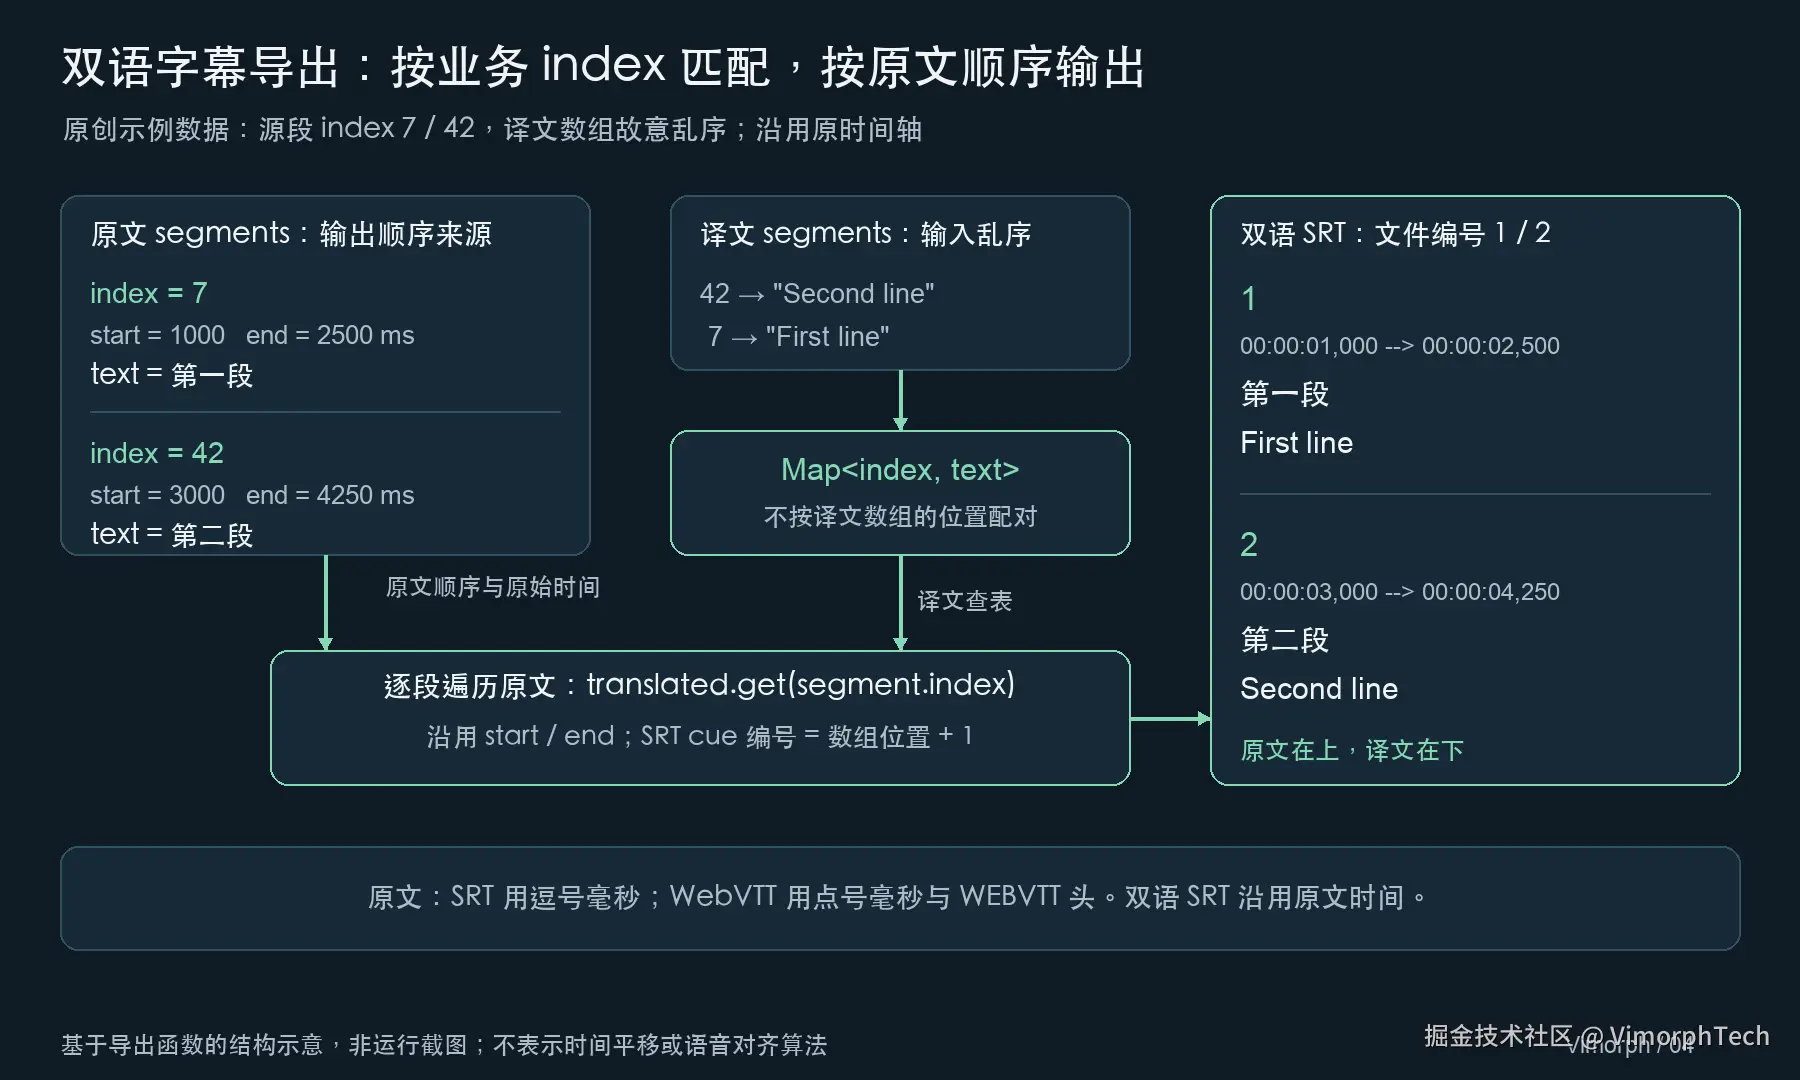
图中用两个片段说明对应关系;配套命令行样本有三个片段。这里只做文本映射和文件序列化,不重新计算语音时间,也不做音频对齐。
时间戳与文件结构
| 输出 | 文件头 | 毫秒分隔符 | 文本 |
|---|---|---|---|
| 原文 SRT | 无专用文件头,cue 前有序号 | 逗号,如 00:00:01,250 |
原文 |
| 原文 WebVTT | WEBVTT 后接空行 |
点,如 00:00:01.250 |
原文 |
| 双语 SRT | 与 SRT 相同 | 逗号 | 同一 cue 中先原文,再译文 |
SRT 的常见文本块由序号、起止时间、正文和空行组成,可参考美国国会图书馆的格式说明。WebVTT 的文件头、时间与 cue 文本按 W3C 格式文档核对;查阅版本为候选推荐草案,具体环境的读取仍需实测。
时间戳表示从媒体开始累计的时长,不是日期。示例用整除和余数得到小时、分钟、秒和毫秒,超过 24 小时也不会回到零点。它接受非负安全整数毫秒;小数、缺失值和非有限值直接报错,不在格式化时悄悄截为零。
保留源数组顺序,同时要求开始时间非递减、结束晚于开始。相邻片段可以重叠,示例不会自动排序或重新对齐音频。重叠字幕在不同播放器中的呈现可能不同;双语文本也会占据更多显示空间。字幕碰撞、自动断行和阅读速度优化不在这个导出函数的职责内。
完整导出实现
下面是完整的 src/subtitle-export.ts。它依赖上面的 types.ts,在配套工程中编译运行。导出前先检查对象、数组和片段形状,再检查时间、索引和文本;双语路径还会核对来源与版本。
typescript
import type { SubtitleFormat, Transcript, Translation } from "./types.js";
export type { Segment, SubtitleFormat, Transcript, Translation } from "./types.js";
function requireObject(value: unknown, name: string): asserts value is Record<string, unknown> {
if (typeof value !== "object" || value === null || Array.isArray(value)) {
throw new Error(`${name}必须是对象`);
}
}
function requireSourceId(value: unknown, name: string): asserts value is string {
if (typeof value !== "string" || !value.trim()) throw new Error(`${name}必须是非空字符串`);
}
function nonNegativeInteger(value: unknown, name: string): asserts value is number {
if (typeof value !== "number" || !Number.isSafeInteger(value) || value < 0) {
throw new Error(`${name} 必须是非负安全整数`);
}
}
function requireFormat(format: SubtitleFormat): void {
if (format !== "srt" && format !== "vtt") throw new Error("仅支持 SRT 和 VTT");
}
export function formatTimestamp(ms: number, format: SubtitleFormat): string {
nonNegativeInteger(ms, "时间");
requireFormat(format);
const hours = Math.floor(ms / 3_600_000);
const minutes = Math.floor(ms / 60_000) % 60;
const seconds = Math.floor(ms / 1_000) % 60;
const fraction = ms % 1_000;
const pad = (value: number, width: number) => String(value).padStart(width, "0");
const separator = format === "srt" ? "," : ".";
return `${pad(hours, 2)}:${pad(minutes, 2)}:${pad(seconds, 2)}${separator}${pad(fraction, 3)}`;
}
function plainText(text: unknown): string {
if (typeof text !== "string") throw new Error("字幕文本必须是字符串");
if (/[\u0000-\u0008\u000B\u000C\u000E-\u001F\u007F]/.test(text)) {
throw new Error("字幕文本不能包含控制字符");
}
const normalized = text.replace(/\r\n?/g, "\n").trim();
if (!normalized) throw new Error("字幕文本不能为空");
if (normalized.split("\n").some(line => !line.trim())) {
throw new Error("字幕文本不能包含内部空白行");
}
return normalized;
}
function payload(text: unknown, format: SubtitleFormat): string {
const normalized = plainText(text);
if (format === "srt") {
// 保留普通 & 和比较符号;拒绝像标签/注释的片段,避免读取器样式差异。
// 这是示例策略,不是通用 SRT 限制,也不是 HTML 净化器。
if (/<\/?[A-Za-z][^>]*>|<!--/.test(normalized)) {
throw new Error("本示例的 SRT 不接受像 HTML 标签或注释的片段");
}
return normalized;
}
return normalized.replace(/&/g, "&").replace(/</g, "<").replace(/>/g, ">");
}
function validateTranscript(transcript: unknown): asserts transcript is Transcript {
requireObject(transcript, "原文");
requireSourceId(transcript.sourceId, "原文 sourceId");
nonNegativeInteger(transcript.revision, "原文 revision");
if (!Array.isArray(transcript.segments)) throw new Error("原文 segments 必须是数组");
if (!transcript.segments.length) throw new Error("没有可导出的字幕片段");
const indexes = new Set<number>();
let previousStart = -1;
for (const segment of transcript.segments) {
requireObject(segment, "原文片段");
nonNegativeInteger(segment.index, "片段 index");
if (indexes.has(segment.index)) throw new Error(`原文 index 重复:${segment.index}`);
indexes.add(segment.index);
nonNegativeInteger(segment.startMillis, "开始时间");
nonNegativeInteger(segment.endMillis, "结束时间");
if (segment.endMillis <= segment.startMillis) throw new Error("结束时间必须晚于开始时间");
if (segment.startMillis < previousStart) throw new Error("片段开始时间必须非递减");
previousStart = segment.startMillis;
plainText(segment.text);
}
}
function cue(number: number, start: number, end: number, text: string, format: SubtitleFormat): string {
const prefix = format === "srt" ? `${number}\n` : "";
return `${prefix}${formatTimestamp(start, format)} --> ${formatTimestamp(end, format)}\n${text}`;
}
export function exportTranscript(transcript: Transcript, format: SubtitleFormat): string {
requireFormat(format);
validateTranscript(transcript);
const cues = transcript.segments.map((segment, position) => cue(
position + 1, segment.startMillis, segment.endMillis, payload(segment.text, format), format,
));
return (format === "vtt" ? "WEBVTT\n\n" : "") + cues.join("\n\n") + "\n\n";
}
export function exportBilingualSrt(transcript: Transcript, translation: Translation): string {
validateTranscript(transcript);
requireObject(translation, "译文");
requireSourceId(translation.sourceId, "译文 sourceId");
nonNegativeInteger(translation.sourceRevision, "译文 sourceRevision");
if (!Array.isArray(translation.segments)) throw new Error("译文 segments 必须是数组");
if (translation.sourceId !== transcript.sourceId) throw new Error("译文 sourceId 与当前原文不一致");
if (translation.sourceRevision !== transcript.revision) throw new Error("译文快照与当前原文 revision 不一致");
const sourceIndexes = new Set(transcript.segments.map(segment => segment.index));
const translated = new Map<number, string>();
for (const segment of translation.segments) {
requireObject(segment, "译文片段");
nonNegativeInteger(segment.index, "译文 index");
if (translated.has(segment.index)) throw new Error(`译文 index 重复:${segment.index}`);
if (!sourceIndexes.has(segment.index)) throw new Error(`译文存在额外 index:${segment.index}`);
translated.set(segment.index, payload(segment.text, "srt"));
}
const cues = transcript.segments.map((segment, position) => {
const translatedText = translated.get(segment.index);
if (translatedText === undefined) throw new Error(`缺少 index ${segment.index} 的译文`);
const text = `${payload(segment.text, "srt")}\n${translatedText}`;
return cue(position + 1, segment.startMillis, segment.endMillis, text, "srt");
});
return cues.join("\n\n") + "\n\n";
}exportTranscript() 按源数组生成 cue,SRT 序号用 position + 1,WebVTT 本例省略可选 cue 标识。双语函数先建立 Map<index, text>,再遍历源片段取译文;译文返回顺序不会决定字幕输出顺序。
TypeScript 类型只约束编译阶段,接口仍可能传来 null、缺失数组或非对象片段。入口先检查这些形状,返回明确的 Error,避免读取字段时意外出现 TypeError。
建立 Map 前检查重复索引,是为了避免后一个值静默覆盖前一个值。缺译文、额外索引和空文本同样拒绝,让调用方修正输入;不通过填空字符串或跳过片段产生一个看似完整的文件。
文本会把 CRLF/CR 统一为 LF、去掉外层空白,保留内部非空的多行。内部空白行可能改变字幕块边界,所以本例拒绝;控制字符在裁剪空白前检查,避免先被 trim() 去掉。空行拒绝与空文件拒绝是示例的输入策略,不表示所有字幕格式都要求如此。
WebVTT 路径把 &、<、> 转成字符引用,原文中的标签也作为普通文本处理,不让识别文本直接变成 cue 标记。SRT 保留普通 & 和裸 < >,例如"研发 & 测试:1 < 2,3 > 2",不套用 HTML 实体转义。
部分 SRT 读取器会解释样式标签,因此本例用有限规则拒绝完整的字母开头标签和 <!-- 注释开头。这是本例选择,不是 SRT 的通用禁令;规则可能拒绝类似 <example> 的字面文本,也不是 HTML 净化器。需要保留这类内容或样式时,应先明确目标读取器的行为。
运行示例并查看输出
工程要求 Node.js 22.12.0 或更高,开发依赖固定为 TypeScript 5.9.3、@types/node 22.19.19。没有 React 或 FFmpeg 的运行依赖。
完整示例工程包含类型、导出函数、手写样本、测试和四个生成文件。解压后运行:
text
cd subtitle-export-demo
npm install
npm test
npm run demo
npm test 先编译 TypeScript,再执行 Node 内置测试;npm run demo 使用编译后的入口。下面是完整 src/demo.ts:
typescript
import { mkdirSync, writeFileSync } from "node:fs";
import { exportBilingualSrt, exportTranscript, type Transcript, type Translation } from "./subtitle-export.js";

// 本地手写样本,不是真实识别或翻译结果。
const transcript: Transcript = {
  sourceId: "demo-transcript",
  revision: 3,
  segments: [
    { index: 10, startMillis: 0, endMillis: 900, text: "先确认时间格式。" },
    { index: 20, startMillis: 1_250, endMillis: 2_450, text: "多行字幕\r\n仍属于同一条 cue。" },
    { index: 99, startMillis: 3_599_999, endMillis: 3_601_250, text: "这一条跨过一小时。" },
  ],
};
const translation: Translation = {
  sourceId: "demo-transcript",
  sourceRevision: 3,
  segments: [
    { index: 99, text: "This cue crosses the one-hour mark." },
    { index: 10, text: "Check the timestamp format first." },
    { index: 20, text: "A multiline subtitle\nis still one cue." },
  ],
};

mkdirSync("output", { recursive: true });
writeFileSync("output/sample.srt", exportTranscript(transcript, "srt"), "utf8");
writeFileSync("output/sample.vtt", exportTranscript(transcript, "vtt"), "utf8");
writeFileSync("output/bilingual.srt", exportBilingualSrt(transcript, translation), "utf8");
writeFileSync("output/special.srt", exportTranscript({
  sourceId: "demo-special", revision: 1,
  segments: [{ index: 5, startMillis: 1_250, endMillis: 2_301, text: "研发 & 测试:1 < 2,3 > 2" }],
}, "srt"), "utf8");
console.log("已生成 output/sample.srt、sample.vtt、bilingual.srt、special.srt;均为手写测试样本。");
原文索引不连续,译文故意乱序,第二段含多行,第三段跨过一小时。程序写出 output/sample.srt、output/sample.vtt、output/bilingual.srt,另用 output/special.srt 检查普通特殊字符。四份文件统一采用 UTF-8 与 LF。
双语文件开头的输出节选:
text
1
00:00:00,000 --> 00:00:00,900
先确认时间格式。
Check the timestamp format first.

2
00:00:01,250 --> 00:00:02,450
多行字幕
仍属于同一条 cue。
A multiline subtitle
is still one cue.
第三条由原文 index 99 对应译文 index 99,但文件序号仍是 3。双语使用原文时间范围,不因译文长度增加就自动延长显示时间;阅读速度和断行属于后续字幕编辑问题。
导出前确认保存与原文版本
用户修改了文本,导出仍读取旧内存对象,就可能下载到旧内容。Vimorph 原文导出会先等待保存,再读取最新任务;当前译文导出重新读取译文列表,但这不能保证源文与译文是一份原子快照。
结构变化比文本变化更难处理。后端替换分段时按位置重新编号,拆分、合并或删除以后,即使旧译文仍有相同的数字索引,它指向的内容也可能变了。因此,按索引配对只在双方来自同一版源数据时成立。
示例同时要求 translation.sourceId === transcript.sourceId 和 sourceRevision === revision,不匹配就拒绝导出,避免不同任务的相同版本号互认。每次影响译文对应关系的源修改都必须更新版本,生成译文时保存来源与版本;若一直沿用旧标识,检查就没有保护作用。标识相同也不能证明译文语义正确。
当前业务已经记录 sourceUpdatedAt,但前端没有用它校验旧译文;缺失时间、重复索引和缺译文也没有本例的严格校验。示例把导出前的检查集中在函数入口;真实集成还需要补齐调用方的保存协调与版本维护。
实际验证范围
| 验证层 | 本次结果 |
|---|---|
| 现有前端相关测试 | 2 个文件共 6 项通过,其中导出 2 项、字幕时间格式 1 项,另 3 项为显示工具 |
| 独立 TypeScript 示例 | 编译成功,40 项测试通过;覆盖对象/数组形状、时间边界、索引集合、来源与版本、文本策略和完整输出 |
| 命令行输出 | 四个字幕文件生成成功,源码、正文完整代码与 ZIP 逐文件一致 |
| ffprobe 6.0 | 原有三份样本各 3 条,特殊字符样本 1 条,开始时间与持续时间匹配 |
| Chromium 148 | 4 项实际 WebVTT 解析检查通过:生成样本、多行与字符引用、重叠片段、超过 24 小时 |
测试于 2026 年 10 月 14 日执行。现有测试和独立工程使用 Node.js 26.7.0;示例编译器为 TypeScript 5.9.3。另用 FFmpeg 6.0 实际读取并重新写出 special.srt,普通 & 和比较符号保持一致。来源与版本检查的运行结果仅对应本次独立示例。
全部输入均为手写文本和时间数据。浏览器检查读取 WebVTT cue 的时间与文本,没有播放真实视频或验证所有样式;FFmpeg 工具的解析也不等于所有剪辑软件兼容。Safari、移动端、目标视频平台导入、真实识别/翻译准确性以及 Vimorph 保存到导出的业务端到端均未验证。本次复用了已安装依赖,没有从空环境重跑 npm install。
接入时保持导出函数职责明确
导出函数接收已经确认的片段数据,输出确定的字幕文本。保存协调、源版本维护和翻译生成留在调用流程中,格式校验与序列化放在导出边界。这样时间轴、匹配关系或文本不满足约定时,可以明确报错,而不是在文件导入失败后才寻找原因。