vLLM 使用实战:在 8GB 显卡上完成模型部署、并发压测与显存调优
学习 vLLM 时,我们经常看到 PagedAttention、Continuous Batching、KV Cache 等概念。但真正把模型部署起来后,还需要回答几个实际问题:服务如何调用?吞吐该怎么测?显存预算该怎么设置?降低显存占用会不会影响性能?
本文以自研的 Xihe-106M Dense 模型为例,在 RTX 4060 Laptop 8GB 显卡上完成一个完整实践:检查模型与环境、启动 OpenAI 兼容服务、验证生成、运行并发压测,再对比不同显存预算。
文中的性能数字来自本次实际测试;安装示例和拓展方向会单独说明。本文侧重 vLLM 的使用和实验方法,不涉及源码级优化。
一、先理解 vLLM 在系统中的位置
vLLM 是面向大语言模型的推理与服务引擎。应用把提示词和生成参数发送给服务,服务负责请求调度、模型执行、KV Cache 管理和结果返回。
text
业务应用 / Python 客户端
          ↓ HTTP 请求
vLLM OpenAI 兼容接口
          ↓
请求调度、批处理、KV Cache 管理
          ↓
GPU 上的模型执行
          ↓
生成结果 / 流式 token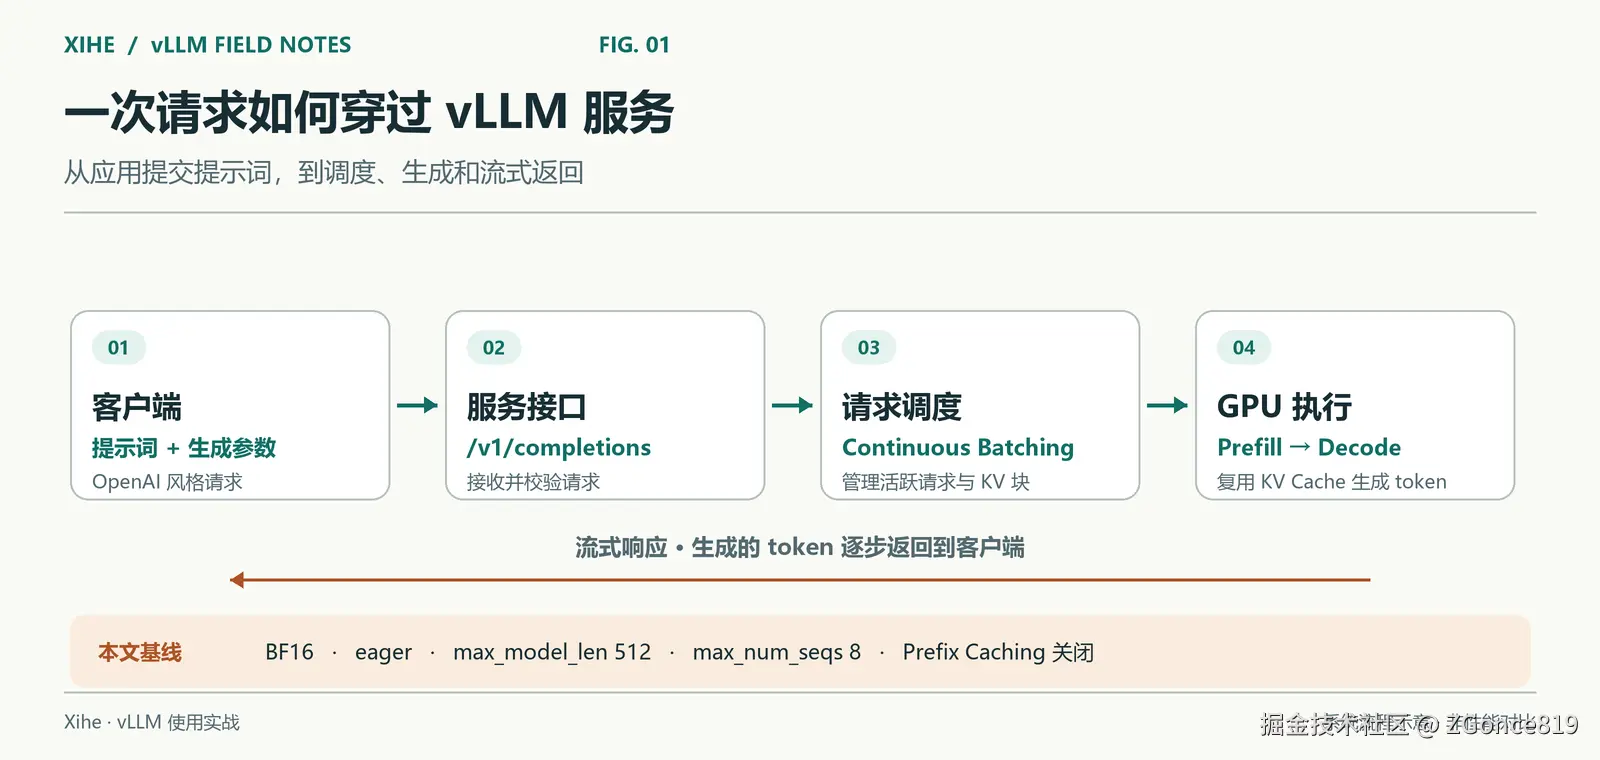
图 1:vLLM 服务中的请求路径。图中参数是本文实验基线;流程图用于解释组件关系,不代表一次请求的实际耗时比例。
本文先理解四个概念即可。
1. Prefill:处理输入
模型首先处理输入提示词,计算相关的 Key、Value 等中间状态,并准备生成第一个 token。输入越长,通常需要更多的 Prefill 工作。
首 token 延迟不只包含 Prefill,还可能包含排队、分词、调度和网络等开销。
2. Decode:逐步生成输出
自回归模型通常每一步生成一个新 token,然后继续下一步。KV Cache 允许模型复用已有 token 的 Key、Value,避免每一步重复计算全部历史状态。
输出越长,请求占据服务的时间通常也越长。
3. PagedAttention:组织 KV Cache
PagedAttention 的核心思路之一,是把 KV Cache 按块组织,通过映射管理请求的逻辑 token 与实际缓存块,改善缓存管理效率与碎片问题。
它不会让模型权重变小,也不意味着可以无限增加上下文或并发。可承载的 token 数仍然受到显存容量约束。
4. Continuous Batching:让请求动态加入和退出
请求的输入与输出长度往往不同。Continuous Batching 允许调度器在执行过程中调整参与处理的请求,让已经完成的请求退出,并让新请求加入。
这有助于提高服务吞吐,但具体收益取决于模型、GPU、输入输出长度、请求到达方式和调度参数。后面的测试展示的是本次配置下的实际结果,不能只凭吞吐数字把收益全部归因于某一个机制。
二、本次实验环境与模型
| 项目 | 本次配置 |
|---|---|
| GPU | NVIDIA RTX 4060 Laptop,约 8GB 显存 |
| 系统 | Windows + WSL2 Ubuntu-24.04 |
| Python | 3.11,Conda 环境 ai_env |
| vLLM | 0.27.1 |
| PyTorch | 2.13.0+cu130 |
| 模型 | Xihe-106M Dense,约 1.06 亿参数 |
| 部署架构 | LlamaForCausalLM |
| 模型精度 | BF16 |
| 执行模式 | eager,关闭 torch.compile 与 CUDA Graph |
| 采样实现 | native sampler |
| 模型执行器 | V1 model runner |
| Prefix Caching | 关闭 |
这些是本次已有环境的实际版本,不是建议所有读者照搬的安装组合。vLLM、PyTorch、CUDA、驱动及附加算子库之间需要兼容。
本次只测试 Dense 模型,没有测试 MoE 部署性能,也没有进行多卡实验。
模型需要符合 vLLM 支持的架构
本次模型目录包含标准 Hugging Face 配置、权重和 tokenizer 文件。配置中的关键字段为:
json
{
  "architectures": ["LlamaForCausalLM"],
  "model_type": "llama",
  "hidden_size": 768,
  "num_hidden_layers": 16,
  "num_attention_heads": 12,
  "num_key_value_heads": 4,
  "head_dim": 64,
  "vocab_size": 6400,
  "dtype": "bfloat16"
}
对于自研模型,不能仅修改 architectures 字段就认为完成适配。权重命名、张量形状、计算结构、位置编码和 tokenizer 都必须与目标实现对应。
Xihe 的 Dense 模型已通过显式 state_dict 映射转换到 Llama 格式。严格加载时检查键和形状,是适配中的必要检查之一;它本身不能代替转换前后的数值一致性验证。
三、准备环境与检查安装
以下命令默认在 WSL 的 Bash 终端中运行。
1. 检查 GPU 与 Python 环境
bash
conda activate ai_env

nvidia-smi

python -c 'import sys; print(sys.executable); print(sys.version)'

python -c 'import torch; print(torch.__version__); print(torch.version.cuda); print(torch.cuda.is_available())'

python -c 'import vllm; print(vllm.__version__)'
确认当前 Python 来自目标环境,并且 PyTorch 能识别 CUDA GPU。
如果尚未安装 vLLM,可以在独立环境中按照所选版本的官方安装说明安装。常见的 pip 安装形式是:
bash
python -m pip install vllm这只是安装入口示例,本文没有重新执行该安装命令。不要在现有训练环境中盲目升级整套依赖;本次实验使用已经安装好的 ai_env。
2. 检查命令行参数
不同版本的参数可能变化,先查看当前安装版本的帮助:
bash
python -m vllm.entrypoints.cli.main serve --help

python -m vllm.entrypoints.cli.main bench serve --help
下面的启动与压测参数已在本文记录的 vLLM 0.27.1 环境中使用。
3. Windows 路径和 WSL 路径需要区分
本文模型位于 Windows 的:
text
D:\Bemyself\Python\Product\Xihe\Xihe-106M-HF在 WSL 中对应:
text
/mnt/d/Bemyself/Python/Product/Xihe/Xihe-106M-HF如果从 Windows 的 Git Bash 调用 WSL,可以这样避免 MSYS 自动转换 Linux 路径:
bash
MSYS_NO_PATHCONV=1 wsl.exe -d Ubuntu-24.04 \
  /home/apolleo/miniconda3/envs/ai_env/bin/python \
  -c 'import vllm; print(vllm.__version__)'
如果已经进入 WSL 终端,则直接运行 Linux 命令即可。
四、启动一个可调用的模型服务
先设置模型路径,并启用本次环境实际需要的兼容配置:
bash
conda activate ai_env

export MODEL_PATH=/mnt/d/Bemyself/Python/Product/Xihe/Xihe-106M-HF

export VLLM_USE_V2_MODEL_RUNNER=0
export VLLM_USE_FLASHINFER_SAMPLER=0

python -m vllm.entrypoints.cli.main serve "$MODEL_PATH" \
  --served-model-name xihe-106m \
  --host 127.0.0.1 \
  --port 8016 \
  --dtype bfloat16 \
  --max-model-len 512 \
  --gpu-memory-utilization 0.4 \
  --max-num-seqs 8 \
  --max-num-batched-tokens 512 \
  --enforce-eager \
  --no-enable-prefix-caching
两个环境变量用于规避本次环境遇到的 runner 和 FlashInfer sampler 问题,具体原因见排错章节。它们不是所有机器的通用要求。
关键参数怎么理解
| 参数 | 作用 | 本次选择 |
|---|---|---|
--served-model-name |
API 请求中使用的模型名称 | xihe-106m |
--host |
服务监听地址 | 127.0.0.1,仅本机访问 |
--dtype |
模型计算精度配置 | BF16 |
--max-model-len |
单请求允许的最大总序列长度,包含输入和输出 | 512 |
--gpu-memory-utilization |
模型执行器使用的 GPU 显存预算比例,参与缓存规划 | 0.4 |
--max-num-seqs |
调度时最多处理的序列数量 | 8 |
--max-num-batched-tokens |
单次调度的 token 预算 | 512 |
--enforce-eager |
使用 eager 执行,禁用相关编译和 CUDA Graph 路径 | 开启 |
--no-enable-prefix-caching |
禁用前缀缓存 | 开启该禁用项 |
max_num_batched_tokens 是调度预算,不能简单理解成"所有请求完整长度之和的上限"。尤其在启用分块 Prefill 时,一个输入可能分多个调度步骤处理。
本次设置 max_model_len=512 是为了限定实验负载,并不表示模型原始配置只能支持 512 token。
为什么先使用 eager 模式
本次目标是先获得一个可重复运行的服务和对照基线。eager 模式避开了部分编译与图捕获路径,便于定位部署问题。
它不是性能最优配置的保证。后续如果测试 CUDA Graph,应作为新的实验变量,重新核对吞吐、延迟与显存,不能把本文数字直接沿用。
什么时候算启动成功
日志中出现 Application startup complete 后,再实际调用健康接口:
bash
curl -f http://127.0.0.1:8016/health

curl -s http://127.0.0.1:8016/v1/models
/health 主要通过 HTTP 状态判断服务是否就绪;/v1/models 应包含 xihe-106m。
仅看到模型权重加载完成,还不能确认服务已就绪。初始化之后仍可能在缓存规划或 kernel warmup 阶段失败。
五、调用 OpenAI 兼容接口
"OpenAI 兼容"是接口格式兼容。请求仍然发送到本地 vLLM 服务,不需要经过 OpenAI 的服务器。
1. 先处理正确的聊天模板
聊天微调模型通常需要特定的角色标记和提示词格式。直接向 /v1/completions 发送一句自然语言,不一定等价于训练时的聊天输入。
本次实验中,直接发送"你好,请介绍一下自己。",模型立即输出 EOS,返回的文本为空。使用 tokenizer 的聊天模板后,才能正常生成中文自我介绍。
下面使用 transformers 构造提示词,再通过 Python 标准库调用接口:
python
import json
import os
import urllib.request

from transformers import AutoTokenizer

model_path = os.environ.get(
    "MODEL_PATH",
    "/mnt/d/Bemyself/Python/Product/Xihe/Xihe-106M-HF",
)

tokenizer = AutoTokenizer.from_pretrained(model_path)

prompt = tokenizer.apply_chat_template(
    [{"role": "user", "content": "你好,请介绍一下自己。"}],
    tokenize=False,
    add_generation_prompt=True,
)

payload = {
    "model": "xihe-106m",
    "prompt": prompt,
    "max_tokens": 64,
    "temperature": 0,
}

request = urllib.request.Request(
    "http://127.0.0.1:8016/v1/completions",
    data=json.dumps(payload).encode("utf-8"),
    headers={"Content-Type": "application/json"},
)

with urllib.request.urlopen(request, timeout=30) as response:
    result = json.load(response)

print(result["choices"][0]["text"])
print(result["usage"])
本次实际生成的文本开头为:
text
你好!我是羲和(Xihe),由 Apolleo 基于 LLaMA 架构从零实现并训练,
当前为参数量约 1.06 亿的稠密(Dense)版本......
实际响应因 max_tokens=64 截断,以上省略号表示节选。该检查说明服务能够完成一次有内容的生成,不等于模型质量评测。
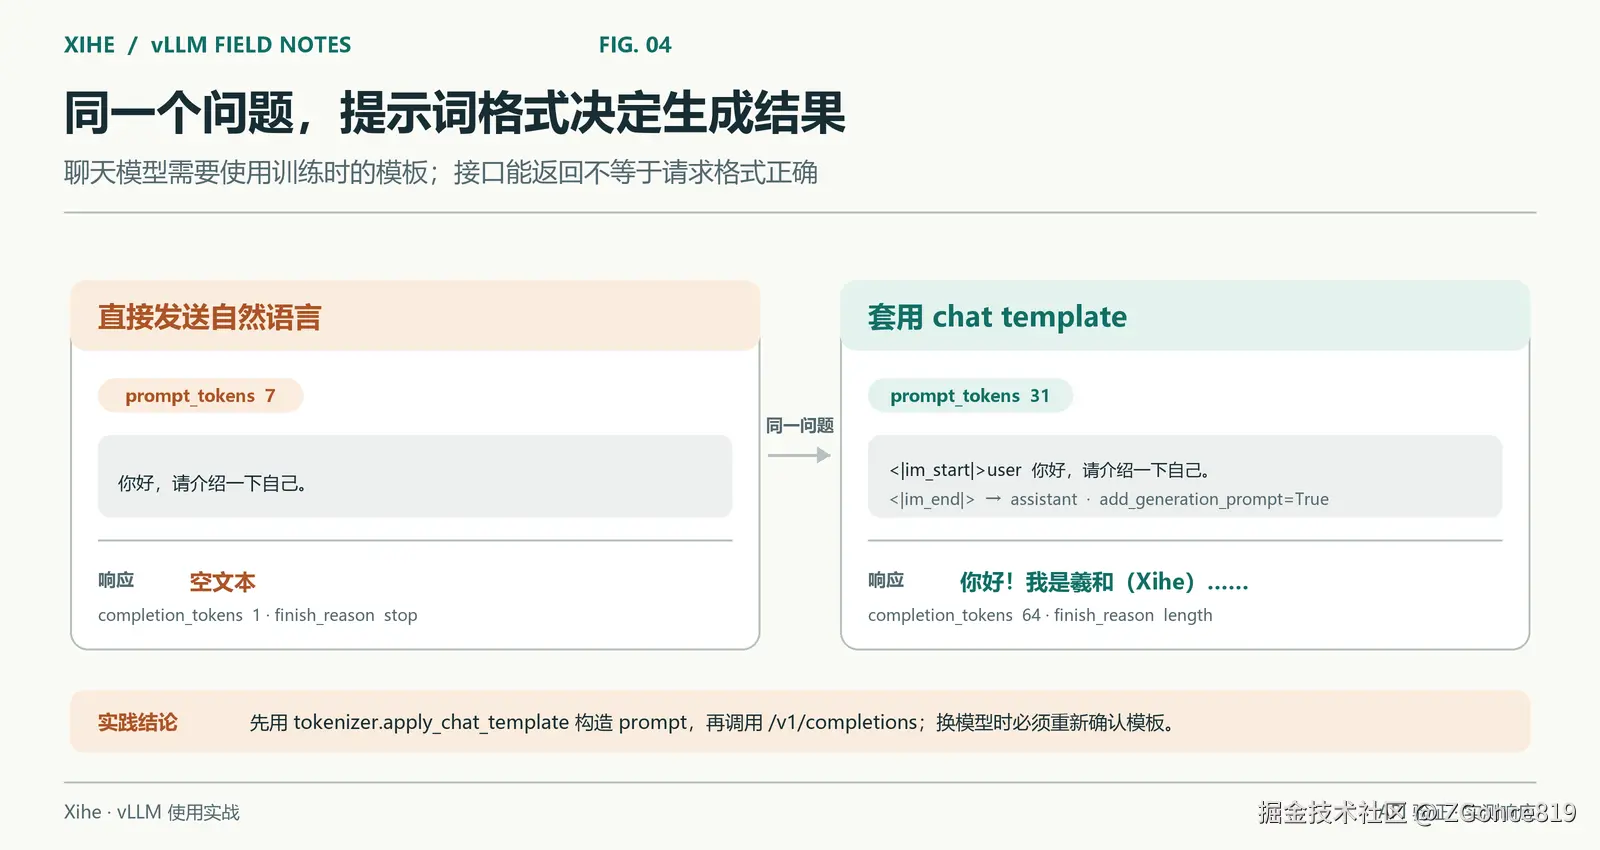
图 4:接口可达不等于提示词格式正确;本次原始输入立即结束,而模板化请求返回了非空中文回答。
如果换用其他模型,需要确认 tokenizer 是否提供适用的 chat_template。不要把 Xihe 的提示词格式硬编码给其他模型。
2. /v1/chat/completions 与 /v1/completions 的区别
/v1/completions 接收已经组织好的 prompt;聊天接口通常接收 messages,由服务端应用聊天模板。
对于具有适用模板的模型,可以尝试如下调用:
bash
curl http://127.0.0.1:8016/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "xihe-106m",
    "messages": [
      {"role": "user", "content": "你好,请介绍一下自己。"}
    ],
    "max_tokens": 64,
    "temperature": 0
  }'
这段是聊天接口的用法示例,本文实测验证的是上一节"本地应用模板 + /v1/completions"的路径。如果聊天接口提示缺少模板,应检查模型的 tokenizer 配置及当前版本的服务端模板设置。
六、先定义指标,再开始压测
单请求生成速度和服务吞吐回答的是不同问题。
| 指标 | 含义 | 用途 |
|---|---|---|
| 输出吞吐 | 测试期间成功输出的 token 总数 ÷ 测试时长 | 衡量服务输出能力 |
| 总 token 吞吐 | 输入与输出 token 总数 ÷ 测试时长 | 衡量含输入在内的处理量 |
| 请求吞吐 | 成功请求数 ÷ 测试时长 | 衡量每秒完成的请求量 |
| TTFT | 从发送请求到收到首 token 的时间 | 衡量开始响应的等待 |
| TPOT | 首 token 之后平均每个输出 token 的耗时 | 衡量持续生成速度 |
| P95 / P99 | 指标分布的百分位 | 观察尾部延迟 |
| 失败数 | 未成功完成的请求数量 | 避免只看成功请求的性能 |
对一个输出超过 1 token 的请求,TPOT 通常可近似理解为:
text
TPOT =(请求完成时间 − 首 token 到达时间)/(输出 token 数 − 1)如果只看输出吞吐,可能忽略排队时间越来越长的情况。因此压测应同时看成功率、TTFT、TPOT 和尾部延迟。
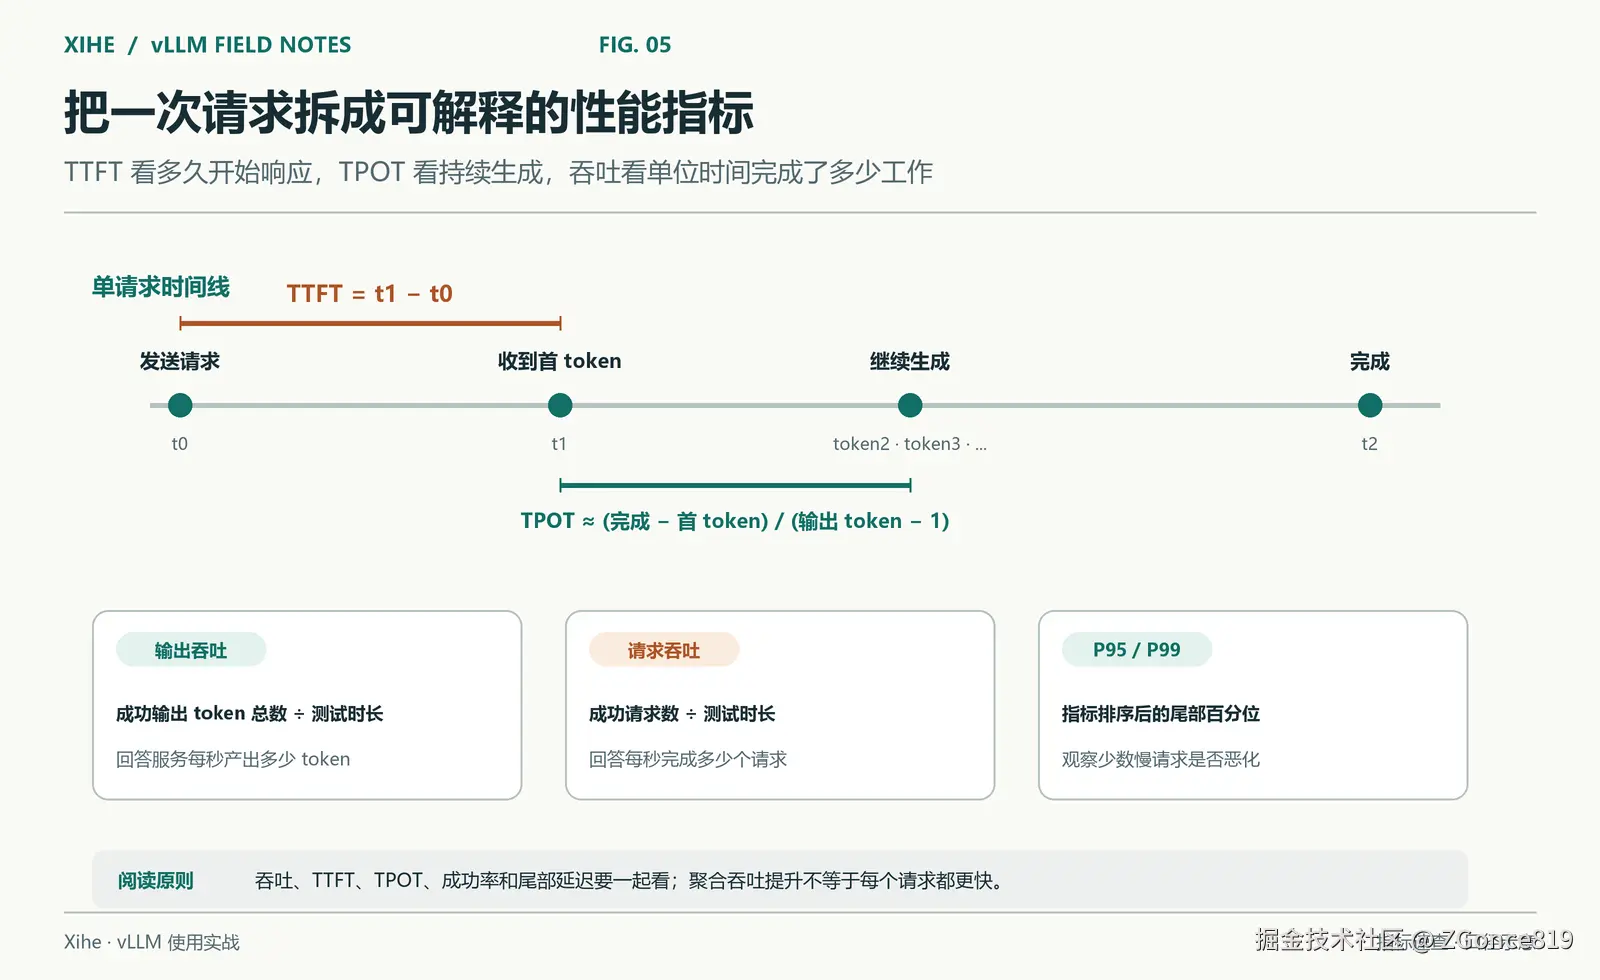
图 5:先明确指标的分子、分母和时间边界,再比较不同并发或显存预算。
七、使用 vLLM 自带工具进行并发压测
在另一个 WSL 终端中激活同一环境,设置路径:
bash
conda activate ai_env

export MODEL_PATH=/mnt/d/Bemyself/Python/Product/Xihe/Xihe-106M-HF
export RESULT_DIR=/mnt/d/Bemyself/Python/Product/vllm_benchmark_results

mkdir -p "$RESULT_DIR"
先运行一轮单并发测试:
bash
python -m vllm.entrypoints.cli.main bench serve \
  --base-url http://127.0.0.1:8016 \
  --model xihe-106m \
  --tokenizer "$MODEL_PATH" \
  --dataset-name random \
  --input-len 128 \
  --output-len 64 \
  --num-prompts 40 \
  --num-warmups 3 \
  --max-concurrency 1 \
  --ignore-eos \
  --seed 42 \
  --save-result \
  --save-detailed \
  --result-dir "$RESULT_DIR" \
  --result-filename tutorial_mem40_c1_r1.json \
  --metric-percentiles 50,95,99 \
  --ready-check-timeout-sec 30
这里使用 tutorial_ 文件名前缀,以免覆盖本文已保存的 dense_ 实验原始结果。
这些参数控制了什么
--max-concurrency 限制客户端同时进行的请求数。它和服务端的 --max-num-seqs 分别作用在客户端和服务调度端,不能混为一谈。
--ignore-eos 用于固定性能实验中的生成长度,避免部分请求提前结束,导致各轮输出工作量不一致。实际业务生成通常需要正常处理 EOS,不能机械照搬这个测试设置。
--seed 42 固定随机数据生成的种子,改善重复实验的可比性;它不保证 GPU 性能测量完全无波动。
本次随机输入目标长度为 128 token,但 tokenizer 的编码、解码往返可能导致个别样本为 129 token。应检查结果中的真实长度,而不是只看命令行参数。
本次没有指定有限的请求到达速率,属于在并发上限内尽快发出请求的容量测试。它不模拟真实业务的到达间隔。
扩展到多个并发档位
bash
for concurrency in 1 2 4 8; do
  for repeat in 1 2; do
    python -m vllm.entrypoints.cli.main bench serve \
      --base-url http://127.0.0.1:8016 \
      --model xihe-106m \
      --tokenizer "$MODEL_PATH" \
      --dataset-name random \
      --input-len 128 \
      --output-len 64 \
      --num-prompts 40 \
      --num-warmups 3 \
      --max-concurrency "$concurrency" \
      --ignore-eos \
      --seed 42 \
      --save-result \
      --save-detailed \
      --result-dir "$RESULT_DIR" \
      --result-filename "tutorial_mem40_c${concurrency}_r${repeat}.json" \
      --metric-percentiles 50,95,99 \
      --ready-check-timeout-sec 30 || exit 1
  done
done
每档先预热 3 个请求,再测量 40 个请求,重复两轮。本文展示的平均值,是两轮指标的算术平均,不是把两个实验合并后重新计算的指标。
八、读取结果:吞吐提高了多少
40% 显存预算下的实测结果如下:
| 并发数 | 第 1 轮输出吞吐 | 第 2 轮输出吞吐 | 两轮平均输出吞吐 | 平均 TTFT | 平均 TPOT |
|---|---|---|---|---|---|
| 1 | 82.85 | 84.39 | 83.62 token/s | 32.15 ms | 11.62 ms |
| 2 | 156.43 | 153.49 | 154.96 token/s | 37.64 ms | 12.50 ms |
| 4 | 329.78 | 309.29 | 319.54 token/s | 41.43 ms | 12.06 ms |
| 8 | 602.82 | 616.40 | 609.61 token/s | 40.52 ms | 12.64 ms |
8 并发与单并发的聚合输出吞吐之比为:
text
609.61 / 83.62 ≈ 7.29这说明在本次负载中,通过同时处理多个请求,服务每秒能输出更多 token。
但单请求的 TPOT 并没有变成原来的七分之一:它从约 11.62 ms 变为约 12.64 ms。因此"吞吐达到单并发的 7.29 倍"和"每个请求快了 7.29 倍"是两个完全不同的说法。
两轮 8 并发测试的 TTFT P95 分别约为 58.88 ms 和 58.77 ms。这里保留每轮百分位,而不是把两个 P95 简单平均后称为整个样本的 P95。
本次也没有在相同条件下测试 Transformers 服务,所以不能据此宣称"vLLM 比 Transformers 快 7.29 倍"。
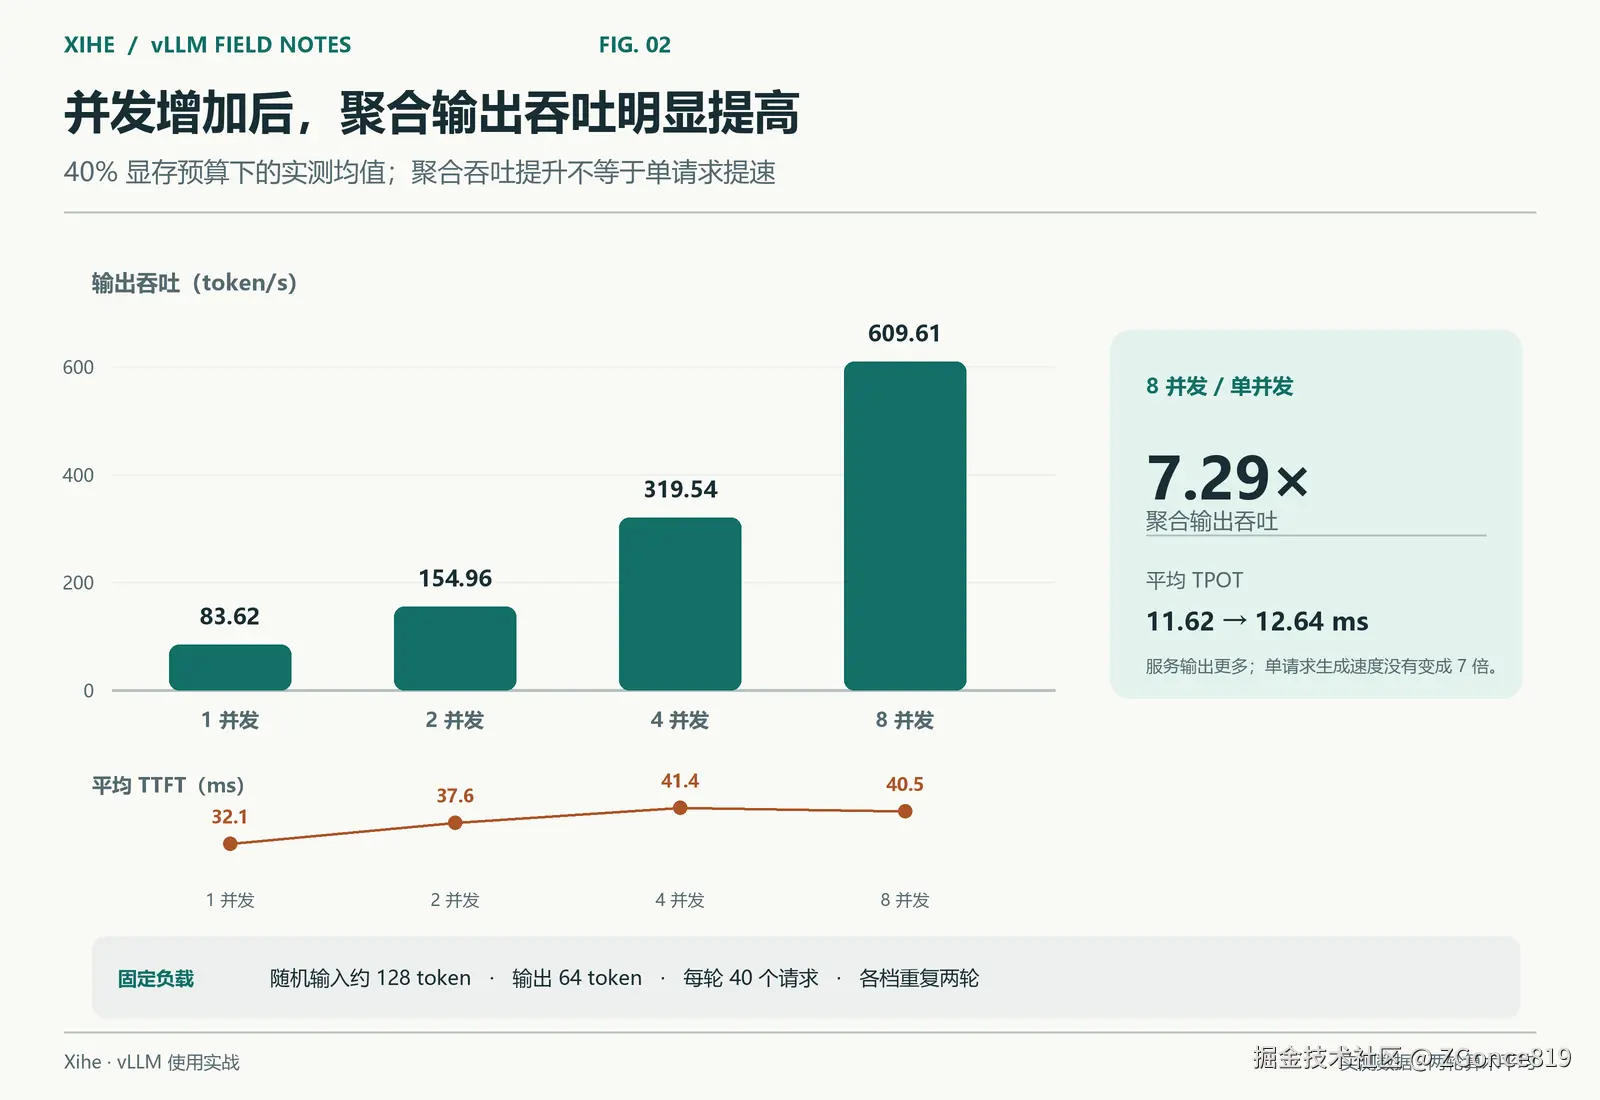
图 2:并发提高后,聚合输出吞吐从 83.62 token/s 提升到 609.61 token/s;平均 TPOT 仍在约 12 ms 的量级。
九、显存调优:调整的是预算与容量
显存不只存放模型权重。推理时还需要 KV Cache、运行时缓冲区、临时张量以及 CUDA 上下文等。
gpu_memory_utilization=0.4 不表示模型权重被压缩到原来的 40%,也不表示整张显卡的实际占用一定等于 40%。这个参数参与模型执行器的显存预算和缓存规划,设备上还可能存在其他进程占用。
1. 先看启动日志
本次 40% 预算的启动日志显示:
text
Available KV cache memory: 2.91 GiB
GPU KV cache size: 190,896 tokens
这些是缓存预算和容量信息,不是吞吐数据。
日志中的理论最大并发估计也不能代替实测:本次服务端 max_num_seqs=8,实际压测最高为 8 并发。
2. 停止服务,只修改一个变量
在运行服务的终端按 Ctrl+C,等待原服务退出,再把启动命令中的预算改成:
bash
--gpu-memory-utilization 0.2其他参数保持一致,重新启动并确认健康检查通过。
不要同时修改上下文长度、并发上限、精度、执行模式和缓存配置,否则难以解释性能变化来自哪里。
20% 预算的启动日志显示:
text
Available KV cache memory: 1.31 GiB
GPU KV cache size: 86,096 tokens
按照日志中的四舍五入值计算:
text
KV Cache 预留减少比例
= (2.91 − 1.31) / 2.91
≈ 55%
减少缓存预留也减少了缓存容量。在更长上下文或更高并发下,可能更容易遇到容量限制。
3. 重新测量吞吐
本次低预算对照测试了 1、8 两个并发档位,各运行两轮。复现时将上一节循环的并发列表改为 1 8,并使用 tutorial_mem20_ 结果前缀。
| 配置 | KV Cache 预留 | 单并发平均输出吞吐 | 8 并发平均输出吞吐 | 8 并发平均 TTFT |
|---|---|---|---|---|
| 40% 预算 | 2.91 GiB | 83.62 token/s | 609.61 token/s | 40.52 ms |
| 20% 预算 | 1.31 GiB | 81.58 token/s | 562.87 token/s | 44.55 ms |
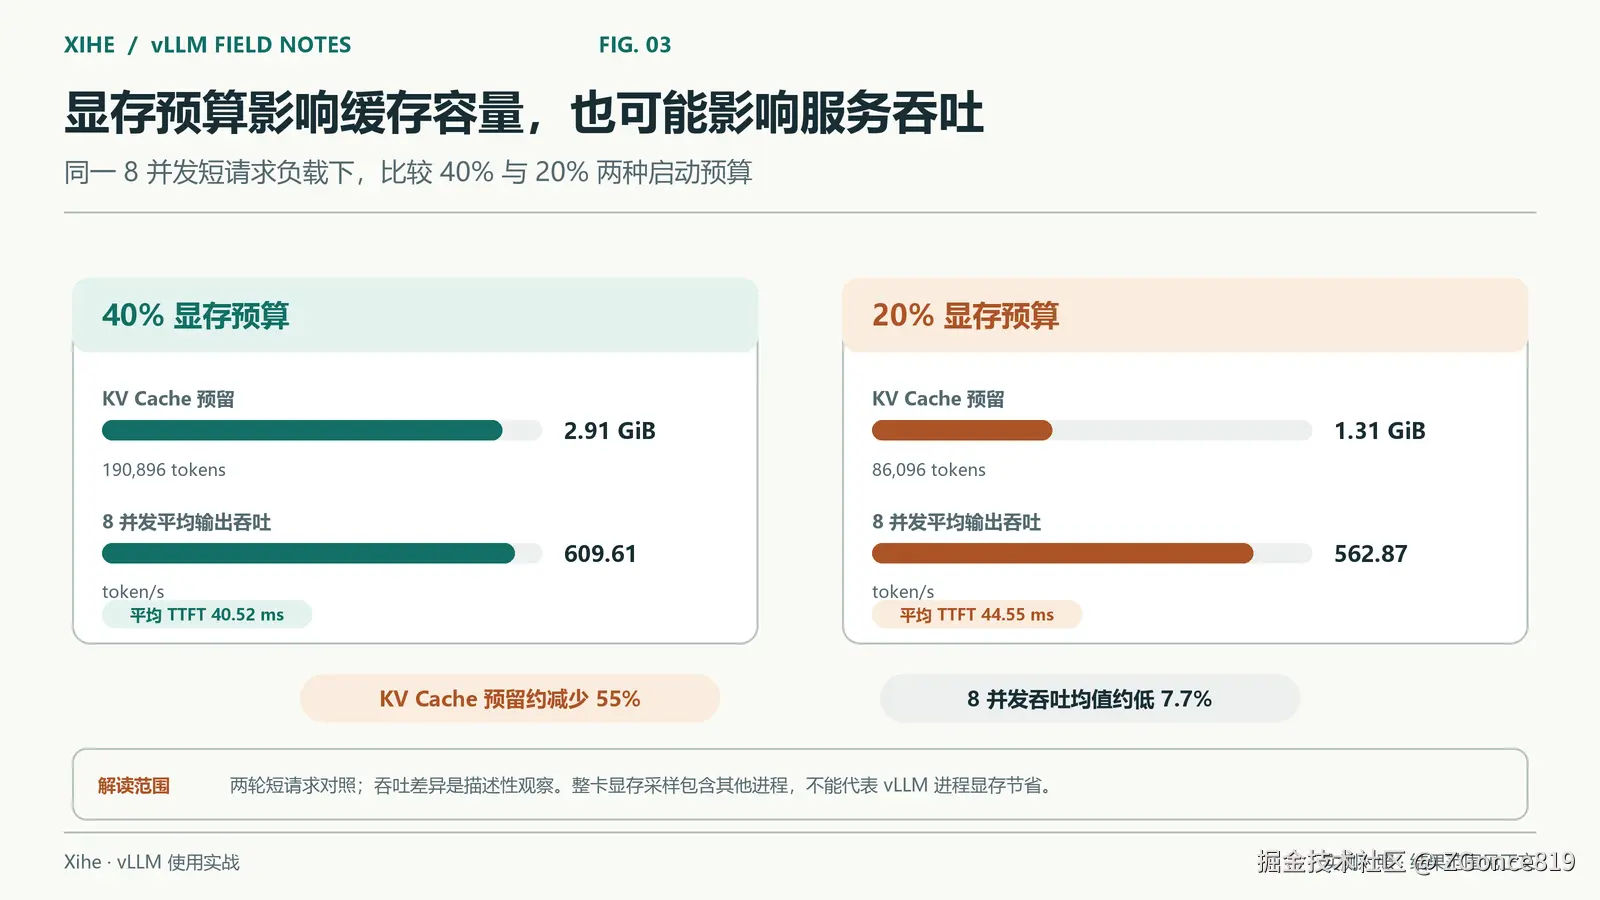
图 3:降低预算后,KV Cache 预留约减少 55%;在本次短请求负载中,8 并发平均输出吞吐约低 7.7%。
8 并发吞吐变化为:
text
(562.87 / 609.61 − 1) × 100% ≈ −7.67%可以确认的是:更低预算下,本次短请求负载仍然全部完成,KV Cache 预留减少约 55%,两轮平均吞吐低约 7.7%。
不能仅凭两轮数据断言"降低缓存预算必然导致 7.7% 的吞吐损失"。低预算的两轮吞吐分别为 591.43 和 534.32 token/s,而且第二轮出现全卡显存波动。当前数据不足以区分缓存配置、系统干扰、GPU 频率或其他因素的影响。
因此,本文把这个结果视为一次配置对照的观察,不把它当作统计意义上的因果结论。
十、显存该怎样监控
可以另开一个 WSL 终端观察:
bash
nvidia-smi \
  --query-gpu=timestamp,memory.used,memory.total,utilization.gpu \
  --format=csv \
  -lms 250
本次配套脚本通过后台线程调用 nvidia-smi,按约 250 ms 的间隔采样;实际间隔还包含命令执行开销。
需要区分两种口径:
| 数据 | 反映什么 |
|---|---|
| vLLM 启动日志中的 KV Cache 预算 | vLLM 规划的缓存空间 |
nvidia-smi 的整卡 memory.used |
整个 GPU 的占用,可能包含 Windows 和其他进程 |
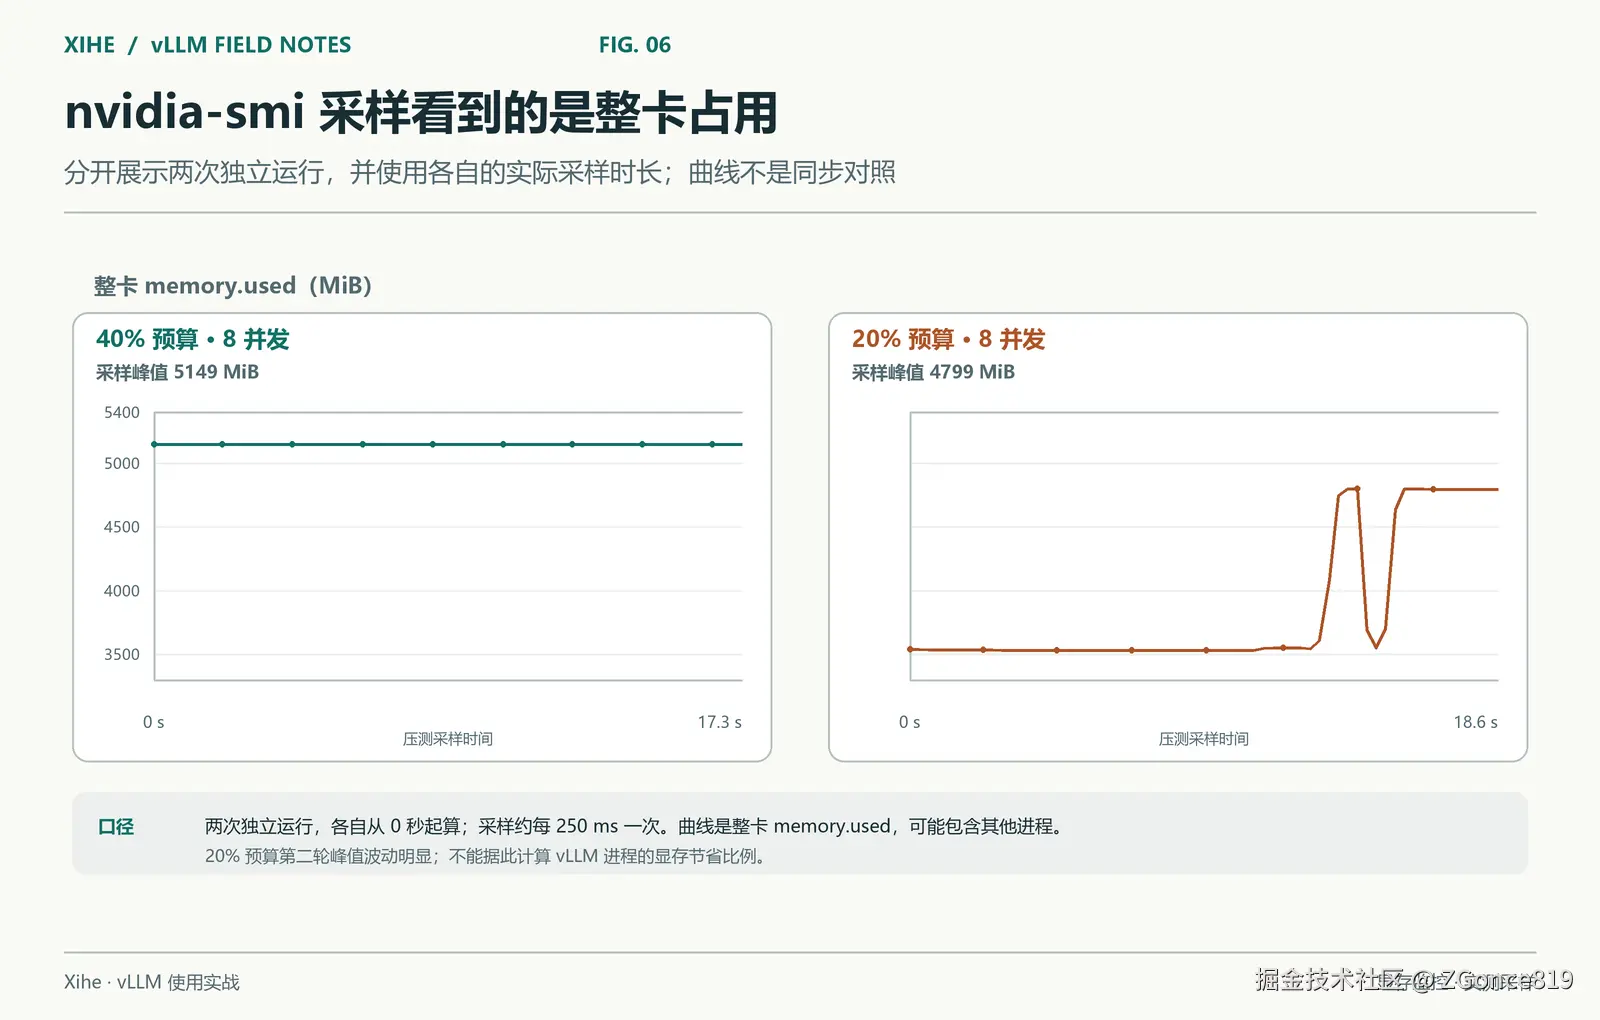
图 6:启动日志和 nvidia-smi 回答的是不同问题;采样曲线只能描述观察到的整卡占用。
40% 预算的 8 并发测试中,采样得到的整卡显存峰值为 5149 MiB。20% 预算的两轮对应峰值分别为 3560 和 4799 MiB。
低预算第二轮的变化提示实验期间存在额外波动,但仅凭整卡数据无法识别具体来源。因此,不能用两组峰值直接计算"vLLM 进程显存节省比例"。
另外,采样峰值只是采样时刻观察到的最大值,未必捕捉到采样间隔内的所有瞬时峰值。
十一、本次 WSL 部署遇到的兼容问题
下面列出本次实际遇到的问题。读者应先根据自己的报错定位,不需要预先应用全部处理。
1. RuntimeError: UVA is not available
本次异常发生在 V2 model runner 的 UVA 相关初始化路径。
当前安装版本支持如下配置,本次通过切换 runner 规避:
bash
export VLLM_USE_V2_MODEL_RUNNER=0这是切换 model runner,不应描述成切换到了旧版 V0 引擎。本次仍然使用 vLLM V1 引擎。
2. ninja 已安装,却提示找不到
要检查的是启动进程的 PATH,不只是当前终端能否找到某个文件:
bash
command -v python
command -v ninja
command -v nvcc
本次通过显式使用 Conda Python,并确保 ai_env/bin 位于服务进程的 PATH 中,进入了实际编译流程。
3. FlashInfer JIT 在链接阶段失败
本次日志中的关键错误为:
text
/usr/bin/ld: cannot find -lcudart
/usr/bin/ld: cannot find -lcuda
这是链接阶段找不到相关 CUDA 库,不是"没有 ninja",也不是模型权重加载失败。
本次为先完成部署实验,使用当前版本提供的配置切换到 native sampler:
bash
export VLLM_USE_FLASHINFER_SAMPLER=0这关闭的是 FlashInfer 采样路径,不表示关闭了 FlashAttention。本次注意力后端仍为 FlashAttention。
如果后续需要使用 FlashInfer sampler,应另行检查 CUDA 库安装和链接路径,并在修复后重新测试。
4. TypeError: type 'array.array' is not subscriptable
关闭 FlashInfer sampler 后,本次仍在 warmup 的间接导入链中进入 flashinfer.comm,遇到以下函数注解:
text
def _fd_ancillary(fd: int) -> tuple[tuple[int, int, array.array[int]]]:在本次 Python 3.11 环境中,导入时求值 array.array[int] 触发异常。
本次先完整备份原文件,再在该依赖文件允许 future import 的位置加入:
python
from __future__ import annotations它延迟注解求值,使该导入路径能够继续执行。
这是针对已定位问题的本地依赖补丁,不是 vLLM 推理优化。该修改位于安装目录,升级依赖时可能被覆盖;记录版本、修改位置和备份文件,是保证后续可维护性的必要步骤。更换环境时应先检查兼容版本是否已修复此问题。
十二、如何让压测结果更可信
本次共完成 12 轮正式测量,每轮 40 个请求,共 480 个请求,失败数为 0。每个正式请求实际输出 64 token,合计输出 30720 token,预热请求不计入这个数量。
核对结果时,至少检查以下内容:
completed是否等于计划请求数,failed是否为 0。output_lens是否符合目标,输出总 token 数是否一致。- 输入实际长度是否符合实验预期。
- 每轮配置是否相同,是否保留原始 JSON、服务日志与环境版本。
- 吞吐和延迟是否同时观察,是否存在明显波动或失败样本。
如果要用于更正式的性能结论,应增加测量时长和重复次数,交替测试不同配置,记录 GPU 温度、功耗与频率,并尽量减少其他 GPU 任务的影响。
随机短提示词适合做初步容量实验,不能代表实际业务质量、长上下文性能或高并发稳定性。
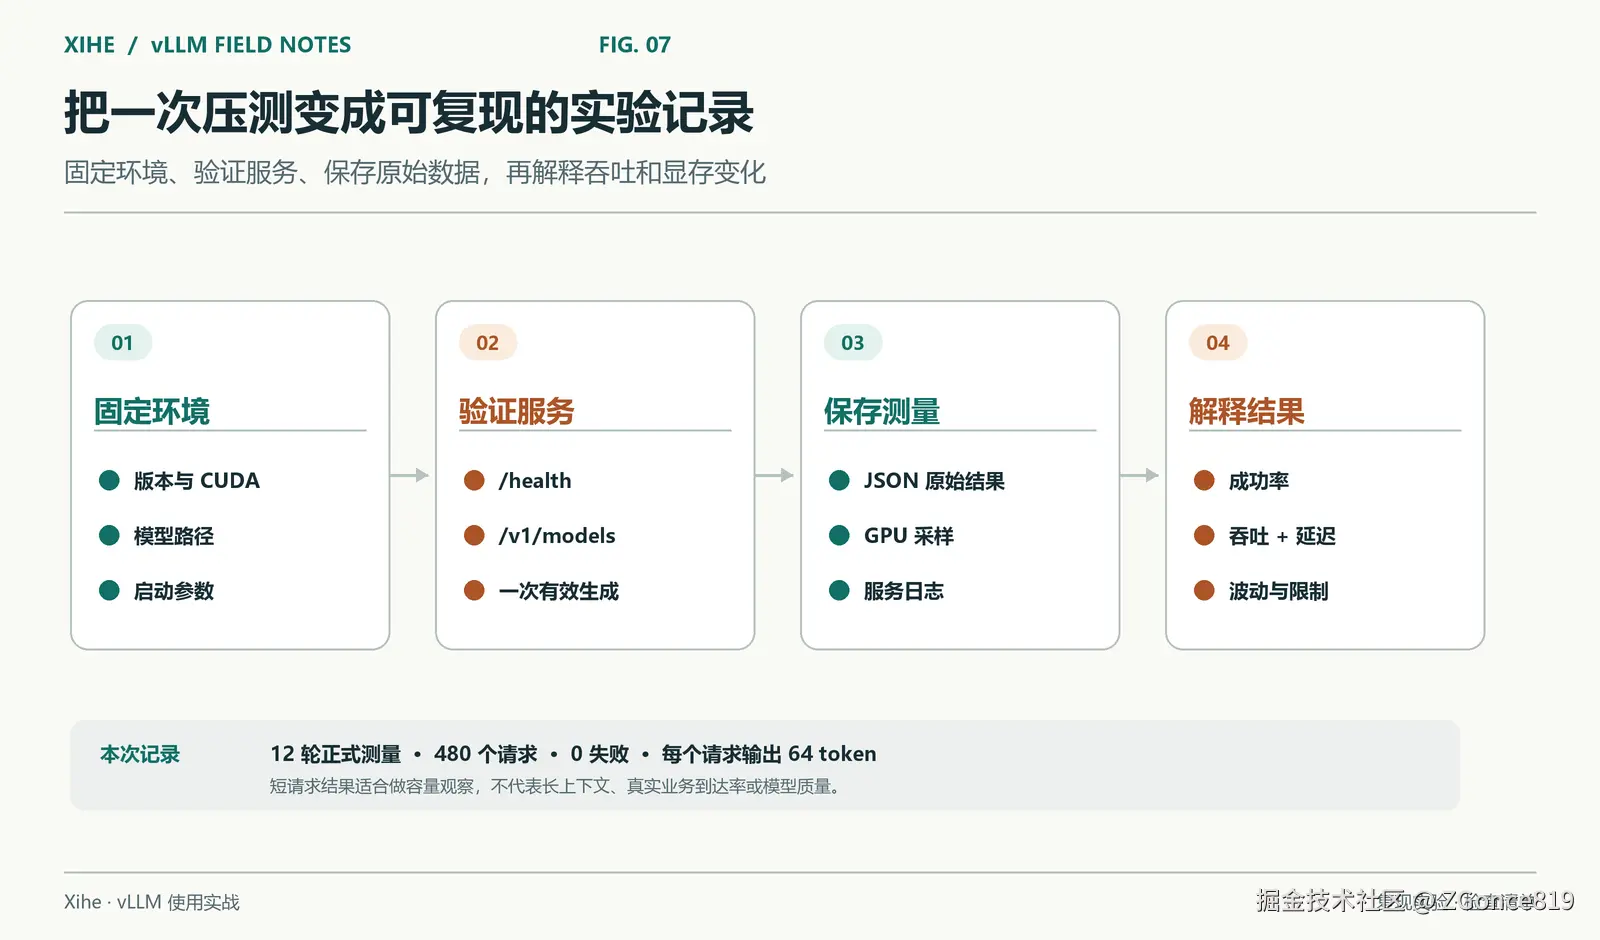
图 7:把环境、健康检查、原始数据和解释范围一起保存,才能让后续对照真正可复核。
十三、后续可以怎样继续调优
先完成可用服务和可靠基线,再一次测试一个方向:
| 方向 | 值得测试的场景 | 同时检查的代价 |
|---|---|---|
调整 max_num_seqs |
请求较多,希望提高聚合吞吐 | 排队、TTFT、尾部延迟、缓存压力 |
调整 max_num_batched_tokens |
输入长度或 Prefill 占比较高 | 调度行为、延迟与显存 |
| 调整显存预算 | 与其他应用共用 GPU | 可用缓存容量、抢占或失败情况 |
| 测试 CUDA Graph | 稳定部署后进一步降低执行开销 | 兼容性、图捕获开销和显存 |
| 测试 Prefix Caching | 大量请求具有相同的 token 前缀 | 缓存命中与真实延迟收益 |
| 测试支持的量化方案 | 权重显存成为主要瓶颈 | 精度、速度及后端兼容性 |
| 多卡并行 | 模型或负载超出单卡能力 | 通信成本、切分策略与硬件拓扑 |
这些是后续实验方向,本文没有测量它们的收益。特别是 Prefix Caching,需要设计具有重复前缀的负载,不能拿纯随机提示词的结果推断效果。
十四、整理可复现的实验材料
本次实践保留了以下文件:
text
vllm_benchmark_results/
├── serve_xihe.py                       # 启动服务并记录 PID、命令与环境配置
├── run_benchmarks.py                   # API 验证、多并发压测与整卡显存采样
├── summarize_results.py                # 校验原始数据并生成汇总
├── environment_notes.txt               # 环境、兼容处理和复现说明
├── benchmark_report.txt                # 测量结果与比较口径
├── validated_summary.json              # 结构化汇总
├── formatted_api_smoke.json             # 应用聊天模板后的请求与响应
├── dense_native_fixed_server.log        # 40% 预算服务日志
├── dense_mem20_server.log               # 20% 预算服务日志
├── dense_eager_mem40_c1_r1.json          # 示例:一轮原始压测结果
├── dense_eager_mem40_c1_r1_gpu.json      # 对应的整卡显存采样
└── flashinfer_fd_exchange.original.py   # 依赖补丁前的原文件备份
这是关键文件示例,并未列出全部结果文件。
配套脚本中的模型和 Python 路径针对本机环境;迁移到其他机器时,需要修改对应常量。未取得配套脚本的读者,可以使用本文给出的服务命令、API 示例和压测循环完成相同流程。
完成测试后,前台服务可通过 Ctrl+C 停止;后台启动时应记录 PID,确认身份后只停止本次创建的服务。本次测试结束后,服务已停止,8016 端口已确认关闭。
十五、怎样描述这次实践
与其笼统地写"掌握 vLLM,提升推理性能",更有信息量的表述是:
在 RTX 4060 Laptop 8GB / WSL2 上使用 vLLM 部署 106M Dense 模型,提供 OpenAI 兼容接口;在 BF16、输入约 128 / 输出 64 token 的负载下完成 1/2/4/8 并发压测,8 并发平均输出吞吐约 610 token/s,为单并发的 7.29 倍。对比 0.4/0.2 显存预算,KV Cache 预留由 2.91 降至 1.31 GiB;低预算下全部请求完成,8 并发平均吞吐约 563 token/s,并保留原始数据分析容量与吞吐的权衡。
这个表述明确了设备、模型、负载、对照基线和结果范围。面试或技术交流时,还应能够解释为什么聚合吞吐不等于单请求速度、为什么缓存预留不等于整卡占用,以及当前实验还缺少哪些更严格的验证。
参考资料与数据来源
- vLLM 官方文档:查询安装、模型支持、服务接口及性能配置。使用时切换到与安装版本匹配的文档。
- vLLM 官方仓库:查询版本记录和具体实现。
- PagedAttention 论文:Efficient Memory Management for Large Language Model Serving with PagedAttention:理解缓存管理与服务系统设计。
- Xihe 项目:本文自研模型的项目入口;本文测量数据来自本次本地部署产物,不代表该仓库已发布全部实验附件。
文中数值以本地 vllm_benchmark_results/ 下的原始 JSON、显存采样和服务日志为依据。官方链接用于读者继续查阅;本文命令的验证范围是文中记录的本地版本与实际执行路径。