自动化发一条内容,链路里最脆的一环往往不是平台改版,也不是登录态过期,而是你拉起来的那个 GUI 进程根本活不到发布结束。这篇文章讲一个踩了很久、代价很高的坑:Electron 发布进程被上游任务回收连坐杀掉,以及怎么用脱离进程组的方式把它托住。
一、现象:进程起来了,发布却断在半路
这个坑有两种长相,都很容易被误判成别的问题。
第一种:前台跑。 直接在终端里拉起应用,一开始全对------接口探活返回 <h1>MatrixMedia API</h1>,说明服务活着;等几分钟再探,返回连接被拒,进程没了。中间什么都没报。
第二种:丢到后台跑。 用 & 丢到后台,以为父进程退场就不影响了。结果任务被回收的那一刻,进程树一起死,发布正好做到一半被杀。翻应用自己的记录,那条 pushData 落的是「应用退出,已中断发布」。
json
{ "pt": "掘金", "publishStatus": "publishing", "lastPublishMessage": "应用退出,已中断发布" }关键判断在这里:不是 Electron 崩了,不是 puppeteer 报错,也不是登录态失效------是它被上游的「任务回收」连坐带走。分不清这一层,就会一直在错的层里排查:换浏览器参数、重装依赖、重新登录,全是白费。
二、两个根因:控制台连带和 Job 对象
2.1 根因一:控制台事件按进程组广播
Windows 上 CreateProcess 默认让子进程继承父进程的控制台 。控制台收到 CTRL_CLOSE_EVENT(窗口被关、宿主任务退场)时,这个信号是发给同一个进程组里的所有进程的,不是只发给发起方。Electron 本身是 GUI 子系统程序,但被 CLI 以控制台方式拉起之后,它还是挂在父控制台上,照样收得到。
所以 nohup + disown 这套东西救不了场------它们是 POSIX 的作业控制概念,只改 shell 自己的作业表,不改变进程在 Windows 上的 Console / Job 归属:
bash
# 看起来"脱离了",其实一点没脱:进程仍在同一个 Console 与 Job 里
nohup ./mmcli_env.cmd > /dev/null 2>&1 &
disown
2.2 根因二:Job Object 的 kill-on-close
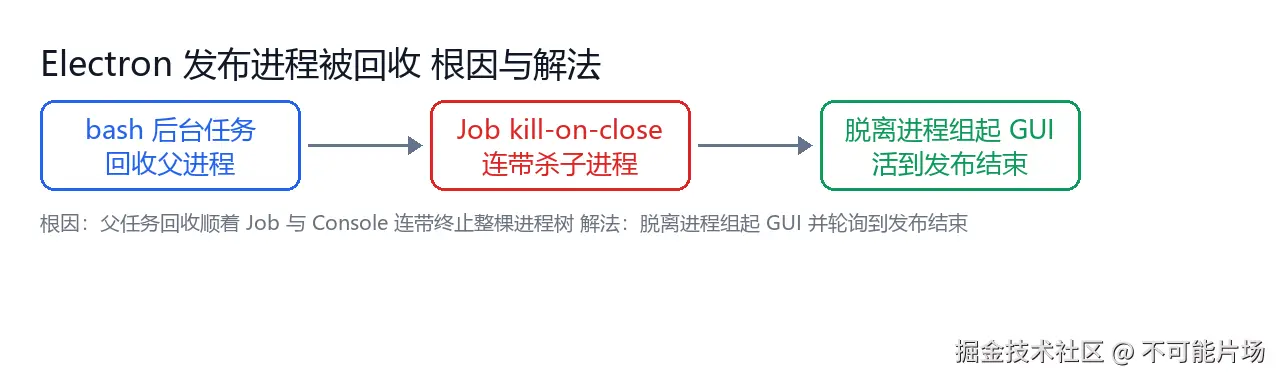
更硬的一层是 Job Object。调度器、宿主环境、IDE 常常把子进程塞进一个 Job,并设上 JOB_OBJECT_LIMIT_KILL_ON_JOB_CLOSE(0x2000)。它的语义是:Job 里最后一个句柄被关闭时,Job 内的所有进程(含孙子进程)被强制终止。
这才是「父进程一退出,GUI 子进程立刻被回收」的真正机制。注意它和「进程崩了」的区别:进程没有崩,是有人按下了一键清场,而且清的是整棵树。
要真正脱身,得用 CREATE_BREAKAWAY_FROM_JOB(0x01000000)把子进程从 Job 里摘出去。但它有个前置条件:父 Job 必须设了 JOB_OBJECT_LIMIT_BREAKAWAY_OK ,没设就直接 Access is denied------这时只能退回到「让发起方活到发布结束」这条路。
三、解法一:用脱离进程的方式起 GUI
Python 侧起进程时把三个创建标志说清楚:
python
import os, subprocess

DETACHED_PROCESS        = 0x00000008   # 不分配控制台,从根上收不到控制台关闭事件
CREATE_NEW_PROCESS_GROUP = 0x00000200  # 自成进程组,父级 Ctrl 事件打不进来
CREATE_BREAKAWAY_FROM_JOB = 0x01000000 # 父进程在 Job 里时尝试脱离(需 Job 允许)

# 必须剔除 ELECTRON_RUN_AS_NODE,否则 Electron 会退化成 node
env = {k: v for k, v in os.environ.items() if k != "ELECTRON_RUN_AS_NODE"}

p = subprocess.Popen(
    [exe],
    creationflags=DETACHED_PROCESS | CREATE_NEW_PROCESS_GROUP,
    close_fds=True,
    stdin=subprocess.DEVNULL, stdout=subprocess.DEVNULL, stderr=subprocess.DEVNULL,
    env=env,
    cwd=os.path.dirname(exe),
)
print("pid", p.pid)   # 记下 pid 就够了,别再去 wait() 它
三个标志各管一件事,别混:
| 标志 | 值 | 解决什么 |
|---|---|---|
DETACHED_PROCESS |
0x00000008 | 新进程不分配控制台,拿不到父控制台的关闭事件 |
CREATE_NEW_PROCESS_GROUP |
0x00000200 | 自成进程组,GenerateConsoleCtrlEvent 打不到它 |
CREATE_BREAKAWAY_FROM_JOB |
0x01000000 | 把子进程从父 Job 摘出去;父 Job 没开 breakaway 会报 Access denied |
还有一个必改项:env 里必须删掉 ELECTRON_RUN_AS_NODE 。宿主环境会把它带进子进程,Electron 一旦看到这个变量就退化成纯 node,启动即 Cannot find module '...\cli'。这个报错看起来像「CLI 坏了」,其实是环境变量把它的身份改了,排查方向完全跑偏。
四、解法二:让发起方活到发布结束
脱离进程只解决了「不被连坐」,没解决「谁来等结果」。发布是分钟级的长任务,一次 30~50 秒,平台弹窗多的时候更久,发起方必须先活到它结束,而且不能靠 wait() 子进程句柄来等------那个句柄一旦失效,你连它什么时候没的都不知道。
正确姿势是轮询输出文件:
python
import pathlib, time

out = pathlib.Path(r"C:\Users\molan\AppData\Local\Temp\mmcli-juejin-2026-10-14.txt")
deadline = time.time() + 300          # 给足 5 分钟
while time.time() < deadline:
    if out.exists():
        txt = out.read_text(encoding="utf-8", errors="ignore")
        if "puppeteerFile-done" in txt or "文章发布成功" in txt:
            break
    time.sleep(3)
两条硬规矩:
- 发布必须放进「自带轮询循环的常驻任务」里跑,父进程持续存活到发布结束。发完就返回的写法一定失败------父进程一退,进程树就没了,输出文件根本不会生成。
puppeteerFile-done status:true只代表提交成功,不代表真上架。落没落到平台侧要另查一遍,别把提交回执当成最终结论。
顺便说一个并发信号,很实用:如果准备发布时发现目标输出文件被别的进程占着(删不掉、报句柄冲突),说明已经有一个发布在跑了。这时候正确动作是立刻停手,而不是清文件重试------清完只会让两个实例撞同一个草稿。
五、为什么这个坑特别贵:僵记录会拦路
被杀掉留下的不只是「这次没发成」,还有一条赖着不走的僵尸记录:
- pushData 那条的状态停在
publishing,永远不翻转; - 之后所有新提交都被
isDuplicate是否存在相同的数据 true静默拒绝------不报错、不抛异常、退出码还是 0,你只会觉得「怎么今天不发了」。
恢复办法是把那条僵记录判死,队列才会重新接收提交:
json
POST /changeData
{
  "fileName": "pushData",
  "type": "update",
  "item": {
    "id": 1791234567890123,
    "date": "2026-10-14",
    "publishStatus": "failed",
    "lastPublishMessage": "应用退出,已中断发布(进程被回收)",
    "publishFailCount": 1,
    "publishSuccessCount": 0,
    "publishAbnormalCount": 0,
    "lastPublishAt": 1791999999999
  }
}
改判成 failed 之后,再做单平台重发,不要整批重来。
判定口诀 :某条 publishing 超过 10 分钟没翻 success,且主日志里完全没有对应平台的自动化日志 → 不是这个平台自己坏了,而是它前面有个平台卡住了串行的发布 worker,把队列堵死在后头了。
六、小结
把这件事收敛成一张清单:
- 前台跑 GUI 会被沙箱回收,探活通过不代表活得过几分钟。
nohup+disown治不了 Windows 的 Console / Job 连坐,别在这上面浪费时间。- 起进程用
DETACHED_PROCESS | CREATE_NEW_PROCESS_GROUP,父 Job 允许时再加CREATE_BREAKAWAY_FROM_JOB。 env里剔除ELECTRON_RUN_AS_NODE,否则 Electron 退化成 node,报错方向会完全误导你。- 发起方要活到发布结束,靠轮询输出文件判完成,不靠等进程句柄。
- 发现输出文件被占用 = 有并发发布在进行,停手,别清文件重试。
- 僵在
publishing的记录要主动判死,否则后续提交会被静默拒绝。
「进程没崩」不等于「进程还在」。在一个会被回收的宿主里做自动化,进程生命周期和业务逻辑一样是必修课------它出问题的时候不报错,只是安静地把你的发布做掉一半。