目录
- [1. 创建一个正则表达式](#1. 创建一个正则表达式)
- [2. 编写一个正则表达式的模式](#2. 编写一个正则表达式的模式)
-
- [2.1 使用简单模式](#2.1 使用简单模式)
- [2.2 使用特殊字符(很复杂,这里面应该还有些很奇怪的坑)](#2.2 使用特殊字符(很复杂,这里面应该还有些很奇怪的坑))
- [2.3 转义](#2.3 转义)
- [2.4 使用插入语](#2.4 使用插入语)
- [3. 使用正则表达式](#3. 使用正则表达式)
-
- [3.1 使用括号的子字符串匹配](#3.1 使用括号的子字符串匹配)
- [3.2 通过标志进行高级搜索](#3.2 通过标志进行高级搜索)
- [4. 示例](#4. 示例)
-
- [4.1 改变输入字符串的顺序](#4.1 改变输入字符串的顺序)
- [4.2 用特殊字符检验输入](#4.2 用特殊字符检验输入)
- 参考
- 待了解
1. 创建一个正则表达式
可以使用以下两种方式构建一个正则表达式:
使用一个正则表达式字面量,其由包含在斜杠之间的模式组成,如下所示:
javascript
let re = /ab+c/;脚本加载后,正则表达式字面量就会被编译。当正则表达式保持不变时,使用此方法可获得更好的性能。
或者调用RegExp对象的构造函数,如下所示:
javascript
let re = new RegExp("ab+c");在脚本运行过程中,用构造函数创建的正则表达式会被编译。如果正则表达式将会改变,或者它将从用户输入等来源中动态地产生,就需要使用构造函数来创建正则表达式。
2. 编写一个正则表达式的模式
一个正则表达式模式是由简单的字符所构成的,比如/abc/;或者是简单和特殊字符的组合,比如/ab*c/或/Chapter (\d+).\d*/。最后的例子中用到了括号,它在正则表达式中常用作记忆设备。即这部分所匹配的字符将会被记住以备后续使用,例如使用括号的子字符串匹配。
2.1 使用简单模式
简单模式是由你想直接找到的字符构成。比如,/abc/这个模式就能且仅能匹配"abc"字符按照顺序同时出现的情况。例如在"Hi, do you know your abc's?"和"The latest airplane designs evolved from slabcraft."中会匹配成功。在上述两个例子中,匹配的子字符串是"abc"。但是在"Grab crab"中会匹配失败,因为它虽然包含字符串"ab c",但并不是准确的"abc"。
2.2 使用特殊字符(很复杂,这里面应该还有些很奇怪的坑)
当你需要匹配一个不确定的字符串时,比如寻找一个或多个"b",或者寻找空格,可以在模式中使用特殊字符。比如,你可以使用/ab*c/去匹配一个单独的"a"后面跟了零个或多个"b",同时后面跟着"c"的字符串;*的意思是前一项出现零次或多次。在字符串"cbbabbbbcdebc"中,这个模式匹配了子字符串"abbbbc"。
| 字符 | 含义 |
|---|---|
| \ | 在非特殊字符之前的反斜杠表示一个字符是特殊字符,不能按照字面理解。\b表示一个字符边界。 在特殊字符之前的反斜杠表示下一个字符不是特殊字符,应该按照字面理解。这部分是转义。 如果你想将字符串传递给RegExp构造函数,不要忘记在字符串字面量中反斜杠是转义字符。所以为了在模式中添加一个反斜杠,你需要在字符串字面量中转义它。/a-z\s/i和new RegExp("a-z\\s", "i")创建了相同的正则表达式:一个用于搜索后面紧跟着空白字符并且在a-z范围内的任意字符的表达式。为了通过字符串字面量给RegExp构造函数创建包含反斜杠的表达式,你需要在字符串级别和正则表达式级别都对它进行转义。例如/a-z:\\/i和new RegExp("a-z:\\\\", "i")会创建相同的表达式,即匹配类似"C:\"字符串 |
| ^ | 匹配输入的开始。如果多行标志被设置为true,那么也匹配换行符后紧跟的位置。 例如,/^A/并不会匹配"an A"中的'A',但是会匹配"An E"中的'A'。 当^作为第一个字符出现在一个字符集合模式时,它将会有不同的含义。 |
| $ | 匹配输入的结束。如果多行标志被设置为true,那么也匹配换行符前的位置。 例如,/t$/并不会匹配"eater"中的't',但会匹配"eat"中的't'。 |
| * | 匹配前一个表达式零次或多次。等价于{0, }。 例如,/bo*/会匹配"A ghost boooooed"中的'booooo'和"A bird warbled"和'b',但是在"A goat grunted"中不会匹配任何内容。 |
| + | 匹配前面一个表达式一次或者多次。等价于{1, }。 例如,/a+/会匹配"candy"的'a'和"caaaaaaaaandy"中所有的'a',但是在"cndy"中不会匹配任何内容。 |
| ? | 匹配前面一个表达式零次或一次。等价于{0, 1}。 例如,/e?le?/匹配"angel"中的'el'、"angle"中的'le'以及"oslo"中的'l'。 如果紧跟在任何量词*、+、?或{}的后面,将会使量词变为非贪婪匹配(匹配尽量少的字符),和缺省使用的贪婪模式(匹配尽可能多的字符)正好相反。例如,对"123abc"使用/\d+/将会匹配"123",而使用/\d+?/则只会匹配到"1"。 |
| . | 默认匹配除换行符之外的任何单个字符。 例如,/.n/将会匹配"nay, an apple is on the tree"的'an'和'on',但不会匹配'nay'。 如果s(dotAll)标志位被设为true,它也会匹配换行符。 |
| (x) | 像下面的例子展示的那样,它会匹配'x'并且记住匹配项。其中括号被称为捕获括号。 模式/(foo) (bar) \1 \2/中的'(foo)'和'(bar)'匹配会记住字符串"foo bar foo bar"中前两个单词。模式中的\1和\2表示第一个和第二个被捕获括号匹配的子字符串,即foo和bar,匹配了原字符串中的后两个单词。注意\1、\2、...、\n是用在正则表达式的匹配环节。而在正则表达式的替换环节,则要使用像1、2、...、这样的语法,例如'bar foo'.replace(/(...) (...)/, '2 1')。&表示整个用于匹配的原字符串。 |
| (?:x) | 匹配'x'但是不记住匹配项。这种括号叫做非捕获括号,使得你能够定义与正则表达式运算符一起使用的子表达式。如果表达式是/foo{1, 2}/,{1, 2}将只应用于'foo'的最后一个字符'o'。如果表达式是/(?:foo){1, 2}/,则{1, 2}会应用于整个'foo'单词。 |
| x(?=y) | 匹配'x'仅仅当'x'后面跟'y',这种叫做先行断言。 例如,/Jack(?=Sprat)/会匹配到'Jack'仅当它后面跟着'Spart'。/Jack(?=Sprat|Frost)/匹配'Jack'仅当它后面跟着'Sprat'或者是'Frost'。但是'Sprat'和'Frost'都不是匹配结果的一部分。 |
| (?<=y)x | 匹配'x'仅当'x'前面是'y',这种叫做后行断言。 例如,/(?<=Jack)Sprat/会匹配'Sprat'仅仅当它前面是'Jack'。/(?<=Jack|Tom)Sprat/匹配'Sprat'仅仅当它前面是'Jack'或者是'Tom'。但是'Jack'和'Tom'都不是匹配结果的一部分。 |
| x(?!y) | 仅仅当'x'后面不跟着'y'时匹配'x',这被称为正向否定查找。 例如,仅仅当这个数字后面没有跟小数点的时候,/\d+(?!\.)匹配一个数字。正则表达式/\d+(?!\.).exec("3.141")匹配'141'而不是'3.141'。 |
| (?<!y)x | 仅仅当'x'前面不是'y'时匹配'x',这被称为反向否定查找。 例如,仅仅当这个数字前面没有负号的时候,/(?<!-)\d+/匹配一个数字。 /(?<!-)\d+/.exec('3')匹配到'3'。 /(?<!-)\d+/.exec('-3')因为这个数字前有负号,所以没有匹配到。 |
| x|y | 匹配'x'或'y'。 例如,/green|red/匹配"green apple"中的'green'和"red apple"中的'red'。 |
| {n} | n是一个正整数,匹配了前面一个字符刚好出现了n次。 比如,/a{2}/不会匹配"candy"中的'a',但是会匹配"caandy"中的所有的a,以及"caaandy"中的前两个'a'。 |
| {n, } | n是一个正整数,匹配前一个字符至少出现了n次。 例如,/a{2, }/匹配"aa","aaaa"和"aaaaa"但是不匹配"a"。 |
| {n, m} | n和m都是整数。匹配前面的字符至少n次,最多m次。如果n或者m的值是0,这个值被忽略。 例如,/a{1, 3}/并不匹配"cndy"中的任意字符,匹配"candy"中的a,匹配"caandy"中的前两个a,也匹配"caaaaaaandy"中的前三个a。 |
| xyz | 一个字符集合。匹配方括号中的任意字符,包括转义序列。你可以使用破折号来指定一个字符范围。对于点和星号这样的特殊符号在一个字符集中没有特殊的意义。它们不必进行转义,不过转义也是起作用的。 例如,abcd和a-d是一样的。它们都匹配"brisket"的'b',也都匹配"city"中的'c'。/a-z.+/和/\\w.+/与字符串"test.i.ng"匹配。 |
| \^xyz | 一个反向字符集。也就是说,它匹配任何没有包含在方括号中的字符。你可以使用破折号来指定一个字符范围。任何普通字符在这里都是起作用的。 例如,\^abc和\^a-c是一样的。它们匹配"brisket"中的'r',也匹配"chop"中的'h'。 |
| \\b | 匹配一个退格(U+0008)。 |
| \b | 匹配一个词的边界。一个词的边界就是一个词不被另外一个"字"字符跟随的位置或者前面跟其他"字"字符的位置,例如在字母和空格之间。注意,匹配中不包括匹配的字边界。换句话说,一个匹配的词的边界的内容的长度是0。 /\bm/匹配"moon"中的'm'。 /oo\b/并不匹配"moon"中的'oo',因为'oo'被一个"字"字符'n'紧跟着。 /oon\b/匹配"moon"中的'oon',因为'oon'是这个字符串的结束部分。它没有被一个"字"字符紧跟着。 JavaScript的正则表达式引擎将特定的字符集定义为"字"字符,不在该集合中的任何字符都被认为是一个断词。这组字符相当有限:它只包括大写和小写的罗马字母,十进制数字和下划线字符。 |
| \B(匹配的是字符间的位置) | 匹配一个非单词边界。匹配如下几种情况: 字符串第一个字符为非"字"字符 字符串最后一个字符为非"字"字符 两个单词字符之间 两个非单词字符之间 空字符串 /\B.../匹配"^test"中的'^t',/\b.../匹配"^test"中的'te'。 /\B.../匹配"noonday"中的'oo',/y\B.../匹配"possibly yesterday"中的'yes'。 |
| \cX | 当X是处于A到Z之间的字符的时候,匹配字符串中的一个控制符。 例如,/\cM/匹配字符串中的control-M(U+00D) |
| \d | 匹配一个数字,等价于0-9。 例如,/\d/或者/0-9/匹配"B2 is the suite number."中的'2'。 |
| \D | 匹配一个非数字字符,等价于\^0-9。 例如,/\D/或者/\^0-9/匹配"B2 is the suite number."中的'B'。 |
| \f | 匹配一个换页符(U+000C) |
| \n | 匹配一个换行符(U+000A) |
| \r | 匹配一个回车符(U+000D) |
| \s | 匹配一个空白字符,包括空格、制表符、换页符和换行符。等价于\\f\\n\\r\\t\\v\\u0020\\u00a0\\u1680\\u180e\\u2000-\\u200a\\u2028\\u2029\\u202f\\u205f\\u3000\\ufeff。 例如,/\s\w*/匹配"foo bar."中的' bar'。 在edge中,\s不匹配\u180e。 |
| \S | 匹配一个非空白字符。等价于\^\\f\\n\\r\\t\\v\\u0020\\u00a0\\u1680\\u180e\\u2000-\\u200a\\u2028\\u2029\\u202f\\u205f\\u3000\\ufef。 例如,/\S\w*/匹配"foo bar."中的'foo'。 在edge中,\S匹配\u180e。 |
| \t | 匹配一个水平制表符(U+0009) |
| \v | 匹配一个垂直制表符(U+000B) |
| \w | 匹配一个单字字符(字母、数字或者下划线)。等价于A-Za-z0-9_。 例如,/\w/匹配"apple,"中的'a',"$5.28,"中的'5'和"3D."中的'3'。 |
| \W | 匹配一个非单字字符。等价于\^A-Za-z0-9_。 例如,/\W/或者/\^A-Za-z0-9_/匹配"50%."中的'%'。 |
| \n | 在正则表达式中,它返回第n个子捕获匹配的子字符串。 比如,/apple(,)\sorange\1/匹配"apple, orange, cherry, peach."中的'apple, orange,'。 |
| \0 | 匹配NULL(U+0000)字符,不要在这后面跟其他小数。 |
| \xhh | 匹配一个两位十六进制数(\x00-\xFF)表示的字符 |
| \uhhhh | 匹配一个四位十六进制数表示的UTF-16代码单元。 |
| \u{hhhh}或\u{hhhhh} | 仅当设置了u标志时,匹配一个十六进制数表示的Unicode字符。 |
2.3 转义
如果你需要使用任何特殊字符的字面值,,你必须通过在它前面放一个反斜杠来转义它。例如,要搜索'a'后跟'*'后跟'b',你应该使用/a\*b/------反斜杠转义字符*,使其成为文字而非特殊符号。
类似地,如果你正在编写正则表达式文字并且需要匹配斜杠,那么需要转义它。例如,要搜索字符串"/example/"后跟一个或多个字母字符,你需要使用//example/a-z+/i------每个斜杠之前使用反斜杠使它们成为普通字符。
要匹配文本符号反斜杠,你需要转义反斜杠。例如,要匹配字符串"C:",其中"C"可以使任何字母,你将使用/A-Z:\\/------第一个反斜杠转义后面的那个反斜杠,因此表达式搜索单个普通字符反斜杠。
如果将RegExp构造函数与字符串文字一起使用,请记住反斜杠使字符串文字中的转义,因此要在正则表达式中使用,你需要在字符串文字级别转义它。/a*b/和new RegExp("a\*b")创建的表达式是相同的,搜索"a"后跟文字"*"后跟"b"。
将用户输入转义为正则表达式中的一个字面字符串,可以通过简单的替换来实现:
javascript
function escapeRegExp(string) {
	return string.replace(/[.*+?${}()|[\]\\]/g, "\\$&");
	// $&表示整个被匹配的字符串
}
正则表达式后的"g"是一个表示全局搜索选项或标记,将在整个字符串查找并返回所有匹配结果。
2.4 使用插入语
任何正则表达式的插入语都会使这部分匹配的副字符串被记忆。一旦被记忆,这个副字符串就可以被调用于其他用途,如同使用括号的子字符串匹配之中所述。
比如,/Chapter (\d+).\d*/解释了额外转义的和特殊的字符,并说明了这部分模式应该被记忆。它精确地匹配后面跟一个以上数字字符的字符'Chapter ',跟着一个小数点,跟着任何数字字符0以上。另外,插入语也用来记忆第一个匹配的数字字符。
此模式可以匹配字符串"Open Chapter 4.3, paragraph 6",并且4将会被记住。此模式并不能匹配"Chapter 3 and 4",因为在这个字符串中'3'的后面没有点号'.'。
括号中的"?:",这种模式匹配的子字符串将不会被记住。比如,(?:\d+)匹配一次或多次数字字符,但是不能记住匹配的字符。
3. 使用正则表达式
正则表达式可以被用于RegExp的exec和test方法以及String的match、replace、search和split方法。这些方法在JavaScript手册中有详细的解释。
| 方法 | 描述 |
|---|---|
| exec | 一个在字符串中执行查找匹配的RegExp方法,它返回一个数组(未匹配则返回null |
| test | 一个在字符串中测试是否匹配的RegExp方法,它返回true或false |
| match | 一个在字符串中执行查找匹配的String方法,它返回一个数组,在未匹配到时会返回null |
| matchAll | 一个在字符串中执行查找所有匹配的String方法,它返回一个迭代器 |
| search | 一个在字符串中测试匹配的String方法,它返回匹配到的位置索引,或者在失败时返回-1 |
| replace | 一个在字符串中执行查找匹配的string方法,并且使用替换字符串替换掉匹配到的子字符串 |
| split | 一个使用正则表达式或者一个固定字符串分隔一个字符串,并将分隔后的子字符串存储到数组中的String方法 |
javascript
let myRe = /d(b+)d/g;
let myArray = myRe.exec("cdbbdbbsbz");
console.log(myArray);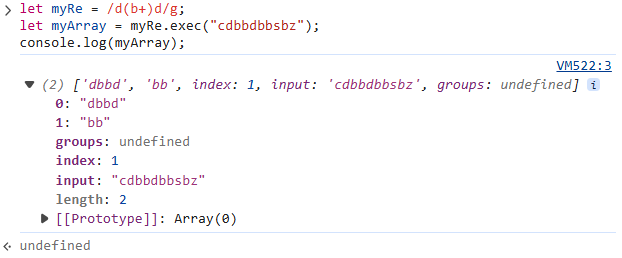
如果你不需要访问正则表达式的属性,可以这样:
javascript
let myArray = /d(b+)d/g.exec("cdbbdbsbz");如果你想要通过一个字符串构建正则表达式,可以这样:
javascript
let myRe = new RegExp("d(b+)d", "g");
let myArray = myRe.exec("cdbbdbsbz");
通过这些脚本,匹配成功后将返回一个数组并且更新正则表达式的属性,如下所示。
| 对象 | 属性或索引 | 描述 | 在这个例子中对应的值 |
| myArray | | 匹配到的字符串和所有被记住的子字符串 | "dbbd", "bb" |
| myArray |
| myArray |
| myArray |
|---------|------------------------|--------------------|------------------|
| index | 在输入的字符串中匹配到的以0开始的索引值 | 1 |
| input | 初始字符串 | "cdbbdbsbz" |
| 0 | 最近一个匹配到的字符串 | "dbbd" |
| source | 模式字面文本。在正则表达式创建时更新,不执行 | "d(b+)d" |
正如上面的第二种形式所示,你可以使用对象初始化器创建一个正则表达式实例,但不分配给变量。如果你这样做,那么,每一次使用都会创建一个新的正则表达式实例。因此,如果你不把正则表达式实例分配给一个变量,你以后将不能访问这个正则表达式实例的属性。
javascript
let myRe = /d(b+)d/g;
let myArray = myRe.exec("cdbbdbsbz");
console.log("The value of lastIndex is " + myRe.lastIndex);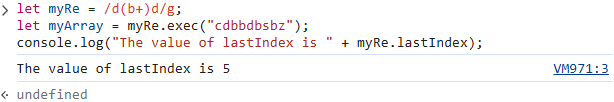
javascript
let myArray = /d(b+)d/g.exec("cdbbdbsbz");
console.log("The value of lastIndex is " + /d(b+)d/g.lastIndex);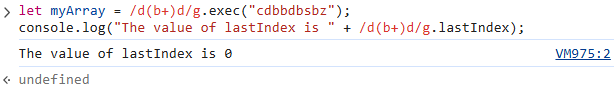
当发生/d(b+)d/g使用两个不同状态的正则表达式对象,lastIndex属性会得到不同的值。如果需要访问一个正则表达式的属性,则需要创建一个对象初始化生成器,你应该首先把它赋值给一个变量。
3.1 使用括号的子字符串匹配
一个正则表达式模式使用括号,将导致相应的子匹配被记住。例如,/a(b)c/可以匹配字符串"abc",并且记得"b"。回调这些括号中匹配的子串,使用数组元素1,......n。
使用括号匹配的子字符串的数量是无限的。返回的数组中保存所有被发现的子匹配。下面的例子说明了如何使用括号的子字符串匹配。
下面的脚本使用replace()方法来转换字符串中的单词。在匹配到的替换文本中,脚本使用替代的1、2表示第一个和第二个括号的子字符串匹配。
javascript
let re = /(\w+)\s(\w+)/;
let str = "John Smith";
let newstr = str.replace(re, "$2, $1");
console.log(newstr);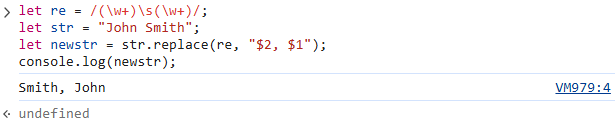
3.2 通过标志进行高级搜索
正则表达式有六个可选参数允许全局和不分大小写搜索。这些参数既可以单独使用,也能以任意顺序一起使用,并且被包含在正则表达式实例中。
| 标志 | 描述 |
|---|---|
| g | 全局搜索 |
| i | 不区分大小写搜索 |
| m | 多行搜索 |
| s | 允许.匹配换行符 |
| u | 使用unicode码的模式进行匹配 |
| y | 执行粘性搜索,匹配从目标字符串的当前位置开始 |
为了在正则表达式中包含标志,请使用以下语法:
javascript
let re = /pattern/flags;或者
javascript
let re = new RegExp("pattern", "flags");值得注意的是,标志是一个正则表达式的一部分,它们在接下来的时间将不能添加或删除。
例如,re = /\w+\s/g将创建一个查找一个或多个字符后有一个空白字符的正则表达式,或者组合起来像此要求的字符串。
javascript
let re = /\w+\s/g;
let str = "fee fi fo fum";
let myArray = str.match(re);
console.log(myArray);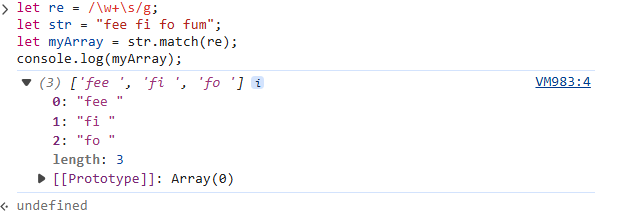
上面的例子中可以把re替换为:
javascript
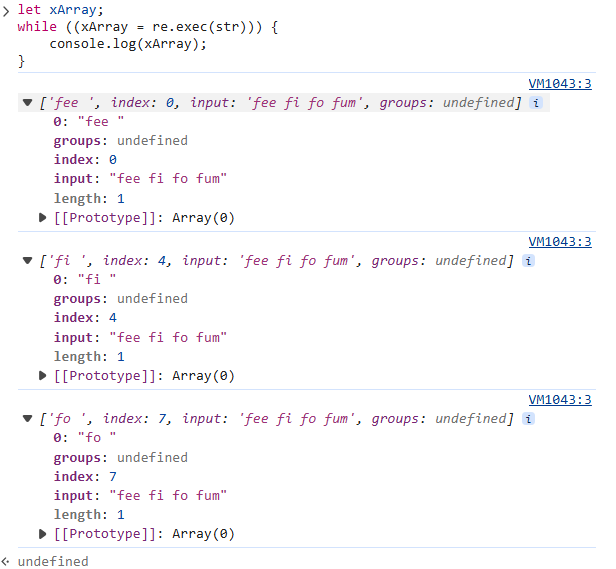
let re = new RegExp("\\w+\\s", "g");在使用.exec()方法时,与g标志关联的行为是不同的。对比str.match(re)与re.exec(str),g标志与.exec()方法一起使用获得迭代进展。
javascript
let xArray;
while ((xArray = re.exec(str))) {
	console.log(xArray);
}
m标志用于指定多行输入字符串应该被视为多个行。如果使用m标志,^和$匹配的开始或结束输入字符串的每一行,而不是整个字符串的开始或结束。
4. 示例
4.1 改变输入字符串的顺序
下面的例子会整理一个只有粗略格式的含有全名(名字首先出现)的输入字符串,这个字符串被空格、换行符和一个分号分隔。最终,它会颠倒名字顺序(姓氏首先出现)和list的类型。
javascript
let names = "Orange Trump ;Fred Barney; Helen Rigby ; Bill Abel ; 	Chris Hand ";
let output = ["---------- Original String\n", names + "\n"];
let pattern = /\s*;\s*/;
let nameList = names.split(pattern);
pattern = /(\w+)\s+(\w+)/;
let bySurnameList = [];
output.push("---------- After Split by Regular Expression");
let i, len;
for (i = 0, len = nameList.length; i < len; i++) {
	output.push(nameList[i]);
	bySurnameList[i] = nameList[i].replace(pattern, "$2, $1");
}

output.push("---------- Names Reversed");
for (i = 0, len = bySurnameList.length; i < len; i++) {
	output.push(bySurnameList[i]);
}

bySurnameList.sort();
output.push("---------- Sorted");
for (i = 0, len = bySurnameList.length; i < len; i++) {
	output.push(bySurnameList[i]);
}
output.push("---------- End");
console.log(output.join("\n"));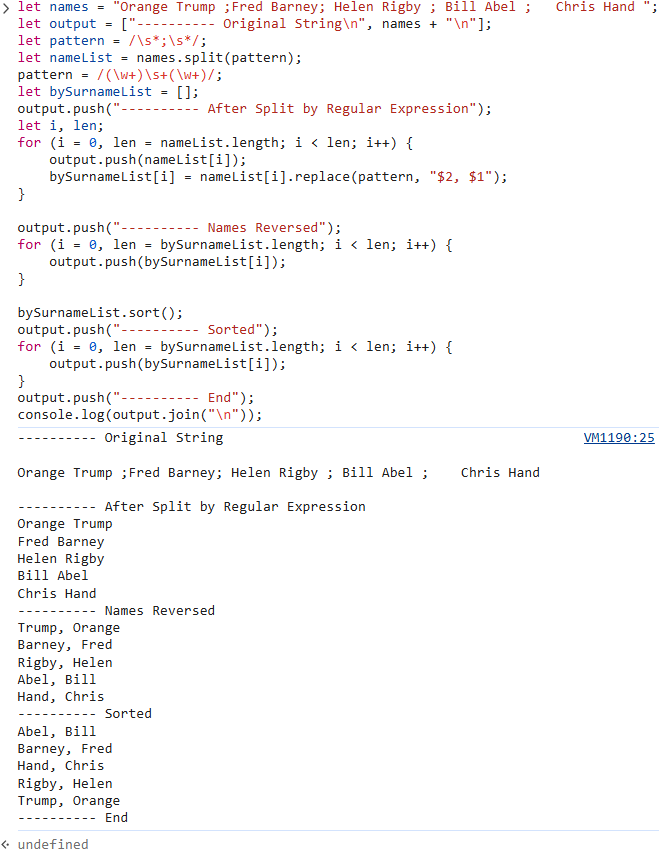
4.2 用特殊字符检验输入
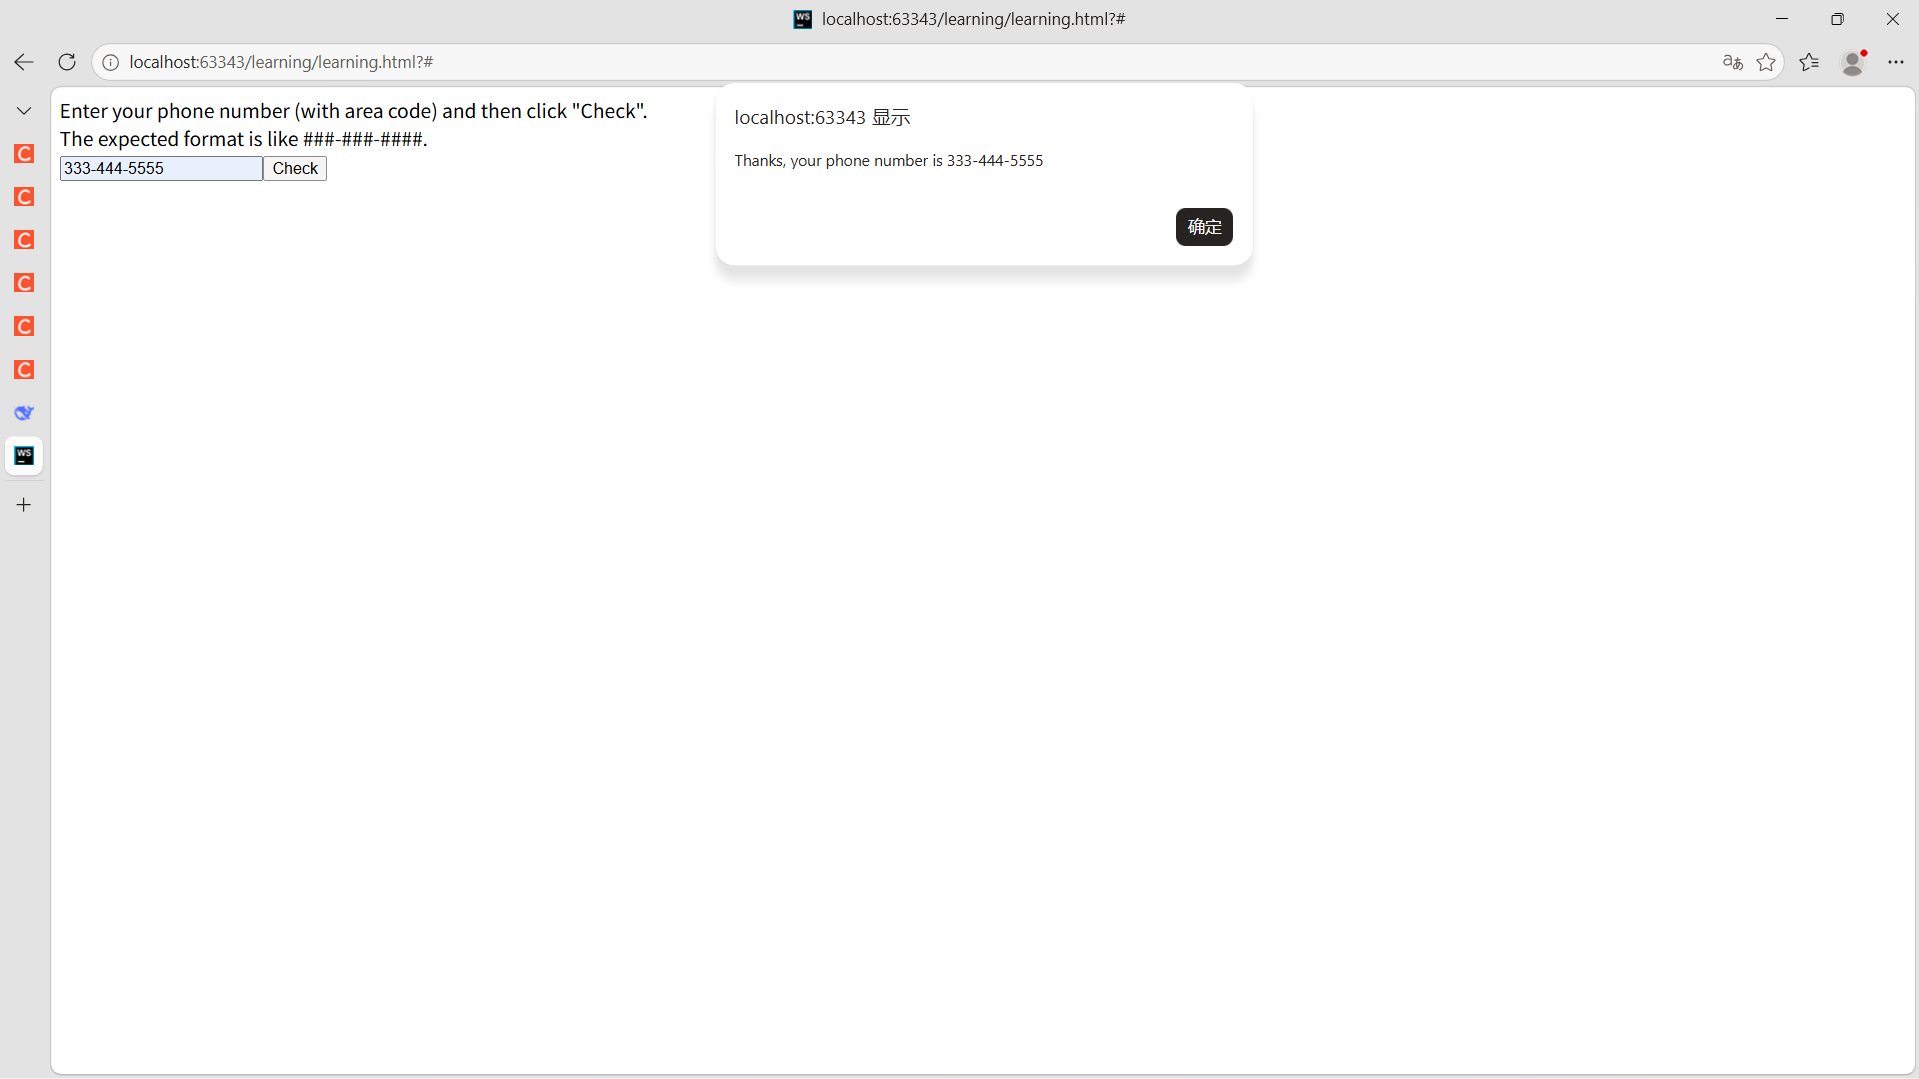
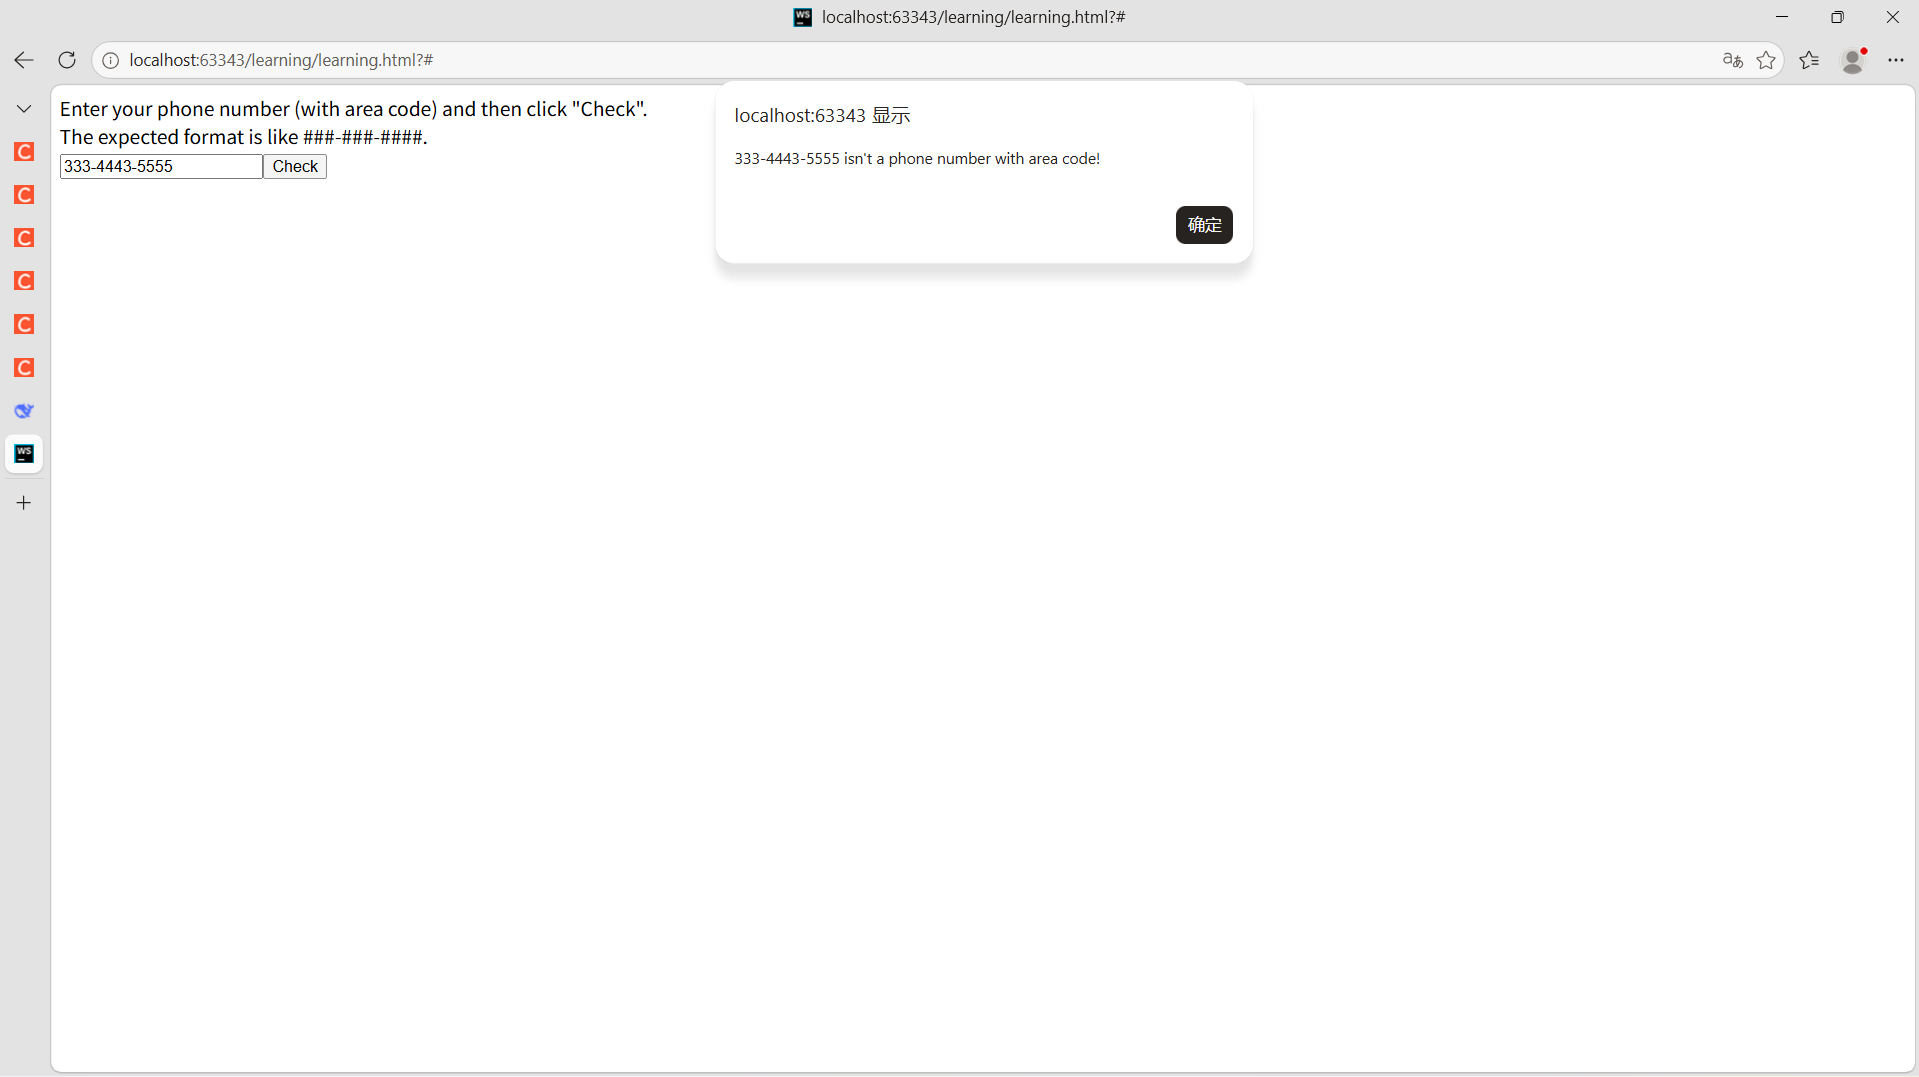
在以下例子中,我们期望用户输入一个点号号码。当用户点击Check按钮,我们的脚本开始检查这些数字是否合法。如果数字合法,脚本显示一条感谢用户的信息并确认该数字。如果这串数字不合法,脚本提示用户电话号码不合法。
包含非捕获括号(?:这个正则表达式寻找三个数字字符\d{3}或者|一个左半括号(跟着三个数字\d{3},跟着一个封闭括号),结束非捕获括号),后跟一个短破折号或正斜杠或小数点,随后跟随三个数字字符,当记忆字符(-/.)捕获并记住,后面跟着三位小数\d{3},再后面跟随记住的破折号、正斜杠或小数点\1,最后跟着四位小数\d{4}。
当用户按下Enter设置RegExp.input,这些变化也能被激活。
html
<!doctype html>
<html lang="en-US">
<head>
    <meta http-equiv="Content-Type" content="text/html;charaset=ISO-8859-1" />
    <meta http-equiv="Content-Type" content="text/javascript" />
    <script type="text/javascript">
        let re = /(?:\d{3}|\(\d{3}\))([-\/.])\d{3}\1\d{4}/;
        function testInfo(phoneInput) {
            let OK = re.exec(phoneInput.value);
            if (!OK) {
                window.alert(
                    phoneInput.value + " isn't a phone number with area code!",
                );
            } else {
                window.alert("Thanks, your phone number is " + OK[0]);
            }
        }
    </script>
    <title></title>
</head>
<body>
<form action="#">
    <label for="phone">
        Enter your phone number (with area code) and then click "Check". <br />
        The expected format is like ###-###-####.
    </label><br />
    <input id="phone" /><button onclick="testInfo(document.getElementById('phone'));">
    Check
</button>
</form>
</body>
</html>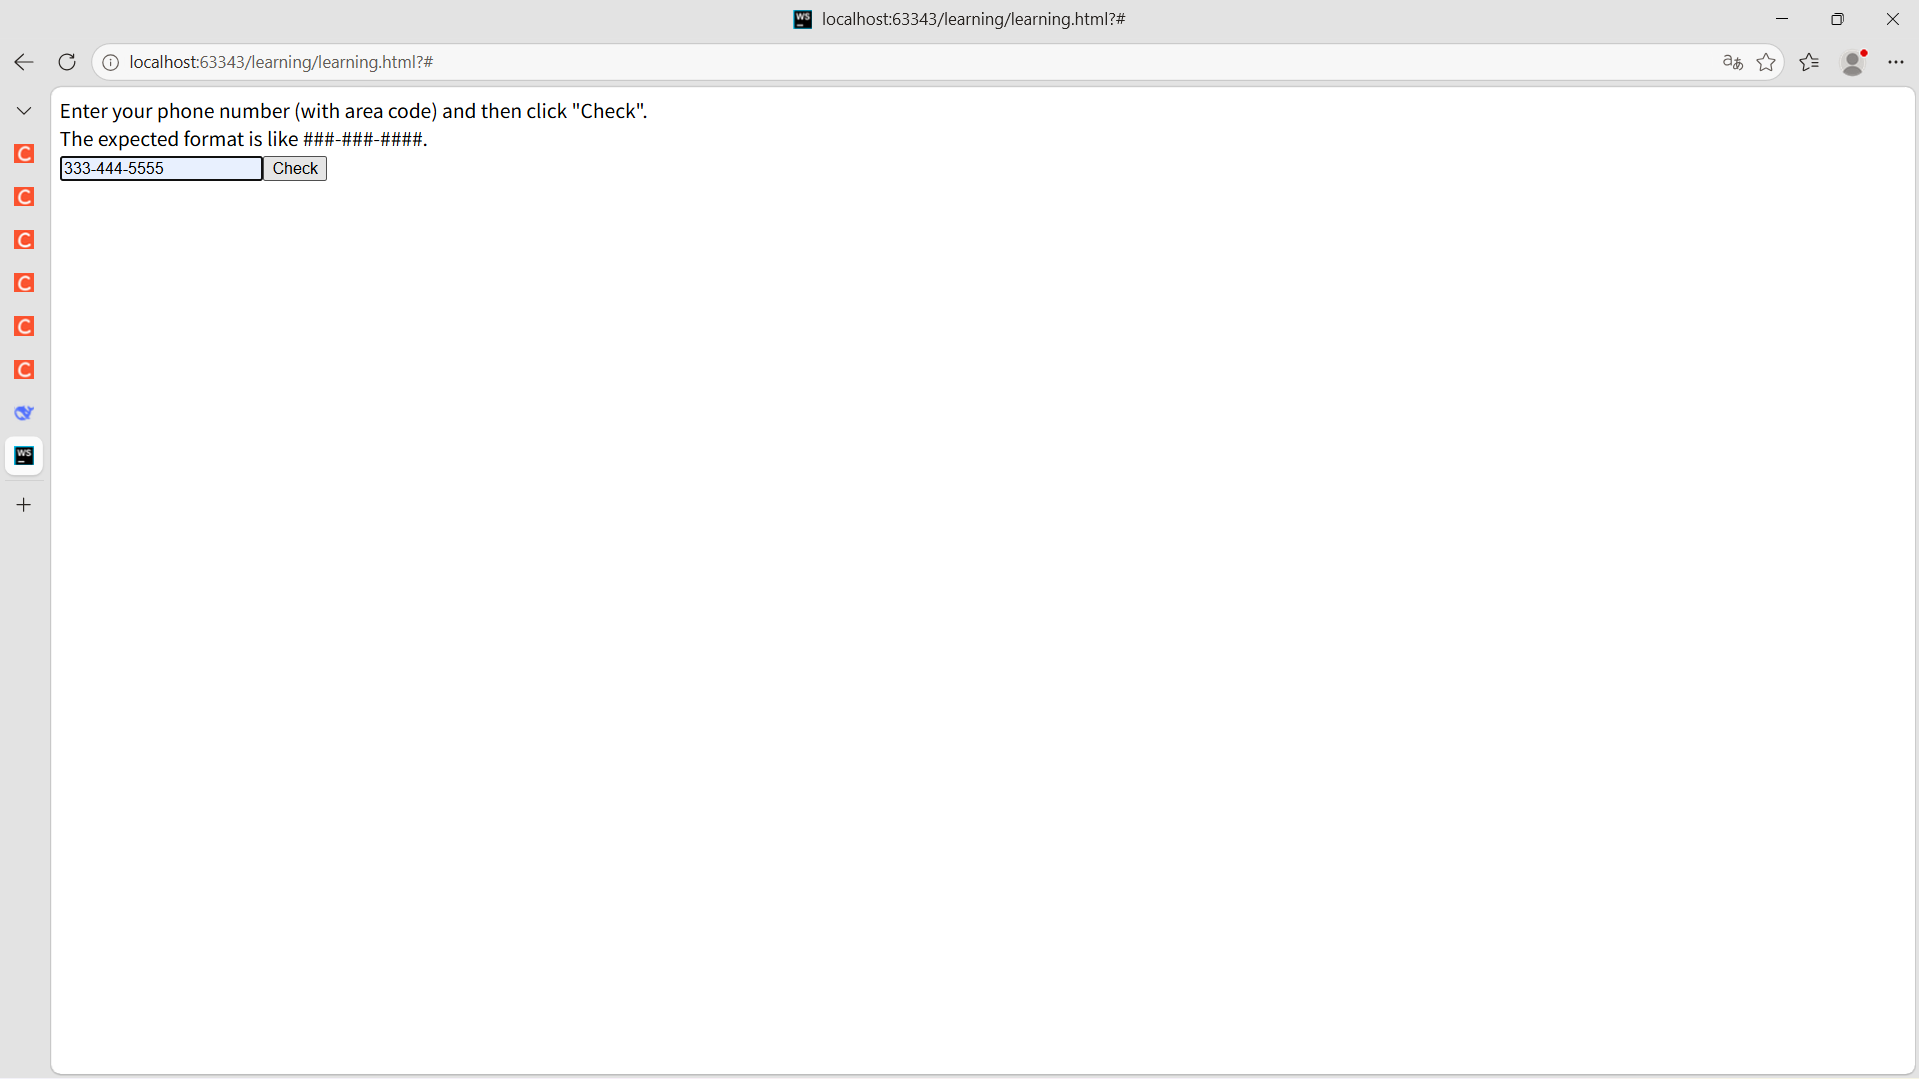
参考
1、正则表达式
待了解
1、断言
2、字符类
3、组和反向引用
4、量词