近期,阿里云人工智能平台PAI的多篇论文在EMNLP 2026上入选。EMNLP是自然语言处理领域的顶级国际会议,聚焦于自然语言处理技术在各个应用场景的学术研究,尤其重视自然语言处理的实证研究。该会议曾推动了预训练语言模型、文本挖掘、对话系统、机器翻译等自然语言处理领域的核心创新,在学术和工业界都有巨大的影响力。此次入选标志着阿里云人工智能平台PAI在自然语言处理、多模态推理与智能体等前沿方向的研究持续获得学术界认可。
论文简述
面向多模态推理模型的规模化蒸馏管线
多模态大模型(MLLM)在视觉语言任务上展现了强大的链式思维(CoT)推理能力,但其庞大的参数规模和推理延迟制约了在线部署。小模型更适合实际服务场景,却受限于缺乏大规模、高质量的多模态CoT监督数据。为此,本工作提出OmniThoughtVis:一套可扩展的数据构建与蒸馏管线,将高能力教师模型的推理能力迁移至更小的多模态模型。该管线从多样化开源种子池出发,生成结构化CoT轨迹,并对每条样本联合标注推理难度、答案质量与语义任务标签;通过规则过滤、难度感知筛选与基于标签的多样性采样,构建出180万条样本的精炼语料库。在九个多模态推理基准上,基于该语料蒸馏的Qwen3-VL(2B至8B)模型在各规模上均取得稳定提升,其中4B模型在MathVerse上提升16.8分、在MMMU-Pro上提升5.6分,并在多项任务上追平甚至超越未蒸馏的8B基线,展现出良好的质量-效率权衡。
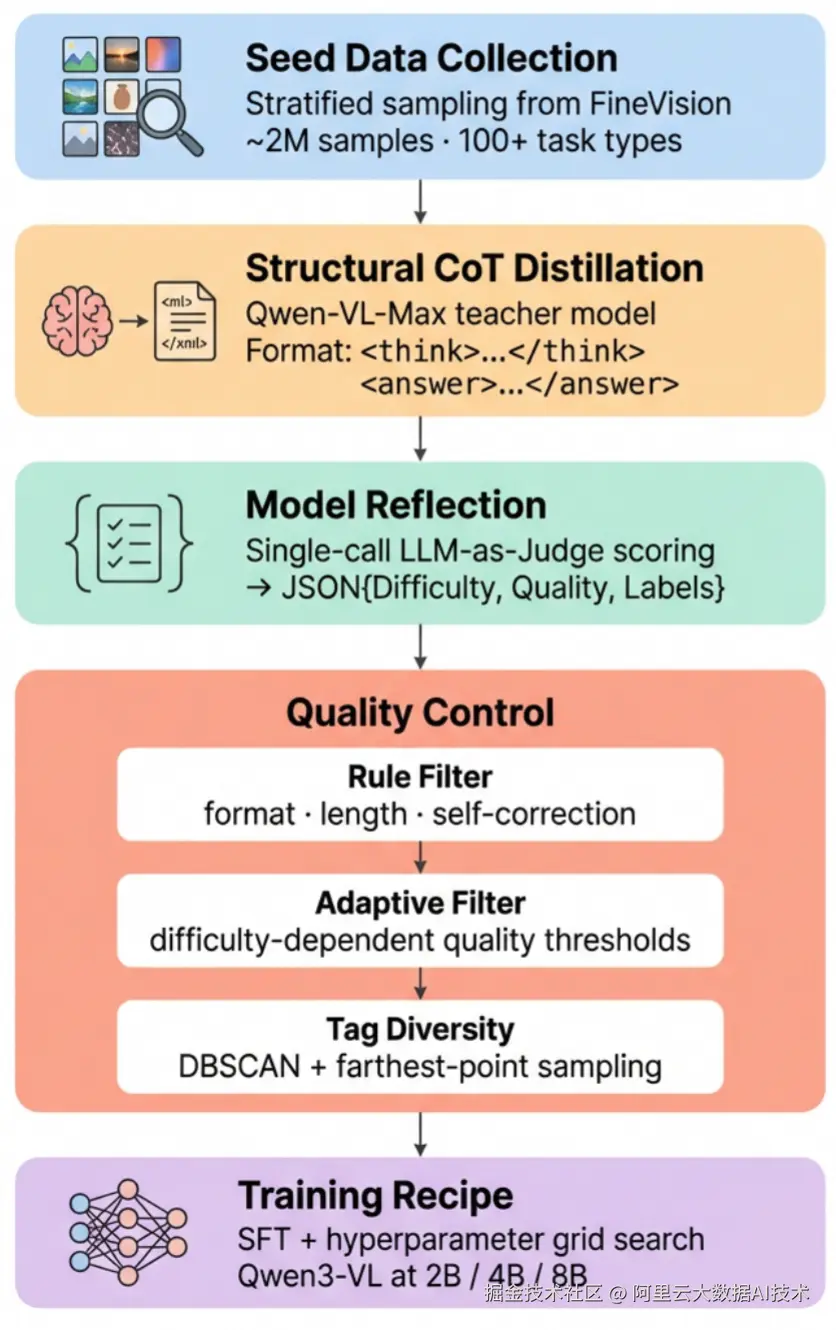
OmniThoughtVis
面向多模态强化学习后训练的探索引导式提示优化
在线强化学习(如GRPO)已成为提升多模态大模型推理能力的重要后训练范式,但训练提示通常被均匀对待,隐含"每条提示对当前策略同等有信息量"的假设。实际中,部分提示已被策略"饱和"而无法产生有效梯度,另一些则过难导致rollout全错、监督信号微弱。针对这一问题,本工作提出探索引导式提示优化框架,并设计了探索潜力分数(Exploration Potential Score, EPS):一种基于KL正则策略改进理论、可直接从在线rollout统计中计算的轻量提示效用指标。对低EPS提示,框架不再直接丢弃,而是用教师模型将其改写为保持原任务意图、但更利于当前策略学习的提示变体,将教师监督从"模仿输出"重构为"训练数据精炼"。在Geo3K与MMK12上结合GRPO训练,该方法在域内基准上最高取得9.7%相对提升,在MathVision与MMMU-Pro上分别提升11.5%与11.1%。
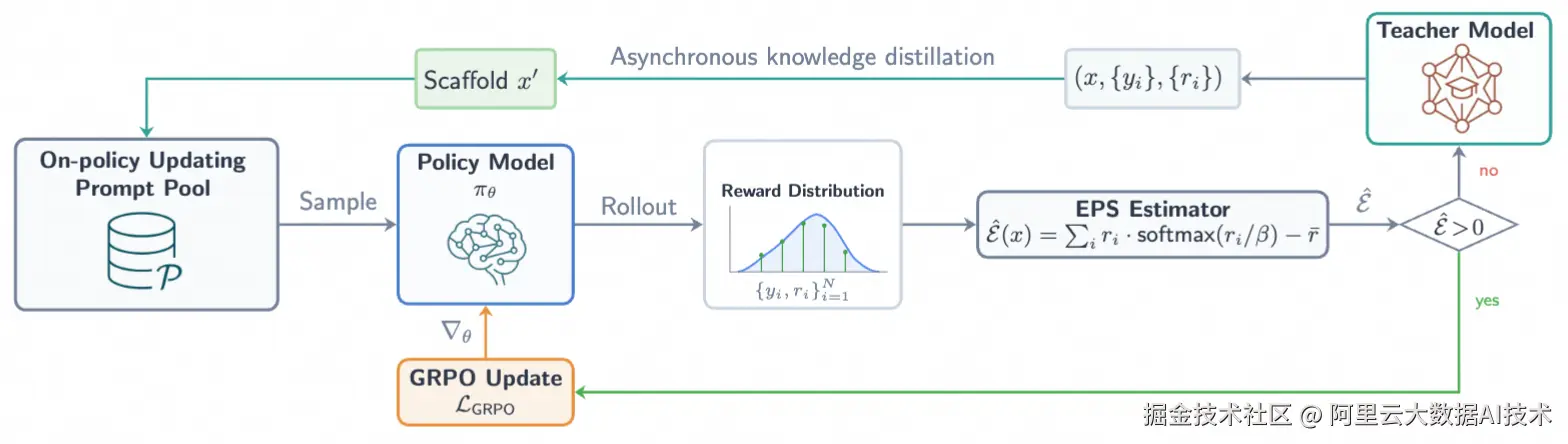
探索引导式提示优化
面向高效长上下文推理的视觉-文本压缩范式
长上下文推理赋予大模型解决复杂任务的能力,但随之而来的计算复杂度造成了严重的效率瓶颈。现有高效方法往往依赖复杂的额外训练或外部压缩模型,限制了可扩展性并可能丢失细粒度信息。本工作提出VTC-R1,一种将视觉-文本压缩融入推理过程的高效推理范式:不再处理冗长的文本推理轨迹,而是将中间推理片段渲染为紧凑图像,迭代地作为"光学记忆"反馈给视觉语言模型。基于OpenR1-Math-220K构建的训练数据可实现3.4倍的token压缩,在Glyph与Qwen3-VL上的实验表明,VTC-R1在MATH500、AIME25、AMC23、GPQA-D等基准上持续优于标准长上下文推理,并在端到端延迟上取得2.7倍加速,为推理密集型应用提供了可扩展的解决方案。
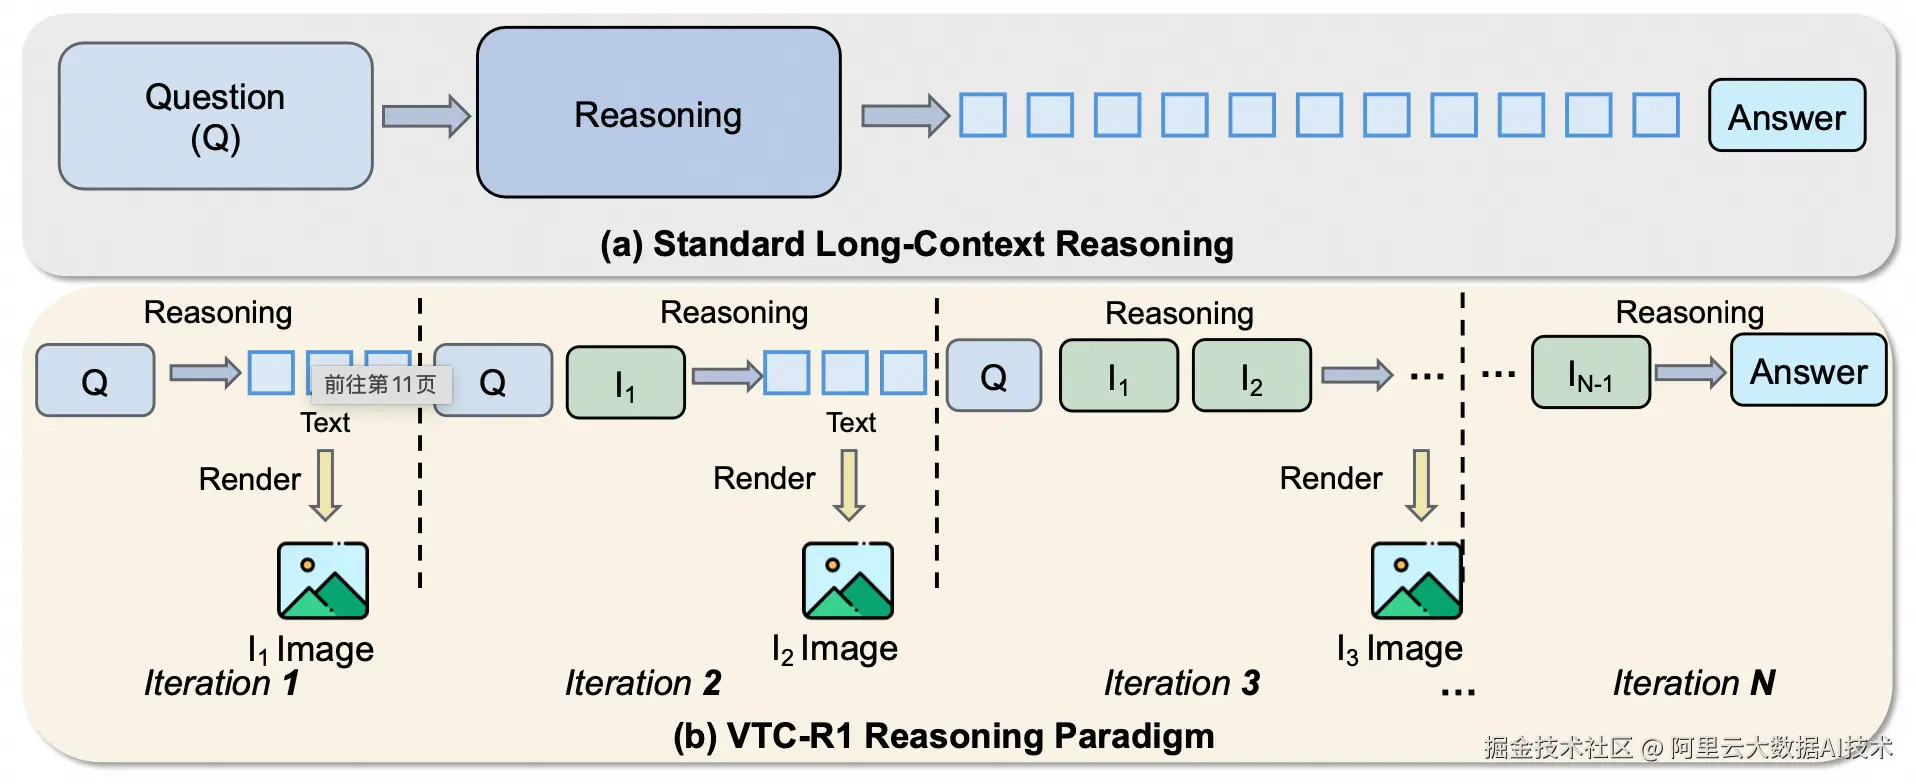
VTC-R1
面向MoE模型的隐层-中间层联合剪枝与蒸馏
混合专家(MoE)架构以高效扩展能力成为主流,但巨大的参数与显存开销制约了部署。以往结构化压缩主要聚焦专家级或FFN中间层剪枝,然而本工作发现一个重要趋势:最新MoE模型的FFN扩展比(intermediate/hidden)持续下降,DeepSeek-V3与Qwen3已降至0.29和0.38,使得仅压缩中间层的收益日益有限。为此,本工作首次提出面向MoE的隐层-中间层联合剪枝与蒸馏框架,同时压缩专家FFN的中间维度与隐层维度。框架引入预算约束坐标下降(BCD)算法高效搜索每个专家在两个维度上的最优剪枝比,并采用基于注意力表示的关系迁移蒸馏(RTD)在隐层通道不对齐时提供稳定监督。在DeepSeek-V2-Lite与Qwen3-30B-A3B-Thinking上的实验显示,在25%和50%结构化剪枝下该方法均取得最优平均性能,其中Qwen3-30B-A3B-Thinking剪枝25%后在GSM8K上保持96.3%、MATH500上93.9%,接近原始模型水平。
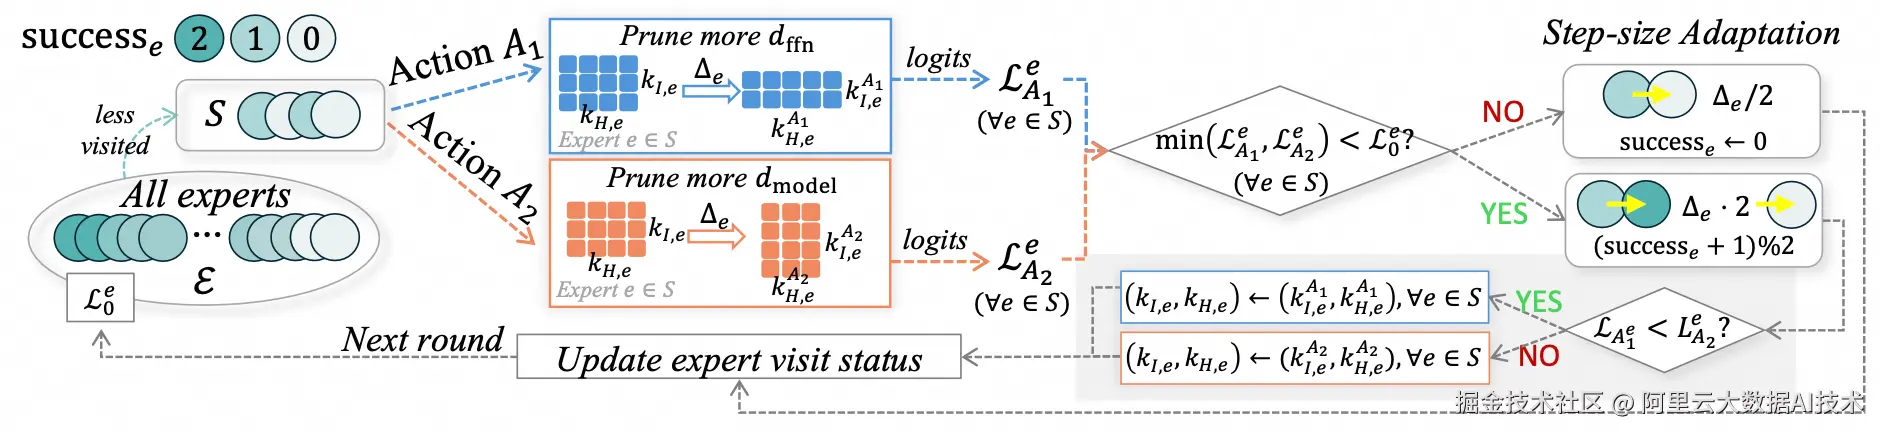
MoE剪枝与蒸馏
在合成搜索环境中训练深度搜索智能体
深度搜索智能体通常依赖反复调用真实搜索API与浏览器环境进行训练,代价高昂、难以复现,且对外部内容漂移敏感。已有模拟器方案虽降低了真实检索依赖,但大多沿用现有QA数据集的任务分布,与深度搜索所需行为不匹配。本工作提出SYNSEARCH,一套完全在合成搜索-浏览环境中训练深度搜索智能体的框架。其核心思想是联合设计环境与训练任务分布:任务需在目标环境中产生可执行的交互轨迹方可判定有效,从而统一了任务生成、轨迹验证与策略优化。框架将深度搜索形式化为带结构化工具动作的任务条件POMDP,通过闭环多智能体管线进行任务合成、回滚修正、难度控制与solver-in-loop验证,并采用过程感知奖励的多轮强化学习训练紧凑语言模型。在多跳QA与深度搜索基准上,SYNSEARCH在答案准确性与搜索行为上均显著提升,生成更长轨迹与更多浏览动作,且边际成本低、可复现、可控制。
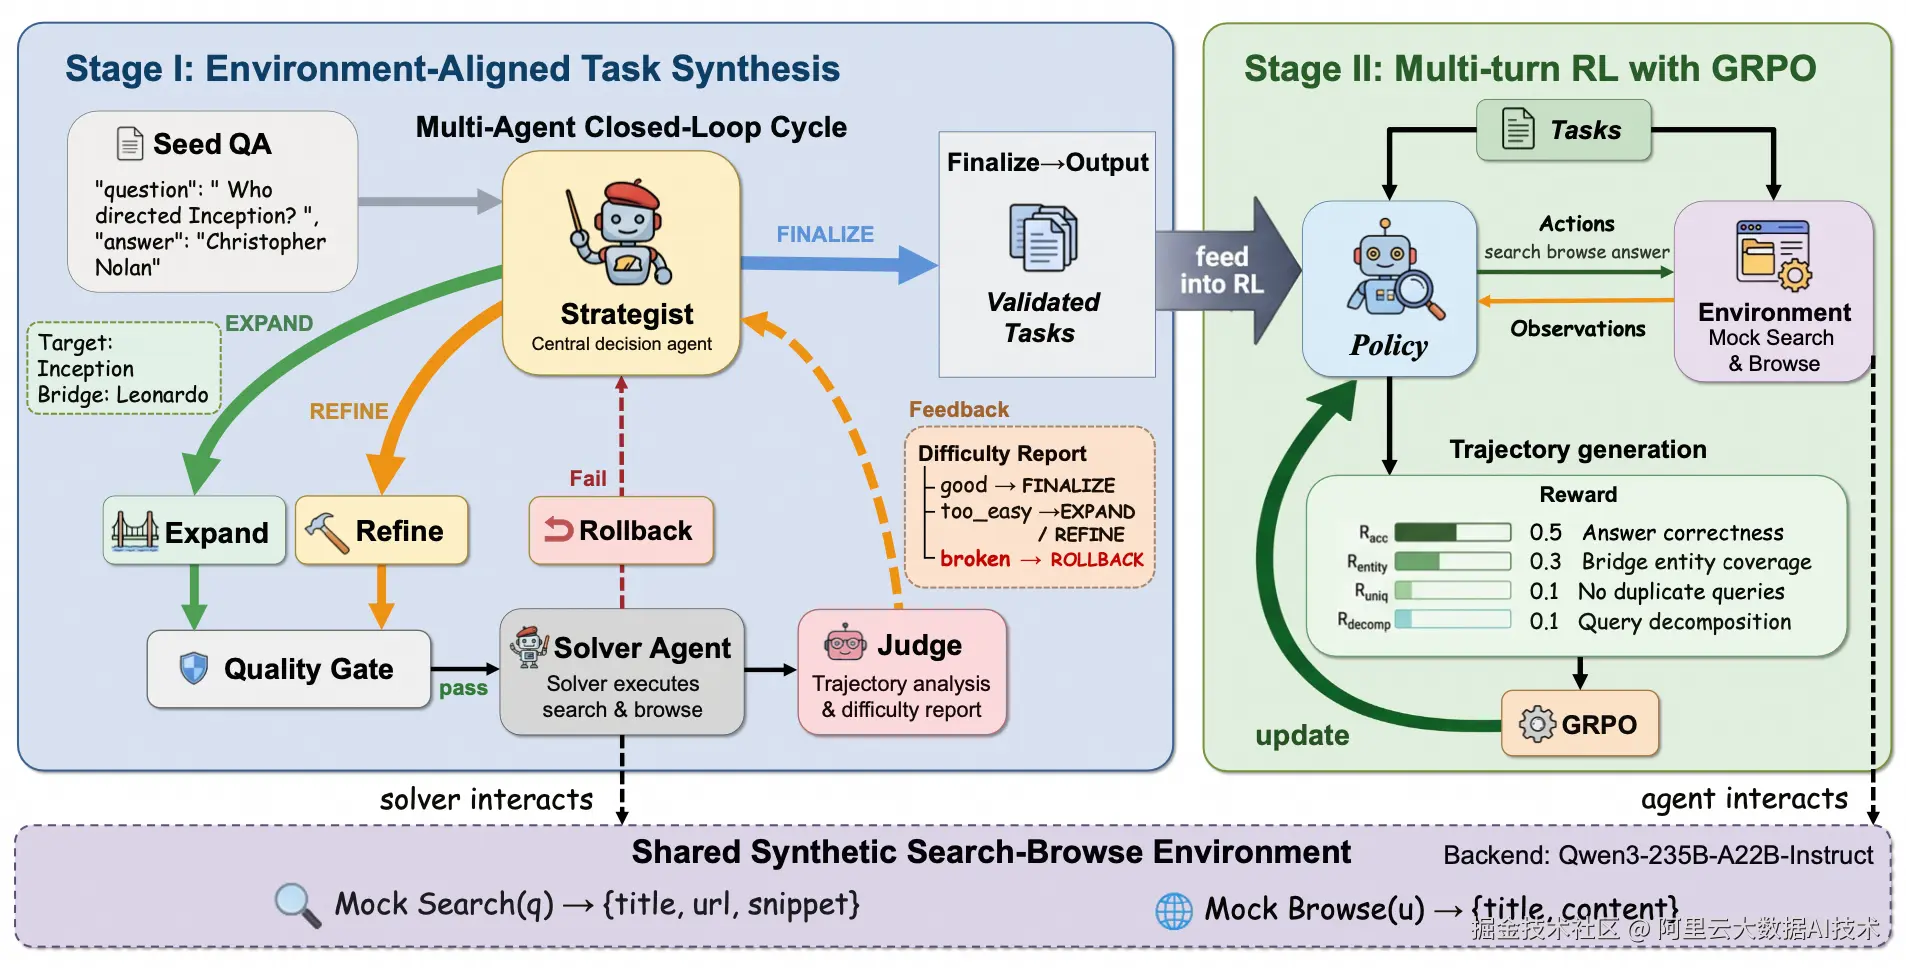
SYNSEARCH
面向深度研究的并行规划-执行-验证框架
开放网页深度研究的瓶颈不仅在于搜索多久,更在于如何将证据组织为独立、可验证的分支。现有系统多沿单条ReAct轨迹扩展或依赖长上下文搜索,可能加深单一假设却忽略候选实体、约束或反证。本工作提出P-SEARCH,一种并行规划-执行-验证框架:先构建有据的背景状态,再分解为独立可执行的证据分支,并行运行分支搜索智能体,迭代验证未关闭的约束后进行综合。在训练上,P-SEARCH避免对完整多阶段rollout进行端到端信用分配,转而训练两个可复用的行为级策略。实验表明,以GLM-5和通义-DR-30B为骨干的P-SEARCH在多个开放网页基准上超越其报告基线,训练得到的8B系统在GAIA上达到59.2%、在Xbench-DeepSearch上达到70.0%。
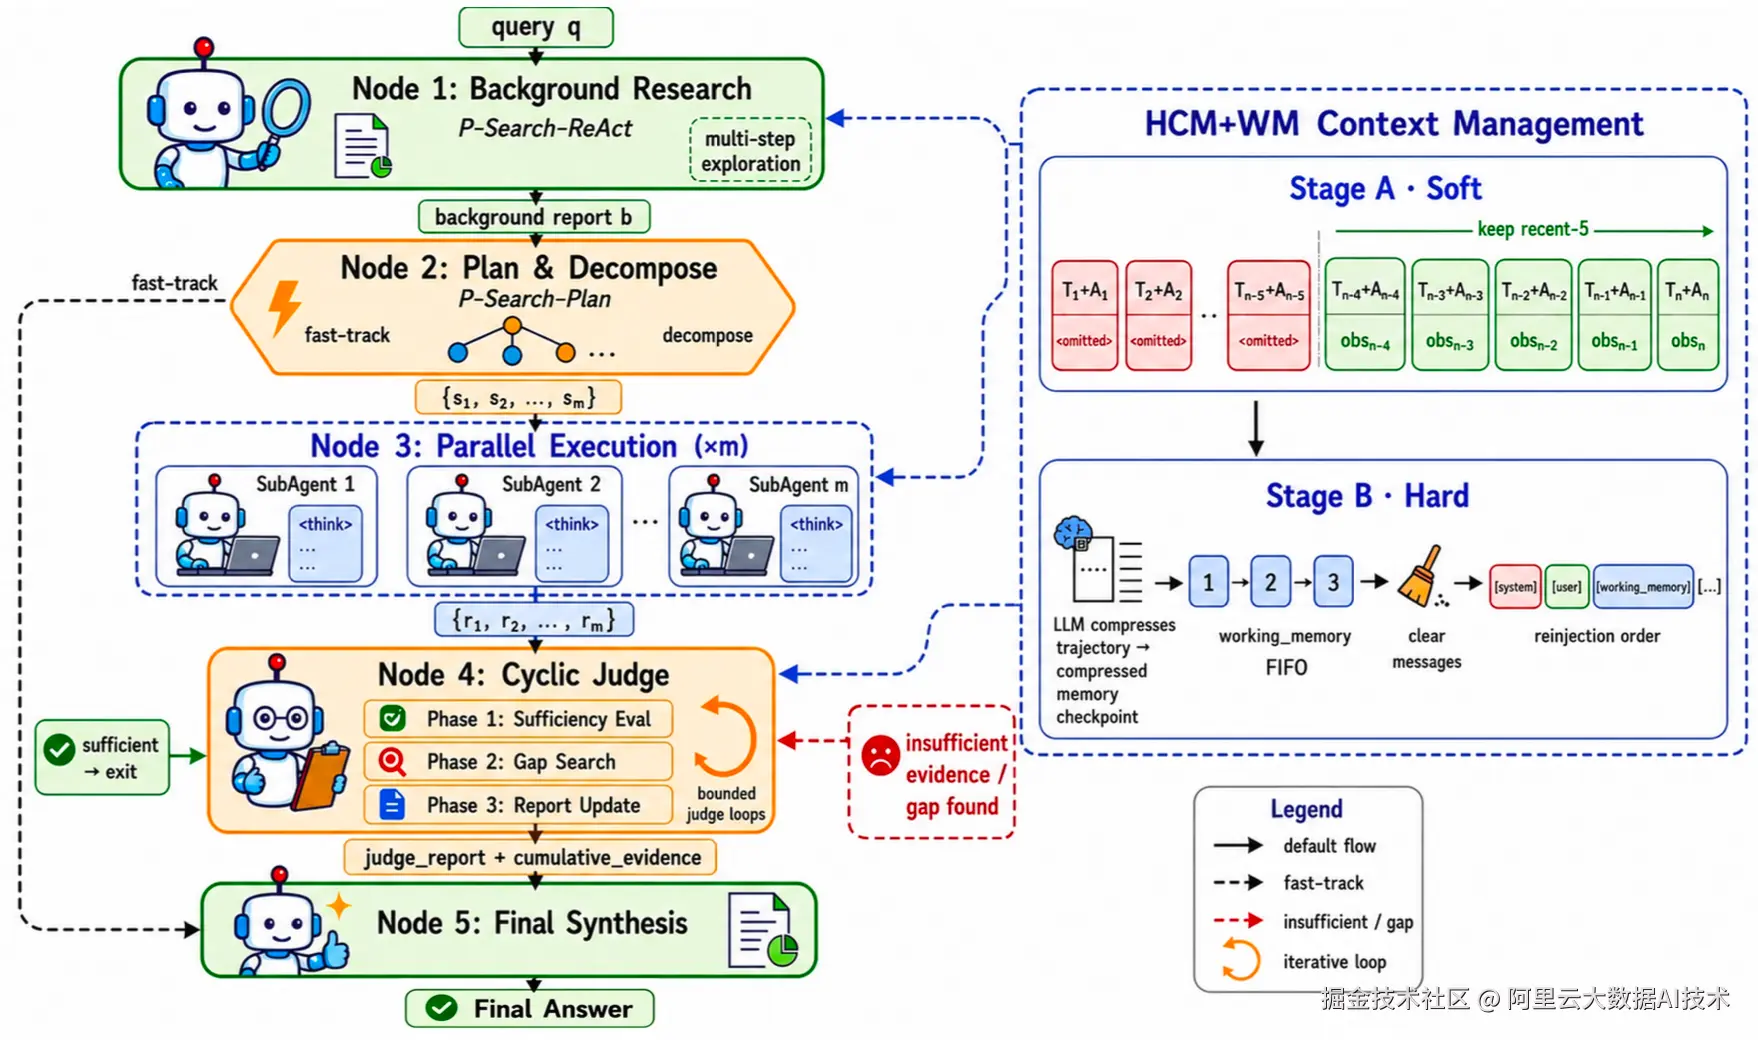
P-SEARCH
产品化服务
上述科研成果也在人工智能平台PAI的模型蒸馏产品进行了深度集成与整合,持续为PAI客户提供AI模型蒸馏、训练和推理相关服务。特别地,PAI提供基于自研EasyDistill2算法库的零代码、端到端的模型蒸馏服务,将教师模型能力迁移至更轻量的学生模型,覆盖数据构建、训练与部署的完整闭环,全程无需自建任何管线,蒸馏后的学生模型在部分场景下可实现推理成本降低 75%+、推理速度提升 5x+。平台也预置一批开箱即用的场景化蒸馏模板。每个模板将「合成 · 生成 · 评估 · 过滤 · 构建」等原子算子编排为端到端流水线,选择场景即可复用最佳实践配置,快速产出 SFT / DPO / 多模态训练数据。
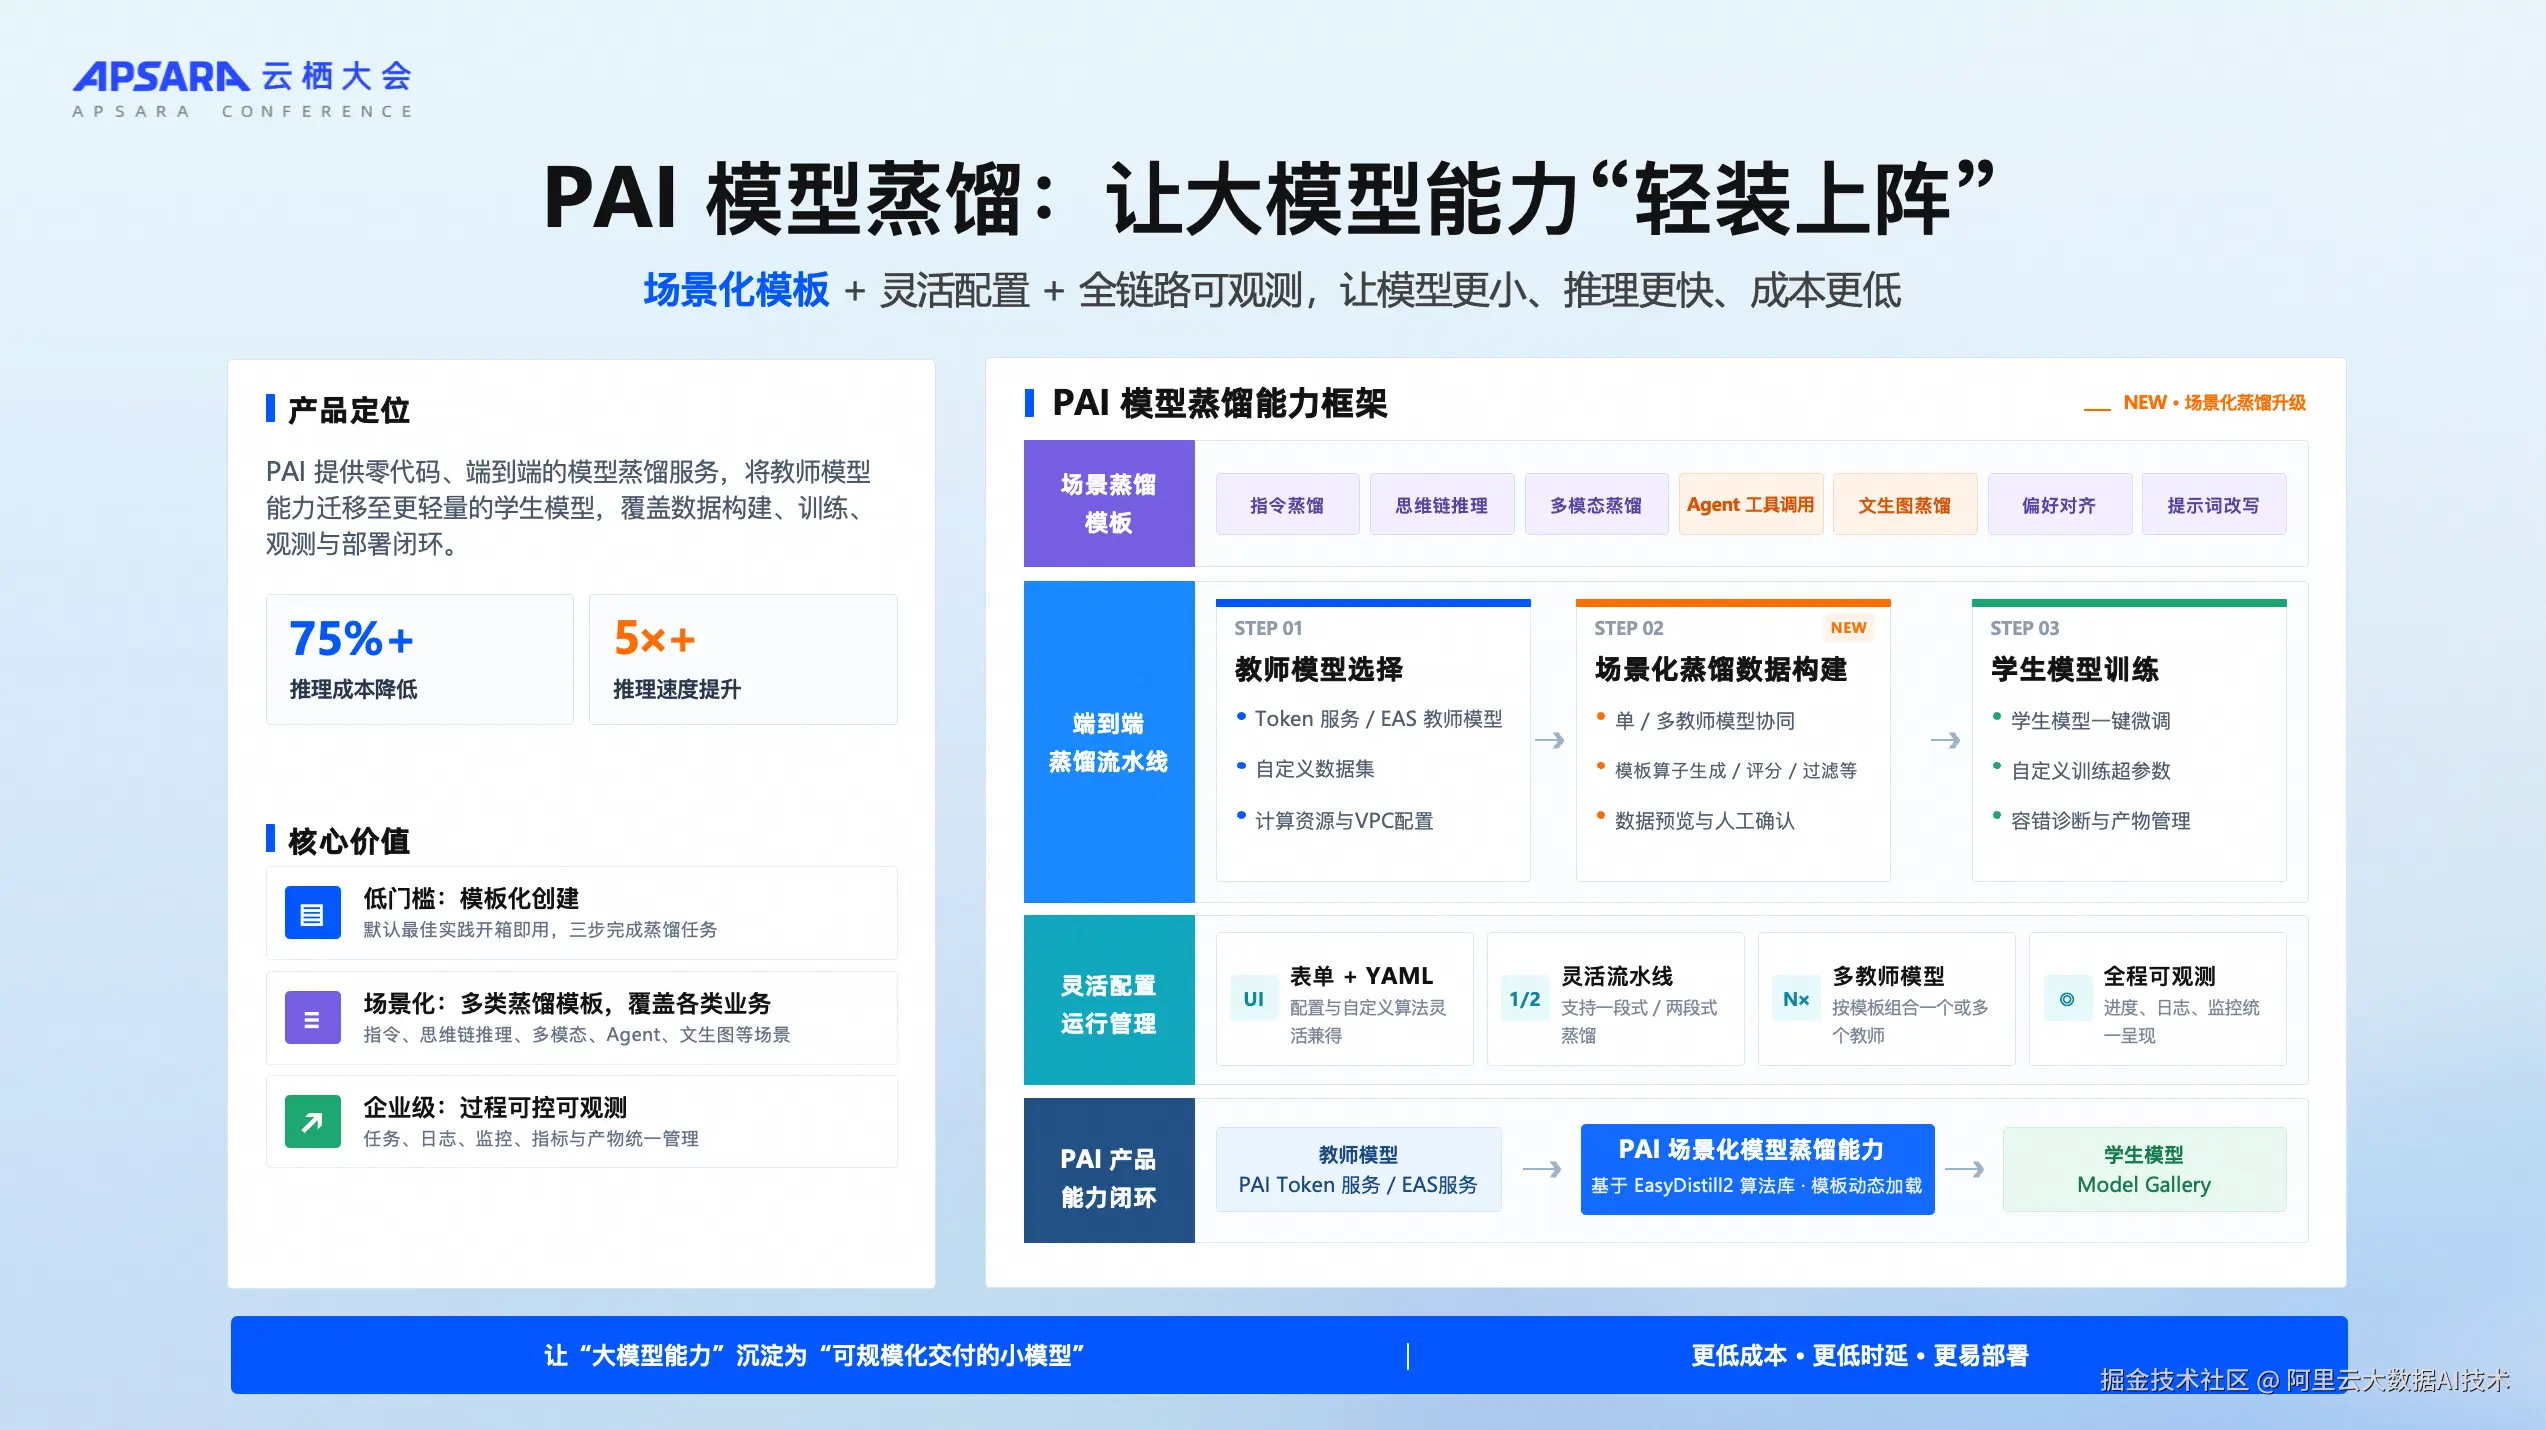
PAI模型蒸馏服务
论文汇总
论文名字: OmniThoughtVis: A Scalable Distillation Pipeline for Deployable Multimodal Reasoning Models
论文作者:岳元浩、汪诚愚、吕元杰、沈磊、黄俊
论文名字: Not All Prompts Are Equal: Exploration-Guided Prompt Scaffolding for Multimodal Reinforcement Post-Training
论文作者:岳元浩、马千里、汪诚愚、王灏廷、沈磊、黄俊
论文名字: VTC-R1: Vision-Text Compression for Efficient Long-Context Reasoning
论文作者:王一博、静永程、刘顺宇、关豪、涂荣成、汪诚愚、黄俊、陶大程
论文名字: Orchestrating Hidden-Intermediate Pruning-and-Distill for MoEs Slimming
论文作者:丁一芙、静永程、汪诚愚、黄俊、陶大程
论文名字: Fake It Till You Make It: Training Deep-Search Agents in Synthetic Search Environments
论文作者:薛逸博、郑品、汪诚愚、康宇焜、吕元杰、王明、彭剑、黄俊、徐常亮
论文名字: P-Search: A Parallel Plan-Act-Verify Framework with Decoupled GRPO for Deep Research
论文作者:郑品、薛逸博、王明、康宇焜、郑皓楠、汪诚愚、彭剑、黄俊、徐常亮