先把结论放在前面:能做出一个完整可用的 BI 查询工具,只是入口从"随便问"变成"引导式输入"。
核心能力多表关联、跨表对齐、排名占比环比,一样不少。差别只在灵活性:用户不能说"帮我看看上月华东区卖得咋样",但可以说"上月 华东 订单金额 总和"。
如果这个交换你能接受,那智能问数可以做到零算力成本、零 token 费用。
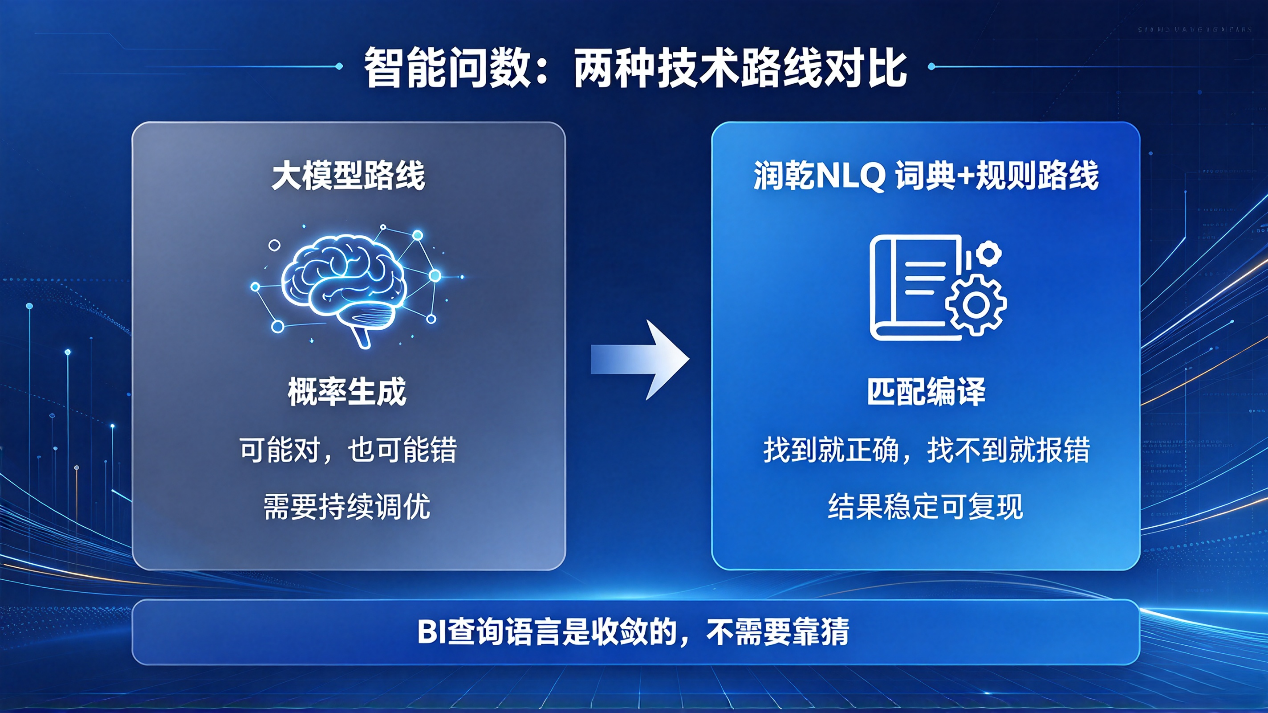
为什么可以不靠大模型
关键在于:BI 查询用的语言,本身就是收敛的。
业务人员问数据,翻来覆去就是那几种意图------查明细、做汇总、搞对比。围绕的实体也是固定的------订单、客户、产品、供应商。条件的组合方式(过滤、分组、计算)是可枚举的。
这不像日常闲聊,天马行空。这更像是"行业黑话",有明确的模式和边界。
润乾 NLQ 的做法是:把这套"黑话"的模式和边界,用一本业务词典定义清楚。系统不靠"理解",靠"匹配",你输入的词在词典里能找到,就按规则编译;找不到,就明确告诉你"不认识"。
没有猜测,就没有幻觉。
不用大模型,能做到什么程度?
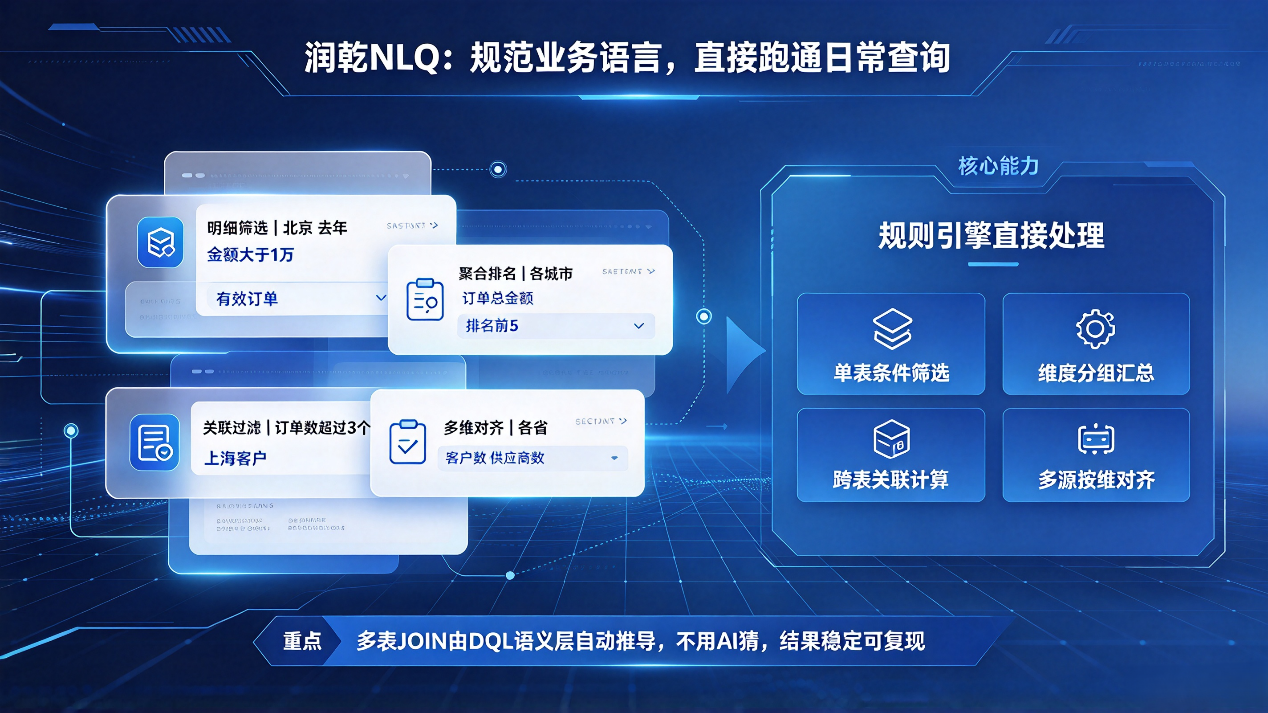
用户只要用规范的业务语言提问,绝大多数日常业务查询都能直接跑通,而且是 100% 准确。
比如下面这些典型场景,直接输入就能查:
-
明细筛选:北京 去年 金额大于 1 万 有效订单
-
聚合排名:各城市 订单总金额 排名前 5
-
关联过滤:订单数超过 3 个 上海客户
-
多维对齐:各省 客户数 供应商数
从能力边界看,企业日常 BI 场景基本全覆盖: 单表条件筛选、维度分组汇总、跨表关联计算、多源按维对齐,这些传统需要写 SQL、做定制查询面板的需求,规则引擎都能直接处理。
尤其是多表 JOIN 这类纯大模型方案的重灾区,在润乾 NLQ 里依托 DQL 语义层的外键属性化和按维对齐机制,表间关联由规则自动推导,不用 AI 猜,不会出现关联遗漏、类型搞错的问题,结果稳定可复现。
操作方式:从"随便问"变成"引导式输入"
不接大模型,最大的变化在输入方式。
接大模型时:用户说"上月华东区卖得咋样",LLM 翻译成规范文本,用户确认后执行。
不接大模型时:用户在输入框里打字,系统根据词典实时提示匹配项。输入"订单",提示"订单 金额 总和"、"订单 数量"、"订单 状态 已完成"等可选组合。用户选一个,就是一个完整的规范查询。
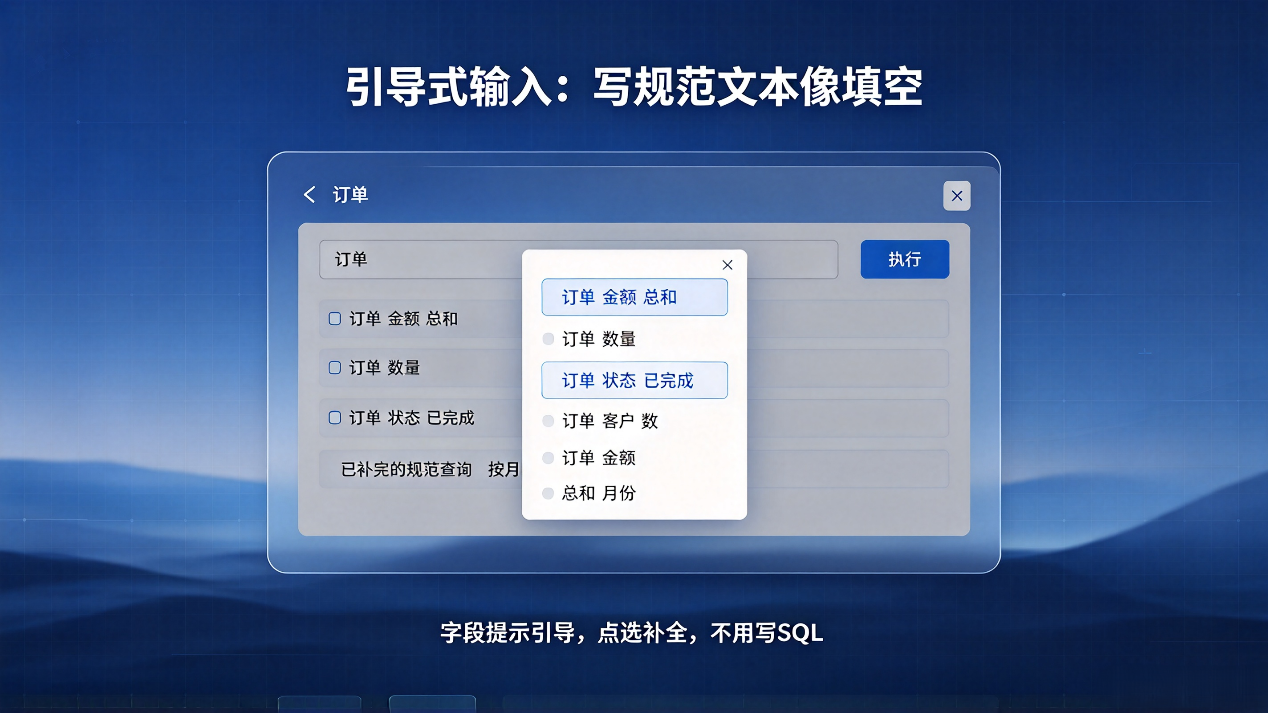
规范文本也是自然语言,只是比口语规整一些。业务人员看一眼提示,组合一下,就能写出查询。不需要学语法,不需要懂 SQL。
更复杂的计算怎么办?跳转到 NLR(自然语言报表)再做
排名、占比、环比、同比这些跨行运算,不接大模型时怎么处理?
分两步:第一步用 NLQ 查出基础数据,第二步跳转到 NLR(自然语言报表)做二次计算。
以"去年各月销售额环比"为例:
- 第一步:查询 "去年 年月 订单金额 总和"------NLQ 查出各月销售额。
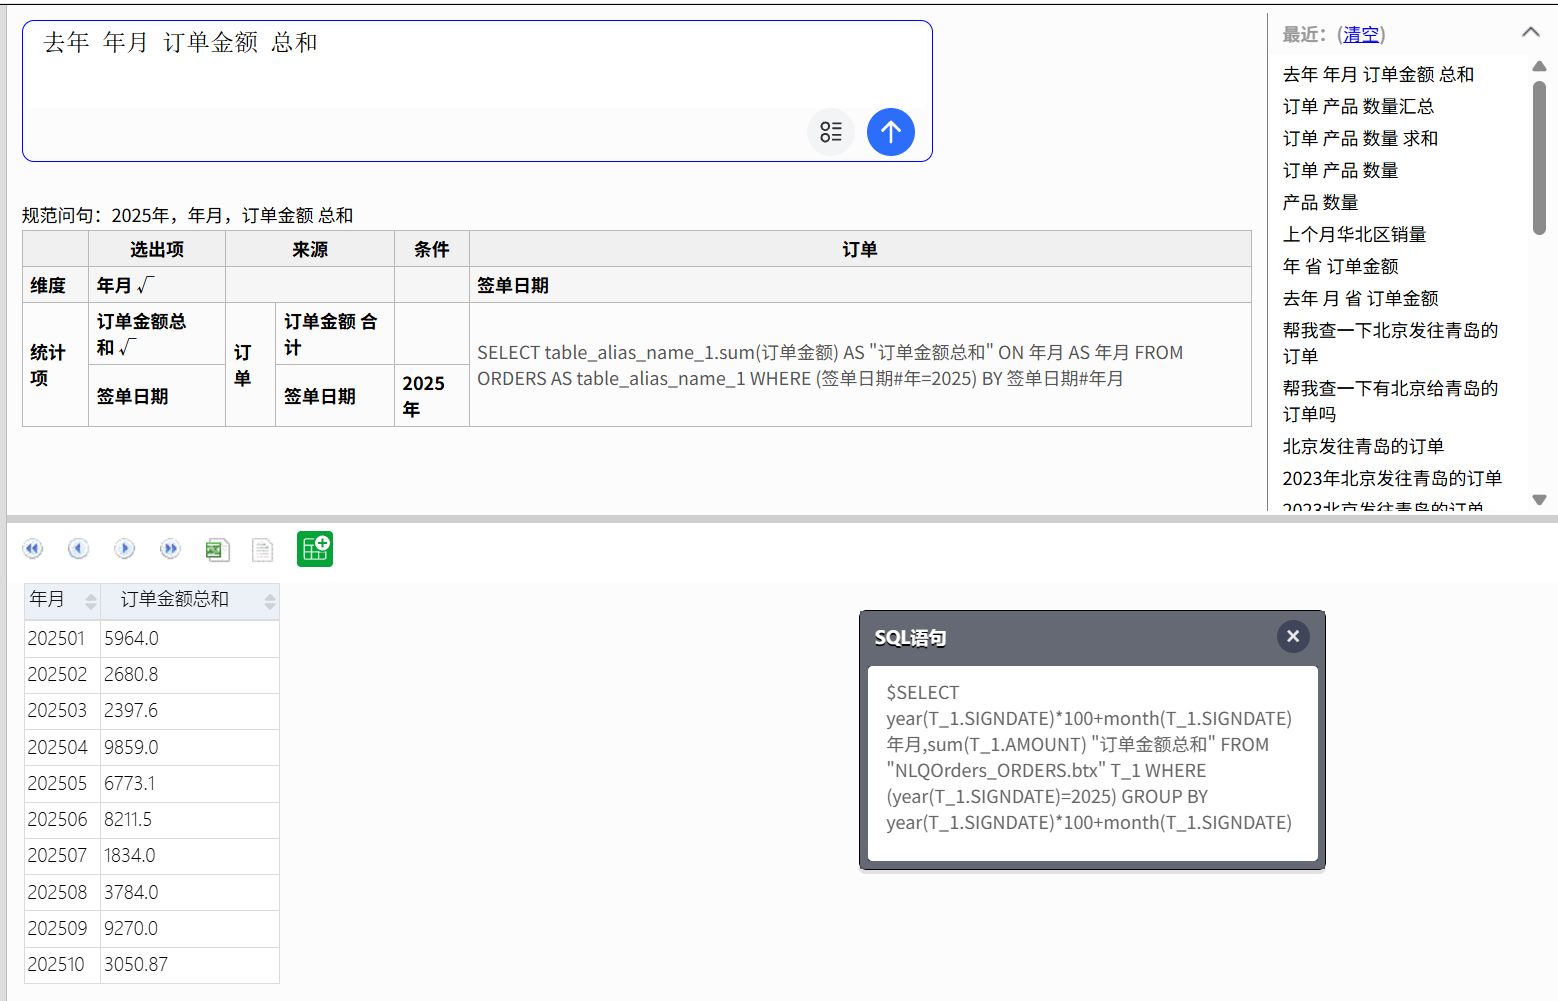
- 第二步:计算订单金额总和比例环比 命名为订单环比------NLR 在结果集上算环比。
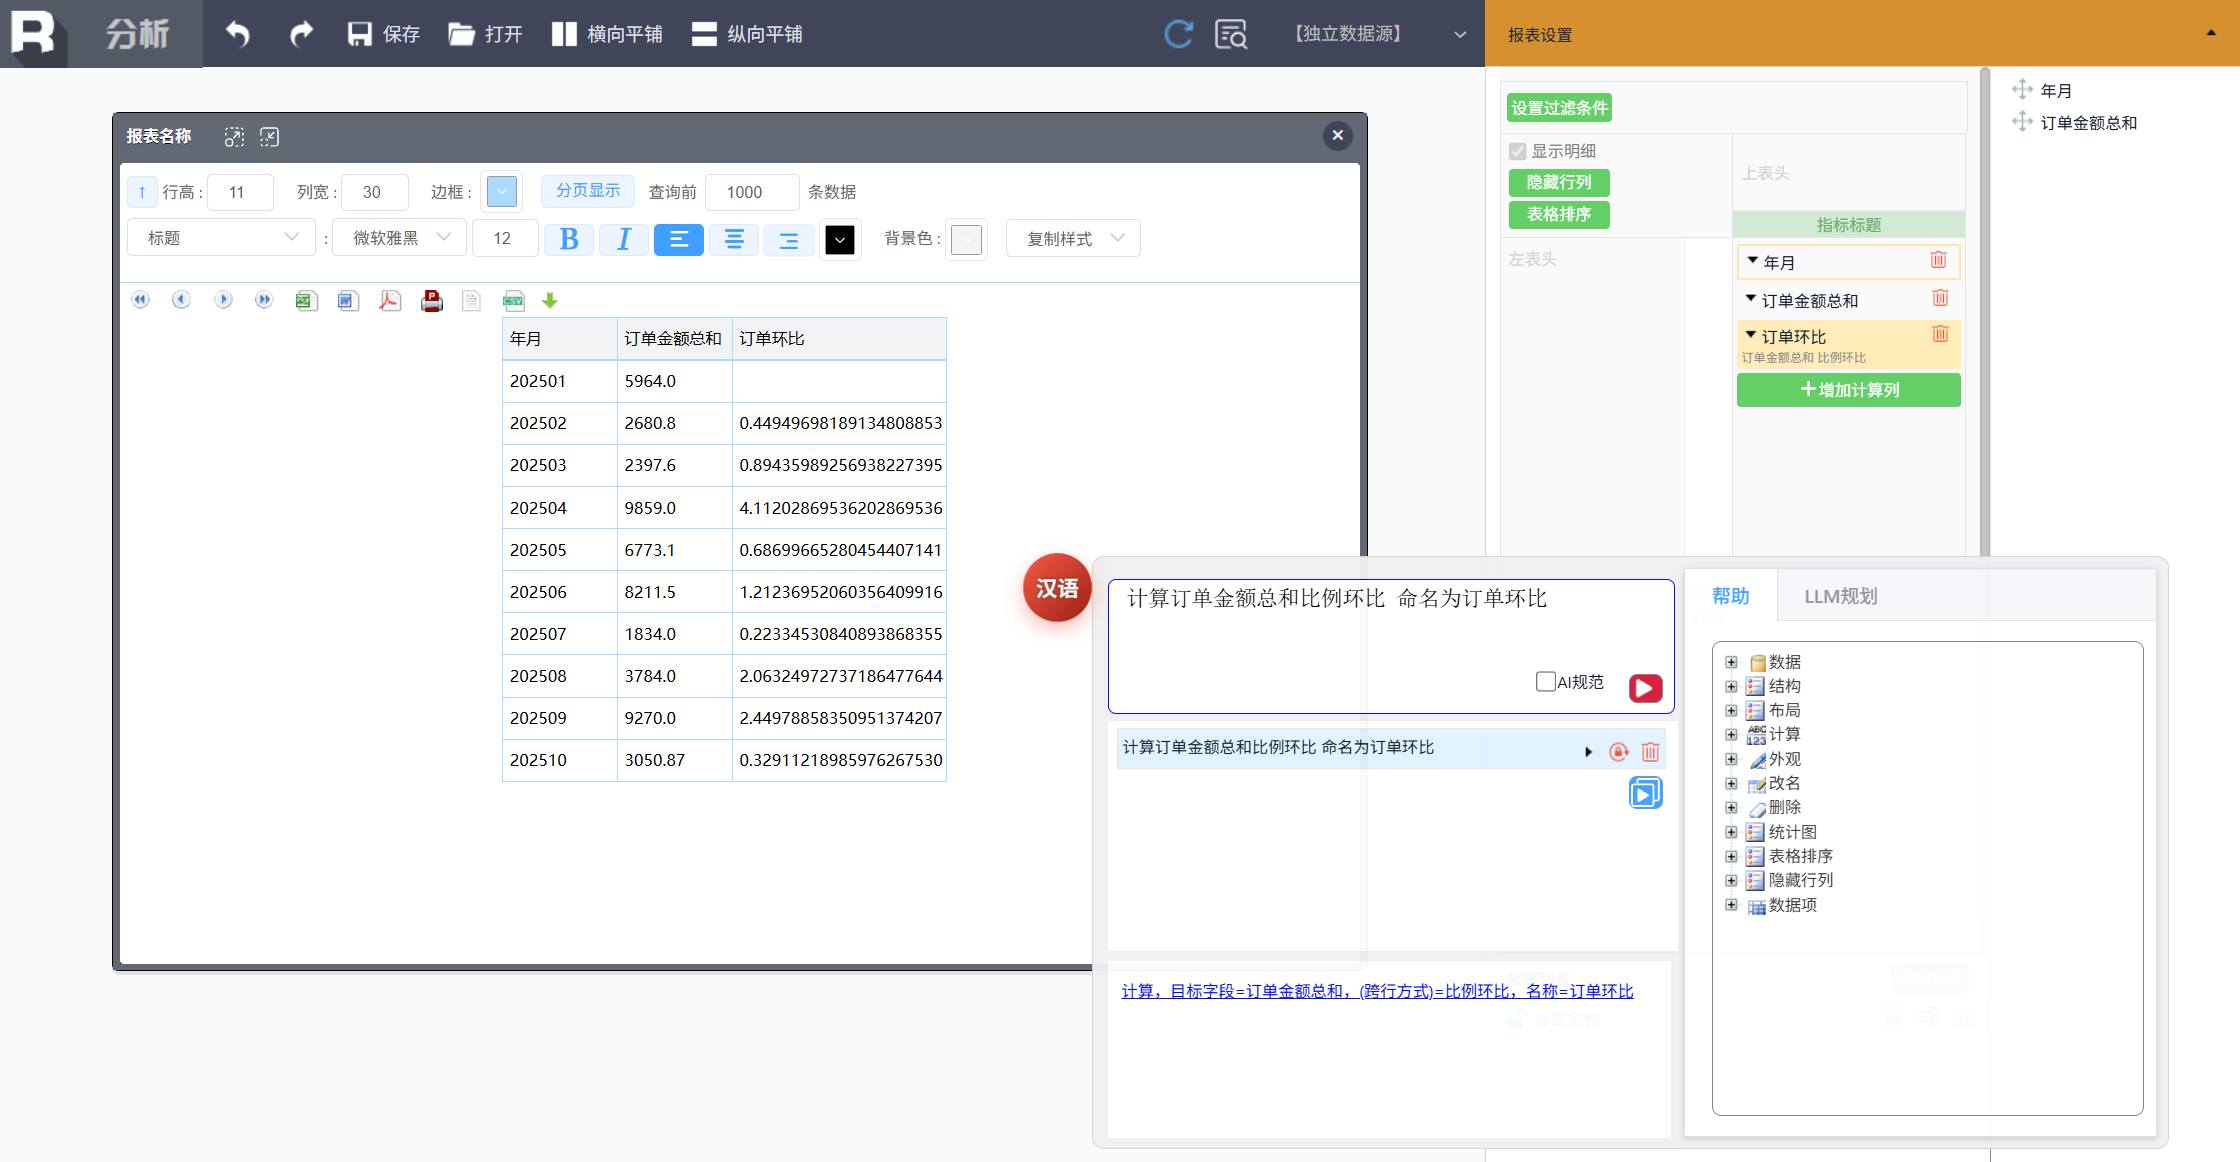
NLR 也是规则驱动,不走 AI。用户手动拆成两步,多一次操作,但结果一样确定。
代价和收益,都很清楚
代价: 入口灵活性降低。用户不能随意说口语,需要按规范方式组织查询。复杂查询需要手动拆步。
收益: 零 GPU 成本,零 token 费用,零 API 延迟。结果 100% 确定,可追溯、可重复。部署在普通 CPU 服务器上,长期持有成本可控。
关键判断标准就一条:你的查询场景,是"模式相对固定"还是"口语千变万化"?
前者,不接大模型完全够用。后者,NLQ 接上大模型提升通过率,但依然保留确认层兜底。
大模型在这里是"加速器",不是"发动机"。 发动机是词典和规则引擎,有没有加速器,车都能跑。