💡 一句话总结 :agent 应用每次调用都重发十几万 token 的上下文,前缀缓存把 GPU 的活几乎干完之后,CPU 上的分词反而成了首字延迟的最大头(实测最高 67%)。KTH 的 GraphTok 把分词的完整流水线整段搬进 GPU、压成一张 CUDA Graph,位级精确不打折:百万 token 编码 1.7 毫秒,vLLM 首 字延迟砍半,一台服务前端能多喂一倍的 GPU 卡。已开源,vLLM/Dynamo 接入是环境变量级的。
先问做推理服务的同行一个问题:你的 vLLM 开了 prefix caching,agent 流量的首字延迟(TTFT,Time-To-First-Token,从发出请求到吐出第一个 token 的时间)还是压不下去,你排查过 GPU 利用率、KV cache 命中率、调度器配置------
有没有顺手看一眼 tokenizer 在干什么?
大概率没有。分词嘛,切切字符串的事,谁在乎。KTH 皇家理工学院的团队较真了一把,把真实编码 agent 的调用轨迹翻出来给你看:TraceLab 统计的约 4300 个真实 agent 会话里,中位每次模型调用携带约 11.9 万个缓存前缀 token,新增的只有 875 个,95.7% 的输入 token 直接命中前缀缓存。
GPU 这边 prefill 几乎白嫖缓存,那时间花哪了?答案有点滑稽:花在 CPU 上一分一分地把那 12 万 token 重新切一遍。
想自己动手?
- 📄 论文:arXiv 2610.13325
- 💻 代码:GitHub · Msiavashi/GraphTok
🤔 这篇论文到底想解决什么问题?
要理解这个瓶颈,得先看现代推理引擎是怎么省钱的。
vLLM、SGLang 这类引擎都有 prefix caching(前缀缓存):同一段开头的文本只算一次 KV 状态,下次请求开头一样就直接复用,跳过昂贵的 prefill 计算。对 agent 来说这是天大的好事------每次调用只多了几百个新 token,前面十几万个 token 的计算全部复用。
但有一个环节逃不掉:缓存查询需要 token ID,而 token ID 要先分词才有。
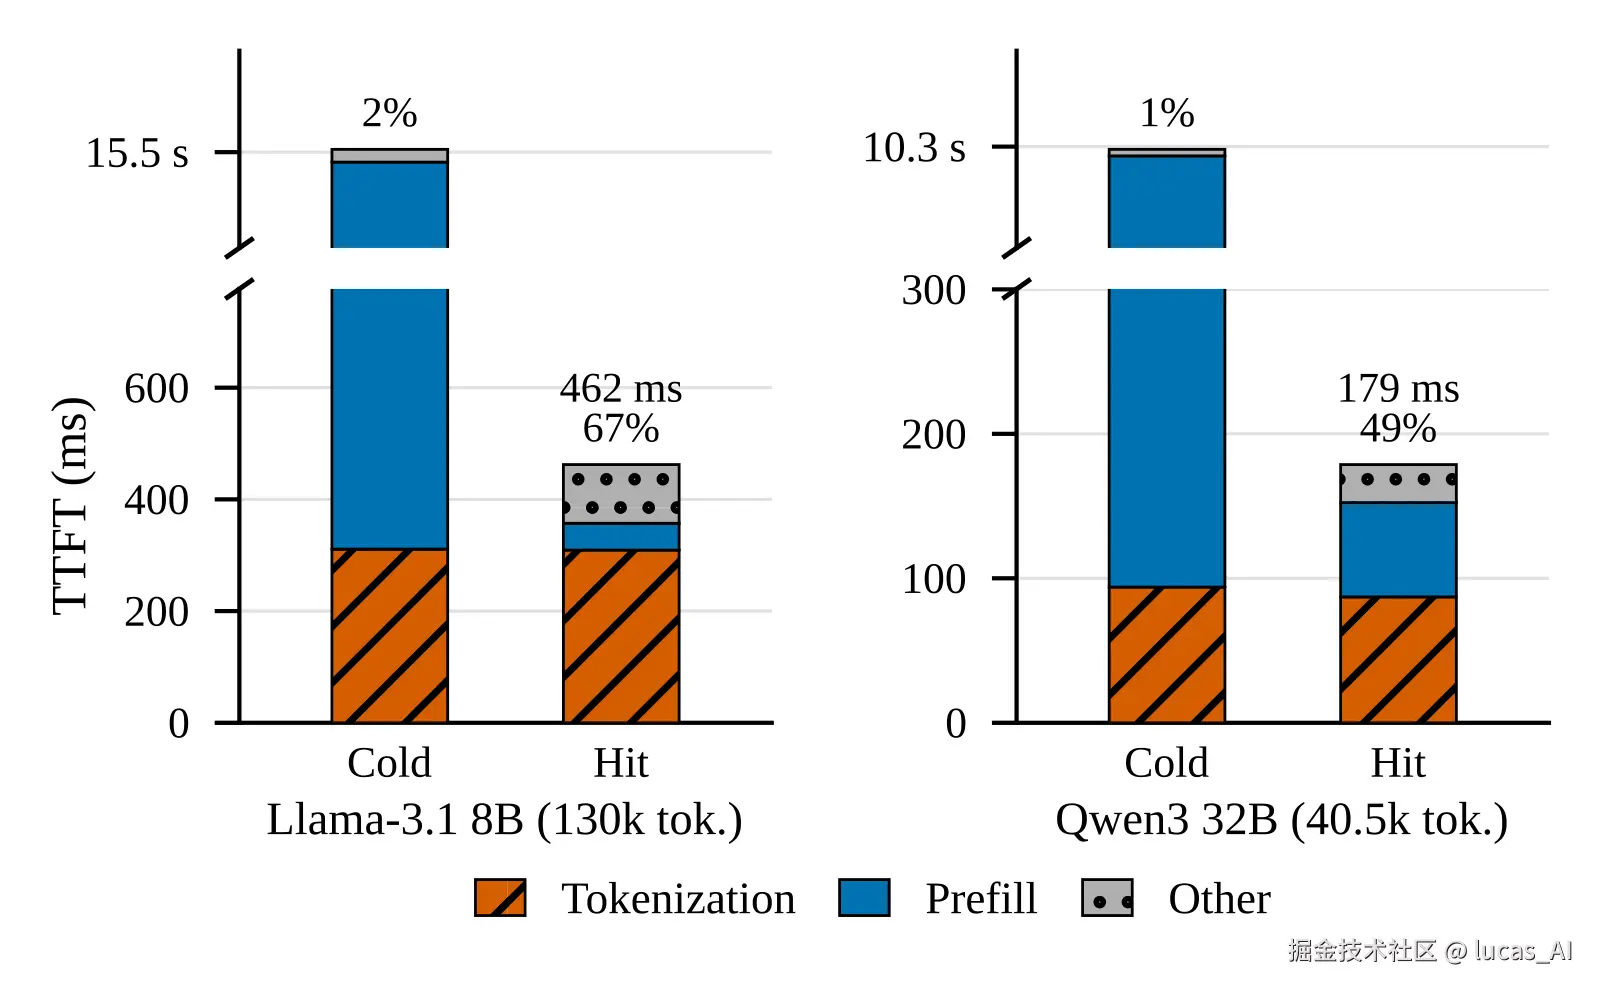
图说:同一台 H100、同一个 vLLM,左边冷缓存时分词只占 TTFT 的 1--2%(prefill 是大头);右边缓存命中后 prefill 没了,分词一跃成为最大组成------Llama 3.1 的 13 万 token 请求里占 67%。
那为什么不只切新增的那 875 个 token,跟前面的缓存拼起来?
因为 BPE 分词不满足「拼接守恒」。把两段文本各自分词再拼接,结果一般不等于把两段拼起来再分词------追加的文本可能改变边界附近的切法。NVIDIA Dynamo 的做法是只在「安全边界」(比如完整的对话轮次)复用 token,剩下的还是得重切。
于是怪事出现了:GPU 越闲(缓存命中越高),CPU 分词在 TTFT 里的占比越高。更要命的是容量视角------像 Dynamo 这样的架构里,一台前端要为整个 GPU 舰队分词,分词吞吐直接决定这台机器能喂饱几张卡。论文实测:默认分词器下,一台前端在 2 秒 P99 目标内只能伺候 2 张 GPU 的 12 万 token agent 流量。
🛠️ 它的思路是什么?
问题的病根是:分词是串行的正则表达式扫描 + 有序的数据依赖合并 ,看起来天生不适合 GPU。前人试过两条路,都有硬伤:BlockBPE、GPUTOK 把合并搬上 GPU,但把正则预分词删了------切出来的 token 和参考分词器不一致;模型吃的是 token ID,切错了等于喂错药。
GraphTok 的答案是三个字:全都要。精确性一个 token 都不让,速度还要拉满。
第一步:把「串行扫描」改写成「逐位置并行判断」。 观察是:一个位置是不是新词的起点,往往只取决于局部字符类型。比如 Llama 3 的规则说「连续数字每 3 个一切」------那一个数字要开新词,当且仅当它是这段数字的第 1 个、第 4 个、第 7 个......字符。于是 GPU 上每个字符一个线程,同时判断「我这儿是不是词边界」,再用前缀扫描(prefix scan,一种并行前缀求和技巧)把边界编号。正则语义一点没丢,串行游标没了。
第二步:warp 协作的 BPE 合并。 跨词并行是免费的(BPE 不越词界),难在词内部合并有序。GraphTok 的写法很漂亮:把「合并优先级 + 位置」打包成一个 64 位整数,一次硬件求最小值归约(warp reduce),最小的秩获胜、同秩最左优先------恰好就是参考实现的合并顺序。一次归约,顺序和性能全保住了。
第三步:整条流水线压成一张 CUDA Graph。 这是系统层面最见功力的部分。GPU kernel 快不等于调用快------重复的 kernel 启动、内存分配、主机同步能把几毫秒的活拖成几十毫秒。GraphTok 把「原始字节进 → token ID 出」的全程捕获成一张可重放的 CUDA Graph(CUDA Graph,预先录制好的 GPU 执行计划,重放时无需 CPU 逐条调度)。分词的工作量是随输入变化的(「锯齿状」),而图要求固定拓扑------解法是把「容量」和「占用」分离:缓冲区按上限预配,实际用了多少由 GPU 上的计数器标记,host 全程只在开头拷一次数据、启动一次图。
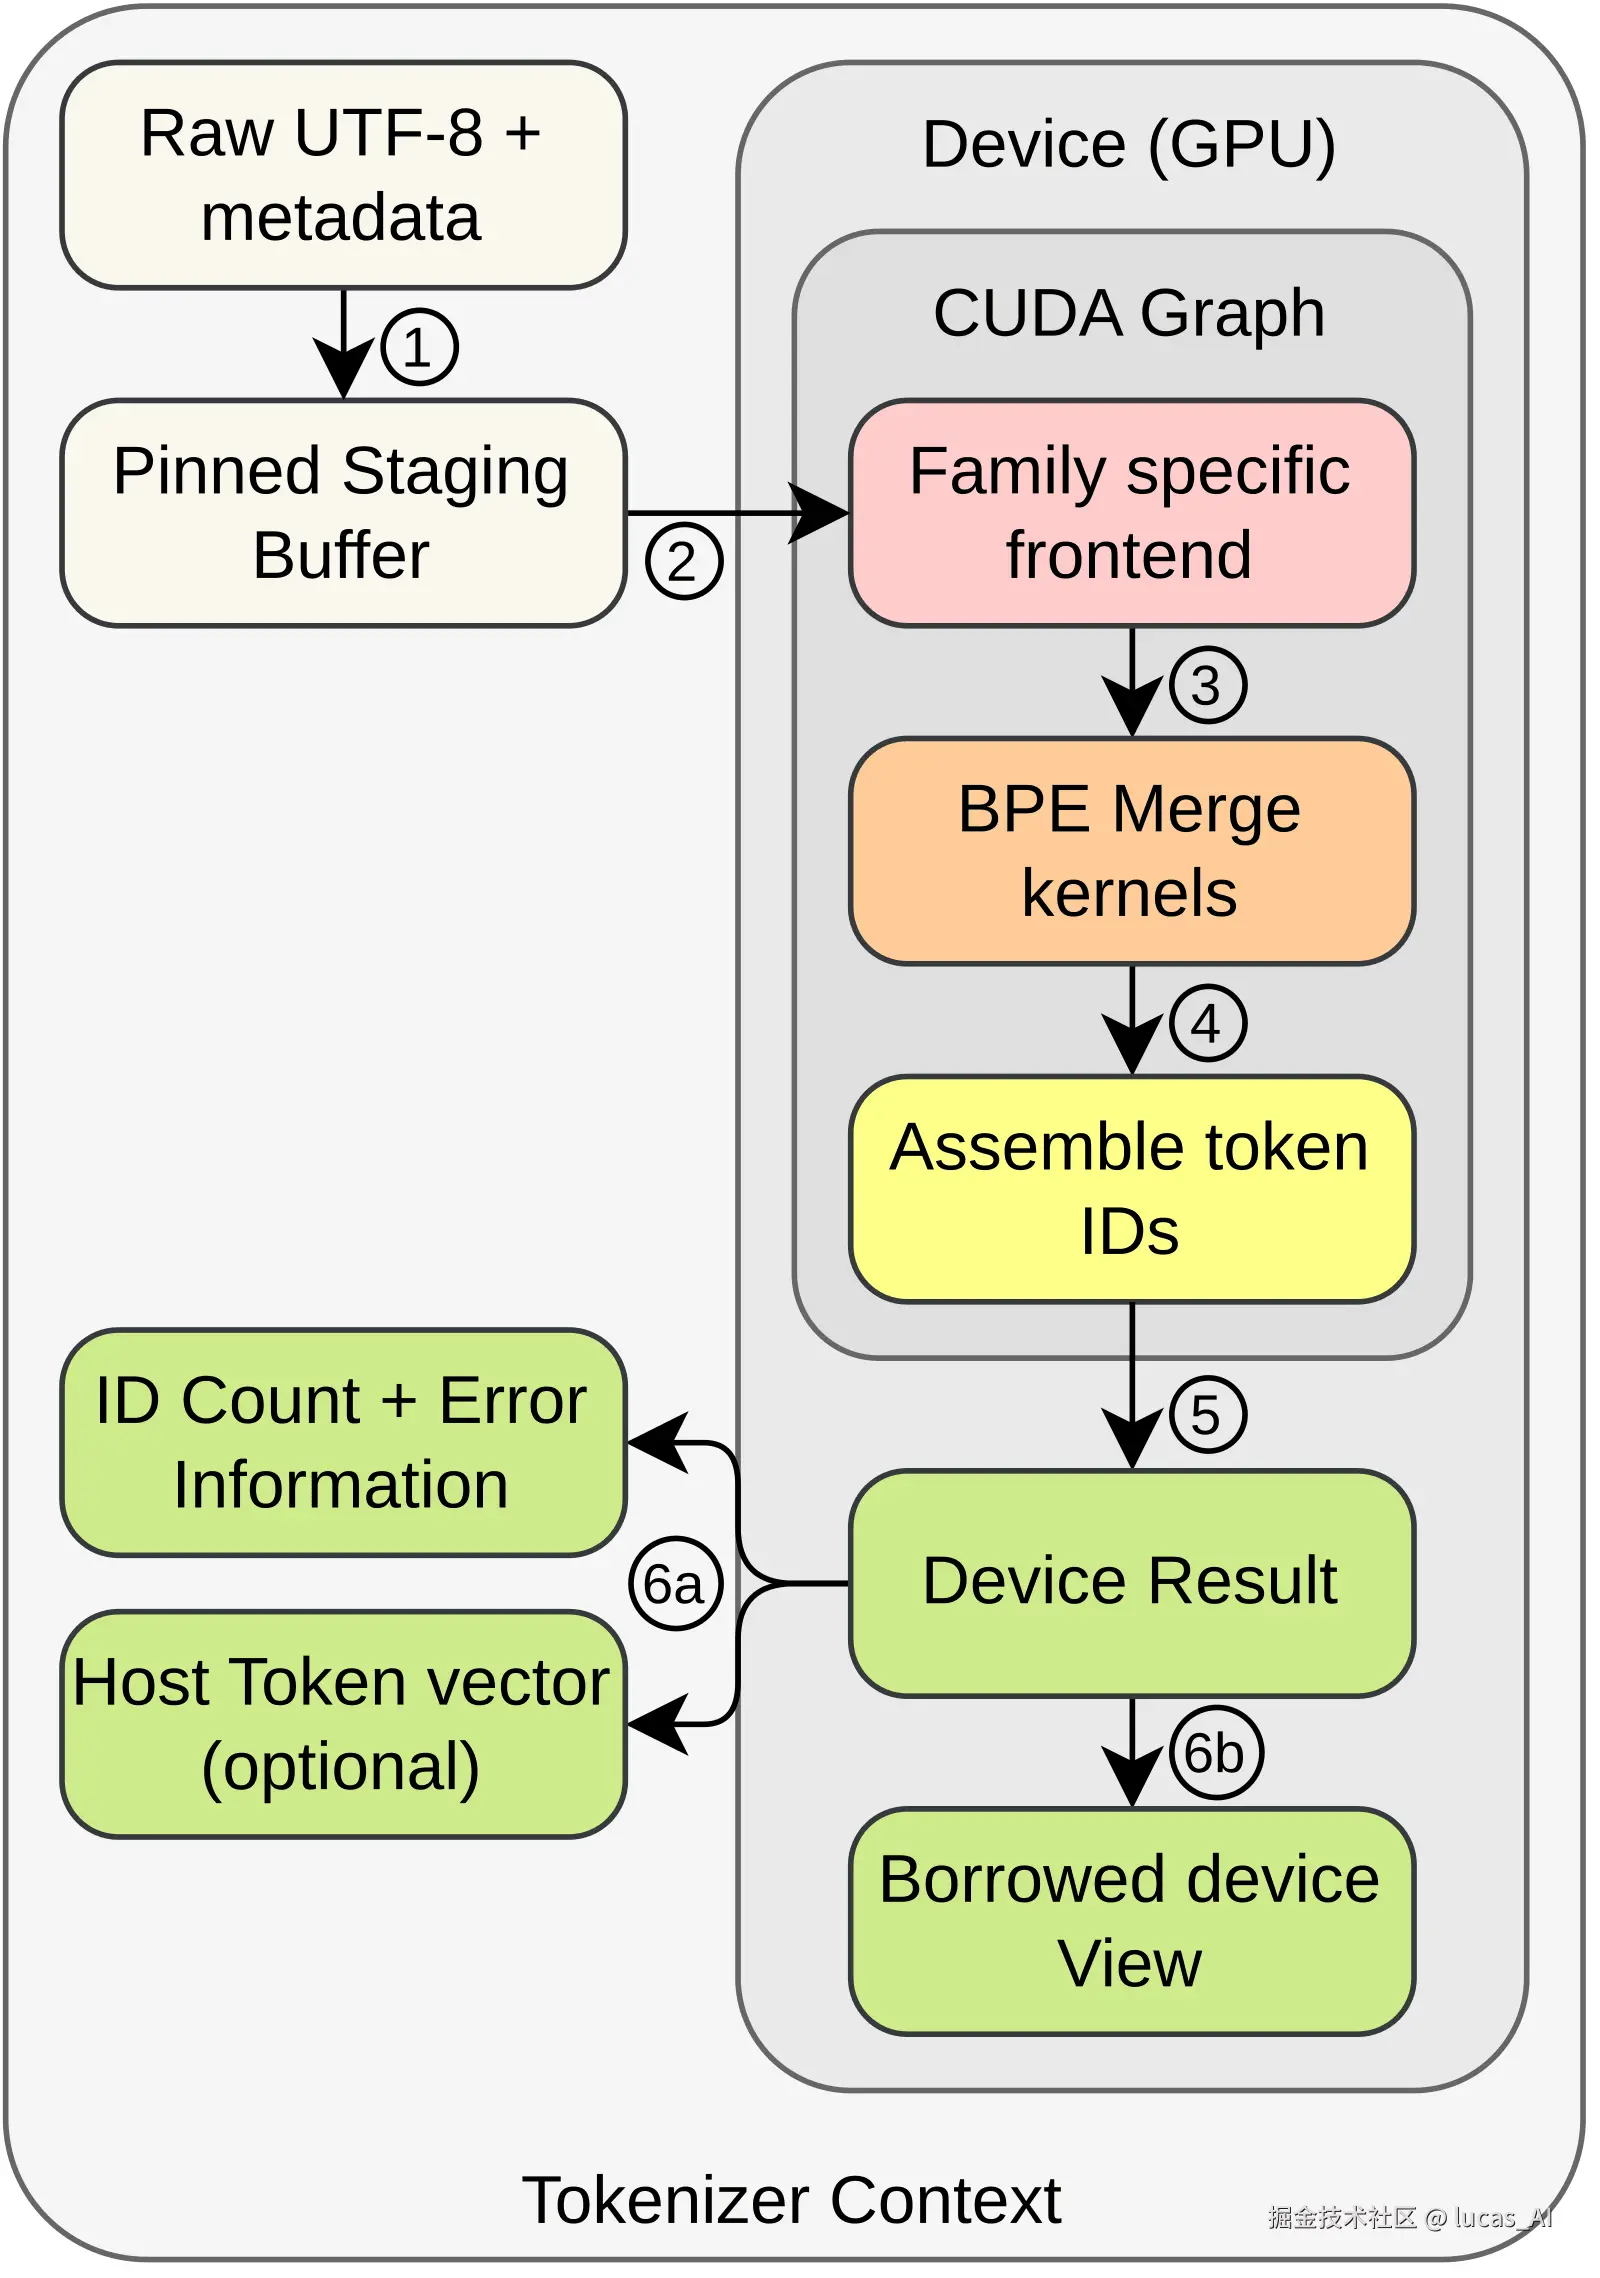
图说:请求进 GraphTok 后,host 只负责把文本拷进 GPU 和启动图(❶❷),预分词、三条合并路径(常规 warp 路径 / 锦标赛树溢出路径 / 重复字符批量轮次)、结果组装(❹❺)全在 GPU 内部完成;结果可以拷回 CPU(6a),也可以直接留在 GPU 上(6b)给未来彻底「去 CPU」的推理引擎用。
最后还有个务实的设计:太短的输入不值得进 GPU(图重放有约 0.06 毫秒的固定底价),GraphTok 内置了 CPU 路由------短文本走静态链接的最强 CPU 分词器 gigatoken,长文本走图,按输入自动选。它不是「GPU 激进派」,是「每个输入都走更便宜的那条精确路径」。
📈 效果到底怎么样?
先说最重要的前提:快,但是一个 token 都没切错。
论文的精确性验证是按「先证明清白,再谈性能」来的:GPT-2、Llama 3、Qwen 2.5、DeepSeek-V3、Gemma 3 五套词表 × 三种语料 × 十种长度 × 1--256 批,每个格子都和参考分词器逐 token 对比------全部一致。这就是它和 BlockBPE/GPUTOK 的本质区别:那些系统在 100 万 token 里悄悄少切了 1 万多个。
速度方面,挑三个最狠的数字:
- 单发延迟 :100 万 GPT-2 token(约一部长篇小说的量级)完整编码 1.7--3.2 毫秒 ,含往返传输。对比最强的 CPU 分词器 gigatoken 快 4.7--6 倍,对比 Hugging Face 参考实现快 865--1295 倍。
- TTFT :99% 前缀复用时,vLLM 换上 GraphTok 平均 TTFT 直降 2.1--2.4 倍 ;分词在 TTFT 里的占比从原装的 56--76% 压到 1.4--2.5%。
- 容量 :Dynamo 前端 + 12 万 token agent 流量,2 秒 P99 目标内可承载从默认的 18.5 请求/秒提到 518 请求/秒 ------从 2 张 GPU 的量提到 56 张。极限处 P99 尾延迟最多低 64 倍。
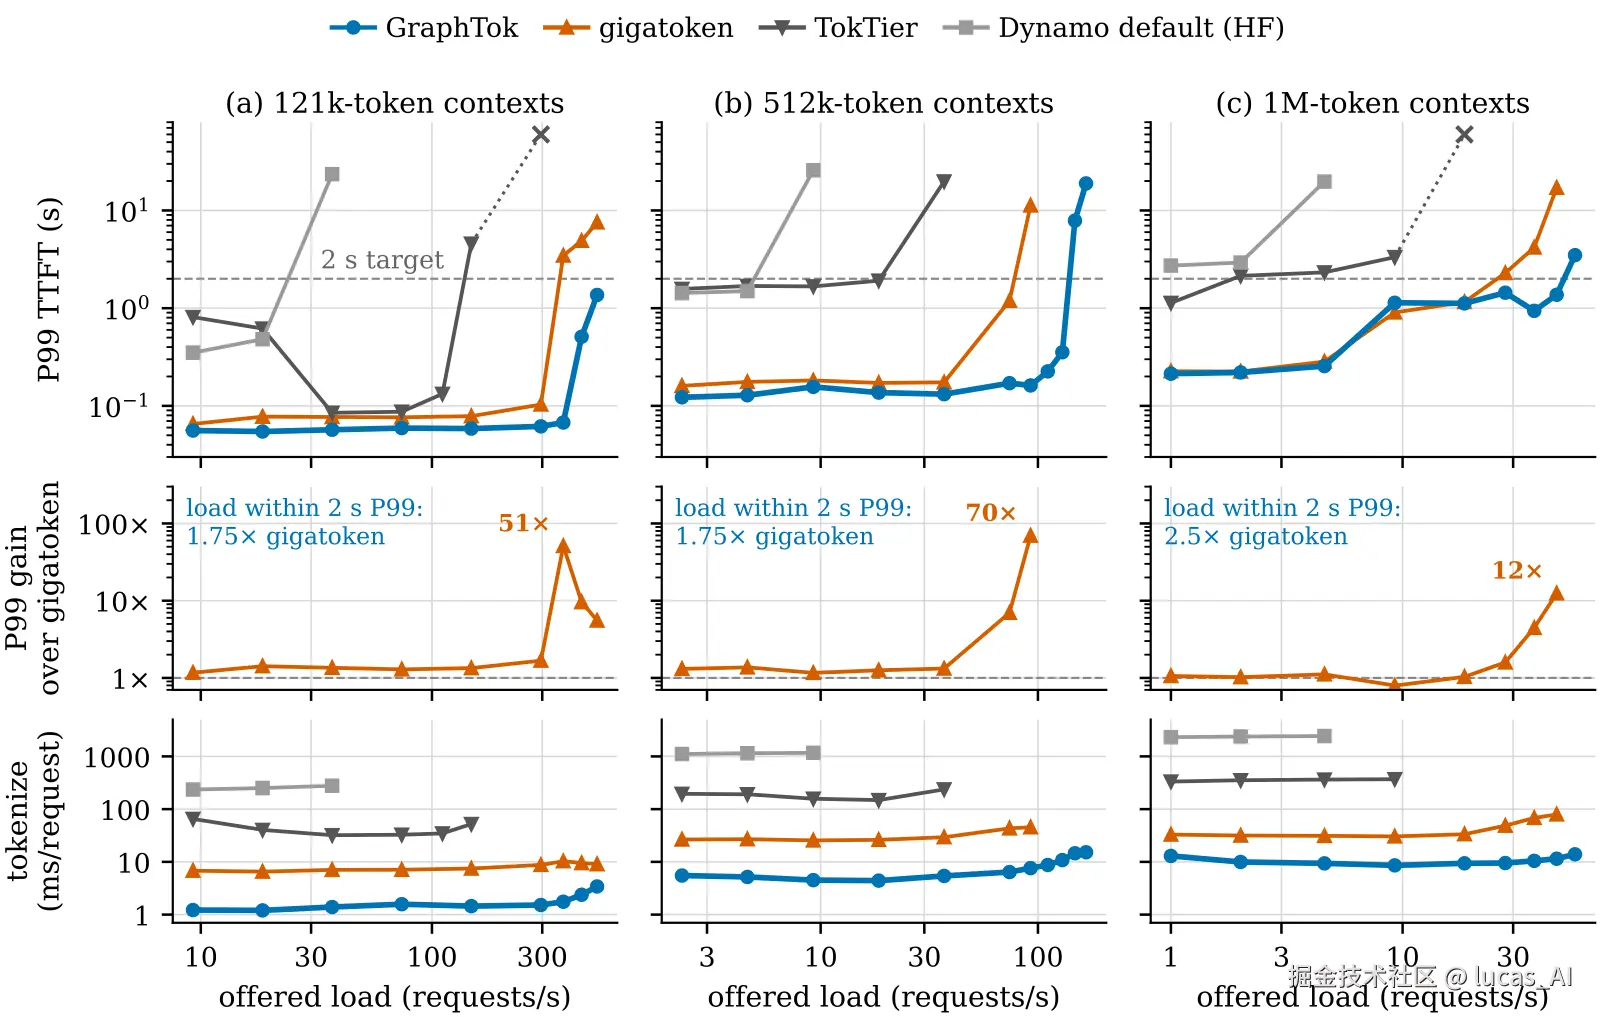
图说:横轴是负载(折合成多少张 GPU 在满速发请求),纵轴是 P99 首字延迟,虚线是 2 秒目标线。GraphTok(绿)的曲线最平、拐点最靠右;换成它之后,瓶颈已经不是分词,而是 Dynamo 自己的请求解析与路由路径------作者用一个「假分词器」对照实验证实了这一点。
还有一个容易被忽略的收益:把 CPU 还给 agent 。agent 平台一台机器上挤着上百个 agent 沙箱,编译、测试、检索全在抢 CPU。实测 128 个 coding agent 和前端挤同一台 96 核机器时,GraphTok 每次调用的 CPU 开销只有 gigatoken 的 1/8.7------省下的核全还给了 agent 的工具调用。而它借的 GPU 资源呢?不到推理空闲算力的十分之一,模型吞吐变化 1.1%,在测量方差之内,等于白借。
💡 为什么你要关心?
如果你的工作和 LLM serving 沾边,这篇论文至少有三件事和你直接相关:
- 自建 vLLM / Dynamo 的团队 :接入成本几乎是变量级的------vLLM 走 tokenizer 工厂钩子(不改源码),Dynamo 加一个
DYN_TOKENIZER=graphtok环境变量。如果你的流量里 agent 占比高(前缀复用 >90%),这是今年性价比最高的一次 TTFT 优化试点。 - agent 平台工程:「长上下文 + 高复用 + 小增量」的负载画像正在成为默认。分词、模板渲染、请求解析这些「非模型阶段」会一个接一个浮出水面------这篇论文等于提前给你画了张雷区地图。
- 做系统优化的所有人 :信号意义大于数字本身。GPU 内卷(attention、kernel、显存)卷到头之后,host 侧的固定开销成了新的主战场。论文结尾那句话值得抄下来:缓存和更快的 prefill 每削掉一分 GPU 份额,剩下的 host 阶段就多决定一分延迟------「每一个都得被搬走或干掉」。
换个角度看,GraphTok 的路线图其实指向「CPU-free 推理」:token 生成后不再回 CPU,整条请求链路都在 GPU 上闭环。分词只是第一块被搬走的砖。
🧊 理性看待
泼点冷水。精确性是按家族手工换来的:目前只支持五套具体分词器配置,碰到不支持的 tokenizer.json 直接拒绝启动(宁可不跑也不切错),新家族要再写一套边界谓词------通用性是有意 sacrificed 的。全部实验基于单张 H100 NVL,Dynamo 舰队实验的 GPU 侧是模拟的(结论限定于前端容量,不是端到端多机实测)。另外单引擎场景下,gigatoken 这类快速 CPU 分词器的 TTFT 与 GraphTok 差距只有 3--18%------如果你的服务独占机器、不和人抢 CPU,收益没有容量叙事那么性感。还有个细节:与 gigatoken 的主力对比是在清空其缓存的条件下做的,虽然论文用「图无缓存冷热同速」补了刀,但读数时心里可以有杆秤。
瑕不掩瑜。这是近期少有的「动机真实、方法闭环、测量诚实、读完就能上手试」的系统论文------尤其当你正被 agent 流量的 P99 折磨的时候。