大家好,我是一言,继续更新 Spring AI 2.0 系列。
前几篇一直在调整"怎么搜"。这次往前看一步:一份完整文档,应该切成多大的片段再入库?
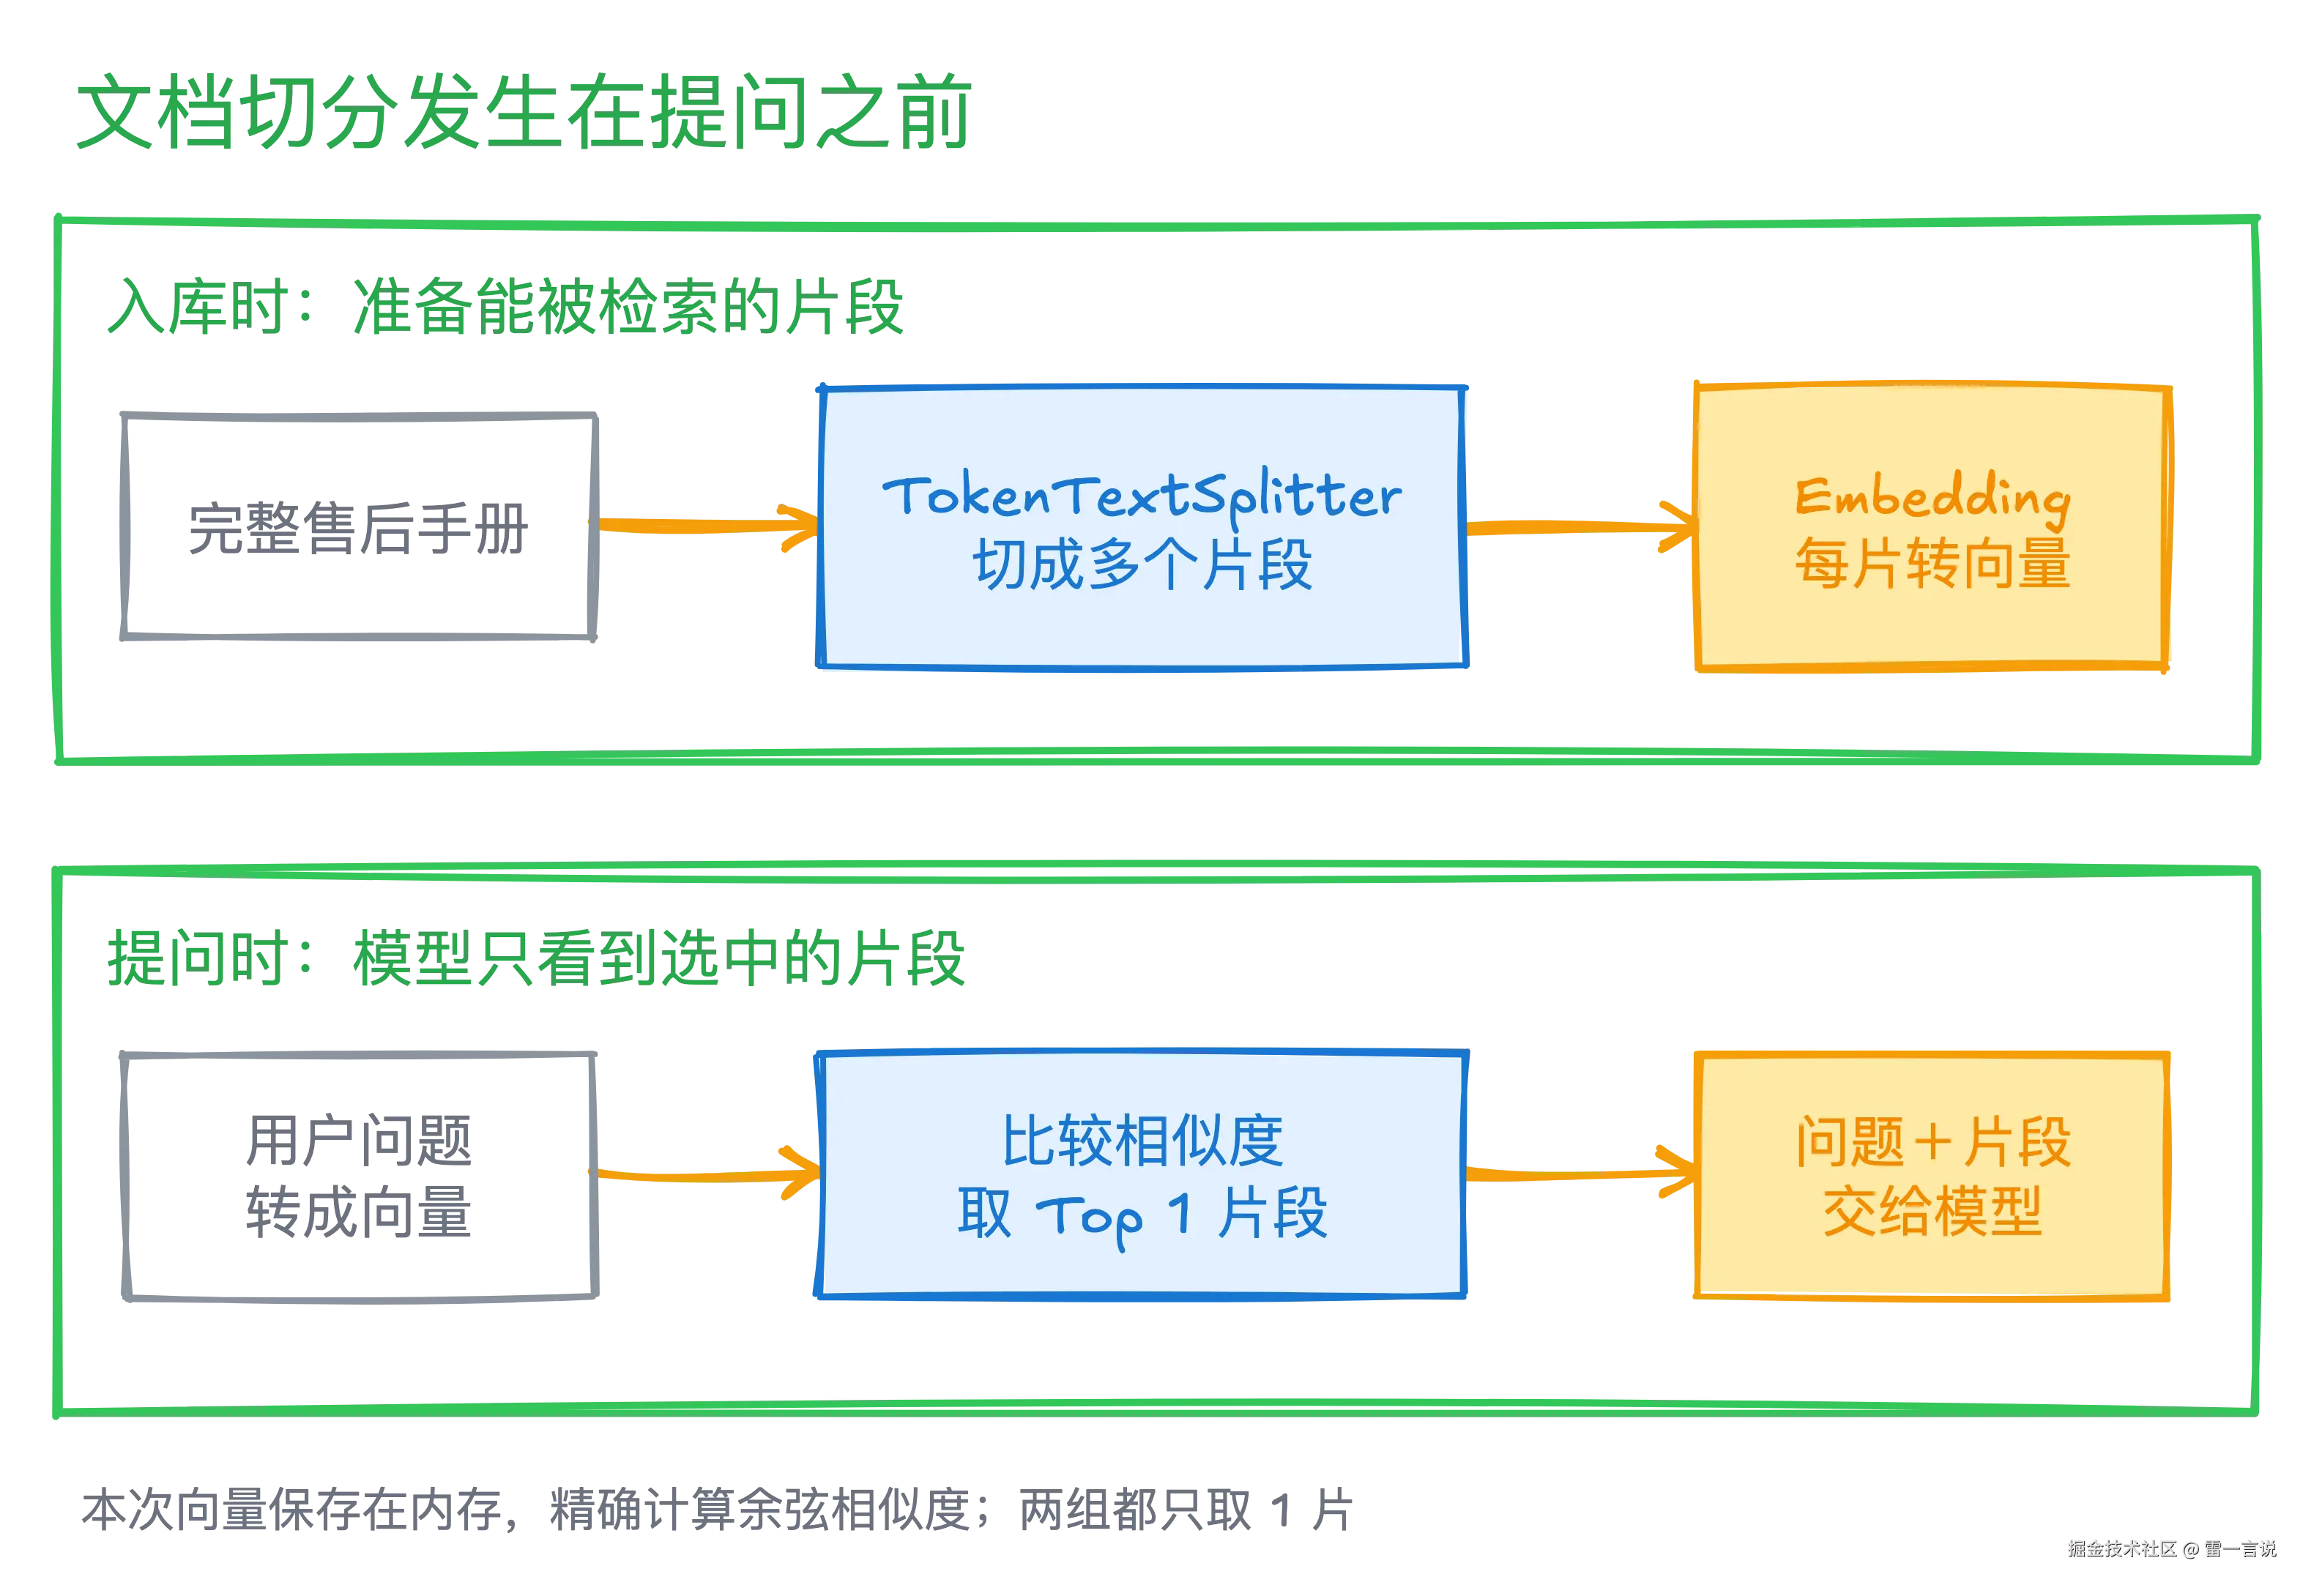
把文档切成片段后,检索就能选取与问题相关的部分,避免每次把整份文档交给模型。Spring AI 的 TokenTextSplitter 负责按 Token 数切分,切在哪里,会影响模型最终看到的内容。
Weaviate 官方用这张动图展示分块:Chunk 是片段,overlap 是相邻片段重复保留的文字。图中演示了重叠
我用同一份售后手册,对比了 180 和 480 两种分块大小。三道题都找到了对应规则,但片段边界和带入的文字量差了不少。
先看切的是什么
这是一份自编的演示手册,包含取消退款、退货条件、发票与地址修改三个部分。比如退款章节连续写着:
银行卡支付的订单取消后,退款通常在一至三个工作日内到账。
后面还有例外:
但如果原付款银行卡已注销,退款可能无法原路退回。
同一章又要求客服核验销户证明,转人工处理,不能直接承诺到账时间。检索时需要找到与用户情况对应的规则。
Spring AI 里怎么切
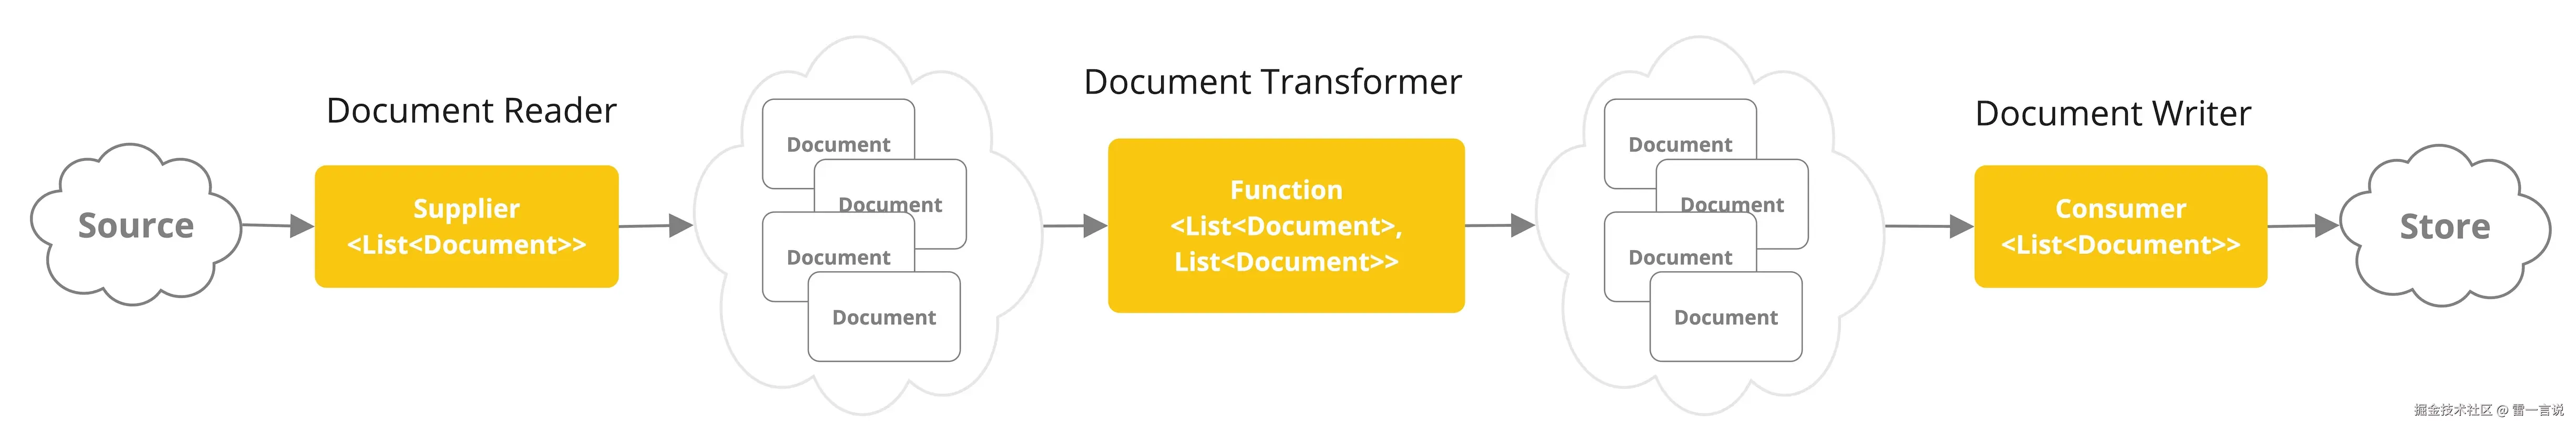
Spring AI 官方把文档入库分成三步:Reader 读取、Transformer 处理、Writer 写入存储。TokenTextSplitter 位于中间的处理环节。
读取文档后,交给 Splitter。两组只改 size,分别传入 180 和 480:
java
var text = new ClassPathResource("after-sales.txt")
        .getContentAsString(StandardCharsets.UTF_8);

var splitter = TokenTextSplitter.builder()
        .withChunkSize(size)
        .withMinChunkSizeChars(80)
        .withMinChunkLengthToEmbed(5)
        .withPunctuationMarks(List.of('。', '?', '!', ';', '\n'))
        .build();

var chunks = splitter.apply(List.of(Document.builder()
        .text(text)
        .metadata("source", "after-sales.txt")
        .build()));
这里有两个容易混淆的单位:
chunkSize是目标 Token 数,不能直接当作汉字数。minChunkSizeChars按字符计数,用于判断是否采用标点处的切分位置。
180、480 和 80 都是这次的对照参数。中文标点也显式配置了,方便观察句子边界。
测试固定使用 Java 21、Spring AI 2.0.1;Embedding 为 Qwen3-Embedding 0.6B,回答模型为 Qwen2.5 3B,均在本地运行。
切出来,边界在哪里
真实切分日志:
text
SPLIT chunkSize=180 chunks=5
SPLIT chunkSize=480 chunks=2
180 组把"退款通常多久到账"和"银行卡注销的例外"分到了相邻两片;480 组把它们放到了一起。
但看退货章节,情况反过来了:
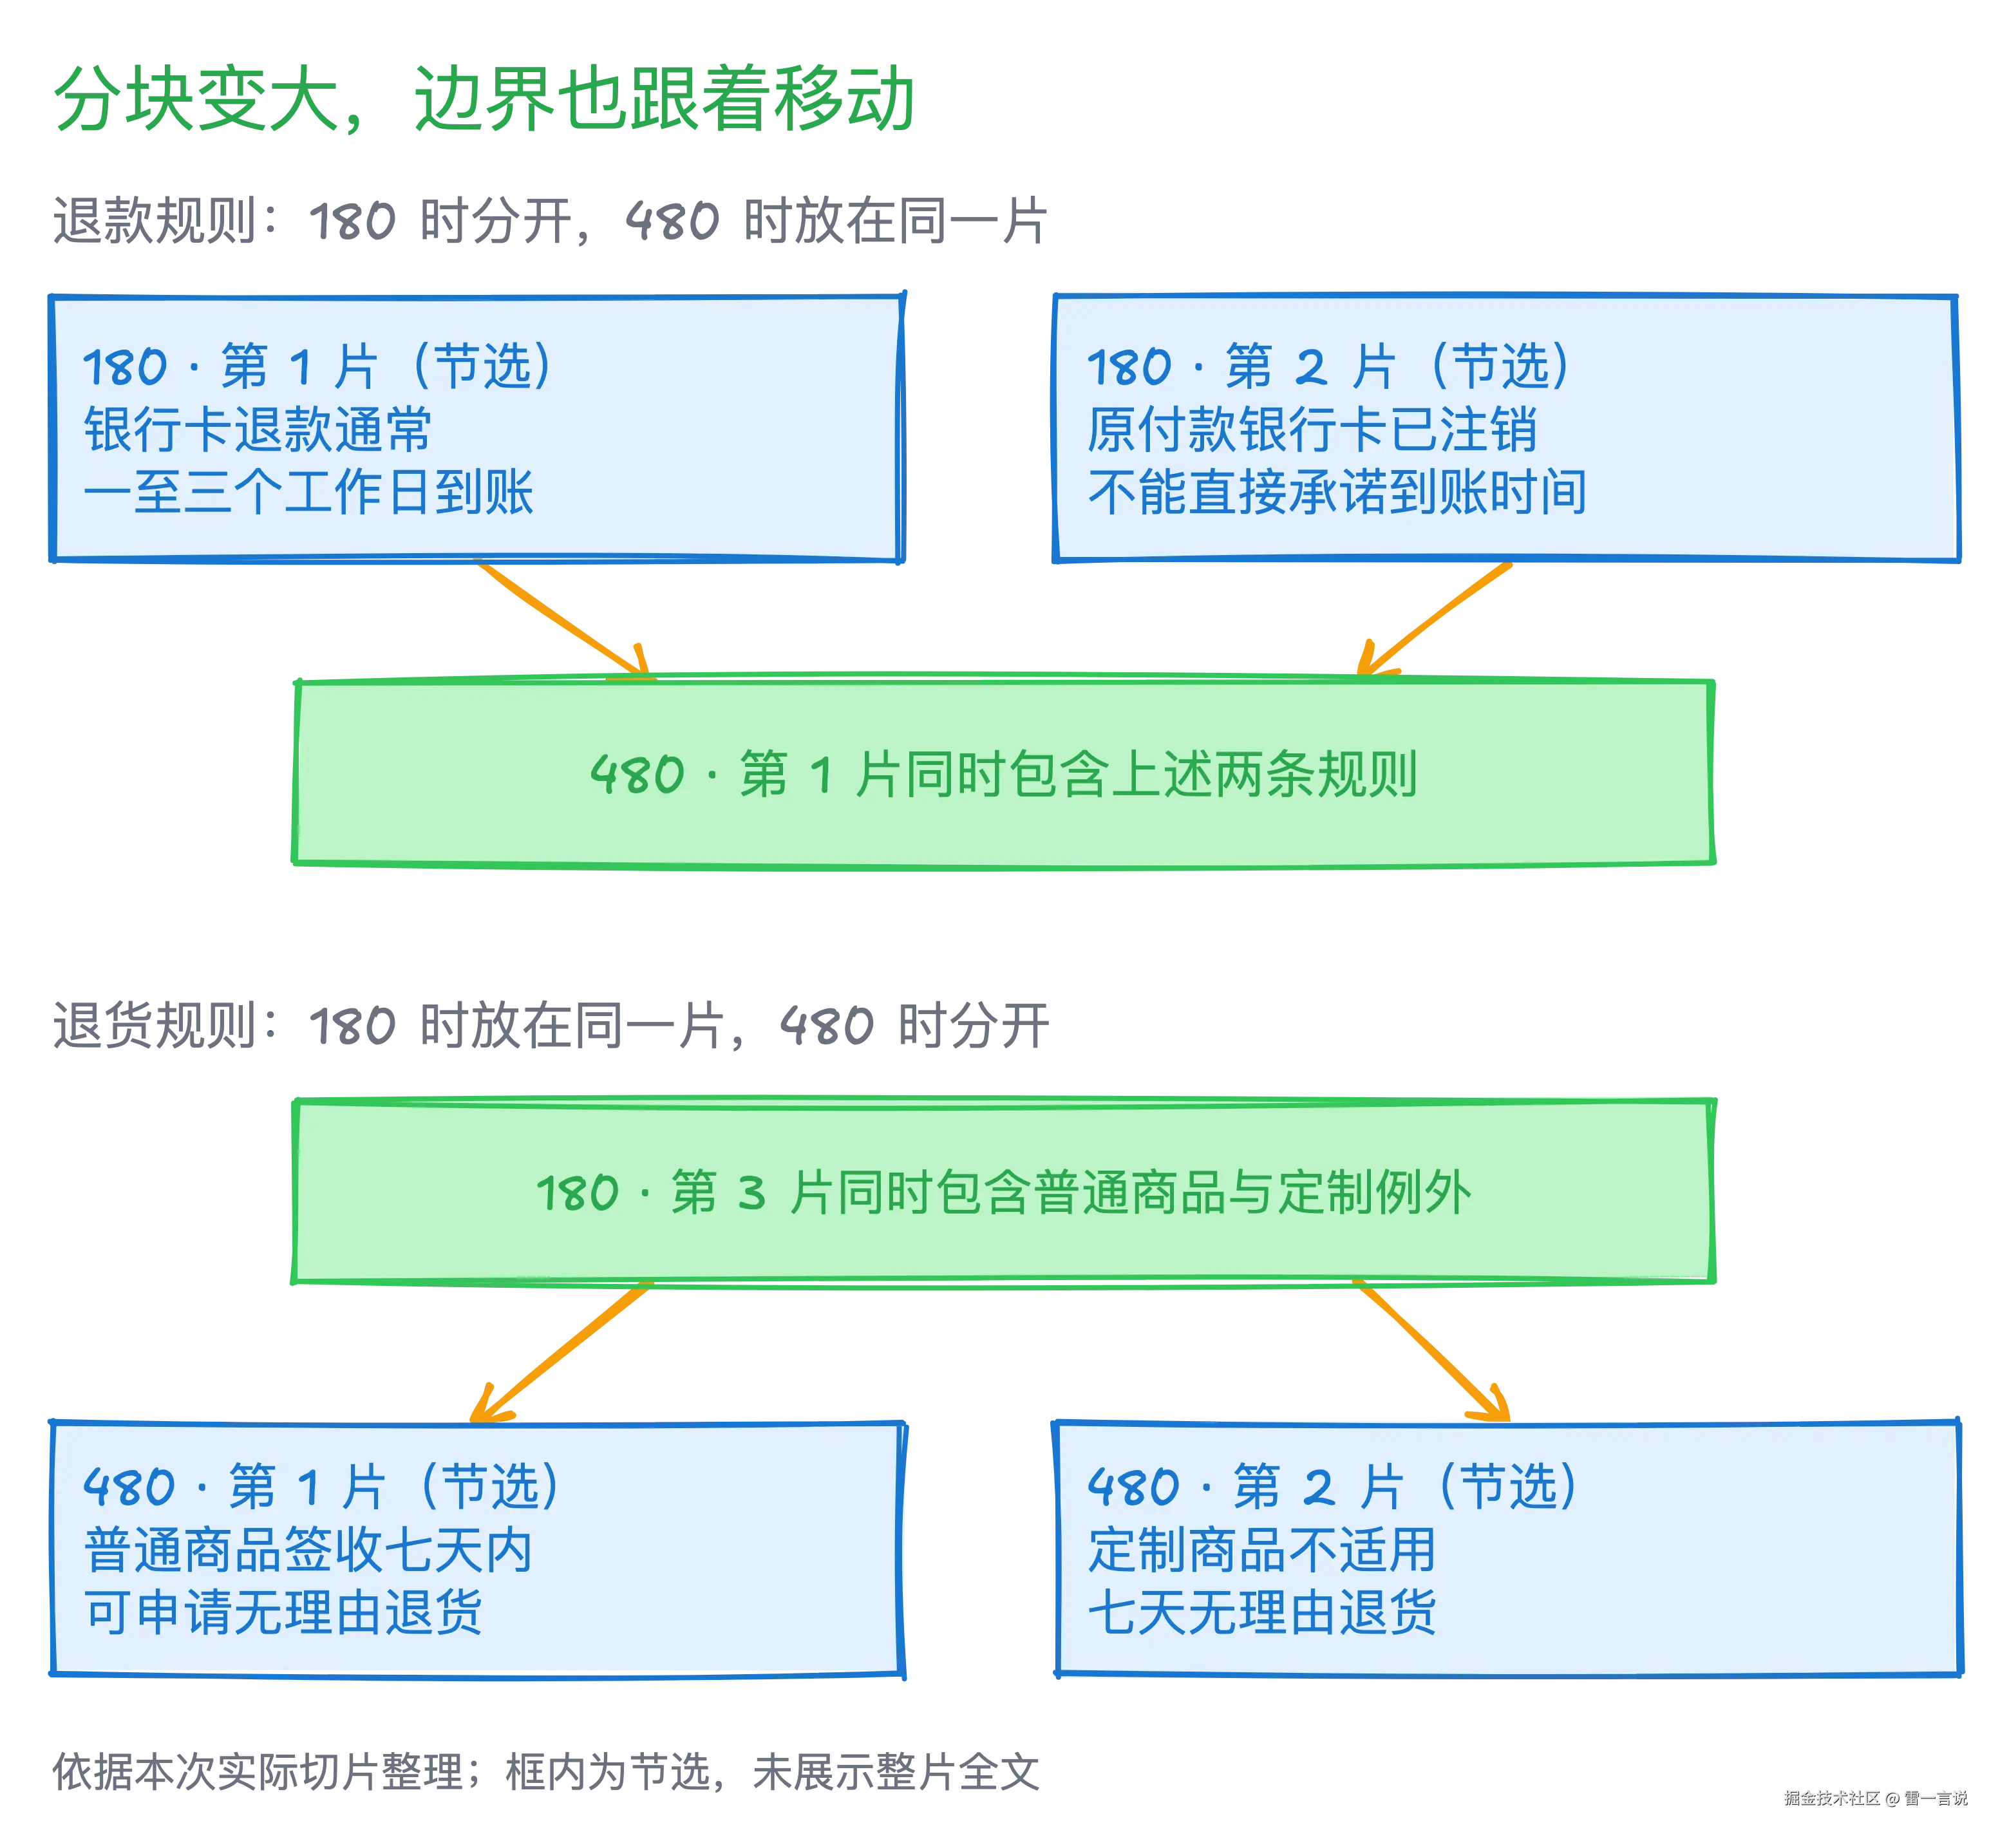
TokenTextSplitter 按 Token 和标点寻找切分位置,无法判断两条业务规则是否需要一起保留。调大分块会移动边界,不能保证每组规则都完整。
同样取一片,实际查到了什么
两组都在内存中按向量余弦相似度检索,只取排名第一的片段交给模型:
| 问题 | 180 组命中 | 480 组命中 |
|---|---|---|
| 银行卡注销,退款还能按时到账吗 | 第 2 片:包含注销例外 | 第 1 片:包含退款规则及例外 |
| 定制商品能七天无理由退货吗 | 第 3 片:包含普通与定制规则 | 第 2 片:包含定制规则 |
| 电子发票抬头写错了怎么办 | 第 5 片:包含发票重开流程 | 第 2 片:包含发票重开流程 |
三道题都找到了对应规则,但交给模型的文字量不同:
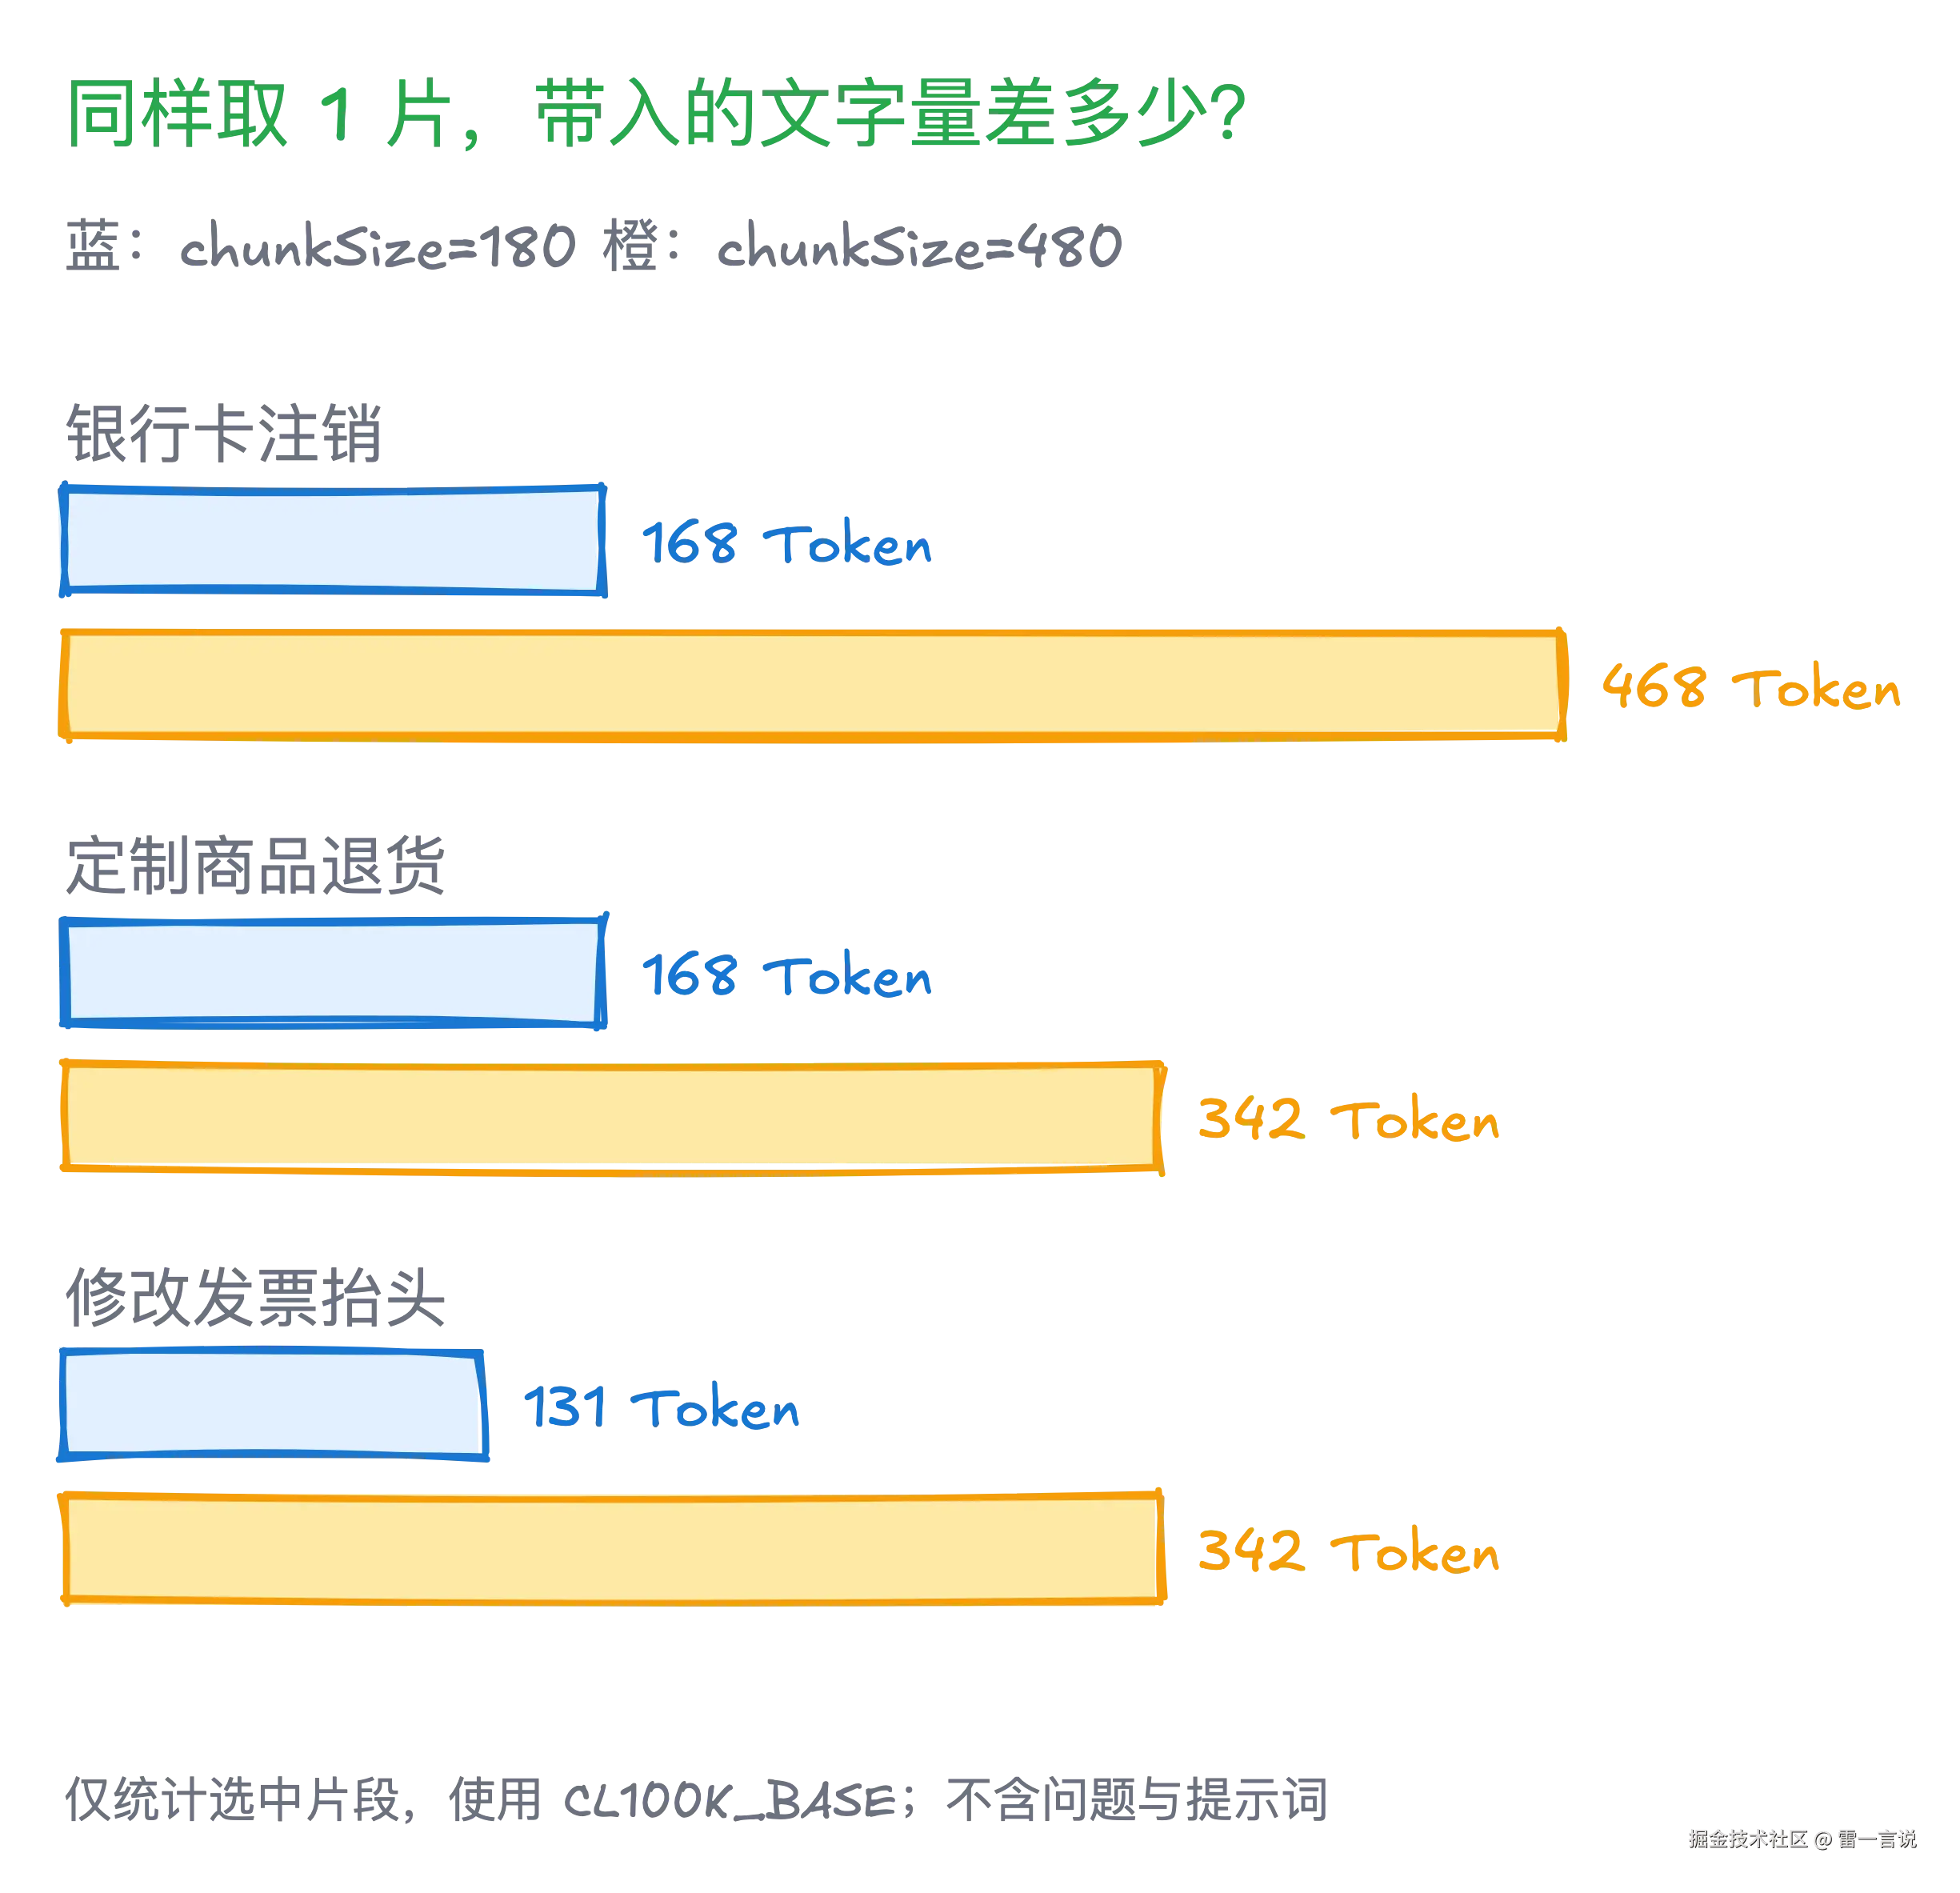
问发票抬头怎么改,两组都回答了"先红冲,再重开"。180 组带入 131 Token,480 组带入 342 Token,还包含退货运费、地址修改等无关内容。
本地执行:
bash
RUN_REAL_MODEL_TEST=true mvn test
text
Tests run: 2, Failures: 0, Errors: 0, Skipped: 0
BUILD SUCCESS
2 项测试通过,包含切分检查和六次真实模型调用;回答质量未计为通过率。
大小怎么选
先看切片全文:规则和例外被切开,就调整大小或文档组织;混入太多无关内容,就尝试缩小片段。每次调整后,用同一组问题检查检索结果。180 和 480 都只是这次的对照值。