📚 本文是《AIGC 人话系列》第 2 篇 > 系列目录:01 内容理解|02 RAG(本篇)|03 三招选型|04 工具清单|05 动手实战|06 踩坑|07 行业观察
上一篇我们聊完了「向量」,这一篇讲怎么用向量,把 AI 从「只会背书」改造成「会翻书」。
引子:一个能把 AI 问懵的问题
先问你一个简单问题:
我们公司的年假有多少天?
你把这句话原封不动丢给任何一个大模型,它会怎么做?
它会一本正经地编一个答案。可能是 5 天,可能是 15 天,看起来还很自信。
但如果你顺手把《员工手册》一起丢给它,再问同样的问题------它大概率能答对。
同一个模型、同一个问题,差别只在于:这一次,它有资料可翻了。
这中间的技术,就叫 RAG。
一、先搞明白:大模型的「记忆」其实是假的
很多人以为大模型像一个随时能查的数据库,其实不是。
训练一个大模型,更像是考前把一屋子书背下来:
- 背完之后,脑子里剩下的是压缩过的印象,不是原文
- 训练之后发生的新事(你公司的规定、今天的新闻),它完全不知道
- 细节也记不准,记住个大概,细节就开始「合理推测」
所以大模型有三个天生的短板:
| 短板 | 表现 |
|---|---|
| 知识过期 | 不知道训练之后的事 |
| 不懂私有资料 | 不知道你公司的文档 |
| 细节不准 | 会「幻觉」,编得还很像真的 |
关键洞察 :这三个问题的本质都是同一个------它脑子里没有那份资料。
那解决办法就很朴素了:既然它记不住,那就别让它记,改成开卷考试。
二、RAG 是什么?给 AI 配一个图书馆
RAG 全称 Retrieval-Augmented Generation,中文叫「检索增强生成」。别被这名字吓到,拆开看就三件事:
| 英文 | 中文 | 人话 |
|---|---|---|
| Retrieval | 检索 | 先从你的资料里,找出最相关的几段 |
| Augmented | 增强 | 把这几段塞进它要回答的问题里 |
| Generation | 生成 | 它照着这几段话,组织出答案 |
一句话总结:
不让 AI 硬背,改成开卷翻书。
用图书馆打比方
想象你要找一个超级学霸实习生 干活。他博览群书,但从没来过你公司,也没看过你公司的任何文件。
这时候你有两个选择:
- 让他硬背(= 微调模型):把公司规定塞进他脑子里。成本高、改一次要重背一次。
- 给他配个图书馆 + 管理员(= RAG):文档整理好书架,他每次答题前先去借几页。
显然后者更快、更便宜、改起来也方便。RAG 就是那个「图书馆 + 管理员」。
角色对照表
| RAG 里的组件 | 图书馆里的角色 |
|---|---|
| 你的文档(PDF/Word/网页) | 一屋子的书 |
| 切分(Chunk) | 把书拆成一页页 |
| 向量化(Embedding) | 给每一页贴一张「内容标签」 |
| 向量数据库 | 按标签排好序的书架 |
| 检索器(Retriever) | 管理员:你说要啥,他去拿 |
| 大模型(LLM) | 拿到几页就能答题的学霸 |
上一篇讲过的 Embedding,在这里终于派上用场------它就是那张「内容标签」,让书架上意思相近的页面挨在一起。
三、完整流程长这样
RAG 其实有两条流水线:一条是提前把资料建好库,一条是每次提问时跑的。
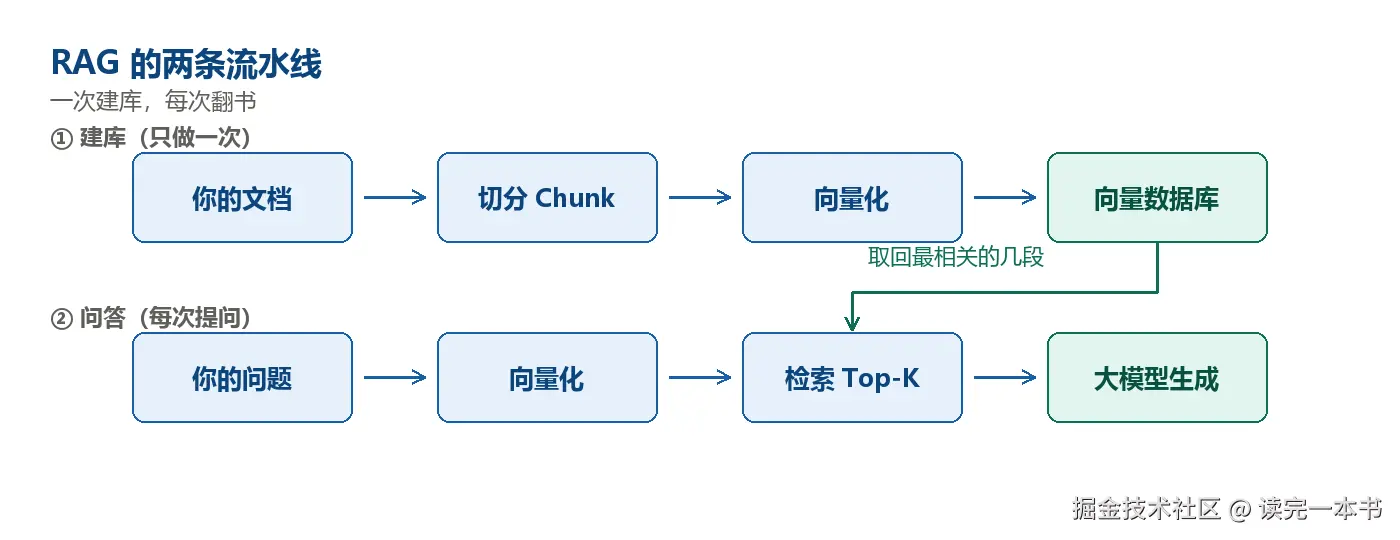
看明白了吗?"检索"这一步,本质是一场超大规模的"找相似"。
你的问题和文档里的每一段,都被变成了向量。谁的向量离你的问题最近,谁就是「最相关的那几段」,被捞出来塞进提示词。
四、为什么说「切分」才是 RAG 的胜负手
大部分人第一次搭 RAG,效果都很差。然后到处换模型、换向量库、调参数------但八成问题出在最不起眼的一步:切分。
| 切分方式 | 后果 |
|---|---|
| 切得太大 | 一段塞满噪音,模型抓不住重点 |
| 切得太小 | 语义被切碎,「它」指的谁都不知道了 |
| 硬按字数切 | 表格、代码被拦腰切断,直接报废 |
一句话:垃圾进,垃圾出。 资料切得乱七八糟,后面再高级的模型也救不回来。
好的切分讲究两点:
- 按语义边界切------按段落、按小标题,而不是按第 500 个字
- 留一点重叠(overlap)------相邻两段共享几十个字,避免关键信息正好落在接缝上
五、20 行代码,看个大概
原理讲完了,实际用起来其实就这么几步(伪代码,看得懂就行):
python
# ① 建库(做一次)
docs   = load("员工手册.pdf")
chunks = split(docs, size=500, overlap=50)   # 切分,留 50 字重叠
vectors = embed(chunks)                      # 每段变成向量
db.add(vectors, chunks)                      # 存进向量数据库

# ② 问答(每次提问)
q = "我们公司的年假有多少天?"
hits = db.search(embed(q), top_k=3)          # 找出最相关的 3 段

prompt = f"""
请严格根据以下资料回答问题,资料里没有的就直说不知道。

【资料】
{'\n'.join(hits)}

【问题】{q}
"""

answer = llm(prompt)                         # 让模型照着资料组织答案
注意 prompt 里那句「资料里没有的就直说不知道」------这一句能挡掉一大半的幻觉,是 RAG 的隐藏保命符。
六、RAG 到底能干嘛
- 企业知识库问答:把公司文档喂进去,新人自助查规章制度
- 智能客服:答案从产品手册里来,而不是模型瞎编
- 个人第二大脑:笔记、论文、收藏夹,全部变成可提问的资料库
- 长文档理解:几百页的合同,直接问「违约金是多少」
七、泼盆冷水:RAG 不是万能药
RAG 很实用,但它也不是银弹。它的失效方式非常典型:
| 症状 | 真正的原因 |
|---|---|
| 答得像模像样但不对 | 检索没检索到------库里根本没有那段资料 |
| 检索到了却答歪 | 模型没用好那几段,提示词没写清 |
| 简单问题能答,复杂问题崩 | 多跳问题(要串好几处信息)依然很难 |
| 明明有资料却说不知道 | 切分把关键信息切丢了 |
所以调试 RAG 的正确姿势是:先看检索结果,再看生成结果。 十次有八次,问题出在检索那一步。
写在最后
RAG 其实就三句话:
- 别让模型硬背,改成开卷翻书
- 流程是 检索 → 增强 → 生成
- 效果好不好,八成看切分和检索
上一篇我们讲了「向量」,这一篇讲的是「怎么用向量」,两篇连起来看,AIGC 应用的地基就打好了。
下一篇,我们聊 Prompt、微调、RAG 到底该用哪个------很多人一上来就选错,白花了不少钱。
如果这篇对你有用,欢迎点赞收藏。也欢迎在评论区聊聊:你踩过 RAG 的哪些坑?