一、引言
Spark 最早的核心抽象是 RDD,它让用户用函数式 API 表达分布式计算逻辑。RDD 很灵活,但这种灵活性也意味着 Spark 很难理解用户代码的"语义":一个map 里到底是在过滤字段、转换类型,还是做复杂业务逻辑,系统通常无法可靠判断。
随着 Spark SQL、DataFrame 和 Dataset API 的出现,Spark 开始获得更结构化的计算描述。SQL 和 DataFrame 操作天然包含关系代数语义,例如select 、filter 、join 、groupBy 。这让系统有机会像传统数据库一样分析查询逻辑,并在真正执行前做优化。
Catalyst 正是在这个背景下出现的:Spark 需要一个既能服务 SQL,又能服务 DataFrame/Dataset,并且足够可扩展的查询优化器。简单说,Catalyst 解决的是三个问题:
| 问题 | 没有 Catalyst 时 | 有 Catalyst 后 |
|---|---|---|
| SQL 如何执行 | 直接翻译成执行任务,优化空间有限 | 先生成逻辑计划,再逐步优化 |
| DataFrame 如何优化 | API 调用难以统一处理 | DataFrame 与 SQL 进入同一优化管线 |
| 扩展能力如何实现 | 每加一种优化都可能侵入执行引擎 | 通过规则、策略、扩展点逐步增强 |
二、Catalyst是什么
Catalyst 可以理解为 Spark SQL 的"编译器前端 + 查询优化器"。
用户写的 SQL 或 DataFrame 代码,并不会立即变成分布式任务。Spark 会先把它变成一棵逻辑计划树,然后经过解析、校验、优化、物理计划选择、代码生成等阶段,最后才提交给 Spark 执行。
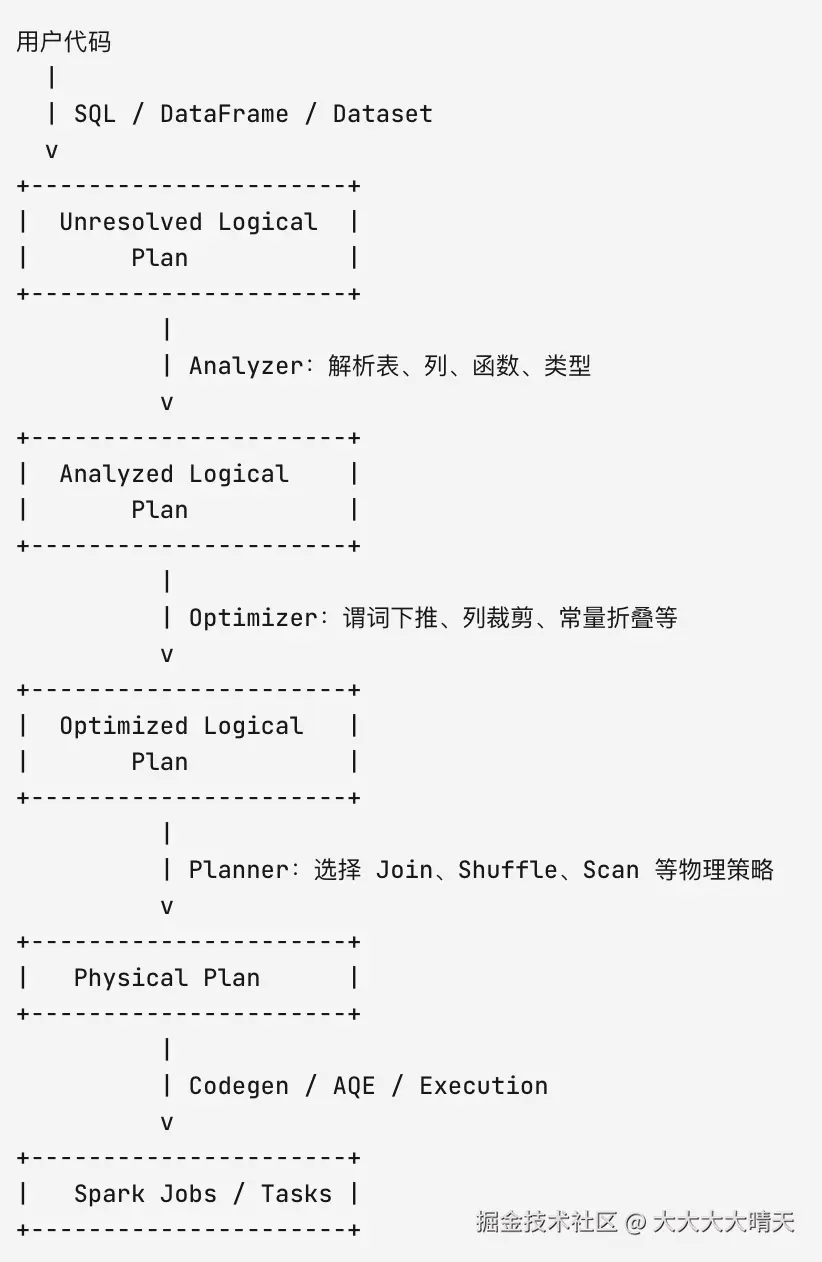
Catalyst 不是只优化 SQL 字符串。只要你使用 Spark SQL、DataFrame 或 Dataset API,最终都会进入 Spark SQL 的逻辑计划与优化体系。
三、架构原理
Catalyst 的底层模型是"树 + 规则"。
在 Catalyst 中,查询计划、表达式、逻辑算子、物理算子都可以表示成树。树上的每个节点代表一个操作,例如扫描表、过滤、投影、聚合、Join。优化过程就是不断匹配树上的某些模式,并把它们改写成更好的形式。
一个简单 SQL:
sql
SELECT name
FROM users
WHERE age > 18 AND country = 'CN'
可以抽象成类似下面的逻辑树:
css
Project [name]
    |
 Filter [age > 18 AND country = 'CN']
    |
 Relation [users]
如果底层数据源支持谓词下推,Catalyst 或相关数据源规则可能把过滤条件尽量推近数据读取层:
ini
Project [name]
    |
 Scan users
   PushedFilters: [age > 18, country = CN]
   ReadColumns:   [name, age, country]
这类优化的直觉很简单:越早过滤、越少读取、越少传输,后续计算压力越小。Catalyst在逻辑优化阶段的常见规则包括常量折叠、谓词下推、投影裁剪、空值传播、布尔表达式简化等。
四、四个核心阶段
Spark SQL 使用 Catalyst 的过程分为四个阶段:分析逻辑计划、逻辑优化、物理规划、代码生成。
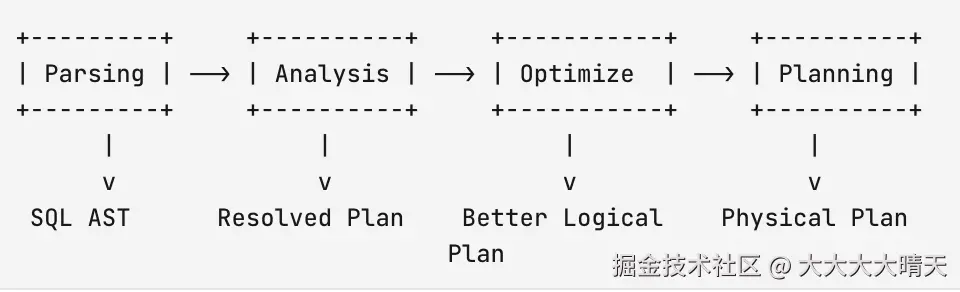
- 解析与未解析逻辑计划
用户提交 SQL 或 DataFrame 操作后,Spark 首先得到一个未解析逻辑计划。这里的"未解析"是指,计划里可能还不知道某个字段来自哪张表、字段类型是什么、函数是否存在。
例如:SELECT col FROM sales,在查询刚被解析时,sales 是否存在、col 是否是合法字段、col 的类型是什么,都需要后续结合 Catalog 元数据确认。
- Analysis 阶段
Analyzer 会结合 Catalog 解析表名、列名、函数、类型,并完成类型推断和类型强制转换。Spark SQL 会从包含未绑定属性和数据类型的未解析逻辑计划开始,然后用规则查找关系、映射属性、分配唯一 ID、传播和强制转换表达式类型。
可以把 Analyzer 理解为"语义校验器":
markdown
Unresolved Plan
    |
    | 查 Catalog:表是否存在
    | 查 Schema:列是否存在
    | 查 FunctionRegistry:函数是否存在
    | 类型推断与类型转换
    v
Analyzed Logical Plan
常见的字段不存在、表不存在、函数不存在、类型不兼容,通常都会在这个阶段或相邻阶段暴露出来。
- Logical Optimization 阶段
逻辑优化阶段不会直接关心集群资源,也不决定最终是否使用 Broadcast Hash Join 或 Sort Merge Join。它主要改写逻辑计划,让计划在语义不变的前提下更简单、更高效。
| 优化类型 | 含义 | 例子 |
|---|---|---|
| Predicate Pushdown | 把过滤条件尽量下推 | 先过滤再 Join |
| Projection Pruning | 只读取必要列 | select name 不读无关列 |
| Constant Folding | 编译期计算常量表达式 | 1 + 2 变成 3 |
| Boolean Simplification | 简化布尔表达式 | a = true AND true 简化 |
| Null Propagation | 利用空值规则简化表达式 | 某些表达式遇到 null 可提前判断 |
一个常量折叠的简化示意:
sql
原始表达式树:

        Add
       /   \
      x    Add
          /   \
         1     2

优化后:

        Add
       /   \
      x     3
Catalyst 的规则会分批执行,并且每个批次可以运行到 fixed point;这让单条规则可以保持简单,但多条规则组合起来仍能产生全局优化效果。
- Physical Planning 阶段
逻辑计划回答"要做什么",物理计划回答"怎么做"。同一个逻辑 Join,可以有多种物理实现:
sql
Logical Join
    |
    +--> Broadcast Hash Join
    |
    +--> Sort Merge Join
    |
    +--> Shuffle Hash Join
    |
    +--> Broadcast Nested Loop Join
物理规划阶段会基于数据大小、统计信息、Join 类型、配置参数、Hint 等信息选择执行策略。Spark SQL 会从逻辑计划生成一个或多个物理计划,并使用代价模型选择计划。
在实际工程中,你经常会通过explain() 看到类似这些物理算子:
css
BroadcastHashJoin
SortMergeJoin
HashAggregate
Exchange
Project
Filter
FileScan parquet其中Exchange 通常意味着 Shuffle 边界,是性能排查时需要重点关注的节点。
五、规则优化与代价优化
Catalyst 同时支持规则优化和代价优化。早期 Catalyst 主要以规则优化为主,后续 Spark SQL 引入了更完整的 CBO 能力,用统计信息辅助 Join 顺序、Join 策略等决策。
规则优化依赖确定性的改写规则。例如:
sql
SELECT *
FROM orders
WHERE dt = '2026-09-28'如果orders 是按dt 分区的表,那么过滤条件可能帮助 Spark 只扫描相关分区。虽然具体行为还取决于表格式、Catalog、数据源实现和配置,但"尽量减少扫描范围"是逻辑优化和数据源下推的重要方向。
规则优化的优点是稳定、可解释、实现相对简单。缺点是它不一定知道真实数据分布。例如,它知道filter 应该尽量提前,但未必知道过滤后到底剩多少数据。
CBO 依赖统计信息,可收集并使用列级统计信息,例如基数、不同值数量、NULL 数、最大值、最小值、平均长度和最大长度等,以改进执行计划质量。Spark 选择执行计划的能力部分取决于它对执行计划中各节点输出行数的估计,而这些估计来自数据源、Catalog 或运行时统计信息。
CBO 的典型收益体现在 Join 场景:
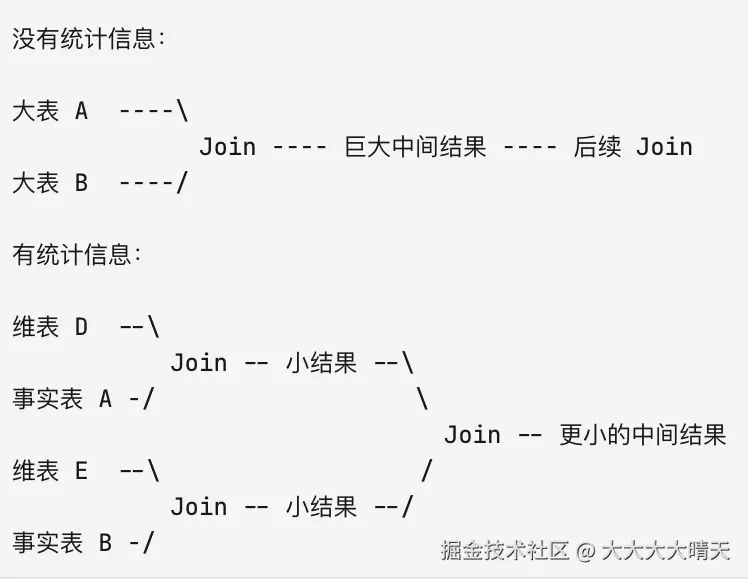
启用 CBO 后 Spark 通过更优 Join 计划降低中间数据量,当 Spark 知道某个过滤条件会把 500GB 表过滤到 100MB,它就可能选择完全不同的 Join 构建边或 Join 顺序。
六、AQE 与 Catalyst 的关系
Adaptive Query Execution,简称 AQE,是 Spark SQL 的运行时自适应优化机制。它不是 Catalyst 的替代品,而是与 Catalyst 查询优化体系协同工作:Catalyst 在执行前生成计划,AQE 在执行过程中利用更准确的运行时统计信息调整计划。
| AQE 能力 | 解决的问题 |
|---|---|
| 合并 Shuffle 后的小分区 | 避免过多小任务 |
| 处理倾斜 Shuffle 分区 | 缓解数据倾斜导致的慢任务 |
| Sort Merge Join 转 Broadcast Join | 运行时发现一侧足够小 |
| Sort Merge Join 转 Shuffled Hash Join | 某些分区规模适合 Hash Join |
| Local Shuffle Reader | 减少不必要的网络读取 |
可以这样理解 Catalyst 与 AQE 的分工:
yaml
查询提交前:

SQL/DataFrame
    |
    v
Catalyst 生成初始优化计划
    |
    v
开始执行


查询执行中:

Shuffle 产生运行时统计
    |
    v
AQE 重新判断 Join / 分区 / 倾斜
    |
    v
调整后续执行计划这也是为什么有时explain() 看到的初始计划,与 Spark UI 中执行过程里的最终计划存在差异。对于 Spark 3.x 及以后版本,排查 SQL 性能时只看静态计划往往不够,还要结合 SQL UI 的 runtime statistics。
七、功能特性与适用场景
- 统一 SQL 与 DataFrame 优化:Spark SQL 和 DataFrame API 共享 Catalyst 优化链路。
- 可扩展规则体系:Catalyst 的规则是围绕树结构做变换,规则可以匹配某类节点,也可以在规则体中执行 Scala 代码。规则条件和规则体可以包含任意 Scala 代码,这让 Catalyst 比仅依赖优化器 DSL 的系统更灵活,同时对简单规则仍保持简洁。
- 数据源下推:Catalyst 与数据源能力结合后,可以把过滤、列裁剪、聚合等操作下推到数据读取层。这样 Spark 不必把所有数据都读进来再处理。
- Join 策略选择:包括自动广播 Join、Join Strategy Hints 等能力。
Catalyst 最适合发挥作用的场景,是查询逻辑清晰、数据源元信息较完整、表达式可被 Spark 理解的结构化计算。
| 场景 | Catalyst 价值 |
|---|---|
| 数仓 ETL | 自动优化过滤、投影、聚合、Join |
| 交互式 SQL 分析 | 减少无关扫描,提高响应速度 |
| 宽表明细查询 | 列裁剪减少 IO |
| 星型模型 Join | CBO 和 AQE 可改善 Join 顺序与策略 |
| Parquet/ORC 数据湖 | 结合列式存储和谓词下推减少读取 |
| 多租户 SQL 平台 | 统一优化 SQL 与 DataFrame 作业 |
| 自定义 Spark SQL 平台 | 可通过扩展点增加规则或函数 |
不太适合期待 Catalyst "自动救场"的场景:
| 场景 | 原因 |
|---|---|
| UDF 大量包裹业务逻辑 | 优化器难以理解 UDF 内部语义 |
| 数据严重倾斜但无治理 | AQE 能缓解部分问题,但不能替代建模治理 |
| 小文件极多 | Catalyst 不是文件管理系统 |
| 统计信息缺失或严重过期 | CBO 判断依据不足 |
| Join 条件复杂且不可等值 | 可选 Join 策略受限 |
| 数据源不支持下推 | 逻辑上能推,不代表物理上能推 |
八、与Apache Calcite的差异
在查询优化领域,Catalyst 经常与 Apache Calcite 放在一起讨论。两者都能把 SQL 转换成关系代数计划,通过规则和代价模型优化查询,但定位并不相同:Catalyst 是与 Spark SQL 执行引擎深度绑定的查询优化框架;Calcite 是供数据库、数据平台和查询引擎嵌入的通用数据管理与查询优化框架。
Apache Calcite 将自身定位为动态数据管理框架,提供标准 SQL 解析、关系代数、规则优化、代价优化以及数据源适配能力。它通常不负责完整的分布式执行,而是为上层系统提供解析和优化基础设施。
Catalyst 则是 Spark SQL 内部的一部分。它生成的物理计划直接面向 Spark 执行体系,能够选择BroadcastHashJoin 、SortMergeJoin 、Exchange 、HashAggregate 等 Spark 物理算子,并与代码生成、Shuffle、AQE 和 Spark UI 等机制结合。
| 对比维度 | Spark Catalyst | Apache Calcite |
|---|---|---|
| 核心定位 | Spark SQL 内置优化框架 | 通用、可嵌入的数据管理与查询优化框架 |
| 与执行引擎的关系 | 与 Spark 执行引擎深度绑定 | 通常由宿主系统提供执行能力 |
| 主要实现语言 | Scala | Java |
| 查询表示 | LogicalPlan、Expression、SparkPlan 等 | 以 RelNode 为核心 |
| 规则执行方式 | 按批次执行规则,部分批次迭代到固定点 | 可使用 HepPlanner、VolcanoPlanner 等不同规划器 |
| 物理属性表达 | 通过分区、排序要求和 Spark 物理算子等机制表达 | 使用 Trait、TraitSet、Convention 等抽象表达 |
| 物理计划目标 | 生成可由 Spark 直接执行的 SparkPlan | 生成符合宿主系统 Convention 的关系表达式 |
| 数据源接入 | 依托 Spark Data Source API 和 Catalog | 通过 Adapter 将外部数据表示为 Schema 和 Table |
| 运行时优化 | 与 AQE 深度结合,可利用 Shuffle 运行时统计调整计划 | 核心侧重规划;运行时重优化取决于宿主系统集成 |
| 典型使用者 | Spark SQL 用户、Spark 平台开发者 | 数据库、查询引擎、联邦查询和数据虚拟化平台开发者 |
| 使用方式 | 部署 Spark 即可获得,通常无需单独集成 | 作为依赖嵌入目标系统,需要自行完成执行层集成 |
九、常见问题
1.为什么我的谓词没有下推?
| 原因 | 说明 |
|---|---|
| 数据源不支持 | 不是所有数据源都能下推所有表达式 |
| 表达式过于复杂 | 复杂函数、UDF、类型转换可能阻碍下推 |
| 文件格式限制 | 不同格式支持能力不同 |
| 写法不利于识别 | 例如把字段包在复杂函数里 |
| 分区字段未直接过滤 | 分区裁剪需要清晰的分区条件 |
2.为什么没有使用 Broadcast Join?
| 原因 | 说明 |
|---|---|
| 小表超过阈值 | 超过 spark.sql.autoBroadcastJoinThreshold |
| 统计信息缺失 | Spark 不知道表足够小 |
| Join 类型不支持 | 某些策略不支持特定 Join 类型 |
| 广播被禁用 | 阈值设置为 -1 |
| Hint 不保证生效 | 官方说明 Hint 不保证一定被采用 |
3.为什么开启 AQE 后计划变了?
这是正常现象。AQE 的设计目标就是在运行时根据真实统计信息调整计划。比如初始计划是 Sort Merge Join,但运行时发现某一侧 Shuffle 后数据很小,就可能转为 Broadcast Hash Join。
4.为什么df.explain() 和 Spark UI 看到的不一样?
df.explain() 展示的是某个阶段的计划视图,而 Spark UI 中可能展示 AQE 调整后的计划和运行时统计。对于启用 AQE 的作业,最终执行计划可能与初始物理计划不同。
建议排查顺序:
markdown
1. 看 analyzed logical plan:字段、类型、函数是否解析正确
2. 看 optimized logical plan:过滤、列裁剪、常量折叠是否生效
3. 看 physical plan:Join、Exchange、Aggregate、Scan 是否合理
4. 看 Spark UI:运行时分区大小、倾斜、任务耗时、Shuffle 读写
5.为什么 UDF 会影响优化?
Catalyst 可以理解内置表达式的语义,但很难理解普通 UDF 内部做了什么。对 Catalyst 来说,myUdf 通常是一个黑盒。它不知道这个函数是否等价于age > 18 ,也就难以做谓词下推、常量折叠或表达式简化。
建议优先使用 Spark SQL 内置函数,只有在内置函数无法表达业务逻辑时,再使用 UDF。