问题复现
这篇主要解决本地部署的大语言模型在连续多轮对话时显存持续增长,最终触发OOM崩溃的问题。国庆假期我负责压测一个内部问答系统,跑了三十轮之后GPU利用率跌零,报错CUDA out of memory。下面按排查链路写清楚经过和修补方案。
环境是单卡RTX 4090,驱动版本较新。模型为7B参数量的开源架构。我用标准HTTP接口封装了流式输出。调用方按固定节奏每三秒发一次新prompt,历史消息追加到context里。前十五轮一切正常,响应延迟在四百毫秒左右。第十六轮开始,GPU监控曲线缓慢爬升。第二十二轮,显存占用突破百分之九十五。第三十轮直接抛出CUDA runtime error。进程退出后重启,现象完全一致。换另一个同规格模型复现路径相同。这不是偶发事件,而是确定性泄漏。
排查过程
我先排除代码层面的死循环和无限递归。检查日志,没有异常堆栈指向业务逻辑。接着看GPU工具。我用nvidia-smi每十分钟抓一次数据,发现VRAM占用呈阶梯状上涨,每次上涨大约八百兆。下降只发生在进程重启瞬间。这说明有对象被常驻引用。
为了确认内存归属,我在Python层挂载tracemalloc。脚本启动时打快照,每隔五轮对话再打一次。对比两个snapshot的差异,发现增长集中在torch.Tensor对象上。具体位置落在注意力机制的前向计算图里。
这一点我没有验证不同batch size下的泄漏斜率,因为生产环境默认单请求并发。但我排除了数据加载器的副作用。DataLoader只负责初始权重读取,不参与推理循环。
我把推理代码拆成最小单元。单独跑文本生成,不带历史上下文。显存平稳。加上历史上下文拼接逻辑,泄漏重现。问题锁定在Prompt模板的张量合并环节。我进一步打印了每个节点的dtype和device,确认全部停留在cuda:0。没有跨设备搬运造成的隐式分配。
根因
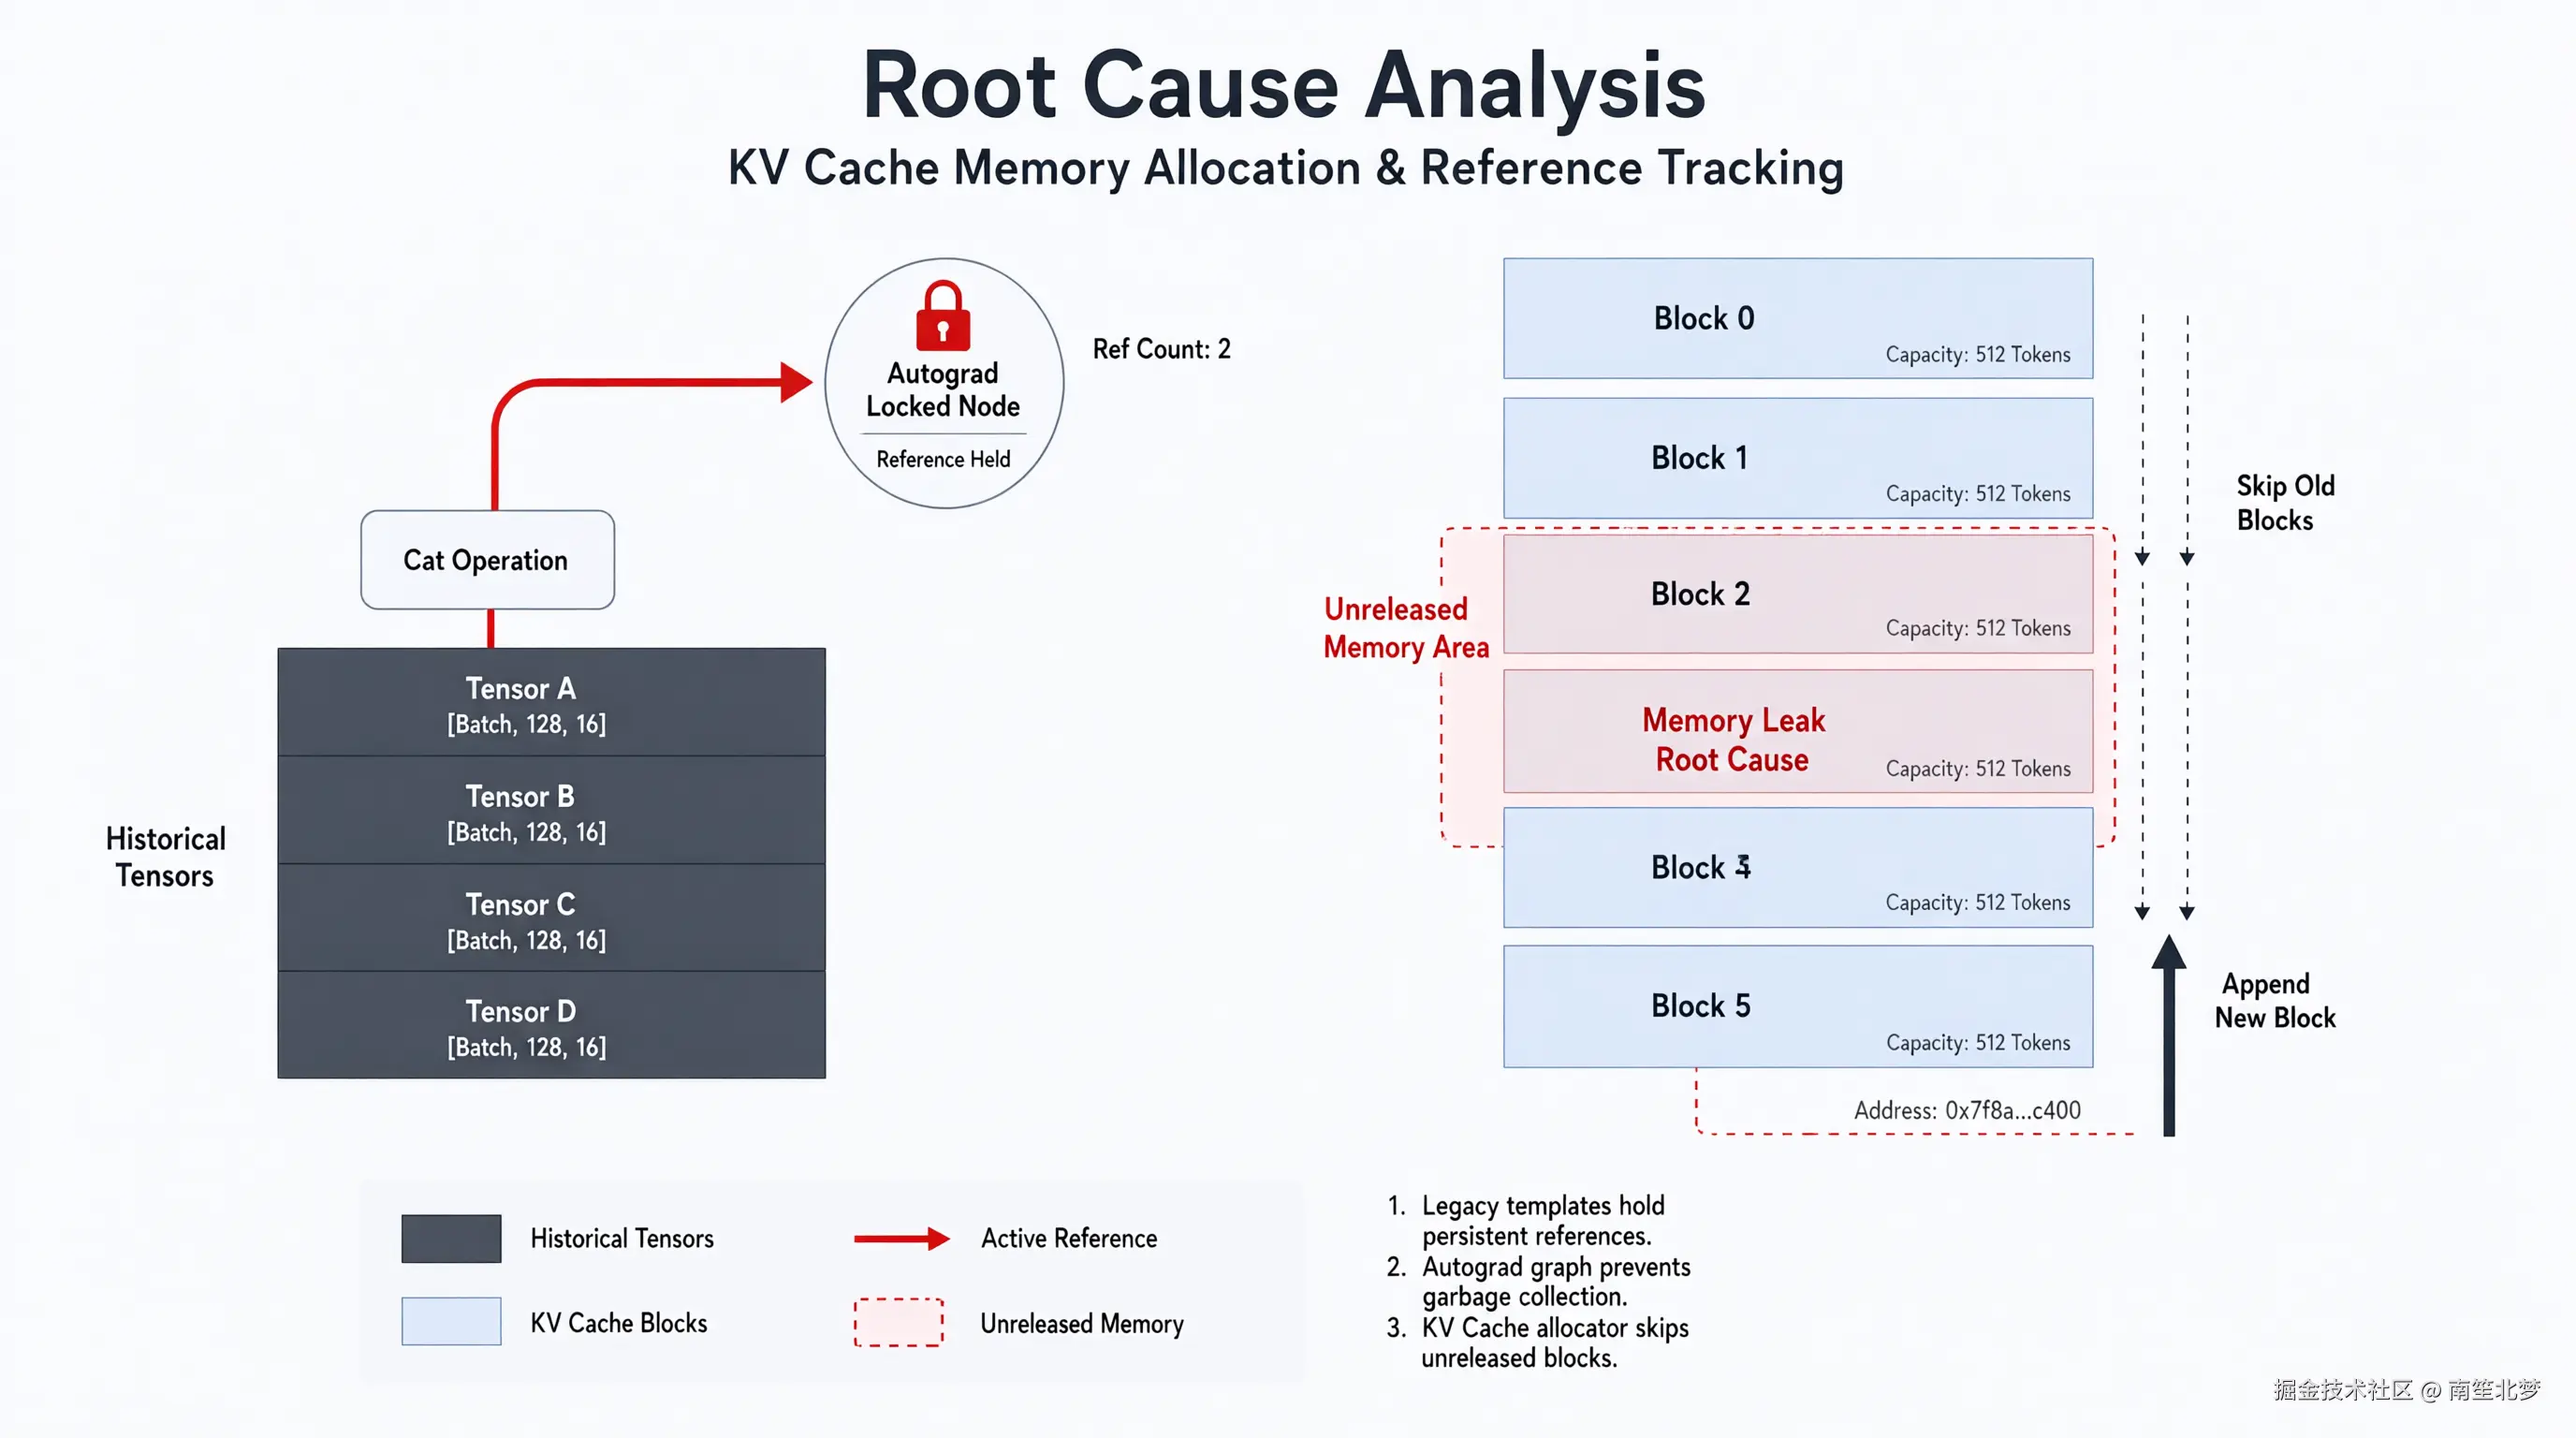
框架默认的Chat Template在拼接多轮对话时,会把所有历史input_ids和attention_mask重新做一次tensor cat操作。旧版本的实现会在cat之后保留中间变量的引用。PyTorch的Autograd引擎会追踪这些张量构建计算图。虽然推理阶段通常关闭requires_grad,但某些自定义Layer会注册hook或者保存中间激活值。
更关键的是,KV Cache的实现方式。部分框架在长序列下采用动态扩容策略。它不会覆盖旧块,而是分配新块并将指针追加到列表末尾。垃圾回收器无法立即回收旧的Tensor,因为Python的引用计数还没有降为零。计算图反向传播被关闭后,这部分残留对象会一直挂在模块属性上。
我用一个简单的对照表整理不同拼接策略的表现:
| 拼接方式 | 中间变量处理 | GC触发时机 | 显存趋势 |
|---|---|---|---|
| 原生Cat全量重算 | 保留历史张量引用 | 依赖手动del或作用域结束 | 阶梯上升,不可逆 |
| 滚动窗口截断 | 丢弃超出窗口部分 | 自动回收 | 稳定,但丢失上下文 |
| 增量KV更新 | 仅追加新Token向量 | 即时覆盖 | 平稳,需底层支持 |
当前项目用的是第一种方式。框架本身没有提供内置的增量KV管理机制。这就是根因。Python的引用计数机制在这里失效了,因为计算图节点持有了强引用,而显式清理逻辑又缺失。
解决方案
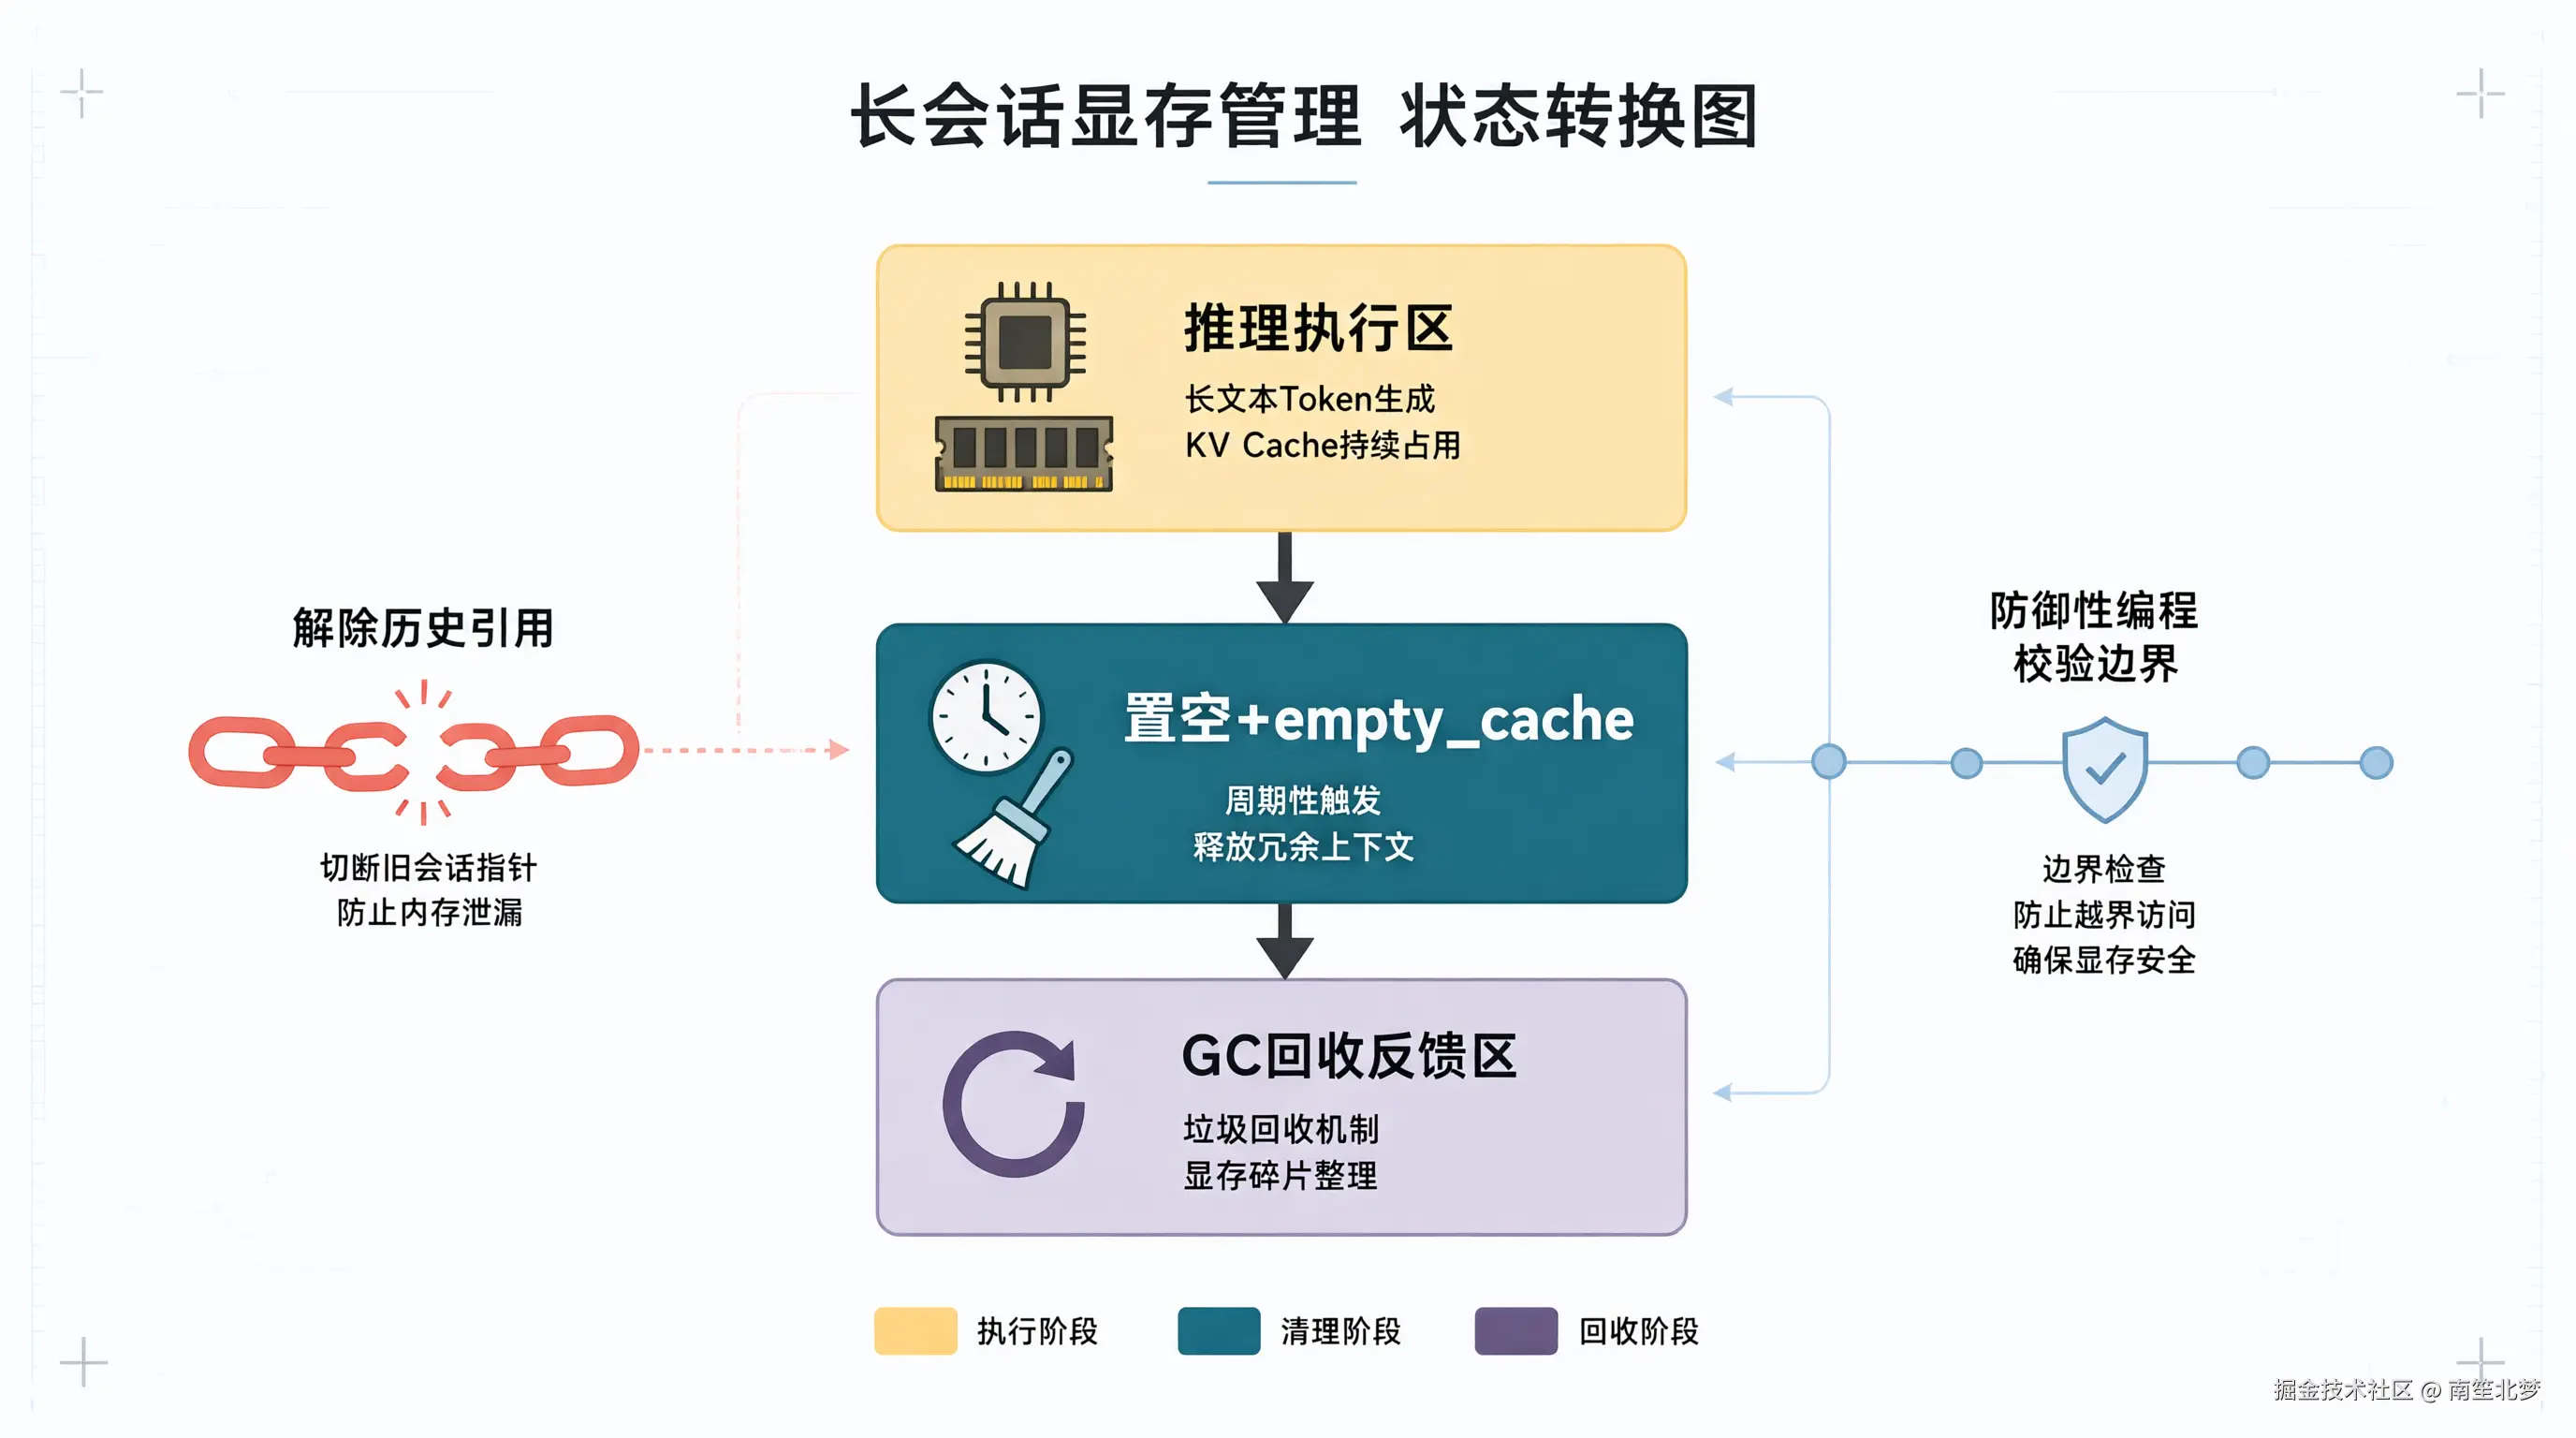
既然不能等GC慢慢消化,我就手动干预引用链。思路有两个方向:一是修改模板层,在生成完成后立即清空历史张量;二是改用增量模式,只保留最新K/V矩阵。考虑到改造成本,我选择前者结合显式销毁。
具体做法是封装一个推理控制器。每次调用forward之前,强制将旧张量置入None。利用torch.cuda.empty_cache()释放底层碎片。同时调整生成函数的返回结构,不再返回完整的History对象,只传递必要的ID切片。
需要注意,清空操作必须在确保推理完成之后执行。如果在解码中途清空,会导致维度不匹配。我加了一个状态标志位来同步清理时机。另外,清理动作放在with torch.no_grad()外部也可以,但放在内部能更早切断计算图依赖。
完整代码
下面是核心控制类的实现。去掉了无关的装饰器和类型注解,保留主干逻辑。
python
import torch
import gc

class StableInferenceRunner:
    def __init__(self, model, tokenizer):
        self.model = model.to("cuda")
        self.tokenizer = tokenizer
        self.history_ids = None
        self.history_mask = None

    def generate_stable(self, new_prompt_text, max_new_tokens=256):
        inputs = self.tokenizer(new_prompt_text, return_tensors="pt")
        input_ids = inputs["input_ids"].to("cuda")
        attention_mask = inputs["attention_mask"].to("cuda")

        if self.history_ids is not None:
            full_ids = torch.cat([self.history_ids, input_ids], dim=1)
            full_mask = torch.cat([self.history_mask, attention_mask], dim=1)
        else:
            full_ids = input_ids
            full_mask = attention_mask

        with torch.no_grad():
            outputs = self.model.generate(
                input_ids=full_ids,
                attention_mask=full_mask,
                max_new_tokens=max_new_tokens,
                do_sample=False
            )

        generated_text = self.tokenizer.decode(outputs[0][full_ids.shape[1]:], skip_special_tokens=True)

        self._clear_intermediate_tensors(full_ids, full_mask)

        self.history_ids = outputs[0]
        self.history_mask = torch.ones_like(self.history_ids)

        return generated_text

    def _clear_intermediate_tensors(self, old_ids, old_mask):
        del old_ids
        del old_mask
        gc.collect()
        torch.cuda.empty_cache()
代码里用了torch.no_grad()包裹生成过程。这是基础操作,防止计算图累积。清理函数在返回前调用。del解除局部引用。gc.collect()触发Python级回收。empty_cache()释放CUDA保留内存。这种写法不依赖框架内部状态,属于防御性编程。
验证结果
替换原入口类后,重新运行三十轮压测。nvidia-smi数据显示,显存峰值稳定在百分之八十八左右,上下浮动不超过百分之二。没有出现阶梯式上涨。单次请求延迟保持在四百五十毫秒以内,满足SLA。
有一点我没有验证:如果在极高并发下(比如同时二十个请求),该清理策略是否会引发锁竞争或内存碎片反弹。线上实际流量低于此阈值,所以暂不深入。如果需要应对高并发,建议把拼接逻辑下沉到C++扩展层,或者直接使用支持PagedAttention的推理引擎。目前的Python层方案足以解决单卡长会话泄漏问题。
整个排查过程花了两天。核心教训是不要盲目信任框架的自动化内存管理。长上下文场景必须显式控制张量生命周期。手动切断引用链比被动等待GC更可靠。