大模型评测,能否大幅省钱省时,还能测得准?
围绕这个问题,我们公开了**大语言模型高效评测(Efficient Evaluation of LLMs)**综述 Are We Testing Too Much? ,系统梳理截至 2026 年 8 月的 119 篇研究 ,聚焦 基准压缩(Benchmark Compression):如何大幅压缩评测开销,同时可靠地估计完整基准上的分数与排名。
在一些已有研究的实验设置中,LongBench、GSM8K、MMLU 等基准只用少于 20% 的测试样本,就能得到接近全量评测的结果。 这为降低评测开销提供了空间,具体能省多少,则取决于模型、任务和允许的误差。
1. 题少了,为什么还能测得准?
想象一张试卷里有很多考查相似知识点的题。做完其中一部分后,继续做同类题带来的新信息可能已经有限。
大模型基准也可能存在这样的冗余:有些题测试相近的能力,有些题在不同模型上的答对、答错模式高度相似。利用这些关系,就有机会用较少的作答推断更完整的结果。
这就是「基准压缩」(Benchmark Compression)的基本思路:
选择一部分评测 → 获得局部结果 → 估计全量结果 → 检查误差和成本。
这里有两个同样重要的问题:选哪些题,以及测完这些题后,怎样还原原来的结果。 例如,某类题被选得更多,直接平均就可能改变它在总分里的权重,需要通过加权或统计校正来处理。
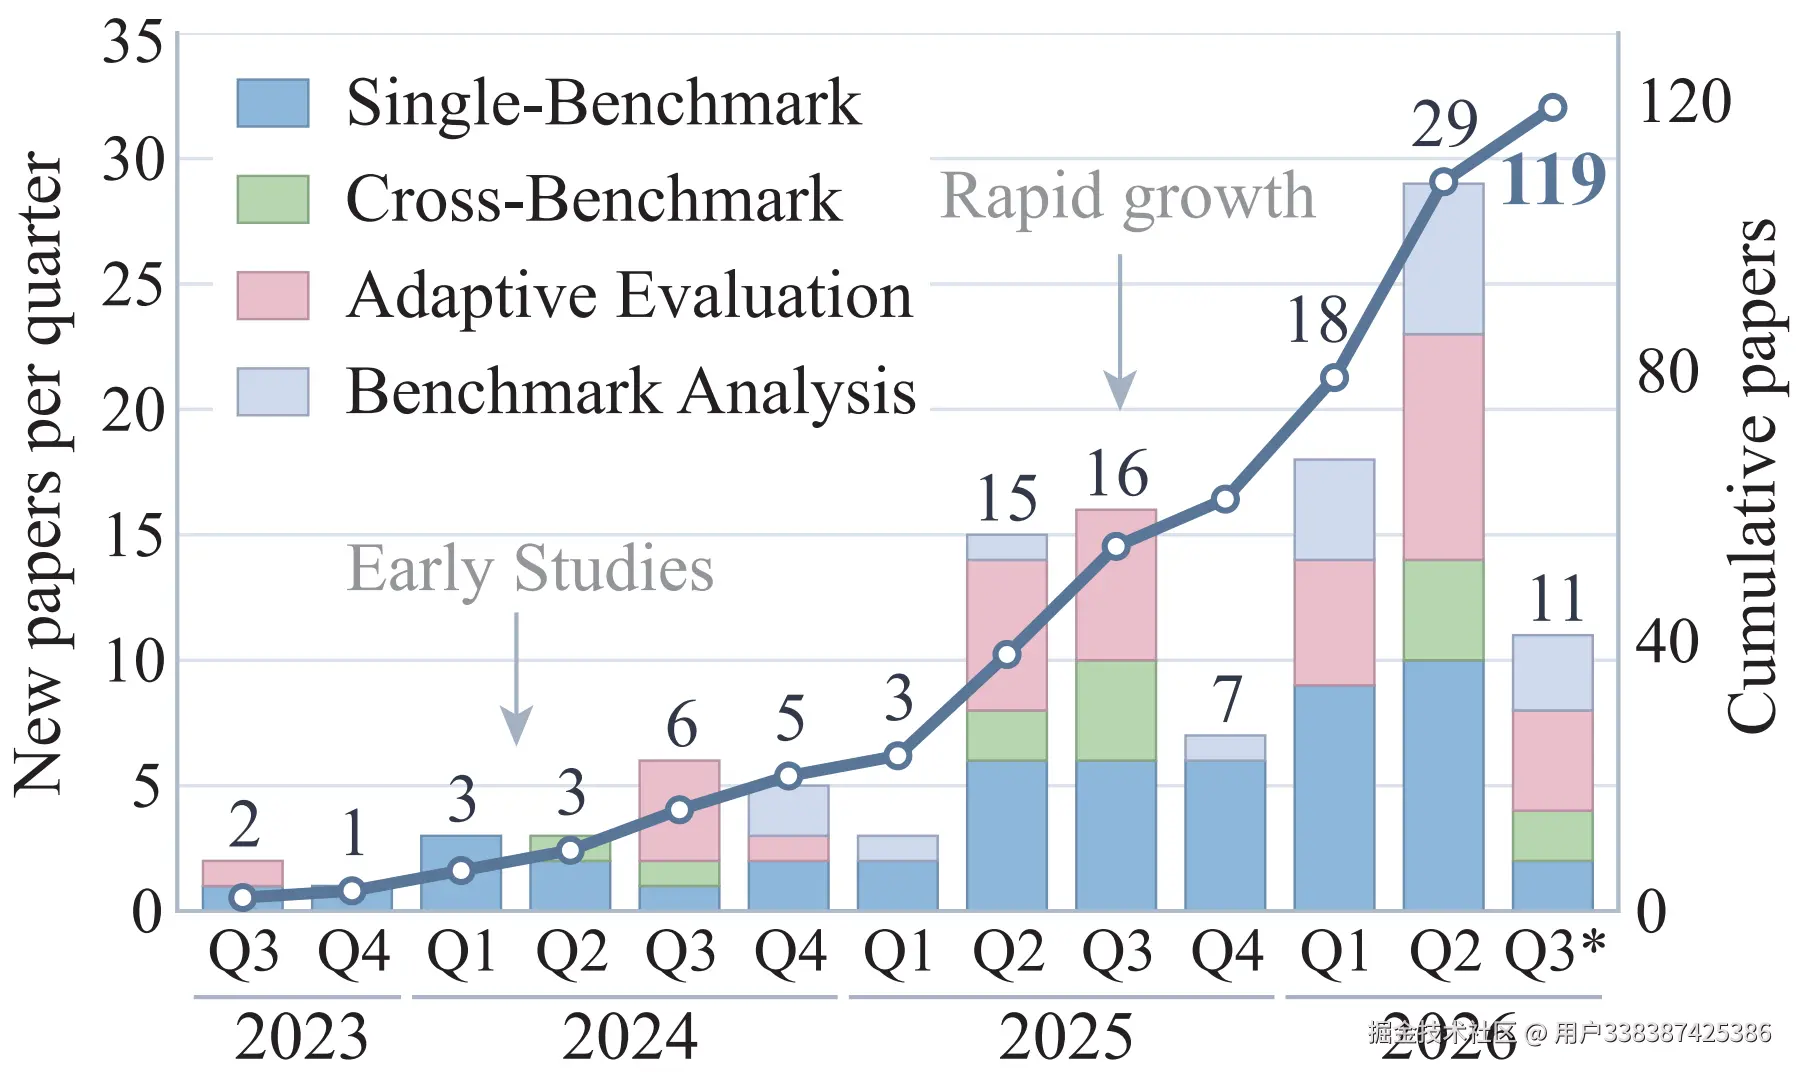
论文 Figure 1:相关研究自 2024 年起快速增长。图中统计截至 2026 年 8 月,2026 年第三季度为不完整季度。
2. 怎么少测?先看三条路线
路线一:在一个基准里,挑出更有信息的题
单基准压缩先固定一份较小的题集,再估计模型在原始基准上的表现。不同方法的区别,主要在于它们用什么信息来选题。
只看题目。 按题型分层抽样,或根据文本、语义表示、所需技能进行聚类,从不同组里挑选代表题。准备门槛相对低,但文本看起来不同,并不一定意味着测试的能力不同。
参考历史答卷。 利用过去多个模型的答题记录,寻找有代表性、能区分模型表现的题目。tinyBenchmarks、MiniLongBench 等工作属于这一方向。历史记录可以反复复用,效果则依赖这些规律能否迁移到新模型。
先了解当前模型。 用少量探测题或低成本信号,先判断当前模型的表现特点,再为它选定一份题集。不同模型可以拿到不同的短卷,探测本身的成本也需要计入。
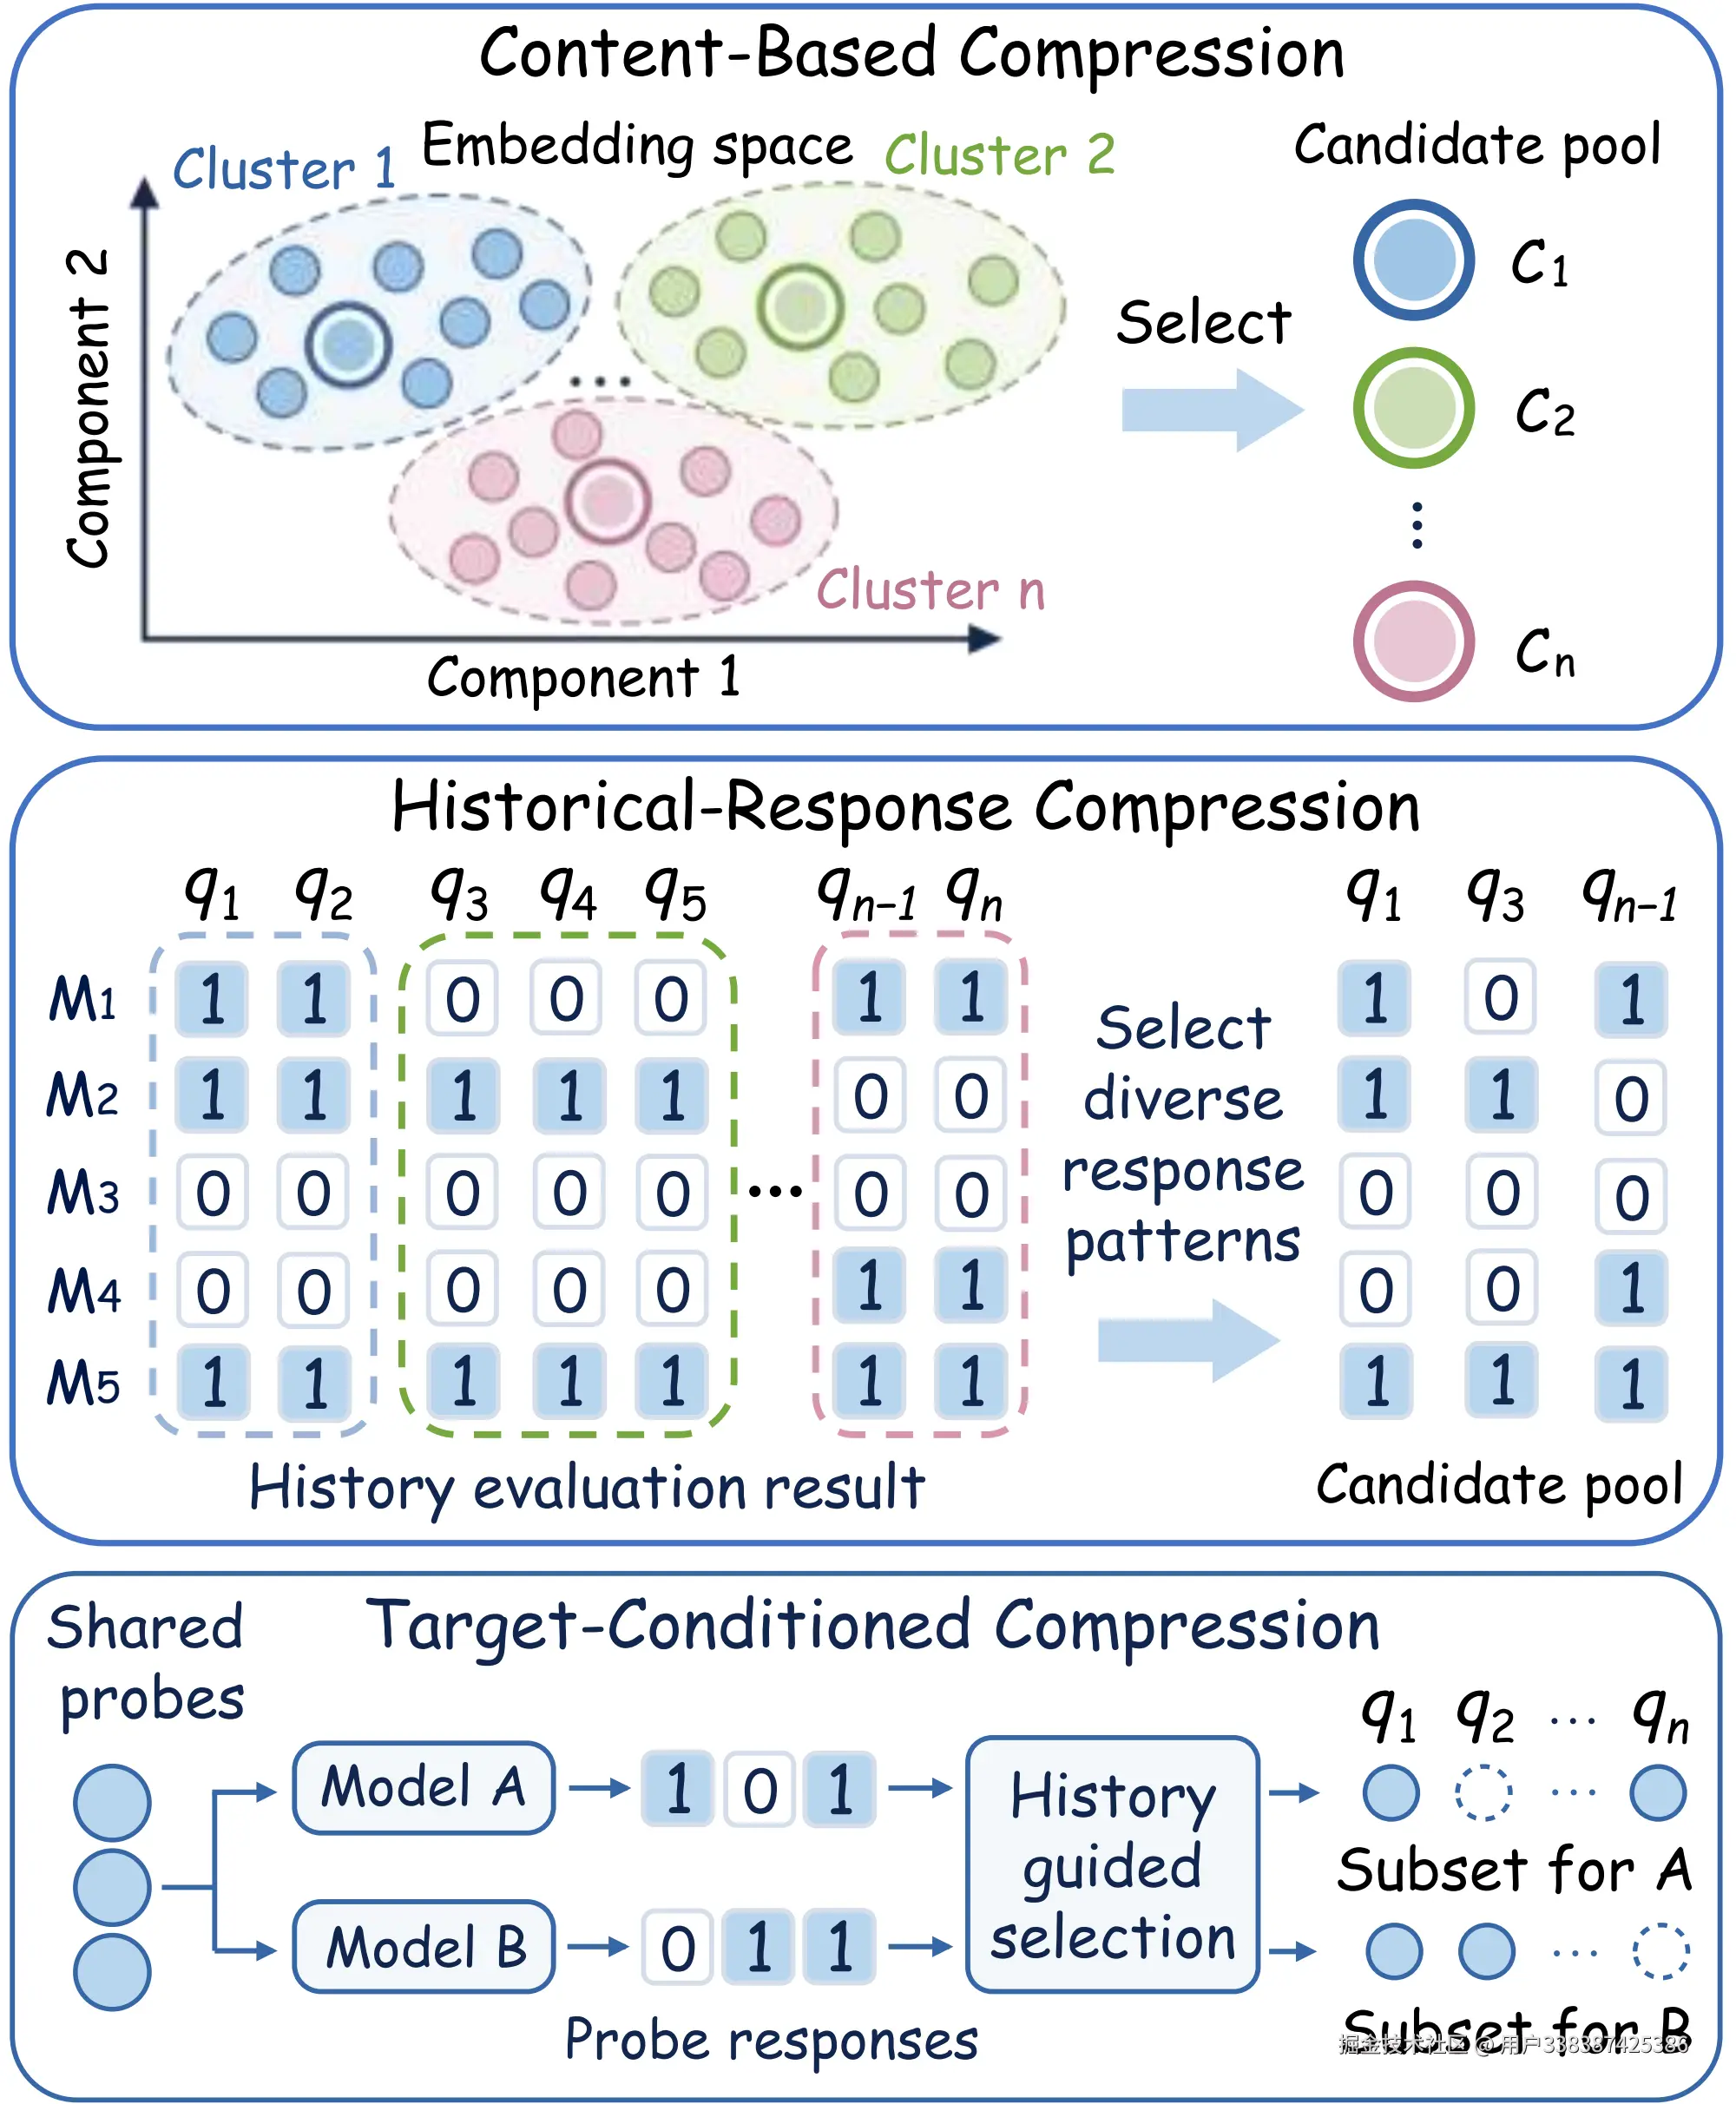
论文 Figure 4:从上到下,分别利用题目内容、历史模型答题记录、当前模型的低成本信号来选题。
路线二:把多个基准放在一起,减少重复评测
如果要同时测试多个基准,还可以利用它们之间的关联。
例如,某些方法从整套基准中联合挑选题目;另一些方法只运行部分任务,再预测跳过的基准分数。metabench、SimBA 等工作探索了这类做法。
这相当于从「精简一张试卷」走向「统筹整套考试」。节省的单位可以从单道题扩展到完整任务,但前提是基准之间的关系对新模型仍然有效。
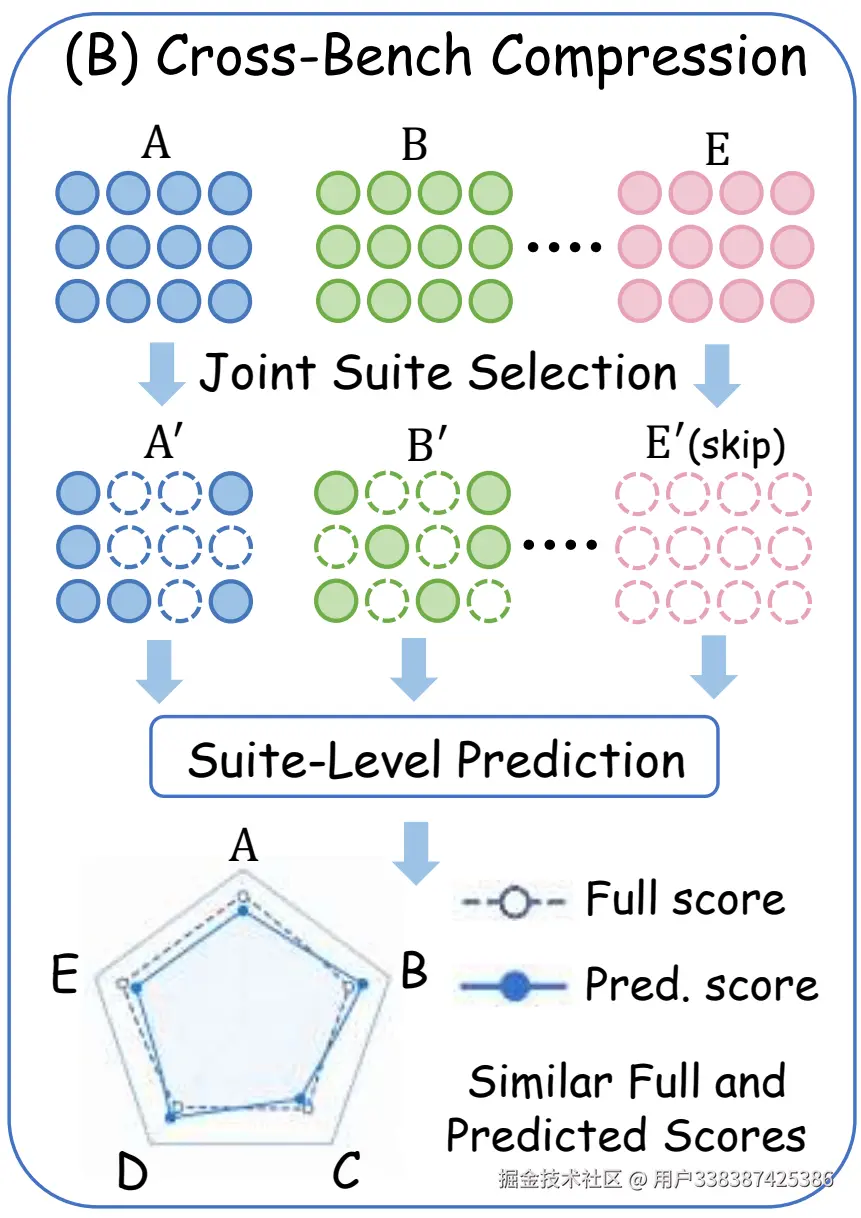
论文 Figure 2B:联合选择多个基准中的评测内容,并估计各基准的完整结果。实心圆表示选中项,虚线圆表示跳过项。
路线三:边测边决定,下一题做什么、什么时候停
自适应评测会利用已经拿到的结果,调整后面的评测过程。
它包含两个重点:自适应选题 关注下一道题测什么,序贯决策与停止关注证据是否已经足够,能否作出比较、筛选或停止的决定。
就像一场可以追问的考试:已经很清楚的部分少问一些,不确定的部分继续补测。若两个模型表现非常接近,仍可能需要测到接近全量,才能可靠地区分。
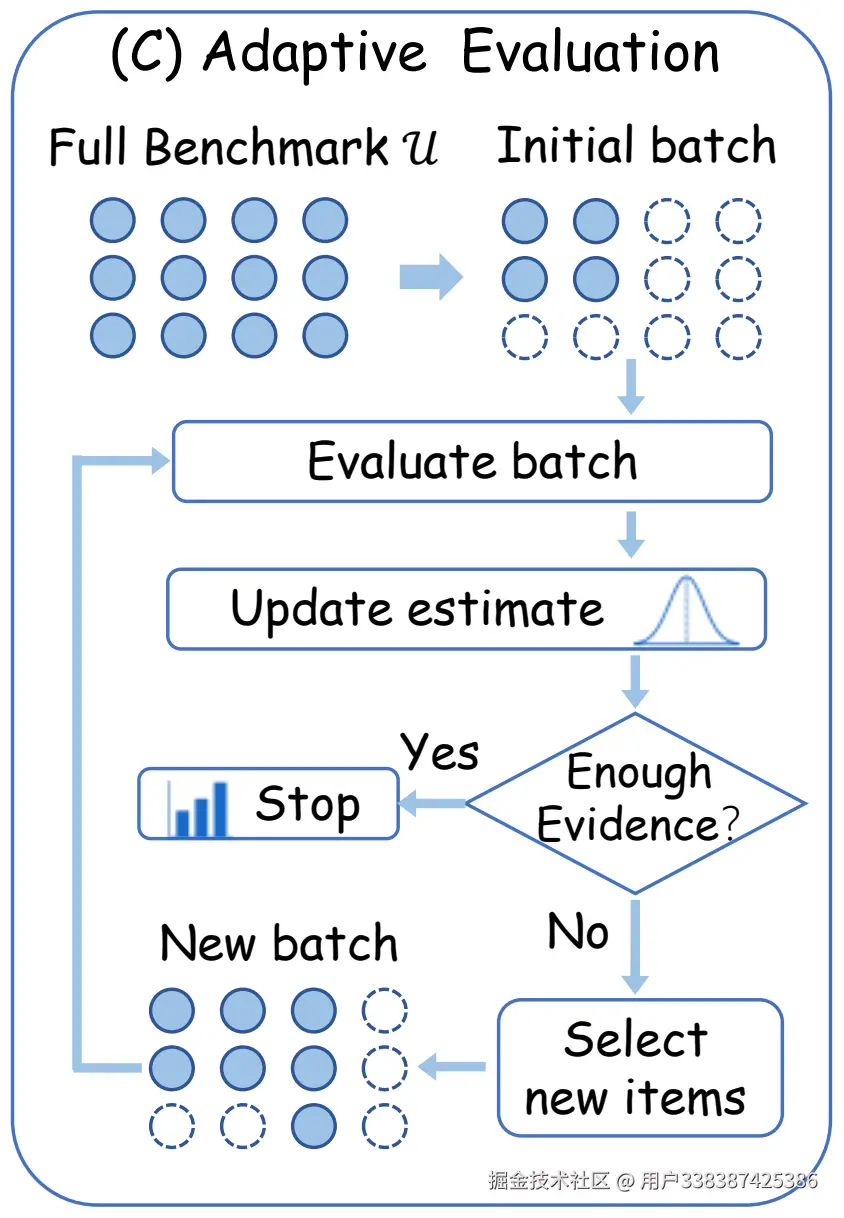
论文 Figure 2C:评测一批题,更新估计,再依据有效的决策规则继续选题或停止。
3. 看一种压缩方法,最该问什么?
综述还梳理了基准冗余、可靠性和评测协议等基础研究。把这些分析与方法放在一起,会发现「用了多少题」只是判断效率的起点。
第一,省下的到底是什么? 构建历史答题矩阵、生成题目表示、调用便宜的裁判、维护压缩题集,都有开销。自适应方法还可能需要多轮等待。题数、模型调用量、人工标注量和实际耗时,需要分别核算。
第二,保住的是哪一种结果? 估计总分、保持排名、选出最优模型,是不同的目标。整体相关性很高,也可能把两个接近的模型排反。验证时,需要对齐实际要作出的判断,并查看误差和不确定性。
第三,换一个新模型,还有效吗? 在旧模型上选出的代表题,可能漏掉新模型的能力变化。把完整的新模型留出来验证,并检查不同模型家族和时间变化,是评估泛化能力的关键。
4. 这篇综述,能帮你做什么?
**做模型迭代,**可以从已有数据出发,寻找适合反复验证和候选筛选的评测方案。
**研究评测方法,**可以沿着统一分类,对照不同方法的信息需求、结果估计方式和失效条件。
**设计新基准,**可以进一步考虑:发布之前,就把题集做得更紧凑、更有区分度。
论文主文提供全景,附录收录逐篇文献目录、方法比较与详细分析。对于希望降低评测成本的读者,这是一份可以按场景查阅的入门与选型参考。
每多做一道题,能否多获得一份有用的判断? 这也是基准压缩留给评测设计者的问题。
论文信息
Are We Testing Too Much? A Survey of Benchmark Compression for Efficient Evaluation of Large Language Models