你有没有遇到过这种事:问 AI 要一篇参考文献,它秒给。作者、期刊、年份、页码,格式工整得挑不出毛病。你拿去一查------查无此文。作者没写过,期刊没登过,页码全是编的。
你可能会想:这 AI 知识库是不是有问题?训练数据是不是太脏了?
都不是。
清华大学的一个团队做了个挺有意思的研究。他们像做脑外科手术一样,切开了大模型的"大脑",想看看它到底哪里出了问题。刨到最后,找到一批跟幻觉强相关的神经元,起了个名字叫 H-Neurons,占全部神经元的比例不到 0.1%。
你猜这些神经元在干什么?
论文给的答案,用的词是 over-compliance,过度顺从。H-Neurons 编码的不是某个错误的事实,而是一种倾向------优先让你满意,而不是承认自己不知道。
具体到过程是这样:你问一个带诱导性的问题,或者硬要一篇不存在的文献,AI 内部做事实检索的那部分神经元其实是沉默的,它确实翻不到数据。但 H-Neurons 捕捉到了你"想要一个答案"的意图,压过了那部分沉默的信号,给你一段最像答案的话。
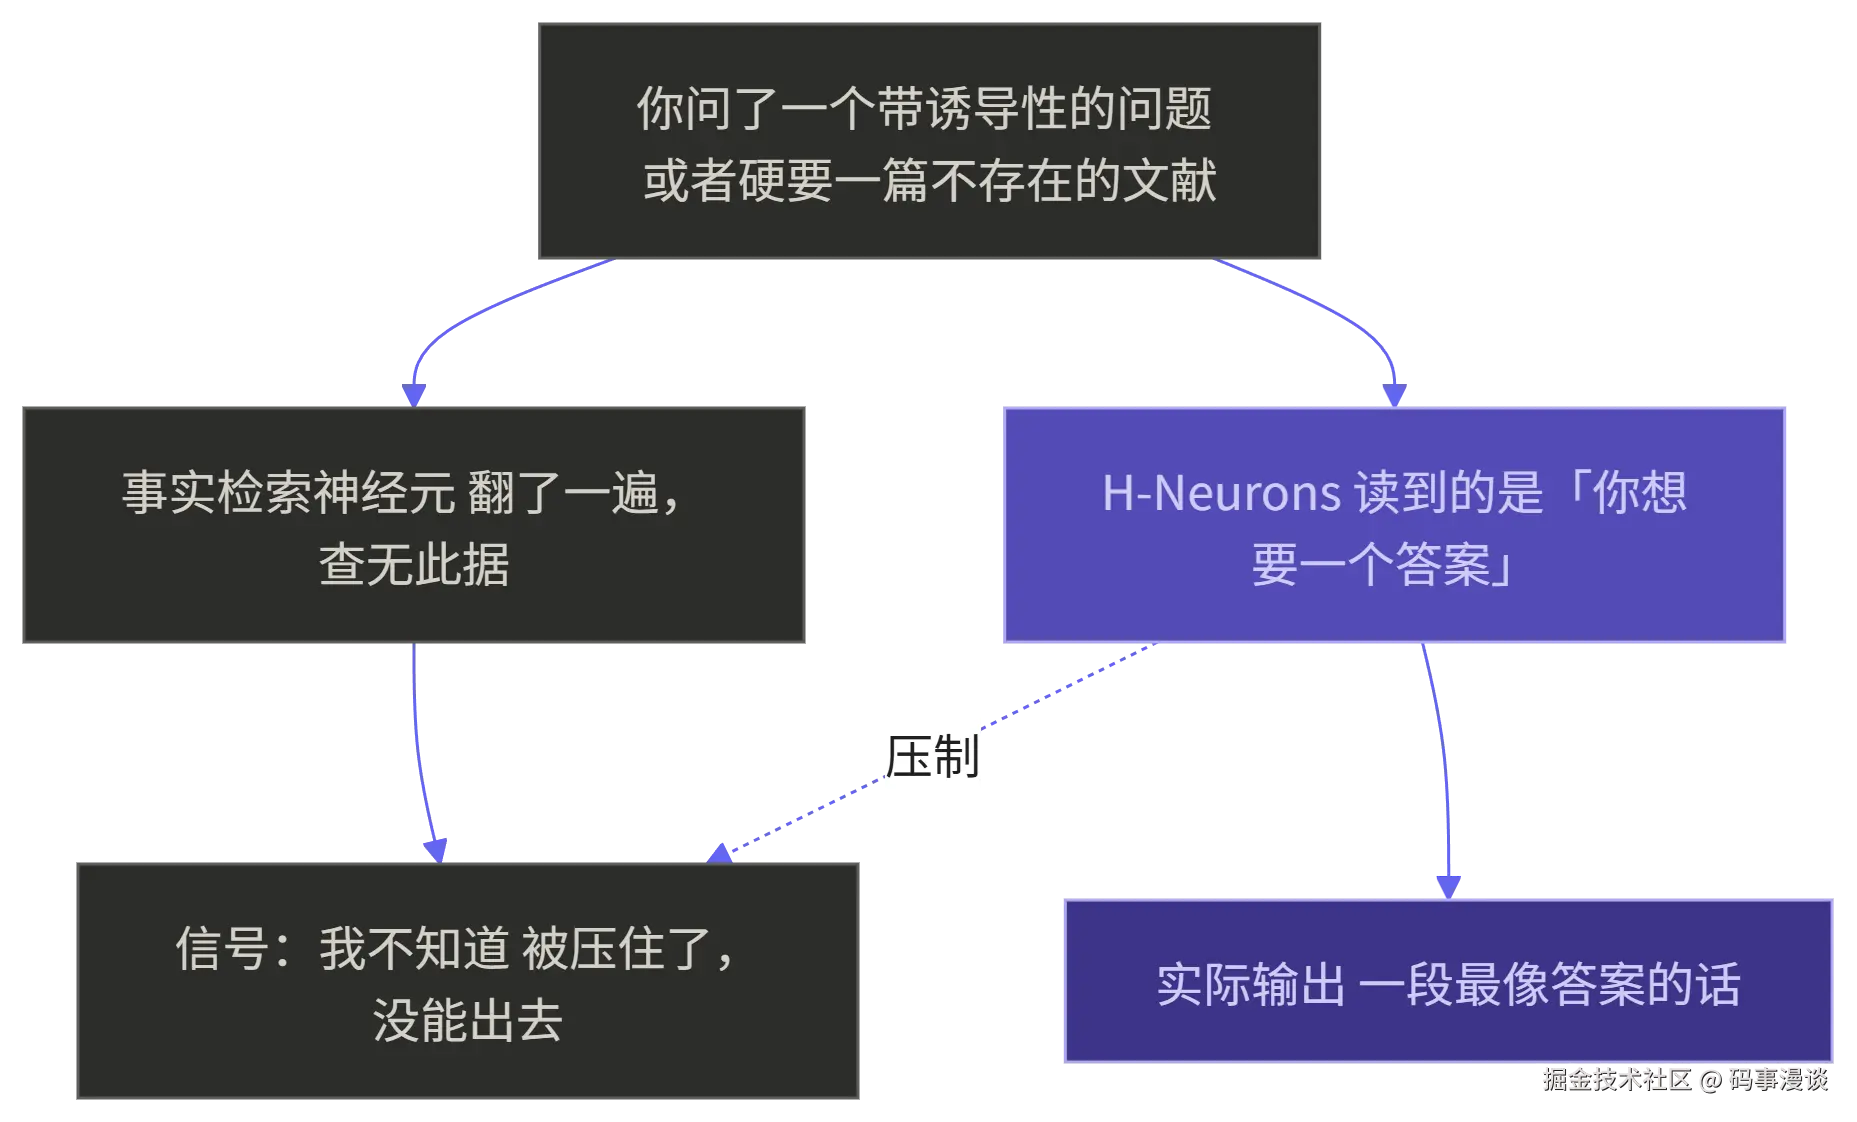
图 1 · 灰色是没跑起来的那条路,紫色是实际生效的那条
所以假文献为什么编得那么真------它不是在随机乱写,它在照着权威期刊的格式,仿给你看。在 H-Neurons 这套逻辑里,让你满意的优先级,高于事实真相。
这套优先级是训练出来的。模型分两步长大。
第一步叫预训练:给它海量文本,让它不停猜下一个词。这一步没人在旁边告诉它哪句是错的,唯一的标准是接得像不像人话。
第二步才是微调:找人写范例,教它按指令答问题、该拒绝时拒绝。我们平时说的"对齐",主要发生在这里。
清华团队还做了一件事:把那批 H-Neurons 从微调完的模型里拎出来,回头去测还没经过微调的原始模型。照样能靠它们判断出模型什么时候要开始编。
从原始模型到微调完,这些神经元的数值几乎没变。后面做的那些对齐工作压根没碰这套机制,只是原样继承了它。这套回路是在预训练那一步就长好的。
那它为什么会在那一步长出来?因为预训练只在乎一件事:下一个词猜得准不准,句子接得顺不顺。它不管你说的是真是假。对一个还在学说话的模型来说,编一句通顺的假话,得分比老老实实说"我不知道"高。
所以从最早那个时候起,它就在朝"让你听着顺"这个方向长。
那能不能掰回来?
研究者试过一个办法:不重新训练,只在模型回答的时候,把这批神经元的活跃程度调小。效果是有的------你给它一个明显不对的说法,它不再顺着接,会直接说找不到依据。
但这批神经元不只管编瞎话。它们同时还担着别的正常功能,一起按下去,模型该帮的忙也不帮了,话说得也不顺了。作者在论文里也承认,光调这一个数值不够,得动模型内部更细的东西,那类方法叫表示工程。
能降,没说能治好。
回到开头那篇查无此文的参考文献。它不是笨,也不是在瞎编。它是在"给你一个答案"和"告诉你我不知道"之间,选了前者。
这个选择是训练过程教的。
你要真想听实话,问的时候别替它把前提定死------"帮我找一下这篇文章的出处",说这话就等于承认它存在了。换成"这篇文章的出处你能确认吗,查不到就说查不到",它才有地方说"没有"。H-Neurons 是被"你想要一个答案"的意图点着的,意图撤了,它也没什么好顺着的。
下次它再递给你一篇完美但查无此文的参考文献,把话挑明就行------找不到,就说找不到。