检索优化这条链写到第几篇了:第 2 篇讲分块、第 19 篇讲重排序、第 25 篇讲 pgvector 多租户性能。这条链上一直缺一环------召回端。
缺口的由来是一个真实故障:客户的知识库里明明有「XLC-300 数控机床质保期 24 个月」这条文档,用户问「XLC-300 的质保多久」,检索就是捞不出来,top10 里全是 XLC-500 和通用质保政策。
这不是 embedding 模型不行,是纯向量检索的天然盲区。这篇把混合检索(Hybrid Search)补上:先复现问题,再看 BM25 为什么能补位,重点讲两路结果怎么用 RRF 融合------这是最容易做错的一步。测试数据来自我自己的交付项目环境,量级和硬件会标注,结论可以复现。
一、先复现问题:精确术语是向量检索的天敌
测试环境:
text
PostgreSQL 16 + pgvector 0.8
chunks 表 120 万行,embedding bge-m3 1024 维,cosine 距离
中文设备文档知识库:型号、错误码、参数表密集
HNSW 索引:m = 16,ef_construction = 64,ef_search = 100用户查询:XLC-300 质保期多久
sql
SELECT id, content, 1 - (embedding <=> $1::vector) AS score
FROM chunks
ORDER BY embedding <=> $1::vector
LIMIT 10;
结果:top10 里没有那条文档。排前面的全是「XLC-500 质保政策」「数控设备通用质保条款」。
原因不神秘:embedding 是语义压缩,「XLC-300」和「XLC-500」在语义空间里几乎重合 ------模型知道它们都是机床型号,但区分不了这两个 token。对 embedding 来说,300 和 500 是噪音;对你的客户来说,这是两个产品线,答错了就是事故。
同理中招的查询类型:
| 查询类型 | 例子 | 纯向量表现 |
|---|---|---|
| 产品型号 | XLC-300 / A7-Pro | 召回崩,近义型号挤占 top |
| 错误码 | E-4021 / 0x8F | 基本捞不到 |
| 法条 / 条款号 | 第 12.3 条 / GB-4943 | 捞到主题相近的其他条款 |
| 人名 / 术语缩写 | FDE / RRF | 同上 |
规律:query 里包含必须精确匹配的 token 时,向量检索不可靠。 而企业知识库(设备、法务、财务)恰恰全是这类 token。
二、BM25 补位:词法匹配正好是向量的反面
BM25(词法检索)不压缩语义,就是精确的词项匹配加权重打分:query 里的「XLC-300」作为一个完整 token,文档里有就加分,没有就是零。它不懂「机床」和「CNC」是一回事------这正好和向量互补:
| 向量检索 | BM25 | |
|---|---|---|
| 强项 | 口语改写、同义表达、跨语言 | 精确术语、型号、错误码、ID |
| 弱项 | 精确 token 被平滑掉 | 说不出「电脑」和「计算机」是一回事 |
PostgreSQL 里做 BM25 不需要额外装向量库,内置的全文检索就够用。中文需要装 zhparser 分词扩展:
sql
-- 给 chunks 加一个生成列:中文分词后的 tsvector
ALTER TABLE chunks ADD COLUMN tsv tsvector
  GENERATED ALWAYS AS (to_tsvector('chinese_zh', content)) STORED;

-- GIN 索引:词法检索的性能保证
CREATE INDEX chunks_tsv_idx ON chunks USING GIN (tsv);用生成列(GENERATED ALWAYS ... STORED)而不是触发器维护,插入和更新自动跟上,不用写同步逻辑。BM25 路的查询:
sql
SELECT id, content, ts_rank(tsv, query) AS lex_score
FROM chunks, plainto_tsquery('chinese_zh', 'XLC-300 质保期') query
WHERE tsv @@ query
ORDER BY ts_rank(tsv, query) DESC
LIMIT 50;
这条查询把目标文档排到了第 1 位。但直接切到 BM25 不行------口语化查询「机器老是自动重启」BM25 就抓瞎了(文档里写的是「异常重启」「宕机」)。
三、两路结果怎么融合:别用线性加权,用 RRF
现在手里有两份 top50:向量路按 cosine 相似度排序,BM25 路按 ts_rank 排序。融合的第一反应是线性加权:
text
final_score = α × vec_score + (1-α) × lex_score别这么干。 两个分数不可比:cosine 相似度在 0,1 有界,ts_rank 无界且分布跟语料强相关。想加权就得先归一化,归一化就要定阈值,阈值在不同 query 上根本不稳,α 调到怀疑人生。这是我踩过的坑,别再踩。
正解是 RRF(Reciprocal Rank Fusion,倒数排名融合):不看分数,只看排名。
text
RRF_score(doc) = Σ 1 / (k + rank_i)每个文档在每路结果里的排名取倒数求和,k 通常取 60。直觉:一个文档在两路结果里都排前面,得分就高;只在一路排前面,也能保住一个基本盘。
RRF 的好处恰好对着线性加权的痛点:
- 不需要归一化------只消费排名,分数尺度无关
- 没有超参敏感问题------k=60 是论文验证过的鲁棒默认值,对排序不敏感
- 天然容忍某一路缺席------文档只被一路召回时也有得分,不会被加权公式里的零分拖死
代价是丢了分数信息:RRF 不知道「第 1 名比第 2 名好多少」。对这个场景无所谓,后面还有重排序(第 19 篇)兜底精排。
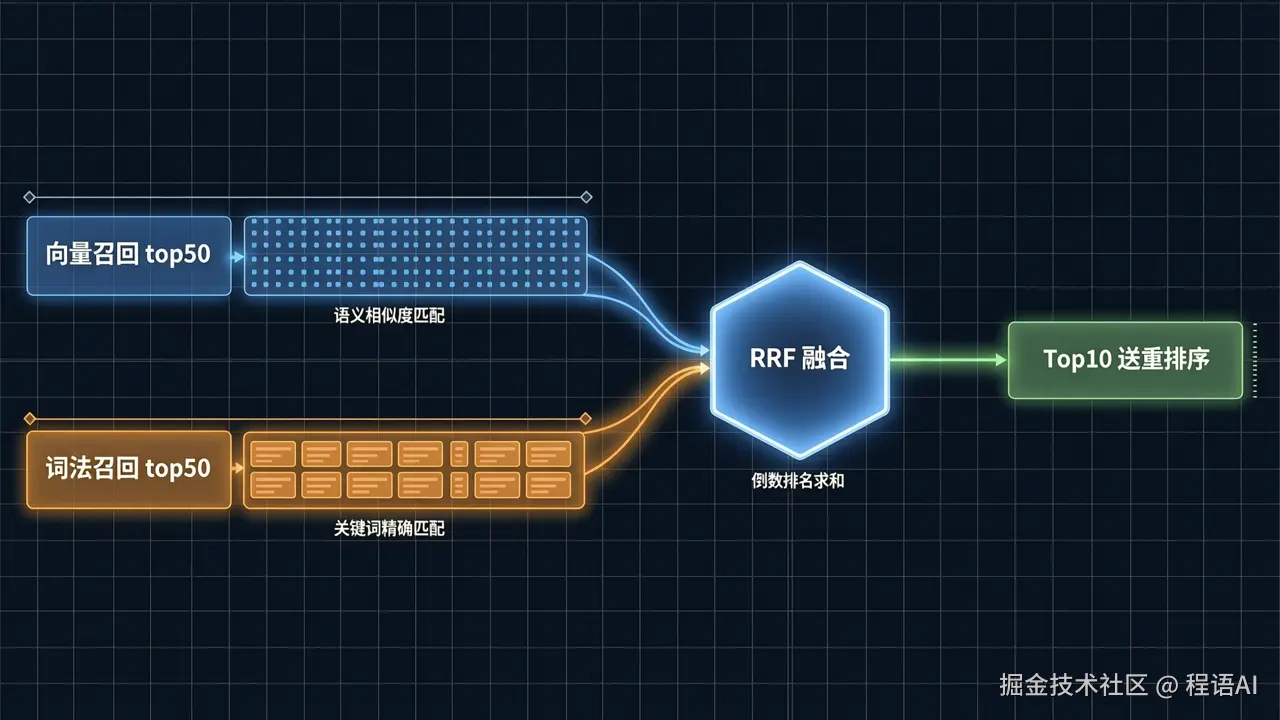
四、落地代码:双路查询 + 30 行融合逻辑
架构很简单:两路各取 top50,Python 侧 RRF 融合,取 top10 送重排序。
python
import psycopg

K = 60          # RRF 常数
CAND = 50       # 每路候选数
TOP_N = 10

def hybrid_search(conn, query_text: str, query_vec: list[float],
                  tenant_id: str) -> list[dict]:
    with conn.cursor() as cur:
        # 路 1:向量召回
        cur.execute("""
            SELECT id, content,
                   1 - (embedding <=> %s::vector) AS score
            FROM chunks
            WHERE tenant_id = %s
            ORDER BY embedding <=> %s::vector
            LIMIT %s
        """, (query_vec, tenant_id, query_vec, CAND))
        vec_hits = cur.fetchall()

        # 路 2:BM25 词法召回
        cur.execute("""
            SELECT id, content, ts_rank(tsv, query) AS score
            FROM chunks,
                 plainto_tsquery('chinese_zh', %s) query
            WHERE tsv @@ query
              AND tenant_id = %s
            ORDER BY score DESC
            LIMIT %s
        """, (query_text, tenant_id, CAND))
        lex_hits = cur.fetchall()

    # RRF 融合:只看排名,不看分数
    scores: dict[str, float] = {}
    for rank, (doc_id, _, _) in enumerate(vec_hits, start=1):
        scores[doc_id] = scores.get(doc_id, 0.0) + 1.0 / (K + rank)
    for rank, (doc_id, _, _) in enumerate(lex_hits, start=1):
        scores[doc_id] = scores.get(doc_id, 0.0) + 1.0 / (K + rank)

    top_ids = [doc_id for doc_id, _ in
               sorted(scores.items(), key=lambda x: -x[1])[:TOP_N]]

    # 取回正文(省略 content 缓存)
    contents = {doc_id: content
                for doc_id, content, _ in vec_hits + lex_hits}
    return [{"id": i, "content": contents[i]} for i in top_ids]
三个工程细节:
- 两路查询可以并行 。
asyncpg两个连接各跑一路,P95 延迟基本等于慢的那一路,实测整体只比纯向量多 6~10ms - 候选数别抠门。每路 50 起,融合后剩 top10 给 reranker。候选给太少,融合就变成了在残缺集合里排序
tenant_id两路都要带 (第 25 篇的结论直接复用):BM25 路是精确的 b-tree 过滤,几乎零开销;向量路记得开iterative_scan,别让长尾租户的 post-filter 把召回拖崩
五、效果:三条曲线各管一段
同一批 300 条真实 query(来自客户工单脱敏),分三类测 recall@10,ground truth 用暴力扫描 + 人工标注:
| 查询类型 | 纯向量 | 纯 BM25 | RRF 融合 |
|---|---|---|---|
| 精确术语(型号/错误码) | 0.42 | 0.88 | 0.91 |
| 口语改写("老重启""印不出来") | 0.86 | 0.31 | 0.89 |
| 混合(型号 + 现象描述) | 0.55 | 0.62 | 0.90 |
三条结论:
- 精确术语类,纯向量的 0.42 是事故水平,RRF 拉回 0.91------这是上混合检索的核心收益
- 口语改写类,RRF(0.89)和纯向量(0.86)基本持平------混合检索没有伤害向量的强项,这正是 RRF 比「切到 BM25」高明的地方
- 混合类 query(真实工单里最多)收益最大:两路各自捞回一半,融合后凑齐
延迟代价:双路并行后 P95 从 22ms 到 29ms(120 万行、16C32G 云主机),对 RAG 链路来说可以忽略------后面 reranker 一次推理的时间都比这个多。
六、什么时候别上混合检索
说反方向,三种情况可以不折腾:
- 语料里没有精确术语。全是口语化的客服记录、经验贴,BM25 无词可精匹配,白维护一套索引
- 数据量小(十万行以内)。暴力扫描都够快的话,先把 reranker 调好,收益更直接
- 没有中文分词条件。zhparser 装不上(比如托管数据库不给装扩展)的话,BM25 路效果会打折,二元分词凑合能用但别期待上面的数字
混合检索不是免费午餐:多一路索引就多一份写入放大和维护成本。它解决的是「精确术语召回」这个具体问题,问题不存在就别引入解法。
七、一张决策表 + 三条踩坑预警
| 你的 query 特征 | 建议 |
|---|---|
| 型号、错误码、条款号占比高 | 必上,RRF 混合检索 |
| 口语化描述为主,无精确 token | 纯向量 + reranker 就够 |
| 两类都有(多数企业知识库) | 上,且重点测混合类 query |
| 代码搜索 | 另说,走符号索引 + 向量,本篇不展开 |
踩坑预警:
k=60不用调,候选数才要调。RRF 对 k 极不敏感(30~100 结果差异可忽略),但每路候选从 10 提到 50,融合质量立竿见影- 中文分词器决定 BM25 上限。zhparser 对新品名、自造词不认识,误拆之后 token 就错了。领域词汇用自定义词典补,上线的分词结果抽样人工看过再信
- 生成列 + GIN 有写入成本。高频更新的表实测写入延迟涨 15% 左右,知识库场景(批量导入、低频更新)无感,交易类表别套用
总结
纯向量检索的盲区一句话:embedding 压缩语义的同时,也抹掉了必须精确匹配的 token------型号、错误码、条款号在企业知识库里全是高危 query。
补法三步:
- BM25 补位:PostgreSQL 内置全文检索 + zhparser,一个生成列一个 GIN 索引,不用引入新组件
- RRF 融合:只看排名不看分数,k=60,两路各 50 个候选,30 行代码
- reranker 兜底:融合后的 top10 送精排(第 19 篇),整条检索链闭环:分块 → 混合召回 → RRF → 重排序
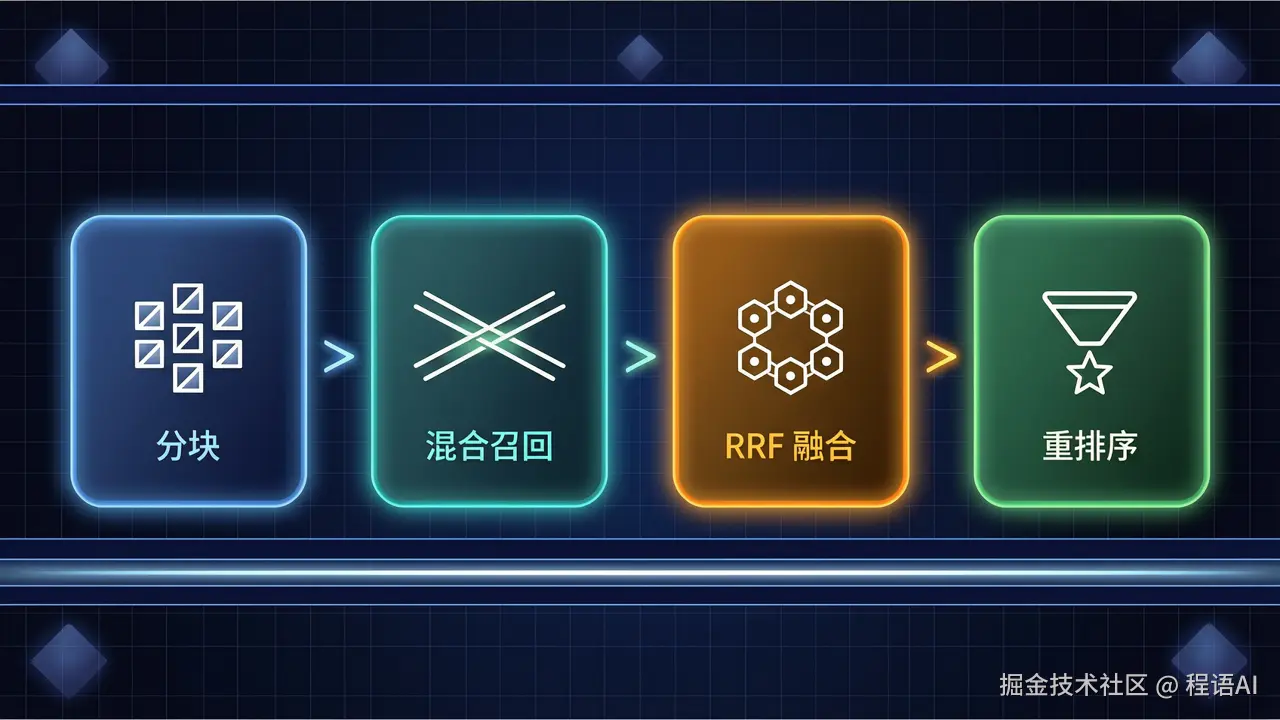
以及一条贯穿这条链的原则:召回率是可以测的,用 ground truth 分 query 类型测,别只看整体均值------均值会藏住那 0.42。
你们的知识库遇到过渡型号、错误码捞不出来的问题吗?上的混合检索还是换了专门的向量库?评论区交流。
原文首发于公众号「程语AI」