抓取 YouTube 视频、频道或评论数据时,403、429、CAPTCHA 和内容为空等问题并不少见,其原因往往涉及 IP、请求频率、客户端特征和页面渲染。2026 年,YouTube 自动化访问校验更加复杂,选对抓取方式并优化网络环境,比反复修改代码更重要。本文将从工具选型、反爬机制和报错排查展开分析。
一、YouTube 爬虫怎么选?3 种常见方法对比
YouTube 数据抓取前,先根据目标数据和页面类型选择工具,不同方案的适用范围并不相同:
|-------------------------|---------------------|-------------------|----------------------|
| 方法 | 适合场景 | 主要优点 | 主要局限 |
| YouTube Data API v3 | 视频、频道、播放列表、评论等结构化数据 | 官方接口,数据结构清晰,稳定性较高 | 有 API 配额和权限限制 |
| yt-dlp | 视频信息、格式、媒体文件等 | 成熟度高,提取逻辑完善,使用灵活 | 受 IP、客户端和 Token 变化影响 |
| Python+浏览器自动化 | 动态页面、JS渲染、复杂交互 | 可模拟完整浏览器流程,扩展性强 | 资源消耗较大,更容易触发反爬 |
如果主要获取视频元数据、频道信息、播放量等标准字段,优先选择YouTube Data API v3。通过 API Key 或 OAuth 调用资源,不需要解析网页,适合对数据规范性和稳定性要求较高的任务。使用前需要确认 API 权限和配额,批量搜索时尤其要提前计算调用成本。
如果任务涉及视频格式、字幕或媒体文件,可以使用yt-dlp。它已经封装了 YouTube 的提取逻辑,适合批量获取视频相关数据。实际运行中,如果任务请求量较大或网络环境不稳定,可以根据需要配置代理,保证连接稳定。
当目标内容依赖 JavaScript 渲染、动态加载或页面交互时,再考虑 Selenium、Playwright 等浏览器自动化方案。这类工具能够控制完整的浏览器流程,适合 API 和 yt-dlp 难以处理的网页内容,但资源消耗更高,实际使用时通常也需要配置代理。
二、YouTube 反爬机制是什么?重点看 3 个层面
1. 网络层
网络层主要判断请求的来源和访问规模,重点关注出口 IP、请求频率以及短时间内的访问集中程度,常见检测维度包括以下三个方面:
- **IP 来源:**判断请求来自数据中心、住宅网络还是其他网络出口
- **访问频率:**短时间内集中访问大量视频、频道或搜索结果,会形成明显的机器访问特征
- **请求规模:**大量任务共用一个出口时,请求会集中到同一 IP,更容易形成异常访问模式
这一层的核心是判断访问来源是否可信,因此代理 IP 并不只是简单更换一个地址,还涉及出口稳定性、IP 历史信誉和请求规模。对于持续运行的抓取任务,网络环境本身就是反爬检测的一部分。
2. 协议层
协议层主要判断请求是否来自符合要求的客户端,除了 URL 外,YouTube 还会结合 User-Agent、Headers、Cookies、客户端类型以及请求凭证等信息识别请求来源。也就是说,即使 IP 和访问频率正常,如果客户端特征或请求参数不符合预期,也可能无法获取完整内容。
过去部分抓取程序通过模拟常见客户端即可正常获取数据,但这种方式在 2026 年面临更多限制。YouTube 对不同客户端的访问能力进一步细分,PO Token 和 SABR 等变化也影响了部分视频数据的获取方式:
- **PO Token:**可以理解为 YouTube 用来验证特定请求来源的凭证。部分客户端在请求视频流、播放器或字幕资源时需要提供对应 Token;缺少时可能出现 403,或者直接导致部分格式不可用。
- **SABR:**YouTube 正逐步在部分客户端采用新的流媒体传输方式。当传统媒体 URL 不再直接提供,而请求转向 SABR 后,原本依赖固定视频 URL 的抓取方式就可能失效。
这意味着现在判断 YouTube 爬虫是否正常,不能只看"浏览器能不能打开网页",还要看当前客户端采用什么请求方式,以及平台是否要求额外凭证。
3. 行为层
行为层关注的不是某一次请求,而是一段时间内的访问轨迹。例如连续搜索相似关键词、快速打开大量视频、重复请求相同资源、固定间隔批量操作等,都可能形成明显的自动化特征。
这类行为的共同特点是:**请求本身可能没有错误,但访问模式明显偏离正常用户。**一旦触发进一步验证,就可能出现 CAPTCHA、登录要求、请求限流甚至网页内容异常。
报错排查:从现象追溯本质
常见错误如 403(禁止访问)、429(请求过多)、CAPTCHA 弹出、内容为空等,往往并非单一原因所致,而是多层反爬机制叠加的结果。排查应遵循以下思路:
- 403 错误:检查是否缺少 PO Token、SABR 认证或请求头不完整。
- 429 错误:确认是否存在短时间内高频请求,考虑加入指数退避算法与请求节流。
- CAPTCHA 出现:表明行为模式已被识别为非人类,需调整请求节奏、更换代理、启用浏览器指纹混淆。
- 内容为空:可能是前端渲染未完成、动态加载失败,或因客户端不兼容导致资源无法加载,建议结合浏览器自动化与日志追踪定位。
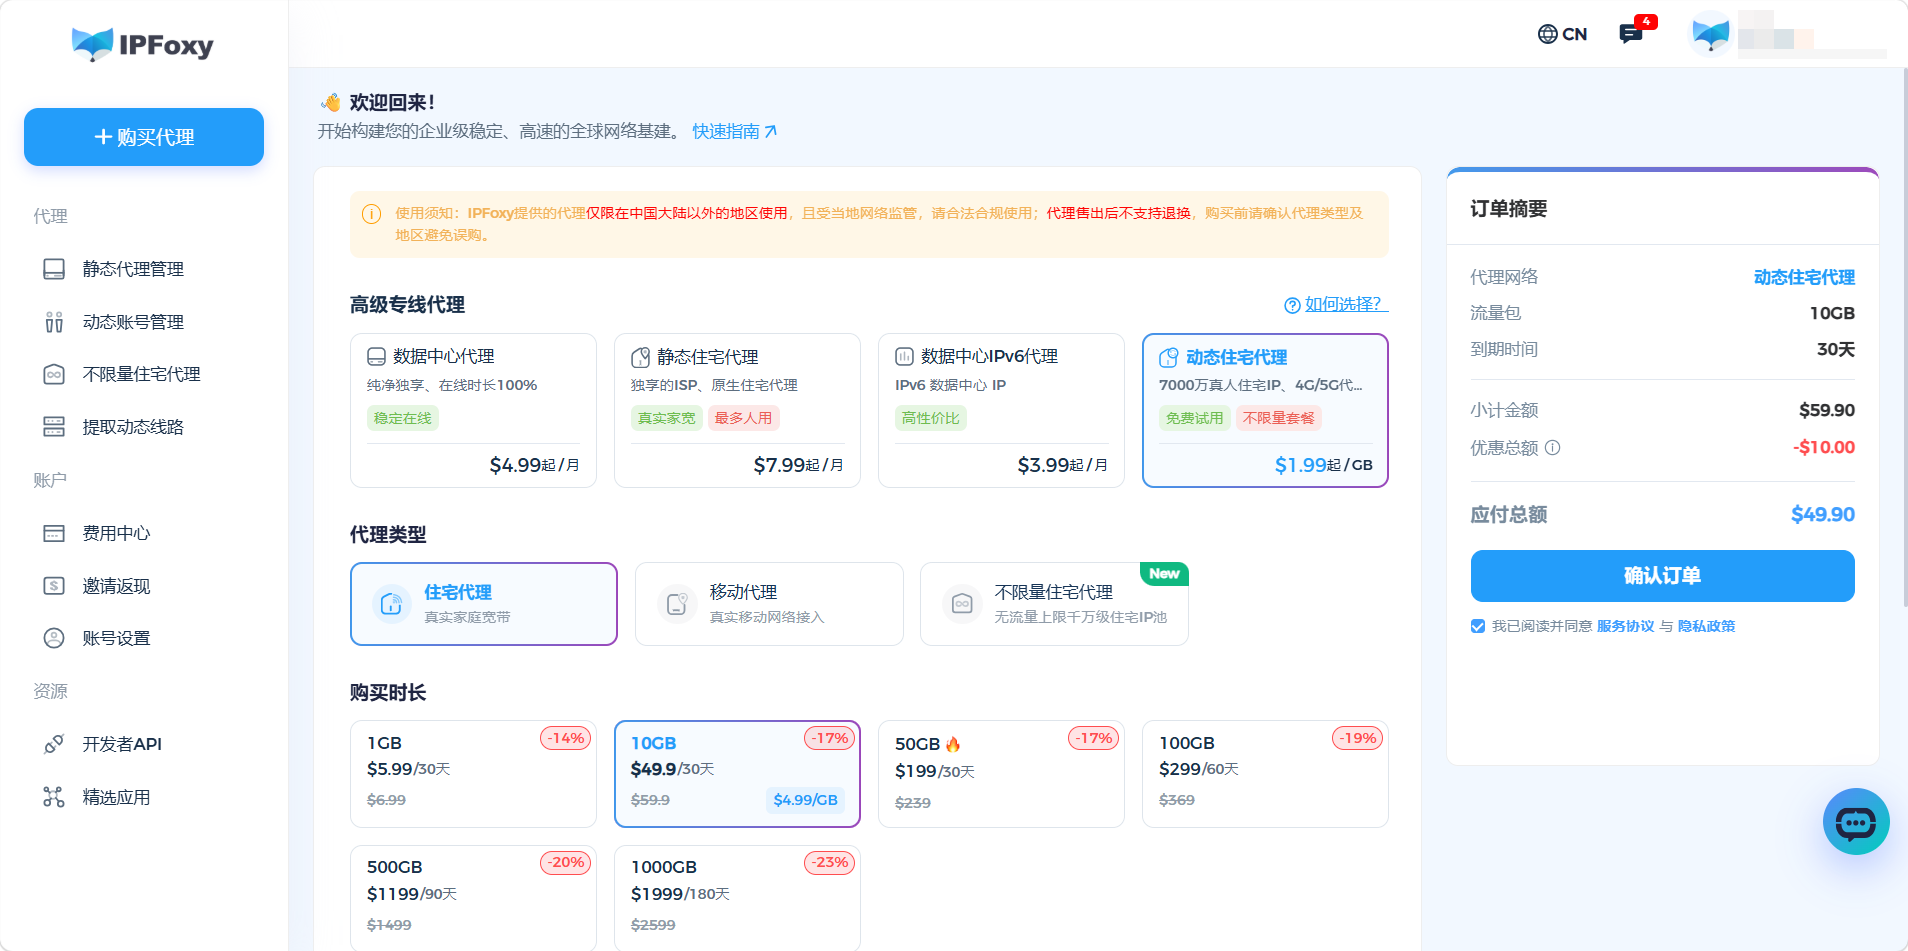
如果想要减少这些报错,可以使用像IPFoxy提供的住宅代理,相比于数据中心代理,这类代理更接近真实用户网络的出口特征,在对 IP 来源和信誉较敏感的 YouTube 数据抓取场景中更合适。同时,根据任务选择动态住宅或 ISP 代理,让不同任务使用更匹配的网络出口,再配合合理的请求频率和并发控制,降低请求集中导致的不稳定和访问限制。
总结建议
在 2026 年的 YouTube 环境下,成功的数据抓取不应局限于"如何写代码",而应聚焦于构建一个具备以下特征的系统:
- 工具组合合理:根据数据类型选择最适配的方案,避免盲目使用复杂工具。
- 网络环境可信:采用高质量住宅代理池,避免集中请求与频繁切换。
- 客户端特征真实:模拟真实浏览器行为,维护合理的请求头、会话与认证状态。
- 行为模式自然:引入随机延迟、多样化操作序列,规避规律性动作。
- 持续监控与自适应:建立日志分析机制,及时响应平台规则变化,动态调整策略。
最终,真正决定抓取成功率的,不是代码的复杂程度,而是整个系统的"真实性"与"可持续性"