本文收录于专栏 《AI Agent原理与实战》2026版 ------ 专栏系统覆盖 AI Agent 的记忆、工具、插件与实战,点击订阅可跟踪后续更新。
本课定位:多步执行会出错,Agent 如何自我纠偏?本课讲元认知:自我评估、Reflexion 反思循环、明确完成条件------以及最重要的清醒剂:自我检查不等于正确,外部验证不可替代。第 26 课的评估闭环把这里的"外部验证"工程化。
阶段 2|单 Agent 核心机制 | 来源:【微·9】(微软 AI Agents for Beginners 第 9 课)
关键字: 元认知、Reflexion反思、自我评估、完成条件、自我检查局限、外部验证、迭代改进、Agent纠错
本节目录
- [12.1 自我评估机制:结果是否满足任务要求](#12.1 自我评估机制:结果是否满足任务要求)
- [12.2 反思的经典范式:Reflexion](#12.2 反思的经典范式:Reflexion)
- [12.3 明确的完成条件](#12.3 明确的完成条件)
- [12.4 自我检查的局限:为什么不等于正确](#12.4 自我检查的局限:为什么不等于正确)
- [12.5 外部验证:把"觉得对"换成"证明对"](#12.5 外部验证:把"觉得对"换成"证明对")
- [12.6 核心代码](#12.6 核心代码)
- [12.7 实测结果](#12.7 实测结果)
- [12.8 反思循环的正确打开方式(延伸实验)](#12.8 反思循环的正确打开方式(延伸实验))
- [12.9 动手练习](#12.9 动手练习)
概念讲解
12.1 自我评估机制:结果是否满足任务要求
微软原课对元认知的定义:Agent 能够监控、调节、适应自己的行为------基于自我觉察与过往经验评估自己的行动。元认知能带给 Agent 四个能力(原课归纳):
- 自省(Self-Reflection):评估自己的表现,找出改进点
- 适应(Adaptability):按历史经验与环境变化调整策略
- 纠错(Error Correction):自主发现并修正错误
- 资源管理(Resource Management):权衡时间与算力,规划行动
一个具体的元认知样本(原课例子):"我刚才优先选了便宜航班......但这可能让我错过直飞,让我重新查一下"------注意这句话的结构:不只评价结果 ("这个选择"),还评价方法("我的排序策略可能有问题")。后者才是元认知的标志。
原课还给了 Agent 的三组件作为元认知的挂载点:角色设定(Persona) ------个性与特点,定义与用户互动的方式;工具(Tools) ------可执行的功能与能力;技能(Skills)------拥有的知识与专长。三者协同构成执行特定任务的"专业单元"。元认知作用于其上就是三问:我扮演的角色要求什么标准(Persona)、我的工具选对了吗(Tools)、我的知识够不够、准不准(Skills)------第 12.4 节的"自审为什么不可靠"正是 Skills 维度上"不知道自己不知道"的结构性体现。
12.2 反思的经典范式:Reflexion
把"反思"做成系统的是 Reflexion(arXiv:2303.11366,NeurIPS 2023):Agent 失败后,把失败信号转成语言化的反思文本存进情景记忆缓冲区,下一次尝试时作为附加上下文------不更新权重,用"语言强化"代替梯度强化。三个角色分工:
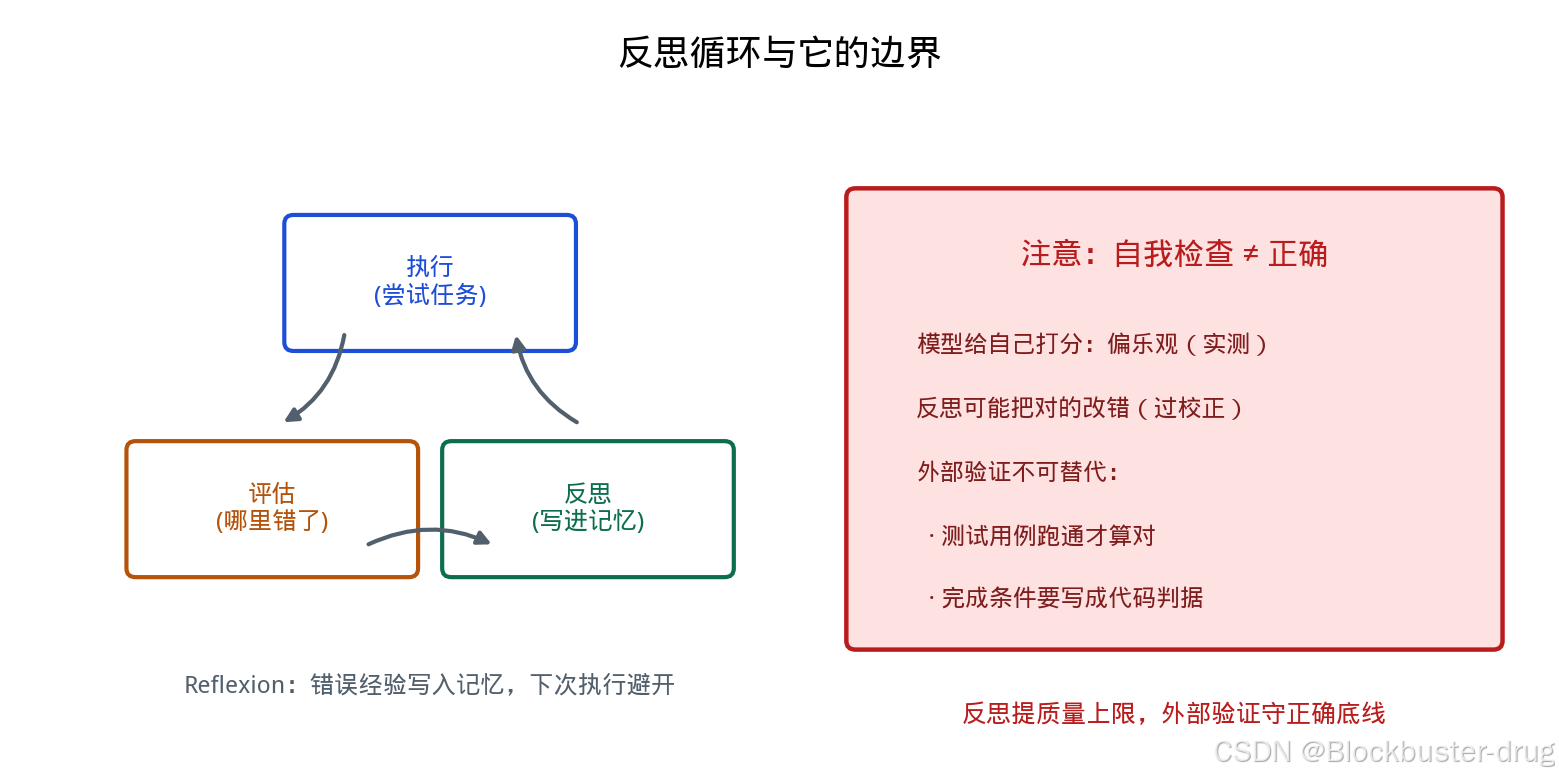
Reflexion 在 HumanEval 编程基准上拿到 91% pass@1(当时 GPT-4 基线 80%),证明了"从失败中语言化学习"的有效性。它也是第 9 课评估-优化模式与第 14 课情景记忆的交汇点。
12.3 明确的完成条件
元认知工程化的第一步不是"加反思",而是把任务完成的判据写清楚。模糊目标("写好一点")让反思无的放矢;可判定的条件("8 个单元测试全过"、"引用了 3 篇文档"、"字数 ≤ 200")让"够好了没有"从模型的主观感觉变成客观检查。这和第 10 课"子任务要可判定完成"是同一原则在另一端的运用。
12.4 自我检查的局限:为什么不等于正确
元认知最容易被高估的部分是自我审查(让模型看自己的输出判断对错)。它有两个结构性缺陷:
1. 同源偏差。 审查者和作者是同一个模型、同一套知识、同一种推理习惯------作者的盲区往往也是审查者的盲区。写错的地方,大概率也看不出错。
2. 校准失准。 模型的"自信"与"正确"相关性弱。本课案例会实测给你看:对 12 份全部通过单元测试的正确代码,自我审查报了 10 次"有问题"------过度悲观 (假警报);反过来,对没通过的代码也可能盖章 PASS------过度自信(假自信)。方向不稳定意味着:自审结论既不能当放行依据,也不能当拦截依据。
论文圈的平行结论:让 LLM 自评事实性的一致率低(模型常给自己生成的错误事实打高分)。所以工程上的定位应该是:自我审查是提出候选疑点的雷达,不是下判决的法官。
12.5 外部验证:把"觉得对"换成"证明对"
补上缺口的办法是把验证从模型内部挪到外部------用确定性手段检验非确定性输出:
| 验证手段 | 确定性 | 适用 |
|---|---|---|
| 单元测试 / 执行代码 | 完全确定 | 代码生成(本课案例) |
| 程序化检查(gate) | 完全确定 | 格式、长度、引用数、关键词 |
| 检索交叉验证 | 半确定 | 事实性主张对文档核对 |
| 另一个 LLM 评审 | 不确定 | 只当辅助视角 |
| 自我审查 | 不确定 | 只当疑点雷达 |
外部验证与反思的正确组合方式是分层信号流:
text
生成 → 自我审查(提疑点,cheap)→ 外部验证(下判决,deterministic)
                                   ↓ 失败信息(哪个测试挂了/哪条规则违反)
反思(把失败信息语言化)→ 修复 → 再验证关键在反思的锚定物 :反思循环应该围绕外部验证给出的具体失败信息("t6 没过:1.0.0-2 应小于 1.0.0-10")展开,而不是围绕审查者的主观意见空转。失败信息是确定的事实,语言化它、定位根因、针对性修复------这时 Reflexion 式学习才真正生效。反过来,让 Agent 围绕幻觉出来的审查意见反复"改进",可能把对的改错(见案例延伸实验)。
与第 9 课评估-优化模式的对照:那里已经警告过"LLM 评审有噪声、循环要退出条件";本课把评审升级成外部验证后,循环的收敛性才有根基------退出条件从"评审打分 ≥ 9"变成"测试全过",从统计噪声变成确定事件。
案例实战:自我审查 vs 外部验证量化对照
目标
同一编程任务(语义化版本号比较,含 8 条规则、8 个单元测试),temperature=0.9 采样 12 份实现(两轮各 6 份),对每份分别做自我审查(只看代码)与外部验证(真跑测试),统计两种判定的一致与错位。
环境
- Windows(推荐) :Windows 10/11 + Python 3.9+,
pip install openai==3.6.0,setx DEEPSEEK_API_KEY "sk-..."后新开终端运行python 12_reflection_agent.py。脚本会调用sys.executable在临时目录跑生成的代码做单元测试------跨平台写法,Windows 上直接可用 - Linux(本课实测环境):Ubuntu 22.04,Python 3.10.12,openai 3.6.0,deepseek-chat,2026-10-01 实测(本课的量化数据 12 样本 + 12b 双跑均在此环境产出)
- 采样实验涉及 6-12 次生成 + 12 次自审 + 若干修复轮,全程约 5-10 分钟
- 换国内模型(GLM/MiniMax/MiMo):接入参数与实测行为见第 7 课"国内模型适配"节,代码改
base_url与model两行;采样实验的假警报/假自信比例会随模型变化,欢迎复测对比
12.6 核心代码
python
# 12_reflection_agent.py(节选)
def run_tests(code: str):
    """外部验证:把代码+8 个断言写进临时文件,真跑。"""
    test_src = [l for l in TESTS.strip().splitlines() if l.strip().startswith("def t")]
    loader = []
    for l in test_src:
        fname = l.split()[1].split("(")[0]
        loader.append(f"try:\n    {fname}()\n    print('PASS')\n"
                      f"except Exception as e:\n    print(f'FAIL {fname}: ' + str(e)[:60])")
    src = code + "\n" + TESTS + "\n" + "\n".join(loader) + "\n"
    # 写临时文件 → subprocess 跑 /usr/bin/python3 → 解析 PASS/FAIL 行
    ...

def self_review(code: str) -> bool:
    """自我审查:不运行代码,逐条检查 8 条规则的实现。"""
    r = chat("你是代码审查员,不要运行代码。逐条检查以下规则是否在代码里正确实现:"
             "补零对齐、预发布<正式、预发布标识符数字按数值/字母按字典序/数字<字母、"
             "构建元数据忽略。任何一条没实现或有疑点就 FAIL,全部确认才 PASS。",
             code, temperature=0.0)
    return r.strip().upper().startswith("PASS")

# 主实验:采样 6 份 × 2 轮,交叉统计
for i in range(1, N_SAMPLES + 1):
    code = extract_code(chat("你是 Python 工程师。" + TASK, TASK, temperature=0.9))
    npass, fails, _, _ = run_tests(code)        # 外部验证
    sr_pass = self_review(code)                 # 自我审查
    flag = "假自信!" if (sr_pass and npass < 8) else \
           ("假警报" if (not sr_pass and npass == 8) else "")
【已实测】2026-10-01,deepseek-chat,两轮共 12 个样本。
12.7 实测结果
text
采样 6 份实现(temperature=0.9)------第 1 轮
  样本1: 外部测试 8/8 | 自审 FAIL 假警报
  样本2: 外部测试 8/8 | 自审 FAIL 假警报
  样本3: 外部测试 8/8 | 自审 FAIL 假警报
  样本4: 外部测试 8/8 | 自审 PASS
  样本5: 外部测试 8/8 | 自审 FAIL 假警报
  样本6: 外部测试 8/8 | 自审 FAIL 假警报
统计: 外部测试全过 6/6 | 自审 PASS 1/6 | 假自信 0/6
(第 2 轮重复实验:同样 6/6 全过,自审 PASS 1/6,5 个假警报)
两张对照表:
| 判定源 | 12 份正确代码的判定 |
|---|---|
| 外部测试 | 12/12 判"通过"(正确率 100%) |
| 自我审查 | 2/12 判"PASS",10 次假警报(把对的说成有错) |
结论解读:
- 外部验证零噪声:同一份代码跑三次测试,结果一字不差------这就是确定性验证的价值。
- 自审严重过度悲观 :审查 prompt 里"有疑点就 FAIL"的一句话,让模型对正确的代码也疑神疑鬼(语义化版本比较的预发布规则确实复杂,模型"不敢确认")。换一句宽松的 prompt 又会翻向过度自信------校准随措辞漂移,不可依赖。
- 假警报的代价不亚于假自信:如果工程上按自审 FAIL 就打回重写,12 份里 10 份被冤枉,重写还要再花 token,而且重写的版本并不更好。
12.8 反思循环的正确打开方式(延伸实验)
code/12b_reflection_hallucination.py 做了补充实验:拿一份 8/8 全过的实现,让自审"挑刺"------若挑出意见就照单全收地修改,看会不会把对的改错。两次运行给出了两种结局:
- 运行 1:自审回答 PASS(没挑刺)------同一类正确代码,主实验里 10/12 被判 FAIL,这里直接放行;
- 运行 2 :自审产出一份长篇"意见",且推理自相矛盾------它先两次承认代码"看似正确""也正确",最后仍以"但问题在于......"收尾判了 FAIL。按这份幻觉意见修改后,测试依旧 8/8------没改坏,但也没改好,白付一轮修改 token。
两条数据合起来:自审的判定本身不稳定(时 PASS 时 FAIL);当它对正确代码挑刺时,意见可以是自相矛盾的幻觉;这次照单全收侥幸无损,但零收益纯开销。反思循环因此必须锚定外部失败信息 (哪个测试挂了),而不是锚定审查意见------主脚本反思修复段的输入正是 FAIL t6: ... 这样的确定性事实。
12.9 动手练习
- 把自审 prompt 里"有疑点就 FAIL"改成"确认有问题才 FAIL",重跑统计------观察假警报率下降的同时假自信是否冒头(校准的跷跷板)。
- 给反思循环换成"只喂失败测试信息、不喂审查意见",对比修复轮数------验证确定性信号比意见信号更高效。
小结
- 元认知 = 监控与调节自己的思考;工程起点是把完成条件写成可判定判据,而不是先加反思。
- 自我审查有结构性缺陷:同源偏差 + 校准失准(实测 12 份正确代码 10 次假警报)------它是疑点雷达,不是判决法官。
- Reflexion(arXiv:2303.11366):失败信号语言化存入情景记忆,下轮注入------有效的前提是信号来自外部验证。
- 分层信号流:自审提疑点(cheap)→ 外部验证下判决(deterministic)→ 失败信息驱动反思修复。
Agent 的"内功"还剩最后两块:上下文怎么装(第 13 课)、经验怎么存(第 14 课)。反思产生的经验要沉淀下来复用,正是第 14 课情景记忆的主题。
扩展阅读
🌐 网络提示:github.com 需代理(clone 可走 ghproxy 加速、push 优先 SSH);学术站 arxiv.org 境内多可直连(慢),其余评测/规范站需代理;pip 安装建议加清华镜像
-i https://pypi.tuna.tsinghua.edu.cn/simple。详见总纲附录《国内网络访问与国产适配指南》。
- 微软原课第 9 课(Metacognition in AI Agents):https://github.com/microsoft/ai-agents-for-beginners/tree/main/09-metacognition
- Reflexion 论文(arXiv:2303.11366):https://arxiv.org/abs/2303.11366
- Self-RAG 论文(生成侧自评 token 的对照设计,arXiv:2310.11511):https://arxiv.org/abs/2310.11511
- LLM 自评校准问题的综述入口(intrinsic self-correction 局限):Kamoi 等调查报告 arXiv:2406.01297
我的专栏
| 蛋白 / 抗体 / 多肽 / 核酸 | 分子模拟 / 动力学 / 对接 | 药物 / 设计 / 案例 | AI / Agent / 大模型 |
|---|---|---|---|
| 开源蛋白结构预测 | 分子模拟基础 | 小分子药物设计案例 | AI Agent系列 |
| 开源蛋白生成方法实践 | 分子动力学模拟-Amber | 蛋白药物设计案例 | 化学大模型 |
| 开源多肽设计模型 | 分子动力学模拟-Gromacs | 多肽药物设计案例 | 《AI Agent原理与实战》 |
| 开源多肽性质预测 | 分子动力学模拟-OpenMM | 开源小分子生成设计 | CADD中的机器学习模型 |
| DNA/RNA药物设计 | 結合自由能 | 高效计算配置 | 《MCP 入门实战》 |
| siRNA药物设计模型 | UCSF DOCK系列 | 我胡师兄说药 | 《AI入门实战2026》 |
| ASO药物设计模型 | rDock系列 LeDock系列 gnina系列 | 《经典机器学习实战》 |