【声明】本博客所有内容均为个人业余时间创作,所述技术案例均来自公开开源项目(如Github,Apache基金会),不涉及任何企业机密或未公开技术,如有侵权请联系删除
标题
254、【AI】【模型部署】基座模型研究:对称性统一视角------等变、不变与归纳偏置
背景
上篇 blog
【AI】【模型部署】基座模型研究:集合视角------Deep Sets、池化与置换不变
把"集合"这条线讲完了:把边也拿掉后,输入是一堆元素的集合,对集合做预测要求置换不变 ;池化(求和/均值/最大)天然不变;Deep Sets 说任何连续置换不变的集合函数都能写成 ρ ( ∑ x ϕ ( x ) ) \rho(\sum_x\phi(x)) ρ(∑xϕ(x))------"个体变换 + 求和 + 整体映射";注意力输出本身是置换等变的集合,再池化一次就得到不变的整体表示;而语言模型把池化换成"取最后一个位置",读出开始依赖顺序,所以必须位置编码。
到此,251(置换等变)、252(注意力即图神经网络)、253(集合与池化)三篇都指向同一个词------对称性 。本篇作为收束,把等变、不变、掩码、位置统一进一个框架:对称性就是归纳偏置,把"任务里本来就该成立的性质"烘进网络结构。
模型部署
先说清楚"对称性"在这里指什么。它不是美学上的对称,而是**"对某个变换保持某种一致":把一个变换写成 g g g(比如"平移一格""重排顺序""旋转一个角度"),它作用在输入 x x x 上得到 g ⋅ x g\cdot x g⋅x。网络 f f f 对 g g g 的态度只有两种------不变或等变**。整篇内容就围绕这两个词展开。
🧩 不变与等变
定义非常短:
- 不变(invariance) : f ( g ⋅ x ) = f ( x ) f(g\cdot x)=f(x) f(g⋅x)=f(x)------施加变换,输出一点没变;
- 等变(equivariance) : f ( g ⋅ x ) = g ⋅ f ( x ) f(g\cdot x)=g\cdot f(x) f(g⋅x)=g⋅f(x)------施加变换,输出跟着一起变。
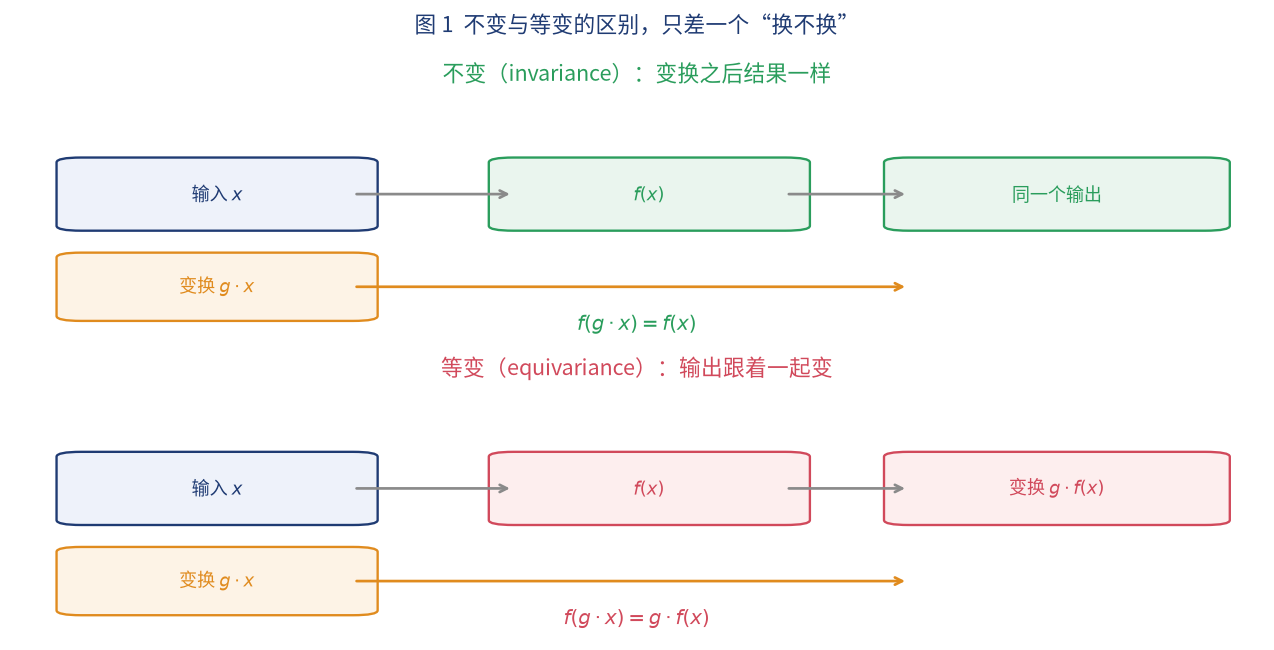
图 1 画出对比:上格是"变换输入、输出照旧"(不变),下格是"变换输入、输出同步变换"(等变)。251 251 251 篇证出的 O ( P X ) = P O ( X ) O(PX)=P\,O(X) O(PX)=PO(X),正是"置换等变"的一个实例;而池化"顺序怎么换结果都一样",则是"置换不变"。
🧩 一张对照表
把前面几篇的结论和更广的架构放到一起:
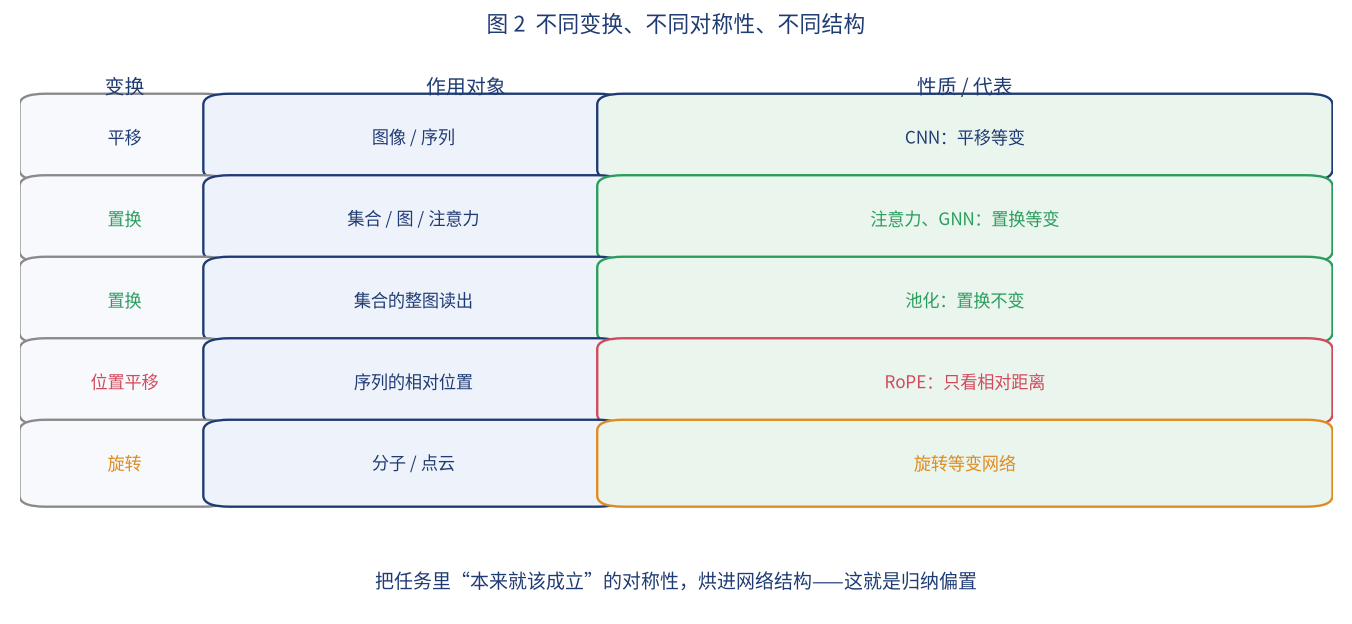
图 2 列了几组"变换 → 作用对象 → 性质/代表":
| 变 换 | 作用对象 | 性 质 / 代表 |
|---|---|---|
| 平移 | 图像 / 序列 | CNN:平移等变 |
| 置换 | 集合 / 图 / 注意力 | 注意力、GNN:置换等变 |
| 置换 | 集合的整体读出 | 池化:置换不变 |
| 位置平移 | 序列的相对位置 | RoPE:只看相对距离 |
| 旋转 | 分子 / 点云 | 旋转等变网络 |
同一张表里,注意力和 GNN 站在"置换等变",池化站在"置换不变",RoPE 站在"相对位置"这一格。 整个位置编码与对称性系列,其实都在反复触碰这张表。
🧩 为什么要把对称性烘进架构
一个自然的疑问:这些性质,让网络自己学不就行了吗,为什么要专门设计?
答案是归纳偏置(inductive bias) 带来的效率。把一条"任务里本来就成立"的性质直接写进结构,等于帮网络排除掉一大批不可能正确的假设。好处有三:
- 省样本:不用从数据里学"平移无所谓""顺序无所谓",结构已经保证;
- 省参数:共享、聚合这些操作本身就是参数高效的(比如卷积核在整张图上共享);
- 更稳健:输入发生对称变换时,输出有可预期的变化,泛化更可靠。
"把必须成立的性质烘进结构,把必须学会的东西留给参数",这是现代架构设计的一条核心思路。
🧩 对称性能在哪几个层面加
"把对称性烘进模型"并不只有一种做法,大致分三个层面:
| 层 面 | 做 法 | 特 点 |
|---|---|---|
| 结构(architecture) | 卷积、注意力、GNN、池化 | 最彻底,天然成立、最省数据 |
| 损失 / 正则(loss) | 惩罚 f ( g ⋅ x ) f(g\cdot x) f(g⋅x) 与 g ⋅ f ( x ) g\cdot f(x) g⋅f(x) 的差异 | 软约束,灵活但要调权重 |
| 数据(augmentation) | 训练时随机施加变换 | 不改结构,但更费数据与算力 |
三者可以叠加。能用结构解决的,优先用结构------它把性质写死了,网络不必再从数据里"悟"。
🧩 不变,其实是等变的特例
这两个词看着并列,其实有包含关系。等变说的是 f ( g ⋅ x ) = g ⋅ f ( x ) f(g\cdot x)=g\cdot f(x) f(g⋅x)=g⋅f(x);如果在这个等变函数后面再接一个对 g g g 不变的读出 R R R(满足 R ( g ⋅ y ) = R ( y ) R(g\cdot y)=R(y) R(g⋅y)=R(y)),那么
R ( f ( g ⋅ x ) ) = R ( g ⋅ f ( x ) ) = R ( f ( x ) ) R\big(f(g\cdot x)\big)=R\big(g\cdot f(x)\big)=R\big(f(x)\big) R(f(g⋅x))=R(g⋅f(x))=R(f(x))
整体就变成不变 的了。这正是 253 篇的配方:注意力(置换等变)再套池化(置换不变),得到一个不变的集合模型。 所以"不变"常常不是单独设计出来的,而是"等变骨干 + 不变读出"自然叠出来的。
🧩 用群的语言说一句
前面反复出现的"变换",其实都属于同一类东西------群(group):一组可以复合、可以求逆、包含"什么都不做"的变换。平移构成平移群、置换构成置换群、旋转构成旋转群。
*等变与不变的定义,本来就是相对某个群而言的 :对置换群等变(注意力/GNN),对平移群等变(CNN)。这里不必深究群论,只要记住"一组能复合、可逆的变换"这个直觉,就足够理解整条主线。
🧩 什么时候要打破对称性
但对称性并非越多越好------它也可能与任务冲突 。语言任务里,"猫吃鱼"和"鱼吃猫"是两回事,顺序是有意义的。这时如果网络坚持置换等变,就永远分不出来。
所以才会故意打破对称性 :251 篇里,因果掩码引入方向、位置编码注入距离;245 篇里,RoPE 用旋转把"相对位置"补进 q , k q,k q,k。它们都是"对称性不适用时,主动把它破坏掉"的措施。
反过来,当任务确实不关心顺序时(点云、集合、整图),就用池化把它变回不变。设计网络,本质上是在"该对称的地方对称、该区分的地方区分"之间做取舍。
🧩 回看整个系列
把两条线合起来看:
- 内容线(
244~250):从"注意力为什么对顺序无感"出发,讲位置编码的三条路径、RoPE 为什么旋转、转哪些维度、用在前向还是推理、有没有替代、长上下文怎么外推; - 对称线(
251~254) :把"顺序无感"升级为置换等变的严格推导,再依次展开"注意力即 GNN""集合与 Deep Sets""对称性统一视角"。
两条线在同一个点交汇:注意力天生置换等变、顺序无感;要让它理解序列,必须主动打破这份对称------这就是位置编码存在的全部理由。 位置编码不是外挂,而是"给对称的架构补上它缺失的那一维"。
更一般地看,这也是深度学习里一条反复出现的思路:先问任务有什么对称性,再决定架构给多少对称性。 给多了,模型表达不出任务需要的区分;给少了,又要靠大量数据去补。位置编码(打破置换对称)与池化(保住置换不变),正是这条思路在两端的具体落点。
🧩 一张设计清单
把上面的取舍落成几个可操作的问题:
| 问 题 | 回答"是" | 回答"否" |
|---|---|---|
| 任务在变换 g g g 下结果相同吗 | 施加该对称性(不变/等变) | 不要强加 |
| 输出是逐元素还是整体 | 逐元素 → 用等变骨干 | 整体 → 等变骨干 + 不变读出 |
| 结构能直接实现该对称性吗 | 改结构(卷积/GNN/池化) | 用损失或数据增强 |
| 顺序对任务重要吗 | 打破对称(掩码 + 位置编码) | 用池化汇总 |
这张表几乎能覆盖过去几篇的所有设计决定:注意力选"置换等变"、池化选"置换不变"、语言模型选"打破对称、补位置编码",都能在这里找到对应的问与答。
🧩 两个常见疑问
- "对称性是不是越多越好?" :不是。对称性越强,约束越硬、表达力越受限。只有当任务确实满足该对称性时才该强加;任务不满足的对称性硬加上去,只会让模型学不动。所以要先问"这个变换下结果该不该变",再决定要不要对称。
- "为什么加了位置编码就'破坏'了对称性?" :因为位置项依赖下标 i i i,使输出不再满足 f ( g ⋅ x ) = g ⋅ f ( x ) f(g\cdot x)=g\cdot f(x) f(g⋅x)=g⋅f(x)。但这是有意的 ------语言任务恰恰需要"顺序不同、结果不同"。破坏对称不是 bug,而是刻意为之的归纳偏置调整。
- "数据增强能替代结构对称性吗?" :能逼近,但代价高。模型得从数据里重新学一遍 本来就已知的性质,样本和算力都更贵;而结构对称性相当于把这条知识免费送给模型。能用结构表达的对称性,就别留给数据。
📌 一句话记忆
把变换记作 g g g: f ( g ⋅ x ) = f ( x ) f(g\cdot x)=f(x) f(g⋅x)=f(x) 叫不变 , f ( g ⋅ x ) = g ⋅ f ( x ) f(g\cdot x)=g\cdot f(x) f(g⋅x)=g⋅f(x) 叫等变 。CNN 平移等变、注意力与 GNN 置换等变、池化置换不变、RoPE 只看相对距离------它们都是把"任务里本来就该成立"的对称性烘进结构当归纳偏置 ,以换取样本效率、参数效率与稳健性。当对称性与任务冲突(如语言在乎顺序),就主动打破 它------掩码给方向、位置编码给距离。"该对称处对称、该区分处区分",就是架构设计在这一维度上的全部学问。
OK,本篇先到这里,如有疑问,欢迎评论区留言讨论,祝各位功力大涨,技术更上一层楼!!!