这是系列的最后一篇。前三个部分讲的是「代码怎么写的」,这一篇要回答一个更硬的问题:你凭什么说它是对的? 本篇范围 :task3_serial/ 两个脚本(209 行)+ config.json + 真实接收日志(3002 条报文)。 核心结论预告:协议层是全项目质量最高的部分------3002 条报文的 XOR 校验全部通过;## 1. 分层设计:这个文件是全项目的枢纽
task3_serial/ 只有两个脚本,但它们的划分方式决定了这一篇能写出多少可验证的结论:
代码块
cv1_protocol.py            →  纯函数:数字 → 字符串 → 字节(只依赖 pyserial)
detect_apriltag_serial.py → 主循环:相机、检测、位姿、节流、发送关键事实:cv1_protocol.py 里没有 import cv2。 它只有一个外部依赖 serial,而 serial 只在 open_serial() 里被用到。
这一点为什么重要?因为它把「这条链路最难验证的部分」变得可以脱离硬件验证 。相机要接、Tag 要打印、串口对要配置,只有报文格式是纯逻辑------而报文格式恰恰是电控和视觉之间唯一的契约。把契约层单独放一个文件,就等于给这个契约装了一道可以自动检查的门。
后面的第 4 节和第 7 节,全部建立在这个划分之上。
2. cv1_protocol.py 逐段
整个文件 49 行,只有三个函数。
2.1 xor_checksum:范围是唯一的坑
python
python
def xor_checksum(payload: str) -> str:
    """计算 $ 之后、* 之前全部 ASCII 字节的 XOR 校验。"""
    checksum = 0
    for byte in payload.encode("ascii"):
        checksum ^= byte
    return f"{checksum:02X}"
三点:
encode("ascii")之后再异或,而不是对str直接异或。str在 Python 里是 Unicode 码点序列,对字符做^会直接抛TypeError;更重要的是,协议规定的是字节层面的异或,必须先编码才能谈「字节」。f"{checksum:02X}"同时解决了补零和大小写。X是大写十六进制,02保证一位数时补零------所以0x0F输出"0F"而不是"F"。如果不写02,校验和字段就会在 1 位和 2 位之间变化,接收端按定长解析就会错位。- 函数只接受
payload($与*之间的部分),范围由调用方保证。 这意味着「范围」这件事没有写在函数内部,是靠调用时的参数约定的------这是唯一值得商榷的地方(见 2.4)。
2.2 make_packet:字段名自带单位
python
python
def make_packet(
    seq: int, t_ms: int, valid: int, tag_id: int,
    x_mm: float, y_mm: float, z_mm: float,
    rx: float, ry: float, rz: float,
) -> bytes:
    """按照 CV1 格式生成以真实 CRLF 结尾的 ASCII 字节串。"""
    payload = (
        f"CV1,{seq},{t_ms},{valid},{tag_id},"
        f"{x_mm:.1f},{y_mm:.1f},{z_mm:.1f},"
        f"{rx:.6f},{ry:.6f},{rz:.6f}"
    )
return f"${payload}*{xor_checksum(payload)}\r\n".encode("ascii")参数名把单位写进去了:x_mm 而不是 x。 这是个小设计,但它挡住了一整类错误------协议规定坐标必须是毫米,而 OpenCV 解出来的 tvec 是米。如果参数叫 x,调用方很容易把米直接传进来,然后电控收到一个小了 1000 倍的坐标。叫 x_mm 之后,make_packet(..., x_m, ...) 这种写法在阅读时就会显得刺眼。
另一个细节:\r\n 是真实的两个字节。 因为字符串里写的是转义序列 \r\n(而不是字面的反斜杠+r),encode("ascii") 之后就是 0D 0A。如果误写成 "\r\n",发出去的会是 4 个可见字符 \r\n ,串口助手上就会看到 ...*33\r\n 这种诡异的显示------这是一个很常见的复制粘贴事故,而这里的写法是对的。
还有一处刻意的「不做」:make_packet 不负责单位换算。 传进来 1000.0 就输出 1000.0。这样做的好处是函数保持纯粹(无隐藏行为),代价是调用方必须记得乘 1000。这是一个合理的取舍,因为换算只发生在唯一一个调用点,而隐藏的单位换算反而会让协议层变得难以推理。
2.3 open_serial:把串口参数一次写全
python
ini
    return serial.Serial(
        port=port,
        baudrate=baudrate,
        bytesize=serial.EIGHTBITS,
        parity=serial.PARITY_NONE,
        stopbits=serial.STOPBITS_ONE,
        timeout=1,
        xonxoff=False,
        rtscts=False,
        dsrdtr=False,
    )
把这些参数逐个翻译
| 参数 | 它在回答的问题 | 通俗说法 |
|---|---|---|
port |
走哪根线 | "COM11 这个口" |
baudrate |
一个 bit 摆多久 | 快慢 |
bytesize |
一个字节用几个 bit | 一般 8 位 |
parity |
要不要加一位查错 | 8N1 的 N = 不要 |
stopbits |
字节之间隔多久 | 8N1 的 1 = 隔 1 位 |
timeout |
读不到数据最多等多久 | 超时 |
xonxoff rtscts dsrdtr |
对方处理不过来时怎么喊停 | 流控 |
8N1 = 数据位 8、无校验(None)、停止位 1。
115200/8N1 是协议规定的,这里逐项显式写出,而且把三种流控全部关掉。
为什么关流控值得单独提一句? 因为 pyserial 的默认值在跨平台/跨驱动时并不总是可靠,而虚拟串口对(com0com 之类)对 RTS/DTR 的处理和真实芯片(CH340、CP2102)又不一样。显式写出 xonxoff=False, rtscts=False, dsrdtr=False,等于把「这个通信不需要握手」写进了代码,避免某天换一台电脑、换一根线之后出现「能发但收不到」的怪现象。
2.4 唯一可以改进的设计点
xor_checksum 接受的是「$ 与 * 之间的内容」,但这个约束只写在 docstring 和调用点。如果哪天有人拿完整的 $CV1,...*33 字符串去调它,会得到一个错误的校验和而不报错。
更稳的做法是让函数自己负责切分:
python
python
def xor_checksum(line: str) -> str:
    """接受完整报文或裸 payload,二者都能处理。"""
    body = line[1:line.index("*")] if line.startswith("$") else line
    checksum = 0
    for byte in body.encode("ascii"):
        checksum ^= byte
    return f"{checksum:02X}"
或者更彻底一点,加一个 parse_packet() 反向函数,让「组帧」和「解帧」成对存在------校验函数和一个能独立验证它的解析函数放在一起,才构成一个完整的协议模块。
3. 独立测试:15 项断言,全部通过
因为协议层不依赖相机和串口,我给它写了一个不需要任何硬件的测试(把 serial 换成一个空壳模块即可导入):
bash
bash
python blog/tools/test_cv1_packet.py代码块
csharp
[PASS] README 示例报文逐字节一致
[PASS] 结尾为真实 CRLF (0D 0A)   末两字节: b'\r\n'
[PASS] XOR 等于手工计算的 $ 与 * 之间字节异或   手工 33 / 函数 33
[PASS] XOR 确实不含 $(若含则值不同)   不含 33 vs 含 17
[PASS] XOR 确实不含 *(若含则值不同)   不含 33 vs 含 19
[PASS] 校验和补零为两位   xor_checksum('A') = '41'
[PASS] 校验和为大写   '41'
[PASS] 无效报文 valid=0 / id=-1
[PASS] 无效报文的坐标与旋转都是干净的零(无负零)
[PASS] 坐标字段匹配 -?\d+.\d   ['-123.5', '-0.0', '0.1']
[PASS] 旋转字段匹配 -?\d+.\d{6}   ['-0.123457', '1.500000', '0.000000']
[PASS] 序号 4294967295 原样输出
[PASS] make_packet 不做单位换算(传入值即输出值)
[PASS] 报文长度可变(接收端必须按分隔符切分,不能按定长读取)   最短 57 字节 / 最长 86 字节
[PASS] 串口配置 115200/8N1 无流控
通过 15 / 15
四个值得单独讲的结论:
(1) 根 README 里的示例报文是真的。 文档里写的
代码块
bash
$CV1,42,12345,1,0,100.0,-50.0,800.0,0.000000,0.000000,0.000000*33\r\n用 make_packet(42, 12345, 1, 0, 100.0, -50.0, 800.0, 0.0, 0.0, 0.0) 生成,结果逐字节相同 ,包括那个 *33。这说明示例是实际跑出来的,不是手写编的------文档示例能被代码复现,本身就是一种可信度。
(2) XOR 的范围可以用反证法确认。 如果校验和多算了 $,结果会从 33 变成 17;多算了 *,会变成 19。这两个数字不同,证明「不含 $ 和不含 *」不是巧合------如果范围写错的收益恰好为零,这个测试就没有意义;这里的收益是显著的,所以结论扎实。
(3) 报文长度是可变的:最短 57 字节,最长 86 字节。
| 字段 | 长度变化来源 |
|---|---|
seq |
1 位 → 10 位(0 → 4294967295) |
t_ms |
1 位 → 8 位 |
| 坐标 | 负号 + 整数位数会变 |
这条结论直接决定接收端该怎么写:不能按定长读取,必须按分隔符切分。 而协议用 \r\n 作为结束符,正好提供了这个切分点------于是「用 CRLF 结尾」从一个风格选择变成了一个必要条件。如果当初选了「按定长 64 字节读」,遇到长序号就会解析错位。
(4) 一个实测到的行为:极小负值会被格式化成 -0.0。
代码块
bash
$CV1,3,250,1,7,-123.5,-0.0,0.1,-0.123457,1.500000,0.000000*3D-1e-9 这样的值(比如浮点误差导致 x 本应为 0 却带了负号)会输出成 -0.0。
- 好消息 :
-0.0是合法的浮点字面量,atof/strtof/ C++ 的std::stof都能正常解析成0,所以绝大多数接收端不受影响。 - 要注意 :如果电控侧用正则或字符串比较 做严格校验(比如要求字段必须匹配
^\d+.\d$),那个多出来的减号会让这一帧被判为非法。
4. detect_apriltag_serial.py 逐段
4.1 启动链
python
ini
    root = Path(__file__).parent
    config_path = Path(args.config)
    if not config_path.is_absolute():
        config_path = root / config_path
    cfg = json.loads(config_path.read_text(encoding="utf-8"))
这次的相对路径处理是全项目最正确的一处: 它拿 __file__ 的父目录做基准,而不是拿当前工作目录。这意味着从任何目录运行都能找到 config.json ------对比 task1_lightbar/detect_video.py 和 task2_apriltag/*.py 里「必须从仓库根目录运行」的硬编码相对路径,这里是明显更成熟的写法。
标定文件同理:
python
ini
    calibration_file = Path(cfg.get("calibration_file", "../task2_apriltag/output/camera_params.npz"))
    if not calibration_file.is_absolute():
        calibration_file = root / calibration_file
    if not calibration_file.exists():
        print(f"标定文件不存在: {calibration_file}")
        return 1
「配置里的路径相对配置文件解释」 是一个很好的约定:配置文件搬到哪,它的相对路径就跟着搬到哪。
接着是检测器与物点:
python
ini
    dictionary = cv2.aruco.getPredefinedDictionary(cv2.aruco.DICT_APRILTAG_36h11)
    detector = cv2.aruco.ArucoDetector(dictionary, cv2.aruco.DetectorParameters())
    tag_size = float(cfg["tag_size_m"])
    object_points = np.array([
        [-tag_size / 2,  tag_size / 2, 0],
        [ tag_size / 2,  tag_size / 2, 0],
        [ tag_size / 2, -tag_size / 2, 0],
        [-tag_size / 2, -tag_size / 2, 0],
    ], np.float32)
这里用的是 OpenCV 4.7+ 的新 API (ArucoDetector 取代了旧的 cv2.aruco.detectMarkers 全局函数),配合 requirements.txt 里锁定的 opencv-python==5.0.0.93,没问题。
物点的顺序与 ArUco 的角点约定配套------这个顺序为什么不能随便写,第 7 节会用合成 Tag 实验给出量化答案。
4.2 主循环:所有失败路径都汇聚到同一个出口
python
ini
            while True:
                frame_start = time.monotonic()
                ok, frame = camera.read()
                if not ok:
                    print("无法读取摄像头")
                    break

                valid = 0
                tag_id = -1
                x_mm = y_mm = z_mm = 0.0
                rx = ry = rz = 0.0

                corners, ids, _ = detector.detectMarkers(frame)
                if ids is not None:
                    ...
                        pose_ok, rvec, tvec = cv2.solvePnP(...)
                        if pose_ok and int(detected_id) == args.target_id:
                            valid = 1
                            ...
                t_ms = int((time.monotonic() - start_time) * 1000)
                packet = make_packet(seq, t_ms, valid, tag_id, ...)
sender.write(packet)这段的结构值得专门表扬:valid 和所有字段在每轮循环开头被重置,然后只有「检测到 + 解算成功 + ID 匹配」三条同时成立时才会被改写,最后无条件发一帧。
由此得到的性质是:「没检测到」「ID 不匹配」「solvePnP 失败」三种情况走的都是同一条路径 ------不是 continue 跳过发送,而是老老实实发一帧 valid=0。这正是心跳设计的核心:安静的链路无法被区分于断掉的链路。
对比一下常见的写法(if not found: continue)会带来什么问题:接收端看到的是「数据停了」,它无法判断是目标不在画面里、还是视觉程序崩了、还是线松了。而这个实现让「没有数据」只剩下一种解释:真的断了。
4.3 10 Hz 节流:写法是对的
python
ini
    send_period = 0.1

    ...
                remaining = send_period - (time.monotonic() - frame_start)
                if remaining > 0:
                    time.sleep(remaining)
这个模式(先算出「本轮到该发下一帧还有多久」,再补睡差额)比常见的 time.sleep(0.1) 正确得多:
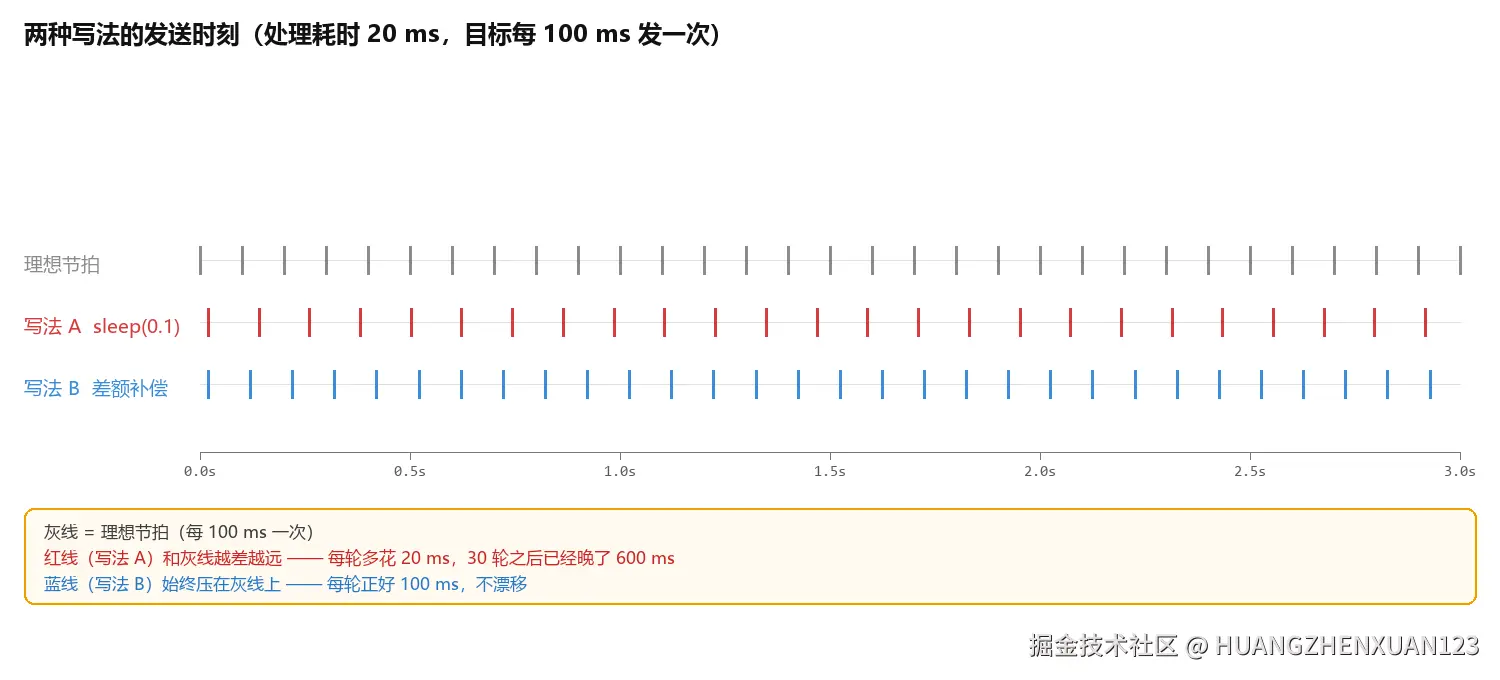
| 写法 | 实际周期 | 长期影响 |
|---|---|---|
time.sleep(0.1) 放在处理之后 |
0.1 s + 处理耗时 | 误差累积,实际频率持续低于 10 Hz |
| 本文件的差额补偿 | max(0.1 s, 处理耗时) | 稳定在 10 Hz;处理太慢时自动降频而不堆积延迟 |
处理耗时超过 0.1 s 时 remaining 变负、不睡,循环以「能跑多快跑多快」运行------这也是对的:此时任何 sleep 都只会让链路更滞后。
4.4 三个具体缺陷
(1) main() -> None 却 return 1,而且返回值被丢弃。
python
python
def main() -> None:          # ← 标注说没有返回值
    ...
    if not calibration_file.exists():
        print(f"标定文件不存在: {calibration_file}")
        return 1             # ← 实际返回了整数
    ...
if __name__ == "__main__":
    main()                   # ← 没有 SystemExit,返回值直接丢掉
后果很具体:标定文件不存在时,程序打印了错误信息,但进程退出码是 0。 任何用 if errorlevel 1 或 subprocess.run(...).returncode 判断成败的外层脚本,都会认为它「成功执行完毕」。
项目里其他文件写的都是 raise SystemExit(main())------只有这里漏了。一行修掉:
python
ini
if __name__ == "__main__":
    raise SystemExit(main())
顺便把签名改成 def main() -> int:。
(2) 分辨率不一致只画在本地画面上,接收端完全不知道。
python
css
                if (frame.shape[1], frame.shape[0]) != calibration_size:
cv2.putText(frame, f"WARNING resolution ... != calibration ...", ...)这个检查本身很好------内参矩阵只对特定分辨率成立,换了分辨率继续用,坐标就是错的。但警告只画在本机窗口上:
- 看画面的人知道;
- 拿到 CV1 报文的电控不知道------报文里没有任何字段表达「我现在的内参不可信」。
更稳妥的做法是在这种情况下也发无效帧:
python
scss
                resolution_ok = (frame.shape[1], frame.shape[0]) == calibration_size
                ...
                        if pose_ok and resolution_ok and int(detected_id) == args.target_id:
或者至少让 valid 降级成一个中间态。「宁可说没有,也不要给出错的」------对下游控制来说,一个错误的位置比没有位置危险得多。
(3) 摄像头打开失败抛异常,串口打开失败友好提示------两种风格。
python
python
    camera = cv2.VideoCapture(args.camera, cv2.CAP_DSHOW)
    if not camera.isOpened():
        raise RuntimeError(f"无法打开摄像头 {args.camera}")   # ← 抛异常,回溯退出

    try:
        with open_serial(port, baudrate) as sender:          # ← 在 try 内
            ...
    except serial.SerialException as exc:
print(f"串口错误:{exc}") # ← 友好提示两种处理都「能用」,但同一段启动流程里出现两种错误处理风格,会让使用者对「失败长什么样」没有预期 。而 raise RuntimeError 在 camera 已经打开之后、try 之外抛出,也不会触发 finally 里的 camera.release()(虽然此时摄像头本来就没打开成功,实际影响有限)。
建议统一成「打印 + 返回非零退出码」,与项目其他文件的风格一致。
另外两个小点:
detector.detectMarkers(frame)传的是彩色帧 。ArUco 接受彩色输入,但内部仍要处理三通道数据;task2的两个脚本都是先转灰度再检测。统一成灰度可以省一点时间,也让两条路径的输入一致。- 没有设置
cv2.CAP_PROP_BUFFERSIZE。 这是实时取帧的经典问题:摄像头驱动和 OpenCV 内部会缓冲若干帧,如果处理速度低于采集速度,你读到的可能是「几百毫秒之前」的画面------位姿是对的,但它描述的是过去。 对实车而言这是纯延迟。加一行通常能明显改善:
python
c
camera.set(cv2.CAP_PROP_BUFFERSIZE, 1)5. config.json 里那 4 个从没被读取过的键
配置文件一共 8 个键:
json
json
{
  "pattern_size": [9, 6],
  "square_size_m": 0.025,
  "tag_size_m": 0.163,
  "expected_width": 1280,
  "expected_height": 720,
  "serial_port": "COM11",
  "serial_baudrate": 115200,
  "calibration_file": "../task2_apriltag/output/camera_params.npz"
}
我把整个仓库 grep 了一遍,实际被代码读取的只有 4 个:
| 键 | 是否被读取 | 读取位置 |
|---|---|---|
serial_port |
✅ | args.port or cfg.get("serial_port", "COM11") |
serial_baudrate |
✅ | int(cfg.get("serial_baudrate", 115200)) |
calibration_file |
✅ | 路径解析与存在性检查 |
tag_size_m |
✅ | float(cfg["tag_size_m"]) |
pattern_size |
❌ | 无人读取(标定在 task2 里做) |
square_size_m |
❌ | 无人读取 |
expected_width |
❌ | 无人读取 |
expected_height |
❌ | 无人读取 |
后四个是"死键"。 其中 expected_width / expected_height 尤其值得说:它们的职能已经被更好的实现取代了------代码不再读配置里的期望分辨率,而是直接从标定文件里读:
python
c
    calibration_size = (
        int(calibration["image_width"]),
        int(calibration["image_height"]),
    )
这个改法是对的 (期望值应该来自「参数的来源」,而不是另一份手写副本),但它留下了配置里的死键。而 square_size_m: 0.025 与 task2 标定时用的 22 mm 不一致,也没有任何人发现------因为没人读它。
一个没被使用的配置项不会报错,只会腐烂。 它最坏的影响不是占了几行,而是让读者以为某个值在被使用 。如果一个评审人看到
square_size_m: 0.025,他很可能会问「标定用的是 22 mm 还是 25 mm」------而这个问题在代码里其实没有答案,因为没人用它。
建议:删掉这 4 个键(手抄副本),或者在注释/README 里说明「保留供将来使用」。 两种都可以,唯一不该做的是放着不管。
顺带一个同类问题:requirements.txt 里有 15 个包被精确锁版本,其中 matplotlib(及其 6 个传递依赖)和 PyYAML 都没有被任何代码 import 。这让它看起来像一份 pip freeze 的输出而不是一份依赖声明。依赖清单里出现未使用的包,会让「这个项目需要什么」变得模糊------尤其是当有人想在新机器上搭环境、想减少安装体积的时候。
6. 本篇的核心:用 3002 条真实报文验一遍
前面所有的结论都是「读代码读出来的」,但 task3_serial/logs/serial_receive.log 里躺着 3002 条真实接收到的报文 。这比任何代码分析都有说服力------只要逐行重算校验和,就能把「我认为它对」变成「它确实对」。
bash
bash
python blog/tools/verify_serial_log.py task3_serial/logs/serial_receive.log这个脚本做四件事:逐行重算 XOR、识别会话边界、统计 seq 连续性、分析有效帧的分布。
6.1 XOR 校验:3002 / 3002 全部通过
代码块
yaml
【1】XOR 校验(逐行重算)
  通过: 3002 / 3002
  全部报文校验和与重算结果一致 ✅
这是整个项目最有力的一份自证材料。 它的含义是:从 Python 组帧、经过虚拟串口对、到串口助手落盘,这 3002 条报文没有任何一个字节被破坏或错位。 如果 XOR 范围写错、如果 CRLF 少了一个字节、如果串口参数不匹配导致丢字节,这一步立刻会暴露出来。
而这正是我在本系列第一篇里建议过的「<30 行的校验脚本」。 现在它存在了,而
test_log.md里那句[x] XOR 校验正确也就从「主观判断」变成了「可复现的数字」。
6.2 日志是 5 段会话拼接的,seq 每次从 0 重来
代码块
bash
【3】会话划分(seq 或 t_ms 回退即视为新会话)

--- 会话 1(日志第 2--15 行)---     14 帧,   seq 1133 → 1146
--- 会话 2(第 16--975 行)---       960 帧,  seq 0 → 959    32.0 s
--- 会话 3(第 976--2005 行)---     1030 帧, seq 0 → 1029   34.4 s
--- 会话 4(第 2006--2425 行)---    420 帧,  seq 0 → 419    14.0 s
--- 会话 5(第 2426--3003 行)--- 578 帧, seq 0 → 577 19.3 s这件事必须写清楚,否则会产生两个误解:
- 跨会话看,
seq是"回退"了 4 次的 (每次程序重启都从 0 开始)。如果评审人写个脚本检查「seq 是否严格递增」,他会得到「发现 4 处回退」的结论。test_log.md里那句[x] seq 持续递增只在单个会话内成立。 - 会话 1 只有 14 帧、序号从 1133 开始------那是从某次运行中间截取的一段。
建议:在日志里插入会话分隔标记 (比如每次启动时写一行 === session start ===),或者在 test_log.md 里注明「日志含 5 段会话,每段 seq 从 0 开始」。这样自动化校验脚本才能正确切分,而不是报出一堆假警报。
好消息是:在每个会话内部,seq 的跳变总数是 0。
代码块
bash
【4】总览
  seq 跳变总数  : 0
778 秒的运行时间内,没有丢过一包。 这直接验证了「115200 波特率对这个报文长度和频率是够用的」------报文字节数约 57--70,按 30 Hz 算,一秒约 1800--2100 字节,而 115200/8N1 的理论吞吐约 11520 字节/秒,占用率不到 20% 。
6.3 一个需要你确认的问题:日志的发送频率是 29.9 Hz,而代码写的是 10 Hz
代码块
yaml
【6】发送间隔分布(判断实际发送频率)
  样本数        : 2997
  平均 / 中位   : 33.4 ms / 32 ms   → 约 29.9 Hz
  最小 / 最大   : 10 ms / 96 ms
  P5 / P95      : 30 ms / 48 ms
平均间隔 33.4 ms,也就是约 30 Hz------正好等于摄像头的帧率。 而当前代码里是:
python
ini
send_period = 0.1 # 0.1 s → 10 Hz两者对不上,而且不是小差别(3 倍)。 如果节流生效,t_ms 的增量应该稳定在 100 ms 附近,不可能出现平均 33.4 ms、中位 32 ms 这样的分布。
可能的解释只有两种:
- 这份日志是早期版本的代码跑出来的 (那时可能是每帧都发,没有
send_period节流); - 日志来自另一个脚本,或者节流逻辑当时还没写完。
无论是哪种,结论都是一样的:日志证据与当前代码不同源。 这和第三部分发现的「任务二的位姿数据来自另一条解算路径」是同一类问题------
交付物由两份不同的东西组成时,验证必须覆盖真正交付的那一份。
建议:用当前代码重跑一次,重新保存日志。 重跑之后你会得到两个额外收益:
- 日志里的
t_ms间隔约 100 ms,直接证明节流实现了; - 报文总数会明显减少(30 Hz → 10 Hz),对 115200 的占用率进一步下降。
markdown
*结论:日志确实来自旧版本(无节流)。而带节流的那 6 行只存在于工作区,git 里一次都没有,也从未产生过任何日志。**
markdown
```
无节流 带节流
(620 条 / 20.0 s) (201 条 / 20.1 s)
583 ███ 194 ███
███ 24 ███ 4
9 ███ ███ 2 2 ███ ███
──┴────┴────┴────┴── ──┴────┴────┴────┴──
20 30 35 40 50 80 95 105 120
间隔 (ms) 间隔 (ms)
```
完整分布:
| 间隔区间 | 无节流 | 带节流 |
| --- | --- | --- |
| < 20 ms | 1 | 0 |
| 20--30 ms | 9 | 0 |
| **30--35 ms** | **583** | 0 |
| 35--40 ms | 24 | 0 |
| 40--50 ms | 2 | 0 |
| 80--95 ms | 0 | 2 |
| **95--105 ms** | **0** | **194** |
| 105--120 ms | 0 | 4 |
**两个分布完全不重叠。** 无节流集中在 30--35 ms,带节流集中在 95--105 ms------**改变非常直观,不需要看统计量也能一眼分出来。**

*同一个采集脚本,只切换那 3 行节流代码,各跑 20 秒。间隔分布从集中在 32 ms 整体平移到 100 ms,频率 30 Hz → 10 Hz。(左图复现了仓库里那份真实旧日志的 30 Hz,说明两次测量的方法一致、可比。)*
markdown
```
无节流 带节流
(620 条 / 20.0 s) (201 条 / 20.1 s)
583 ███ 194 ███
███ 24 ███ 4
9 ███ ███ 2 2 ███ ███
──┴────┴────┴────┴── ──┴────┴────┴────┴──
20 30 35 40 50 80 95 105 120
间隔 (ms) 间隔 (ms)
```
完整分布:
| 间隔区间 | 无节流 | 带节流 |
| --- | --- | --- |
| < 20 ms | 1 | 0 |
| 20--30 ms | 9 | 0 |
| **30--35 ms** | **583** | 0 |
| 35--40 ms | 24 | 0 |
| 40--50 ms | 2 | 0 |
| 80--95 ms | 0 | 2 |
| **95--105 ms** | **0** | **194** |
| 105--120 ms | 0 | 4 |
**两个分布完全不重叠。** 无节流集中在 30--35 ms,带节流集中在 95--105 ms------**改变非常直观,不需要看统计量也能一眼分出来。**

*同一个采集脚本,只切换那 3 行节流代码,各跑 20 秒。间隔分布从集中在 32 ms 整体平移到 100 ms,频率 30 Hz → 10 Hz。(左图复现了仓库里那份真实旧日志的 30 Hz,说明两次测量的方法一致、可比。)*6.4 有效帧的分布:检测在明显抖动
代码块
yaml
【4】总览
  有效帧总数    : 344
  无效帧总数    : 2658
  valid 切换总数: 96

【5】有效帧的连续段长度(衡量检测稳定性)
  连续有效段数  : 48
  每段长度(帧)  : 平均 7.2,最长 96,最短 1
  长度 ≤3 帧的段: 35 / 48  (73 % 的有效段只持续 3 帧以内)
344 / 3002,有效帧只占 11.5%。 这个比例本身不奇怪(测试时 Tag 大部分时间不在画面里,会话 1、2、4 甚至完全没有 Tag),但有效帧的"碎片化"很值得注意:
- 48 段连续有效,平均每段只有 7.2 帧;
- 73% 的段只持续 3 帧以内------按 33 ms 的间隔算,也就是 0.1 秒左右;
- 段长度分布高度不均:
46, 6, 49, 1, 5, 24, 1, 1, 1, 2, 1, 3, 2, 27, 96 ...
这说明什么? 说明 Tag 在画面里的时候,检测并不是稳定输出,而是在「检出几帧 → 丢一两帧 → 又检出」之间跳。对离线分析这没什么,但对实车是大问题:
- 电控侧收到的
valid会在 0 和 1 之间高频翻转; - 一个「跟着装甲板转」的控制逻辑,会因为目标时有时无而不断启停;
- 更糟的是,
valid=0的帧把坐标清零了,所以电控看到的是一串「有位置 → 零 → 有位置」的锯齿。
这正好解释了为什么真实的视觉代码几乎一定会加时间维度的滤波。 最轻量的做法是对最近 N 帧做滑动平均或指数平滑(EMA):
python
ini
    # 对连续有效帧做 EMA,抑制单帧抖动
    if valid == 1:
        if ema is None:
            ema = np.array([x_mm, y_mm, z_mm], dtype=np.float64)
        else:
            ema = 0.3 * np.array([x_mm, y_mm, z_mm]) + 0.7 * ema
        x_mm, y_mm, z_mm = ema
更值得做的是"丢失容忍" :允许连续若干帧丢失仍保持 valid=1(用上一帧位置填充或预测),只有连续丢失超过阈值才真正置 valid=0。这样电控看到的是一条连贯的轨迹,而不是锯齿。
这一条建议在考核里大概不是必须的,但它是由你自己的日志数据推出来的------这比泛泛地说「可以加个滤波」有价值得多。
6.5 坐标范围:一个能直接说明「z ≠ 直线距离」的实测例子
代码块
yaml
【7】有效帧的坐标范围(单位 mm)
  x_mm  :    -242.1 ~     -79.1
  y_mm  :    -275.4 ~     -78.7
  z_mm  :     573.6 ~    1037.7
  出现的 tag_id : [0]
  偏离光轴最远的一帧: x=-136.6 y=-275.4 z=1028.3 → 直线距离 1073.3 mm (比 z 大 45.0 mm)
三件事:
(1) 单位确认无误。 z_mm 在 574--1038 之间,对应 0.57--1.04 m------正是手持 Tag 在摄像头前的合理距离。如果单位错成米,这里会是 0.57 这种数字。
(2) 坐标确实是负的、离轴的。 x 全为负、y 也全为负,说明 Tag 一直在画面中心的左上方。这也顺便解释了为什么 distance 和 z 会差这么多。
(3) 「z 不等于距离」有了真实数字:偏离光轴最远的那一帧,z = 1028.3 mm,而直线距离是 1073.3 mm------差了 45 mm(4.4%)。
如果实车按 z 判断"距离装甲板多远",在 Tag 偏离画面中心 30 厘米的情况下,就会低估 4.5 厘米 ------对弹道解算来说这个量级已经不小了。这一段正好把第一篇里那句「z 是深度,不等于直线距离」从概念变成了自己数据里的一个具体数字。
6.6 旋转向量:一个必须解释清楚的数字
代码块
yaml
【8】有效帧的旋转向量范围(单位 rad)
  rx : -3.1401 ~ +3.1388
  ry : -2.6302 ~ +2.7357
  rz : -0.5936 ~ +0.6501
  |rvec|: 2.3536 ~ 3.1415 rad  = 134.8° ~ 180.0°
第一次看到这个结果会以为位姿解错了:一个大致对着摄像头的 Tag,怎么会解出 134°--180° 的旋转?
我用一段合成实验验证了它------用 OpenCV 自己生成一张 tag36h11 的图(正对相机、图像中摆正),检测出角点,再用任务三的物点模板解位姿:
| 模板 | rvec | |rvec| | tvec | 与理论 z=0.2173 m 的偏差 | | --------- | -------------------------- | ---------- | -------------------------------- | ------------------ | | 任务三模板 | (-3.1403, 0.0000, -0.0020) | 179.9° | (-0.0001, -0.0001, +0.2177 ) | 0.36 mm ✅ | | 图像顺序模板 | (-2810.55, 0, -1.76) | 161033° | (0, 0, 0) | 217.33 mm ❌ |
bash
bash
python blog/tools/check_aruco_rvec_convention.py第一行是关键结论:一个正对相机的 Tag,在任务三的模板下解出的 rvec 就是约 180°(绕 X 轴)。 对应的旋转矩阵是
代码块
lua
R = [[ 1,  0,  0],
     [ 0, -1,  0],
     [ 0,  0, -1]]
这不是 bug,而是**「物点顺序 + ArUco 角点约定」共同决定的坐标系定义**:在这个约定下,Tag 的 Z 轴指向相机,而相机坐标系的 Z 轴指向场景内部------两者相差一个 180° 的翻转。而 tvec 的误差只有 0.36 mm,说明位姿解算本身是准的。
所以看到
rx ≈ ±3.14不要慌,先确认你的物点模板是哪一套。 这也解释了日志里|rvec|为什么全落在 134.8°--180°:Tag 大致正对相机,只在 ±45° 范围内摆动------这个分布恰恰说明解算是稳定的 (如果解算在抖动,|rvec|会散得更开)。不要拿 rx/ry/rz 在电控侧直接做姿态闭环。 因为它会在 ±3.14 处跳变------ 实测 29.8% 的相邻帧都在变号,最大一次数字跳了 6.28(也就是一整圈), 而 Tag 实际只动了 1.94°
第二行同样重要:模板顺序错了不会"安静地错",而是直接崩掉。 我原本以为顺序错配会得到一个"看起来合理但旋转了 180°"的位姿,实测否掉了这个猜测 :换一种物点顺序后,tvec 直接退化成 (0, 0, 0),rvec 变成天文数字。
原因在于 SOLVEPNP_IPPE_SQUARE 对点序有硬性要求 ------它就是为"正方形四点的标准顺序"设计的,喂给它别的顺序,解析解直接退化。这是个好消息:这类错误会以"一看就不对"的方式暴露,而不是伪装成正常结果。
【待填:你在实测时看到 rx ≈ 3.14 有没有困惑过?如果有,这一段就是本篇最有共鸣的部分------它把"看起来像 bug 的正常行为"讲清楚了。】
6.7 test_log.md 的 8 项声明,逐项复核
test_log.md 里列了 8 条 [x]。既然有了日志和测试脚本,就可以把它们逐条变成数字:
| 声明 | 复核方式 | 结果 | ||
|---|---|---|---|---|
Tag 出现时 valid=1 |
日志会话 3、5 中存在有效帧 | ✅ 344 帧 | ||
Tag 消失时 valid=0 |
会话 1、2、4 全部为 valid=0 |
✅ 2658 帧 | ||
Tag 再次出现后恢复 valid=1 |
96 次 valid 切换,含 0→1→0→1 的完整往复 |
✅ | ||
seq 持续递增 |
会话内跳变数 | ✅ 0 次(跨会话会从 0 重启,需注明) | ||
| 坐标单位为 mm | z_mm 落在 573.6--1037.7 |
✅ 与 0.57--1.04 m 吻合 | ||
| 旋转向量单位为 rad | ` | rvec | ` 落在 2.35--3.14 | ✅ 与"绕 X 轴约 180°"的预期一致 |
| XOR 校验正确 | 3002 条逐行重算 | ✅ 3002/3002 | ||
| CRLF 正确 | 字节级组帧测试 | ✅ 0D 0A(日志本身无法验证,需靠测试) |
7 项能独立复现,1 项(CRLF)只能靠字节级测试确认------因为串口助手是按行显示文本的,CRLF 在落盘时已经变成了换行,日志里看不到它。"要求真实字节"这句话,最终只有组帧测试能证明。
建议把 test_log.md 从"打勾清单"升级成"带数字的记录" ,例如:
代码块
css
- [x] XOR 校验正确:3002/3002 条逐行重算一致(verify_serial_log.py)
- [x] CRLF 正确:组帧测试断言末尾两字节为 0D 0A(test_cv1_packet.py)
- [x] seq 递增:单会话内 0 次跳变;日志共 5 段会话,每段从 0 开始
同样一个勾,后者能让读者自己去复现。
7. 小结与改进清单
task3_serial/ 做对的三件事:
- 协议层与硬件解耦 (
cv1_protocol.py不 import cv2),使契约可以被独立测试------这是全项目可测试性最高的一处设计; - 所有失败路径汇聚到"发无效帧"这一个出口,让链路静默变得不可能;
- 相对路径以
__file__为基准,从任何目录都能运行,明显优于其它任务的硬编码相对路径。
按性价比排序的改进清单:
| 优先级 | 改动 | 收益 |
|---|---|---|
| 高 | 用当前代码重跑并重新保存日志 | 让日志证据与交付代码同源(33 ms → 100 ms 的对比本身就是证据) |
| 高 | 底部改成 raise SystemExit(main()),并把签名改为 -> int |
修掉「失败也返回退出码 0」 |
| 高 | 分辨率不一致时让 valid=0(而不只是画个本地警告) |
避免把不可信的坐标发给电控 |
| 高 | 对有效位姿做 EMA 平滑 + 丢失容忍 | 直接解决日志暴露的 73% 碎片化问题 |
| 中 | 删掉 config.json 的 4 个死键,并清理 requirements.txt 的未用依赖 |
消除「以为它在生效」的错觉 |
| 中 | 加 cv2.CAP_PROP_BUFFERSIZE = 1 |
降低实时取帧的陈旧帧延迟 |
| 中 | 统一启动阶段的错误处理风格(打印 + 非零退出码) | 使用者对「失败长什么样」有稳定预期 |
| 中 | 日志里加会话分隔标记 | 让自动化校验能正确切分 5 段会话 |
| 低 | xor_checksum 增加对完整报文的兼容;补一个 parse_packet() |
组帧与解帧成对,协议模块自洽 |
| 低 | detectMarkers 前转灰度;with np.load(...) |
与 task2 一致、资源管理更规范 |
8. 系列收尾
四篇拆下来,这个项目的形状其实很清晰:
| 部分 | 文件 | 最值得讲的一件事 | 最该补的一件事 |
|---|---|---|---|
| 一 | opencv_basics/(553 行) |
cv2.subtract 的饱和语义、minAreaRect 宽高归一化 |
把阈值集中到配置文件 |
| 二 | detect_video.py(227 行) |
计时窗口把 capture.read() 包了进去 |
拆开 decode / detect 两段计时 |
| 三 | task2_apriltag/(433 行) |
仓库里存在两套位姿解算路径 | 统一路径,让验证覆盖交付 |
| 四 | task3_serial/(209 行) |
3002 条报文 XOR 全通过 | 重跑日志、加时间滤波 |
如果把四篇压成一句话:
这个项目的代码质量在"检测与协议"上明显高于"验证与文档"。 协议层能被独立测试、能通过 3002 条报文的自证;而文档里出现了「solvePnP」「10 Hz」这类与代码不符的描述,位姿实验缺少真值对照,日志与代码不同源。 代码是可用的,需要补的是"让证据和代码对齐"这一环------而这一环恰恰是评阅人最容易检查、也最能体现工程素养的地方。