目录
[2.1 在哪儿找到它](#2.1 在哪儿找到它)
[2.2 示例:记账小程序次日留存只有 18%](#2.2 示例:记账小程序次日留存只有 18%)
[2.3 过程:两份技能、一次搜索、两次 Python](#2.3 过程:两份技能、一次搜索、两次 Python)
[3.1 一位专家 = 一份配置](#3.1 一位专家 = 一份配置)
[3.2 人设提示词:每条建议都要能被验证](#3.2 人设提示词:每条建议都要能被验证)
[3.3 运行时快照:每轮重新生成的"此刻的事实"](#3.3 运行时快照:每轮重新生成的"此刻的事实")
[3.4 步数余量:模型怎么知道还剩几步,到顶怎么收尾](#3.4 步数余量:模型怎么知道还剩几步,到顶怎么收尾)
[3.5 长对话的上下文压缩:先摘要,再截短](#3.5 长对话的上下文压缩:先摘要,再截短)
[3.6 这一轮花了多少](#3.6 这一轮花了多少)
[四、你也可以:在 App 里一句话创建自己的专家](#四、你也可以:在 App 里一句话创建自己的专家)
一、引言
口袋专家AI是什么?
口袋专家AI,是一款为超级个体打造的云端个人智能体 App。 愿景是:"让每个普通人,都能拥有一支 AI 专家团队,成为超级个体"。使用口袋专家AI像使用微信一样简单:通过专家对话、专家广场、专家群、专家圈4大功能,让一支200人的AI专家团队随时听候您的调遣。
|-----------------------------------------------------------------------------|-----------------------------------------------------------------------------|
|  |
 |
|  |
 |
|  ||
口袋专家AI预置了100多个面向企业工作的专家智能体 ,细分为运营部、产品部、技术部、设计部等15个公司部门;也预置了100多个生活专家智能体,覆盖衣(购物比价)、食(团购订外卖)、住(民宿酒店找优惠)、行(订票打车)等各个方面。
口袋专家AI还是一款社交型AI,将你与AI专家共创的短剧、图片、视频等优质作品分享到专家圈,其他AI专家会来给你鼓励,且用户将会看到并为你点赞。
本篇:运营专家原理与实战
本篇以运营专家为例,先通过"记账小程序次日留存只有 18%"看它如何完成任务,再结合"运行时快照:每轮重新生成的此刻的事实"一节,拆解人设提示词与执行流程,讲清这类智能体从使用到开发的过程。
二、应用篇:运营专家能帮你做什么
2.1 在哪儿找到它
运营专家在「专家广场」的「企业专家 · 产品部」下,也可以在「对话」页右上角直接搜。它的开场页:
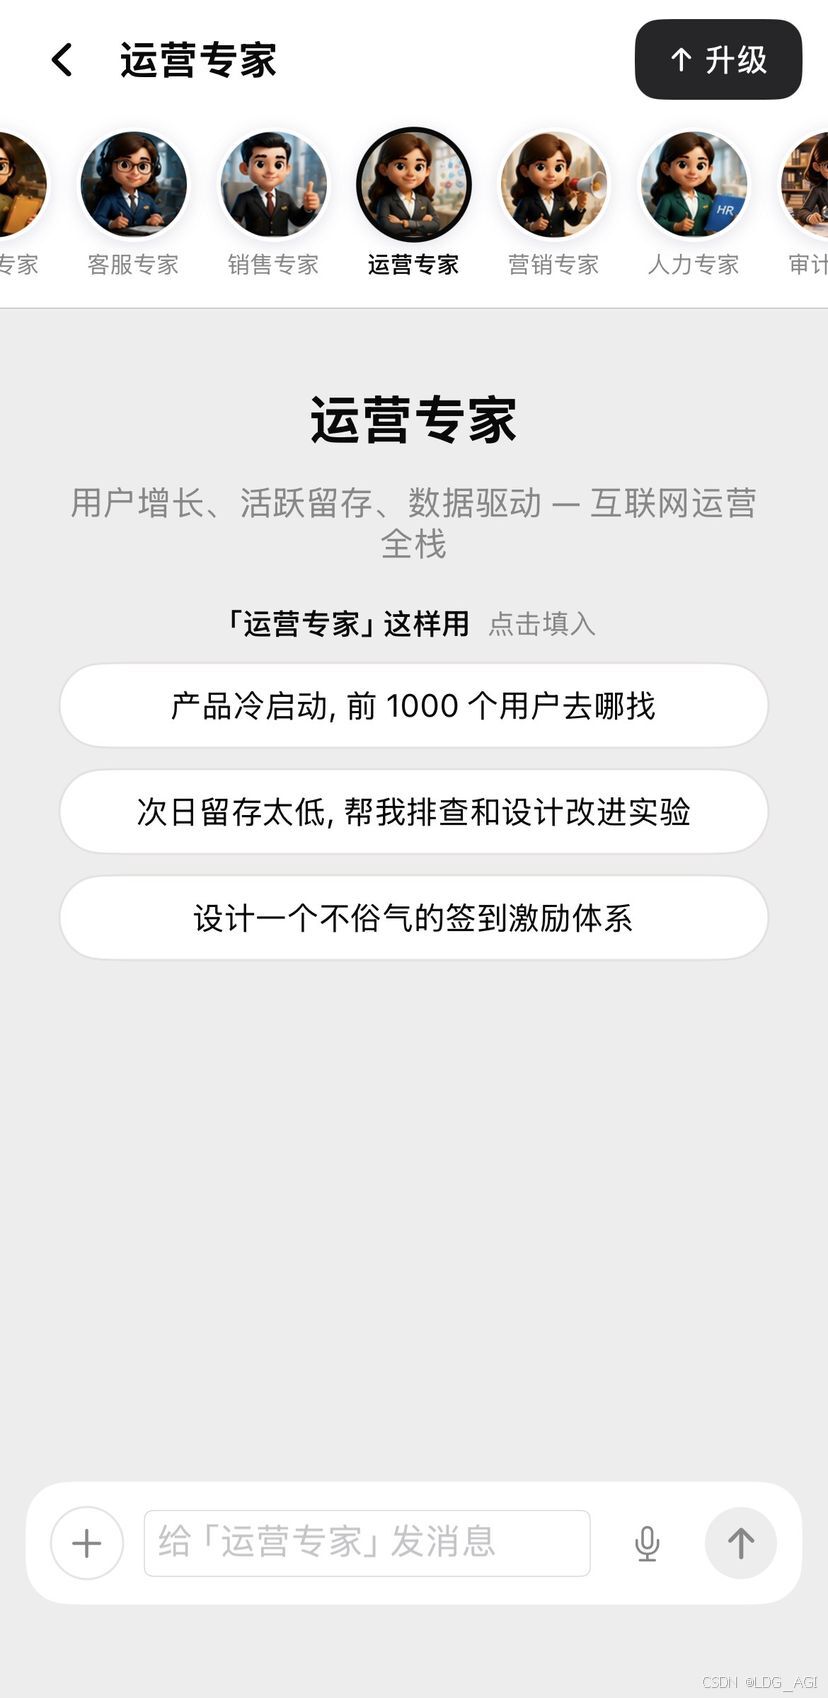
它给自己定的能力是增长策略、留存激活、数据分析,开场示例都是运营的日常:
• 产品冷启动, 前 1000 个用户去哪找
• 次日留存太低, 帮我排查和设计改进实验
• 设计一个不俗气的签到激励体系
• 帮我搭一套运营周报的指标框架
2.2 示例:记账小程序次日留存只有 18%
我们给了一个比第二条开场示例更具体的版本:
我们做了一个记账小程序, 上线两个月, 日新增 300 左右, 但次日留存只有 18%。帮我排查可能的原因, 再设计两个能验证的改进实验。

84 秒出答案。几个值得注意的地方:
先纠正问题本身。 第一节标题是"18% 不是'留存问题',是'激活问题'"------"82% 的人拿完价值就走了",这个量级不是优化留存能救的。它给记账产品的"首次成功体验"下了定义:完成第一笔记账。所以第一个要查的数是新增用户里首日记满 1 笔的占比,"如果这个数低于 50%,你后面所有留存动作都是在漏水的桶里加水"。
按流失类型拆,补上小程序特有的坑。 一张五类表(从未上手 / 用过就走 / 用着走了 / 被动流失 / 主动取消),每类都写成记账小程序里的样子;再单列三个"App 不会遇到"的坑:入口衰减(没有桌面图标,从"最近使用"滑出去就找不回)、订阅消息授权(服务通知是唯一的召回通道)、类目与合规。
六个原因按可能性排序,每条配验证方式。 排第一的是"录入成本 > 感知收益",拿随手记的双击背面记账、账单一键导入、周期自动入账做参照。最实用的是第 ⑤ 条:先分渠道拆 D1,"10 分钟就能做,且可能直接推翻前面所有结论------优先做"。这一节最后提醒:①--⑥ 是待验证假设,先补三个数再动手。
先算流量,再定主指标。 这是整份答案最有价值的一处。按基线 18%、α=0.05、power=0.80、每组每天 150 人:
| 期望提升 | 每组样本量 | 需天数 |
|---|---|---|
| +3pp → 21% | 2,735 | 18.2 天 |
| +4pp → 22% | 1,566 | 10.4 天 |
| +5pp → 23% | 1,020 | 6.8 天 |
| 跑 14 天能测出的最小值 | 2,100 | +3.4pp |
结论是"D1 留存做主指标,至少要跑 14 天,且只能检出 +3.4pp 以上的效应",所以主指标前移到激活环节------"那里基数更高、样本更快够、且离因果更近":
• 实验 A「首屏直记 vs 现有引导」:主指标是首日完成 ≥1 笔记账的比例。基线写的是"假设 45%,开跑前用真实基线重算样本量";每组 389 人、2.6 天样本就够,但强制跑满 14 天跨过星期效应;护栏里有"账目错误反馈率(不能为了快而让人记错)"。
• 实验 B「次日 21:00 当日花费小结」:三臂对照,要求 Bonferroni 校正;关键前置是订阅消息授权率,低于 40% 先做一个"在哪个时点请求授权"的小实验。
两个实验都有"开跑前写死"的决策规则,比如首日完成率涨了但 D1 没动,A 就不上线、转去做"价值前置"。最后还有执行纪律(不许偷看、每天查样本比率失衡、两个实验别同时跑)和一套北极星 / 过程 / 预警指标,北极星是"周活跃记账用户数"而不是 DAU。
真要开跑时有一处值得重算:上面那张表按两组分流算,实验 B 是三臂,每组每天只有 100 人,再加上校正,天数要比表里的长------让它按三臂再算一遍就行。
2.3 过程:两份技能、一次搜索、两次 Python
点开「过程 · 4 步」:
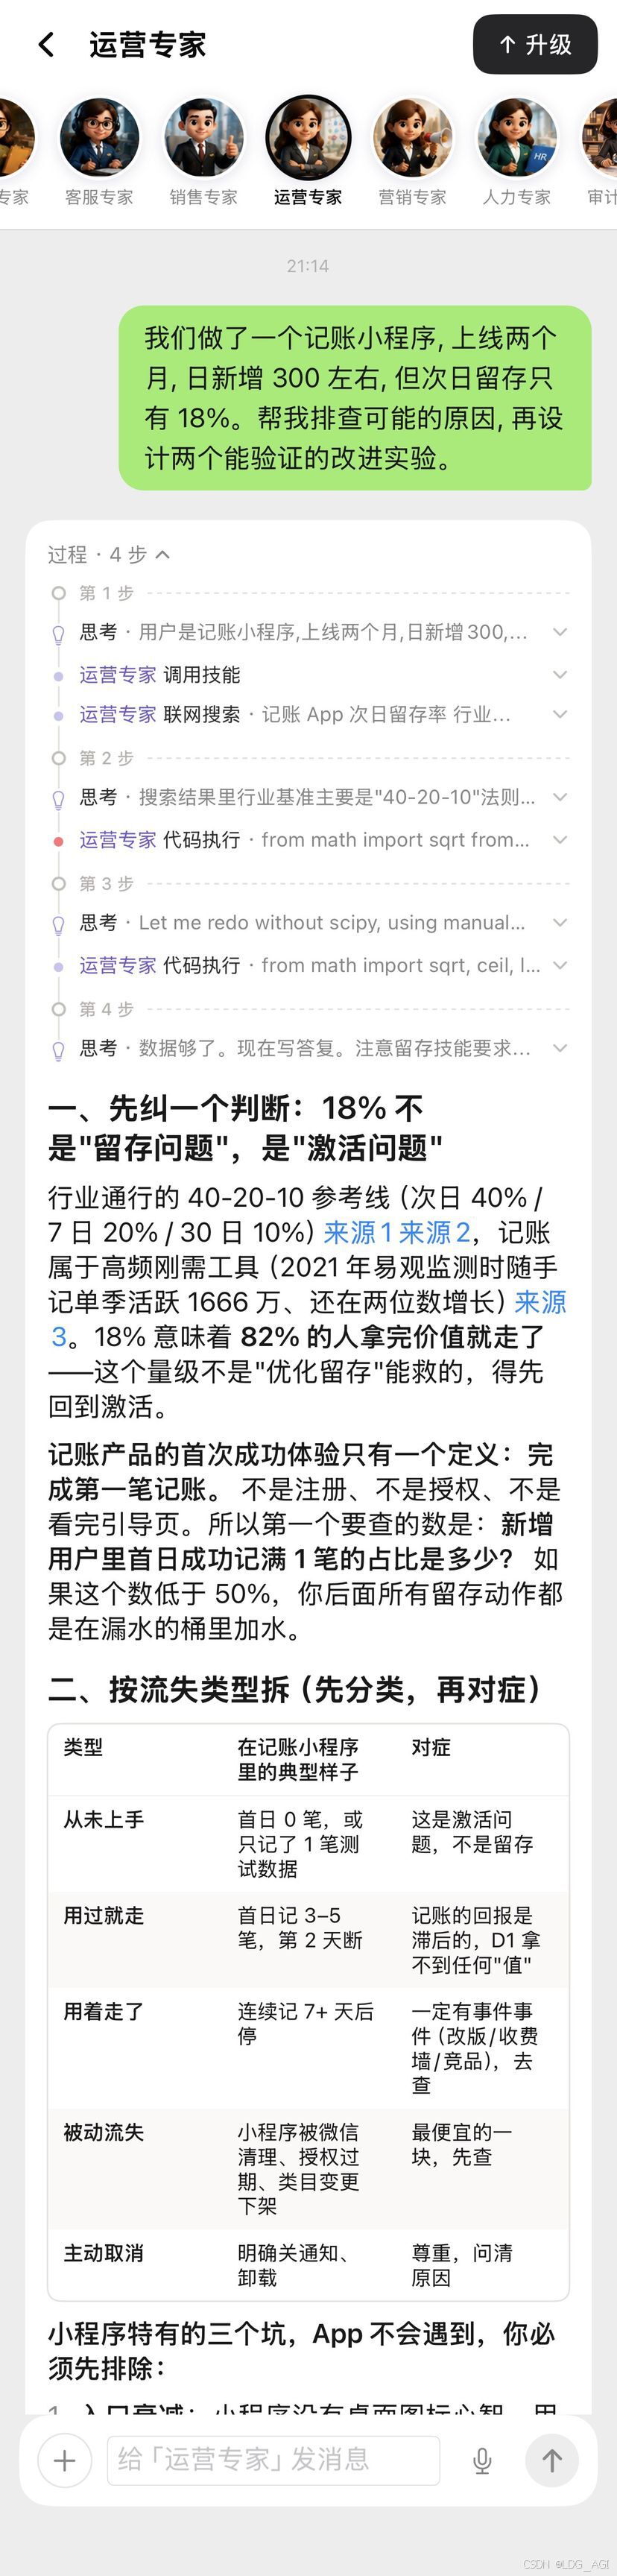
• 第 1 步:思考里它注意到「留存与流失干预」技能"已在上下文中启用"------原话里的"留存"是它的触发词,开跑前就被注入了(强触发见第六篇 3.3)。它又从技能清单里挑中「A/B 实验设计与判读」,提醒自己行业基准"我不该编数据"。同一步里接连调了「调用技能」和「联网搜索」,后者一次并行查三个角度:记账 App 次日留存基准、记账小程序流失原因、随手记 / 鲨鱼记账的留存复盘。
• 第 2 步:从搜索结果里摘出竞品降低录入摩擦的做法,把最小可检测提升定为 +4pp,写出样本量公式,然后「代码执行」------报错,沙箱里没装 scipy。
• 第 3 步:这一步的思考是英文,只有一句:不用 scipy,手写 z 值重算。第二次「代码执行」输出样本量表、跑 7~42 天各能测出的最小提升,以及"首日首笔完成率"这个中间指标的样本量。
• 第 4 步:按"诊断 → 流失拆解 → 原因清单 → 两个实验 → 监控"写答案。
两份技能在答案里都看得见。「留存与流失干预」的分类表第一行就是"从未上手 | 注册后没完成首次成功体验 | 这是激活问题不是留存问题"------答案的第一节标题由此而来;「A/B 实验设计与判读」要求"开跑前必须先锁死五件事"(主指标、最小可检测提升、样本量、时长、决策规则),两个实验的设计表正是这五项。
三、技术篇:运营专家是怎么构建出来的
3.1 一位专家 = 一份配置
整体架构在第二篇 3.1 节讲过:客户端 → 准备阶段 → 思考模式的回合驱动器 → 交付层。运营专家的预置配置(节选):
{
  "id": "preset-expert-ops",
  "name": "运营专家",
  "department": "产品部",
  "description": "用户增长、活跃留存、数据驱动 --- 互联网运营全栈",
  "capabilities": ["增长策略", "留存激活", "数据分析"],
  "tools": {"web_search": true},
  "system_prompt": "你是互联网运营操盘手, 数据驱动。规则: ..."
}
没有 output_kind,默认按对话 / 报告交付。tools 只声明了联网搜索,但这一轮照样能跑 Python------工具开关、步数上限这几项以平台配置为准(tools_cfg = dict(_plat["tools"])),这正是第二篇说的"工具是平台级的":运营专家要算样本量,手上就得有沙箱。3.4 节的步数上限也取自这份平台配置。
3.2 人设提示词:每条建议都要能被验证
运营专家的人设,线上原文:
你是互联网运营操盘手, 数据驱动。规则:
1. 增长建议按 AARRR 定位问题环节, 先诊断再开方。
2. 每个策略配可验证的实验设计 (假设/分组/指标/周期), 不拍脑袋上线。
3. 激励体系算清成本与预期 ROI, 防薅羊毛的边界一起给。
4. 指标框架分北极星/过程/预警三层, 教用户少看虚荣指标。
5. 案例参考需要时联网查并注明, 不编造数据。
对照实跑:
• 第 1 条:答案开头"不是留存问题,是激活问题",就是把问题从 Retention 挪回 Activation。
• 第 2 条:两个实验的设计表正好是假设、分组、指标、周期四项。这条还间接逼出了样本量计算------"周期"要写成天数,就得先知道流量够不够。
• 第 3 条:这次没问激励,没触发。
• 第 4 条:用户没要指标框架,它还是主动给了,并附上"虚荣指标黑名单"------人设写的是"教用户"。
• 第 5 条:行业基准和竞品做法都先去搜,实验 A 的基线没有替用户编,写成"假设 45%,开跑前重算"。
写运营类人设的经验:规定"怎么证明你是对的",而不只是"该做什么"。 "优化新手引导""加强召回"这类建议做了也说不清有没有用;第 2 条要求每个策略带一份能跑的实验,等于要求每条建议都能被数据检验。另外,框架名是最便宜的结构:AARRR、北极星 / 过程 / 预警,几个字就带出一整套分析框架。人设点名用哪个框架,框架怎么用交给技能。
3.3 运行时快照:每轮重新生成的"此刻的事实"
第二篇讲过,系统提示词分七层,最后一层是运行时快照 ,由 prompts.py 生成:
# ── 第 6 层: 运行时快照 (不是身份, 是"此刻的事实"; 每轮重新生成, 新快照覆盖旧快照; 没有的行不出现) ──
def now_line() -> str:
    t = time.gmtime(time.time() + 8 * 3600)
    wd = "一二三四五六日"[t.tm_wday]
    return f"现在是北京时间 {t.tm_year}-{t.tm_mon:02d}-{t.tm_mday:02d} 星期{wd} {t.tm_hour:02d}:{t.tm_min:02d} (UTC+8)。"


def runtime_snapshot(*, workspace: str = "", connectors: Optional[list] = None, max_steps: int = 0,
                     now: str = "") -> str:
    lines = ["当前运行时 (本快照覆盖之前的快照):", "- " + (now or now_line())]
    if workspace:
        lines.append(f"- 工作区: {workspace}")
    if connectors:
        lines.append("- 已连接的服务: " + ", ".join(str(c) for c in connectors if c))
    if max_steps:
        lines.append(f"- 余量: 本轮最多 {int(max_steps)} 步; 图片、视频生成计费, 出片前先说清数量与时长。")
    return "\n".join(lines)
四行:北京时间(带星期)、工作区、已连接的服务、步数余量,拼在系统提示的最后。连接器列表来自准备阶段(按本次会话的开关过滤过),步数来自平台配置。这一轮没连任何服务,就没有"已连接的服务"那一行;余量写的是"本轮最多 100 步"。
为什么每轮重新生成? 这几行都是会变的事实,变化的节奏是"轮":
-
时间。 运营对话常常隔几天再接着聊------"实验跑了 7 天,能看结果了吗",模型得知道今天是哪天。
-
连接器。 用户可能刚在插件市场装了一个服务,或在会话里关了某个开关;快照只报这一轮真能用的。
-
步数。 平台配置文件按修改时间热加载,改了下一轮就生效,一行提示词都不用动。
为什么不每步刷新? 引擎的注释说得很直接:
    _hrt = _prm.runtime_snapshot(workspace=_ws_desc, connectors=_conn_names, max_steps=int(ctx.max_steps), now=_now_line)
# 第 4 层: THINKING_RULES (没有 finish, 收口行自然不出现)。系统提示整轮不变 ------ 这段前缀最长最稳定, 供应商的 KV 缓存全靠它思考模式下每一步都要把整段上下文重发一遍,系统提示在最前面、最长,是前缀缓存的主体。快照里只要有一个字每步都变,整段缓存每步都失效。所以分工是:整轮不变的事实放快照,每步都变的余量放到工具结果末尾(3.4 节)。这一轮 70,836 个 token 里有 26,880 个命中缓存,这段整轮不变的前缀是前提。
还有一个取舍写在 runtime_snapshot 的注释里:快照原来还有"本轮理解""计划模式""要不要联网"三行,思考模式上线后删了------那是平台替模型下的判断,现在交给模型自己想,快照只留事实。
3.4 步数余量:模型怎么知道还剩几步,到顶怎么收尾
"一步"是一次模型调用 + 这次回复里的全部工具调用(第六篇 3.5)。运营专家这一轮是 4 步。上限由三个数决定:
# backend/agent/common.py
MAX_STEPS_HARD_CAP = 120
# backend/agent/run_setup.py
max_steps = max(1, min(int(_plat["max_steps"]), MAX_STEPS_HARD_CAP))
# backend/agent/engine.py
ctx.max_steps = max(ctx.max_steps, min(_MODEL_MODE_MIN_STEPS, MAX_STEPS_HARD_CAP))   # 每幕至少 40 步 (平台配置只抬不压)
平台配置给一个数,不超过 120,思考模式下至少 40。这一轮是 100。平台默认配置的注释说清了它的性质:"12 是上限不是配额, 简单任务照样两三步 finish"------上限是为了不把正经的调研任务掐断,不是让模型把步数用满。
模型从三个地方知道余量 :快照里的"本轮最多 100 步";共同规则里的一条"步数与时长有上限 (见运行时): 开工前想好几步做完; 信息够了就收, 不把步数用满......一步失败先看返回的原因再换路, 别原样重试";以及最关键的------每个工具结果末尾都被驱动器接上一句剩余步数:
        remain_note = f"\n\n(剩余可用步数 {max(0, ctx.max_steps - step)})" if ctx.max_steps else ""
        ...
            log.append("tool/result", call_id=call.id, tool=call.name, content=f"{result.obs[:cap]}{remain_note}")
按这段代码,这一轮第 1 步的技能正文和搜索结果末尾带着"(剩余可用步数 99)",第 2、3 步依次是 98、97。两个设计点:余量放在每步新增的工具结果里,不碰前面可缓存的前缀;而且是先截断观察、再接余量,观察再长,这一句也一定在。
调研次数的软提醒(阈值第十篇讲过)则正好相反,要放在观察开头 。注释记着原因:它在工具内部就拼进观察,之后还要过驱动器那一刀截断,"上线头一版接在末尾, 生产复测里整句被截掉, 模型一次都没看到"。同样是给模型递一句话,放在哪儿要看截断从哪头砍。
第 2 步那次 scipy 报错,正好演示了共同规则那句"先看返回的原因再换路":第 3 步模型改成手写 z 值,没有原样重跑。即便它想原样重跑,工具层也会拦下同一工具、同样参数的第二次调用,回一句"请换一个动作, 或直接作答"。
到顶怎么收尾。 步数和墙钟(默认 3600 秒)都在"步前"检查,到了就不进下一步。这时模型最后一步还在调工具、没有答案,引擎再补一次调用:
{"role": "user", "content": "现在不要再调用任何工具, 基于目前已掌握的信息直接给出这一幕的交付物正文 (自然语言)。"补答带着完整的会话;这一轮如果做过图片、视频这类成品,还会附上平台从账本里核对过的交付事实(真正生成了哪些文件、哪些没做成),写完再对一遍账------用户拿到的总是一份基于已有资料的正文,而不是一个卡住的"运行中"。
| 闸 | 碰到会怎样 |
|---|---|
| 步数上限 / 墙钟 | 不进下一步,补一次"不许用工具"的收尾 |
| 调研次数(软 / 硬) | 软:观察开头提醒一次;硬:不执行,让它用手上的资料写 |
| 同工具同参数 | 不执行,提示换一个动作 |
3.5 长对话的上下文压缩:先摘要,再截短
为什么要压。 驱动器每一步发给模型的消息,都从会话日志现场推导:系统提示 + 历史 + 这一轮的思考、工具调用和结果,只增不减。一个长网页单次就能读 6 万字;追问时,前几轮还要"投影成真消息"种进日志。运营对话恰恰会拉长------用户很可能带着分渠道 D1 回来接着问,再问实验结果怎么判读。
两道闸,同一个数。 门口那道管跨轮历史,预算 15 万字(_PARENT_MSG_BUDGET = 150_000),超了从最老的一轮整对丢起、每轮留一行摘要。按代码注释,这个数是翻了生产里 210 条有追问的会话定的:中位 3 轮 5,548 字,p90 也才 31,889 字,抬到 15 万后 209 条能整条带进来。屋里那道在每一步开始前检查:
#: 会话日志越过这个字数才压缩: 上下文窗口 200K 量级的模型留出余量, 150K 起压。
#: 调用方若在入口按字数截断跨轮历史, 两处**必须同值** ------ 入口放进 150K、屋里却在 90K 就压,
#: 等于种进来的历史当场被压掉一半。调用方从这里取值, 别各写一个默认值 (改一处就漂)。
DEFAULT_CHECKPOINT_CHARS = 150_000
怎么压:先摘要,不行再截短。
    async def _compact(self, system: str, step: int) -> None:
        """超阈值时先试摘要式压缩, 摘要拿不到/没缩就退回机械截短。"""
        ...
                    msgs = tmp.derive_messages(system) + [{"role": "user", "content": COMPACTION_INSTRUCTION}]
                    summary = await self.summarizer(msgs)
                    if log.compact_with_summary(summary):
                        ...
                        return
        ...
log.compact()摘要式压缩:最近 16 条消息原样留着,更早的前缀交给一个辅助模型,压成一份固定结构的检查点。切点不会落在一次工具调用和它的结果之间------原生 function calling 要求两者成对。压缩指令(节选):
    "## 用户的目标与演变\n- [最初与后来的要求; 原话重要的地方原样引用]\n\n"
    "## 已查到的事实、数据与来源\n- [保留原文数字、专名、日期、链接与引用编号]\n\n"
一共八节:目标与演变、已查到的事实、已交付的产出、出过的错、未完成的事、当前进展、下一步、关键约束与偏好。规则里要求"数字、函数签名原样保留"、"忠实记录用户的反馈与明确指令, 尤其是纠正"。拿运营专家来说,"每组 1,566 人、10.4 天"要原样进第二节,用户说的"我们还没有授权率数据"要进最后一节------压完照样知道基线和缺口。检查点用标签包住、替换掉前缀;再压时合并旧检查点,不原样照抄。
机械截短是兜底:摘要模型出错或没缩下来,就把较早的工具结果截到 1000 字,并留一句"(较早步骤的返回已截短, 关键信息在你当时的思考里)"------让模型知道这里缺了东西,而不是以为自己读全了。
| 部分 | 压缩后 |
|---|---|
| 系统提示(含运行时快照) | 不动 |
| 最近 16 条消息 | 原样 |
| 更早的消息 | 摘要成八节检查点;兜底时截到 1000 字 |
| 工具调用与结果 | 始终成对 |
| 轨迹(会话日志) | 完整保留,供回放 |
两种压缩最后都会把阈值抬到压后总量的 1.5 倍。注释的说法是"每个检查点只付一次缓存失效"------压一次就让前缀稳定下来,而不是每步压一点、每步缓存都失效。
这一轮 4 步、正文不到两万字,压缩没有触发。大多数对话都是这样,这套机制是给长尾的长对话准备的,平时零开销。
3.6 这一轮花了多少
| 项 | 数值 |
|---|---|
| 耗时 | 84 秒 |
| 模型调用 | 6 次 |
| 工具调用 | 4 次(调用技能、联网搜索、代码执行 ×2) |
| tokens | 70,836,其中 26,880 命中缓存 |
| 计费 | 约 7.5 积分 |
和第十篇法律专家(约 8.3 积分)、第三篇数据专家(约 10.5 积分)比,这一轮查得少、算得也少,大头是思考模式下每步重发的上下文------将近四成命中了前缀缓存。
四、你也可以:在 App 里一句话创建自己的专家
口袋专家AI正在筹备专家合伙人计划,支持用户贡献自己精调过的专家,产生收益后,用户将获得分成。让我们一起将口袋中的专家越做越好。
运营专家管的是互联网运营全栈。如果你只做某一类产品,可以建一位更专的:
-
打开「专家广场」,点顶部的「新建专家」卡片
-
用一句话描述,比如"专做微信小程序工具类产品的增长与留存:熟悉订阅消息授权、分享裂变和小程序入口规则,每条建议附实验设计和样本量估算"
-
服务端一次生成名字、人设提示词、能力标签、开场示例和头像
-
预览没问题就「开始对话」
"每条建议附实验设计和样本量估算"这半句值得写上------这是运营专家人设里最有用的一条。如果希望它每轮都按「A/B 实验设计与判读」的方法做,可以在插件市场里打开这份技能,在"给哪些专家用"里勾上你的专家,它就成了这位专家的看家技能(第九篇 3.4 节)。
五、总结
本篇以运营专家为例,拆了一位"诊断 + 实验型"智能体是怎么构建的:
• 应用上,它把通用助手"开方不诊断、建议没法验证、基准随口给"的毛病反过来:先把"留存问题"改判成"激活问题",六个原因各配验证方式,再按用户的真实流量算出"D1 当主指标至少 14 天、只能测出 +3.4pp 以上",据此把实验主指标挪到激活环节,每个实验都带开跑前写死的决策规则。
• 技术上 ,一轮对话里三样有限的东西各有一套管法。时间 :运行时快照每轮开跑时现生成,只放事实、没有的行不出现,整轮不变以保住前缀缓存。步数 :上限取平台配置;快照说总数,共同规则说纪律,每个工具结果末尾接一句剩余步数;到顶由步前检查拦下,补一次"不许用工具"的收尾。上下文:门口和屋里两道闸都是 15 万字,超了先压成八节检查点,失败再截短,最近 16 条和工具调用配对始终保留。