(一)注意力机制是什么
注:注意力机制的本质是选择与聚焦,即让网络针对自身当前任务有需要地调整对一些特征的关注度(或者说,增高或降低这些特征对自身的影响权重)。本文所提及的注意力机制仅基于Transformer模型的设计理念。
NLP 的发展过程中,一直在解决这个核心问题:如何构建一个能够理解语言序列性与上下文依赖性的计算模型。在很长一段时间里,循环神经网络(RNN)及其变体长短期记忆网络(LSTM)和门控循环单元(GRU)被认为是解决这一问题的标准答案。这些模型的设计思路受人类线性阅读习惯的影响非常大,它们按时间逐词处理输入,将前一个时刻的隐藏状态传递给当前时刻,试图在递归的过程中积累上下文信息。不过,这种处理方式其实恰恰成了限制大语言模型进一步发展的最大瓶颈。
序列递归处理带来了两个无法回避的问题:
- 计算的不可并行化。由于当前时刻 的计算严格依赖于之前时刻的输出,GPU 这种大规模并行处理的能力在面对 RNN 时显得无用武之地(并发会导致时序错乱问题)。在处理长序列时,这种串行依赖导致训练时间随着序列长度线性增长,极大地限制了模型规模的扩张和数据的吞吐量。
- 长距离依赖的丢失。尽管 LSTM 引入了门控机制来缓解梯度消失问题,但在处理长达数千甚至上万个 Token 的文本时,早期的信息在经过无数次非线性变换和矩阵乘法后,几乎不可避免地被稀释、扭曲甚至遗忘。当模型读到文章末尾时,往往已经无法准确回忆起开头的主语或关键实体,导致生成的文本在长程逻辑上出现断裂。
Transformer 架构的出现,标志着 NLP 领域从"序列递归"向"全局并行"的范式转移。其核心创新在于抛弃了递归结构,且在 Transformer 中,句子中的每一个词都可以同时 "看见" 句子中的所有其他词,无论它们在序列中的距离有多远(相比记忆机制,不再模糊化)------第一,Transformer并不是RNN结构,它不依赖时序,而是(全局视野下)记录位置信息(绝对或相对位置),这是因为各单词的字符顺序/特征并不一定要参考时序,还可以参考位置,且时序无关性使得并行性称为可能(下文可知,编码器可并行编码,解码器在Teacher-Forcing下可以并行解码);第二,"记录"是逐个归类于矩阵中的,而不仅仅是融合于一个元胞状态中、仅能逐序向前参考记忆,从而也解决了一定程度的长距离依赖(远文本稀释)、提升乱序文本理解能力。
注:根据下文Transformer执行流程可知,这种并行性主要还是体现在多头参数计算、编码器编码,至于解码如果是Teacher-Force就可以并行解码了!
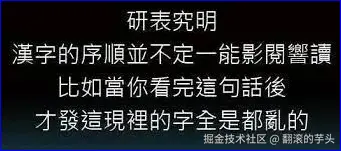
当然,上面只体现了"观察力",还没体现"注意力"。当我们观察一幅图像或阅读一段复杂文本时,我们的视线并非均匀地扫描每一个像素或每一个字母(如图,逐时序阅读并不能提取文本大意,反倒宏观来看能够摸清门道)。相反,我们会迅速将焦点集中在具有高信息量的区域,比如图像中的人脸、物体边缘,或者句子中的关键词汇,而将背景或其他无关信息模糊化处理。Transformer差不多也是这样,在处理每处编码时,都会去为其它编码加权,且是通过注意力机制去动态加权,让与自身密切相关的字词编码升权从而让其更加影响自己的推理与迭代(比如下图,直接关联住"发现"二字),这样无疑能主动提升语义关联度、而不是像RNN一样去被动关联(RNN中通常短记忆影响更加深刻,因为被稀释的程度不高,但下图说明了其实相邻单词不一定关联密切)
而且,由于Transformer的这一思想,稍微改造一下(比如Vision Transformer)甚至还能同时轻松解决静态图像处理任务的"内部长距离依赖问题(即单时刻处理过程中的感受野受限问题)"------之前讲过,虽然结构相似性先验可以极大简化图像特征的提取(基本上找个一般大的卷积核卷积一下就好了),但我们仍想尽可能扩大我们的感受野,去感知所有、使模型性能不断突破,于是Transformer带来了福音(观察力基于全局),并且还能对每个参数用注意力机制去筛选全局感受野中一些不重要信息(维护潜在的相似性,包括局部相似;但代价还是有的,就是不能仅凭一个小卷积核办大事了、舍弃一定的局部相似性归纳偏置,而是把2D数据展平为一维投入Transformer整体进行处理,并且参数更多了)。
注:根据VIT等模型可以知道,CV任务仅使用EncorderBlock作为TransformerBlock就行了,不需要自回归,因此并行性极高,基本上没有串序生成逻辑。
(二)Q、K、V 到底在表示什么?
《Attention Is All You Need》 中最令人费解也最精妙的设计,莫过于将输入投影为三个向量:Query (查询)、Key (键) 和 Value (值)。这三个概念可以借用于计算机中的 数据库检索系统 来理解;为了理解注意力机制,我们必须先剥离它数学表示,深入到它的语义内核层面,详细阐述 Q、K、V 到底是什么,以及它们如何在向量空间中完成信息的交互与融合的。
1.向量空间的语义角色定义
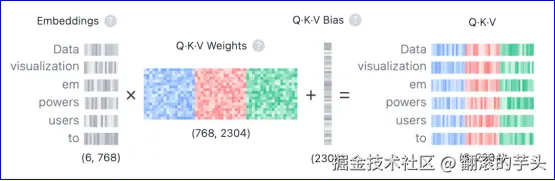
Self-Attention 层中,输入向量序列 (例如词嵌入加上位置编码)并不直接参与计算,而是首先通过三个独立的线性变换矩阵,映射到三个不同的子空间。这三个向量分别扮演了完全不同的角色,构成了注意力机制的完整逻辑闭环:
(1)Query (Q) :意图的发出者-"我在找什么?"
代表了当前 Token 的查询意图,它是一个主动的探针,携带着当前 Token 希望从上下文中获取什么信息的信号。
- 语义理解:在句子 "The cat sat on the mat" 中,当模型处理 "sat"这个词时,它的 Query 向量可能会在向量空间中发出一种信号:"我在找动作的主体(谁坐?)和地点(坐在哪?)"。如果这是一个语法分析任务,Query 可能会寻找名词短语;如果这是一个指代消解任务,Query 可能会寻找之前出现的实体。
- 数学视角: 是目标向量,它决定了注意力的方向,它是注意力函数的自变量之一,用于与环境中的 Key 进行匹配。
(2)Key (K) :特征的标识符-"我包含什么信息?"
代表了当前 Token 的特征索引。它是一个被动的标签,用于向外界展示该 Token 所蕴含的关键特征,以便与 Query 进行匹配。Key 并不直接提供内容,而是提供一种 可被检索的属性。
- 语义理解:对于 "cat" 这个词,其 Key 向量可能会编码 "我是名词"、"我是有生命物体"、"我是主语候选者" 等信息。当 "sat" 的 Query 扫描过来寻找动作主体时,"cat" 的 Key 能够与该 Query 产生高响应。注意,Key 的设计是为了响应 Query,而不是为了表达完整的词义。
- 数学视角: 是源向量的索引,它与 Query 进行点积运算,决定了被注意的权重 。
(3)Value (V) :内容的承载者-"由于我被关注,我将贡献什么?"
代表了当前 Token 的实际内容。当 Query 与 Key 匹配成功后,Value 是真正被提取并传输的信息。Value 往往包含了 Token 的语义表示,甚至可能经过转换以适应后续层的处理。
- 语义理解:如果 "cat" 被 "sat" 成功关注,那么 "cat" 的 Value 向量(包含了"猫"的语义概念)就会沿着注意力权重传输给 "sat",从而更新 "sat" 的表示,使其变为"猫坐",Value 可以看作是存储在记忆单元中的具体数据。
- 数学视角: 是加权求和的内容,它决定了注意力的输出结果,最终的上下文向量是所有 Value 向量的加权线性组合。
2.运作机制:从软寻址到信息融合
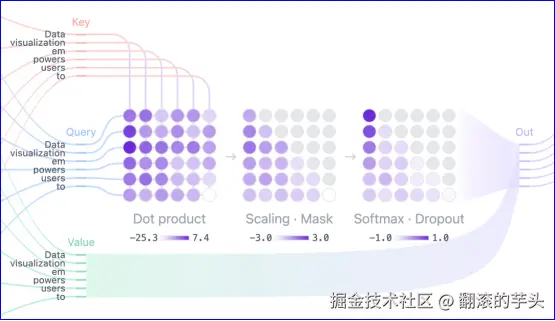
这三个组件的协作过程可以被看作是一个 软寻址 过程,它不同于哈希表的精确匹配(Key 必须完全相等),注意力机制执行的是基于相似度的模糊匹配,整个过程是完全可微的,因此可以通过反向传播进行训练。
整个过程可以细化为三个步骤:
(1)第一步:计算相关性
模型计算当前 Token 的 Query 与序列中所有 Token 的 Key 之间的相似度,最常用的度量方式是缩放点积(Scaled Dot-Product) 。
点积的几何意义:点积衡量了两个向量在方向上的对齐程度。如果Q和K指向相似的方向(或在高维空间中具有正相关的特征激活),点积值就大。这意味着Q所寻找的特征,正是K所具备的。
(2)第二步:生成注意力权重(Attention Weights)
通过 Softmax 函数将原始分数转化为概率分布。
表示 Token 对 Token 的关注程度,所有 的权重之和为 1,这一步是一个去噪和聚焦的过程,过滤掉不相关的 Key,高亮匹配度高的 Key。
(3)第三步:信息的加权聚合(Weighted Aggregation)
最后,利用计算出的权重对所有 Token 的 Value 进行加权求和,得到 Token 的最终输出。这一步实现了信息的流动与融合。Token 不再是孤立的词,而是吸收了整个句子中相关部分信息的聚合体,这种聚合操作是排列不变的,因此 Transformer 需要额外的位置编码来保留序列信息。
3.为什么 Q、K、V 必须分离?
一个常见的疑问是:为什么不能直接用某个输入向量,既当 Q 又当 K 还当 V(嫌逐步筛选太麻烦了呗)?如果这样的话,意味着一个词只能关注与它自身最相似的词(因为向量与自身的点积通常最大),这会限制模型的表达能力(例如 "it" 和 "robot" 并不相似,但在 "The robot fell because it..." 中,it 必须关注 robot)。分离设计赋予了 Transformer 强大的灵活性和泛化能力。
(三)从"单头"到"多头"
既然单个注意力机制能够捕捉词与词之间的关联,为什么我们还需要 "多头" 呢?
这就好比人类在思考问题时,需要从多个不同的角度切入,当我们理解一句话时,我们的大脑同时在处理多种关系:
- 语法关系(如主谓一致、动宾搭配)
- 语义关系(如指代消解、同义词关联)
- 位置关系(如相邻词的修饰)
- 情感色彩(如形容词对名词的修饰)
如果只有一个 Single-Head,模型只能提取出一种类型的相关性,所有这些复杂的关系被迫压缩到同一组权重中,必然导致信息的互相干扰和平均化。Multi-Head Attention 通过并行运行多组独立的注意力机制解决了这个问题。
多头机制带来了两个优势:
1.扩展了模型关注不同位置的能力
在单头情况下,注意力往往由当前位置最强的某种关系主导(例如,只关注到了紧邻的词)。多头机制允许模型在同一时间步,一部分头关注局部邻居,另一部分头关注长距离的特定词。
2.提供了多个"表示子空间"(Representation Subspaces)
每个头可以独立学习一种特定的语义或句法关系。
- Head 1 可能专门学习捕捉 "主语-谓语" 关系。
- Head 2 可能专门学习捕捉"指代词-先行词"关系(解决 it 指代谁的问题)。
- Head 3 可能专注于捕捉时间状语。
多头注意力将高维向量空间切分成了多个正交的子空间,使得模型能够在不同的子空间中并行地寻找特征,极大地增强了模型的表达能力和鲁棒性。
(四)注意力 的优劣 ?
Transformer 的架构设计初衷是为了解决序列处理的并行化问题,但这种高度冗余、多通道的机制在海量数据训练后,涌现出了令人惊讶的复杂行为。 我们不再仅仅关注它 "能否工作",而是深入到了机械可解释性(Mechanistic Interpretability)的层面。
1.发展 Induction Heads 归纳头
什么是归纳头?简而言之,它是一种能够执行 "前缀匹配与复制" 算法的注意力头(特殊注意力头)。它的工作逻辑可以描述为:"我在当前的上下文中寻找,以前我在哪里见过当前的这个 Token?如果我找到了,我就看看它后面当时跟着的是什么 Token,然后我把那个 Token 复制过来作为现在的预测。"
这听起来像是一个简单的 Ctrl+C, Ctrl+V 操作(比如你看到一段文本里反复出现 "苹果 → 红色",那么下次再看到 "苹果",模型就可能直接猜 "红色"),但在神经网络内部,它是通过 双头电路 来实现的:
第一步:记住 "谁在我前面" --> 回顾头(Previous-Token Head)
- 发生在模型较浅的某一层(比如第 N 层)。这个头的作用是:把前一个词的信息"悄悄塞进"当前词的表示里。
- 处理到序列中的词 B 时,回顾头会把前一个词 A 的信息(通过 Key/Value)注入到 B 的向量中。结果就是:B 的内部表示不仅代表自己,还"携带"了上下文线索。
第二步:找到 "上次 A 后面是什么" --> 归纳头(Induction Head)
- 发生在更深的一层(比如第 N+1 层)。当模型再次遇到 A,并要预测下一个词时,归纳头就开始工作:
- 它用当前的 A 作为 Query,去搜索整个上下文中有没有"和 A 配对过"的位置。由于第一步中,历史上 A 后面的那个词(比如 B)已经 "背上了 A 的照片"(即包含了 A 的特征),所以归纳头能通过特殊的注意力匹配(称为 Q-Composition 和 K-Composition)精准定位到那个 B。一旦找到,它就把 B 的内容(Value)提取出来,大幅提高 B 在预测结果中的概率
说白了,先"回顾"后"归纳"。将传统多头替换为归纳多头能进一步提升效能。
2.劣势
在浅层网络中,可以观察到大量的注意力头退化为类似卷积神经网络的行为,仅关注当前 Token 的前一个或后一个位置,这说明在处理低级语言特征(如词组搭配、分词)时,局部性依然是最有效的归纳偏置 。
随着层数加深,注意力模式变得越来越稀疏。Softmax 函数虽然理论上给所有 Token 分配非零概率,但实际上,许多深层头会将 99% 的权重集中在 1 到 2 个特定的 Token 上,而对其他 Token 视而不见。这说明多头注意力实际上演化成了一种 路由网络,也就是说每个头都是一个特定功能的专家,只有在遇到特定的触发条件(如特定句式、特定实体)时才会被激活并传输信息。
Transformer两两记录间的权重参考需要单独计算,不方便利用类似卷积操作的"归纳偏置"(不能靠一个卷积核打天下),所以参数较多,参数越多,拟合难度就越大、需要的数据量就越大。而且TransformerBlock(内部的基本网络单元)不是像RNN Cell那样循环利用的,各个Block参数如卷积层一样参数不共享,所以整体呈现的网络规模也是非常大的。
但说白了,如果是深层复杂网络、处理复杂问题、训练集丰富,Transformer一定是比较好的选择。
(五)从 MHA 到 MLA
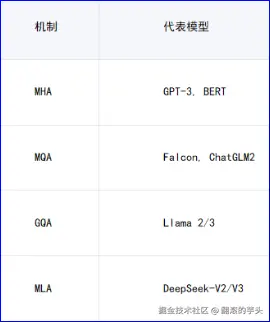
Transformer 的核心是注意力机制,但随着模型规模从 BERT 的 1.1 亿参数迈向 GPT-4 级别的万亿参数,以及上下文长度从 512 扩展到 128k 甚至 1M,标准的 多头注意力(Multi-Head Attention, MHA) 就暴露出了问题:推理时的显存占用与带宽瓶颈。
在 LLM 的自回归生成(推理)阶段,为了避免重复计算,会将之前所有 Token 的 Key 和 Value 向量缓存起来,这就是我们熟知的 KV Cache 。随着 Batch Size 和序列长度 的增加,KV Cache 会迅速吃掉数十 GB 甚至上百 GB 的显存,从而导致显存带宽饱和。GPU 不是在算得慢,而是在等数据搬运。
1.MHA(Multi-Head Attention)
MHA 是 Transformer 的原始形式,也是我们理解后续变体的基准。
- 机制:它赋予每个注意力头独立的矩阵,n个头,就有n组独立的 Q、K、V。
- 优点:表达能力最强,正如前面所分析的,每个头可以自由捕捉不同的句法或语义特征,互不干扰,形成了丰富的特征子空间。
- 瓶颈:KV Cache 极大,每个头都需要存储自己独立的 K 和 V。例如,对于一个 70B 参数的模型,如果使用 MHA,仅 KV Cache 就可能占据超过 100GB 的显存(取决于 Context Window),这极大地限制了最大 Batch Size,从而限制了推理吞吐量。
2.MQA(Multi-Query Attention)
为了解决 MHA 的显存问题,Noam Shazeer 等人在 2019 年提出了 MQA。
- 核心创新:既然 Query 是负责"提问"的,需要多样性来捕捉不同的关系;而 Key 和 Value 是被检索的"资料"------是不是可以共享?故,MQA 让所有的注意力头共享同一组Key 和 Value 矩阵(即K、V只有一组),但保留多组Q。
- 结构变化: n个 Query 头,对应 1 个 Key 头和 1 个 Value 头。
- 效果:KV Cache 的大小瞬间缩小了x倍(通常是 8 倍或 16 倍),极大地降低了显存占用,使得在相同硬件下可以支持更大的 Batch Size,推理速度提升显著。
- 代价:性能大幅退化,强行让所有头共享同一套 K 和 V,相当于强迫模型在所有语义子空间中使用完全相同的"资料库"。例如,一个头想查语法关系,另一个头想查语义关系,但它们只能查同一本 "字典",这严重削弱了模型捕捉复杂细节的能力,且训练往往不稳定。
3.GQA(Grouped-Query Attention)
鉴于 MQA 的性能损失太大,Llama 2 和 Llama 3 等主流开源模型采用了 GQA 作为折中方案。
- 核心创新:GQA 是 MHA 和 MQA 的插值。它不让所有头共享一组 KV,而是将 Query 头分成m个组,每组内的 Query 共享一对 K 和 V(哇,还有组相联)。
- 结构变化:n个 Query 头,对应m个 Key/Value 头。例如,64 个 Query 头,分成 8 组,每组 8 个 Query 共享 1 个 KV,总共有 8 对 KV。
- 效果:GQA 成功地在 MHA 的高质量和 MQA 的高速度之间找到了平衡点;它保留了足够的 KV 多样性以维持性能,同时显著减少了显存占用。
4.MLA(Multi-Head Latent Attention)
尽管 GQA 表现出色,但它仍然是一种 "丢弃信息" 的有损压缩(减少了 KV 的头数)。DeepSeek-V2 和 V3 引入的 MLA (Multi-Head Latent Attention) 则代表了另一种维度的创新:通过低秩投影(Low-Rank Projection)在保持多头能力的同时,实现比 MQA 更极致的压缩。
MLA 的核心创新点在于它不再通过减少"头数"来压缩,而是通过压缩"向量维度"并利用低秩恢复技术,实现了 性能优于 GQA,显存占用甚至少于 MQA 的奇迹。MLA 由两大核心技术构成:
(1)低秩键值联合压缩(Low-Rank Key-Value Joint Compression)
在标准 MHA 中,KV Cache 存储的是高维的K 和V 向量。MLA 认为,这些高维向量中存在大量冗余。因此,MLA 不直接存储K 和V ,而是将它们压缩进一个低维的 潜在向量(Latent Vector) 中。
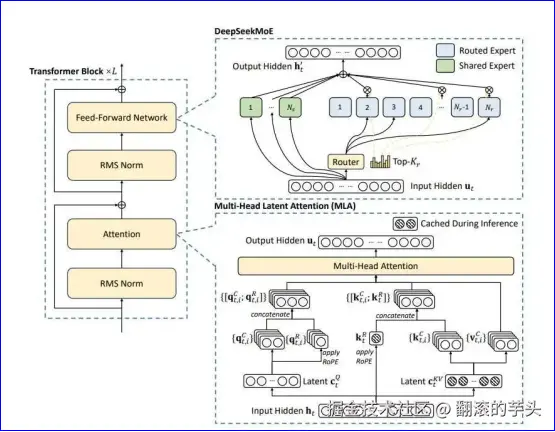
具体过程如下:
- 压缩(Down-Projection)------将输入隐藏状态 投影到一个低维的潜在空间
- 解压(Up-Projection)与矩阵吸收------理论上,计算注意力分数时,模型需要将低维的潜在空间投影回高维空间,生成每一个头所需的 Key 和 Value
MLA 的精妙之处在于矩阵吸收(Matrix Absorption),由于矩阵乘法具有结合律,我们在推理时不需要显式地恢复巨大的 多头 Q/K/V 矩阵。这种方法的精髓在于:用计算换显存。
(2)解耦旋转位置编码(Decoupled RoPE)
RoPE 的核心机制依赖于高维、完整且结构化的向量空间来维持相对位置信息,但是低秩压缩会破坏这种精细的几何结构,导致位置编码失效或严重退化,DeepSeek 的解决方案是 Decoupled RoPE(解耦 RoPE):将 Key 向量一分为二------内容、位置。
- 内容部分(Content Part):承载语义信息,不加 RoPE,参与低秩压缩,这部分进行完全的极致压缩。
- 位置部分(RoPE Part):承载位置信息,单独生成一个携带 RoPE 的小向量 ,这个向量很小(例如 64 维),且所有头共享。
最终的 Attention 计算中,Query 也被对应地拆分为 "内容 Query" 和 "位置 Query"。
- 内容 Query 与 压缩恢复后的 Key 进行交互(主要贡献语义分数)。
- 位置 Query 与 共享的 RoPE Key 进行交互(主要贡献位置分数)。
两者相加得到最终的 Attention Score。
(六)Transformer网络模型训练与推理
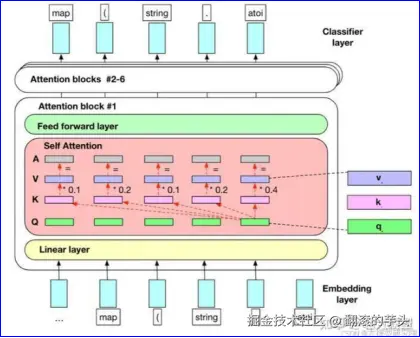
1.Transformer 整体结构
首先介绍 Transformer 的整体结构,下图是 Transformer 用于中英文翻译的整体结构:
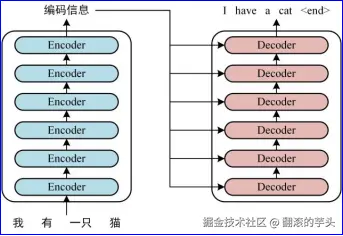
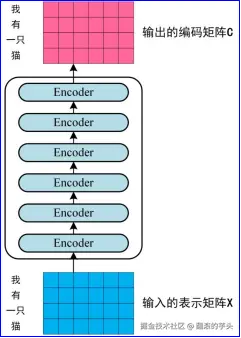
可以看到 Transformer 由 Encoder 和 Decoder 两个部分组成,Encoder 和 Decoder 都包含 6 个 block。Transformer 的工作流程大体如下:
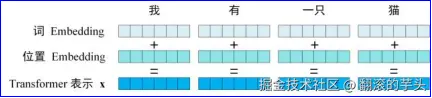
第一步:获取输入句子的每一个单词的表示向量 X,X由单词的 Embedding(Embedding就是从原始数据提取出来的Feature) 和单词位置的 Embedding 相加得到。
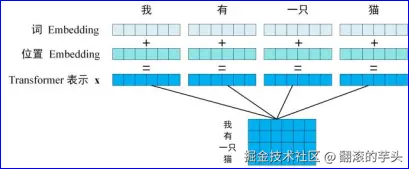
第二步:将得到的单词表示向量矩阵 (如上图所示,每一行是一个单词的表示 x) 传入 Encoder 中,经过 6 个 Encoder block 后可以得到句子所有单词的编码信息矩阵 C,如下图。单词向量矩阵用 表示, n 是句子中单词个数,d 是表示向量的维度 (论文中 d=512)。每一个 Encoder block 输出的矩阵维度与输入完全一致。
第三步:将 Encoder 输出的编码信息矩阵 C传递到 Decoder 中,Decoder 依次会根据当前翻译过的单词 1~ i 翻译下一个单词 i+1,如下图所示。在使用的过程中,翻译到单词 i+1 的时候需要通过 Mask (掩盖) 操作遮盖住 i+1 之后的单词。
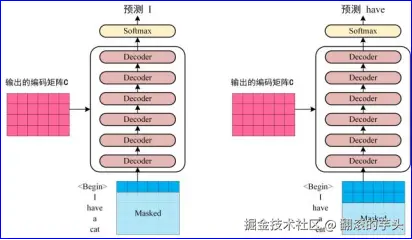
上图 Decoder 接收了 Encoder 的编码矩阵 C,然后首先输入一个翻译开始符 "",预测第一个单词 "I";然后输入翻译开始符 "" 和单词 "I",预测单词 "have",以此类推。如果是Teacher-forcing就是拿标签去逐个生成Masked注意力块(期间可以并行),如果是free-Running就是拿Decorder的最终预测去逐个生成Masked注意力块(并行不了)。这是 Transformer 使用时候的大致流程,接下来是里面各个部分的细节。
注:如果是free-runing mode是否就不需要masked了(反正在输出新的结果前后续的词嵌入都是空)?------大错特错。后续词嵌入为空,只是 "没有有效信息可参考",但模型的注意力机制依然会 "试图关注" 这些位置(错误生成注意权重并影响模型迭代);而 mask 的作用,是从机制上彻底禁止这种 "无效关注",确保生成的时序正确性。
2.Transformer 的输入
Transformer 中单词的输入表示 x由单词 Embedding 和位置 Embedding (Positional Encoding)相加得到。Embedding的计算基本上是并行的。
(1)单词 Embedding
单词的 Embedding 有很多种方式可以获取,例如可以采用 Word2Vec、Glove 等算法预训练得到,也可以在 Transformer 中训练得到。没错,这里的"单词Embedding"就是之前我们所着重介绍的"词嵌入"!
(2)位置 Embedding ( 位嵌入 )
Transformer 中除了单词的 Embedding,还需要使用位置 Embedding 表示单词出现在句子中的位置。因为 Transformer 不采用 RNN 的结构,而是使用全局信息,但我们仍需要利用单词的顺序信息,而这部分信息对于 NLP 来说非常重要。所以 Transformer 中使用位置 Embedding 保存单词在序列中的相对或绝对位置。
位置 Embedding 用 PE表示,PE 的维度与单词 Embedding 是一样的。PE 可以通过训练得到,也可以使用某种公式计算得到。 在 Transformer 中采用了后者,计算公式如下:
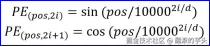
其中,pos 表示单词在句子中的位置,d 表示 PE的维度 (与词 Embedding 一样),2i 表示偶数的维度,2i+1 表示奇数维度 (即 2i≤d, 2i+1≤d)。使用这种公式计算 PE 有以下的好处:
- 使 PE 能够适应比训练集里面所有句子更长的句子,假设训练集里面最长的句子是有 20 个单词,突然来了一个长度为 21 的句子,则使用公式计算的方法可以计算出第 21 位的 Embedding。
- 可以让模型容易地计算出相对位置,对于固定长度的间距 k,PE(pos+k) 可以用 PE(pos) 计算得到。因为 Sin(A+B) = Sin(A)Cos(B) + Cos(A)Sin(B), Cos(A+B) = Cos(A)Cos(B) - Sin(A)Sin(B)。
将单词的词 Embedding 和位置 Embedding 相加,就可以得到单词的表示向量 x,x 就是 Transformer 的输入。
3.Self-Attention(自注意力机制)
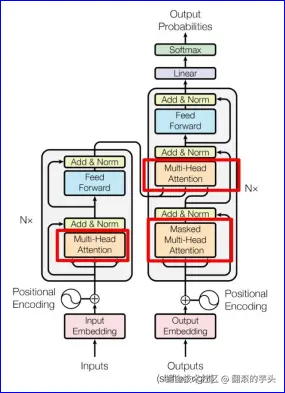
上图是论文中 Transformer 的内部结构图,左侧为 Encoder block,右侧为 Decoder block。红色圈中的部分为 Multi-Head Attention,是由多个 Self-Attention组成的,可以看到 Encoder block 包含一个 Multi-Head Attention,而 Decoder block 包含两个 Multi-Head Attention (其中有一个用到 Masked)。Multi-Head Attention 上方还包括一个 Add & Norm 层,Add 表示残差连接用于防止网络退化,Norm 用于对每一层的激活值进行归一化。
因为 Self-Attention是 Transformer 的重点,所以我们重点关注 Multi-Head Attention 以及 Self-Attention,首先详细了解一下 Self-Attention 的内部逻辑。
(1)Self-Attention 结构
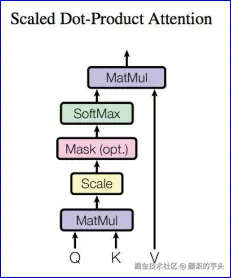
上图是 Self-Attention 的结构,在计算的时候需要用到矩阵Q(查询),K(键值),V(值)。在实际中,Self-Attention 接收的是输入(单词的表示向量x组成的矩阵X) 或者上一个 Encoder block 的输出。而Q,K,V正是通过 Self-Attention 的输入进行线性变换得到的。
(2)Q, K, V 的计算
Self-Attention 的输入用矩阵X进行表示,则可以使用线性变阵矩阵WQ,WK,WV计算得到Q,K,V。计算如下图所示,注意 X, Q, K, V 的每一行都表示一个单词。
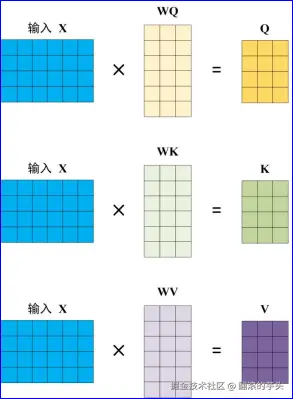
注:这也是为啥SelfAttention模块下有三根线------分别对应Q、K、V矩阵。
(3)Self-Attention 的输出
得到矩阵 Q, K, V之后就可以计算出 Self-Attention 的输出了,计算的公式如下:
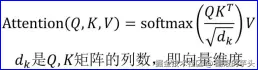
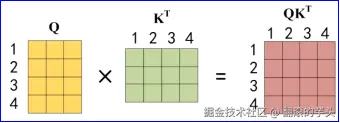
公式中计算矩阵Q和K每一行向量的内积,为了防止内积过大,因此除以dk的平方根。Q乘以K的转置后,得到的矩阵行列数都为 n,n 为句子单词数,这个矩阵可以表示单词之间的 attention 强度。下图为Q乘以 KT,1234 表示的是句子中的单词。
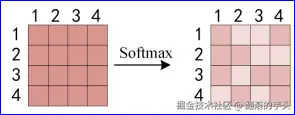
计算Q乘以K的转置,得到QKT之后,使用 Softmax 计算每一个单词对于其他单词的 attention 系数,公式中的 Softmax 是对矩阵的每一行进行 Softmax,即每一行的和都变为 1.
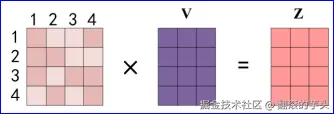
对矩阵的每一行进行 Softmax,得到 Softmax 矩阵之后可以和V相乘,得到最终的输出Z。
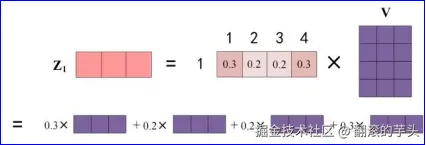
上图中 Softmax 矩阵的第 1 行表示单词 1 与其他所有单词的 attention 系数,最终单词 1 的输出Zi 等于所有单词 i 的值 根据 attention 系数的比例加在一起得到,如下图所示:
(4)Multi-Head Attention
在上一步,我们已经知道怎么通过 Self-Attention 计算得到输出矩阵 Z,而 Multi-Head Attention 是由多个 Self-Attention 组合形成的,下图是论文中 Multi-Head Attention 的结构图。
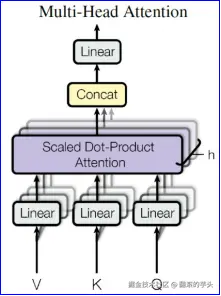
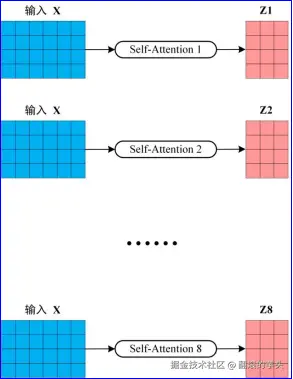
从上图可以看到 Multi-Head Attention 包含多个 Self-Attention 层,首先将输入X分别传递到 h 个不同的 Self-Attention 中,计算得到 h 个输出矩阵Z。下图是 h=8 时候的情况,此时会得到 8 个输出矩阵Z。
多个 Self-Attention计算完毕得到 8 个输出矩阵 到 之后,Multi-Head Attention 将它们拼接在一起 (Concat),然后传入一个Linear层,得到 Multi-Head Attention 最终的输出Z。
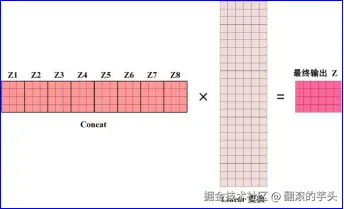
可以看到 Multi-Head Attention 输出的矩阵Z与其输入的矩阵X的维度是一样的。
4.Encoder 结构
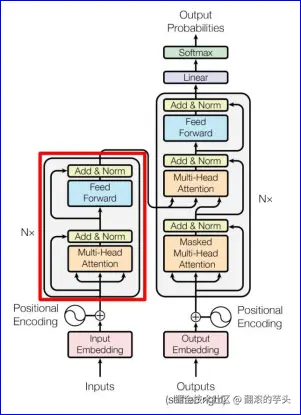
上图红色部分是 Transformer 的 Encoder block 结构,可以看到是由 Multi-Head Attention, Add & Norm, Feed Forward, Add & Norm 组成的。刚刚已经了解了 Multi-Head Attention 的计算过程,现在了解一下 Add & Norm 和 Feed Forward 部分。
(1)Add & Norm
Add & Norm 层由 Add 和 Norm 两部分组成,其计算公式如下:
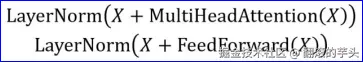
其中 X表示 Multi-Head Attention 或者 Feed Forward 的输入,MultiHeadAttention(X) 和 FeedForward(X) 表示输出 (输出与输入 X 维度是一样的,所以可以相加)。
Add指 X+MultiHeadAttention(X),是一种残差连接,通常用于解决多层网络训练的问题,可以让网络只关注当前差异的部分,在 ResNet 中经常用到:
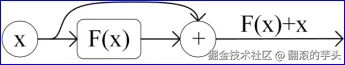
Norm指 Layer Normalization,通常用于 RNN 结构,Layer Normalization 会将每一层神经元的输入都转成均值方差都一样的,这样可以加快收敛。
(2)Feed Forward
Feed Forward 层比较简单,是一个两层的全连接层,第一层的激活函数为 Relu,第二层不使用激活函数,对应的公式如下。
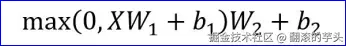
X是输入,Feed Forward 最终得到的输出矩阵的维度与X一致。
功能:对注意力层输出的特征进行逐位置的非线性变换,进一步提取特征。与自注意力的 "全局交互" 不同,前馈网络仅对单个 token 的特征进行独立变换,无序列间交互。
(3)组成 Encoder
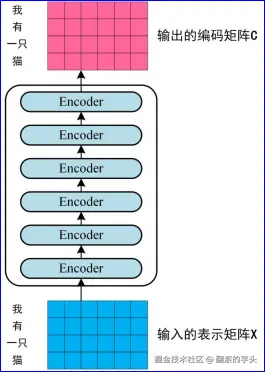
通过上面描述的 Multi-Head Attention, Feed Forward, Add & Norm 就可以构造出一个 Encoder block,Encoder block 接收输入矩阵 ,并输出一个矩阵 。通过多个 Encoder block 叠加就可以组成 Encoder。
第一个 Encoder block 的输入为句子单词的表示向量矩阵,后续 Encoder block 的输入是前一个 Encoder block 的输出,最后一个 Encoder block 输出的矩阵就是编码信息矩阵 C,这一矩阵后续会用到 Decoder 中。
5.Decoder 结构
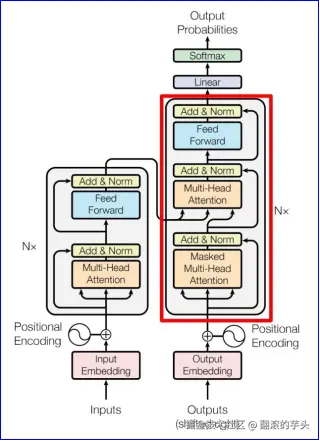
注:Outputs(shifted right)的输入取决于监督模式(上文有讲);Encorder的输出结果需要传递到所有串接的N个DecorderBlock的交叉注意力块中(图中只示例了一次传递)。****
上图红色部分为 Transformer 的 Decoder block 结构,与 Encoder block 相似,但是存在一些区别:
- 包含两个 Multi-Head Attention 层。
- 第一个 Multi-Head Attention 层采用了 Masked 操作。
- 第二个 Multi-Head Attention 层的K, V矩阵使用 Encoder 的编码信息矩阵C进行计算,而Q使用上一个 Decoder block 的输出计算。
- Decoder 最后一层的输出特征(维度dmodel) 会通过 Linear(线性层)映射到词汇表维度(V,如机器翻译中目标语言的单词数),得到未归一化的分数。最后有一个 Softmax 层计算下一个翻译单词的概率。
(1)第一个 Multi-Head Attention
Decoder block 的第一个 Multi-Head Attention 采用了 Masked 操作,因为在翻译的过程中是顺序翻译的,即翻译完第 i 个单词,才可以翻译第 i+1 个单词。通过 Masked 操作可以防止第 i 个单词知道 i+1 个单词之后的信息。下面以 "我有一只猫" 翻译成 "I have a cat" 为例,了解一下 Masked 操作。
下面的描述中使用了类似 Teacher Forcing 的概念。在 Decoder 的时候,是需要根据之前的翻译,求解当前最有可能的翻译,如下图所示。首先根据输入 "" 预测出第一个单词为 "I",然后根据输入 " I" 预测下一个单词 "have"。
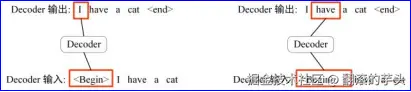
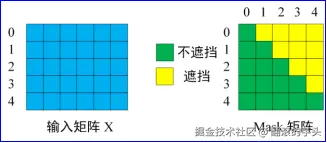
Decoder 可以在训练的过程中使用 Teacher Forcing 并且并行化训练,即将正确的单词序列 ( I have a cat) 和对应输出 (I have a cat ) 传递到 Decoder。那么在预测第 i 个输出时,就要将第 i+1 之后的单词掩盖住,注意 Mask 操作是在 Self-Attention 的 Softmax 之前使用的,下面用 0 1 2 3 4 5 分别表示 " I have a cat "。
注:Teacher Forcing 提供了并行输入的基础,我们可以把整个目标序列/标签的嵌入一次性输入 Decoder 的自注意力层,然后并行训练出全部预测结果并更新迭代参数(这得益于注意力机制是全局协同且非递归的,目标序列不用挨个输入然后执行);而FreeRunning不能,因为每次Decorder只会输出一个只有前i行的词嵌入矩阵(只包括前i个词的预测),完整的词嵌入矩阵只能不断输出然后最终得出并计算损失等。
第一步:是 Decoder 的输入矩阵和 Mask 矩阵,输入矩阵包含 " I have a cat" (0, 1, 2, 3, 4) 五个单词的表示向量,Mask 是一个 5×5 的矩阵(实际Mask方阵的行列数依照输入矩阵X的行数,即单词数决定)。在 Mask 可以发现单词 0 只能使用单词 0 的信息,而单词 1 可以使用单词 0, 1 的信息,即只能使用之前的信息。
第二步:接下来的操作和之前的 Self-Attention 一样,通过输入矩阵X计算得到Q,K,V矩阵。然后计算Q乘以K的转置。
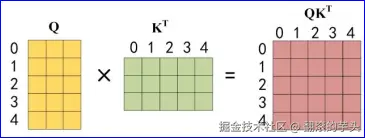
第三步:在得到 之后需要进行 Softmax,计算 attention score,我们在 Softmax 之前需要使用Mask矩阵遮挡住每一个单词之后的信息,遮挡操作如下:
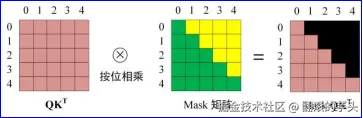
得到 Mask 之后在 Mask 上进行 Softmax,每一行的和都为 1。但是单词 0 在单词 1, 2, 3, 4 上的 attention score 都为 0。
第四步:使用 Mask 与矩阵 V相乘,得到输出 Z,则单词 1 的输出向量 是只包含单词 1 信息的。
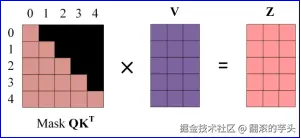
第五步:通过上述步骤就可以得到一个 Mask Self-Attention 的输出矩阵 ,然后和 Encoder 类似,通过 Multi-Head Attention 拼接多个输出 然后计算得到第一个 Multi-Head Attention 的输出Z,Z与输入X维度一样。
(2)第二个 Multi-Head Attention
Decoder block 第二个 Multi-Head Attention 变化不大, 主要的区别在于其中 Self-Attention 的 K, V矩阵不是使用 上一个 Decoder block 的输出计算的,而是使用 Encoder 的编码信息矩阵 C 计算的。Masked 自注意力先处理 "已生成的目标序列",得到仅包含目标内部依赖的表示。交叉注意力再将这个 "目标内部表示" 作为 Query,与编码器的 "源序列全局表示"(Key/Value)进行交互,实现源 - 目标信息对齐。
这个过程反复N次(重复对输出的未来特征进行Masked然后交叉全局注意力编码,确保Q计算的区域,最终输出)
根据 Encoder 的输出 C计算得到 K, V,根据上一个 Decoder block 的输出 Z 计算 Q (如果是第一个 Decoder block 则使用输入矩阵 X 进行计算) ,后续的计算方法与之前描述的一致。
这样做的好处是在 Decoder 的时候,每一位单词都可以利用到 Encoder 所有单词的信息 (这些信息无需 Mask)。
(3)Softmax 预测输出单词
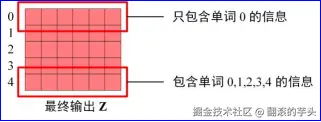
Decoder block 最后的部分是利用 Softmax 预测下一个单词,在之前的网络层我们可以得到一个最终的输出 Z,因为 Mask 的存在,使得单词 0 的输出 Z0 只包含单词 0 的信息,如下:
Softmax 根据输出矩阵的每一行预测下一个单词:
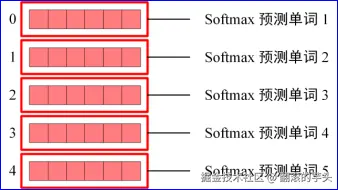
注:Free-Running Mode下只会依次完善Z矩阵(输出矩阵依次是1X5、2X5、...、5X5自回归)。
这就是 Decoder block 的定义,与 Encoder 一样,Decoder 是由多个 Decoder block 组合而成。
6.Transformer 总结
a. Transformer 与 RNN 不同,可以比较好地并行训练。
b. Transformer 本身是不能利用单词的顺序信息的,因此需要在输入中添加位置 Embedding,否则 Transformer 就是一个词袋模型了。
注:词袋模型的基本概念便是将每个文档视为无序词汇集,只考虑每个词语的出现频率,将出现频率作为文本的特征地图。
c. Transformer 的重点是 Self-Attention 结构,其中用到的 Q, K, V矩阵通过输出进行线性变换得到。
d. Transformer 中 Multi-Head Attention 中有多个 Self-Attention,可以捕获单词之间多种维度上的相关系数 attention score。