部分卷积
标准卷积有个前提:数据是完整的。每个位置都有值,窗口滑过去就能算。
现实里这个前提经常不成立,例如:图上有洞,人脸被遮住了,骨架缺了一段关节。这时候早期做法很朴素:在缺失处填 0,再老老实实做卷积。填 0 不算错,但存在一个问题:网络分不清这个 0 是"这里是黑的"还是"这里缺失了",卷积照样把它当有效输入算进去,出来的特征图上会留下一圈圈痕迹。后期得靠手工后处理去修。
部分卷积(Partial Convolution,PConv)就是来解决这个问题的。它是 2018 年 NVIDIA 在 ECCV 上的一篇论文《Image Inpainting for Irregular Holes Using Partial Convolutions》提出的。
核心想法一句话说完:与其编造假数据糊弄网络,不如显式告诉网络"这里是空的,别当真"。
一、这东西从哪来
在 PConv 之前,图像修复(inpainting)已经有几十年历史。传统路线是找相似纹理一块块贴上去,或者解一个泊松方程让边界颜色扩散进去,能用但慢,而且大洞基本填不好。
深度学习路线从 2016 年开始跑起来。
Pathak 等人的 Context Encoder(CVPR 2016)是转折点。它把修复当成"mask 掉一块 → 卷积编码 → 预测缺失块"来做,端到端训练,效果比传统方法好一大截。但它有个硬伤:网络输出中间那段总是发虚、发糊,边界还带一圈伪影,躲不掉。原因是损失函数只管像素值对不对,不管生成的内容像不像真实纹理。
Iizuka 等人的 GLCIC(2017)把全局卷积和局部卷积拼在一起,并用判别器做对抗训练,糊的问题缓解了,但这两条路线都还在跟后处理较劲,生成完要做泊松融合之类的修补才能用。
Liu 等人的 PConv(ECCV 2018)换了思路:不改损失、不加判别器,改卷积算子本身。让算子从一开始就只算有效像素,网络结构还是 U-Net,问题就消失了。这是一篇典型的算子型论文。整体架构没什么新东西,给出的是一个能搬到别的任务里复用的积木。事实也如此,后面两年一堆修复、分割、显著性检测的工作都搬了这个算子。
后面还会继续改进优化:Yu 等人的 Gated Conv(ICCV 2019,Free-Form Image Inpainting with Gated Convolution)把 PConv 的硬掩码换成了从特征里学出来的软门控。硬掩码有个前提假设:缺失位置是已知的。在图像修复里这成立(用户自己画的笔迹),在别的场景里就不一定了。
二、公式
输出尺寸公式和标准卷积完全一样:
out=⌊stridein+2×padding−kernel⌋+1
部分卷积只改了计算方式,没改尺寸。掩码不额外占位置,它和特征图是逐通道对齐的。
设窗口特征为 X,掩码为 M(1 有效,0 空洞),核权重为 W,偏置为 b,算子写作:
x′=⎩ ⎨ ⎧W⊤(X⊙M)⋅sum(M)sum(1)+b,0,若 sum(M)>0否则
掩码本身也要更新,规则简单:
m′={1,0,若 sum(M)>0否则
拆开看:
| 部分 | 运算 | 干什么 |
|---|---|---|
| X⊙M | 逐元素乘(点乘) | 空洞位置归零,屏蔽 |
| W⊤(⋅) | 矩阵乘(行×列求和) | 把核和窗口加权聚合成一个数 |
| ×sum(M)sum(1) | 幅值补偿 | 有效像素少时把量级补回来 |
| m′ 更新 | 判断 | 邻域里有有效像素,这个位置就算有效 |
这里有两个不同的乘法,特别容易混。 X⊙M 是点乘,形状不变,负责位置对位置地屏蔽; W⊤(⋅) 是矩阵乘,把 9 个位置塌缩成一个数,负责聚合。一个管筛,一个管收。
关于 sum(M) 的一个坑。 公式里 sum(M) 出现了两次,一次当分母、一次在缩放因子里,直觉上容易混。实际上 NVIDIA 官方代码 partialconv2d.py 里的实现是:用一个全 1 的卷积核去数出窗口里有效像素个数,然后
ratio=num_validnumel
也就是 sum(1)/sum(M)。 numel 是窗口元素总数, num_valid 是有效像素数。写代码时注意分母是个数 ,不是权重和。另外有些二手资料写成 ∑(w⊙m) 做分母,那是 Context Encoder 那类早期 masked conv 的写法,值会不一样,别混。
三、举例
假设有 3×3的输入特征矩阵,8 个有效像素加 1 个空洞。
输入窗口全填 10(方便口算),中心挖洞:
X= 10101010?10101010 ,M= 111101111
核用个对称的,方便手算:
W= 121212121
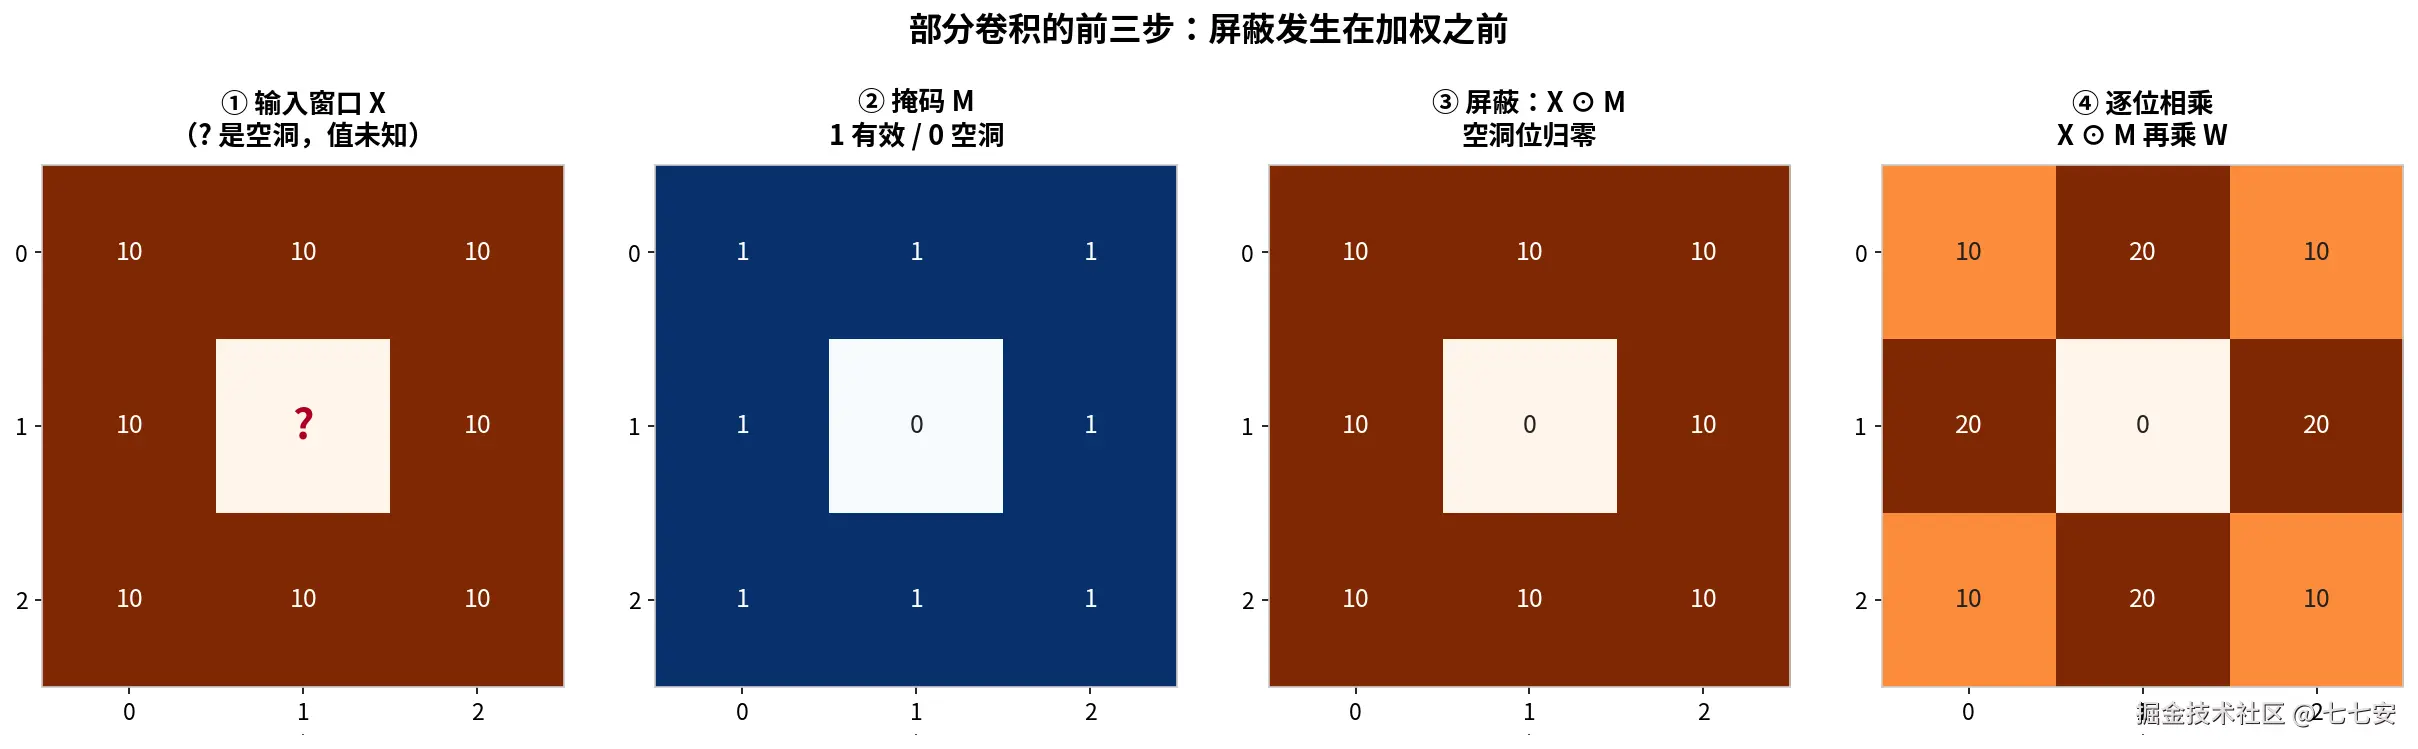
图 1:屏蔽发生在加权之前
第一步,屏蔽。 X⊙M 把空洞那一格打成 0:
X⊙M= 10101010010101010
第二步,聚合成一个数。 把这 9 个数和核里同一位置的 9 个数一一相乘再求和:
W⊤(X⊙M)=++= 10×1+10×2+10×1 10×2+0×1+10×2 10×1+10×2+10×1 120
中间那个 0×1 就是"屏蔽"落地的地方:空洞被置 0,乘上核中心权重 1 之后贡献 0,这个位置对结果完全没有影响。
第三步,算缩放因子。 sum(1)=9 是窗口元素总数, sum(M)=8 是有效像素个数:
ratio=89=1.125
第四步,合并。
x′=120×1.125=135
标准卷积是不做归一化的,分子是多少输出就是多少。所以同一个窗口,9 个像素全有效时算出 130,中心挖个洞之后算出 120,看着只差一点是吧?因为这个核的中心权重恰好是最小的 1,挖掉它损失不大。
换个位置就不一样了。看看空洞越来越严重的情况:
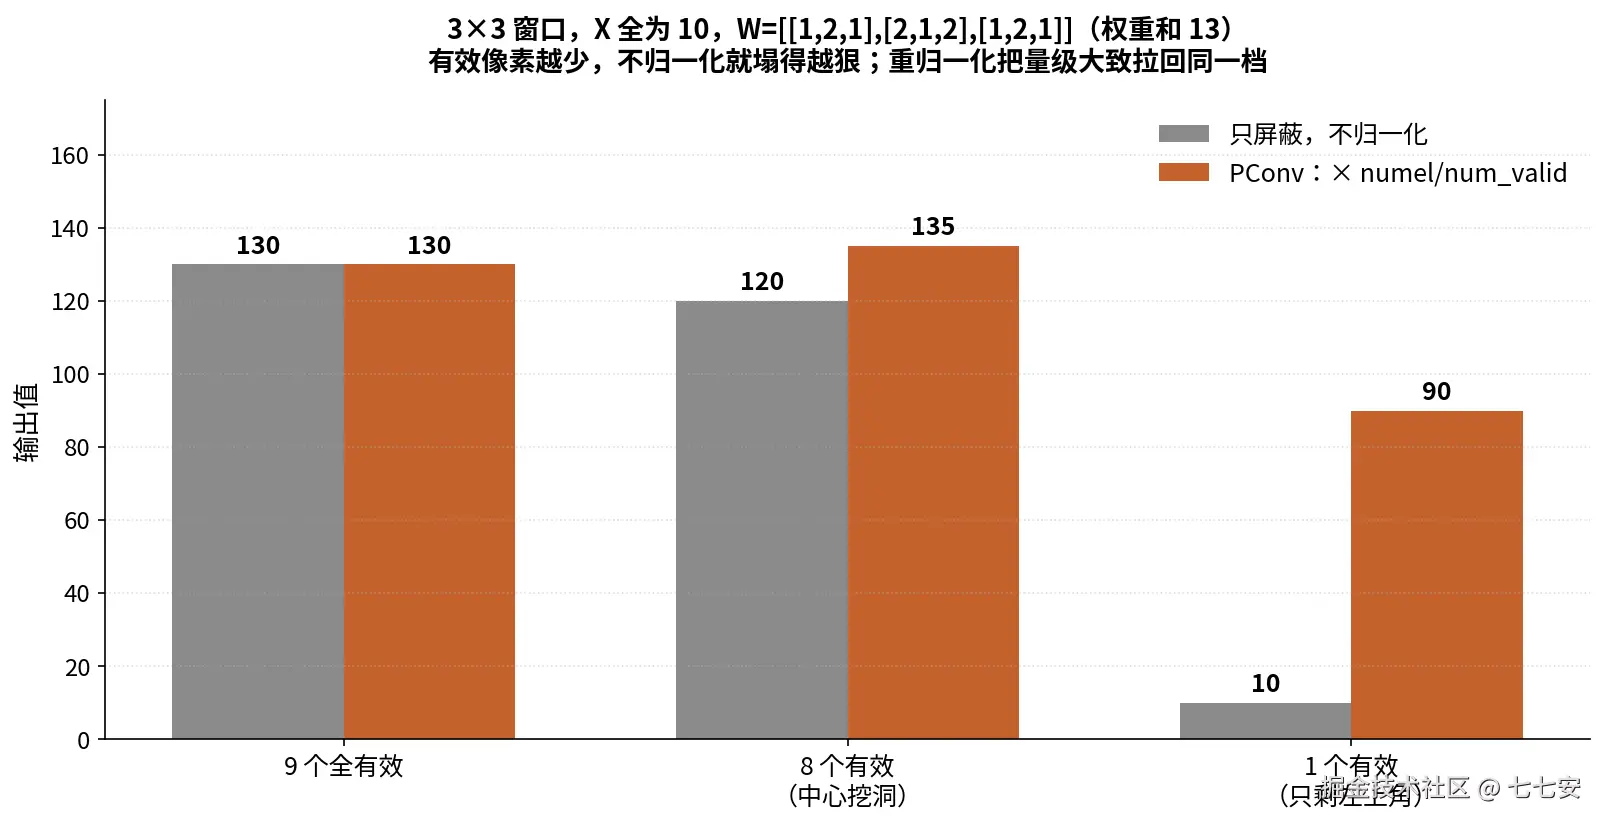
图 2:有效像素一少,不归一化就量级坍缩
窗口里只剩左上角一个有效像素时,只屏蔽不归一化的输出是 10,而全有效时是 130,塌了 13 倍。特征图上会浮现出一大片偏暗的区域,网络下游得费劲去适应这种忽大忽小的输入。幅值补偿把这一档拉回到 90,虽然没完全追平 130,但量级已经在一个数量级上了。
顺带能看出这个补偿只是粗略的,不是精确还原。它按个数等比放大,不知道每个位置的实际权重,所以补偿后跟理想值总有点残差。它要解决的是塌得离谱,不是分毫不差。
零填充的坑比这个更大。 前面说填 0 是谎言,因为网络分不清那个 0 是真值还是占位。更糟的是空洞位置在训练时被填的可能是 0、也可能是随机数、还可能是图像均值,同一个位置在训练和推理时填的东西不一样,梯度直接就乱了。
四、掩码会自己长大
PConv 最容易被忽略的一步是掩码更新。
规则就一句:一个位置的 3×3 邻域里只要有任意一个有效像素,它的新掩码就是 1。
也就是说,掩码每过一层向外扩一圈,空洞每过一层往里缩一圈。看这个例子:
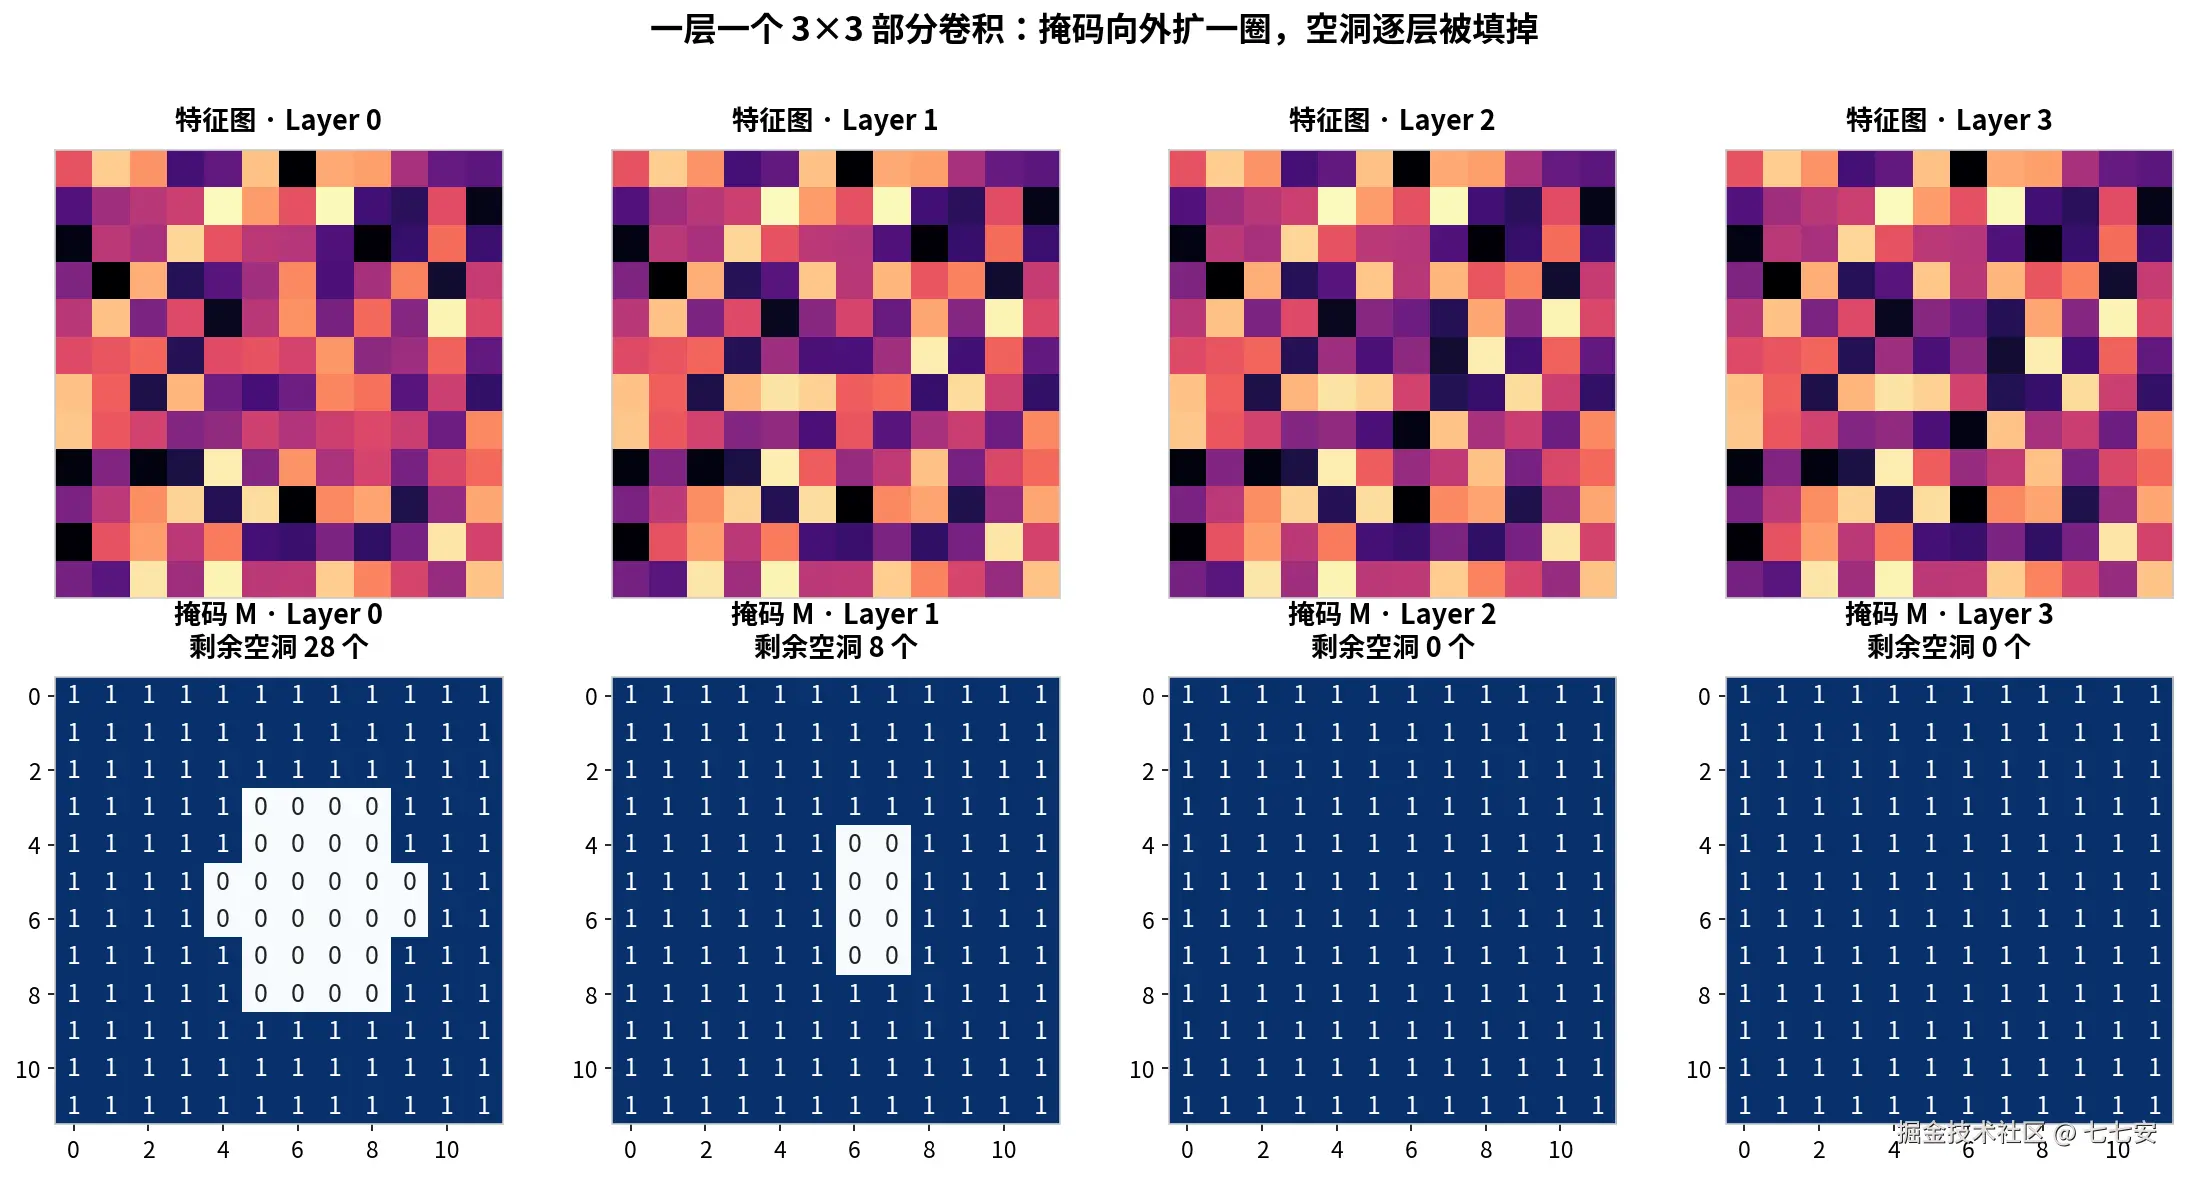
图 3:12×12 图上一个椭圆空洞,两层 3×3 部分卷积就填平了
Layer 0 有 28 个空洞,过一层剩 8 个,再过一层全满。这其实就是形态学里的膨胀操作(dilation),PConv 把它塞进了前向传播,每层自动做一次。
层数怎么估?膨胀量等于 ⌊K/2⌋,3×3 核一层扩 1 圈,5×5 核 2 圈,7×7 核 3 圈。半径为 r 的空洞大概需要 ⌈r/⌊K/2⌋⌉+1 层。
这里有个设计后果值得留意:网络深度必须够。 一个很大的洞需要足够多的层才能让掩码长满,否则中心区域的掩码永远是 0,那里的 m′ 恒为 0,输出恒为 0,网络在那一块什么都学不到。论文没正面讨论深度和洞大小的关系,这是个隐含约束。自己用的时候算一下。
五、和标准卷积放一起看
| 对比项 | 标准卷积 | 部分卷积 |
|---|---|---|
| 解决什么问题 | 特征提取 | 缺失 / 遮挡数据 |
| 核是否翻转 | 不翻转 | 不翻转 |
| 乘法类型 | 点乘 + 求和 | 点乘 + 幅值补偿 |
| 输出尺寸 | (in+2p−K)/s+1 | (in+2p−K)/s+1 |
| 幅值补偿 | 无 | × numel/num_valid |
| 额外输入 | 无 | 掩码 M |
| 典型伪影 | 无明显 | 无明显 |
| 数据要求 | 完整 | 可含缺失 |
尺寸上两者一模一样,差别全在数值怎么算。这也是它好上手的原因:拿标准卷积的实现改改,把空值处理和幅值补偿加进去就行,网络结构可以一行不动。
六、注意事项
分母是有效像素个数,不是权重和。 这个前面说了,官方代码用的是全 1 核数个数。写成 ∑(w⊙m) 是别的论文的写法,算出来数值不一样。
掩码不是特征。 掩码只在计算 sum(M) 和 m′ 更新时用,它不参与特征本身的卷积,也不该和特征一起送进第一个卷积层。网络内部有独立的一路 mask 通道在传,用 max pooling 更新,跟特征那条路是分开的。
掩码和特征必须逐层同步更新。 有人只算了 PConv 却忘了更新掩码,那空洞永远不会收窄,深层还是零。这也是复现 PConv 最常见的 bug。
硬掩码的前提是缺失已知。 论文假设空洞是用户画的笔迹(确实已知)。如果你处理的是"部分遮挡""低置信度预测"这类不硬的不确定性,硬掩码就不太合适了,得换软门控或者做掩码的软化。
sum(M) = 0 的分支别忘了写。 整个窗口全是空洞的时候 W⊤(X⊙M) 为 0,除法会出 0/0。公式里第一行的条件就是管这个,输出直接给 0, m′ 给 0。
参考文献
- Pathak, P., Donahue, J., Darrell, T., & Malik, J. (2016). Context Encoders: Feature Learning by Inpainting. CVPR 2016 . arxiv.org/abs/1604.07...
- Iizuka, S., Isogo, Y., & Matsuyama, C. (2017). Globally-local/globally-local convolutional neural networks for image inpainting. IPS 2017 . arxiv.org/abs/1707.02...
- Liu, G., Reda, F. A., Shih, K. J., Wang, T.-C., Tao, A., & Catanzaro, B. (2018). Image Inpainting for Irregular Holes Using Partial Convolutions. ECCV 2018 . arxiv.org/abs/1804.07...
- Liu, G., Reda, F. A., Shih, K. J., Wang, T.-C., Tao, A., & Catanzaro, B. (2018). NVIDIA Partial Convolutions implementation. github.com/NVIDIA/part...
- Yu, J., Lin, Z., Jin, J., Cai, S., & Yan, G. (2019). Free-Form Image Inpainting with Gated Convolution. ICCV 2019 . arxiv.org/abs/1903.07...