摘要
工业互联网、能源采集、智能制造场景持续产生高频设备指标时序数据,数据规模可达千亿行级别,具备持续写入、时间局部性强、采样周期固定、历史数据归档量大的特征。传统关系型数据库在海量时序场景下面临存储膨胀、批量导入缓慢、时间范围查询性能衰减等痛点。本文从列式存储压缩引擎、批量高速写入机制、时序超表数据组织模型三个维度,阐述面向千亿时序数据集的底层优化方案,并附带SQL示例,验证在大规模测点场景下的存储压缩、写入与查询性能收益。
1 时序场景痛点分析
工业监测场景下,海量时序数据具备典型特征:
- 测点基数大,单集群可达数百万观测点,按固定周期采集指标;
- 数据时间有序,相邻采样点数值波动小,存在强相关性;
- 业务存在存量历史数据迁移需求,TB级历史数据导入周期直接影响项目上线;
- 查询模式以时间范围+设备测点的曲线查询为主,极少跨行随机更新。
普通分区表模型仅依靠时间分区做简单隔离,无法利用时序数据内在相关性,存在冗余高、压缩差、时间范围扫描IO开销大等问题,难以承载千亿级长期时序数据。
2 存储压缩引擎:基于时序特征的多编码混合压缩
时序数据相邻时间戳、指标值存在高度相关性,存储引擎采用列式存储 + 多层编码组合的压缩方案,对时间列、数值列分别选用适配编码算法:
- 时间列:Delta-of-Delta差值编码。时序采集时间基本固定间隔,存储增量差值而非原始时间戳,大幅降低时间字段存储开销;
- 浮点指标列:Gorilla XOR压缩。利用相邻浮点数的高位比特重复特性,只存储变化比特,适配传感器浮点测量值;
- 维度标签列(设备ID、站点、测点类型):字典编码。对重复出现的维度字符串映射为整型ID,消除标签冗余;
- 底层存储:列式组织,同一字段连续存放,压缩时批量处理同类型数据,查询时支持只扫描需要的列,减少IO。
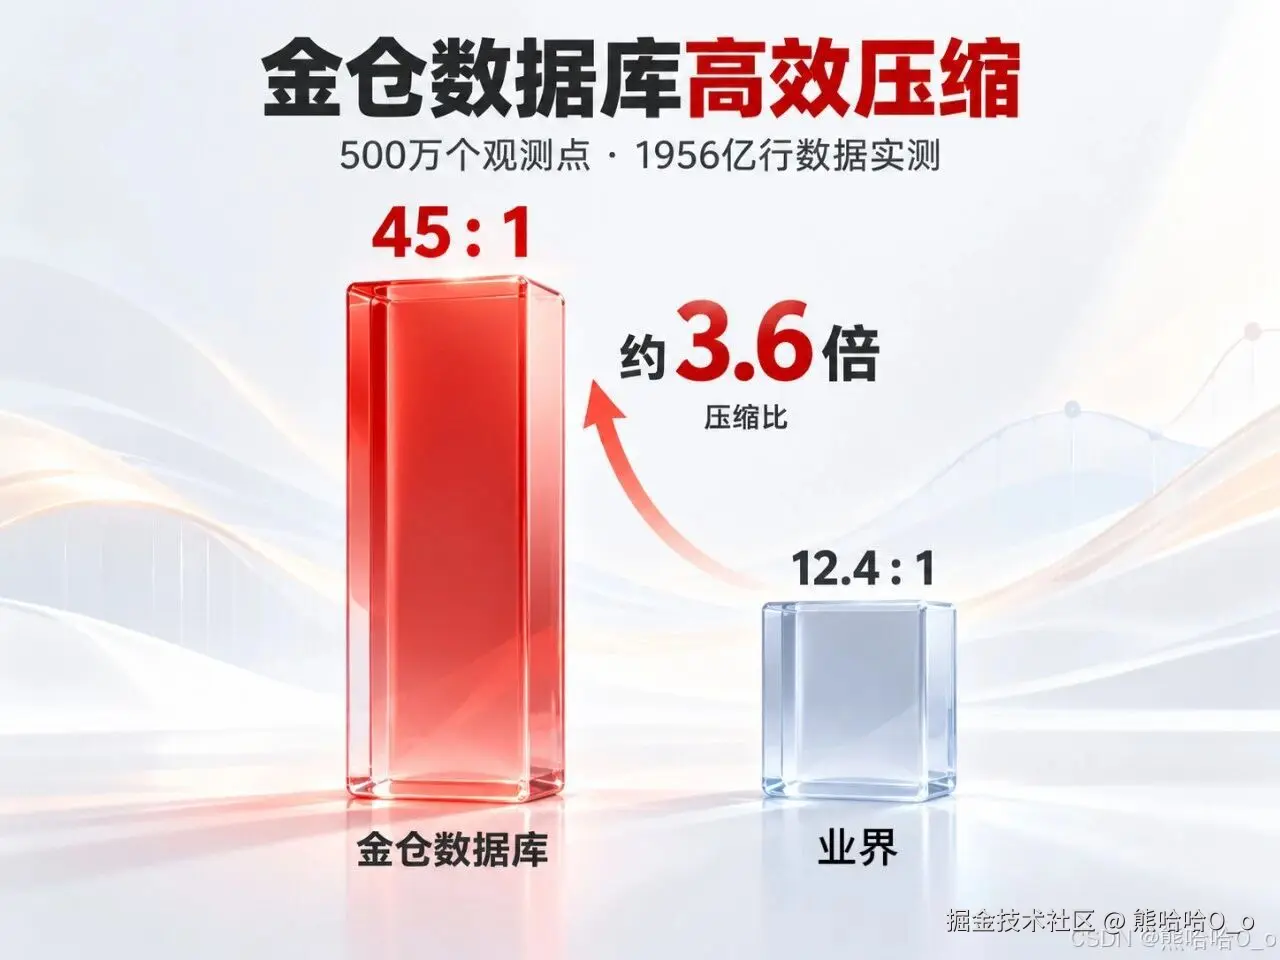
实测场景:500万观测点,全年1956亿行时序采集数据,整体压缩比可达45:1。相比通用压缩方案,存储容量显著下降,长期归档存储成本大幅降低。
时序超表建表示例
时序超表自动按时间分片管理数据,内部封装分区、分片、压缩策略,无需手动维护大量分区表:
sql
-- 创建时序超表,time为主时间列,tags为设备维度标签,val为采集指标
CREATE TABLE sensor_ts (
    time TIMESTAMPTZ NOT NULL,
    device_id BIGINT NOT NULL,
    metric_code TEXT NOT NULL,
    val DOUBLE PRECISION,
    status INT
) WITH (
    -- 开启时序列式压缩,自动启用Delta、Gorilla、字典编码
    enable_ts_compress = true,
    compress_segment_size = '128MB',
    time_chunk_interval = '1h' -- 数据按1小时粒度分片
)
-- 时序超表,按时间+设备测点做分片组织
TIMESERIES SUPER TABLE ON (time, device_id);

-- 插入单条实时测点数据
INSERT INTO sensor_ts(time, device_id, metric_code, val, status)
VALUES (now(), 100001, 'voltage', 220.3, 0);
3 高速写入:实时数据流与历史批量加载双路径
时序业务写入分为两类:实时持续流式写入 、存量历史数据批量导入。两套写入路径做差异化优化。
3.1 实时写入路径
实时测点数据按时间有序流入,写入层做:
- 内存写入缓冲区,按时间分片预聚合;
- 缓冲区满后,后台异步落盘,合并小文件,避免大量小文件拖垮查询;
- 分布式场景下,按
device_id做分片路由,同一测点数据落在同一节点,保证时间序列局部性。
3.2 历史数据批量加载(迁移场景)
针对多年历史存量数据迁移,提供独立批量导入接口,绕过单条事务开销:
- 批量数据按时间预先排序,对齐底层存储分片边界;
- 批量写入阶段直接生成压缩后的数据段文件,跳过重复编码开销;
- 分布式集群并行分片加载,多节点同时导入,横向扩展写入吞吐。
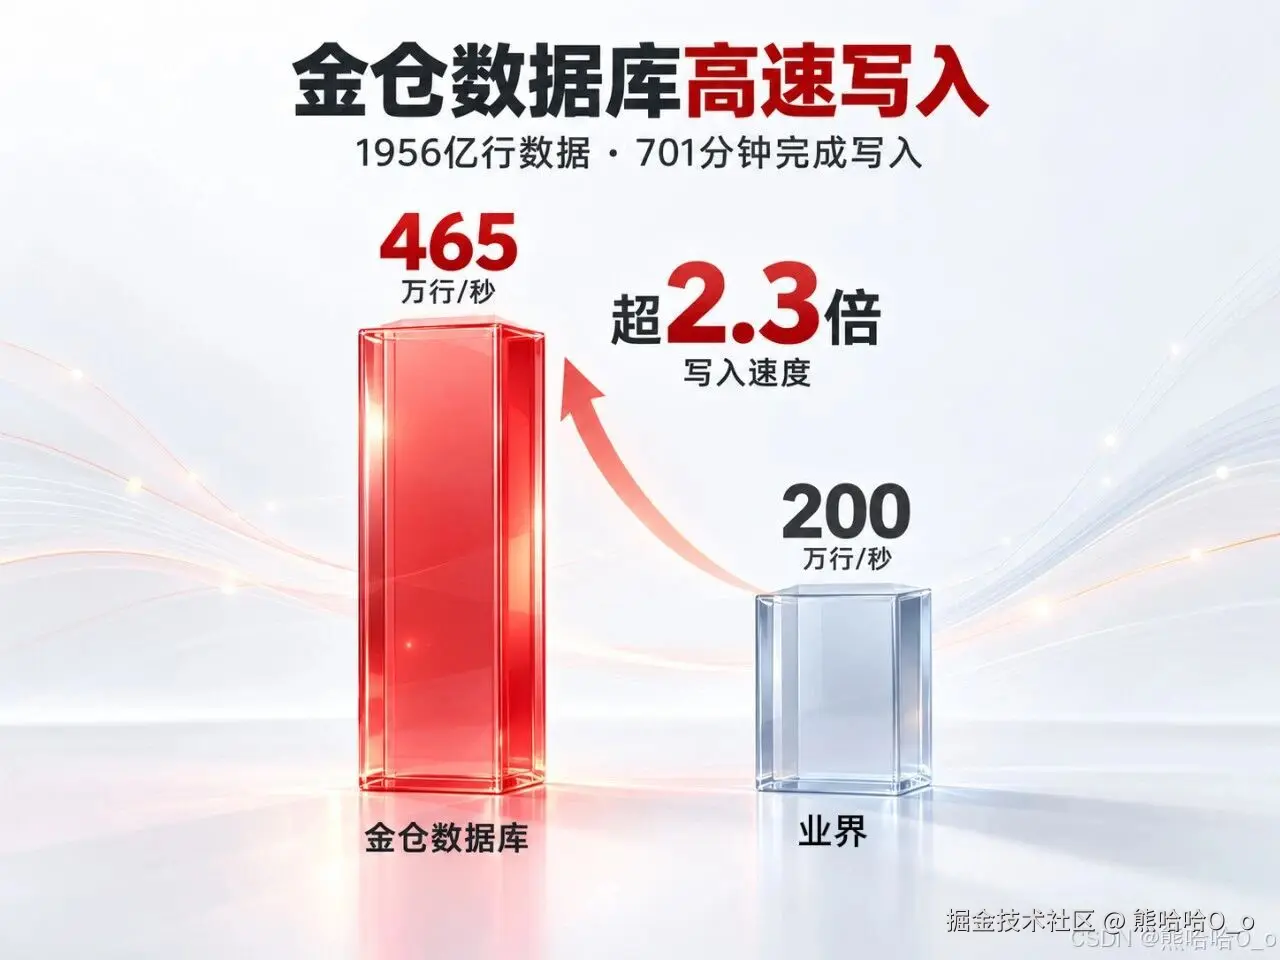
实测:分布式集群导入1956亿行历史时序数据,总耗时701分钟,平均吞吐465万行/秒。
批量COPY导入示例(历史数据迁移推荐)
sql
-- 从本地CSV文件批量导入历史时序数据(历史迁移高速路径)
COPY sensor_ts(time, device_id, metric_code, val, status)
FROM '/data/history_sensor_data.csv'
WITH (
    FORMAT csv,
    HEADER,
    DELIMITER ',',
    TS_BULK_LOAD = true -- 开启时序批量加载优化
);
4 时序超表:面向时序查询的数据组织优化
时序超表是时序场景核心数据组织模型,区别于手动维护的普通分区表:
- 自动管理时间分片,自动分片创建、过期归档、合并清理,无需DDL维护大量分区;
- 数据在分片内部按测点+时间有序排列;当执行设备曲线查询时,只扫描对应时间分片,减少无效数据读取;
- 标签维度字典与数据段绑定,过滤标签时可以先过滤元数据,再读取指标值,实现下推裁剪。
查询示例:设备曲线范围查询(工业最常用场景)
sql
-- 查询指定设备一段时间内电压曲线
SELECT time, val
FROM sensor_ts
WHERE device_id = 100001
  AND metric_code = 'voltage'
  AND time >= '2025-01-01 00:00:00'
  AND time <= '2025-01-02 00:00:00'
ORDER BY time;
性能对比(同等数据量、字段结构):
- 实时插入:时序超表404s,普通分区表549s;
- 时间范围曲线查询:时序超表253ms,普通分区表4834ms,查询性能提升19.1倍。
普通分区表需要人工维护分区生命周期,分片内数据无序,查询时需要扫描更多数据页,IO开销高;时序超表把时序语义内置于存储层,从底层适配时序读写模式。 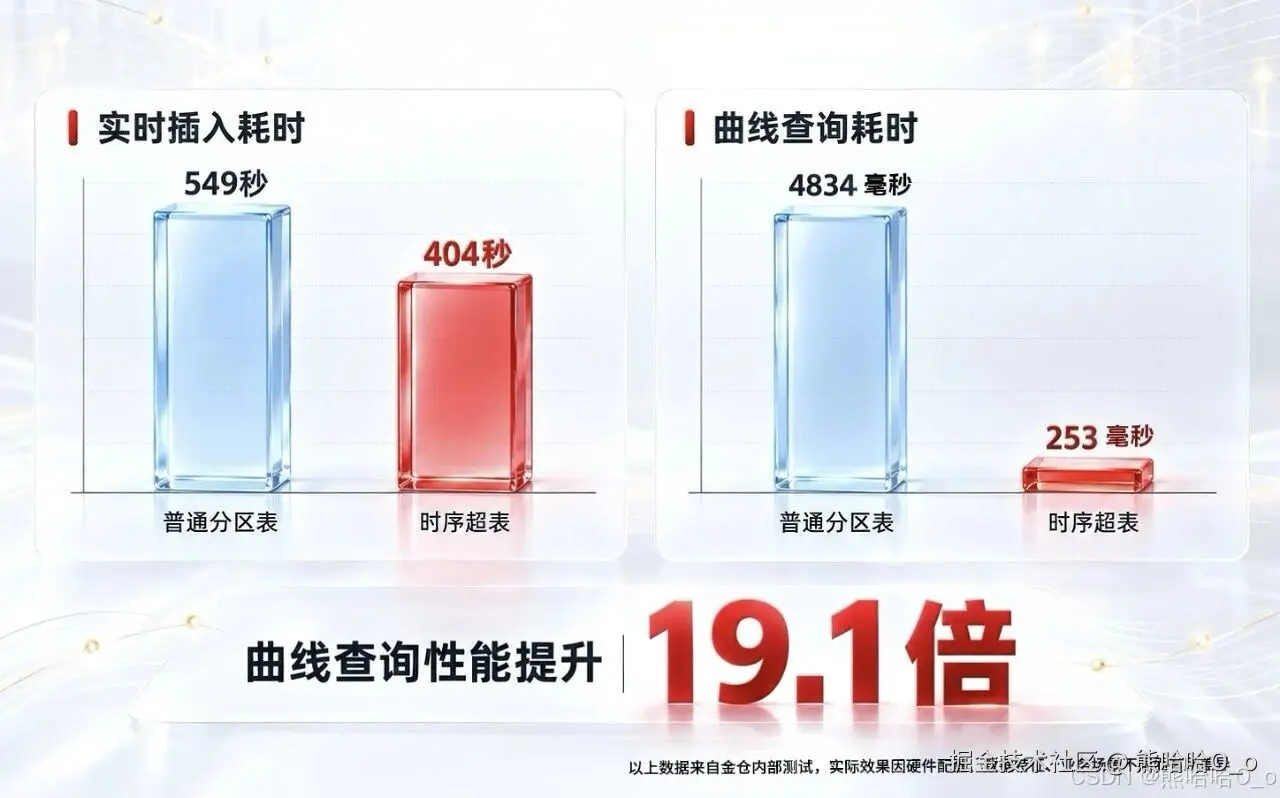
5 总结
千亿级时序数据的挑战,核心不在于单纯的数据库容量,而在于利用时序数据本身的时间局部性、数值相关性,在存储层、写入层、数据组织层做垂直优化。
- 混合编码列式压缩,针对时间戳、浮点数、标签分别压缩,大幅降低存储成本;
- 双写入路径区分实时流与历史批量迁移,分布式并行导入,支撑亿级、千亿级历史数据快速上线;
- 时序超表封装时序语义,自动分片与元数据裁剪,相比传统分区表,在实时写入和时间范围曲线查询上获得显著性能提升。
面向能源、工业物联网等海量测点场景,这套方案可以支撑长期海量时序数据存储、迁移与分析,作为设备运维、指标研判、智能决策的数据底座。