压缩一个大文件、然后把结果原地覆盖回去,这个动作看起来干净得像没发生过------文件路径没变,文件名没变,内容还变好了。但它偷偷改掉了一样东西:文件的创建时间。而我们的发布调度恰好用它当排序键,于是「一次无痕优化」变成了「这条素材被顺延十三个周期」。
这不是虚构的场景。下面按我实际踩坑的顺序,把「原子替换会破坏什么」拆成可复用的清单。
起因 压缩替换让补发顺序错位
流水线对单个视频体积有隐式上限:百家号的安全区大约 10MB 以内,头条上传也吃体积。有条 37.5MB 的素材(5040x2160、60fps、7:3 超宽)从第一次尝试起连续五个周期真失败,而且因为选片算法每周期都优先挑它,排在它后面的三十多条素材被一起饿死。
破案口径很简单------统计全台账 status=success 条目的文件体积分布:365 条成功记录里只有 4 条大于 10MB,恰好就是这一条视频发成功的四个平台;百家号自己的成功记录都在 2~5MB。根因确认后处置也很直接:
bash
ffmpeg -i 中国人能飞.mp4 -vf "scale=1920:-2,fps=30" \
  -c:v libx264 -crf 30 -preset medium -pix_fmt yuv420p \
  -c:a aac -b:a 96k -movflags +faststart out.mp4
# 37,542,947B -> 4,523,689B (4.31MB),耗时 22s
压完把 out.mp4 替换回原文件名,百家号一次通过。当时我以为这事结了。下一个周期选片日志告诉我没结:程序预言的「下轮仍会选中这条」没有发生,被选中的是队列里另一条。文件明明还在、体积也合适,为什么排到后面去了?
ctime 为原子替换背了锅
替换用的是 os.replace,这是「原子替换」的标准写法:同目录内写出临时文件,再 rename 覆盖目标,调用方永远看不到半截文件。
问题出在 NTFS 的 rename 语义上------改名保留 mtime,但创建时间采用源文件的创建时间。也就是说,替换之后这个文件的 ctime 变成了那个临时文件的诞生时刻:
text
原文件 ctime  2026-09-15 16:28:59
压缩临时文件  2026-09-18 03:30:57
替换后 ctime  2026-09-18 03:30:57   ← 排序键换人了
选片算法按「ctime 最早的先发」排队,这条素材一夜之间从第 1 位掉到第 14 位,补发被推迟约十三个周期。而台账键 {文件}#c{ctime}|{平台}|{分区} 里的 ctime 也跟着变了,等于这条素材在账上换了个名字。
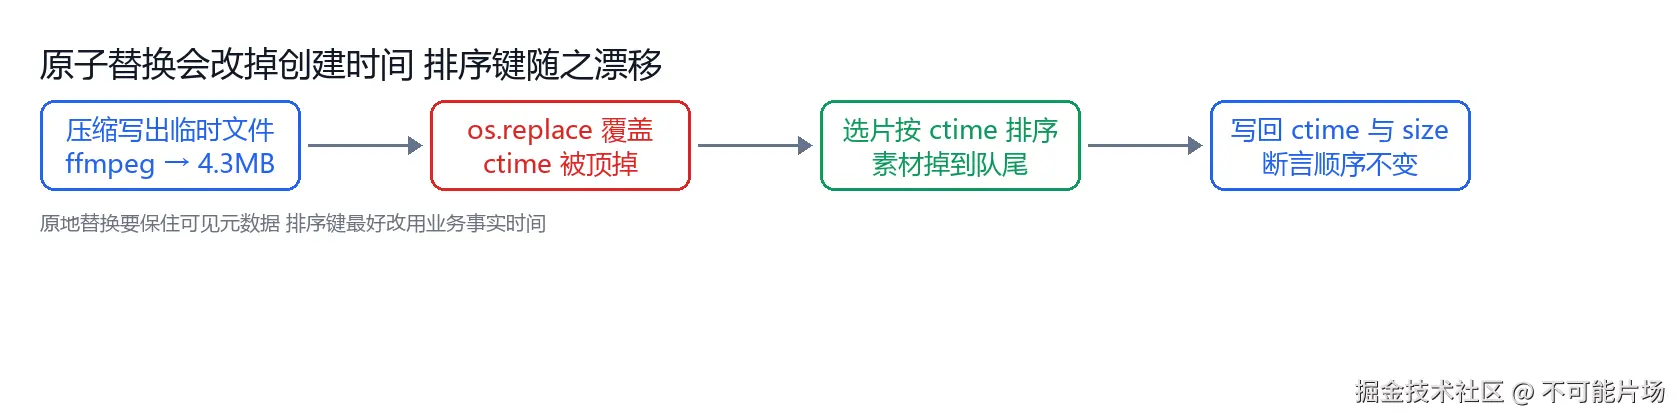
别拿 ctime 当业务排序键
这件事真正的教训不是「记得写回 ctime」,而是别把文件系统元数据当业务事实用。
第一,ctime 这个词本身就是一桩历史遗留的糊涂账。在 Unix 里 st_ctime 是 inode 变更时间(change time),不是创建时间;Windows 上 os.path.getctime() 拿到的才是真正的创建时间。同一段代码换个平台读到的语义就不同。以此做跨平台一致的排序,天然不成立。
第二,绝大多数语言的「设置时间」API 只覆盖 atime/mtime。Python 的 os.utime() 就只能改这两个,创建时间不在它的能力范围内------因为它不是「文件的属性」,而是文件系统记账的产物。想动它,得下沉到平台 API。
第三,排序键一旦被别人(转码器、同步工具、备份脚本)顺手改掉,你的业务顺序就漂了,而且不报错、不告警,只在日志里表现为「预测与结果不符」。这类故障的排查成本远高于写回时间的那几行代码。
三种修法 与各自的代价
摆在我面前的是三条路:
接受漂移。 按字面算法继续推进,该素材自然排队补发。无害,只是慢------如果队列不长,这其实是最省事的选项。
显式指定补发。 绕开字面选片,直接对这条素材跑一次单文件补发。适合「这条必须尽快上」的场景,一次性、不动全局逻辑。
写回创建时间。 治标但有效:替换前记下原 ctime,替换后用 Win32 SetFileTime 原样写回。
第三条路最容易被低估,因为它藏了一串细节。下面是可用版本:
python
import ctypes, time, os
from ctypes import wintypes

class FILETIME(ctypes.Structure):
    _fields_ = [('dwLowDateTime', wintypes.DWORD),
                ('dwHighDateTime', wintypes.DWORD)]

def to_ft(ts: float) -> FILETIME:
    # unix 秒 -> FILETIME(100ns 为单位的 1601 纪元计数)
    v = int(round((ts + 11644473600) * 10000000))
    return FILETIME(v & 0xFFFFFFFF, (v >> 32) & 0xFFFFFFFF)

k32 = ctypes.WinDLL('kernel32', use_last_error=True)
k32.CreateFileW.restype = ctypes.c_void_p   # 不声明会截断句柄,必踩
k32.SetFileTime.argtypes = [ctypes.c_void_p, ctypes.POINTER(FILETIME),
                            ctypes.POINTER(FILETIME), ctypes.POINTER(FILETIME)]

FILE_WRITE_ATTRIBUTES = 0x0100
OPEN_EXISTING = 3

def restore_ctime(path: str, ctime: float) -> None:
    h = k32.CreateFileW(path, FILE_WRITE_ATTRIBUTES, 0, None, OPEN_EXISTING, 0, None)
    if not h or h == ctypes.c_void_p(-1).value:
        raise OSError(f'CreateFileW failed: {ctypes.get_last_error()}')
    try:
        ct, at, mt = to_ft(ctime), to_ft(os.path.getatime(path)), to_ft(os.path.getmtime(path))
        if not k32.SetFileTime(h, ctypes.byref(ct), ctypes.byref(at), ctypes.byref(mt)):
            raise OSError(f'SetFileTime failed: {ctypes.get_last_error()}')
    finally:
        k32.CloseHandle(h)
两个坑必须记住。第一个是 wintypes.FILETIME(一个很大的整数)------很多人以为这样能直接构造,但 FILETIME 是两个 DWORD 组成的结构体 ,单个整数只会落到 dwLowDateTime,高 32 位丢掉,写进去是个非法值,之后 os.path.getctime() 会直接抛 OSError: [Errno 22] Invalid argument。必须显式拆高低位。第二个是 CreateFileW 的返回类型,不声明 restype = ctypes.c_void_p,句柄在 64 位下会被截断成 32 位,随后所有调用都失败得莫名其妙。
写完还要加一条断言,否则你只是把自己骗过去了:
python
tag = time.strftime('%Y%m%d%H%M%S', time.localtime(os.path.getctime(path)))
assert tag == original_ctag, f'ctime 写回失败: {tag} != {original_ctag}'
被替换破坏的第二样东西 派生字段
时间戳只是第一个受害者。台账里还存着文件大小,而「这个文件是否已经发过」的判定,长这样:
python
done[platform] = any(e['status'] == 'success' and e['fileSize'] == os.path.getsize(video)
                     for e in ledger_entries)
压缩之后 size 从 37542947 变成 4523689,派生字段不同步,这条件就全部为假------这条素材在下一周期被判成「全新文件」,missing 直接列出全部六个平台,等于把已经发过的六个平台重发一遍。
更麻烦的是档案逻辑的门槛:只有「全平台成功」时才会用新体积重刷台账,一旦有部分平台失败,就既不归档也不刷新。所以你不可能指望事后补救,只能在替换完、发布前先把已成功平台的体积预防性地改掉。
这条经验的适用范围很宽:任何由外部工具原地改写过的文件,它的派生字段(体积、哈希、时长、帧数)都必须立刻回写。否则你的「校验」就成了「误判」的另一个名字。
跨卷替换会直接抛异常
还有一个容易在测试环境漏掉、在生产环境炸掉的分支:os.replace 只在同一文件系统 内是原子 rename。临时目录和目标目录不同卷(比如临时文件写在 C: 盘、素材在 D: 盘),它会抛 OSError: [Errno 18] Invalid cross-device link(EXDEV)。
所以「压缩输出到系统临时目录,再替换回素材目录」这个看起来很自然的写法,是可移植性上的定时炸弹。稳妥做法是临时文件永远写在目标文件同目录 ,命名为 .tmp 后缀,替换完再收尾。如果确实必须跨卷,回退路径是 copy + unlink,但那条路不是原子的:中间崩了会留下半截目标文件,所以回退路径也必须先 copy 到目标同目录的临时文件、再 rename。
治本 让排序键来自业务事实
把上面几件事做完,故障是修好了,但设计上的毛病还在:我们把「顺序」这件事托付给了操作系统。
真正的修法是换掉排序键的来源。不要用文件系统元数据做业务排序,用只存在于你自己数据库里、由业务事件产生的时间。 比如素材首次入库的时刻、首次尝试发布的时刻、内容被创建的时刻------这些是你在写入时就记下的事实,任何外部工具改不动它。
替换键之后,压缩、转码、重命名都不再影响队列顺序,「写回 ctime」这种补丁也就不需要了------补丁越少,越不容易在下一个 NTFS 细节上再摔一跤。顺带说一句,这也解释了为什么不建议把 ctime 这种字段写进业务主键(我们台账键里就嵌了一个),它属于实现细节,不该承担业务语义。
收尾一份替换动作自查表
如果非要原地改写用户文件,按这个顺序走一遍,成本几分钟,能省掉上面所有的坑:
python
def replace_preserving(path: str, tmp_same_dir: str) -> dict:
    """原地替换,保持可见元数据,并返回需要同步的派生字段。"""
    before = {
        'ctime': os.path.getctime(path),
        'atime': os.path.getatime(path),
        'mtime': os.path.getmtime(path),
        'size':  os.path.getsize(path),
        'sha1':  sha1_of(path),          # 哈希慢,按需
    }
    os.replace(tmp_same_dir, path)       # 同目录、原子
    restore_ctime(path, before['ctime']) # Win32 写回创建时间
    os.utime(path, (before['atime'], before['mtime']))
    assert os.path.getctime(path) == before['ctime'], 'ctime 未写回'
return {'size': os.path.getsize(path), 'sha1_old': before['sha1']}清单本身只有六条:替换前记下 ctime / size / 哈希;临时文件写在同目录;用 rename 而不是 copy 做替换;替换后立刻写回创建时间并断言;同步所有派生字段;跑一次选片 dry-run,确认队列顺序没变。
最后一条最容易被跳过,但它才是真正的验收条件------因为前面所有细节出问题,最终都只会表现为「顺序不对」这一种症状。能在你不发一篇稿、不碰一次线上数据的情况下提前看到这个症状,成本低到没有理由不做。