各位 C++、Rust 语言爱好者们,大家好。
今天,我们从 4 行关键代码出发,看看 C++ 和 Rust 如何处理同一个引用失效问题,也给后续项目的语言选择提供一点参考。
首先,叠个甲,两种语言都很快。
除了速度,选择语言时还可以问问:
- 哪些安全问题需要你自己检查?
- 哪些可以交给编译器?
先看下面这段 C++ 程序,其中关键操作只有四行。它可以通过编译,但能编译,并不意味着后面的引用访问一定有效:
cpp
#include <iostream>
#include <vector>

int main() {
    std::vector<int> v = {1, 2, 3};
    int& first = v[0];            // 引用第一个元素,没有复制它
    v.push_back(4);               // 容量不足时会重新分配内存
    std::cout << first << "\n";  // 若发生重新分配,这里就是未定义行为
}
先分清"值"和"引用"。
int& first = v[0] 没有把数字 1 复制到一个新的整数里,而是让 first 引用 vector 中现有的那个元素。它依赖的是这个元素所在的存储位置。
vector 的元素连续存放在内存中。size() 表示已有多少个元素,capacity() 表示当前这块内存最多能容纳多少个元素。当 push_back 让元素数量超过容量时,vector 会分配新的存储空间,把元素迁移过去,再释放旧空间。
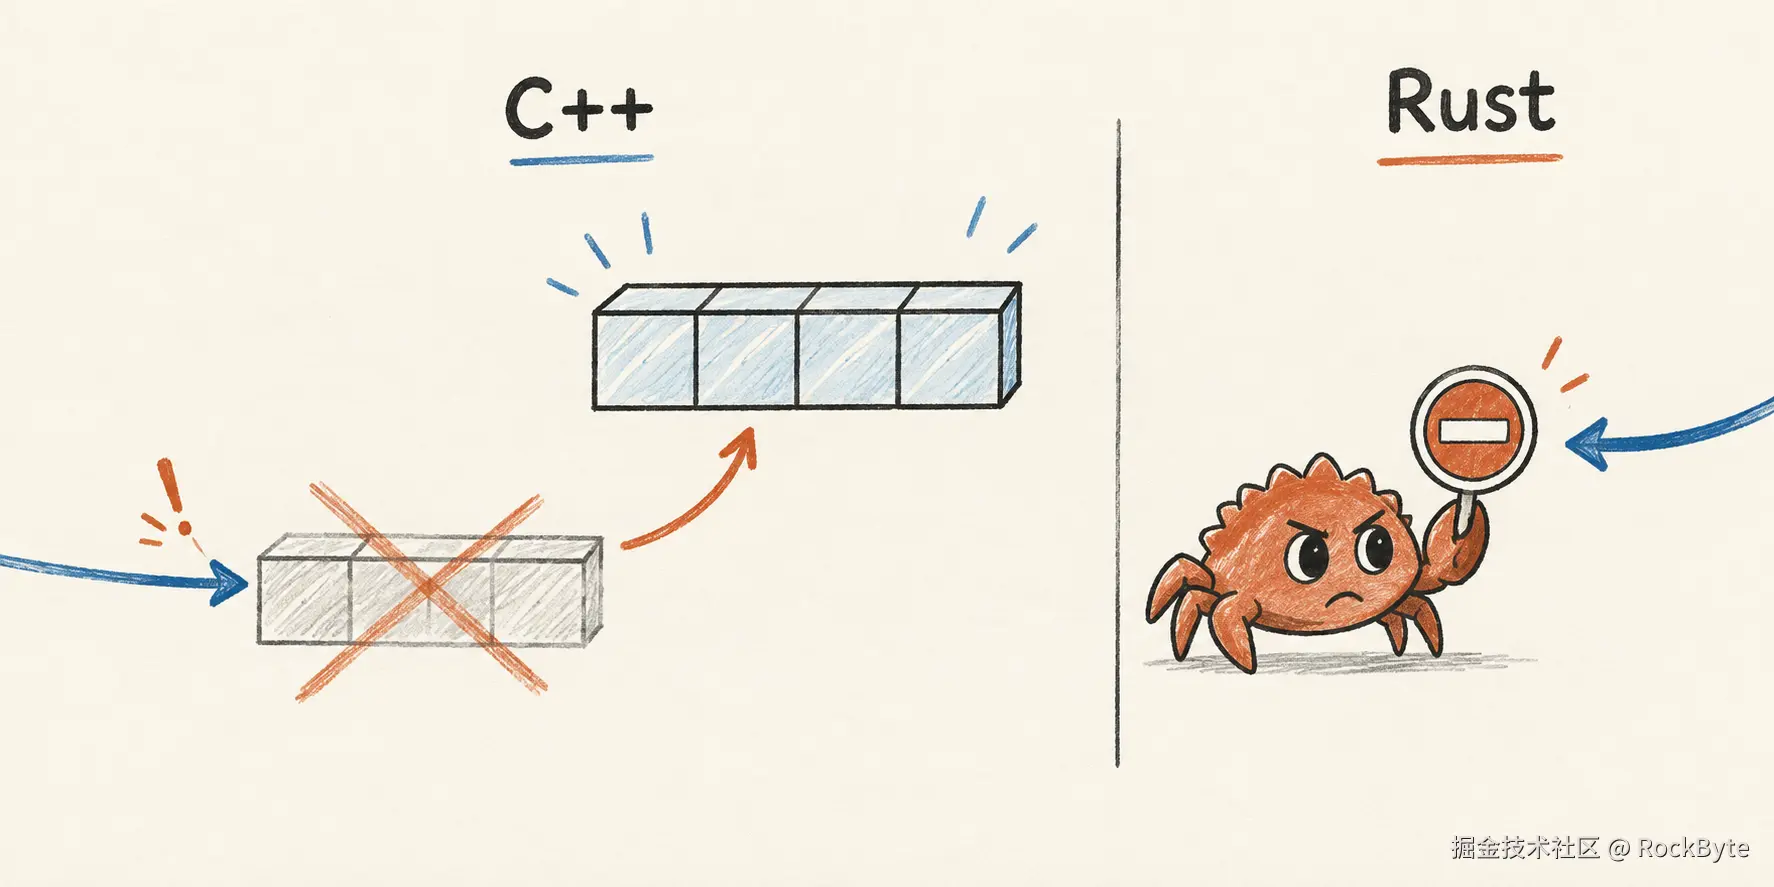
问题就出在这里:first 不会自动跟着元素搬家。它仍然引用旧位置,接下来再读取它,就成了释放后使用(use-after-free)。
未定义行为并不等于"一定崩溃",也可能打印出看似正确的数字,或者出现其他结果。
不过,有一个必须说清楚的条件:初始化为三个元素,并不意味着标准保证容量恰好是三。
只有这次追加触发了重新分配,first 才会失效;如果容量足够,追加不会使原有元素的引用失效。
要让这个错误示例确定地触发重新分配,可以先填满当前容量,再取得引用:
cpp
// 故意演示错误:请用 AddressSanitizer 观察,不要用于实际业务。
#include <iostream>
#include <vector>

int main() {
    std::vector<int> v = {1, 2, 3};
    v.resize(v.capacity());       // 让 size() == capacity()
    int& first = v[0];
    v.push_back(4);               // 成功追加时必然需要重新分配
    std::cout << first << "\n";  // 错误:读取已经失效的引用
}
如果只是想保留追加前的第一个数字,最简单的修正是保存值,而不是保存引用:
cpp
#include <iostream>
#include <vector>

int main() {
    std::vector<int> v = {1, 2, 3};
    int first = v[0];  // 复制整数,它不再依赖 vector 的存储位置
    v.push_back(4);
    std::cout << first << "\n";  // 输出 1
}
如果你想在追加后继续访问容器中的第一个元素,可以先调用 push_back,再通过 v[0] 取得引用。这样取得的是元素当前存储位置的引用。两种做法的含义不同:复制整数保存的是当时的值,重新取得引用则是在访问容器里当前的元素。
复制整数解决了这个例子的问题。但如果确实需要保留引用,谁来保证它在使用时仍然有效?再看看 Rust 怎么处理同样的操作:
rust
// 故意演示编译错误:E0502。
fn main() {
    let mut v = vec![1, 2, 3];
    let first = &v[0];
    v.push(4);
    println!("{}", first);
}
这段代码编译不过,会报 E0502 错误。
first 对第一个元素的共享借用,需要持续到最后的 println!;而中间的 push 又要通过 &mut self 可变借用整个 v,两个借用的有效期间发生了重叠,因此被编译器拒绝。即使提前留足容量,也不会改变这里的借用冲突。
对应前面的 C++ 修正,也可以直接复制整数:
rust
fn main() {
    let mut v = vec![1, 2, 3];
    let first = v[0];  // i32 实现了 Copy,这里得到一个独立的整数值
    v.push(4);
    println!("{}", first); // 输出 1
}
这个例子展示了两者在安全检查上的一个重要区别:C++ 需要开发者保证引用没有失效,Rust 则会在编译时拒绝这里的借用冲突。
先撇开速度
看到这里,你可能会问:Rust 多做了这些检查,会不会更慢?
前面这项借用检查是在编译时完成的,不需要在程序每次运行时再检查一遍,因此检查本身不会增加运行时开销。
至于整个程序的性能,还要看算法、数据布局、编译器设置和实际工作负载。两种语言都能编译成原生机器码,也都没有内置垃圾回收器;同一个紧凑循环,只要写法合理,生成的机器码往往很接近。但这不能推出两者在所有场景下性能都一样。
所以,看到"某种语言永远更快"这样的说法,先打个问号。如果性能对你很重要,就测自己的实际工作负载。
回到开头的引用问题,如果把两者的处理方式拟人化,可以这样理解:C++ 说"我相信你",Rust 说"证明给我看"。
那 Rust 编译器到底根据什么规则,拒绝了刚才的代码?
Rust 背后的规则
理解普通 Rust 引用时,可以先记住这条规则:
对于同一份数据,在相互重叠的借用期间,可以有多个共享引用 &T,或者一个独占可变引用 &mut T,但不能两者兼有。它们也常被通俗地称为"读引用"和"写引用"。
这里强调的是访问权限;拿到了 &mut T,即使还没有执行写入,也已经取得了独占借用。
前面的 first 需要跨过 push 继续使用,而 push 需要独占可变借用整个容器,正好违反了这条规则。"同时"指的是借用的有效期间重叠,不要求读写操作真的在同一时刻执行。这个例子只有一个线程,也一样会被拒绝。
借用也不一定持续到右大括号。对这里的局部引用,编译器可以在它最后一次使用后结束借用。因此,先使用引用,再追加元素,就是另一种正确写法:
rust
fn main() {
    let mut v = vec![1, 2, 3];
    let first = &v[0];
    println!("{}", first); // first 最后一次使用
    v.push(4);             // 共享借用已结束,可以取得可变借用
    println!("{:?}", v);   // 输出 [1, 2, 3, 4]
}
这就是为什么"先读再改"可以,"保留引用,修改后再读"却不行。
不过,并不是所有借用约束都必须由编译器静态判断。RefCell<T> 仍然遵守共享借用与独占可变借用不能冲突的规则,只是把检查放到了运行时。这也是内部可变性的一种实现:允许通过共享引用修改内部数据,同时用运行时检查来约束访问。
例如,RefCell<T> 的 borrow() 和 borrow_mut() 会在运行时检查借用状态。borrow() 取得共享借用,borrow_mut() 取得独占可变借用。如果前一次可变借用还没有释放,再调用 borrow_mut(),程序可以通过编译,却会在第二次借用时 panic:
rust
use std::cell::RefCell;

fn main() {
    let value = RefCell::new(0);
    let mut first = value.borrow_mut();
    *first += 1;

    // 故意演示运行时错误:first 仍持有独占可变借用。
    let _second = value.borrow_mut(); // panic:已经被可变借用
}
关键不在于调用了几次 borrow_mut(),而在于上一次返回的借用守卫是否已经释放。borrow_mut() 返回的是 RefMut<T> 守卫,守卫被丢弃时才会释放这次借用。只要 first 仍然持有守卫,再申请可变借用就会冲突。
这和前面的普通引用有所不同:仅仅后面不再使用 first,并不会让这个守卫提前释放。可以让它离开作用域,或者显式调用 drop(first):
rust
use std::cell::RefCell;

fn main() {
    let value = RefCell::new(0);

    let mut first = value.borrow_mut();
    *first += 1;
    drop(first); // 释放第一次借用

    let mut second = value.borrow_mut(); // 可以再次借用
    *second += 1;
    assert_eq!(*second, 2);
}
同样,持有共享借用时调用 borrow_mut(),或者持有可变借用时调用 borrow(),也会因冲突而 panic。如果希望自己处理借用失败,可以使用返回 Result 的 try_borrow()、try_borrow_mut()。
所以,编译期借用检查没有运行时开销,不代表 Rust 没有运行时检查。RefCell 的动态借用检查,以及数组、切片等索引访问可能保留的越界检查,就是两个例子。
移动:两种语言真正不同的地方
借用讨论的是如何临时访问一个值。接下来看看另一件事:如果把这个值交给另一个变量,会发生什么?
C++ 和 Rust 都有"移动"这个概念,但移动之后,源变量还能怎么用,两者的规则很不一样。
在 C++ 中,std::move 会把表达式转换成将亡值(xvalue),让后续操作有机会选中移动构造或移动赋值。这个转换本身不会搬运资源,真正的操作发生在后续构造或赋值中。是否转移资源、如何转移,取决于相应类型的实现和选中的操作;有时最终执行的甚至仍然是复制。
源对象依然存在,也允许继续使用,但"允许使用"不等于"还能把它当成原来的内容使用"。对标准库类型,默认约定是移动后有效,但状态未指定。你可以销毁它,或给它赋新值;调用其他操作时,仍要满足该操作的前置条件。自定义类型则要看它自己的约定。
在 Rust 中,对于不实现 Copy 的类型,赋值默认会移动所有权。移动后,旧变量不能再用于访问原来的值,否则就会编译报错:
rust
// 故意演示编译错误:E0382。
fn main() {
    let a = String::from("hello");
    let b = a;         // String 的所有权转移给 b
    println!("{}", a); // 错误:不能再使用已经移走的值
}这里的"所有权",可以理解为谁负责持有这个值,以及在不再需要它时完成清理。let b = a 之后,String 由 b 持有,a 不能再用来访问它。等 b 离开作用域,字符串持有的堆内存才会被释放;也可以调用 drop(b) 提前释放。
如果只是要接着使用这个字符串,就使用新的所有者 b:
rust
fn main() {
    let a = String::from("hello");
    let b = a;
    println!("{}", b); // 输出 hello
}
如果希望 a、b 各有一份独立的字符串,则应写 let b = a.clone()。对 String 来说,这会复制字符串内容,需要额外分配内存。前面的整数不需要这样做,因为 i32 实现了 Copy,赋值即可复制;String 没有实现 Copy,赋值会转移所有权。
这套机制避免了安全 Rust 中的重复释放问题。C++ 也有 RAII 和智能指针来自动管理资源;如果直接编写拥有资源的类,则需要处理好析构、复制、移动之间的关系,也就是常说的"五法则"。优先把资源交给已有的资源管理类型,往往可以遵循"零法则",不用自己实现这些特殊成员函数。
线程:问题开始危险起来
前面都在一个线程里讨论引用和所有权。到了多个线程,还要保证它们不会无同步地访问同一份可变数据。
假设两个 C++ 线程没有使用原子操作或其他同步措施,却并发递增同一个普通整数。你可能觉得,顶多就是结果少算了几次。实际上,这构成了数据竞争,属于未定义行为。编译器可以假定程序不存在数据竞争,并据此优化代码,所以程序的行为可能完全超出预期。
安全 Rust 会阻止这里存在数据竞争的共享访问。
要在线程间共享并修改数据,可以用 Mutex 保护它,或者对简单计数使用原子类型。Send 表示一个类型的值可以安全地转移到另一个线程,Sync 表示它的共享引用可以安全地在线程间共享。它们是类型的能力约束,不会自动给操作加锁。
Rust 的互斥锁会把数据本身包在里面:
rust
use std::sync::{Arc, Mutex};
use std::thread;

fn main() {
    let counter = Arc::new(Mutex::new(0));
    let mut handles = vec![];

    for _ in 0..4 {
        let counter = Arc::clone(&counter);
        handles.push(thread::spawn(move || {
            let mut n = counter.lock().unwrap();
            *n += 1;
        }));
    }

    for h in handles {
        h.join().unwrap();
    }

    let result = *counter.lock().unwrap();
    assert_eq!(result, 4);
    println!("{}", result); // 输出 4
}
沿着代码的执行顺序看,几个类型和操作各有分工:
Arc::new(Mutex::new(0))创建一个由互斥锁保护的计数器,再用Arc提供线程安全的共享所有权。- 每次循环调用
Arc::clone,增加引用计数,让新的局部变量counter指向同一个计数器。它没有复制里面的整数,也不会自动保护整数的读写。 move闭包取得本次克隆得到的Arc的所有权,因此工作线程不需要借用循环里的局部变量。外层的counter仍然保留,可以在后面读取结果。- 工作线程调用
lock(),成功后取得锁守卫MutexGuard,再通过*n递增整数。闭包结束时,守卫被丢弃,锁随之释放,其他线程才有机会取得锁。 - 主线程逐个调用
join(),等待所有工作线程结束,再取得锁读取最终结果。
这里每个线程只加一次,所以最终结果应为 4,示例用断言检查了这一点。unwrap() 则简化了演示中的错误处理:锁中毒或工作线程 panic 时,主线程也会 panic。实际项目应根据业务要求决定如何处理这些失败。
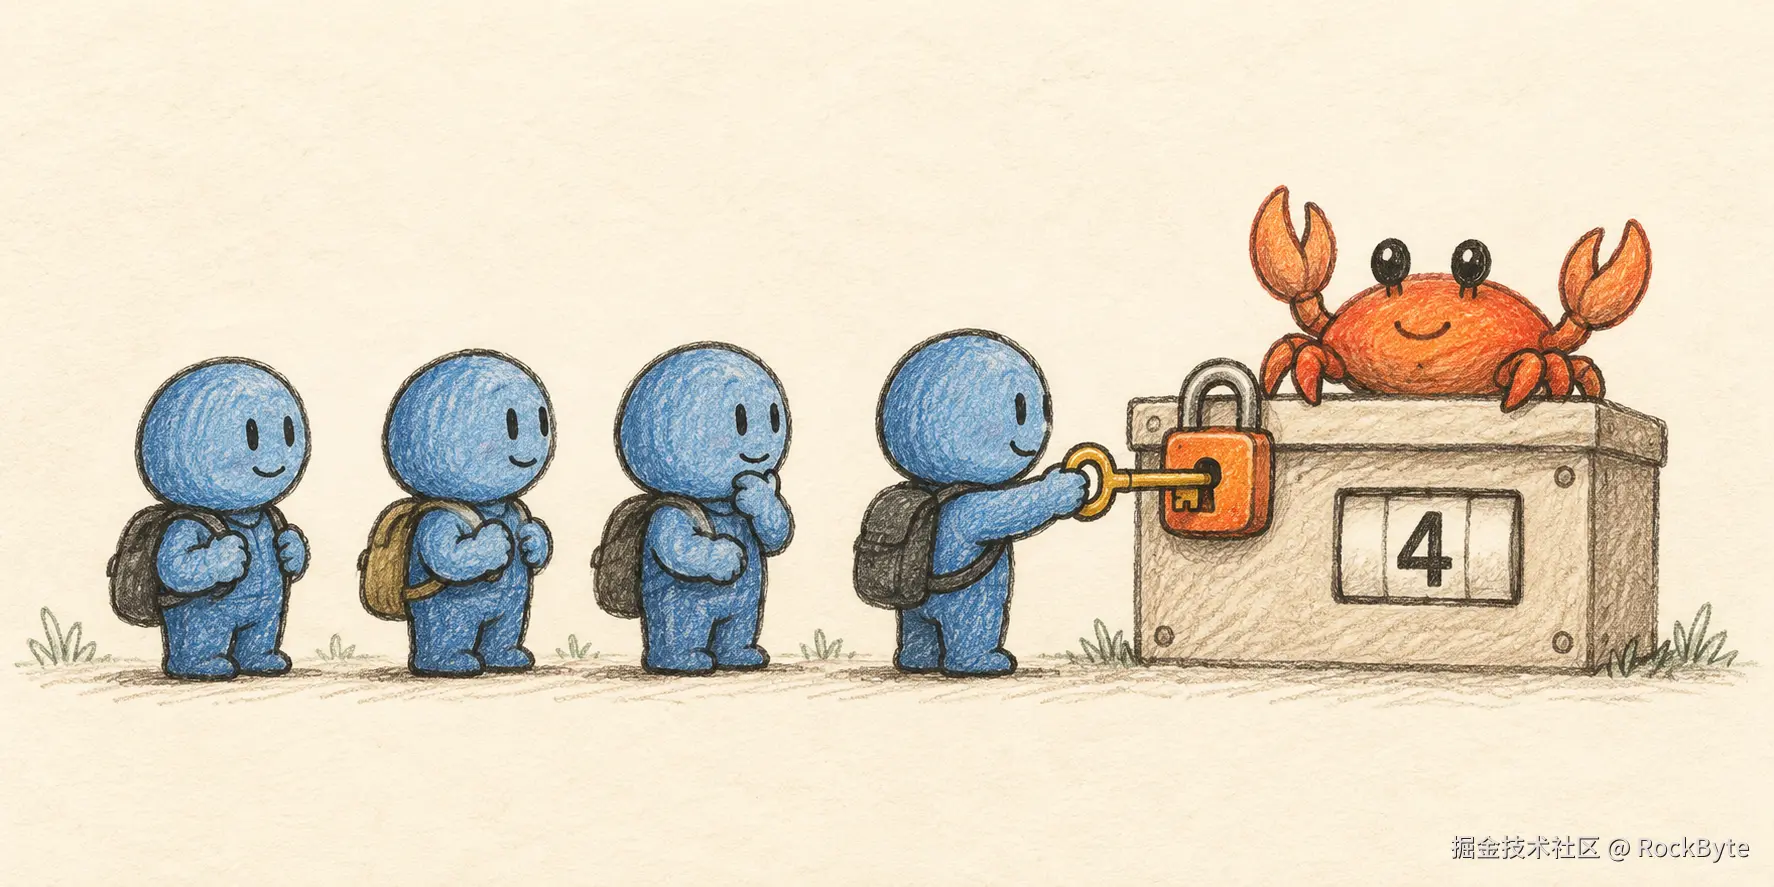
在这个例子里,线程通过 Arc 共享 Mutex,因此访问计数器要先取得锁。不要把它理解成"Rust 任何时候都必须加锁才能访问 Mutex 内的数据":独占持有时还可以使用 get_mut 等接口。这些接口之所以可行,是因为独占访问已经排除了其他线程同时访问的可能。
在常见的 C++ 写法里,互斥锁和数据是两个独立成员,调用者需要遵守"访问前先加锁"的约定。也可以把它们封装到一个类中,统一控制访问。
区别在于,Rust 的 Mutex<T> 已经把这种关联放进了类型和访问接口里。
有个边界必须说清楚:在所依赖的底层实现正确的前提下,安全 Rust 能防止数据竞争,但不能防止死锁,也不能防止逻辑上的竞态条件。例如,先加锁检查余额,解锁后再重新加锁扣款,中间就可能有其他线程改变余额。每次访问都加了锁,整个业务操作仍然可能出错。借用检查器无法替你决定哪些步骤应该作为一个整体执行。
Rust 也有成本
借用检查器会让你碰壁。双向链表、带环的图,这些数据结构写起来都不轻松。你可能会在单线程场景使用 Rc<RefCell<T>>,把共享所有权和运行时借用检查组合起来,或者改用 Vec 存节点、用索引表示连接。
这些方案也有代价。前面用 RefCell 把检查移到了运行时,这也意味着借用冲突可能变成 panic。强 Rc 引用构成环时,对象还可能无法释放,需要用 Weak 等方式打破所有权环。内存安全不等于不会泄漏内存。
编译时间也可能让人头疼,尤其是大型项目。
学习曲线很陡。刚开始学的那一周,跟编译器对线的时候,就像在跟一个特别有礼貌、却一直说"不行"的人争论。
C++ 仍然有自己的优势
C++ 有几十年的积累。游戏引擎、浏览器、交易系统、CAD 软件,以及嵌入式开发中的大量系统,都建立在它之上。模板和 constexpr 也积累了丰富的编译期编程能力。
虽然 Rust 同样有泛型、trait、宏和常量求值,但不能把其中的 const generics 当成 C++ 模板的完整对应物。具体哪种方案合适,要看你需要表达什么,而不是笼统地排一个高下。
如果你需要的库只有 C++ 版本,很多时候,选择也就定下来了。
那 unsafe 呢
说到这里,你可能会问:Rust 还有 unsafe,那些编译器不能保证的操作怎么办?
在 C++ 中,任何一行代码都可能藏着内存问题。在 Rust 中,需要额外安全保证的操作被限制在 unsafe 边界内,便于定位和审查。审查者可以把注意力集中在这些边界及其相关实现上,而不是对几百万行代码一视同仁。
unsafe 也不表示"这一段必然有 Bug",而是表示有些条件需要实现者自己保证,编译器无法全部检查。例如,通过裸指针读取数据时,实现者要保证指针有效、对齐正确,而且没有违反访问规则。
审查因此不能只看被标记的几行,还要确认相关实现始终维持这些条件。一个封装如果对外提供安全接口,却没有正确检查输入或维护内部状态,调用者即使没有写 unsafe,也可能触发底层的未定义行为。
实际怎么选
对于网络服务、解析器,或者处理不可信输入的新项目,如果一个 Bug 就可能造成实际经济损失,可以选择 Rust。
如果你已经在维护一个庞大的 C++ 代码库,那就继续用 C++。别因为一时不满就重写,先把现代 C++ 用好:
- 使用智能指针表达所有权,例如
std::unique_ptr、std::shared_ptr。但它们不会自动修复指向 vector 元素的失效引用,shared_ptr也不会自动同步所指对象的读写。 - 使用 C++20 的
std::span表示连续数据的非拥有视图。它把起始位置和元素数量放在一起,但不会延长底层数据的生命周期,也不等于所有访问都有边界检查;vector 重新分配后,旧 span 同样可能失效。 - 分别构建启用 AddressSanitizer 和 ThreadSanitizer 的测试版本,检查内存错误与数据竞争。它们需要工具链和目标平台支持,不能在同一次构建中组合启用。
把前面"先填满容量"的错误示例保存为 vector_bug.cpp,在支持 AddressSanitizer 的 Clang 环境中,可以这样编译运行:
sh
clang++ -std=c++17 -O1 -g -fsanitize=address -fno-omit-frame-pointer vector_bug.cpp -o vector_bug
./vector_bug
这里使用类 Unix shell 写法,Windows 上的运行命令和工具链配置需要相应调整。正常完成重新分配并执行到最后的读取时,这段代码会触发释放后使用,AddressSanitizer 应报告 heap-use-after-free。
检测工具只能检查实际执行到的路径。一次测试没有报告错误,不能证明整个程序不存在内存问题;同样,没有运行到并发冲突路径,也不能证明不存在数据竞争。
也不用一次选定,就永远不变。可以使用 cxx 这个 Rust 库,在它支持的类型和接口范围内搭建 Rust 与 C++ 的互操作桥接,再逐个模块迁移。不过,它不会自动证明任意 C++ 实现都安全,C++ 一侧仍需遵守接口约定并保证自身安全。
一点想法
Rust 和 C++ 该怎么选,要看你愿意把精力花在哪里,单比速度或争论哪个"更好",还不够。
做决定前,先看看团队花最多时间证明的是什么:
- 引用是否始终有效?
- 并发访问是否正确同步?
- 重写后的程序,是否仍然符合过去 20 年积累下来的行为?
如果新代码最大的风险是内存和并发 Bug,Rust 可以把其中一部分证明工作,从你的脑子交给编译器。如果最大的风险是与庞大旧系统保持兼容,那么,配合严格工具检查的 C++ 往往更合适。