一张普通照片,能不能知道哪里近、哪里远?
能不能点击画面里的主体,让背景柔和地虚化?再往前走一步,让前景和背景产生一点移动差异,把静态照片做成循环小动画?
最近,我把这些想法做成了一款 Windows 桌面软件:照片深度与景深工坊。
它基于 Depth Anything V2,提供灰度深度图、伪彩深度图、景深虚化和照片视差 GIF。界面使用 C# WinForms,神经网络推理由 C++ Vulkan 核心完成,支持单张图片,也能处理整个文件夹。
想玩效果,可以直接使用部署包;想研究实现,也有完整的 VS2022 解决方案。
先看看:一张街景照片的"远近关系"
下面使用项目随附的官方街景示例,展示本软件的实际输出。
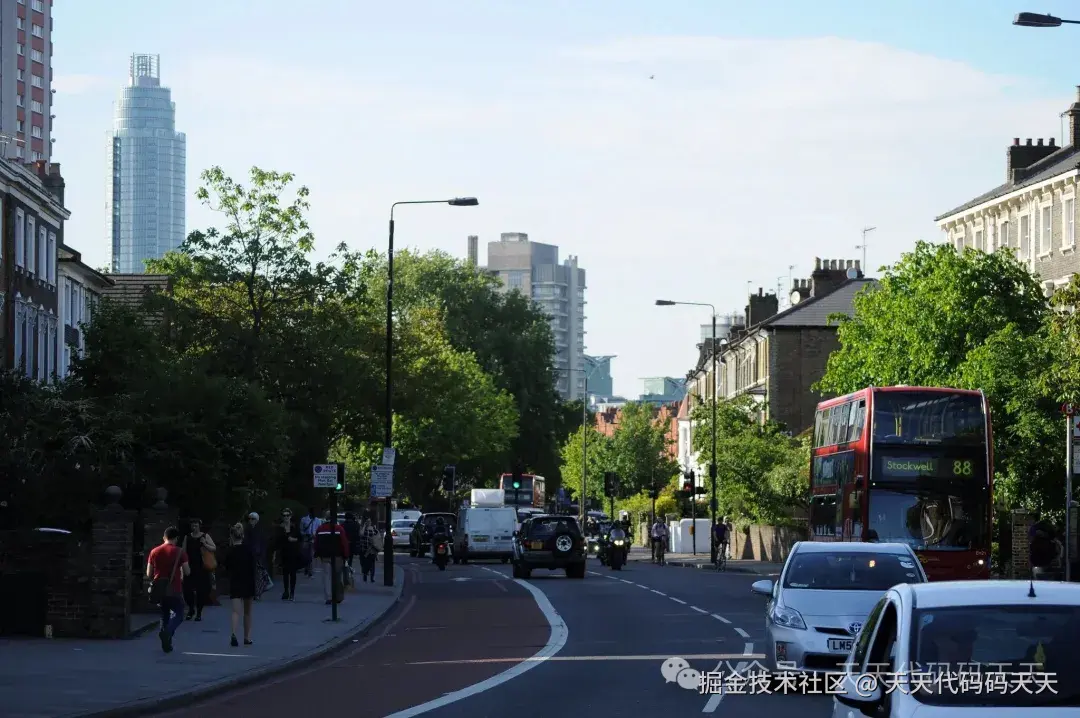
官方示例原图
原图:近处汽车、沿街树木和建筑、远处道路与天空,具有比较明显的空间层次。示例来自 Depth Anything V2 官方项目。
经过 Vulkan 推理后,可以得到这样一张伪彩深度图:
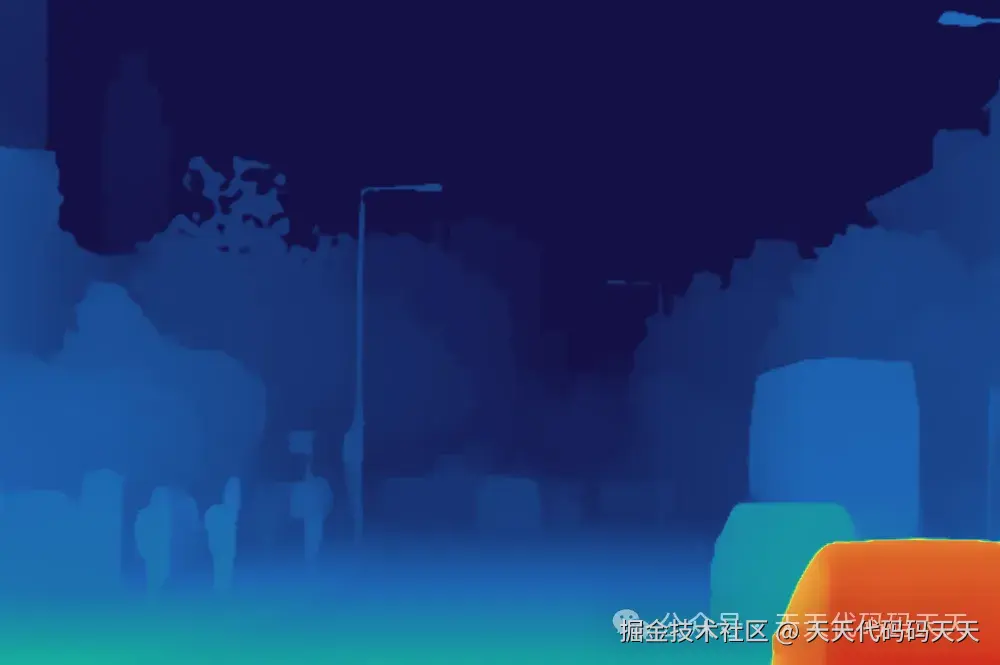
本软件实际生成的伪彩深度图
本例中,近处汽车偏暖色,远处区域偏冷色。颜色用于表达模型估计的相对远近,不表示物体本来的颜色。
有了这张深度图,再让不同深度的区域产生不同幅度的位移,就能得到照片视差动画:
本软件导出的照片视差循环 GIF
实际导出的循环 GIF:长边 320、6 帧/秒、共 12 帧,时长约 2 秒。这里采用小尺寸演示,软件中可调整导出参数。
这样的效果适合拿来做照片展示、旅行相册、社交分享,或者和小朋友一起观察:为什么近处的东西与远处的东西,看起来移动得不一样?
深度图到底是什么?
我们看照片,会自然判断汽车在前、楼房在后。深度估计模型则尝试为画面中的每一个像素预测远近关系。
这次使用的 Depth Anything V2 Small ,是一个约 2480 万参数的单目深度估计模型。单目,就是输入一张普通照片,不需要双目摄像头。模型与研究来自 Depth Anything V2 官方项目(github.com/DepthAnythi...
本版使用的是相对深度模型:输出通常可以理解为"越近,数值越大"。软件按每张照片的结果归一化,灰度图默认近白远黑。
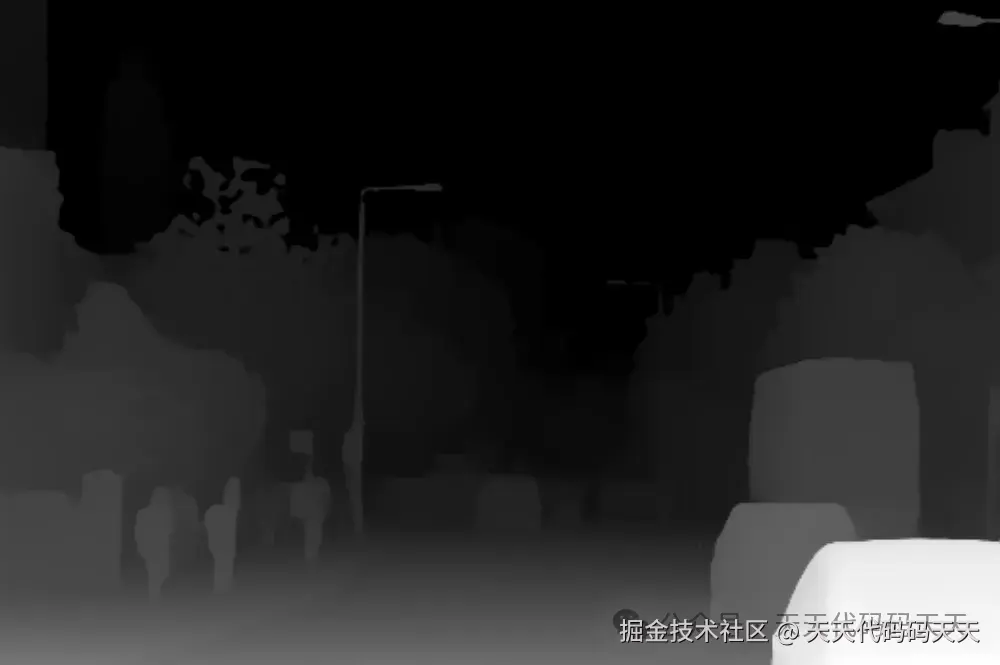
本软件实际生成的灰度深度图
它适合做图像效果和空间层次分析。不能根据灰度读出距离是多少米,也不能直接拿两张照片的归一化数值比较实际距离。
一次分析,可以玩四种效果
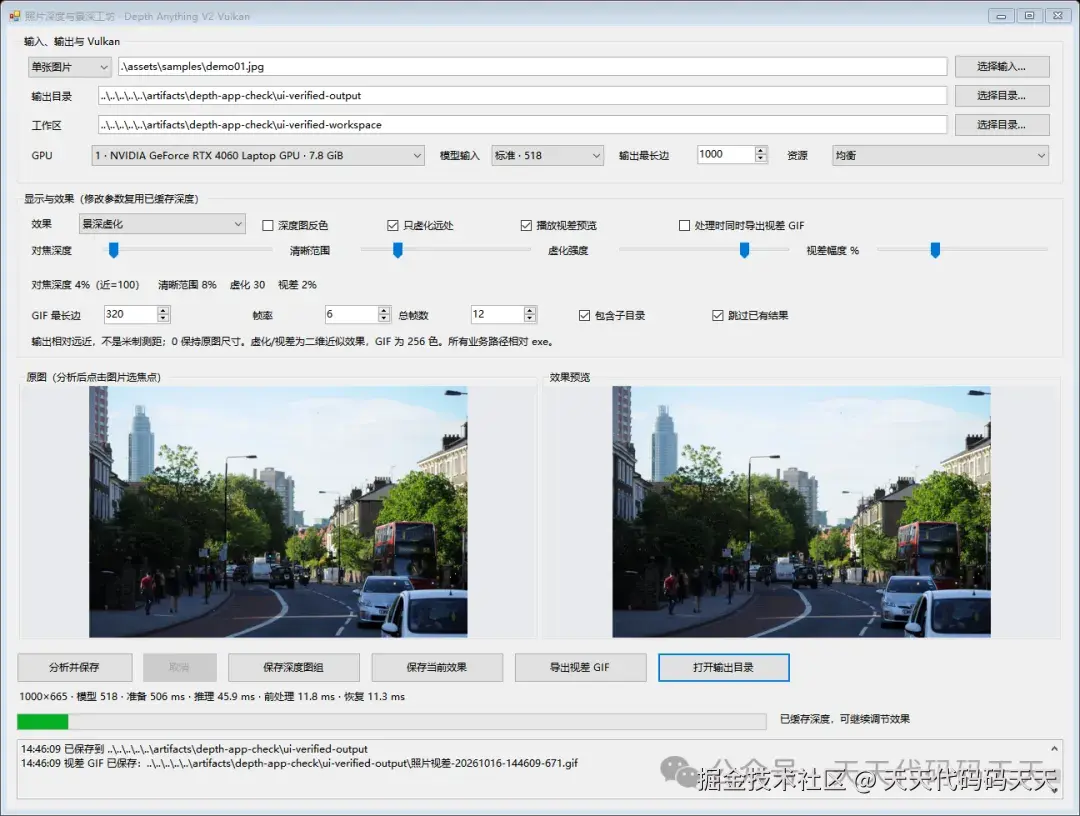
照片深度与景深工坊实际界面
实际运行界面:左侧原图,右侧效果预览,上方设置参数,下方显示进度和日志。此截图选择的是景深模式,虚化程度随焦点与参数变化。
| 功能 | 可以做什么 |
|---|---|
| 灰度深度图 | 直观看远近,也便于后续制作深度遮罩 |
| 伪彩深度图 | 用颜色观察空间层次,更适合展示和讲解 |
| 景深虚化 | 点击主体对焦,调整清晰范围与虚化强度 |
| 照片视差 | 预览轻微的空间摆动,导出循环 GIF |
这里专门做了一个交互优化:模型分析一次,深度结果就会缓存下来。
之后切换效果、修改焦点、调整虚化强度或视差幅度,都复用这份深度,不需要反复运行模型。选焦时直接点击左侧原图,比手动猜一个深度值方便得多。
改变原图、模型输入档位或输出最长边后,需要重新分析。
怎么使用?从导入到保存
第一步,完整解压并启动。
运行 Run.cmd 或 DepthAnything.WinForms.exe。保留同目录下的模型和运行文件,选择可写的解压目录。
第二步,选择照片和输出位置。
单图模式适合边看边调。想处理一组照片,可以切换到文件夹模式,并按需勾选包含子目录。
第三步,选择模型档位和输出尺寸。
软件提供 266 快速预览 和 518 标准两档。可以先用快速档观察整体关系,再尝试标准档比较边缘与细节。
注意,"模型输入"和"输出最长边"是两个设置:前者决定模型分析的分辨率;后者决定最终保存照片的尺寸,默认最长边 2048,设置为 0 时保留原尺寸,但仍受软件的图像尺寸上限限制。
**把输出尺寸调大,不会让模型凭空分析出更多深度细节。**大图也会增加后处理、保存和内存开销。
第四步,点击"分析并保存"。
首次使用某个档位时,需要准备 GPU 管线,可能等待几十秒。完成后可以继续调效果;相同档位会复用会话,后续启动也会尝试读取显卡管线缓存。
景深模式下,点击原图中的主体,再调整清晰范围和虚化强度。"只虚化远处"适合希望保留前景、突出主体的场景。
第五步,保存图片或 GIF。
"保存深度图组"一次导出灰度和伪彩两张 PNG;"保存当前效果"导出当前参数下的图片;"导出视差 GIF"生成循环动画。
GIF 默认长边 720、12 帧/秒、36 帧,约 3 秒。帧数更多、尺寸更大,生成和保存也会更慢。GIF 为 256 色格式,细腻渐变可能出现色带,适合轻量动效分享。
文件夹批量,也考虑了日常使用
批量任务可以保留子目录结构,并跳过已有的匹配结果。判断时结合原图内容、模型和效果参数;同名照片换了内容,或者调整了效果,会生成另一组结果。
遇到损坏图片会记录错误并继续处理;GPU 运行异常则停止当前任务。软件还会保存任务参数、逐图状态和耗时,方便查看处理情况。
路径默认相对 exe 所在目录,例如:
bash
./assets/models    模型
./输出             图片与 GIF
./工作区           任务记录
./cache            显卡管线缓存
整个文件夹移动位置后,自带资源仍按程序目录查找。同盘选择的路径尽量保存为相对路径,跨盘则保留完整路径。
资源模式提供"流畅、均衡、全速"。它主要通过图片之间的等待调整处理节奏,方便一边工作一边跑任务;单次推理时仍会正常使用 GPU。
技术上,一次完整处理是怎样完成的?
可以把流程理解为:
读取照片,应用 EXIF 方向
    ↓
等比例缩放、居中补边、RGB 归一化
    ↓
Vulkan GPU 执行 Depth Anything V2 Small
    ↓
裁掉补边区域,恢复深度图尺寸
    ↓
缓存深度,生成虚化、伪彩或视差效果
    ↓
保存 PNG / 逐帧编码 GIF
网络使用 DINOv2 编码器与 DPT 深度预测结构。本版把固定输入档位提前转换为离线执行计划,由 C++ Vulkan 核心执行 FP32 神经网络计算。
Vulkan 提供访问 GPU 计算能力的接口;模型如何执行、数据如何传输、结果如何恢复,仍需要推理核心和应用程序来完成。
**本版的网络计算在 GPU,读图、前后处理、虚化、视差和 GIF 编码在 CPU。**所以优化完整使用体验,还要考虑图像尺寸、内存、编码和写盘。
为便于部署,这一版将输入保持比例后补到 266 或 518 的正方形。官方默认推理使用可变矩形输入,两者的预处理策略不同,因此不承诺与官网默认演示逐像素一致。开发中已用相同输入,对照原始官方 PyTorch FP32 输出检查数值。
跑起来有多快?给一个有条件的实测
开发机器为 RTX 4060 Laptop GPU,8 GiB 等级显存,使用 Small FP32。GPU 和缓存准备完成后的短测结果为:
| 模型输入 | 单次网络调用短测 |
|---|---|
| 266 × 266 | 约 13 ms |
| 518 × 518 | 约 45 ms |
这里的网络调用包含输入上传、GPU 执行、同步与输出下载,不包含整张照片的全部处理、PNG 保存或 GIF 导出。这些是开发阶段短测记录,没有做大样本平均,不能据此直接换算成软件的完整处理帧率。
首次没有本应用管线缓存时,计划加载与 GPU 准备在本机约 26~36 秒。准备后的速度与第一次打开的等待,是两件需要分别观察的事。
518 档位的逻辑张量工作区约 151 MiB,这只是其中一部分内存,不等于总显存或峰值显存。本轮没有给出整卡利用率对比;其他显卡的表现也需要单独验证。
普通用户能用,开发者也能继续改
部署版面向 Windows x64,需要 .NET Framework 4.8 和支持 Vulkan 1.1 的显卡驱动。模型与必要运行文件随包提供,日常使用不需要安装 Python、CUDA、OnnxRuntime、FFmpeg 或 Vulkan SDK。
源码使用 C# .NET Framework 4.8 + 标准 .Designer.cs 窗体,界面可以在 VS2022 设计器里继续调整。解决方案包含 WinForms 项目和 C++ Vulkan 核心项目。
安装 .NET 桌面开发、C++ 桌面开发、.NET Framework 4.8 目标包以及相应 C++ 工具链后,打开解决方案,选择 Release | x64 ,将 DepthAnything.WinForms 设为启动项目即可编译运行。普通构建所需的 Vulkan 头文件、导入库和预编译着色器已提供。
本次部署 ZIP 约 196 MiB ,完整源码 ZIP 约 197 MiB,都已整理完成。开发者可以继续扩展深度遮罩、相册动效,或把推理模块接进自己的工具。
使用时也要保留一点预期:发丝、透明物体和遮挡边缘可能出现深度误差;景深是近似虚化,视差是基于原照片的二维重采样,无法恢复被遮住的背景。建议从较小的虚化和位移幅度开始,逐步找到自然的效果。
项目与交流
感谢 Depth Anything V2(github.com/DepthAnythi... 原作者开放模型与实现。本工具选用 Small 权重,官方标注其许可为 Apache-2.0;其他规格权重的许可不同,使用与二次分发时应分别查看。软件包保留了相应来源与第三方许可说明。
我很喜欢把这些开源模型做成可以直接打开、点一点击就能尝试的小工具。从动漫线稿到文档修复,再到这次的照片深度,希望技术既能用于开发,也能给日常生活带来一点乐趣。
如果你也喜欢 C#、WinForms、Vulkan 和 AI 桌面工具,欢迎一起交流使用体验、分享效果,也聊聊还想做什么有趣的功能。