简介:模型调用失败先分类再决定是否重试,重试必须有边界;再用 Model Adapter 让 Loop 依赖能力而不是供应商,做到不改 Loop 切换模型
模型调用失败:先分类,再决定是否重试
简介:「重试」只对暂时性故障有效,不是对所有失败都适用的兜底
| 阶段 | 典型问题 | 是否重试 | 正确处置 |
|---|---|---|---|
| 请求前 | 参数 / Schema 不合法 | 否 | 本地修复,记录配置错误,不要发起请求 |
| 认证 | Key 无效 · 权限不足 | 否 | 终止并提示配置问题 |
| 传输 | 网络中断 · 连接超时 | 有边界 | 短退避 · 保留幂等键 · 控制次数 |
| 服务端 | 429 限流 · 5xx 过载 | 有边界 | 指数退避 + jitter,减少对过载服务的二次伤害 |
| 模型输出 | 拒答 · 被截断 · 格式错 | 视原因 | 修复输入 · 调整预算 · 修正 Schema,不要盲目重试 |
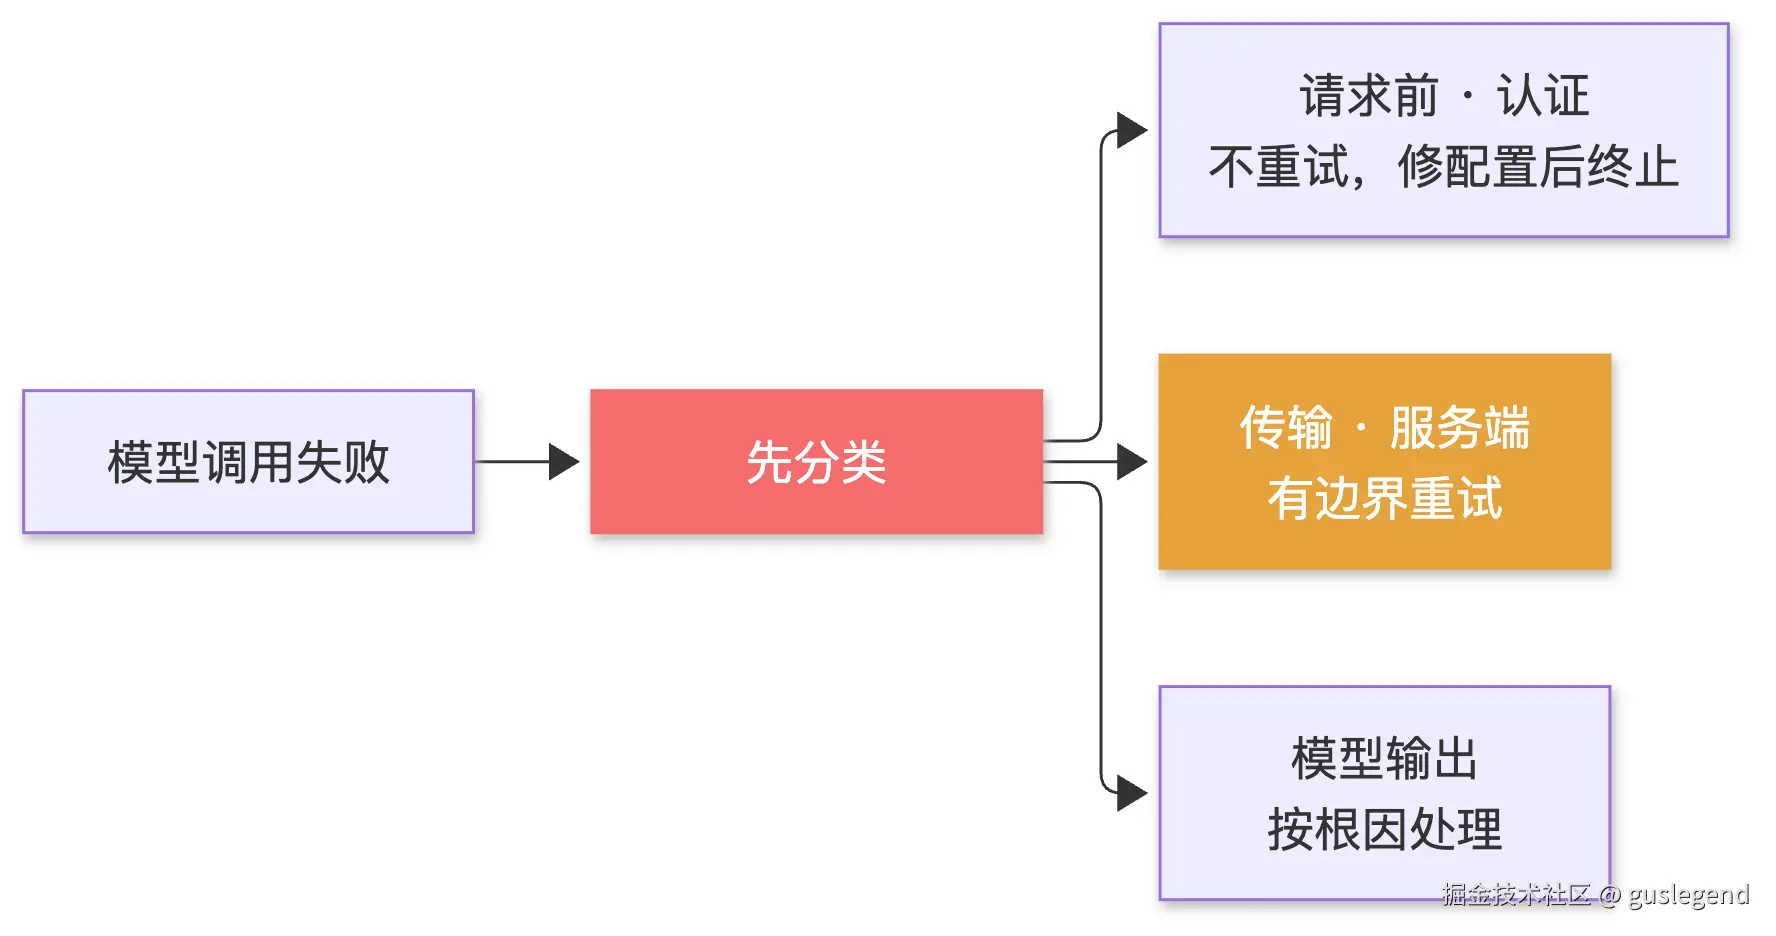
- 图中红色是第一步「先分类」,橙色是唯一适合自动重试的一类
- 重试的是暂时性故障,不是所有失败
有边界的重试、退避与降级
简介:最大次数、指数退避、jitter 三者缺一不可,重试失败还要有降级出口
python
import random, time

TRANSIENT = (TimeoutError, ConnectionError,
             RateLimitError, ServiceOverloaded)

def call_with_retry(call, attempts=3):
    for attempt in range(attempts):
        try:
            return call()
        except TRANSIENT:
            if attempt == attempts - 1:
                raise
            delay = min(8, 0.5 * (2 ** attempt)) + random.uniform(0, 0.2)
time.sleep(delay)- 退避公式:
delay = min(8, 0.5 × 2^attempt) + uniform(0, 0.2)- attempt=0 → 0.5~0.7s
- attempt=1 → 1.0~1.2s
- attempt=2 → 2.0~2.2s,第三轮仍未恢复即终止
- 退避有上限:过长的退避对单个任务没有意义,用户等待的总时长无法接受
- 四个组成部分
| 组成 | 作用 |
|---|---|
| 最大尝试次数 | 防止任务无限等待,防止成本失控 |
| 指数退避 | 2 ** attempt,对多服务器友好 |
| Jitter 抖动 | 避免大量请求同时重试形成 thundering herd(惊群) |
| 降级 | 换模型 · 缩短上下文 · 转人工 |
- 「有边界」是关键词:超过预算的 retry,本质上是事故制造机
拒答、截断、格式错:不是同一种「失败」
简介:模型层面的失败也要按根因区分,不能都丢给 retry 兜底
| 现象 | 根因假设 | 下一步 |
|---|---|---|
| 内容拒答 | 任务触发安全边界,或上下文不充分 | 终止或请求用户澄清,不能自动绕过 |
finish_reason = "length" |
输出预算不足 | 扩大预算或拆分任务,再次请求 |
| JSON 解析失败 | 未开约束 · 输出被污染 · 输出被截断 | 重新开启结构化输出,仍失败则终止 |
| 字段校验失败 | 模型生成值违反业务契约 | 回传具体字段错误给模型,限制重试次数 |
- 原则:把失败原因写入 Trace
- 后续才能区分是「模型问题」还是「系统设计问题」
- 记录字段:
trace_id·model_id·latency·finish_reason·schema_diff·retry_count
Model Adapter:让 Loop 依赖能力,而不是依赖供应商
简介:Loop 只认一个稳定的 ChatModel 协议,各家模型由 Adapter 实现
python
from typing import Protocol

class ChatModel(Protocol):
    def generate(self, messages: list[dict], *, max_tokens: int):
        ...  # returns str

class DeepSeekChatAdapter:
    def generate(self, messages, *, max_tokens):
        response = self.client.chat.completions.create(
            model=self.model,
            messages=messages,
            max_tokens=max_tokens,
        )
        return response.choices[0].message.content or ""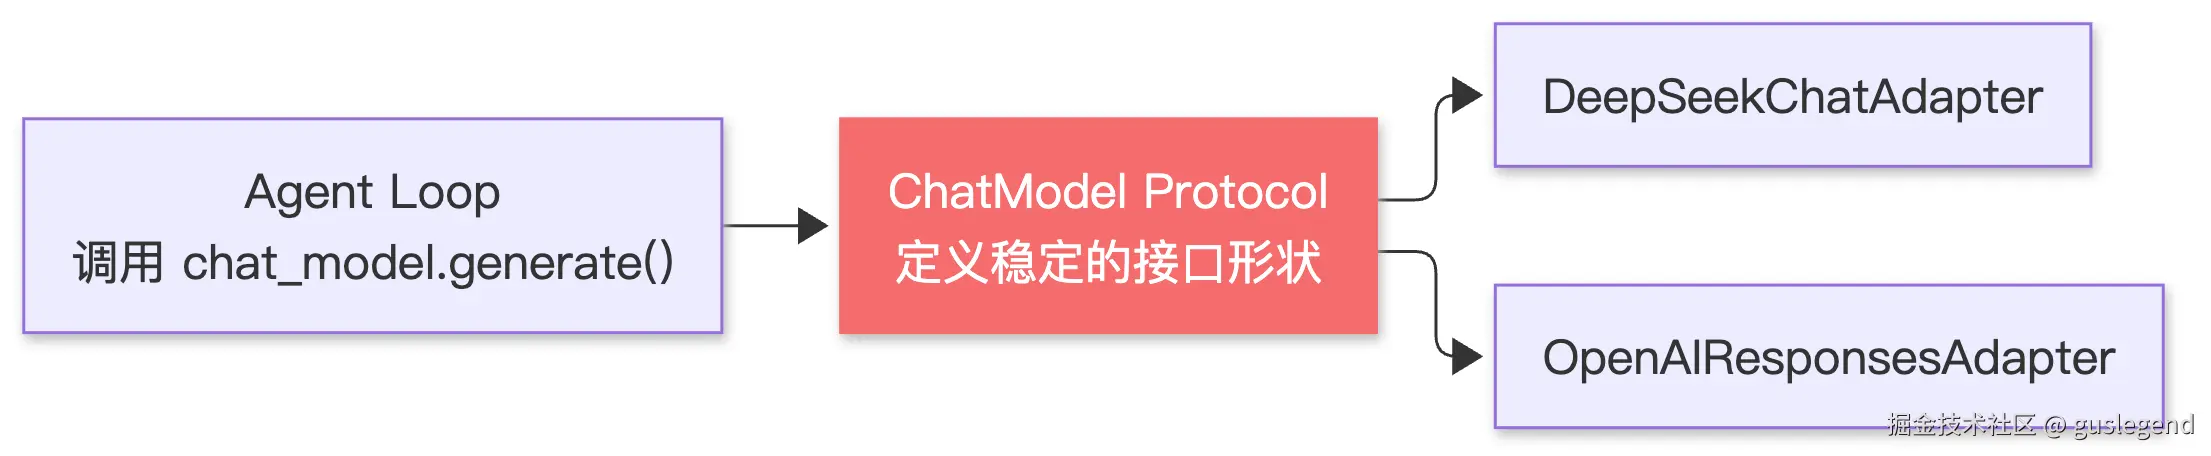
- 图中红色的 Protocol 是 Loop 与各家模型之间的契约
- 契约应该携带的内容
| 字段 | 内容 |
|---|---|
return type |
文本 · 结构化结果 · 工具请求 |
usage |
token 用量 · 费用估算 |
finish_reason |
正常 · 截断 · 拒答 |
- 不要暴露给 Loop 的东西
- 某个 SDK 的内部类型
- 嵌套三层的 provider-specific 字段
- 不一致的命名约定
- 后续扩展:把返回类型扩展为统一的
ModelResult,而不是直接返回str - 好处与代价
- 好处:换模型不改 Loop · 可以写 FakeModel 做测试 · 可以接 Langfuse / OpenLLMetry
- 代价:多一层抽象的初期学习成本,用业务单元测试覆盖即可收回
不改 Loop 切换两个模型
简介:Loop 只接受一个 ChatModel,换模型只是构造一个新对象
python
class MiniAgent:
    def __init__(self, model: ChatModel):
        self.model = model

    def run(self, task: str) -> str:
        messages = build_messages([], task)
        return self.model.generate(messages, max_tokens=600)

agent = MiniAgent(model=DeepSeekChatAdapter(...))
# 切换时:
# agent = MiniAgent(model=OpenAIResponsesAdapter(...))- 换来的四个能力
- ① 供应商切换不污染 Loop:
agent.run还是那样,只是输入改了 - ② 路由与 fallback:按成本、延迟、能力做选择
- ③ FakeModel 测试:确定性单元测试,不依赖真实模型
- ④ 可观测性:统一记录 token、费用、错误、trace
- ① 供应商切换不污染 Loop:
- 路由维度
- 切换维度:成本 · 延迟 · 能力 · 区域可用性
- 按任务类型路由、高峰期切到次级模型、跨区域容灾,都只发生在 Adapter 工厂,不在 Loop 内
- 注意点
- 切换前要先基于回归集评估,不能凭直觉在线切换生产流量
Harness 轮廓与实战任务
简介:Harness 不是一个 Prompt,也不是 SDK 包装,而是一组协同的工程职责
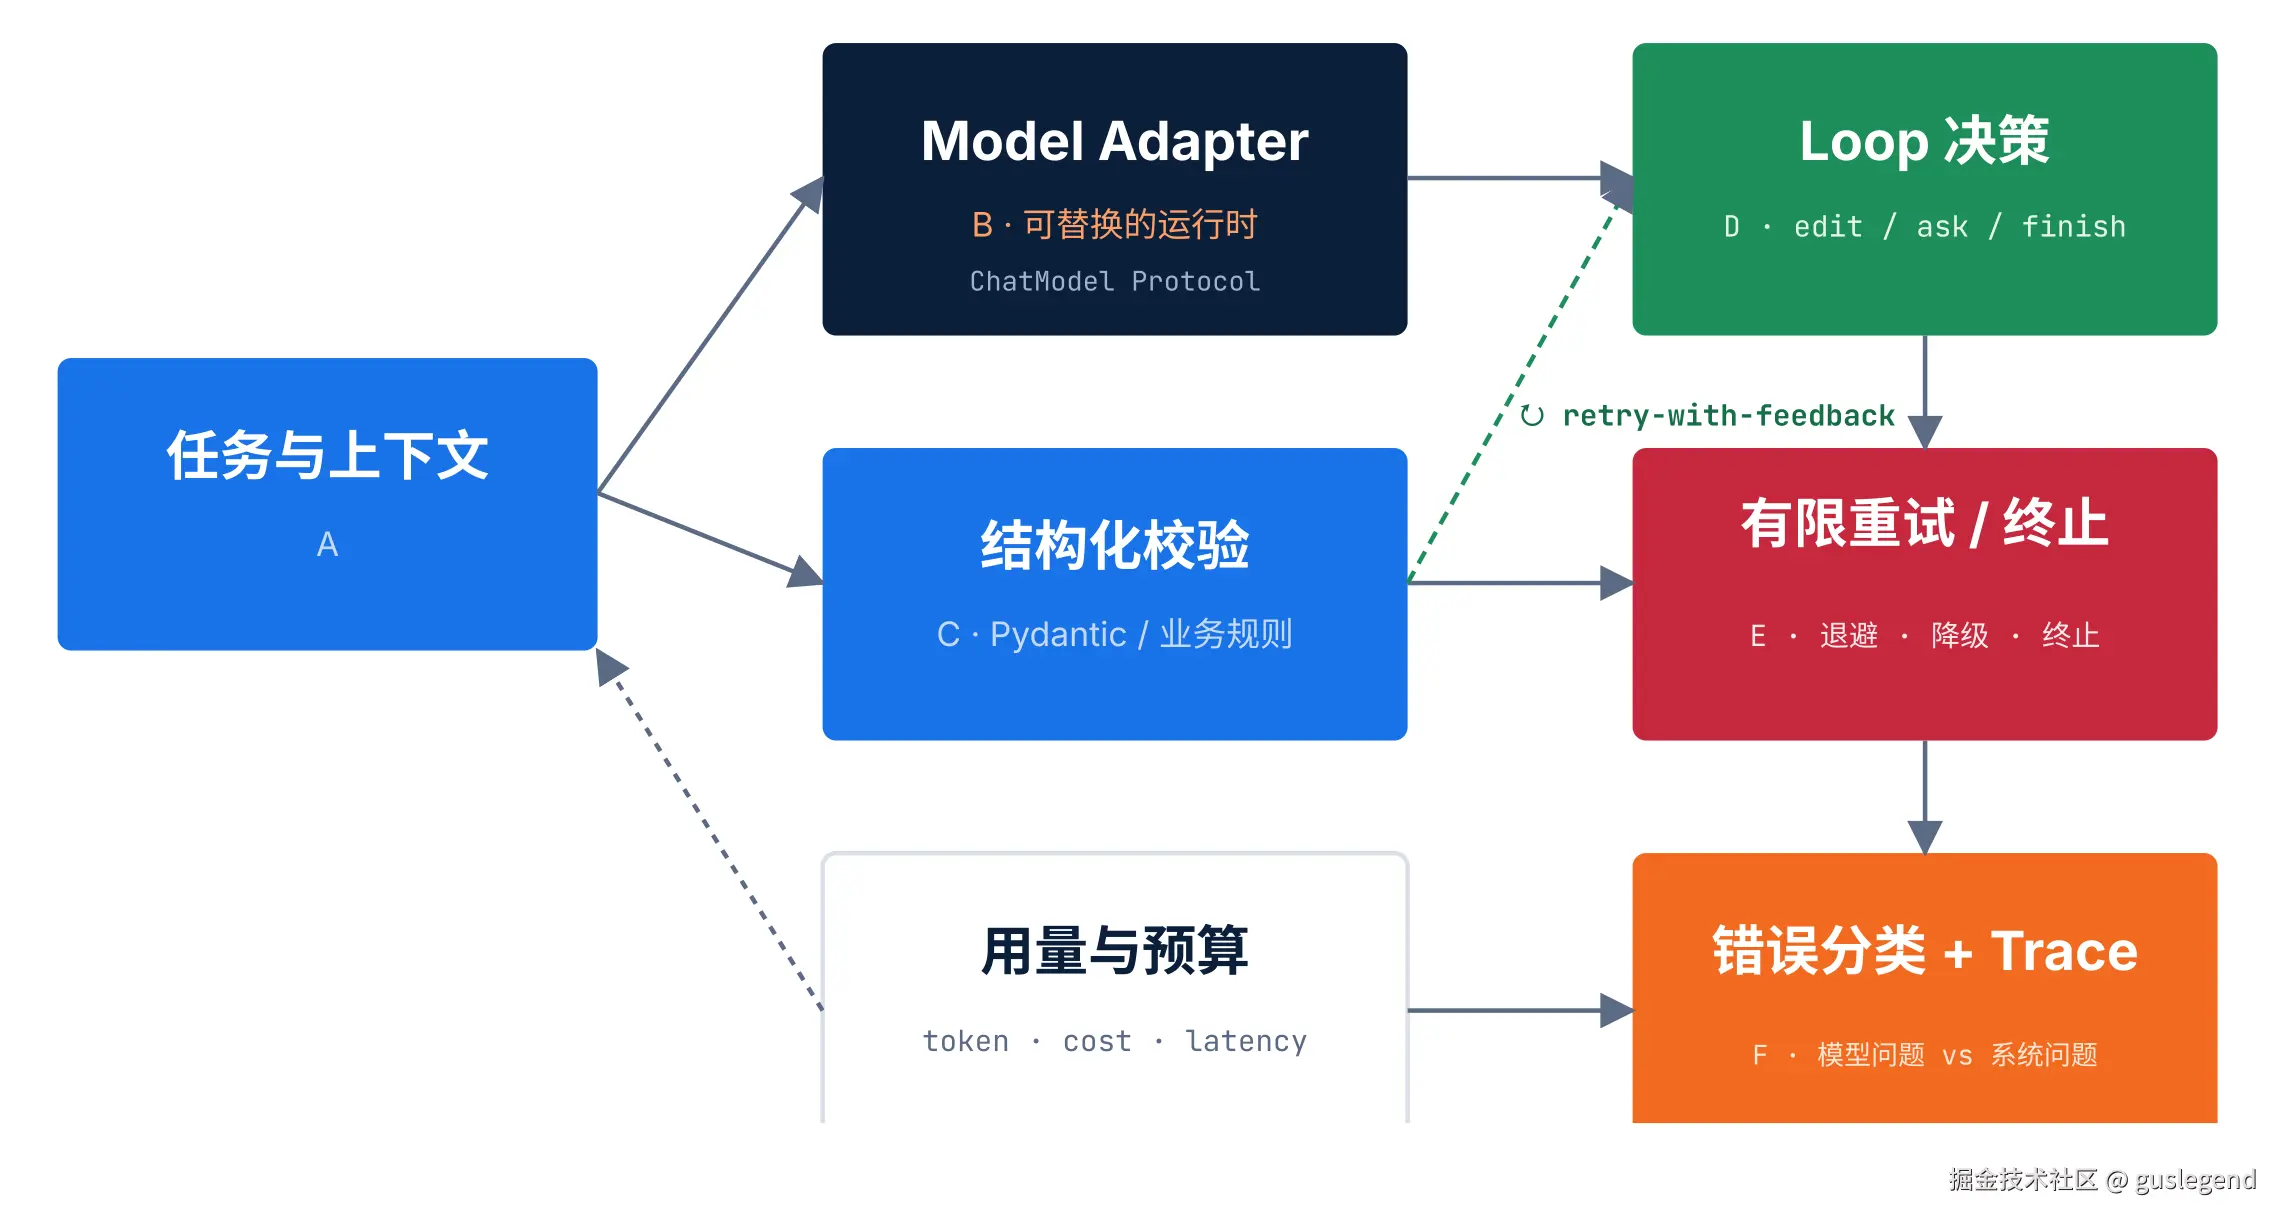
- Harness 统一管理的内容
- 模型 · 上下文 · 预算 · 状态 · 校验 · 失败策略 · 可观测性 · 路由与降级
- 不是一个 Prompt,也不是一个 SDK 包装,而是一组缺一不可的协同工程职责
- 结构化校验失败时走 retry-with-feedback,把错误回传后再让 Loop 决策
- 实战任务:Mini Coding Agent
- 输入一个代码问题 → 输出一个可校验的修改计划
| 部分 | 内容 |
|---|---|
| 输入 | 问题描述(git issue 或 user question)· 仓库摘要(结构、依赖、现有测试)· 相关文件片段(不超过 token 预算) |
| 输出契约 | action ∈ edit / ask_user / finish · file_path 必须是工作区相对路径 · reason 1~500 字 · risk ∈ low / medium / high |
| 异常与切换 | 429 / 超时 / 拒答必须记录并有停止条件 · Schema 校验失败回传具体字段错误 · DeepSeek ↔ 其他家 Adapter 切换时 Loop 不变 |
- 验收不是「模型回答得不错」
- 同类请求可回归 · 失败可定位 · 模型可替换 · 输出可校验
面试/考试记忆点
- 模型调用失败要先分类再决定是否重试,重试只针对暂时性故障
- 参数错误和认证失败不重试;网络中断、429、5xx 做有边界重试;拒答、截断、格式错按根因处理
- 有边界重试 = 最大次数 + 指数退避 + jitter + 降级,缺一个都会变成事故制造机
- 退避公式
min(8, 0.5 × 2^attempt) + uniform(0, 0.2),jitter 用来避免惊群 - 拒答不能自动绕过;截断要扩大预算或拆任务;字段校验失败要把具体字段错误回传给模型
- 失败原因要写进 Trace,才能区分模型问题和系统设计问题
- Model Adapter 让 Loop 依赖 ChatModel 协议而不是具体供应商,换模型只是构造新对象
- Adapter 契约要带返回类型、usage、finish_reason,不暴露 SDK 内部类型
- 模型切换前先基于回归集评估,路由、fallback 只发生在 Adapter 工厂里