摘要
在多源异构数据汇聚场景,往往同时运行上百条数据同步链路,源端数据库种类繁多,包含Oracle、MySQL、SQL Server、国产关系型数据库等多种类型。数据同步任务中,DML数据捕获与传输已经具备成熟方案,但源库DDL结构变更是异构同步链路稳定性最大的风险点:新增字段、修改字段类型、索引/约束变更会造成源目标表结构不一致,后续增量DML写入直接报错中断链路。
传统方案依靠人工分析DDL语句、手写转换规则、验证上线,在260+条长期并行链路场景下运维成本极高。本文介绍一套DDL自动翻译转换引擎完整实现思路,围绕语法AST解析、元数据模型、跨库类型映射、SQL重构、执行校验全链路展开,结合核心代码示例,阐述异构环境下表结构变更自动化同步的底层原理,降低大规模链路运维压力。
1 异构数据同步场景下DDL变更痛点
大型医疗数据汇聚项目中,部署260+条同步链路,多源数据库持续向统一目标平台汇聚业务数据。 数据本身的增量同步难度可控,真正影响链路稳定性的是业务侧持续发生的表结构变更:ALTER TABLE增删字段、调整数据类型、新增索引、修改约束等DDL操作。异构数据库天然存在语法与数据类型差异:同样是新增字段,Oracle、MySQL、SQL Server在类型定义、默认值、语法关键字、约束规则上各不相同。直接将源端DDL原样投递至目标库,大概率执行失败。
小规模链路场景下,工程师尚能人工解析SQL、编写转换规则、测试后恢复链路。但当链路规模扩张至260+条长期并行运行时,业务侧DDL变更持续发生,人工处理会形成持续堆积的运维工单,极易出现漏处理、错转换问题,引发数据写入异常、数据错位等隐性问题。
早期不少同步工具采用正则字符串替换实现DDL转换,这种轻量方案仅适合简单单字段DDL。一旦遇到一条ALTER语句同时修改多列、附带默认值与约束的复合DDL,正则匹配规则会持续膨胀,多条规则之间互相冲突,复杂DDL场景下匹配准确率快速下降。
核心思路:抛弃正则文本替换,采用 AST语法树解析 → 结构化元模型抽取 → 跨库类型映射 → 目标SQL生成器 → DDL执行校验闭环 。 不再操作原始SQL字符串,而是先读懂DDL语义,再按照目标数据库方言重新生成SQL语句。
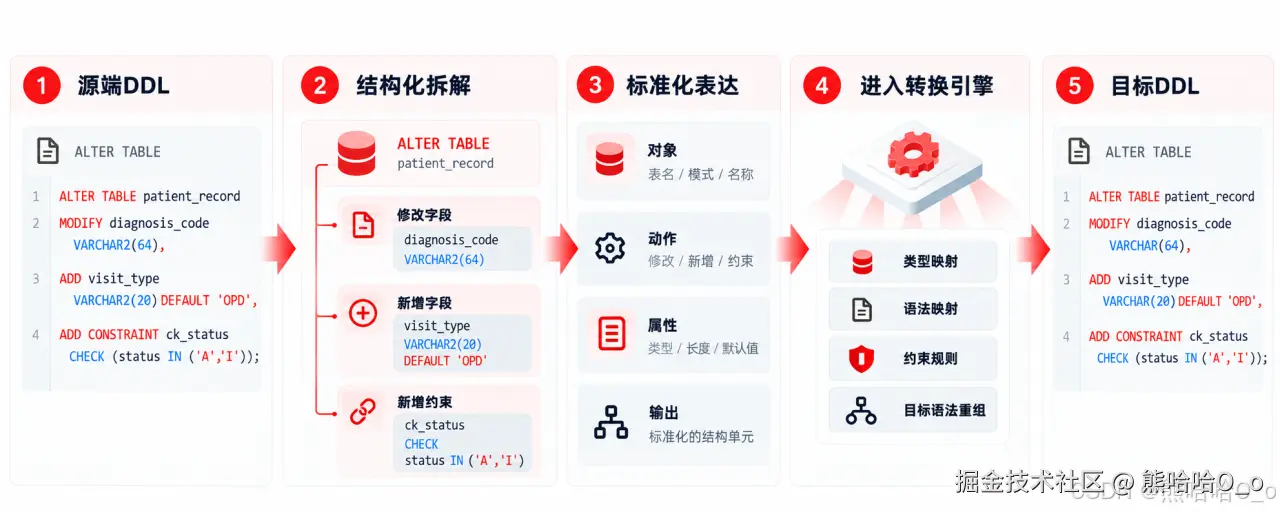
2 核心数据模型设计
整个引擎的基础是结构化元数据模型。AST语法树解析完成之后,无论源端SQL如何书写,都会把DDL变更信息抽取、填充到这套结构化对象中。后续所有类型映射、SQL生成逻辑都基于对象内的字段元数据,不再依赖原始SQL文本。
模型覆盖数据库表、字段、索引、约束以及单次DDL变更动作。每一条DDL语句,都可以拆解为一条顶层DdlEvent事件,事件内部包含多条独立的字段变更、索引变更、约束变更子项。这套模型支持解析复合ALTER语句,一条SQL中同时修改多个字段的场景会被拆分为多条独立变更动作,方便后续单独处理。
swift
import lombok.Data;
import java.util.List;

/**
 * DDL操作枚举类型
 */
public enum DdlOpType {
    CREATE_TABLE,
    ALTER_ADD_COLUMN,
    ALTER_MODIFY_COLUMN,
    ALTER_DROP_COLUMN,
    ALTER_RENAME_COLUMN,
    ALTER_ADD_INDEX,
    ALTER_DROP_INDEX,
    ALTER_ADD_CONSTRAINT,
    ALTER_DROP_CONSTRAINT
}

/**
 * 字段元数据
 */
@Data
public class ColumnMeta {
    private String columnName;
    private String sourceDataType;
    private Integer precision;
    private Integer scale;
    private boolean nullable;
    private String defaultValue;
    private String comment;
}

/**
 * 约束元数据:主键、唯一、check约束
 */
@Data
public class ConstraintMeta {
    private String constraintName;
    private String type; // PRIMARY / UNIQUE / CHECK
    private List<String> columnList;
    private String expression;
}

/**
 * 索引元数据
 */
@Data
public class IndexMeta {
    private String indexName;
    private boolean unique;
    private List<String> columnList;
}

/**
 * 单次DDL变更动作,一条SQL可拆解为多个Change
 */
@Data
public class ColumnChange {
    private DdlOpType opType;
    private ColumnMeta newColumnMeta;
    private ColumnMeta oldColumnMeta;
}

/**
 * 顶层DDL事件对象:AST解析输出结果
 */
@Data
public class DdlEvent {
    private String sourceDbType; // oracle / mysql / sqlserver
    private String targetDbType;
    private String schemaName;
    private String tableName;
    private List<ColumnChange> columnChanges;
    private List<ConstraintMeta> constraintList;
    private List<IndexMeta> indexList;
    private String rawSourceDdl; // 原始DDL文本,用于异常兜底
}
3 DDL AST解析模块:读懂源端DDL语义
AST解析模块是整个DDL翻译引擎的入口。在同步链路捕获到数据库增量日志之后,系统首先事件类型为DML还是DDL。如果判定是DDL事件,则送入语法解析器。
底层基于SQL语法解析组件(JSqlParser/ANTLR SQL Grammar),将原始DDL文本编译生成抽象语法树。程序遍历语法树节点,识别表名、字段、操作类型、字段属性、索引约束信息,最终组装成上文中的DdlEvent结构化对象。
这个阶段最重要的价值:剥离原始SQL的书写风格。无论业务开发写的SQL是否换行、关键词大小写差异、多操作合并在同一条ALTER语句中,最终输出的结构化元数据是统一标准。解决正则方案受SQL写法干扰、匹配不稳定的痛点。
ini
import net.sf.jsqlparser.parser.CCJSqlParserUtil;
import net.sf.jsqlparser.statement.Statement;
import net.sf.jsqlparser.statement.alter.Alter;

public class DdlAstParser {

    /**
     * 入口:传入源库类型 + 原始DDL,输出结构化DdlEvent
     */
    public DdlEvent parse(String sourceDbType, String rawDdl) throws Exception {
        DdlEvent event = new DdlEvent();
        event.setSourceDbType(sourceDbType);
        event.setRawSourceDdl(rawDdl);

        Statement statement = CCJSqlParserUtil.parse(rawDdl);
        if (statement instanceof Alter alterStmt) {
            event.setTableName(alterStmt.getTable().getName());
            // 遍历ALTER子节点,拆解多列变更,填充columnChanges
            AlterAstVisitor visitor = new AlterAstVisitor();
            alterStmt.accept(visitor);
            event.setColumnChanges(visitor.getColumnChanges());
            event.setConstraintList(visitor.getConstraints());
        }
        // 可扩展:CreateTable、DropTable等语句解析逻辑
        return event;
    }
}
4 跨数据库类型映射引擎:沉淀异构数据库转换规则
异构数据库之间大部分差异是稳定可复用的,例如Oracle NUMBER、MySQL DECIMAL,SQL Server NVARCHAR这类类型映射关系,不需要每条链路单独配置。引擎将这些映射关系注册到全局类型注册表中,所有260+条链路共用同一套规则库。
类型映射模块接收解析完成的字段元数据,根据源数据库类型、源数据类型、目标数据库类型,自动匹配模板,并把精度、标度、长度等参数填充到模板中。对于规则库中不存在的类型映射,直接抛出异常,不做猜测性转换,规避不可控的隐性错误。
项目落地中,这套内置规则可以覆盖95%常规DDL变更场景。仅带特殊默认值、复杂自定义约束、业务专属逻辑的DDL场景,才需要人工补充定制映射规则。
arduino
import java.util.HashMap;
import java.util.Map;

public class DataTypeMapper {
    // 类型映射注册表: sourceDb -> sourceType -> (targetDb, targetTypeTemplate)
    private final Map<String, Map<String, TypeRule>> typeRegistry = new HashMap<>();

    public DataTypeMapper() {
        // Oracle -> MySQL 映射样例
        register("oracle", "NUMBER", "mysql", "DECIMAL(${precision},${scale})");
        register("oracle", "VARCHAR2", "mysql", "VARCHAR(${precision})");
        register("oracle", "DATE", "mysql", "DATE");
        register("oracle", "TIMESTAMP", "mysql", "DATETIME");

        // SQL Server -> KES映射样例
        register("sqlserver", "NVARCHAR", "kes", "VARCHAR(${precision})");
        register("sqlserver", "INT", "kes", "INT");
    }

    private void register(String srcDb, String srcType, String dstDb, String dstTemplate) {
        typeRegistry
                .computeIfAbsent(srcDb, k -> new HashMap<>())
                .put(srcType, new TypeRule(dstDb, dstTemplate));
    }

    /**
     * 根据源字段元数据,映射得到目标库数据类型字符串
     */
    public String map(String targetDbType, ColumnMeta srcCol) {
        Map<String, TypeRule> srcTypeMap = typeRegistry.get(srcCol.getSourceDataType());
        if (srcTypeMap == null) {
            throw new UnmappedTypeException("无匹配类型规则:" + srcCol.getSourceDataType());
        }
        TypeRule rule = srcTypeMap.get(targetDbType);
        String template = rule.template;
        // 填充模板变量
        template = template.replace("${precision}", String.valueOf(srcCol.getPrecision()));
        template = template.replace("${scale}", String.valueOf(srcCol.getScale()));
        return template;
    }

    @Data
    static class TypeRule {
        String targetDb;
        String template;
    }
}
5 目标DDL SQL重构生成器:从零生成目标方言SQL
完成类型映射之后,进入SQL重构阶段。这一步和正则替换方案有着本质区别:正则是修改源SQL文本;而本引擎基于结构化元数据,完全按照目标数据库语法规范重新组装生成全新DDL语句。
引擎遍历所有字段变更动作,区分新增字段、修改字段、删除字段等不同操作类型,分别拼接目标数据库对应的ALTER子句,最后合并成一条完整可执行DDL。源端SQL的写法不再影响最终输出,只关心表结构变更动作本身。这种解耦设计便于后续新增数据库类型接入,只需要新增对应方言生成逻辑,不需要改动AST解析核心流程。
arduino
public class DdlSqlGenerator {
    private final DataTypeMapper dataTypeMapper;

    public DdlSqlGenerator(DataTypeMapper mapper) {
        this.dataTypeMapper = mapper;
    }

    /**
     * 核心生成入口,根据DdlEvent生成目标端可执行DDL
     */
    public String generate(DdlEvent event) {
        String targetDb = event.getTargetDbType();
        StringBuilder sqlBuilder = new StringBuilder();
        sqlBuilder.append("ALTER TABLE ").append(event.getTableName()).append(" ");

        List<String> alterClauses = new ArrayList<>();
        for (ColumnChange change : event.getColumnChanges()) {
            ColumnMeta srcCol = change.getNewColumnMeta();
            String targetType = dataTypeMapper.map(targetDb, srcCol);
            switch (change.getOpType()) {
                case ALTER_ADD_COLUMN:
                    String addClause = String.format(
                            "ADD COLUMN %s %s %s DEFAULT %s",
                            srcCol.getColumnName(),
                            targetType,
                            srcCol.isNullable() ? "NULL" : "NOT NULL",
                            srcCol.getDefaultValue()
                    );
                    alterClauses.add(addClause);
                    break;
                case ALTER_MODIFY_COLUMN:
                    String modifyClause = String.format(
                            "MODIFY COLUMN %s %s %s",
                            srcCol.getColumnName(),
                            targetType,
                            srcCol.isNullable() ? "NULL" : "NOT NULL"
                    );
                    alterClauses.add(modifyClause);
                    break;
                case ALTER_DROP_COLUMN:
                    alterClauses.add("DROP COLUMN " + srcCol.getColumnName());
                    break;
            }
        }
        sqlBuilder.append(String.join(", ", alterClauses));
        return sqlBuilder.toString();
    }
}
6 DDL执行 & 结果校验模块:构建安全闭环
生成目标DDL不等于DDL同步完成。引擎会把生成SQL下发至目标库执行,并捕获执行返回结果。整套机制采用保守设计原则:能够确定转换结果的自动执行;无法确定转换、执行报错的场景,不会强行执行不确定SQL,而是暂停链路、保留原始DDL并推送告警,交由人工介入处理。
这套安全策略是生产环境可靠性的关键。DDL转换最危险的场景,是转换出错的语句静默执行,造成源库和目标库表结构隐性不一致,后续数据错位问题排查成本极高。在项目抽样验证中,经过自动转换的常规DDL语句,目标端一次性执行通过率可达98%以上。
ini
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.Statement;

public class DdlExecuteService {

    /**
     * 执行生成的目标DDL,并返回执行结果
     */
    public DdlExecuteResult execute(String targetJdbcUrl, String user, String password, String targetDdl) {
        try (Connection conn = DriverManager.getConnection(targetJdbcUrl, user, password);
             Statement stmt = conn.createStatement()) {
            stmt.execute(targetDdl);
            return DdlExecuteResult.success();
        } catch (Exception e) {
            // 执行异常,返回错误信息,上层触发链路暂停、告警
            return DdlExecuteResult.fail(e.getMessage(), targetDdl);
        }
    }

    /**
     * 完整DDL翻译+执行入口,对外暴露给同步链路
     */
    public DdlSyncResult handleDdlEvent(DdlEvent rawEvent, String targetJdbc, String user, String pwd) {
        try {
            // 1. 类型映射
            DataTypeMapper mapper = new DataTypeMapper();
            // 2. 生成目标方言SQL
            DdlSqlGenerator generator = new DdlSqlGenerator(mapper);
            String targetDdl = generator.generate(rawEvent);
            // 3. 执行DDL
            DdlExecuteResult execResult = execute(targetJdbc, user, pwd, targetDdl);
            if (execResult.isSuccess()) {
                return DdlSyncResult.ok("DDL自动转换并执行成功");
            } else {
                // 执行失败:暂停链路,保留原始DDL,人工介入
                return DdlSyncResult.pauseLink("目标库执行失败:" + execResult.getErrMsg(), rawEvent.getRawSourceDdl());
            }
        } catch (UnmappedTypeException e) {
            // 无法自动映射,直接暂停链路,不强行生成SQL
            return DdlSyncResult.pauseLink("无法自动转换DDL:" + e.getMessage(), rawEvent.getRawSourceDdl());
        } catch (Exception e) {
            return DdlSyncResult.pauseLink("DDL处理未知异常:" + e.getMessage(), rawEvent.getRawSourceDdl());
        }
    }

    @Data
    public static class DdlExecuteResult {
        boolean success;
        String errMsg;
        public static DdlExecuteResult success() {
            DdlExecuteResult r = new DdlExecuteResult();
            r.success = true;
            return r;
        }
        public static DdlExecuteResult fail(String msg, String sql) {
            DdlExecuteResult r = new DdlExecuteResult();
            r.success = false;
            r.errMsg = msg;
            return r;
        }
    }

    @Data
    public static class DdlSyncResult {
        boolean autoComplete;
        boolean needPause;
        String message;
        String rawDdlBackup;

        public static DdlSyncResult ok(String msg) {
            DdlSyncResult res = new DdlSyncResult();
            res.autoComplete = true;
            res.needPause = false;
            res.message = msg;
            return res;
        }
        public static DdlSyncResult pauseLink(String msg, String rawDdl) {
            DdlSyncResult res = new DdlSyncResult();
            res.autoComplete = false;
            res.needPause = true;
            res.message = msg;
            res.rawDdlBackup = rawDdl;
            return res;
        }
    }
}
7 链路调度入口:多链路共享DDL翻译引擎
在260+条链路集群部署架构中,DDL翻译引擎是全局单例服务,所有同步链路复用同一套解析、类型映射、SQL生成能力。每条链路独立维护自身源库类型、目标库类型、数据库连接信息。
同步链路持续消费增量日志事件,区分DML与DDL。DML事件走常规数据写入流程;捕获DDL事件后,送入DDL翻译流水线。当DDL处理返回需要暂停链路的结果时,链路会自动停止消费增量数据,同时向运维监控平台推送告警,附带原始DDL语句和错误信息,方便运维人员排查处理。人工修复完成后,可手动恢复链路继续同步。
csharp
public class SyncLinkWorker {
    private String linkId; // 链路ID,如 LINK-201
    private String sourceDbType;
    private String targetDbType;
    private DdlExecuteService ddlService;

    public SyncLinkWorker(String linkId, String sourceDb, String targetDb, DdlExecuteService service) {
        this.linkId = linkId;
        this.sourceDbType = sourceDb;
        this.targetDbType = targetDb;
        this.ddlService = service;
    }

    /**
     * 同步链路捕获到增量事件,区分DML/DDL
     */
    public void consumeIncrementEvent(IncrementEvent event) {
        if (event.isDml()) {
            // DML正常写入目标库
            writeDml(event);
        } else {
            try {
                // 捕获DDL事件,送入自动翻译流程
                DdlAstParser parser = new DdlAstParser();
                DdlEvent ddlEvent = parser.parse(sourceDbType, event.getRawSql());
                ddlEvent.setTargetDbType(targetDbType);
                DdlSyncResult syncResult = ddlService.handleDdlEvent(
                        ddlEvent,
                        event.getTargetJdbc(),
                        event.getTargetUser(),
                        event.getTargetPwd()
                );
                if (syncResult.isNeedPause()) {
                    // 链路暂停,推送告警消息到运维平台
                    alarmService.sendAlarm(linkId, syncResult.getMessage(), syncResult.getRawDdlBackup());
                    this.pause();
                }
            } catch (Exception e) {
                alarmService.sendAlarm(linkId, "DDL解析异常:" + e.getMessage(), null);
                this.pause();
            }
        }
    }

    private void writeDml(IncrementEvent event) {
        // DML增量写入逻辑,本文省略
    }
    private void pause() {
        System.out.println("链路 " + linkId + " 已暂停,等待人工处理DDL变更");
    }
}
8 端到端案例演示
源端Oracle原始DDL语句:
less
ALTER TABLE hospital_patient MODIFY (age NUMBER(4), name VARCHAR2(128));整条处理链路:
- AST解析:识别ALTER MODIFY操作,拆解两个字段变更,填充到DdlEvent对象;
- 类型映射:
NUMBER(4)映射为INT(4),VARCHAR2(128)映射为VARCHAR(128); - SQL重构:生成适配MySQL方言的目标DDL;
sql
ALTER TABLE hospital_patient MODIFY COLUMN age INT(4) NULL, MODIFY COLUMN name VARCHAR(128) NULL- 目标库执行,校验返回结果;执行成功,链路继续同步增量DML数据。
9 大规模链路场景价值
单条链路DDL自动翻译解决单次表结构变更问题;260+条链路统一搭载这套DDL解析-映射-重构-校验引擎,解决规模化运维难题。 第一,消除大量重复人工DDL转换工单,降低上百条异构链路的运维人力投入。业务侧频繁的表结构变更不再需要工程师逐条评估、编写转换SQL。 第二,规避正则替换带来的复杂DDL匹配错误、规则冲突问题,稳定支持复合ALTER多列变更场景。 第三,异常保守机制,禁止静默执行不确定DDL,避免DDL转换错误引发的数据一致性隐患。 第四,映射规则全局复用,新增同步链路时可直接复用已有跨库转换能力,快速扩容链路集群。
10 总结
多源异构大规模数据汇聚场景,DDL结构变更是同步链路稳定性的核心挑战。传统人工处理或简单字符串替换方案无法支撑200+链路长期稳定运行。 这套DDL自动翻译机制,将DDL处理拆解为语法AST结构化拆解、跨库规则映射、目标方言SQL重构、执行校验闭环四个阶段。不依赖原始SQL文本替换,把数据库之间稳定的类型、语法差异沉淀为可复用映射规则,实现绝大多数常规表结构变更自动同步。同时采用保守异常策略,在保证自动化效率的前提下,守住异构数据同步的结构一致性底线,支撑医疗、政企等多源汇聚场景下数百条异构同步链路稳定运行。