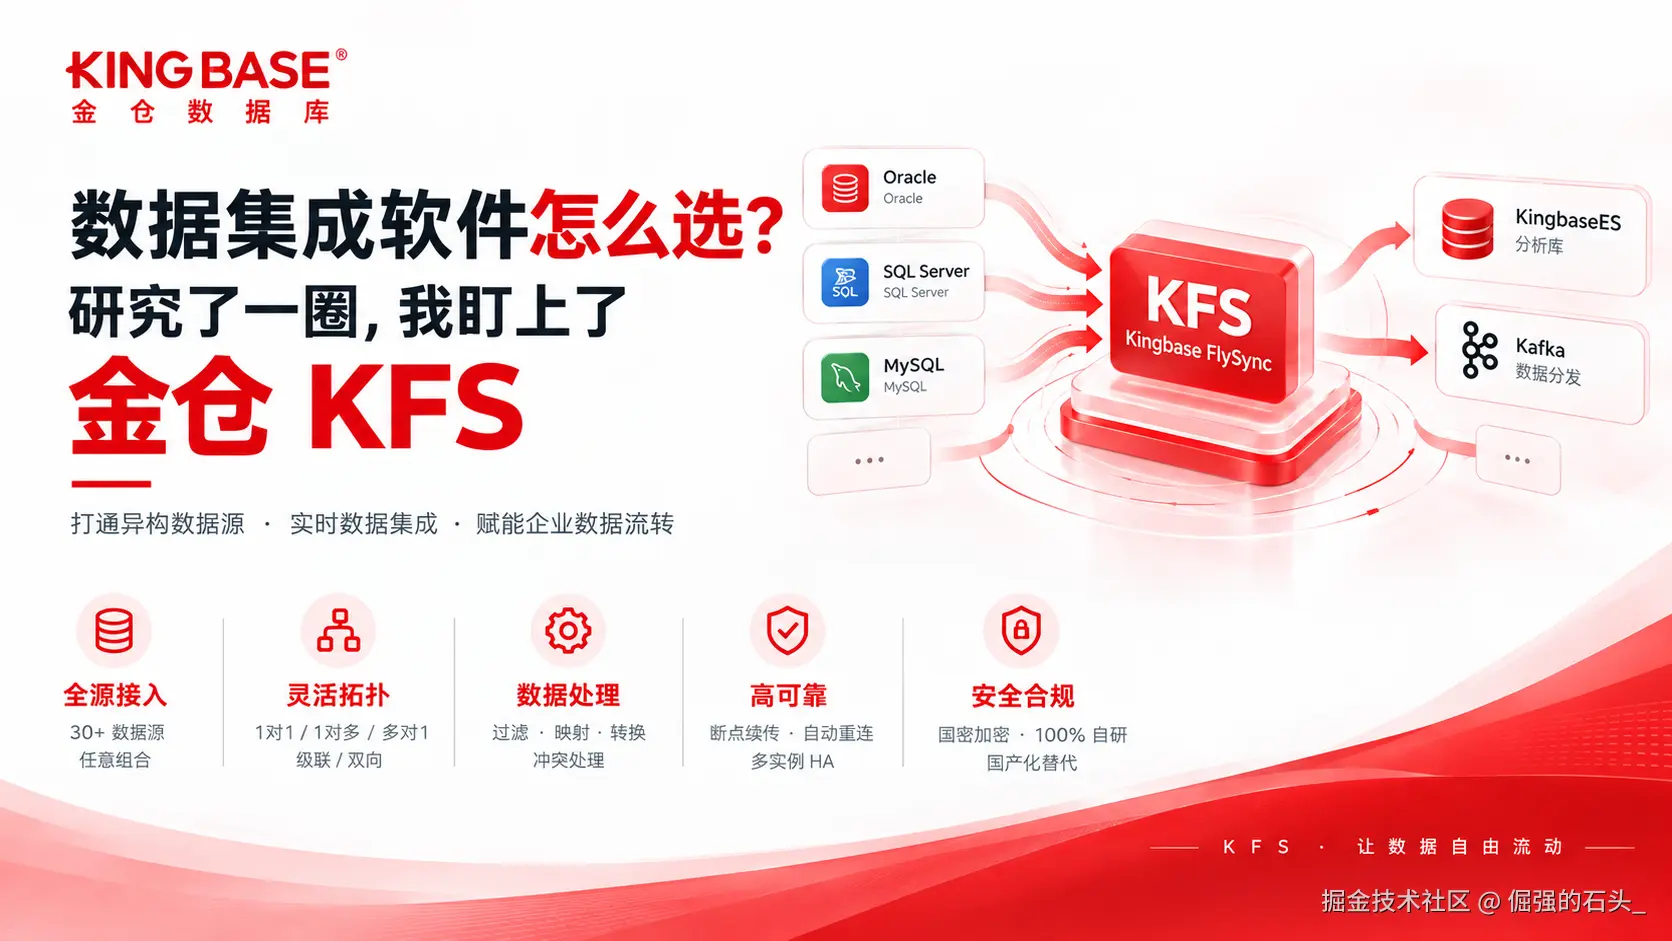
今天的主角是 Kingbase FlySync(KFS)。聊聊它作为一款数据集成软件,在企业数据架构里能站在什么位置、解决什么问题。文末附一份我自己整理的集成方案设计实操清单。
@toc
企业里的数据,为什么总是"各自为政"
先讲一个我见过太多次的画面。
一家中型企业,ERP 跑在 Oracle 上,CRM 在 SQL Server,MES 在 MySQL,财务系统又是一套独立的库。报表部门要一份"本月各区域销售与库存对照表"。那 IT 部门怎么处理呢?导出 Excel → 人工核对 → 合并表格 → 发邮件。一套流程下来,半天没了。而且数据还未必准。
这不是个例。大型企业和政府部门的信息系统,因为历史原因,普遍是分阶段、分部门建设的。系统碎片化,就带来了所谓的"信息孤岛":每个系统的数据都很好,就是彼此不通。数据资产没法整合利用的话,那数字化转型也就无从谈起了。 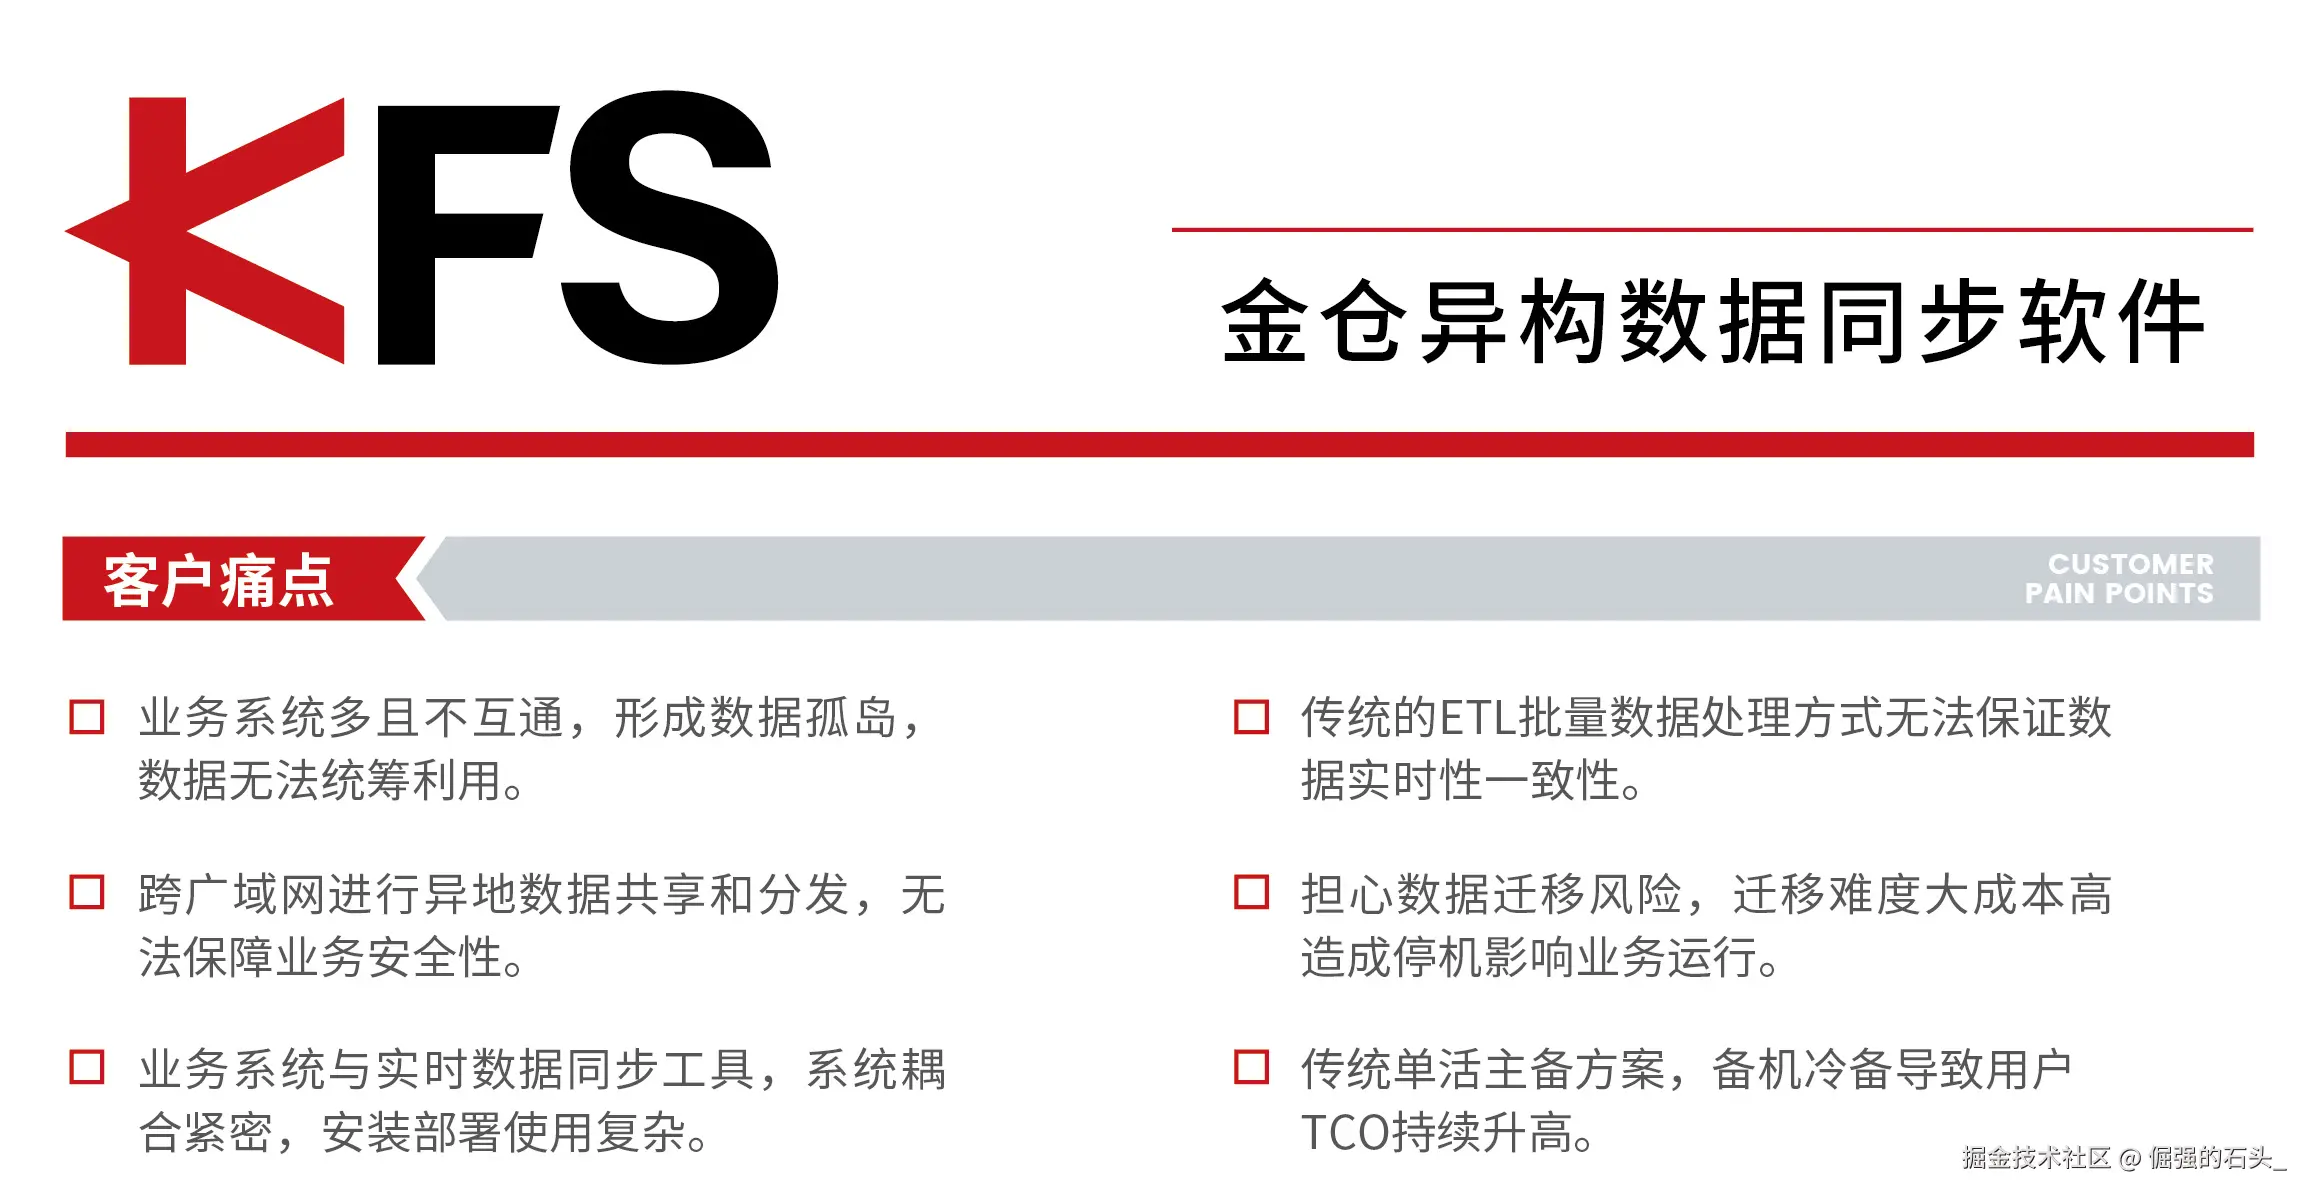
那解数据孤岛这个问题,业界有两类工具:
第一类是传统 ETL 批量工具。 定时抽、批量灌。特点是成熟、便宜。但是实时性差------数据延迟往往按小时甚至按天算,一致性也没有严格保证。同步期间对生产库的资源占用,还不小。业务对数据实时性的要求越来越高之后,这类方案就越来越跟不上了。举个具体的例子:连锁零售企业要做"线上线下库存联动",凌晨批量的库存数据,到早高峰就失效了。爆款商品超卖、门店调拨决策滞后,这些都是天级延迟直接造成的业务损失。
第二类是基于日志解析的实时数据集成软件。 直接读数据库事务日志捕获变更,实时同步到下游。代表产品是 Oracle 生态的 OGG。这类工具实时性好、对生产库侵入低。但长期以来,被国外产品垄断着。而且对国产数据源的支持,普遍是不佳的。
金仓 KFS 就属于第二类。而且是我这次调研里看到的、对国产数据源支持最全面的实时数据集成软件之一。它对标 OGG 的定位,配合 100% 自研的代码自主率和国密加密能力,恰好卡在了"国外同步软件替代"这个需求点上。下面展开讲讲,它的集成能力到底强在哪。
作为数据集成软件,KFS 的三板斧
第一板斧:全源接入,30 余种数据源任意组合
数据集成软件的第一道门槛,就是"接得进来"。KFS 支持的数据源,覆盖了当前企业层级里的主流选择:
- 交易型数据库:Oracle、SQL Server、MySQL/MariaDB、DB2、Informix、KingbaseES、达梦、OceanBase、PolarDB、openGauss、Vastbase、磐维、AntDB、TDSQL 等国内外产品,源端目标端双向支持;
- 分析型与大数据:Greenplum、ClickHouse、华为 DWS、KADB、Hive、Hadoop、星环 Inceptor/ArgoDB 等作为目标端;
- 消息队列:Kafka、RabbitMQ、RocketMQ、华为 ROMA;
- NoSQL 与其他:MongoDB、ElasticSearch、Redis、SQLite、SQL 文件,还能对接 FlinkCDC、StreamSets 等数据集成平台。
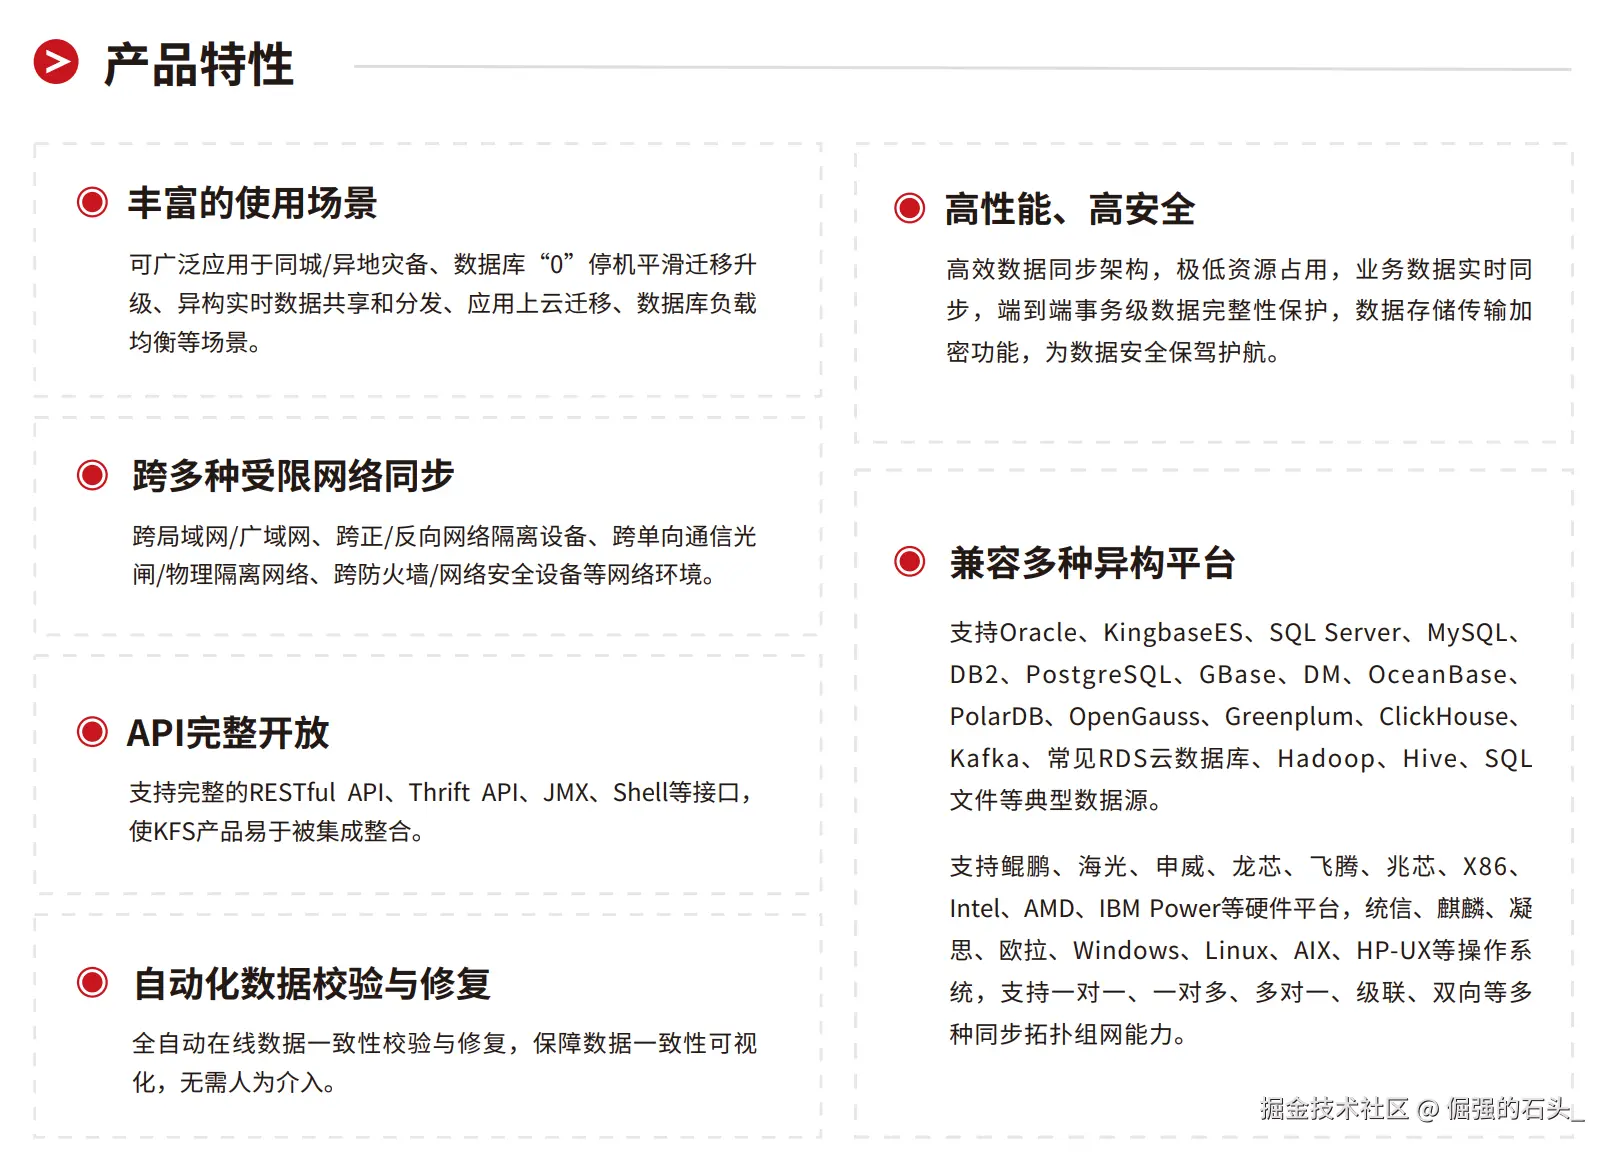
硬件和操作系统层面呢,鲲鹏、海光、申威、龙芯、飞腾、兆芯、x86 这些芯片平台,统信、麒麟、欧拉、凝思以及 Windows、Linux、AIX 等系统,都能跑。这个覆盖度意味着一个很实际的好处:企业不管存量系统是什么组合,大概率都能用一套软件把数据链路织起来,不用为了几种边缘数据源,再引入第二套工具。
第二板斧:拓扑自由,数据流向按业务需要设计
集成的核心,其实是数据流向设计。KFS 支持 1 对 1、1 对多、多对 1、级联、双向这些基础拓扑,而且可以任意组合、无限延伸。对应到真实业务场景:
- 实时数据汇聚:多个交易库的变更实时汇总到分析库,支撑数据治理和分析平台;
- 实时数据分发:总部向分支机构一对多分发。比如省级平台向十几个地市同步数据;
- 级联同步:先汇聚再分发,一条链路串起整个数据流转过程;
- 双向同步:两个数据库互为源和目标,配合自动冲突检测与处理,支撑双活架构。
跨网络能力也值得一提:KFS 能跨局域网/广域网、正反向网络隔离装置、单向通信光闸、物理隔离网络、防火墙同步。政务和央国企的朋友应该知道,"跨网闸同步"是个多让人头疼的需求。很多同步工具到这一步,就直接出局了。KFS 还有广域网传输优化,4 倍压缩比,2M 带宽就能跑实时容灾。安徽发改的公共资源交易平台项目,就是在 2M 低带宽、高时延的省-市专线环境下,实现合肥中心向 16 个地市的实时数据分发的。而且没有为同步新增任何专线成本。
第三板斧:不只搬数据,还能"整形"数据
很多同步软件只做搬运工。那 KFS 呢?它在链路中间提供了轻量级的数据处理能力:
- DDL 同步与转换:支持 DDL 过滤(按操作类型、按对象过滤),支持基于正则表达式规则对特定 DDL 语句做转换、或在前后附加其他语句;
- 数据映射与过滤:模式、表、列名称映射,数据库/模式/表/列级筛选过滤,行级筛选(按操作类型、按值);
- 冲突处理策略:从简单的"遇冲突中止等人工",到基于值大小、最后修改时间等条件的专业策略(自动忽略、执行 UPDATE、记录日志),都支持;
- GIS 数据类型同步:与 Oracle、KingbaseES 配合形成 GIS 数据同步方案,覆盖水利、自然资源这些行业的国产化替代需求。
这套转换能力,让 KFS 在"数据集成软件"这个定位上站得住------它不只是把 A 库的数据原样搬到 B 库,还能在流转过程中完成改名、过滤、整形,去适配下游系统的 schema 要求。
生态兼容:把 KFS 接进已有数据中台
不少企业已经有 FlinkCDC、Debezium 这类数据集成平台,或者用 Kafka 做数据总线。这种情况下引入 KFS,不是推翻重来,而是接入:
- KFS 提供标准的 Kafka 消息格式,同步到 Kafka 的数据,下游直接消费就行。中海油数据湖项目里,6 个 KES 库的数据通过 KFS 实时同步进 Kafka,DML 和 DDL 都能同步,数据落到 Kafka 后按标准消息格式即可对接消费;
- KFS 支持标准 FlinkCDC 消息格式,可以把 KES 数据库接进客户已有的 FlinkCDC 平台。中国移动的集中化查询平台项目,95 个源端数据通过 KFS 实时同步到 FlinkCDC,存量数据十几个 T,日增 10GB 以上。
这个思路我觉得很务实。新数据库(比如 KES)要进入企业数据链路,最顺滑的方式不是重建一套集成体系,而是让新数据库产生的开箱即用的变更流,汇入企业已经验证过的数据管道。KFS 在这里扮演的角色,说白了就是 KES 数据库与整个数据生态之间的"标准转接头"。
还有一个容易被忽视的集成质量话题:同步链路自己的可靠性。数据集成软件一旦部署,就成了企业数据流的必经通道。它自己出故障的话,影响面比任何一台业务服务器都大。KFS 在这方面给了四层保护。最底下是断点续传,保证故障恢复后不重传、不丢数据;再往上是连接重试参数,让网络抖动不至于中断链路;然后是外部依赖恢复后同步服务自动重启,不用人工干预;最顶层呢,是 KFS-HA + KFS-replicator 构成的多实例热备架构,主同步节点故障后备用节点自动接管,实测切换通常在 10 秒内完成。另外它支持防回环机制------双向同步、多数据中心互相同步的场景里,各条链路的数据互不干扰,不会出现 A 传给 B、B 又传回 A 的死循环。这些能力单看每一个,都不新鲜。但组合在一起,才能支撑医疗、金融、轨道交通这类"同步断了就是事故"的级别。
实操:设计一条"多源汇聚 + 单点分发"的集成链路
理论讲完了,给一份我整理的方案设计清单。假设场景是这样的:某集团要把 ERP(Oracle)、CRM(SQL Server)、电商(MySQL)三个系统的核心业务表,实时汇聚到 KingbaseES 分析库。然后再把汇总结果实时分发到 Kafka,供风控系统消费。
第一步:数据源盘点。 每个源库搞清楚五件事:数据库类型和版本;归档日志/事务日志模式开没开(Oracle 要开归档、补全日志);要同步哪些 schema 和表;哪些表没有主键、哪些表含大对象;日增数据量级。这一步决定同步方式和资源规划。无主键表和大对象表,必须单独标记出来。
第二步:拓扑与链路规划。 三源汇聚,可以一条链路建三个同步任务,也可以按业务域拆分。我的建议是按业务域拆:ERP 一条链路、CRM 一条链路、电商一条链路。这样的话,出问题的时候互不影响,监控上也能分清责任。KFS 到 Kafka 的分发,作为第二级链路,挂在分析库之后。
第三步:对象过滤与映射设计。 只同步需要的对象,用过滤规则排除日志表、临时表:
text
同步对象示例(ERP 链路):
  包含:ERP_SALES.*、ERP_FINANCE.gl_*
  排除:*_TMP、*_LOG、ERP_SALES.T_INTERIM*
列映射示例:
  源端 ERP_SALES.ORDERS.amount  → 目标端 sales.orders.amt
第四步:一致性保障设计。 这是数据集成方案里最不能省的部分。方案层面约定三道保险。第一道,靠 KFS 的事务级同步机制本身(按提交顺序加载、多道完整性检查)。第二道,启用 KFS 的定时数据校验任务,每天凌晨对核心表做增量校验,差异自动告警、按需自动修复。第三道,在关键对账场景保留业务级核对 SQL:
sql
-- 分析库侧每日对账:比较当日两端的订单笔数与金额合计
SELECT COUNT(*) AS cnt, SUM(amount) AS amt
  FROM sales.orders
 WHERE created_at >= CURRENT_DATE - INTERVAL '1 day';
-- 与源端 Oracle 同口径查询结果比对,差异即触发排查
第五步:监控与告警。 通过 KFSMC 管理平台配置:每条链路的同步延迟阈值告警(比如超过 5 秒就告警)、数据不一致告警、同步程序异常告警,通知渠道接邮件/短信/企业微信或钉钉。给风控消费方承诺 SLA 的时候,这些监控指标就是底气。
按这套清单走完,一个中等规模的多源汇聚方案,基本就成型了。回头看,数据集成软件的价值不只是"同步快",而是把评估、链路、转换、校验、监控这一整套工程问题做成了产品------这正是我从 KFS 身上看到的、它区别于"同步脚本"和"单点工具"的地方。
结语
数据集成是企业数字化的底座工程,选型的时候值得多花点时间。金仓 KFS 给我的整体印象是这样:数据源覆盖足够全、拓扑足够灵活、转换校验能力是原生内置而不是外挂的、跨网能力在同级别里明显突出。再加上金仓数据库本身的行业积累,KES + KFS 构成的国产化数据链路组合,在"数据集成软件"这个赛道上,已经有了完整的竞争力。如果你正在为数据孤岛发愁,或者正在规划国产化改造之后的数据流转体系,那么 KFS 值得进入你的评估名单。