系列 :《从0到1构建一个能"记住你"的智能体》 阶段 :优化 · 对应模块 M9 闭环迭代机制、M10 多智能体协作与编排 一句话 :智能体不是"做完就完",是"越用越聪明"。闭环迭代的本质,是让每一次踩坑都变成下一次的能力------这才是它区别于"一次性脚本"的地方。
上一篇,我们给超体装上了"尺子"------四个维度、三个北极星指标、一组基准集、一个独立验证器、一块运行时监控驾驶舱。尺子能量出"好不好用"了,但还有最后一道坎没迈过去:它不会自己长记性。
你让它调研一次泰国市场,它吭哧吭哧跑完 6 步、交出一份报告,这事就算结了。可下次你让它调研秘鲁,它又从零开始 ------重新想一遍"调研该分几步、先查什么后查什么、上次哪一步踩了坑",一模一样的弯路再走一遍。你做数据十几年,最不能忍的就是这个:同一个坑,掉进去第二次。
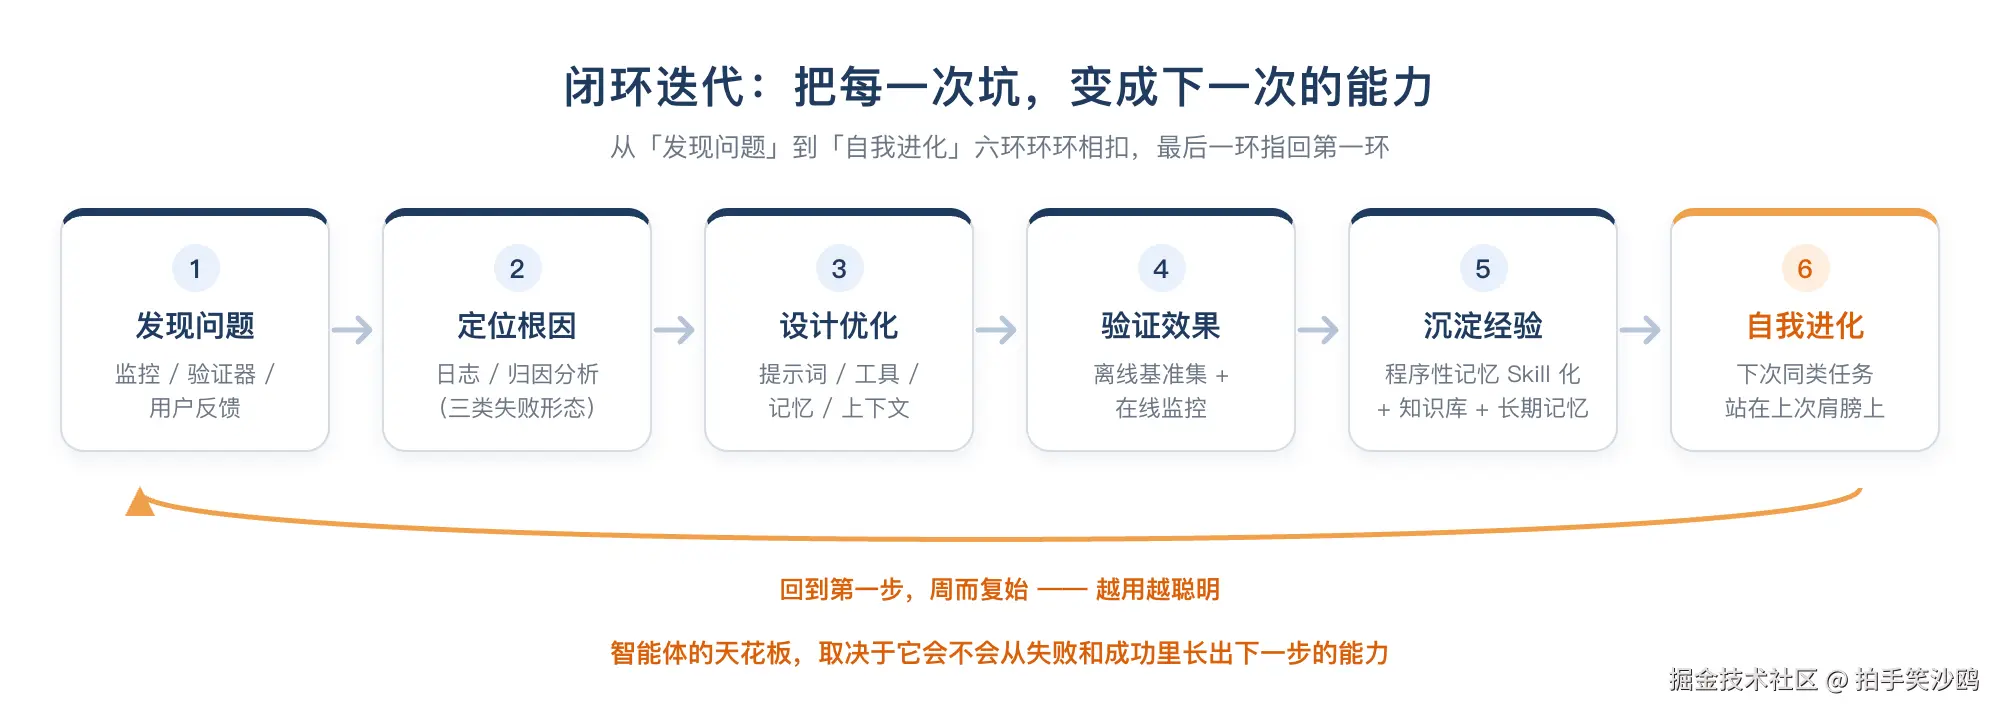
这就是这篇要解决的:闭环迭代。把"发现问题 → 定位根因 → 设计优化 → 验证效果 → 沉淀经验"串成一套能自动转起来的机器,让智能体从"被动的工具"变成"越用越聪明的系统"。
先摆一句定场的话:战术上的勤劳永远不能掩盖战略上的懒惰。 反复手动修 bug、手动帮它擦屁股,是战术勤劳;把"修 bug 的经验"自动沉淀成"下一次的能力",才是战略。这篇讲的,就是这套"战略"怎么落到代码里。
■ 一、数据埋点:让每一次行为都可追溯
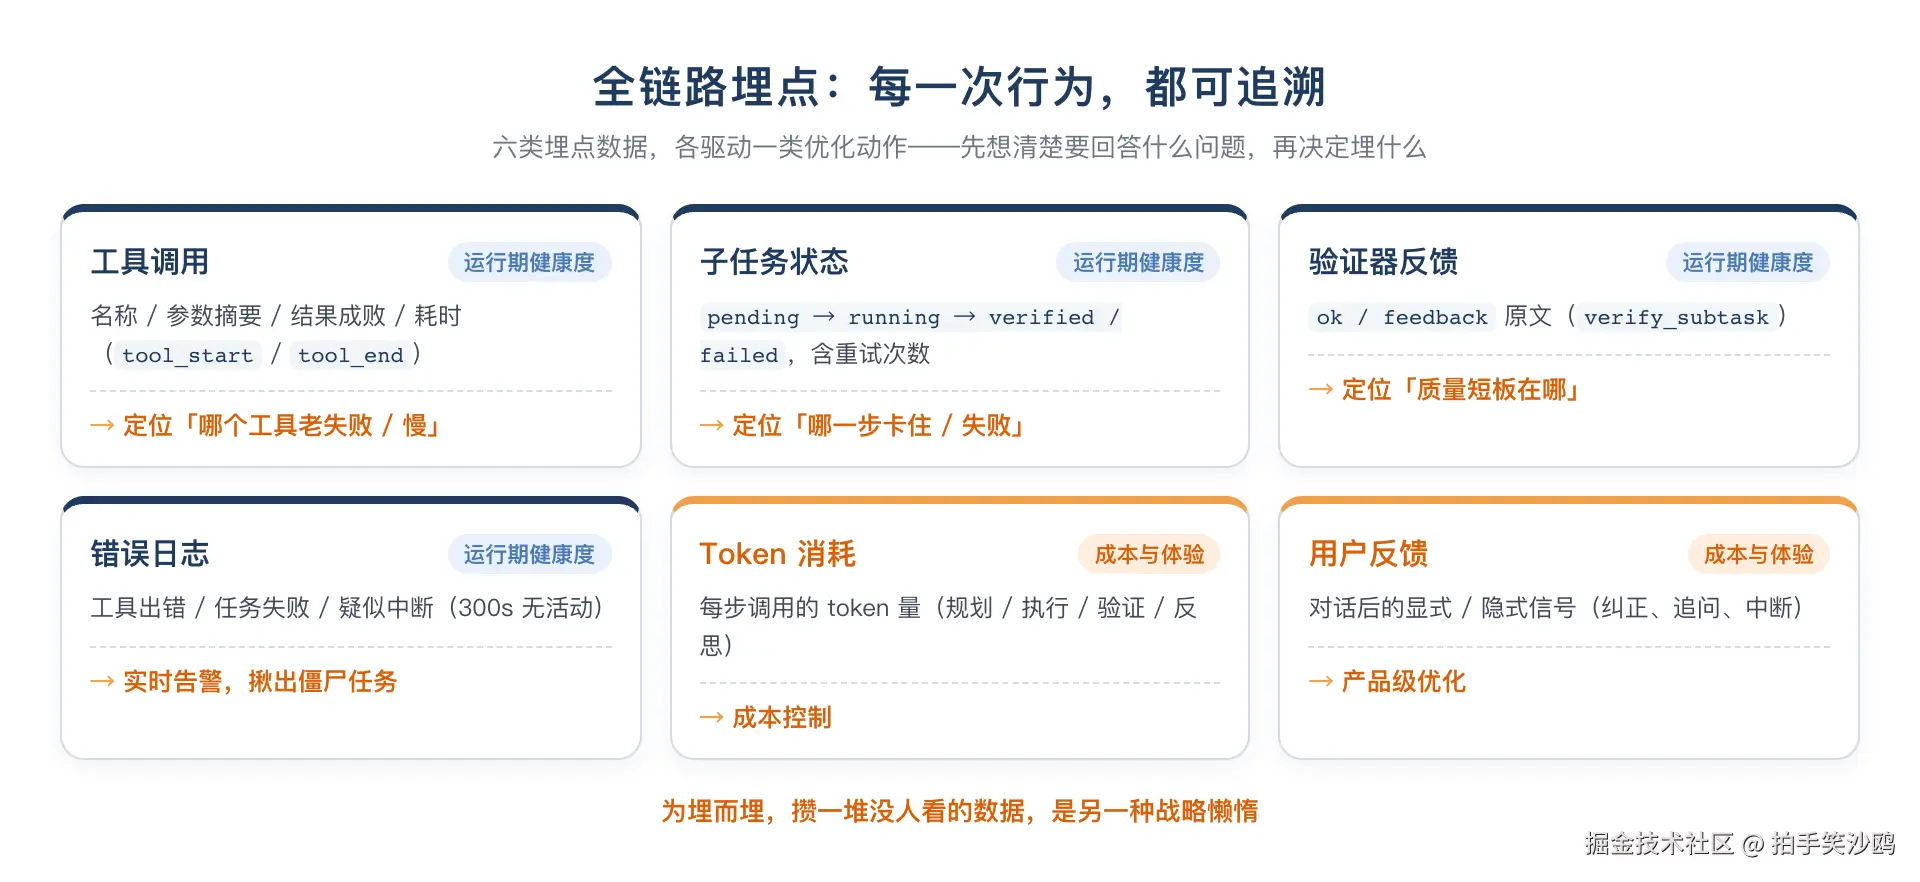
核心观点一句话:没有数据,就没有进化。 智能体运行时要全链路埋点,把每次行为记下来------不是为了记而记,是为了出了问题能定位到"哪一环"。
第 7 篇讲的是"看板长什么样",这篇讲的是"看板的数据怎么用起来"。两者的关系是:看板是仪表盘,埋点是仪表盘背后的传感器。传感器不装好,仪表盘再漂亮也是一堆死指针。
六类关键埋点,各司其职
超体的埋点集中在 app/monitor.py,一个进程内、不落盘的轻量注册表。为什么不落盘?因为埋点数据是"瞬态"的------服务重启后它就该清空,真正需要持久化的是"反思出来的记忆"和"任务的检查点",那两样有各自的落盘机制。埋点只负责"当下这一刻,发生了什么"。
| 埋点数据 | 记录什么 | 驱动哪个优化动作 |
|---|---|---|
| 工具调用 | 名称 / 参数摘要 / 结果成败 / 耗时 | 定位"哪个工具老失败/慢" |
| 子任务状态 | pending → running → verified/failed | 定位"哪一步卡住/失败" |
| 验证器反馈 | ok / feedback 原文 | 定位"质量短板在哪" |
| 错误日志 | 工具出错、任务失败、疑似中断 | 实时告警 |
| Token 消耗 | 每步调用量 | 成本控制 |
| 用户反馈 | 对话后的显式/隐式信号 | 产品级优化 |
一眼能看出关键:前四类是"运行期健康度",后两类是"成本与体验"。很多人埋点只埋了日志(第 5 类),结果出了质量问题是两眼一抹黑------因为日志只告诉你"哪里报错了",不告诉你"哪一步做得不好"。
埋点是怎么在代码里埋进去的
埋点的核心是工具调用的一进一出 。orchestrator.py 里每个工具调用都包了两层:
python
# app/orchestrator.py::_run_subtask ------ 工具执行前后埋点
eid = monitor.tool_start("plan", task_id, name, args)   # 开始:记事件 id
try:
    result = await asyncio.to_thread(run_tool, name, args)
    ok = not (isinstance(result, dict) and "error" in result)
    err = str(result.get("error", "")) if (isinstance(result, dict) and "error" in result) else ""
except Exception as te:
    result_str = json.dumps({"error": f"工具执行异常:{te}"}, ensure_ascii=False)
    ok = False
    err = str(te)
monitor.tool_end(eid, ok, err)                          # 结束:算耗时、记成败
tool_start 返回一个自增的 eid,tool_end 用它关联,算出一对 start/end 的耗时 ,同时把成败写进两个环缓冲:_tool_log(最近 200 条工具事件)和 _tool_stats(按工具聚合的成功/失败/平均耗时)。
这里有个很"数据人"的设计细节------埋点只存参数摘要,不存参数原文:
python
# app/monitor.py::_args_summary ------ 参数压成一行短摘要,避免泄露大段内容
def _args_summary(args):
    ...
    s = str(v)
    if len(s) > 30:
        s = s[:30] + "..."
    ...
return text[:60]为什么?因为工具参数里经常塞着整段网页原文、整篇检索结果。全存进去,监测驾驶舱瞬间被撑爆,还泄露内容。埋点的边界感很重要:你要的是"发生了什么"的元信息,不是"内容本身"。 内容本身属于任务结果,走 plan.json 的检查点落盘。
一个真实告警:任务"疑似中断"
monitor.snapshot() 每次被驾驶舱轮询时,会顺手做一次"僵尸任务清理":
python
# app/monitor.py ------ STALE_SECONDS = 300
# 任务超过 300 秒无任何活动(且无在途工具)→ 判定为中断
stale_ids = []
for tid, t in _active_tasks.items():
    has_inflight = any(ev["source"] == "plan" and ev["context"] == tid
                       for ev in _in_flight.values())
    if not has_inflight and now - t.get("last_activity", t["started_at"]) > STALE_SECONDS:
stale_ids.append(tid)这背后是一个真实踩过的坑:客户端断连会导致 generator 被关闭,但进程里的任务状态还挂着"running"。如果不做这个清理,驾驶舱里会永远躺着一堆"僵尸任务",你还以为是系统卡死了。有了"300 秒无活动即中断"的判定,僵尸任务会被自动揪出来、打上告警。
实操小结(这一节能带走什么): 埋点要做的第一件事,不是写代码,是先想清楚你要回答什么问题。定位工具问题就埋工具成败;定位质量短板就埋验证器反馈;控成本就埋 Token。为埋而埋,攒一堆没人看的数据,是另一种形式的战略懒惰。
■ 二、失败样本回流 + 自动反思:从"失败"里淘金
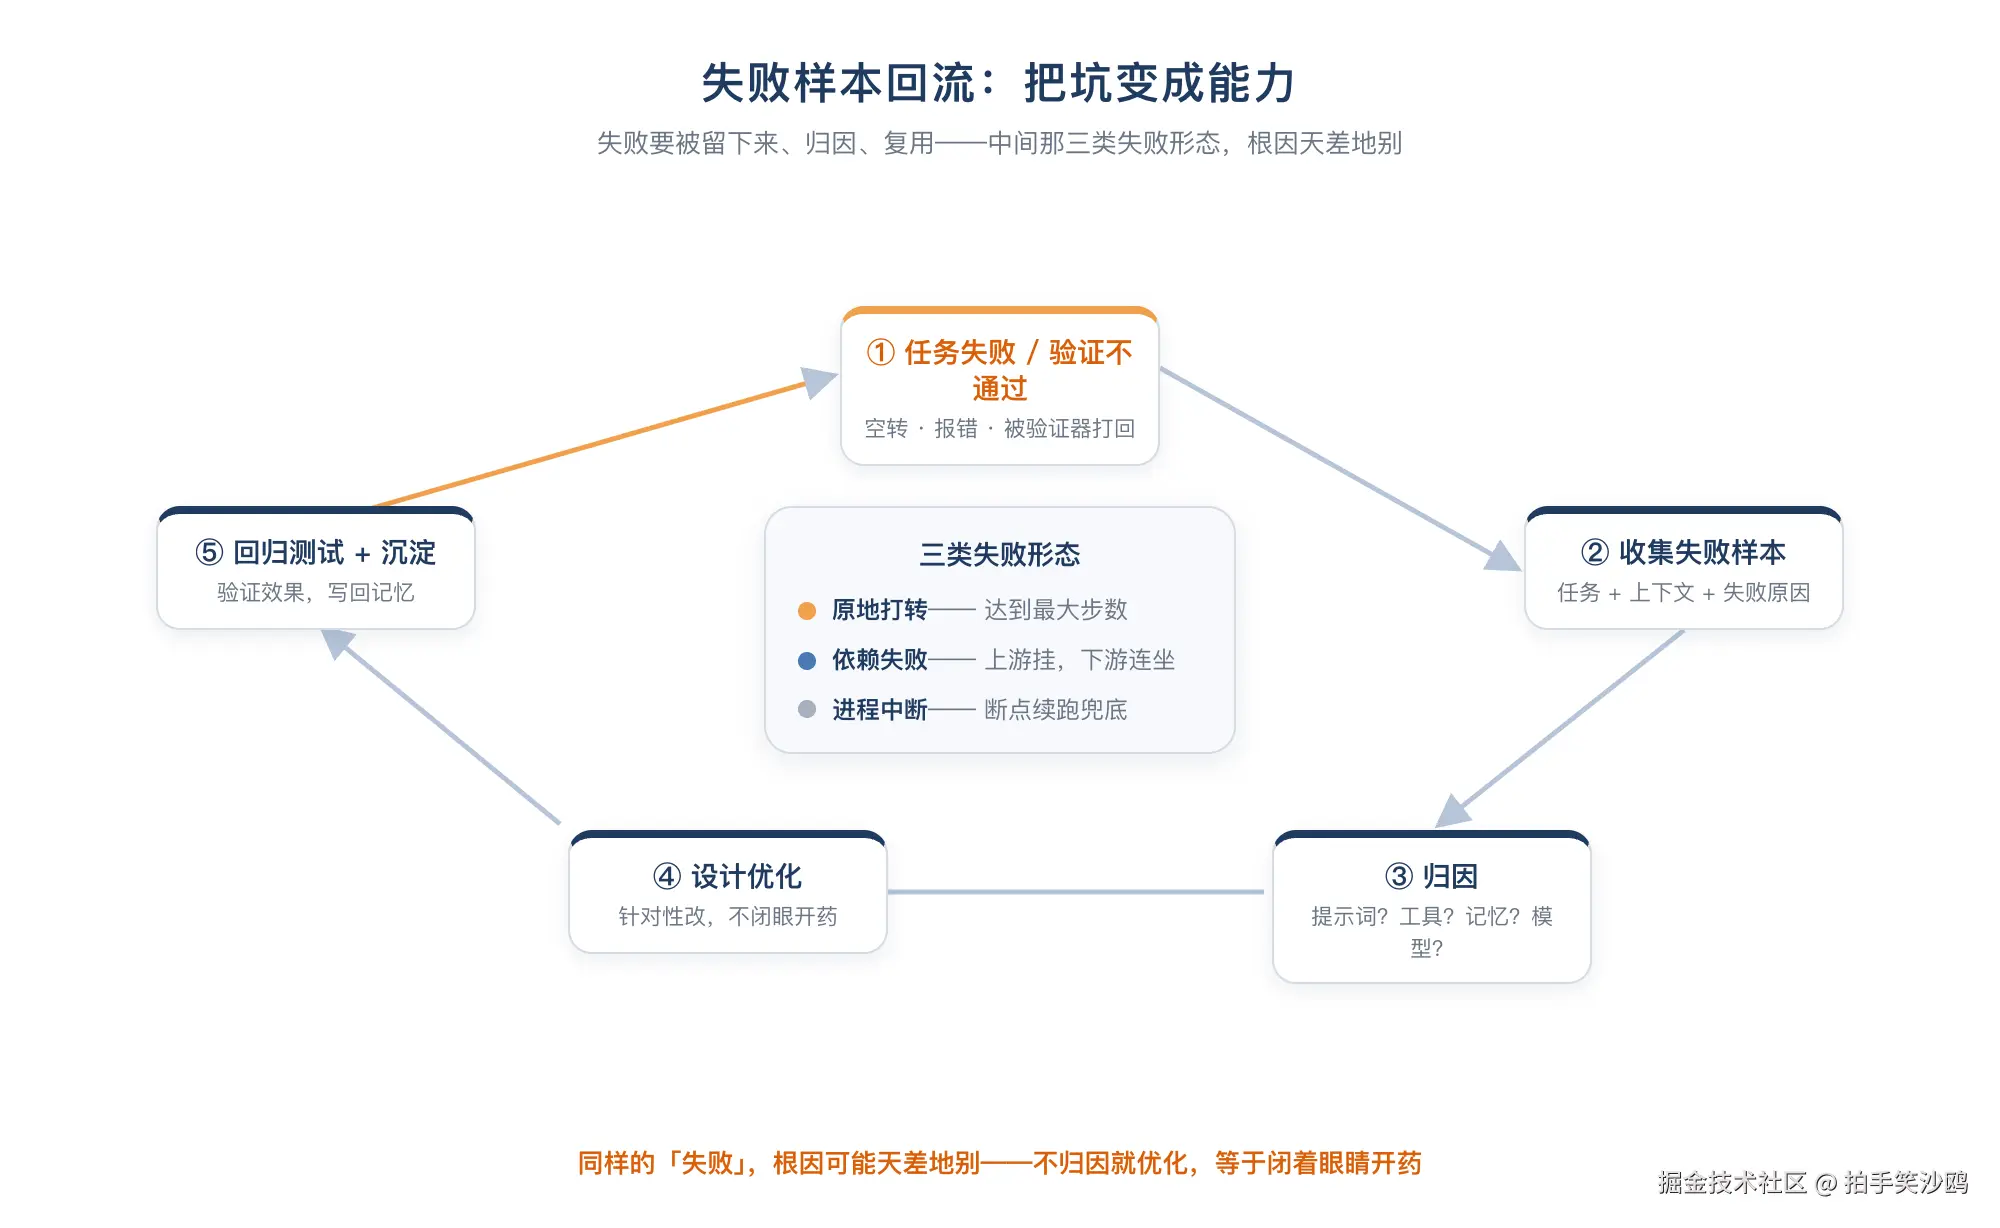
核心观点一句话:失败是最好的老师,但前提是失败能被留下来、被归因、被复用。 反思机制就是那个"把失败变资产"的齿轮。
先用一个真实失败开场
这是超体早期一次真实的翻车现场,比任何成功学都有说服力。任务目标:
调研 2026 年 arXiv 上数据科学在 Agent 领域的最新研究成果,并生成调研报告
规划器把目标拆成了 6 步:①确定检索范围与关键词 → ②从 arXiv 抓取候选论文元数据 → ③筛选与分类论文 → ④提取每篇核心内容 → ⑤总结趋势与热点 → ⑥撰写报告。拆得没毛病,但第一次跑的结果是整体 failed。
看 data/tasks/9dbcfc4f.../plan.json 里的记录,问题一目了然------中间四步的 result_summary 全是同一句话:
sql
s2 | 从arXiv获取候选论文元数据 | result: (达到最大执行步数,未产出明确结论)
s3 | 筛选与分类论文           | result: (达到最大执行步数,未产出明确结论)
s4 | 提取每篇论文的核心内容   | result: (达到最大执行步数,未产出明确结论)
s5 | 总结研究趋势与热点       | result: (达到最大执行步数,未产出明确结论)
s6 | 撰写调研报告             | result: 进程中断,未完成
这是智能体执行中最典型的**"原地打转"**:执行器每步都在调用工具,但调完 20 步(MAX_STEPS)也没产出结论,最后进程还中断了。它不是在偷懒,是在空转。
归因:失败分几种,各是什么病
失败样本回流的前提是能把失败归对因,否则"从失败里学"就是一句空话。超体的失败就三种形态,对应三种完全不同的病根:
| 失败形态 | 典型症状 | 根因 | 对症的优化 |
|---|---|---|---|
| 原地打转 | (达到最大执行步数,未产出明确结论) |
工具没返回有效结果 / 目标太发散 | 收紧 objective、换工具、加步数 |
| 依赖失败 | 依赖的前置步骤失败 |
上游步骤挂了,下游被连坐 | 修上游,别让下游白跑 |
| 进程中断 | 进程中断,未完成 |
服务重启 / 客户端断连 | 检查点落盘,断点续跑 |
这里藏着闭环迭代的一个关键洞察:同样的"失败",根因可能天差地别。 不归因就优化,等于闭着眼睛开药。上面那次 arXiv 翻车,根因是第 1 种------执行器空转,所以后来给 verifier.py 加了一道守卫:
python
# app/verifier.py::verify_subtask ------ 兜底守卫:空转结果直接判不通过
if not result_text or not result_text.strip() \
        or result_text.strip() == "(达到最大执行步数,未产出明确结论)":
return {"ok": False, "feedback": "执行器未产出有效结论,请重新执行并给出明确结果"}这道守卫的意义在于:执行器可以空转,但验证器不能让它蒙混过关。 空转结果会被判 ok=false,触发重试(MAX_RETRIES=2),而不是被当成"做完了"写进任务记录。
从"失败"到"成功":闭环的威力
有意思的是,同一个目标,26 分钟后再跑了一次(data/tasks/1001c5096a.../plan.json),结果是 done。更值得说的是第二次跑的过程------每一步都在"查账",把第一次埋的雷一颗颗排掉了:
- s3 发现 :"s2 声称生成的论文数据文件(
data/arxiv_2026/)实际不存在,我通过 arXiv API 重新抓取......共获取 249 篇"; - s4 发现:"s3 声称筛选出 159 篇并生成了分类清单,但清单文件并未实际保存到磁盘";
- s5 发现:"s4 笔记的完整内容未持久化落盘"。
这就是为什么"可验证的 objective + 落盘检查点"不是锦上添花,而是刚需 。执行器有个天生的毛病------自我确认偏差:它"觉得自己做了",于是"声称自己做了",但它可能根本没落盘。独立验证器 + 检查点,就是那个逼它"拿出证据"的机制。
人味/决策 :失败样本回流真正的价值,不是"记录了这次失败",而是让下一次不用重新失败一次。但反思也有陷阱------抽得太碎会污染记忆库,所以要有置信度和去重合并兜底。下一节会展开。
自动反思:把失败之外的"事实/偏好/关系"也沉淀下来
失败样本只覆盖了"任务"这一条线,超体还有一条更日常的反思线------对话结束后的自动提炼 。入口在 context.py 的 _safe_reflect,它把整段对话丢给 long_term_memory.reflect:
python
# app/context.py::_safe_reflect ------ 后台反思,任何异常都不影响主流程
def _safe_reflect(session_id, messages):
    try:
        result = ltm.reflect(session_id, messages)
        if result.get("reflected"):
            logger.info("[memory] 反思完成 session=%s %s", session_id, result)
    except Exception as e:
        logger.warning("[memory] 反思失败 session=%s: %s", session_id, e)
注意两个细节:第一,它叫 _safe_reflect,因为反思绝不允许阻塞主流程 ------对话体验优先,反思是"顺手做"的后台任务;第二,反思是增量 的------reflect 内部用 meta 表记录 reflected_count,只处理"上次反思之后新增"的消息,而不是每次都把整段历史重新提炼一遍:
python
# app/storage/long_term_memory.py::reflect ------ 增量反思
key = f"reflected_count:{session_id}"
done = int(_meta_get(key, "0"))     # 上次反思到第几条
...
new_msgs = dialogue[start:] # 只取新增的部分反思的产物是四类东西:事实(fact)、偏好(preference)、关系(relationship)、思维习惯(thinking) ,外加一个 corrections(纠正) ------当用户明确纠正此前说错的信息("不对,我现在在......""我早就离职了"),反思器会把它单独拎出来,把旧记忆标记为 superseded、写入正确版本。
人味/决策 :反思的价值在于让智能体"不是每次从零开始" 。但反思也有陷阱------抽得太碎会污染记忆库,所以每类记忆都要过置信度门槛(
REFLECT_MIN_CHARS=80、只保留confidence >= 0.6),并且写入时做去重合并。记忆是长出来的,不是灌进去的。
■ 三、程序性记忆 Skill 化:不只记"结论",还记"怎么干"
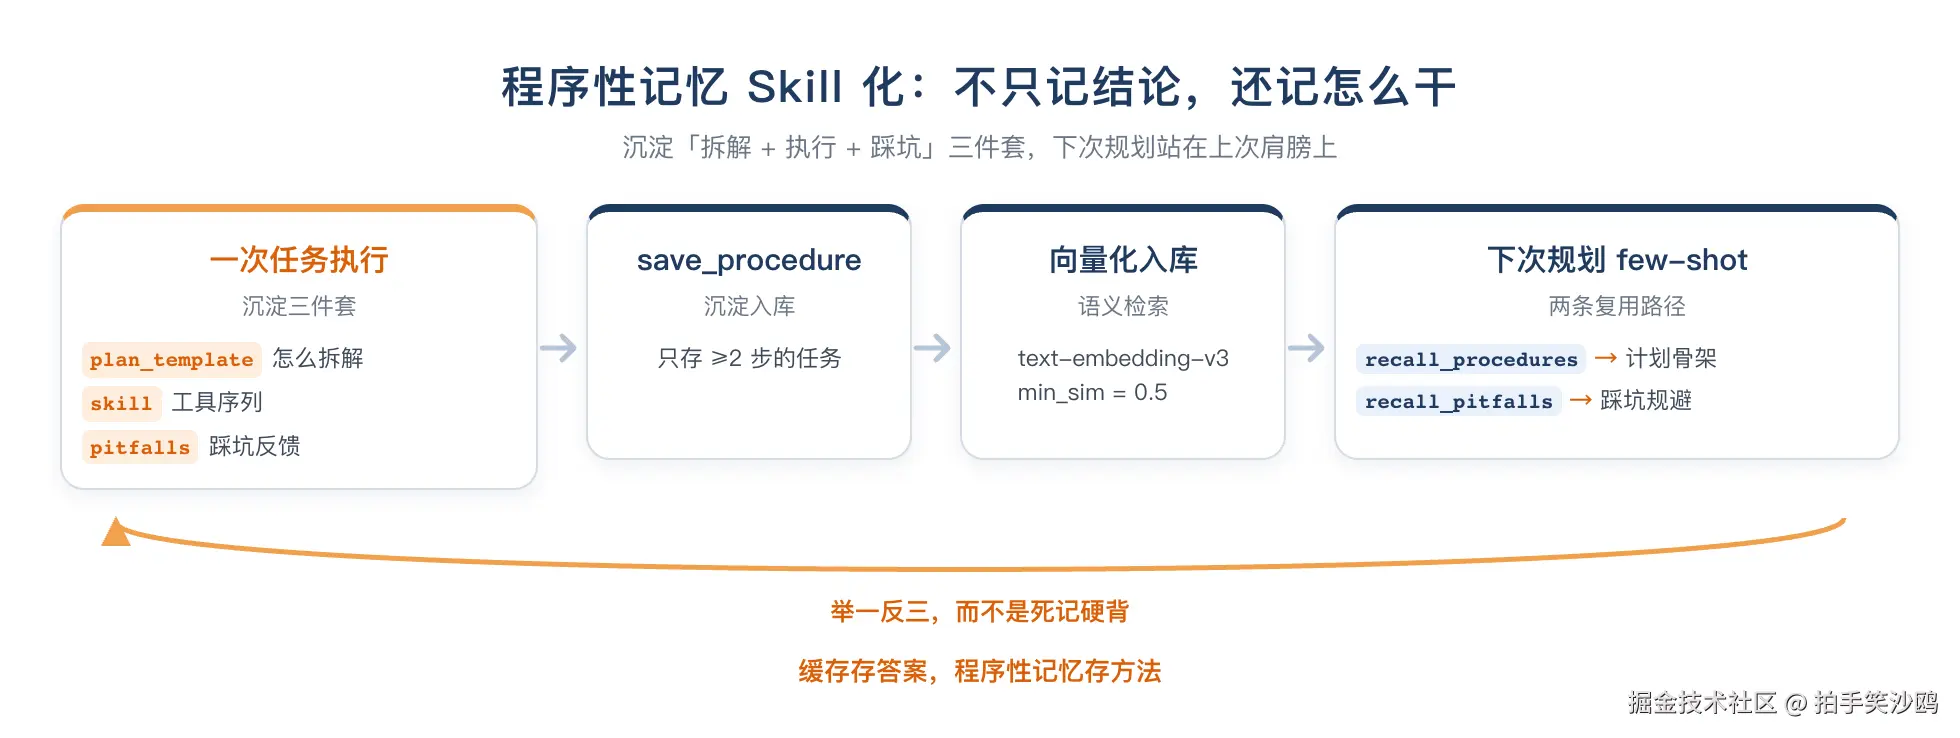
核心观点一句话:这是闭环迭代最硬核的一环。 普通记忆只记"这次成功了还是失败了",程序性记忆(procedure)要沉淀三样东西------怎么拆解(plan_template)、怎么执行(skill 工具序列)、踩过什么坑(pitfalls)------下次直接当 few-shot 喂给规划器。
三件套:拆解、执行、踩坑
沉淀发生在每个 plan 任务结束的那一刻。orchestrator.py 的 run_plan 末尾会调用 ltm.save_procedure,把整次任务的结构化经验压进一条记忆:
python
# app/orchestrator.py::run_plan ------ 任务结束,沉淀程序性记忆(取消的不沉淀)
if not cancelled:
    outcome = "success" if plan["status"] == task_store.PLAN_DONE else "failed"
    ltm.save_procedure(plan["goal"], plan["subtasks"], outcome,
                       task_id=plan["task_id"], source="plan")
save_procedure 内部把子任务拆成三样东西(见 app/storage/long_term_memory.py::save_procedure):
plan_template:计划骨架------每个子任务的title+objective,回答"这类任务该怎么拆";skill:执行轨迹------每步实际调用的工具序列 + 参数模板(由orchestrator写入st["tools"]),回答"拆完每一步具体怎么干";pitfalls:踩坑库------失败步骤的验证反馈(由orchestrator写入st["feedback"]),回答"这条路上哪里有坑"。
注意两个设计细节:
第一,只记"有拆解价值"的任务 。save_procedure 第一行就是 if not goal or len(subtasks) < 2: return None------单步的平凡任务(比如"算 1 到 5 的累加")不沉淀,否则记忆库里全是垃圾。
第二,成失败分开存、分开用 。confidence = 0.9 if outcome == "success" else 0.5,成功的高置信、失败的降置信,检索时用 outcome 参数区分。
复用路径:规划时"站在上次肩膀上"
沉淀不是目的,复用才是。web_app.py 的 /api/plan 在规划前会先检索历史程序性记忆,喂给 planner.plan_goal:
python
# app/planner.py::plan_goal ------ 把程序性记忆作为 few-shot 注入规划器
async def plan_goal(goal, persona_text="", plan_template="",
                    memory_text="", pitfall_text=""):
    ...
    if plan_template:
        user += f"\n\n【参考】此前同类任务的计划骨架与执行轨迹...\n{plan_template}"
    if pitfall_text:
        user += f"\n\n【规避】此前同类任务踩过的坑...\n{pitfall_text}"
两条注入路径分工明确:
recall_procedures(query)→plan_template:给规划器一个"照抄起点",让它不用从零想拆解;recall_pitfalls(query)→pitfall_text:只取outcome="failed"的历史坑,让规划器主动规避。
检索本身复用 text-embedding-v3 的向量余弦(与知识库 RAG 同源),min_sim=0.5 兜底过滤,向量化失败时降级为"去停用词字符重叠":
python
# app/storage/long_term_memory.py::search_procedures ------ 语义检索 + 降级兜底
def search_procedures(query, top_k=3, min_sim=0.5, outcome=None):
    ...
    qvec = _embed_or_none(query)          # 优先向量
    if qvec is not None:
        ...                               # 余弦相似度,< min_sim 过滤
        return out
    # 降级:字符重叠(去停用词 + 阈值)
    ...
一个真实案例:同一套骨架,被复用了五遍
看 data/tasks/ 里的一组任务,你会看到一个特别漂亮的"程序性记忆复用"现场。用户先后让它调研了泰国、南美、秘鲁、瑞士 (还有一次针对"中国平台重点发展泰国"的复跑),五次任务,规划器拆出来的骨架几乎一模一样:
s1 制定调研框架与报告大纲
s2 收集 {地区} 跨境电商基础数据
s3 分析市场潜力与机会点
s4 分析进入卡点
s5 分析风险因素及应对建议
s6 撰写并输出最终调研报告第一次跑泰国时,规划器是从零拆的;跑南美、秘鲁、瑞士时,recall_procedures 已经把"调研报告 = 大纲→数据→潜力→卡点→风险→报告"这套骨架当成 few-shot 喂了进去,规划器只需把"泰国"替换成"秘鲁"。这就是程序性记忆的核心价值:它把"经验"从人脑里的主观感受,变成了可检索、可复用、可量化的结构化资产。
人味/决策:这也是"记忆自我进化"和普通"缓存结果"最本质的区别。缓存只是把上次的答案存下来,下次照着抄;程序性记忆存的是**"怎么拆、怎么干、坑在哪"的方法**,下次是"照着上次的思路,解决一个新问题"。前者是死记硬背,后者是举一反三。
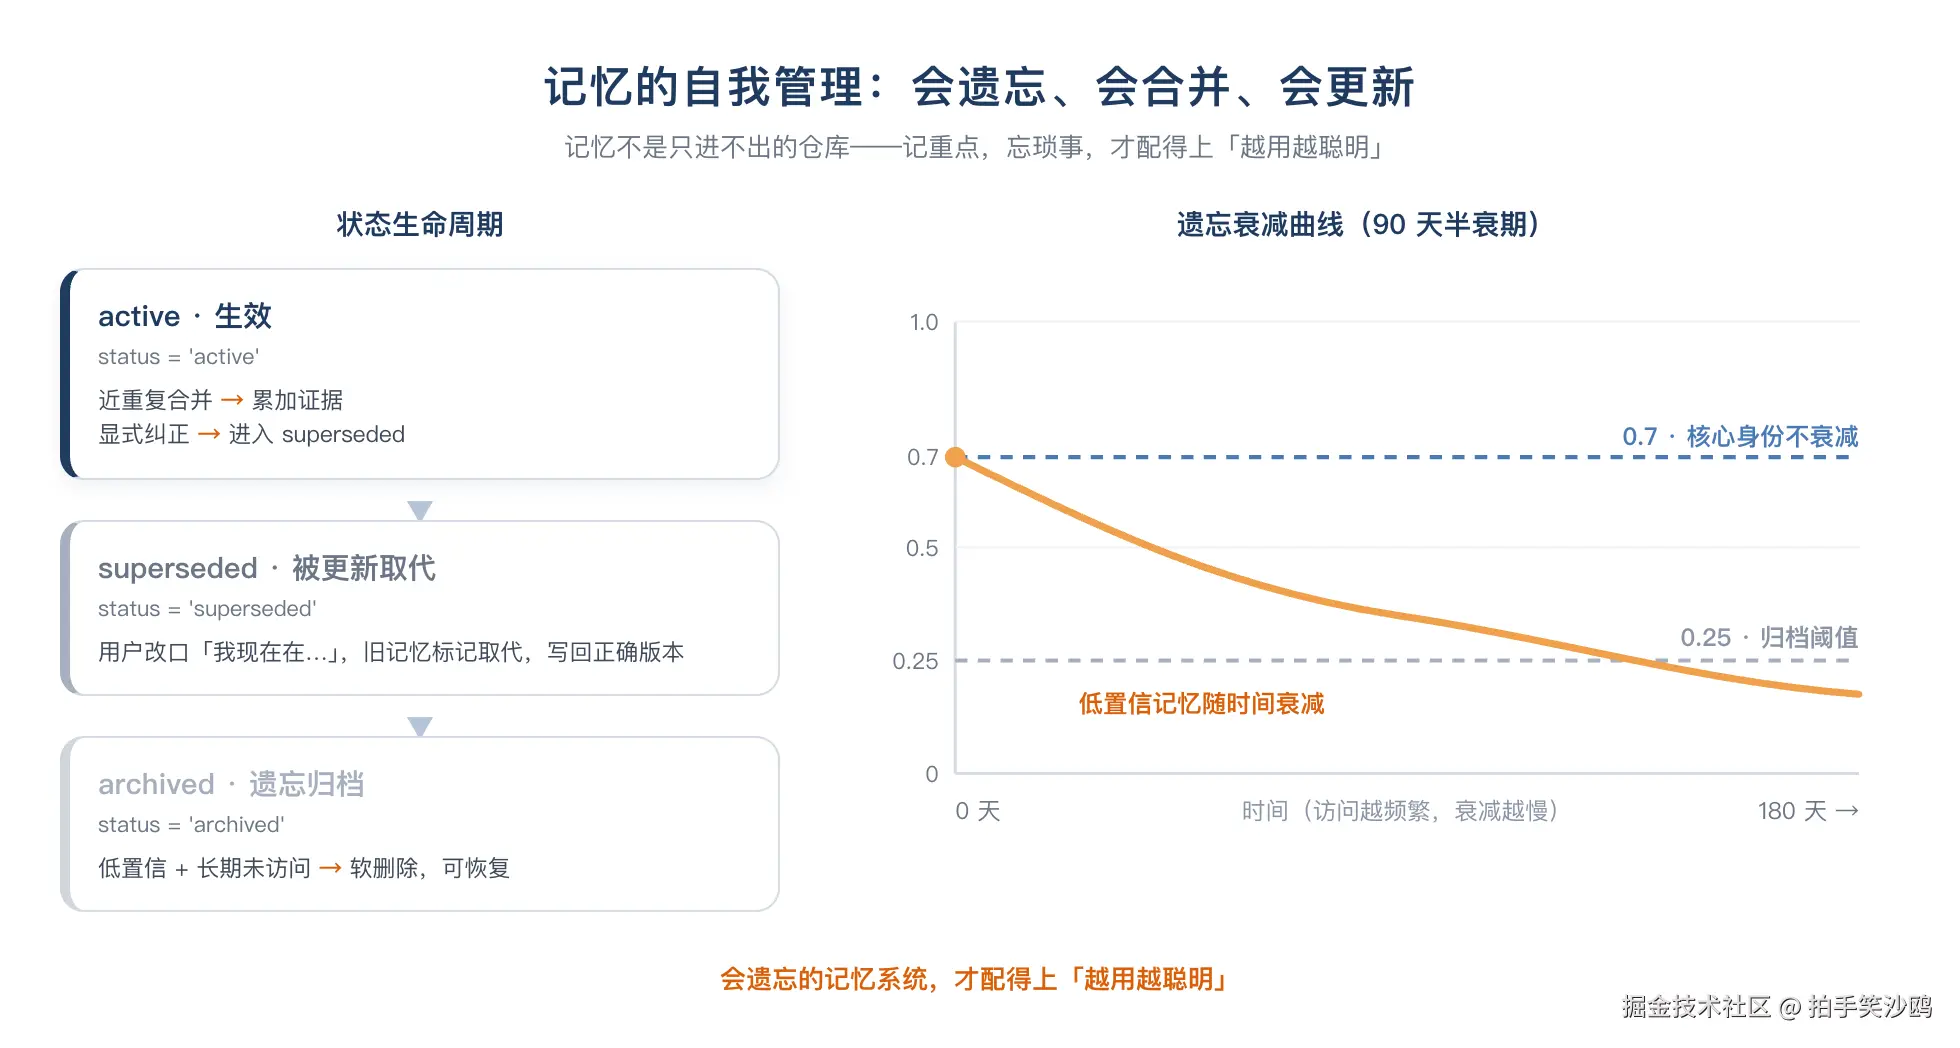
■ 四、记忆的自我管理:会遗忘、会合并、会更新
核心观点一句话:记忆不是只进不出的仓库,只会堆、不会理的记忆,越用越乱。 所以超体的长期记忆有三件"减法和更新"的功课:近重复合并、遗忘衰减、状态迁移。
近重复合并:同义改写,累加证据而非新增
同一个意思,用户今天说"我喜欢数据驱动",明天说"我倾向用数据说话",后天又说"做决策得看数据"。如果每次反思都当成新记忆插一条,三个月后记忆库里躺着 20 条同义近义的东西,注入上下文时全是噪声。
超体的解法是 add_memory 里做了两级去重。第一级精确去重 (规范化后字符串相等),第二级语义近重复合并 (NEAR_DUP_SIM = 0.97,余弦相似度超过 0.97 视为同一条):
python
# app/storage/long_term_memory.py::add_memory ------ 近重复合并
# 2) 语义近重复合并(同义改写,避免记忆膨胀)
if "embedding" in extra and kind != "procedure":
    for r in rows:
        r_emb = _parse_extra(r).get("embedding")
        if r_emb and _cosine_sim(extra["embedding"], r_emb) >= NEAR_DUP_SIM:
            conn.execute(
                "UPDATE memories SET confidence=MAX(confidence,?), updated_at=?, "
                "access_count=access_count+1 WHERE id=?", ...)
            return r["id"]   # 合并,不新增
注意那个 access_count=access_count+1 和 confidence=MAX(...):同义记忆不新增一条,而是给旧记忆"加证据"------置信度取高值、访问次数累加。记忆是靠"证据累加"长结实的,不是靠"条数堆"。
遗忘衰减:核心身份不衰减,琐事慢慢归档
人脑之所以高效,很大程度靠"记重点 + 忘琐事"。智能体的记忆系统也得学会这套,否则越用越臃肿。超体用 apply_decay 做时间衰减:
python
# app/storage/long_term_memory.py::apply_decay ------ 时间衰减
DECAY_PROTECT_ABOVE = 0.7   # 核心身份(confidence >= 0.7)不衰减
DECAY_ARCHIVE_BELOW = 0.25  # 衰减到 0.25 以下归档

for r in rows:
    if r["confidence"] >= protect_above:
        continue                      # 核心身份记忆不衰减
    age = max(0.0, now - r["updated_at"])
    factor = 0.5 ** (age / half_life)            # 90 天半衰期
    factor = min(1.0, factor + min(r["access_count"], 10) * 0.02)  # 被访问过衰减更慢
    new_conf = round(r["confidence"] * factor, 4)
    ...
    new_status = STATUS_ARCHIVED if (new_conf < archive_below and r["access_count"] < 2) \
        else STATUS_ACTIVE
三个关键参数,每个都是一次取舍:
DECAY_PROTECT_ABOVE = 0.7:核心身份不衰减。因为"用户在哪工作、毕业于哪"这类高置信事实是数字分身的底子,不能被时间磨掉;DECAY_ARCHIVE_BELOW = 0.25:低置信 + 长期未访问的记忆归档。归档是软删除,可被恢复,不是物理删除;- 访问次数抵消衰减 :
factor + min(access_count, 10) * 0.02------被频繁访问的记忆衰减更慢,这是"用进废退"的直觉。
状态迁移:每条记忆都有明确生命周期
记忆的三种状态构成一个清晰的单向生命周期:
active(生效) → superseded(被更新版本取代) → archived(遗忘归档)superseded 和 archived 是两个不同的"消失":前者是"被纠正/更新取代了",后者是"时间到了自然遗忘"。区分它们很重要,因为纠正过的错误记忆不该被遗忘机制再翻出来。
状态的写入和读取都收敛在 set_memory_status 和 get_memories(status=...)。有个真实场景最能说明 superseded 的价值------用户纠正自己的记忆时:
python
# app/storage/long_term_memory.py::correct_memory ------ 显式纠正
def correct_memory(match, replacement, kind=None, confidence=0.9, source=None):
    ...  # 找到与 match 最相似的生效记忆
    conn.execute("UPDATE memories SET status=? WHERE id=?",
                 (STATUS_SUPERSEDED, best_id))     # 旧记忆标 superseded
    add_memory(kind or "fact", replacement, ...)   # 写入正确版本
当反思器捕捉到用户说"不对,我现在在......""我早就从......离职了"这类纠正,就会走这条路:旧记忆标 superseded,新记忆落 active。记忆系统要能"改口",否则一个早期错误会污染后续所有回答。
记忆注入:核心常驻 + 按需召回
记忆管理做得好,还得"喂"得好。build_injection 的注入策略是**"核心身份常驻 + 按当前 query 语义召回"**,而不是全量塞:
python
# app/storage/long_term_memory.py::build_injection
def build_injection(query=None, max_core=4, max_relevant=8):
    merged = _core_memories(max_core) + \
             (search_memories(query, top_k=max_relevant) if (query and query.strip()) else [])
    ...
高置信高频的核心身份(最多 4 条)常驻,与当前问题语义相关的(最多 8 条)按 query 召回,去重合并。不是全量灌------全量灌会把上下文撑爆,还稀释了重点。
人味/决策 :遗忘是智能体的"减法能力"。很多人一上来就追求"记更多",但记更多的边际收益是递减的,噪声的边际成本却是递增的。真正让记忆系统好用起来的,是"敢忘"------把低价值的琐事归档,把高频的核心身份供起来。
■ 五、多智能体协作:生成 → 批判 → 精修 → 主编排
核心观点一句话:复杂任务,单个智能体容易"一条道走到黑";多智能体协作用分工提升产出质量------但不是"越多越好",简单任务硬上多智能体就是过度设计。
四个角色,一条流水线
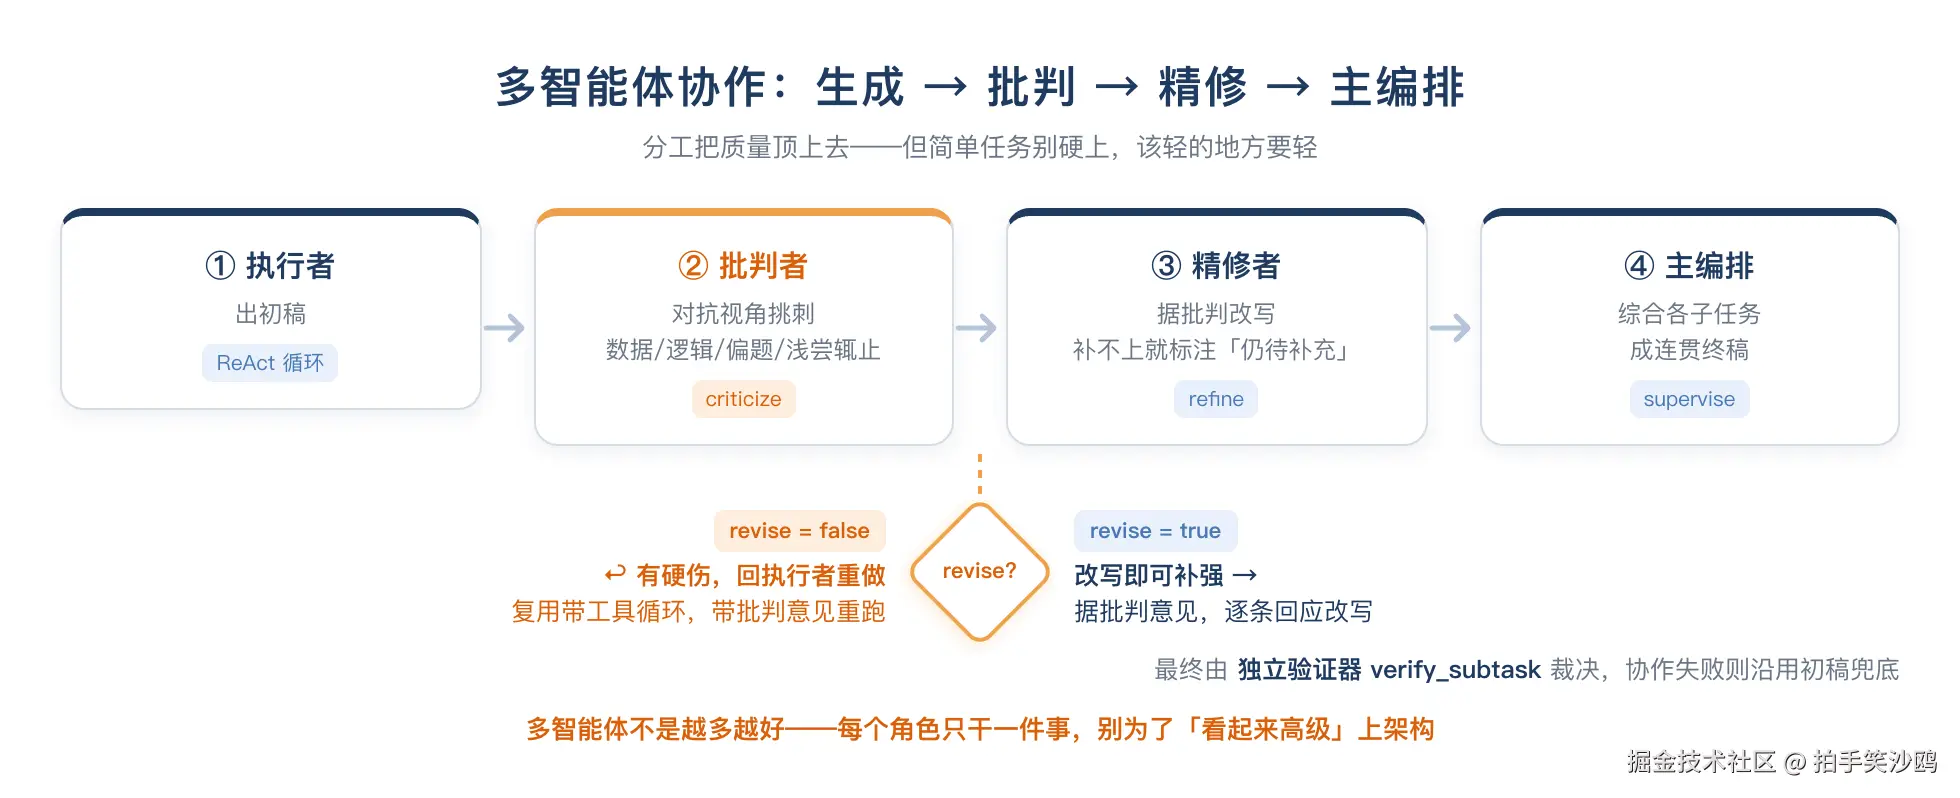
超体的多智能体协作集中在 app/collab.py,四个角色依次接力:
执行者(出初稿)→ 批判者(criticize,对抗视角挑刺)→ 精修者(refine,据批判改写)→ 主编排(supervise,综合成终稿)批判者是这套机制的灵魂。它的系统提示词第一句就定调了"对抗视角":
python
# app/collab.py::CRITIC_SYSTEM ------ 批判者,只挑刺不表扬
挑刺重点(按优先级):
- 是否偏离了 objective / 总目标;
- 关键数据、事实、数字是否缺失或存疑(有没有编造/臆断);
- 逻辑链是否成立、结论是否被证据支撑;
- 是否浅尝辄止、只给了表面结论。

revise=true 表示「改写即可补强」;revise=false 表示「初稿有硬伤,需重新执行」。
不要为了挑而挑,也不要表扬,只列真实、可执行的问题。批判者输出的不是一个模糊的"写得好不好",而是一个结构化的判断 :{"issues": [...], "revise": bool}。revise 这个布尔值是关键分叉------它决定了下一步是"小修"还是"重做":
python
# app/orchestrator.py::_collaborate ------ 批判后的分叉
crit = await collab.criticize(goal, subtask, draft)
current = draft
if not crit["revise"]:                    # revise=false:有硬伤,需重新执行
    current = await _loop(feedback=critique_text)   # 复用执行器的带工具循环重跑
refined = await collab.refine(goal, subtask, current, critique_text) # 据批判改写这里的分工特别讲究:批判者只负责"挑",不负责"改";精修者只负责"改",不负责"验证";验证器最终裁决。 一个角色干一件事,每个角色都能把上下文压到最精,不互相干扰。这就是多智能体的本质------不是把一个大脑换成多个大脑,而是把"思考"拆成多个可独立校验的阶段。
一个真实案例:批判让"编造"现形
看 data/tasks/b2b9e748.../plan.json("Chrome 扩展被动收入调研")里,每个子任务的终稿开头都带着这样一句话:
markdown
> 说明:本终稿逐条回应批判意见。凡本次无法核验或缺少权威来源的,明确标注「仍待补充」,不做硬编。这就是批判者起作用的证据。这篇调研里,执行者初稿给出了不少"精确到小数点"的行业数字,批判者一查,发现很多数字无法核验、口径不清 ,于是打回。精修者最终把无法核实的数字一律降级为定性判断,或标注「仍待补充」------比如:
diff
- 对个人开发者而言,没有真正"躺赚"的扩展变现模式。
- 凡涉及官方口径的数据,均标注来源类型;无法核验者显式标「估算」。
这是多智能体协作最值钱的地方:它逼着智能体从"自信地编"变成"诚实地标注不确定"。 单个执行器很容易"一条道走到黑",把臆断当成事实写进报告;加一个对抗视角的批判者,就能把"编造"抓出来。
该重的地方重,该轻的地方轻
多智能体不是银弹,它是有成本的------每多一个角色,就多一次模型调用、多一份延迟。所以超体把它做成了一个开关 (collaborate 参数),默认关,只有复杂任务才开:
| 维度 | 单智能体 | 多智能体协作 |
|---|---|---|
| 质量 | 依赖单次生成 | 多轮对抗,更严谨 |
| 成本 | 1 次调用/步 | 3~4 次调用/步 |
| 延迟 | 低 | 高(串行接力) |
| 适用 | 简单任务、单步决策 | 报告/文章/调研等复杂产出 |
orchestrator.py 里 _run_subtask 的 collaborate 参数控制这一整条流水线,而且协作失败时优雅降级------批判者或精修者崩了,就沿用初稿,绝不让协作成为单点故障:
python
# app/orchestrator.py::_run_subtask ------ 协作失败,沿用初稿
if collaborate:
    try:
        final_text = await _collaborate(final_text)
    except Exception as e:
        print(f"[collab] 协作失败,沿用初稿: {e}")
人味/决策 :核心心法一句------不是"越多越好" 。简单任务单智能体就够了,复杂任务(报告/文章)才上多智能体。该重的地方重,该轻的地方轻,别为了"看起来高级"上架构。 这个"开关式"的设计,就是把选择权交给调用方,而不是把多智能体焊死在主链路上。
■ 六、从单智能体到智能体矩阵:各司其职、协同编排
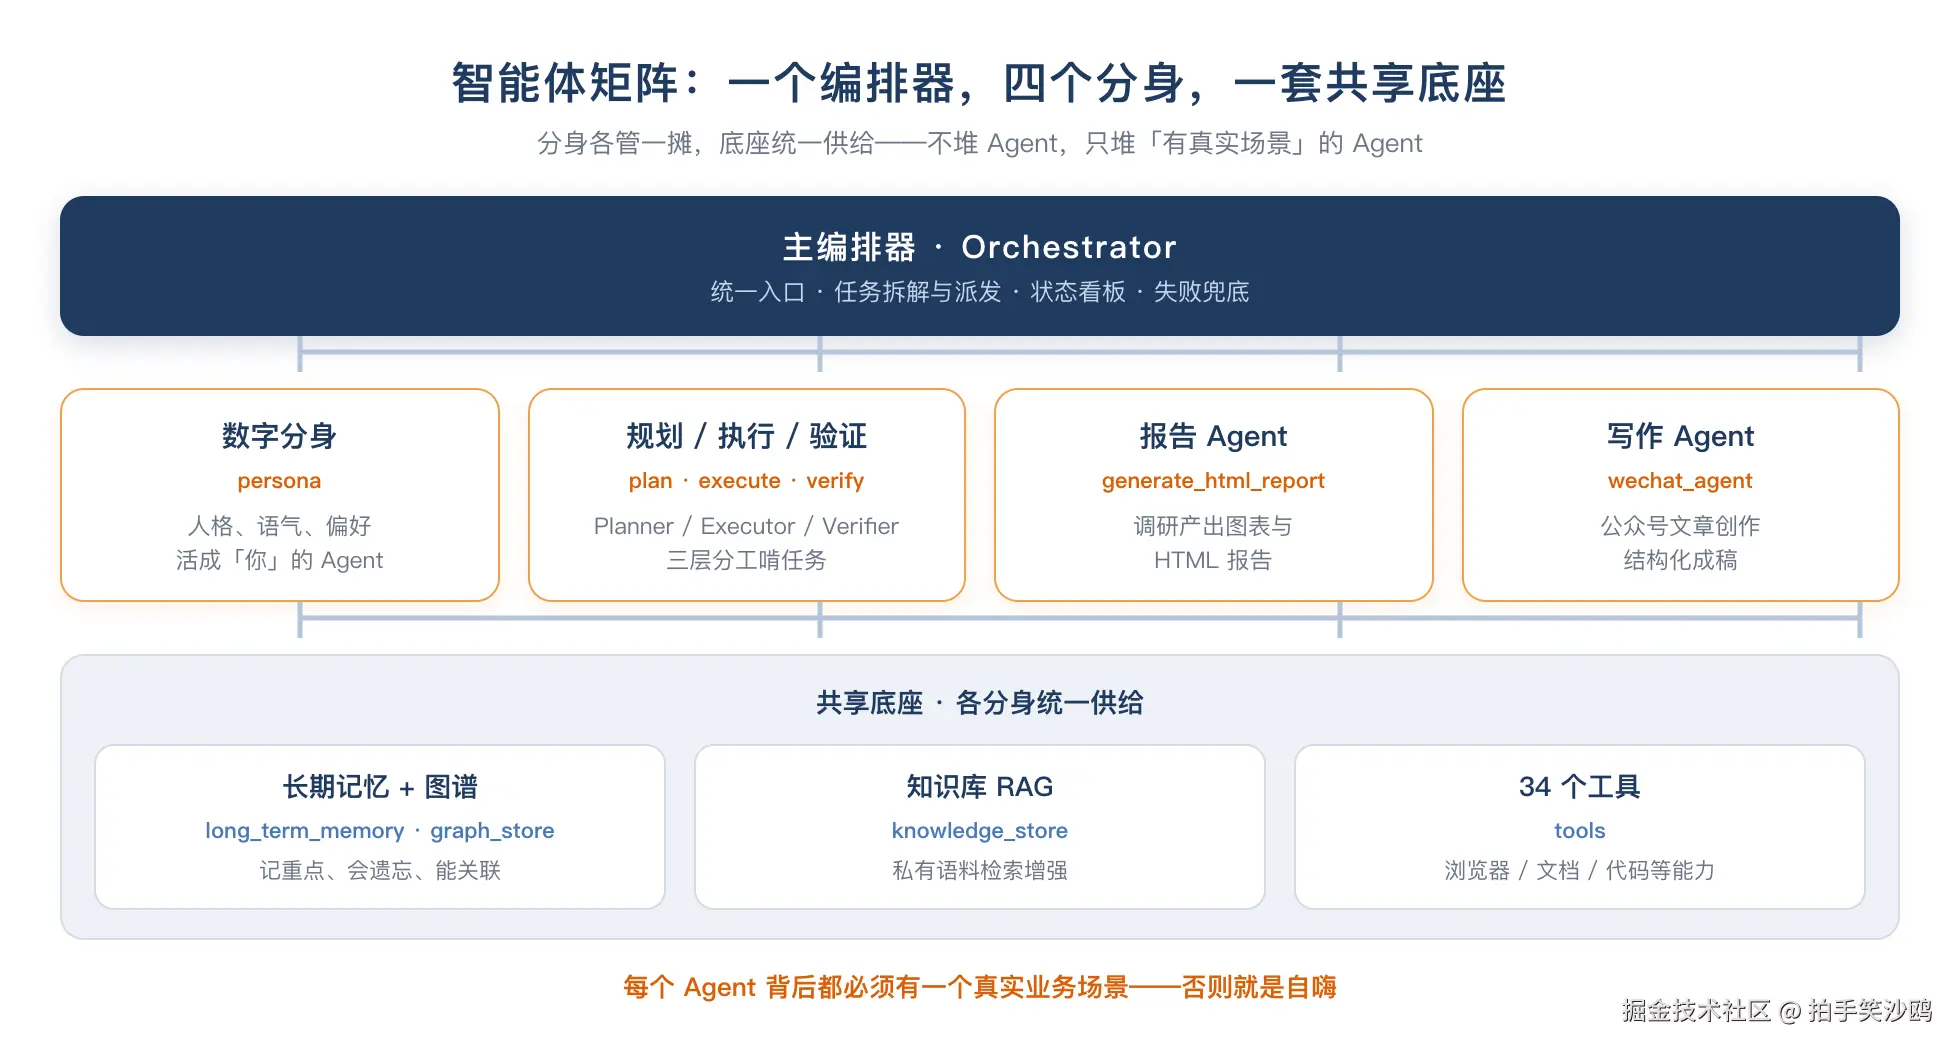
核心观点一句话:当多个智能体各司其职,就形成了智能体矩阵------每个 Agent 专注一个领域,主编排统一调度。
超体已经长出的几个"分身"
矩阵不是设计出来的,是按需长出来的。超体从"一个聊天助手"一路长过来,现在已经有了好几个各司其职的分身:
| Agent | 模式 | 专注领域 |
|---|---|---|
| 数字分身 | persona | 带着用户的经历、决策原则、说话方式回答 |
| 规划/执行/验证 | plan | 长任务编排:拆解 → 调度 → 校验 |
| 报告 Agent | generate_html_report |
调研 → 结构化报告(HTML 承载) |
| 写作 Agent | wechat_agent/ |
选题 → 写作 → 发布(下一篇专门讲) |
它们的底座是共享的 :同一个 orchestrator 调度、同一套 long_term_memory + graph_store 记忆、同一个 knowledge_store 知识库、同一套 tools 工具。分身是"能力切面",底座是"公共基础设施"。 这就像一家公司,每个部门各管一摊,但都共用一个 ERP、一个财务、一个 HR。
矩阵的四个价值
矩阵不是"堆 Agent 数量",它带来四个实打实的能力:
- 专业化:每个 Agent 只精一环,上下文和提示词都能为这一环极致优化;
- 可扩展:新增一种能力 = 新增一个 Agent,不用改主链路;
- 可观测:每个 Agent 的输入输出都能被追踪、被验证;
- 可编排 :主编排器(
orchestrator)统一调度,任务在 Agent 之间流转。
人味/决策 :智能体矩阵最容易犯的错,是为了"架构完整"硬造一堆 Agent 。超体的原则相反------每个 Agent 背后都必须有一个真实业务场景。数字分身对应"成为用户"的场景,规划模式对应"长任务"的场景,报告 Agent 对应"调研产出"的场景。没有场景的 Agent,是 PPT 里的装饰品,不是代码里的模块。
迭代闭环总结
把前面串成一张总图------这就是超体"越用越聪明"的完整闭环:
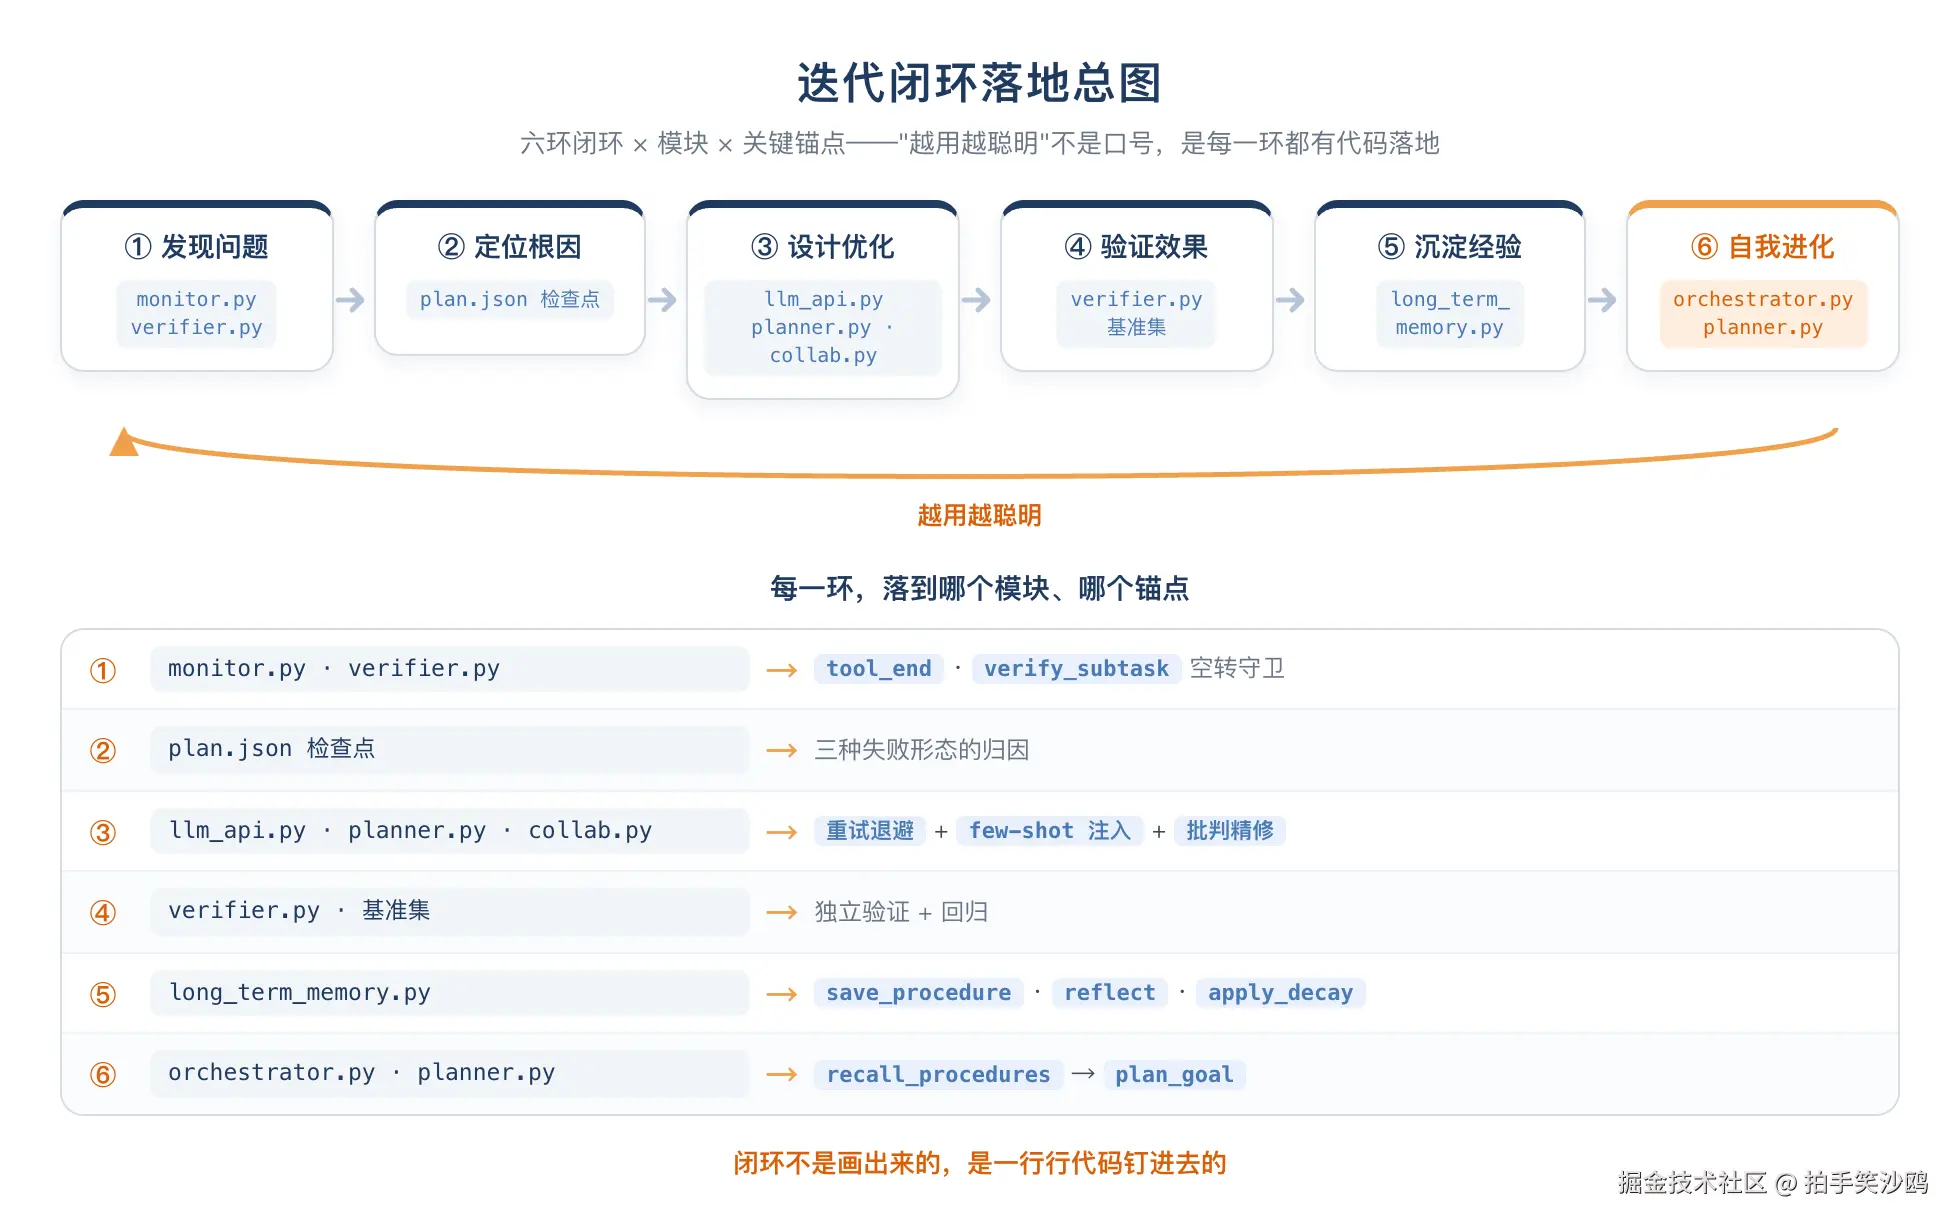
【发现问题】监控 / 验证器 / 用户反馈
   ↓
【定位根因】日志 / 归因分析
   ↓
【设计优化】提示词 / 工具 / 记忆 / 上下文
   ↓
【验证效果】离线基准集 + 在线监控
   ↓
【沉淀经验】程序性记忆 Skill 化 + 知识库 + 长期记忆
   ↓
【自我进化】下次同类任务,站在上次的肩膀上
   ↓(回到【发现问题】)
这六环,每一环都有对应的代码模块落地:
| 环 | 模块 | 关键锚点 |
|---|---|---|
| 发现问题 | monitor.py / verifier.py |
tool_end、verify_subtask 的空转守卫 |
| 定位根因 | plan.json 检查点 |
三种失败形态的归因 |
| 设计优化 | llm_api.py / planner.py / collab.py |
重试退避、few-shot 注入、批判精修 |
| 验证效果 | verifier.py / 基准集 |
独立验证 + 回归 |
| 沉淀经验 | long_term_memory.py |
save_procedure / reflect / apply_decay |
| 自我进化 | orchestrator.py / planner.py |
recall_procedures → plan_goal |
结束语 · 系列收官
九篇走完,超体才算真正"立住"了:它有手 (工具调用)、有血肉 (知识库 RAG)、有尺子 (评测体系)、会打磨 (效果优化)、能进化(闭环迭代)。
回望这一路,每一步都在补一块能力:
- 需求------把模糊的"想要",翻译成可建模的任务;
- 架构------搭起"规划 → 执行 → 验证"的循环骨架;
- 模型------选一颗稳得住的大脑,用 Prompt 调教到不跑偏;
- 工具------装上一双能真正动手的手;
- 知识------让它开口有据,基于事实说话;
- 评测------造一把尺子,量得出"好不好用";
- 优化------检索、提示词、工具三管齐下;
- 闭环------把每一次踩坑,沉淀成下一次的能力。
走到这里,你大概已经看清这个系列真正在讲什么了。它叫《从0到1构建一个能"记住你"的智能体》,但"记住你"三个字,比字面意思重得多:
"记住你",不是记住你叫什么、喜欢什么、在哪儿上班。 那是记忆的"存储"。真正值钱的,是记住你交给它的每一件事里,哪里做对了、哪里栽了跟头------然后,下一次,不再栽同一个跟头。
所以这一篇的标题才叫"越用越聪明"。记忆的终点不是"存",是"长":存得再多,是仓库;长得起来,才是脑子。
九篇文章,九个模块,底层就两句老话,收官之际再重复一遍,因为它们值得:
- 工程上,能用、能上线,永远优先于优雅;
- 认知上,战术的勤劳,永远不能掩盖战略的懒惰。
一个智能体的天花板,从来不取决于它调了多强的模型、接了多少工具,而取决于一件事------它会不会从自己的每一次失败和成功里,长出下一步的能力。
正篇到这里,就算收官了。但"记住你"这件事,还有很多没讲透的地方:记忆的隐私与边界、遗忘的代价、多智能体之间的协作分寸、数字分身如何始终"是你"......这些,不再各开一章,而是留作番外篇,挑几个点,慢慢延伸。
最后,用开篇那句定场的话作结------它如今,有了真正的落点:
让每一次踩坑,都变成下一次的能力。 这,才是一个能"记住你"的智能体,真正的样子。
番外篇预告
正篇收官,番外不散场。后续不再各开一章,而是挑几个点做延伸思考,想到哪写到哪:
- 记忆的隐私与边界------智能体"记住你"之后,这些记忆如何可控、可遗忘、可撤回;
- 遗忘的代价------90 天半衰期若调错,是"忘得快"还是"忘得狠";
- 多智能体的分寸------批判者与精修者,什么时候该上、什么时候该撤;
- 人格的一致性------长期记忆如何在变与不变之间,始终"是你"。
参考链接
- Anthropic - Building effective agents --- 智能体迭代方法论
- AutoGen: Enabling Next-Gen LLM Applications via Multi-Agent Conversation --- 多智能体框架
- ReAct: Synergizing Reasoning and Acting in Language Models --- ReAct 范式
- Reflexion: Language Agents with Verbal Reinforcement Learning --- 反思机制
本文为《从0到1构建一个能"记住你"的智能体》系列第 9 篇,也是系列正篇的收官之作。
公众号同号:拍手笑沙鸥,欢迎关注~