一、引言
Hadoop 生态早期解决了海量数据的离线存储与批处理问题:HDFS 适合存储大文件,MapReduce 适合批量计算。但如果业务需要在海量数据中按 RowKey 快速读取或更新单条记录,单靠 HDFS 并不合适,因为 HDFS 定位不是通用文件系统,也不提供面向单条记录的快速查找能力;HBase 则构建在 HDFS 之上,通过内部索引化的 StoreFile 为大表提供快速记录查找和更新能力。
Apache HBase 是构建在 Hadoop/HDFS 之上的分布式、可扩展大数据存储系统,面向海量表的随机、实时读写访问。HBase 的定位是 "The Hadoop Database",它适合承载数亿到数十亿行、百万级列规模的稀疏数据,并提供严格一致的读写、自动分片、RegionServer 故障转移、HDFS 集成、Java/REST/Thrift API、Block Cache 与 Bloom Filter 等能力。
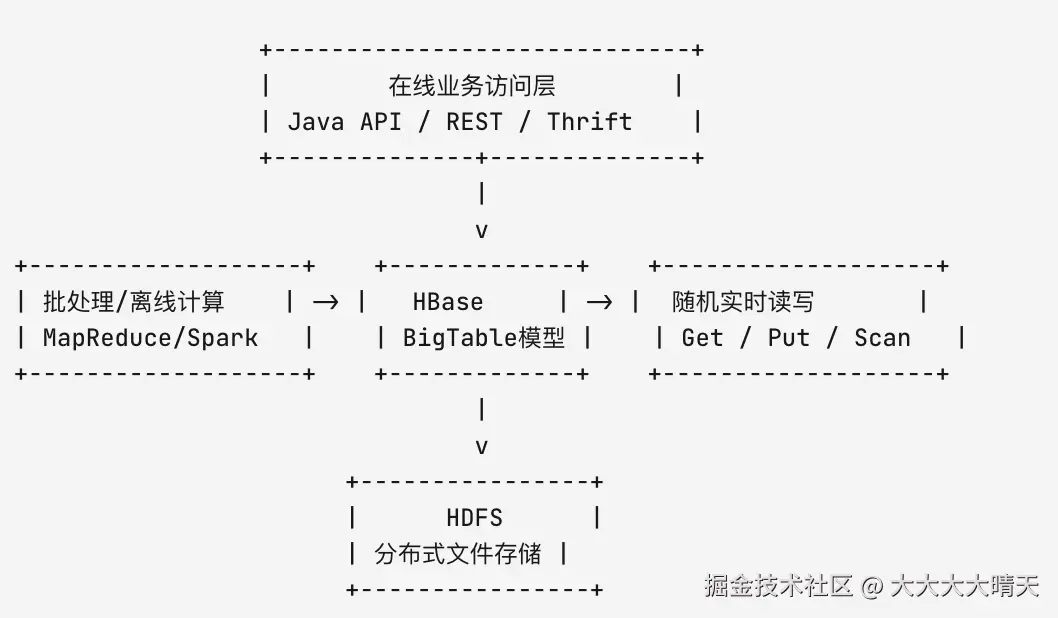
HBase 的核心价值不是替代所有数据库,而是在 Hadoop 体系里补齐"海量数据上的低延迟随机访问"能力。如果只有几千到几百万行数据,传统 RDBMS 可能更合适;如果希望保留 SQL、二级索引、触发器、复杂事务和高级查询语言等 RDBMS 能力,不能简单通过替换 JDBC 驱动把应用迁到 HBase,而应视为一次重新设计。
二、HBase 的数据模型
HBase 表面上也有表、行、列这些概念,但不要把它直接类比为关系型数据库表,更准确的理解是一个多维 Map。一个 Cell 由{row, column, version} 唯一定位,其中 column 又由 Column Family 和 Column Qualifier 组成,Cell 的内容本身是字节数组。
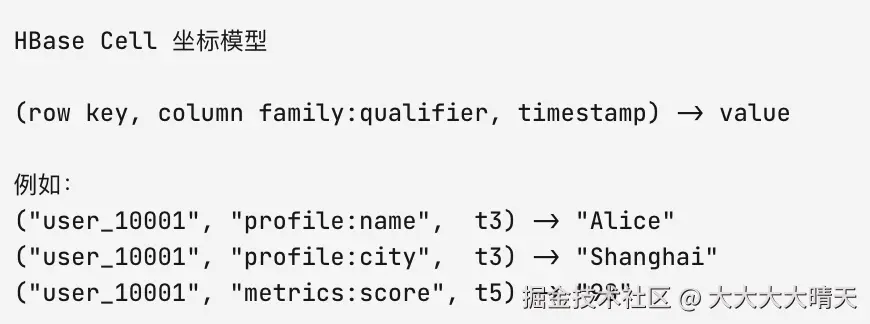
HBase 中 RowKey 按字典序排序存储,因此 RowKey 设计会直接影响数据局部性、扫描效率和热点风险。如果 RowKey 是网站域名,通常应反转域名顺序,例如把www.apache.org 设计成org.apache.www ,这样同一组织下的域名会在表中相邻,而不会因为子域名前缀分散在不同位置。
Column Family 是物理存储与调优的基本单位。Column Family 必须在建表时声明,而 Column Qualifier 可以在表运行时动态增加;同一 Column Family 内的列会在文件系统上一起存储,因此一个 Column Family 内的数据最好有相近的访问模式和大小特征。
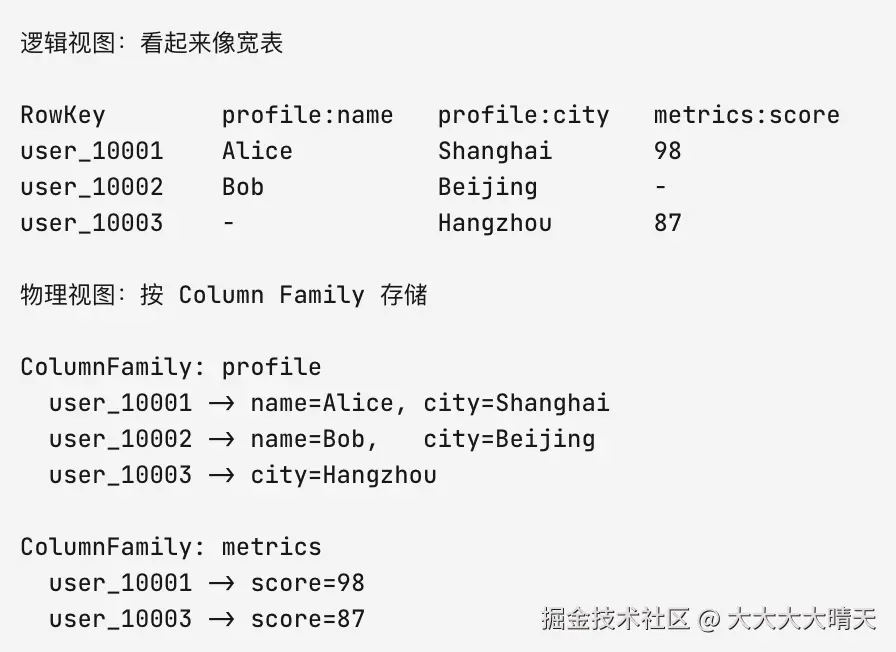
HBase 是稀疏存储:逻辑表中看似为空的 Cell 并不实际占用空间,这也是 HBase 适合宽表、稀疏列、多版本数据的重要原因。
三、HBase 集群整体架构
HBase 集群由客户端、HMaster、RegionServer、ZooKeeper 和 HDFS 共同组成。客户端通过元数据定位目标 Region,直接访问承载该 Region 的 RegionServer;HMaster 主要负责集群管理和元数据操作,RegionServer 承担实际的数据读写,HDFS 保存 WAL、HFile 等持久化数据,ZooKeeper 则参与服务发现、Master 选举和集群协调。
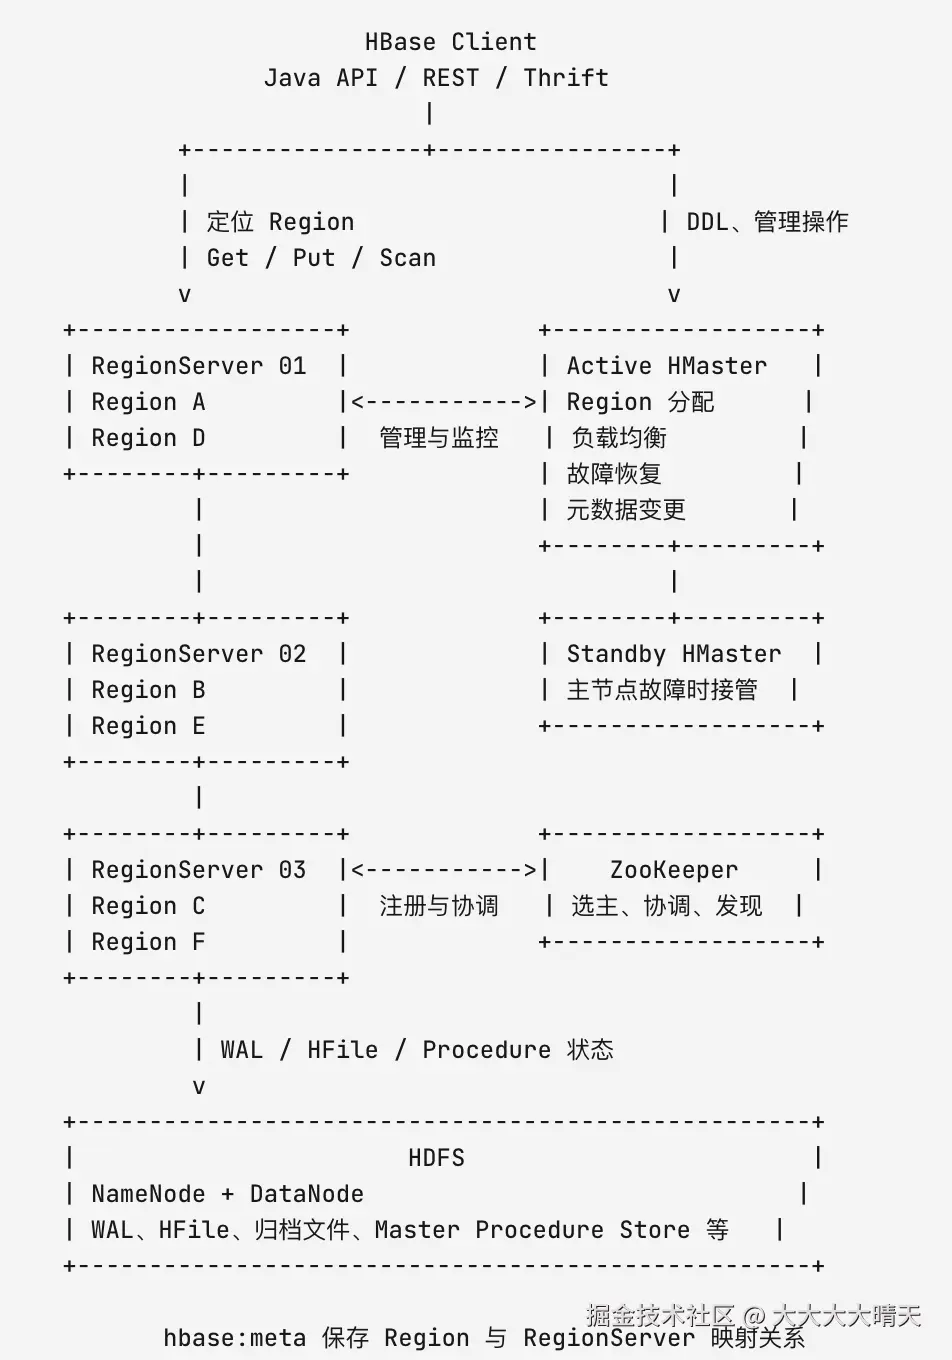
集群中的主要组件分工如下:
| 组件 | 主要职责 | 是否直接保存用户数据 |
|---|---|---|
| Client | 查找 Region、缓存位置、直接发起读写及重试 | 否 |
| HMaster | 表管理、Region 分配、负载均衡、故障恢复 | 否 |
| RegionServer | 管理 Region,执行 Get、Put、Scan、Delete | 是,通过 MemStore 和 HFile |
| hbase:meta | 保存 Region 的范围、位置和状态等元数据 | 保存系统元数据 |
| ZooKeeper | Master 选举、服务协调和部分发现机制 | 否 |
| HDFS | 持久化 WAL、HFile 和集群状态文件 | 是 |
hbase:meta 本身也是一张 HBase 表,记录用户表的 Region 信息及其所在的 RegionServer。客户端定位目标数据时,先根据 RowKey 找到对应 Region,再直接连接承载该 Region 的 RegionServer。客户端会缓存 Region 位置信息,后续访问同一 Region 时通常不需要重新查找。
当 Region 因 split、迁移或 RegionServer 故障而改变位置时,客户端缓存可能暂时过期。请求失败后,客户端会重新获取位置并重试。因此,应用侧看到的NotServingRegionException 、RegionMovedException 等异常不一定意味着数据丢失,它们往往表示 Region 正处于迁移、分裂或重新分配过程中。
1.Region 如何分布数据
一张 HBase 表会按连续的 RowKey 范围划分为多个 Region,每个 Region 对每个 Column Family 有一个 Store;Store 内包含 MemStore 与 StoreFile;StoreFile 再由 Block 组成。
scss
Table
└── Region
    ├── Store(ColumnFamily: cf1)
    │   ├── MemStore
    │   └── StoreFile(HFile)
    │       └── Block
    └── Store(ColumnFamily: cf2)
        ├── MemStore
        └── StoreFile(HFile)
            └── Block
Region 是 HBase 数据分布、负载均衡和故障恢复的基本单位。当一个 Region 增长到配置阈值时,RegionServer 可以将其 split 成两个子 Region;HMaster随后管理这些 Region 的分配和负载平衡。
Region 与 RegionServer 是一对多关系:
- 一个 Region 同一时刻通常只由一个 RegionServer 提供主服务。
- 一个 RegionServer 可以承载多个表的多个 Region。
- 一个大表通常跨多个 RegionServer 分布。
- RegionServer 故障后,HMaster 会把其 Region 重新分配给其他 RegionServer。
- Region 迁移后,底层 HFile 仍保存在 HDFS,不需要复制整份业务数据。
这里体现了 HBase 计算与存储相对分离的特点:RegionServer 是数据服务进程,而持久化文件位于 HDFS。RegionServer 故障后,接管 Region 的新 RegionServer 可以从 HDFS 打开原有 HFile,并通过 WAL 恢复尚未完全持久化的数据。
2.HMaster 内部架构
HMaster 是 HBase 的控制面核心。它不承担常规用户数据的转发,但负责维护集群状态、执行管理操作并协调故障恢复。
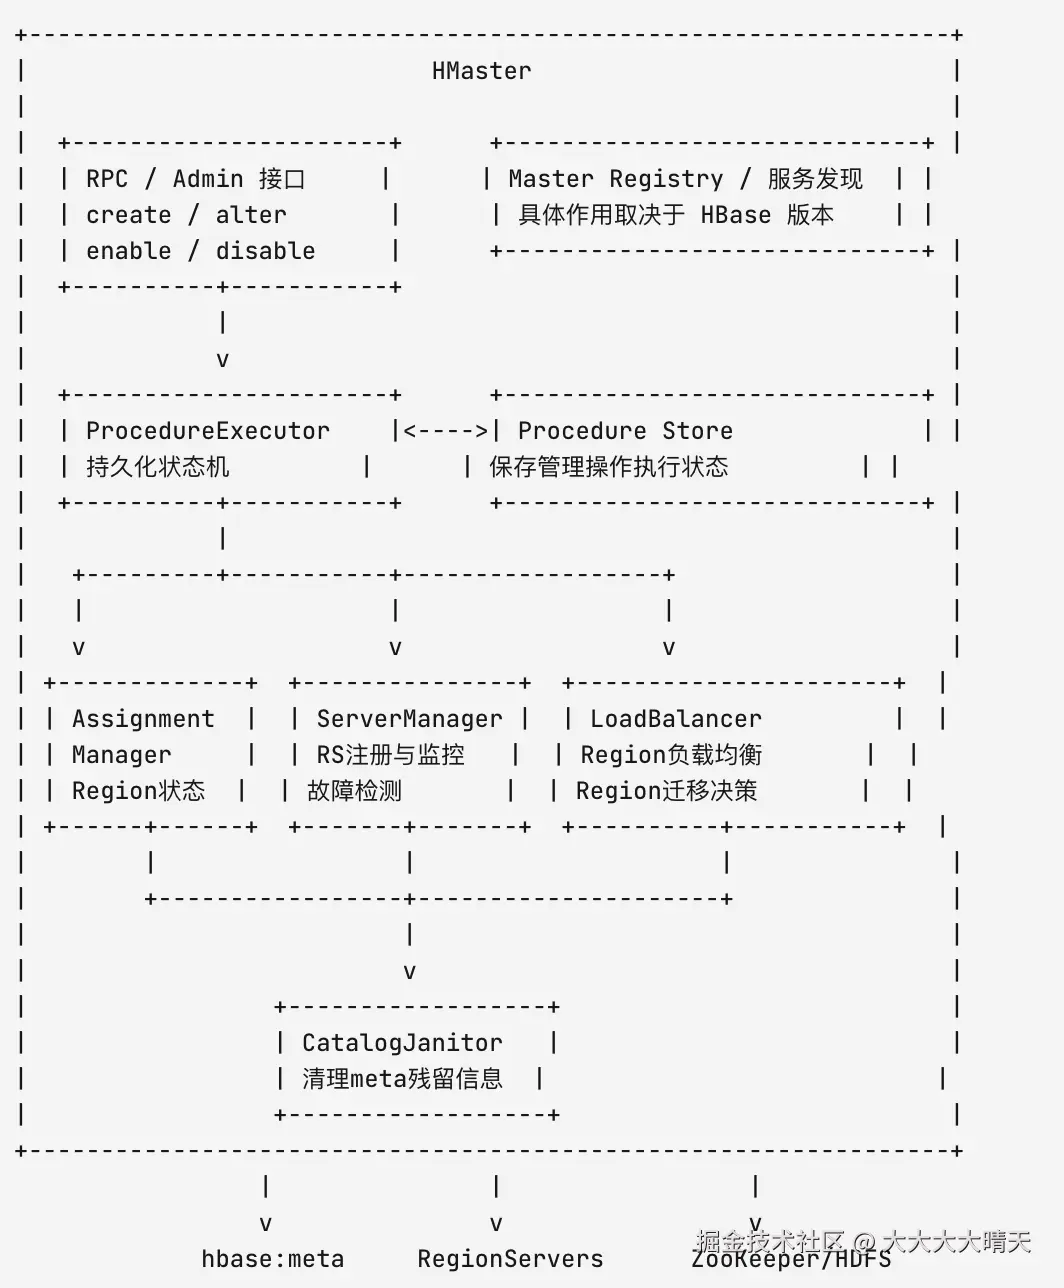
AssignmentManager 维护 Region 状态,并负责 Region 与 RegionServer 之间的分配关系。Region 可能经历OFFLINE、OPENING 、OPEN 、CLOSING 、CLOSED 、SPLITTING 和MERGING 等状态。
当 RegionServer 故障时,大致流程如下:
yaml
RegionServer 失联
       |
       v
HMaster 检测服务器故障
       |
       v
ServerManager 标记服务器不可用
       |
       v
AssignmentManager 识别受影响 Region
       |
       v
处理并拆分故障 RegionServer 的 WAL
       |
       v
把 Region 重新分配给存活 RegionServer
       |
       v
新 RegionServer 打开 HFile 并回放必要 WAL
       |
       v
Region 恢复服务
LoadBalancer 根据 Region 数量、请求负载、数据本地性、Region 大小等信息生成迁移计划,使 Region 在各 RegionServer 之间尽可能合理地分布。官方文档说明,当没有 Region 正处于状态转换时,HMaster 会周期性运行负载均衡器并移动 Region。
负载均衡不是简单地让每台服务器拥有完全相同数量的 Region。不同版本和配置下,均衡器还可能考虑读写请求数、StoreFile 大小、数据本地性、机架分布以及 RegionServer Group 等因素。
建表、删表、Region 分配和服务器故障恢复都不是一次 RPC 就能可靠完成的简单动作。HMaster 使用 Procedure Framework 把这些操作实现为可持久化、可重试的状态机。
yaml
创建表 Procedure 示例

PREPARE
   |
   v
CREATE_TABLE_DIRECTORY
   |
   v
WRITE_FS_LAYOUT
   |
   v
ADD_TO_META
   |
   v
ASSIGN_REGIONS
   |
   v
UPDATE_DESCRIPTOR_CACHE
   |
   v
FINISH
如果 Active HMaster 在中途崩溃,新的 Active HMaster 可以读取持久化的 Procedure 状态,从已完成的阶段继续执行,而不是盲目重做整个操作。
3.RegionServer 内部架构
RegionServer 是 HBase 的数据面核心。一个 RegionServer 同时管理多个 Region;每个 Region 按 Column Family 划分 Store;每个 Store 包含一个 MemStore 和若干 StoreFile。
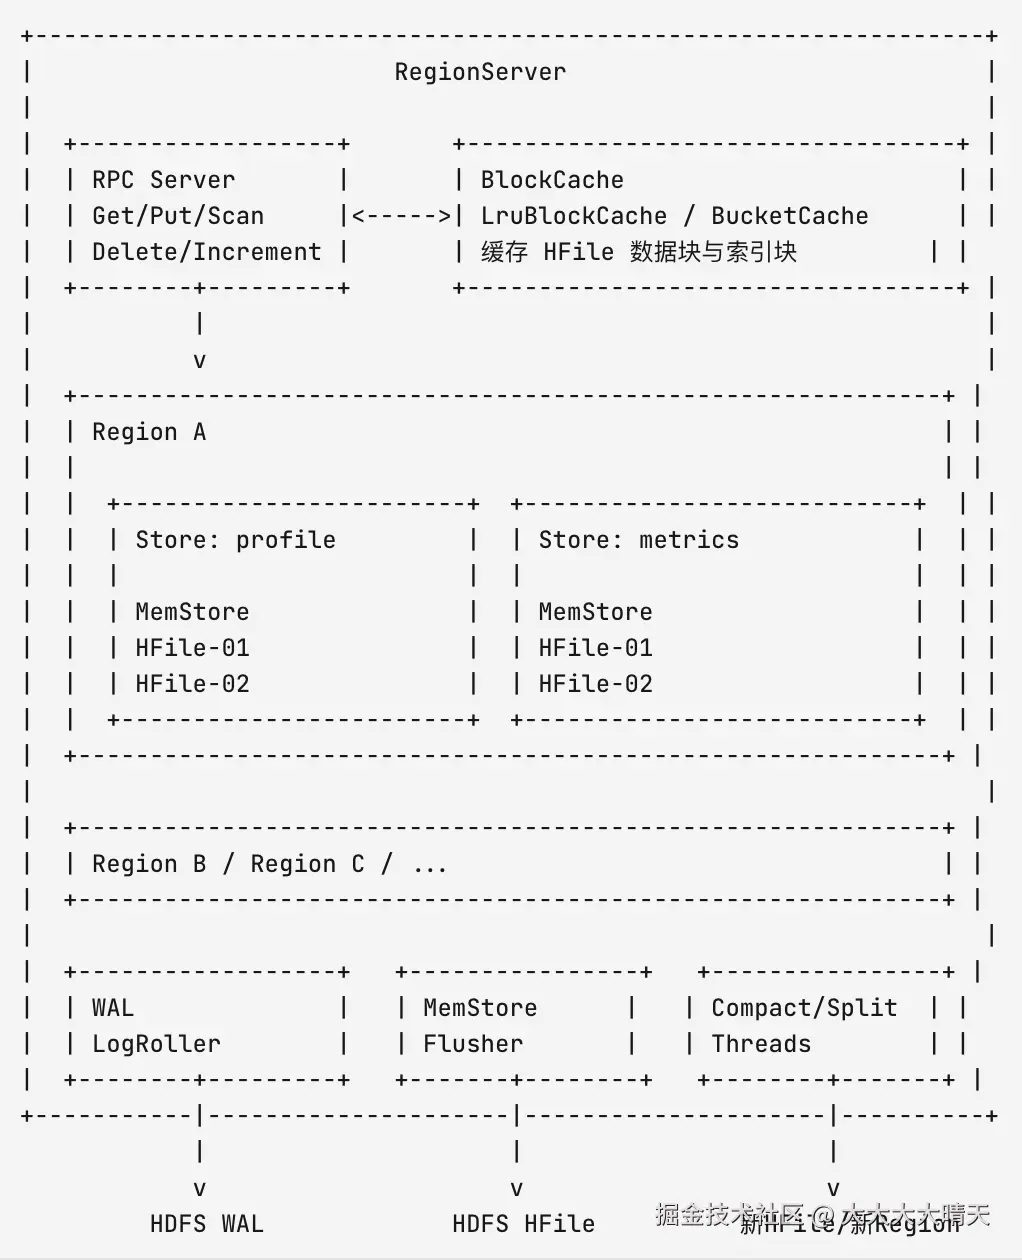
RegionServer 的 RPC 层接收客户端数据请求,RegionServer 会根据请求的 RowKey 判断目标 Region 是否由自己服务。如果客户端使用了过期的 Region 位置缓存,RegionServer 会返回相应异常,促使客户端重新定位 Region。
WAL 是 RegionServer 的预写日志。一条写入在更新 MemStore 前,需要先追加到 WAL;只有达到相应持久化条件后,RegionServer 才向客户端确认成功。
yaml
Put 请求
   |
   v
检查目标 Region
   |
   v
追加 WAL
   |
   v
写入对应 Store 的 MemStore
   |
   v
返回客户端
WAL 的主要作用是故障恢复。如果 RegionServer 在 MemStore flush 前崩溃,内存数据已经丢失,但 WAL 中仍保留写入记录。HBase 可以拆分并回放 WAL,把这些写入恢复到接管 Region 的 RegionServer。
一个 RegionServer 通常不是为每个 Region 单独维护一份完全独立的 WAL。多个 Region 的写入可能复用 RegionServer 级 WAL,因此故障恢复时需要按 Region 拆分或回放相关日志。
每个 Store 都有对应的 MemStore。新数据先进入 MemStore,并按 HBase 的内部 Key 顺序组织。当 MemStore 达到阈值或 RegionServer 内存压力过大时,MemStoreFlusher 会把数据写成不可变 HFile。
yaml
MemStore
   |
   | 达到阈值或内存压力触发
   v
生成新的 HFile
   |
   v
写入 HDFS
RegionServer 上 Region 数量过多时,MemStore 数量也会增加。全局 MemStore 内存压力可能触发较小规模的频繁 flush,进而生成大量小 HFile,并进一步放大 compaction 压力。这是官方建议控制 Region 和 Column Family 数量的重要原因之一。
StoreFile 是 HBase 在逻辑层使用的存储文件抽象,底层主要以 HFile 格式保存在 HDFS。HFile 是不可变文件,新写入不会在原文件中原地更新,而是通过新的 HFile 表达新版本或删除标记。
这种设计适合顺序追加和分布式文件系统,但会产生多个文件和重复版本,因此需要 compaction:
lua
Minor Compaction

HFile-01 \
HFile-02  +----> 较大的 HFile-A
HFile-03 /

Major Compaction

多个 HFile
   |
   +--> 合并数据
   +--> 处理过期版本
   +--> 在满足条件时清理 tombstone
   |
   v
更少的 HFile
Major compaction 可能消耗大量磁盘 I/O、网络和 CPU。生产环境不宜在业务高峰期无计划地对大量表同时触发 major compaction。
Compaction 和 split 都由 RegionServer 执行,但解决的问题不同:
| 操作 | 处理对象 | 主要目的 |
|---|---|---|
| Flush | MemStore | 把内存数据持久化为 HFile |
| Minor Compaction | 部分较小 HFile | 减少文件数量和读放大 |
| Major Compaction | Store 中较广范围 HFile | 合并数据并清理满足条件的旧版本和 tombstone |
| Region Split | 一个过大的 Region | 把 RowKey 范围拆成两个 Region |
| Region Merge | 相邻小 Region | 减少过多小 Region |
Region split 并不等价于立即复制所有 HFile 数据。HBase 可以先通过文件引用组织父 Region 与子 Region 的数据关系,再由后续 compaction 逐步生成完全独立的子 Region 文件。这降低了 split 瞬间需要搬迁的数据量。
BlockCache 缓存从 HFile 读取的数据块、索引块和 Bloom Filter 相关块,以减少对 HDFS 的重复读取。目前主要有两种实现:
LruBlockCache:位于 JVM 堆内;BucketCache:通常位于堆外,也可以使用文件或持久内存等介质。
启用 BucketCache 后,通常把 DATA Block 放入 BucketCache,把 INDEX、BLOOM 等元数据块留在堆内 LruBlockCache,由CombinedBlockCache 统一管理。
lua
读取一个 Cell

MemStore 中存在?
   |
   +-- 是 --> 合并版本后返回
   |
   +-- 否 --> BlockCache 命中?
                |
                +-- 是 --> 返回缓存块中的数据
                |
                +-- 否 --> Bloom Filter 判断
                              |
                              +-- 明确不存在 --> 跳过文件
                              |
                              +-- 可能存在 --> 读取 HFile
                                               |
                                               v
                                          写入 BlockCache
四、写流程
一次典型 Put 请求大致经历以下过程:
yaml
1. Client 根据 RowKey 查找 Region
              |
              v
2. Client 从缓存或元数据服务获得 RegionServer 地址
              |
              v
3. Client 直接向目标 RegionServer 发起 Put
              |
              v
4. RegionServer 确认自己仍持有目标 Region
              |
              v
5. 写 WAL
              |
              v
6. 写目标 Column Family 对应的 MemStore
              |
              v
7. 满足持久化语义后向 Client 返回成功
              |
              v
8. MemStore 达到阈值后 flush 为 HFile
              |
              v
9. 后台 compaction 合并 HFile
             |
             v
10. Region 达到阈值时触发 split
HMaster通常不会出现在上述正常数据写入链路中。只有 Region 迁移、RegionServer 故障、表结构变更、负载均衡或客户端需要重新发现元数据位置时,控制面组件才会明显参与。
五、读流程
yaml
1. Client 根据 RowKey 定位 RegionServer
              |
              v
2. RegionServer 查找对应 Region
              |
              v
3. 查询 MemStore 中尚未 flush 的数据
              |
              v
4. 查询 BlockCache
              |
              v
5. 必要时借助 Bloom Filter 和 HFile 索引定位数据块
              |
              v
6. 从 HDFS 读取未缓存的 HFile Block
              |
              v
7. 合并 MemStore、HFile、版本和 tombstone 结果
              |
              v
8. 把最终结果返回 Client
由于同一个 Cell 可能在 MemStore 和多个 HFile 中存在不同版本,读取并不总是简单地从某个文件取值。RegionServer 需要按照 RowKey、Column、Timestamp 和删除标记等规则合并结果。HFile 数量过多会增加读放大,因此 flush 和 compaction 状态会直接影响读延迟。
六、功能特性
HBase 的第一类特性是分布式扩展。表会按 Region 分布到集群中,随着数据增长,Region 可以自动 split 并重新分布;集群扩容时增加 RegionServer 即可提升整体存储和处理能力。
第二类特性是强一致的随机读写。HBase 不是 eventually consistent 的 DataStore,而是提供 strongly consistent reads/writes,因此适合高速计数聚合等需要强一致读写的任务。
第三类特性是面向大宽表和稀疏数据的数据模型。HBase 可以承载拥有海量(十亿级)行和大量(百万级)列的表,并支持严格一致操作下的随机实时读写。
第四类特性是生态集成与访问方式。HBase 支持 Java Client API、REST、Thrift,并可通过 MapReduce 把 HBase 同时作为输入源和输出目标。
| 特性 | HBase 的做法 | 工程含义 |
|---|---|---|
| 水平扩展 | 增加 RegionServer 扩展存储与处理能力 | 适合数据量持续增长的在线大表 |
| 自动分片 | 表按 Region 分布,Region 可 split | 业务无需手动管理所有分片 |
| 强一致读写 | 官方声明不是最终一致存储 | 适合状态、计数、特征等一致性敏感数据 |
| 稀疏宽表 | 空 Cell 不实际存储 | 适合字段多、不同实体字段差异大的场景 |
| HDFS 集成 | StoreFile/HFile 存在 HDFS | 复用 Hadoop 存储可靠性和生态 |
| 多接口访问 | Java、REST、Thrift | 支持多语言或服务化接入 |
七、适用场景
HBase 适合"数据量足够大、访问模式明确、以 RowKey 或 RowKey 范围访问为主"的场景。如果有数亿或数十亿行,HBase 是很好的候选;如果只有几千或几百万行,传统 RDBMS 可能更好,因为数据可能最终集中在一个或两个节点上,集群其他节点处于空闲状态。
典型场景包括用户画像宽表、IoT 设备状态表、风控实时特征表、订单/轨迹明细索引、日志检索索引、时间序列明细存储等。这些场景的共性是:Key 访问强、单行或小范围读写频繁、列稀疏、规模大、对横向扩展和写入吞吐敏感;但这类归纳属于工程经验总结,具体是否合适仍应回到 RowKey 设计、读写比例、延迟目标、数据保留周期和运维能力验证。
scss
适合 HBase 的访问模式

高匹配:
  Get(rowkey)
  Scan(startRow, stopRow)
  Put(rowkey, columns)
  按 RowKey 前缀或范围读取

低匹配:
  SELECT * WHERE arbitrary_column = ?
  多表复杂 JOIN
  跨行事务
  临时多维分析
  小数据量 CRUD 后台系统
HBase 不适合直接替代 OLTP 关系库。HBase 缺少 RDBMS 中常见的 typed columns、secondary indexes、triggers、advanced query languages 等能力;从 RDBMS 迁移到 HBase 不能被视为"换一个 JDBC 驱动",而应是完整的数据模型和访问模式重构。
八、部署与使用
HBase集群的基本启动顺序是:先确认 HDFS 已启动;如果自行管理 ZooKeeper,则先启动并确认 ZooKeeper 正常,否则 HBase 会在启动过程中启动 ZooKeeper;随后在HBASE_HOME 目录执行bin/start-hbase.sh 启动 HBase。
bash
简化启动流程

1. 启动 HDFS
   HADOOP_HOME/bin/start-hdfs.sh

2. 启动 ZooKeeper
   如果自管 ZooKeeper,先启动并确认可用

3. 启动 HBase
   HBASE_HOME/bin/start-hbase.sh

4. 查看日志
   HBASE_HOME/logs/

5. 查看 Web UI
   Master 默认端口:16010
   RegionServer 默认 RPC 端口:16020
   RegionServer 默认 HTTP 端口:16030
一个最小的 HBase Shell 使用流程通常是:
bash
# 进入 Shell
hbase shell

# 创建表,指定 Column Family
create 'user_profile', 'profile', 'metrics'

# 写入数据
put 'user_profile', 'user_10001', 'profile:name', 'Alice'
put 'user_profile', 'user_10001', 'metrics:score', '98'

# 读取单行
get 'user_profile', 'user_10001'

# 扫描表
scan 'user_profile', {LIMIT => 10}

# 禁用并删除表
disable 'user_profile'
drop 'user_profile'
九、常见问题
1.RowKey 热点
HBase 按 RowKey 有序存储,连续递增的 RowKey 容易让最新写入集中到最后一个 Region,导致单个 RegionServer 过载。常见缓解思路包括 RowKey 加盐、哈希前缀、反转部分 Key、预分区、按业务维度拆表等。需要注意,这些策略会改变扫描模式:例如加盐能分散写入,但会让按原始时间范围扫描变复杂,所以 RowKey 设计必须从查询模式反推,而不是只为写入均衡服务。
2.Region 数量过多
Region 是扩展和可用性的基本单位,但不是越多越好。HBase 通常被设计为每台服务器运行较少数量、相对较大的 Region,一般是每台服务器 20 到 200 个、每个 Region 5 到 20GB,当然实际效果也需要结合服务器配置等因素综合评估。
Region 过多会带来 MemStore、Master 调度、flush、compaction、MapReduce mapper 数量等多方面成本。MSLAB 每个 MemStore 需要 2MB,如果有 1000 个 Region 且每个 Region 有 2 个 Column Family,仅这部分就会占用约 3.9GB 堆内存,还没有真正存储数据。
3.Column Family 设计不当
Column Family 是物理存储和调优单位,而不是随意分组的逻辑标签。同一 Column Family 的成员应具有相似访问模式和大小特征,因为同一 Column Family 的成员会在文件系统上一起存储,缓存、压缩、编码等调优也发生在 Column Family 层面。
实践中应尽量控制 Column Family 数量。把冷热数据、大小差异极大的字段、访问频率完全不同的数据放在同一个 Column Family,会放大读写和 compaction 成本;反过来,Column Family 拆得过多也会增加 Store、MemStore 和 flush 管理负担。
4.Block Cache 使用不当
Block Cache 能提升热点数据读取性能,但不是所有读取都应进入缓存。如果工作集不能放进内存,使用 block caching 通常不好;例如完全随机读取且短时间几乎不重复访问同一行时,缓存命中率接近 0,启用缓存会浪费内存和 CPU,并增加 JVM GC 压力。
对于一次性全表扫描、MapReduce 扫描等场景,通常应考虑关闭 Scan 的 cache blocks,以避免大量冷数据冲掉在线服务热点缓存。官方文档也提到,在典型 MapReduce 读取表作为输入的场景中,每行通常只读一次,因此没有必要把这些数据块放入 Block Cache。
5.删除后空间不立即释放
HBase 删除会写入 tombstone,而不是立即物理删除数据。Delete 会创建 tombstones,tombstones 和 dead values 会在 major compactions 中清理;因此删除大量数据后,磁盘占用可能不会马上下降,读路径也可能在 compaction 前受到删除标记影响。
这意味着 TTL、版本数、major compaction 策略和批量删除节奏都需要纳入容量规划。不要把 HBase 当作"删除后立刻释放空间"的文件系统或传统单机数据库来理解。