DeepSeek 今天换了线上模型,版本号 V4.1-Flash-1017。网页、App、API 三边一起切,价格没动。
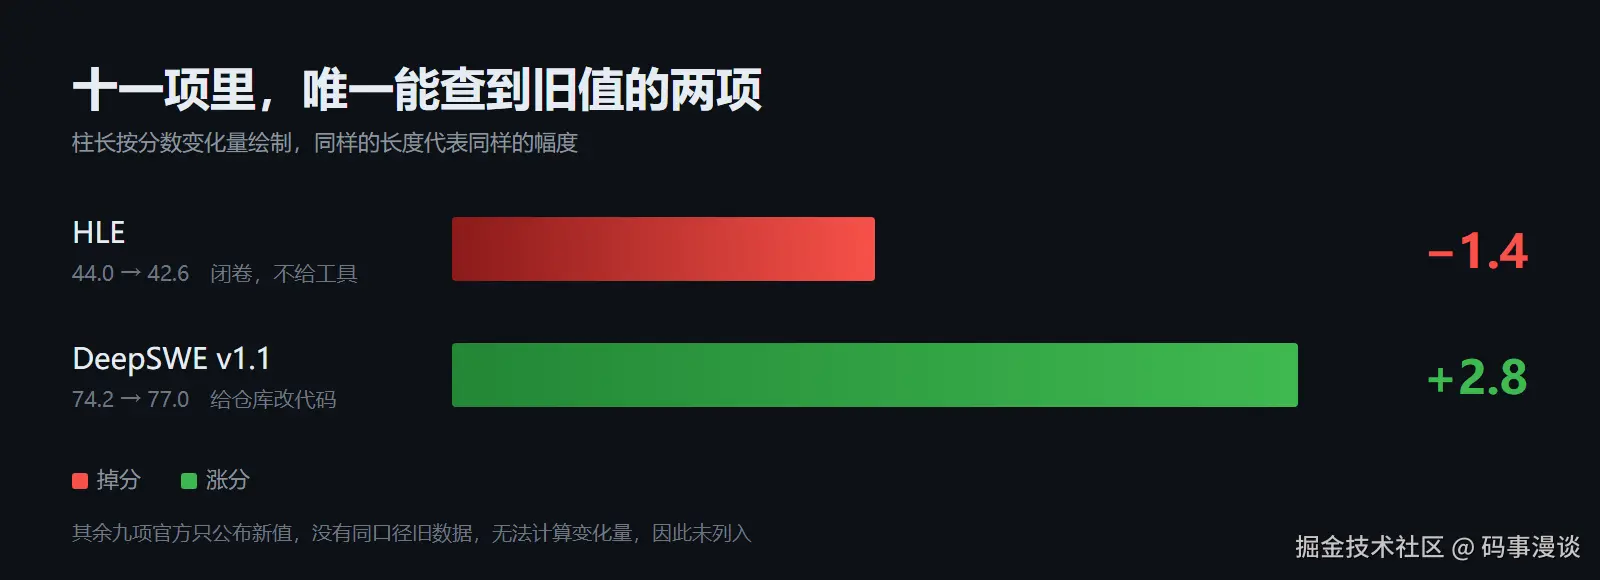
官方通稿说各项基准都有提升,后面附了十一项成绩。我对着旧版本翻了一遍,能直接比对的只有两项,一项涨 2.8 分,一项掉 1.4 分。
涨的是 DeepSWE,77.0,上一版 74.2。
掉的是 HLE,42.6,括号里写着 44.0。
剩下九项官方只贴了新数字,没有可比的旧值。所以"十项涨"是我顺着"各项均有提升"那句话推出来的,严格讲没逐项核对过。
十一项里只有 HLE 标了 w/o tools,不给工具,不给网络,就在脑子里把一道难题想完。其余十项都要开电脑、跑命令、看结果。
闭卷那一项让了 1.4 分,动手那十项在涨。这是有意换的方向。
换了个练法
官方给的训练方法叫自反馈强化学习。翻成平常话,模型写完代码不马上交,自己先跑一遍。跑出报错就回来改,改完再跑,一直跑到通过。训练的时候,这个自查的过程算加分。
练出来的本事偏向把一件完整的事干到底。纯靠在脑子里硬想解难题的能力,退了半步。
HLE 掉那 1.4 分,是训练上做的取舍,还是采样设置跟上一版不一样,官方没说。我猜是前者,掉的和涨的划得太整齐。这话没有依据,纯属我这么看。
官方放的四个演示跟这个对得上。故宫的 3D 模型、网页版赛车、用 Godot 引擎复刻《传送门 2》,还有一个叫 Valley of Ages 的场景,用 3D 从史前一路演到现代。这几样有个共同点,光靠嘴说不清楚,只能让它自己边做边试。
最值钱的是那句括号话,极短的交互轮次。
轮次就是账单
跑一个 Agent 任务,模型要来回问你几十次。每一次它都把前面说过的全部重发一遍,你的要求、它能调的工具、项目代码。一个任务跑到底,送进去的可能有二十万字,它自己回的只有一万多。
输入是输出的十几倍。钱就压在这些重复内容上。
DeepSeek 对这块单独定价。工作日白天算高峰,晚上和周末算空闲,两档差一倍。更狠的是重复和不重复的差价,每百万字,重复过的收两分钱,没重复过的收一块,差五十倍。
同一段话你第二次发过去,基本等于白送。
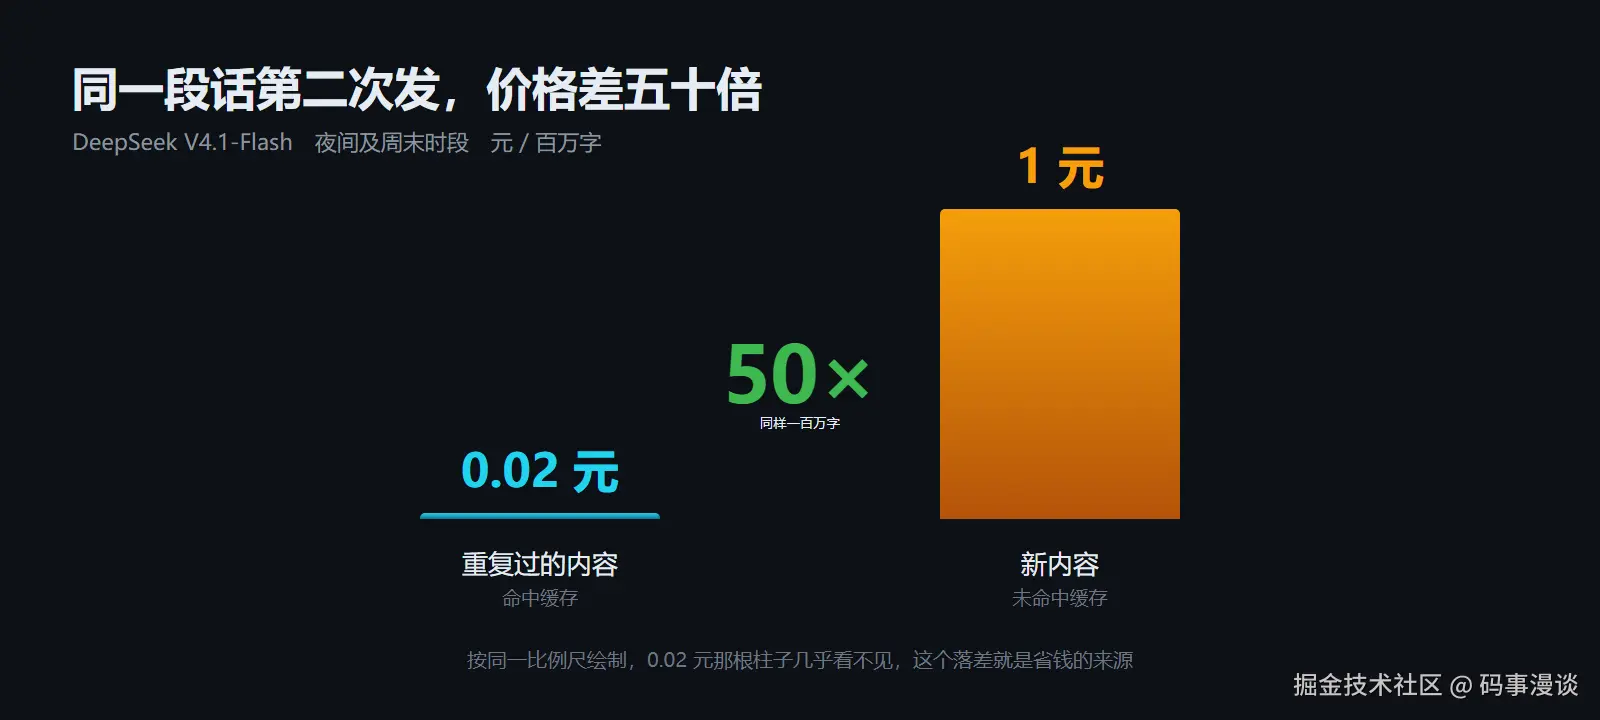
这条直接决定你每月付多少钱。系统提示词固定住、工具列表顺序别动、别每轮往里塞新东西,成本能砍掉大半。你每轮都拼一段不一样的提示词,那五十倍的便宜一分拿不到,全按一块钱那档算。
价目表一个字没改,钱是从工程习惯里省出来的。
跟 GLM-5.3 摆在一起看
智谱那边,GLM-5.3 输入八块、输出二十八块,重复内容两块。DeepSeek 是两块和八块,重复内容四分钱。输入输出差三到八倍,重复内容那栏差五十到一百倍。
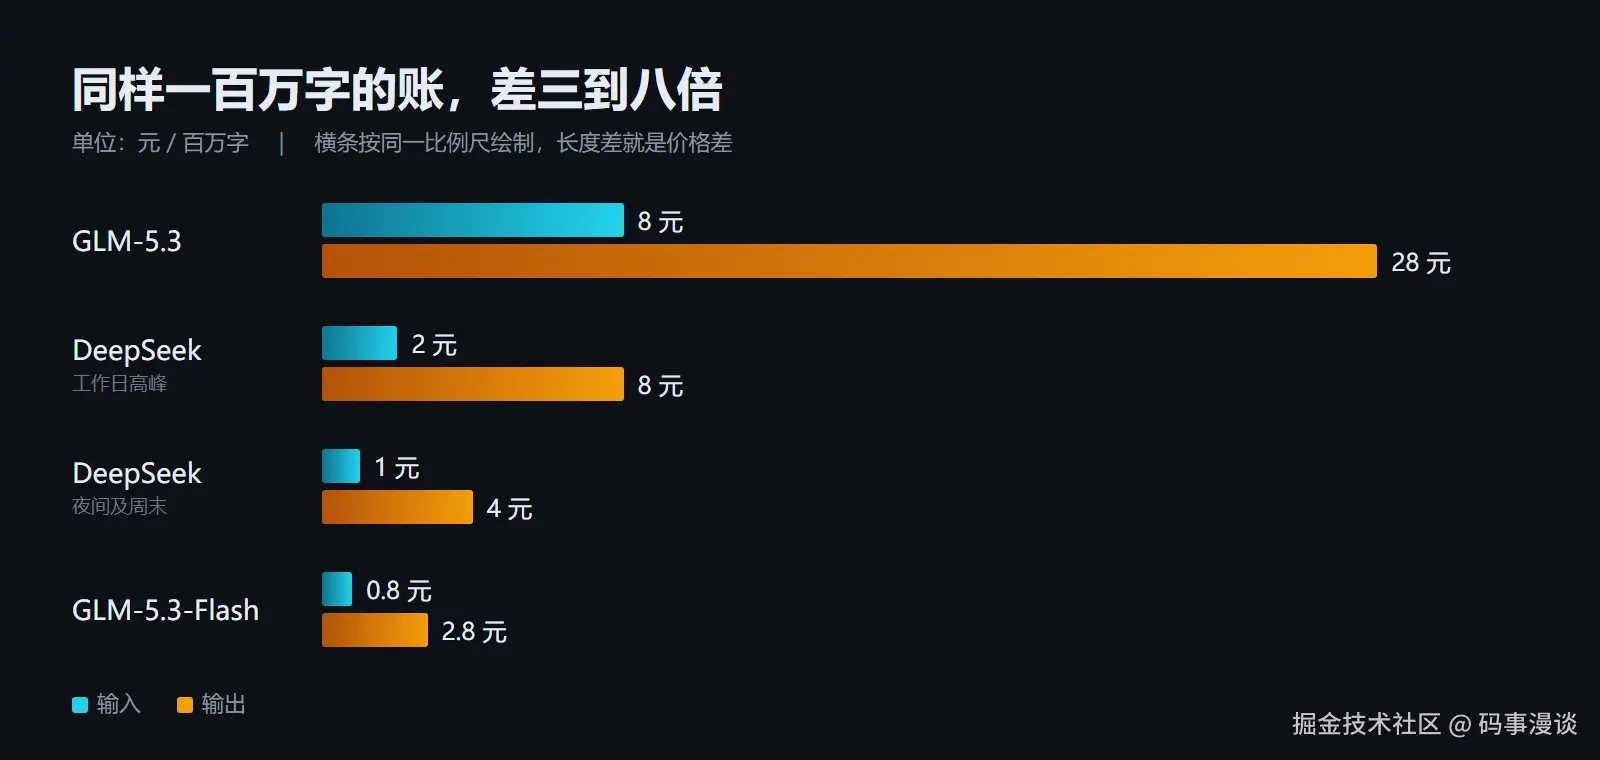
贵有贵的道理。GLM-5.3 在综合评测上高出六分,那套评测把知识、推理、数学混在一起算。写文案、答问题、做分析这类杂活,它更稳。
换成代码任务,位置就对调了。同一个 DeepSWE,DeepSeek 77.0,GLM-5.3 是 66.9。NL2Repo 是 68.2 对 58.0。
两组数搁在一起不打架。一家把训练花在什么都会一点上,另一家全押在写代码和跑任务上。你拿综合分去挑写代码的模型,方向就偏了。
平时写代码多、跑自动化多,挑 DeepSeek。什么活都干一点、要一个全能选手,挑 GLM-5.3。
一个容易踩的地方
DeepSeek 的便宜分时段。只在工作日白天跑任务,价格翻到两块和八块。这个价摆在智谱的小模型 GLM-5.3-Flash 旁边比不过,那边八毛和两块八。
内部批处理、数据清洗这类不急的活,挪到晚上,成本直接对半。挪不动的业务,它便宜这件事跟你关系不大。
速度差也得算进去。有评测机构测过,DeepSeek 每秒吐两百多个字,GLM-5.3 五十几个,差四倍。单次对话感觉不到,Agent 循环几十轮起步,一轮慢三秒,攒下来就是几分钟。这比多花几毛钱难受。
还有一条被漏掉的
这次开放了自家的搜索接口,Search 和 Fetch,一千次五块钱,十一月一号开始正式收费。我自己没比过其他家的报价,但五块钱一千次放在同类里算便宜的。
做 RAG、让 Agent 自己查资料的人,这条比换模型实惠。
回到那个掉分的数字
通稿里肯把掉分项和涨分项一起贴出来,这件事本身比每项都涨更可信。
这版到底行不行,榜单上看不出来,每家跑的都是自己出的卷子。挑你自己最烦的那个任务,跑二十遍,数它几次不用你插手就干完了。