OpenCode 版 OmO:职责分工、编辑校验与技能边界
把一个任务交给代理前,先写清谁规划、谁实现、谁检查,以及失败后由谁接手。
先看这篇文章讨论哪一版
本文固定讨论 OmO v3.12.2 的 OpenCode 插件形态,文档核对日期为 2026-10-17,依据上游固定版本 README与特性说明整理。仓库名、插件名和后续版本会变化,安装时应对照自己的版本。
这篇文章关注一个问题:把规划、实现、文档检索和审查交给不同角色后,怎样把结果汇总成可验收的交付。
以下流程图是作者对职责关系的简化;Python 代码是角色说明演示,不会创建、调用或隔离真实代理。本文没有多代理稳定性、token 用量、成本或交付速度的对照实验;作者的一次有边界自用记录见后文同题小节。
下文先用角色表说明规划、实现、检索与审查的责任,再用 IntentGate、Hashline 和技能与 MCP 加载记录检查需求、编辑与调用。评估时还要核对失败后的接手者,以及当前上下文中是否仍混有过期假设。
角色数量只是组织方式;交付仍需要检查结果支持。
OmO 到底解决了什么问题
先看一种职责没有拆开的流程示意:
bash
flowchart LR
  A[需求] --> B[单个 Agent]
  B --> C[代码]
  C --> D[返工]
  D --> B
如果上述工作全挤在一个长会话里,需要留意:
- 同一个 Agent 同时做规划、实现、查文档、审查
- 旧假设和已失效的结论是否仍占据上下文
- 一旦中间方向错了,后面只能继续在错误路径上堆 token
- 最后有没有可回查的修改、检查结果与未解决事项
OmO 的这些角色,可以用下面的简化关系说明:
bash
flowchart TB
  U[用户目标] --> S[Sisyphus 主编排]
  S --> P[Prometheus 战略规划]
  S --> H[Hephaestus 深度执行]
  S --> L[Librarian 文档检索]
  S --> O[Oracle 审校]
  H --> R[代码与产物]
  L --> H
  O --> S
  R --> F[结果/修复/继续迭代]
拆分后的直接变化是职责范围更清楚,文档检索和实现可以分别留下结果。
主编排把文档依据、修改位置与检查结果汇总到同一份交付说明,标明各项由谁提供;审查意见要与对应改动一一关联:审查者按原始目标列出未满足项,实现者逐项提交修复与复测结果。
OmO 的核心架构,为什么值得认真看
下表按 v3.12.2 文档概括角色职责。它是阅读这版配置的索引,不是所有任务都必须完整启动的固定流水线。
角色分工
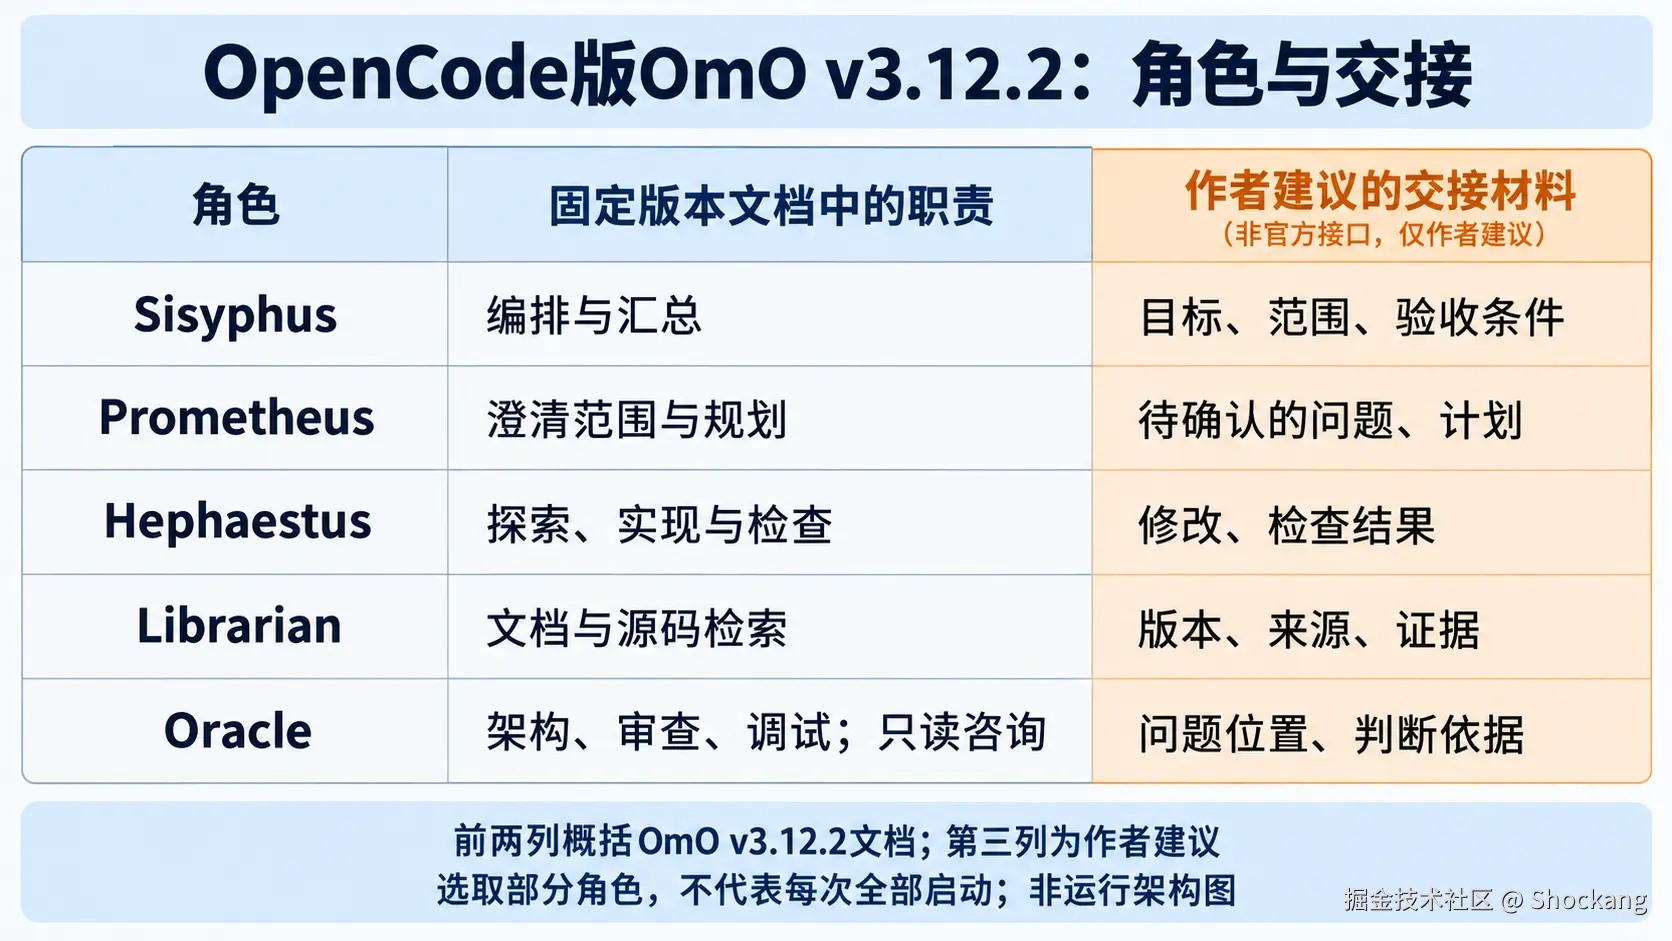
作者按 OmO v3.12.2 固定版本文档整理的部分角色职责与交接建议;下表给出对应的职责释义。配图由 AI 生成,作者核对,不是产品 API 或固定执行顺序。
| 角色 | 典型职责 | 实际意义 |
|---|---|---|
| Sisyphus | 编排、调度、持续推进 | 不亲自写所有代码,而是负责推进系统完成目标 |
| Hephaestus | 深度执行 | 真正做代码探索、实现和端到端动作 |
| Prometheus | 先问后做 | 在范围不清时先收集约束,而不是直接上手 |
| Librarian | 文档与 GitHub 检索 | 降低"拍脑袋 API 调用"的概率 |
| Oracle | 架构、代码审查与调试的只读咨询 | 提供另一份分析,仍需要测试和负责人判断 |
阅读这张表时,要区分"有这个角色"和"本次需要调用这个角色"。简单、范围清楚的修改可以先由一个执行者完成。
什么时候值得拆开代理
增加代理会增加交接、调度和合并结果的工作。先判断任务是否独立,再决定是否拆分。
例如,查一个已选库的官方 API,可以与一个修改范围清楚的实现任务分别进行;两个执行者同时改同一段代码,就需要额外协调。
判断依据是依赖关系和修改边界,不能只看代理数量。
如果任务很短,拆出多个角色的开销也应算进成本。
对比一下两种工作流
bash
flowchart LR
  A[单 Agent] --> B[规划]
  B --> C[实现]
  C --> D[查文档]
  D --> E[改代码]
  E --> F[自我审查]
  F --> G[上下文膨胀]
bash
flowchart LR
  A[主编排] --> B[规划 Agent]
  A --> C[实现 Agent]
  A --> D[文档 Agent]
  A --> E[审查 Agent]
  E --> A
第二种把规划、检索、实现与审查放在不同节点。
确需拆开时,按下文组织方式表逐项核对交接点。
三个值得核对的机制
1. IntentGate
v3.12.2 README 将 IntentGate 描述为行动前的意图分析。这里把它看作一道需求理解环节。
它的核心思想是:
行动前先识别任务意图,再决定是澄清、规划、检索还是实现。
读者可以检查它有没有复述目标、识别缺失信息、说明下一步动作。
这些输出仍需与原始请求对照;一个名为 IntentGate 的环节不能保证理解一定正确。
2. Hash-Anchored Edit Tool
这一版 README 介绍的 Hashline,会在读取的行旁附带内容哈希,编辑时引用这些标记;文件变化导致标记不匹配时,编辑会被拒绝。
它检查的是读取依据是否仍匹配。哈希匹配不能证明业务修改正确,仍要查看 diff 并运行相关检查;读取后发生变化时,应重新读取再决定修改。
3. Skills + MCP 的懒加载
要把技能加载与 MCP 连接分开看。OpenCode 技能文档说明,技能可由 skill 工具按需读取完整内容。
v3.12.2 README 介绍了技能内嵌的按需 MCP,同时也列出默认启用的内置 MCP。不能把所有 MCP 都概括成同一种懒加载机制。
排查加载与交接时,对照技能目录中声明的入口、本次实际读取的技能内容,以及本次启动或调用的 MCP 服务;工具失败时,记录错误回到哪个角色。哪一项与预期不符,就先查那一项的配置或调用路径。比较 token 用量时,还应固定任务、模型和上下文口径。
实际工作流里,模型应该怎么分工
下面是本文建议的一种分工顺序,实际选择需要结合任务与用量记录:
- 高层规划交给更强的大模型
- 执行交给代码能力稳定的模型
- 简单修补交给更便宜的模型
这件事可以用一张图说明:
bash
flowchart TB
  A[用户目标] --> B[高层规划模型]
  B --> C[执行模型]
  C --> D[审查模型]
  D --> E[收口]
图中的模型是职责占位,不是型号或价位排行。应同时比较任务完成质量、失败回退、等待时间和实际费用;便宜模型反复返工也会增加总成本。
在 OpenCode 里,这套分工有具体落点:每个 agent 的 frontmatter 可以用 model: provider/model-id 单独指定模型,也可以在配置文件里按 agent 名设置,例如给规划用 agent 配更强的模型;未指定时主 agent 使用全局模型,subagent 继承调用它的主 agent 的模型。写法以官方代理文档和自己安装的版本为准。
三种组织方式,各检查哪些交接点
比较单代理、多窗口与多代理编排,应先定义交接点和验收条件,再查看实际记录。下面列出三种方式各自需要检查的地方:
| 工作流 | 需要检查的交接点 | 需要留下的证据 |
|---|---|---|
| 单代理对话式 | 同一会话有没有混用过期假设 | 当前任务约束、修改与检查结果 |
| 多窗口人工切换 | 人工转述有没有漏掉限制 | 转交的上下文、接收者确认的范围 |
| 多代理编排 | 调度、共享接口和汇总是否正确 | 各角色输出、冲突处理与集成检查 |
这张表不排列优劣。要比较稳定性,应先给三种流程同一批任务和验收条件,再记录失败、重试与人工修改;没有记录时,就不填成绩。
哪些步骤适合沉淀成技能
技能适合保存反复使用、需要按步骤检查的约定。提示词的长度本身不能说明约定能否执行。
整理 skills 时,把可复用的步骤与适用任务写清楚,便于路由到对应入口。按需读取的机制见前文;执行权限仍由工具或宿主配置落实。
一个理想技能目录的样子
bash
flowchart LR
  A[SKILL.md] --> B[scripts]
  A --> C[templates]
  A --> D[references]
  B --> E[可执行步骤]
  C --> F[复用骨架]
  D --> G[权威资料]
OpenCode 的技能入口是目录中的 SKILL.md,并包含 name、description 等 frontmatter;scripts、templates、references 是作者整理材料的一种方式,不是每个技能必备的固定三目录。
最简的 SKILL.md 头部只要两个字段(照官方技能文档摘录,以实际安装版本的文档为准):
bash
---
name: git-release
description: Create consistent releases and changelogs
---
name 用小写字母、数字和单个连字符,与所在目录同名;description 用一句话写清这个技能什么时候用。
技能保存操作说明,权限配置决定动作是否允许。两者应分别检查。
OpenCode 权限文档通过 permission 配置决定 allow、ask 或 deny。工具层权限也不自动等于操作系统沙箱。
一条最小的 permission 配置长这样(照官方权限文档摘录):
bash
{
  "permission": {
    "*": "ask",
    "bash": "allow",
    "edit": "deny",
    "webfetch": {
      "*": "ask",
      "https://en.wikipedia.org/*": "allow"
    }
  }
}
每个键对应一类动作,值是 allow、ask、deny 三选一;同一键也可以像 webfetch 那样按通配模式写多条规则,最后匹配的一条生效。
OpenCode 里还需要分别核对什么
对照OpenCode 代理文档检查自己的安装时,可以把下列项目分开核对:
- agent markdown
- subagent 角色分工
- skills 权限边界
- MCP 文档/浏览器接入
- session 压缩和导出
代理定义、技能加载、MCP 接入和会话管理各有自己的入口,不能从其中一项已配置推断其余项都生效。
先用一个小任务检查调用了谁、读入什么、产出什么;需要更大范围的任务时,再检查交接与失败路径。
用一段可运行代码说明角色清单
这段标准库 Python 代码只构造四条角色说明并打印出来;tools 是标签列表,不会注册真实工具,也不会限制操作系统权限。
bash
from dataclasses import dataclass, field

@dataclass
class AgentRole:
    name: str
    responsibility: str
    tools: list[str] = field(default_factory=list)


def build_team() -> list[AgentRole]:
    return [
        AgentRole("Sisyphus", "orchestration", ["plan", "dispatch", "review"]),
        AgentRole("Hephaestus", "implementation", ["read", "write", "bash"]),
        AgentRole("Librarian", "documentation", ["search", "read"]),
        AgentRole("Oracle", "critique", ["review", "summarize"]),
    ]


def explain(team: list[AgentRole]) -> str:
    return "\n".join(f"- {role.name}: {role.responsibility}" for role in team)


if __name__ == '__main__':
    print(explain(build_team()))
如果我现在重新搭一套 AI 编码环境,我会怎么做
我会按这个顺序来:
- 先确定主编排模型
- 再确定执行模型
- 再定义 subagent 分工
- 再补技能系统
- 最后接 MCP 和浏览器能力
每增加一个入口,都应能说明它接收什么、如何报告失败、由谁核对结果。上述顺序是作者的起步建议,不是该版本安装器的执行步骤。
发布或合入前,怎样检查交付
检查一次交付时,可以沿下表核对目标、角色、依据、检查与收口:
| 检查点 | 查看什么 |
|---|---|
| 目标 | 任务输入与验收条件是否一致 |
| 角色 | 实际调用的执行者与修改范围是否对应 |
| 依据 | API 和配置说明是否指向所用版本 |
| 检查 | 报告中的测试是否真的运行,结果能否回查 |
| 收口 | 失败与未覆盖事项是否有人接手,是否到达约定停点 |
给检查表的每一项填上证据位置和负责人;角色名、流程图或模型自评不能替代运行结果。
作者的一次有边界自用记录
先说边界:这段记录来自今年五月,用的是当时版本的 OmO 系工具,角色命名与本文上文固定版本的表格不完全一致;这里只报告账本与回执能直接复核的机制。
作者在自己的 Python 仓库里用这套工具跑过一个多任务计划。任务账本登记了这轮计划的十余个会话,子任务分别交给 explore、Sisyphus-Junior 等代理;每个子任务在账本里有标题、所属会话和更新时间。这些记录保存在作者本地仓库的运行台账里,不随本文分发;读者不必采信具体数字,可按下面三样东西检查自己的记录。
事后回看,交接能不能复核取决于三样东西有没有留下:
- 任务账本:谁在哪个会话里领了哪个任务;
- 证据文件:环境检查输出和测试运行回执(结果为全部通过),而不是口头声称"测试通过";
- 工作笔记:每个工作流一份笔记,沉淀实现模式与踩坑。
这段经历与本文检查表一致的地方是:当需要对照"到底改了什么、检查是否真的跑过"时,这些记录能直接给出答案;缺了它们,多代理的产出只能靠信任。角色叫什么名字反而是最不重要的:五月那套命名与本文固定版本的表格不同,"账本+证据+笔记"的交接结构却可以直接迁移。
从一次有边界的任务开始
第一次试用时,可以只选一个需要改动少量文件的任务:写清目标,让执行者报告修改与检查,再由另一位审阅者核对验收条件。
记录发生了什么,再决定是否增加角色、替换模型或接入更多工具。这样的记录能回答这套分工对自己的项目有没有帮助。
参考资料
- OmO v3.12.2 README及同版本特性说明:本文角色与机制说明的版本依据。
- OpenCode 技能、代理与权限文档:按实际安装版本核对加载和动作授权。