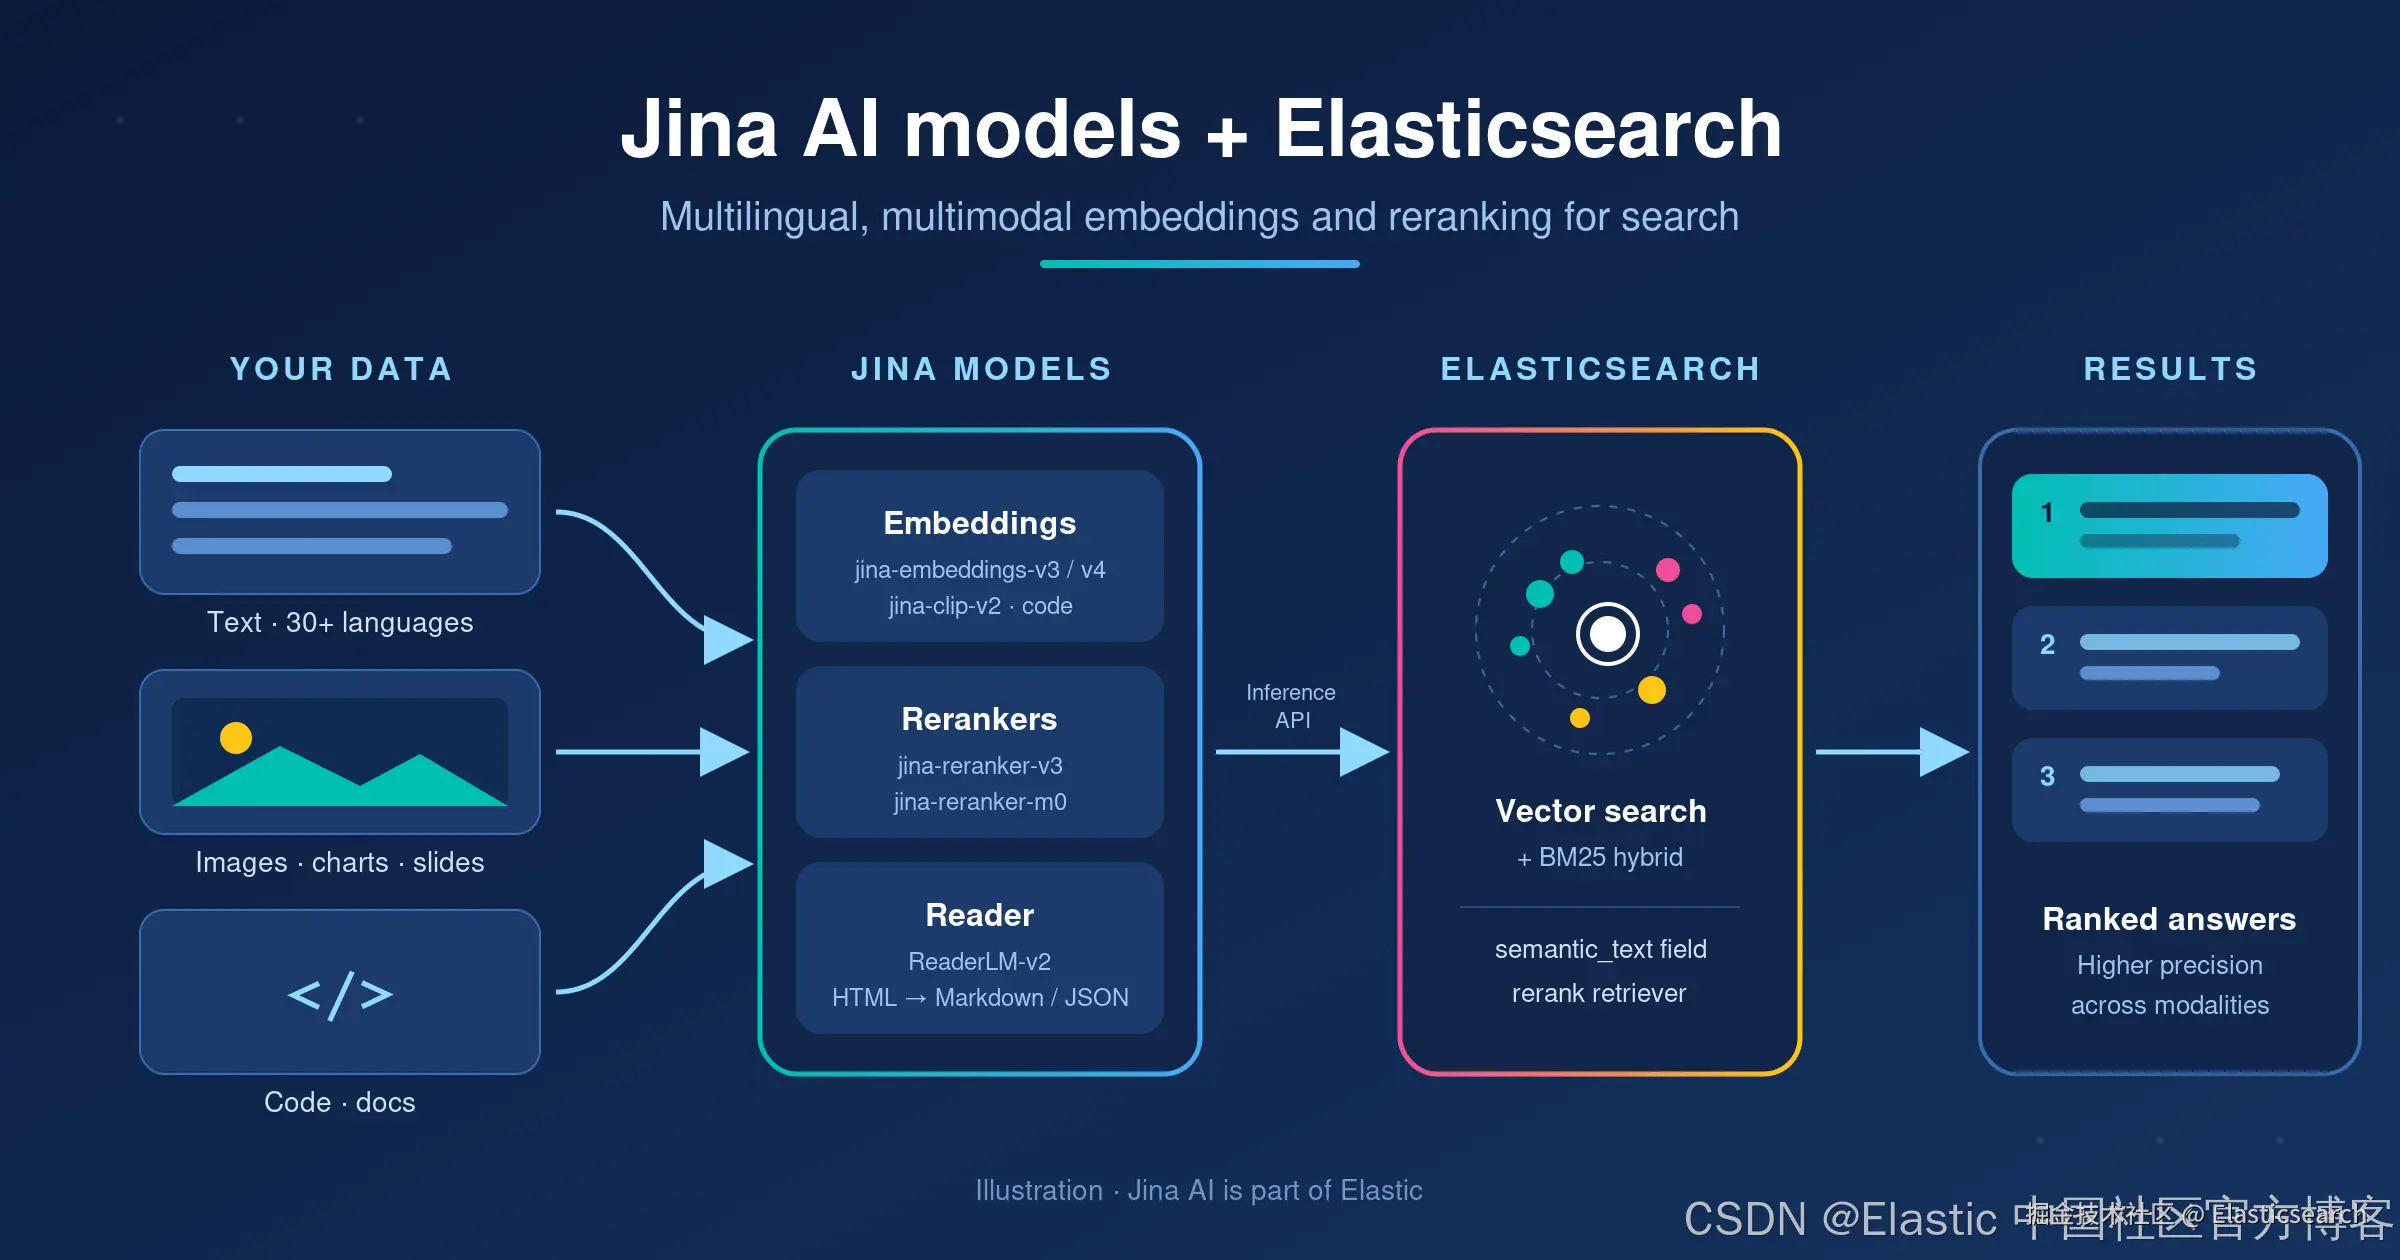
Jina AI 现已成为 Elastic 的一部分,将其高性能的多语言、多模态搜索 AI 与 Elasticsearch 强大的数据存储、检索和索引能力相结合。Jina AI 模型可通过公共 API 与 Elasticsearch 集成,并提供 1,000 万个免费 token 用于测试。
jina-embeddings-v4 是一款多语言、多模态嵌入模型,支持图像及 30 种主要语言的文本。该模型拥有 38 亿个参数,在同等规模的模型中达到领先水平,不仅擅长以文搜图,在文本到文本的任务中也表现出色。它在视觉文档检索方面尤为突出,能够处理图表、幻灯片、地图、屏幕截图、扫描件和示意图等常见图像类型,而这些恰恰是大多数 计算机视觉 模型的薄弱领域。
该模型支持最长 32,768 个 token 的文本输入,以及最高 2,000 万像素的图像输入。其关键创新之一是提供两种输出模式:
- 单向量嵌入------在统一的语义空间中,为文本和图像生成紧凑的文档嵌入。用户可在 128 至 2,048 维之间选择嵌入向量的维度,精度损失很小。较短的嵌入向量能够节省存储空间,提高索引和检索速度,但精度相对较低,因此用户可以自行权衡速度、计算资源和检索准确性。
- 多向量嵌入 ------嵌入向量的数量随输入规模变化:每个文本 token 对应一个 128 维向量,图像对应的向量数量则与图像大小成比例。这类嵌入适用于 "后期交互" 相似度计算。与单向量嵌入相比,多向量嵌入的数据量更大,比较时的计算开销更高,但能够实现更精确的匹配。
Jina AI 针对多种任务优化了该模型,并通过紧凑、可选的 LoRA 扩展模块支持以下三类用途:
- 非对称检索------在基于嵌入的检索中,对文档和查询文本采用不同的编码方式,可以获得更好的效果。Jina Embeddings v4 通过两个经过协同训练的独立 LoRA 扩展模块实现这一点:一个用于待索引的文档,另一个用于查询。
- 语义相似度------衡量两段文本在含义或主题上的接近程度。常见应用包括相关文档发现、去重和翻译对齐。
- 代码专用任务------针对计算机技术及编程语言的相似度任务,提供专门的处理方式和训练。
jina-embeddings-v3 是一款多语言、多用途的纯 文本嵌入 模型,支持最长 8,192 个 token 的文本输入,并可根据用户选择,生成 64 至 1,024 维的可变长度嵌入向量。这款紧凑模型的参数量不足 6 亿,尽管发布于 2024 年,但相对于其规模而言,性能依然出色。
Jina AI 为其训练了五个 LoRA 扩展模块,以支持四类任务:与上述 jina-embeddings-v4 类似,一个模块用于语义相似度,两个模块用于非对称检索,另外两个模块分别用于:
- 分类------将文本划分到不同类别,可用于情感分析、垃圾信息过滤、内容审核和欺诈识别等场景。
- 聚类------根据文本自身的分布特征确定其所属类别,常用于推荐系统、新闻聚合及类似任务。
jina-code-embeddings (0.5b & 1.5b) 是两款面向编程语言和框架的专用嵌入模型,参数量分别为 5 亿和 15 亿。两款模型都能为自然语言文本和 15 种编程语言的 代码生成 嵌入,支持最长 32,768 个 token 的输入。用户可以自行选择输出嵌入的维度:较小模型支持 64 至 896 维,较大模型支持 128 至 1,536 维。
它们提供五种针对特定任务的检索模式,为各类任务生成经过优化的查询和文档嵌入:
- 代码到代码------跨编程语言检索相似代码,用于代码对齐、代码去重,以及辅助代码移植和重构。
- 自然语言到代码------检索与自然语言查询、注释、描述和文档相匹配的代码。
- 代码到自然语言------为代码匹配相关文档或其他自然语言文本。
- 代码到代码补全------推荐相关代码,以补全或改进现有代码。
- 技术问答------为信息技术问题查找自然语言答案,非常适合技术支持任务。
jina-clip-v2 是一款同时支持文本和图像的多模态嵌入模型。经过训练,当文本描述图像内容时,两者会生成相似的嵌入向量,从而实现多模态匹配。任何已经支持文本嵌入的数据库,都可以直接使用该模型,支持通过文本查询检索图像。
该模型还经过专门训练,可作为高性能文本嵌入模型使用,广泛支持多种语言,文本输入 上下文长度 为 8,192 个 token。这使用户无须为文本到文本和文本到图像检索分别使用不同模型,从而降低成本。
输入图像会被缩放至 512 × 512 像素。
jina-reranker-m0 是一款多语言、多模态的成对文档重排序模型,采用更细粒度的"后期交互"分析来提高检索精度。它接收一个文本查询和两个候选项,并判断哪一个与查询更匹配。候选项可以是两段文本、两张图像,或一段文本与一张图像。该模型经过训练,支持幻灯片、屏幕截图和示意图等多种印刷及计算机生成的图形材料,为复杂搜索环境提供了提高精度的有效方法。图像的每条边均须至少为 56 像素;过大的图像会被缩小,使其生成的 28 × 28 像素图像块不超过 768 个。查询文本与候选文档的 token 总数不得超过 10,240。
jina-reranker-v3 是一款采用列表式重排序的多语言文本文档重排序模型,使用与 jina-reranker-m0 相同的"后期交互"方法,但会根据文档与查询的匹配程度,对整个文档列表重新排序。利用 AI 模型进行列表式重排序,适用于任何能够生成有限候选结果列表的搜索方式,而不仅限于基于 AI 的搜索。作为现有搜索方式的补充,它能够全面提高准确性,因此非常适合直接用于增强混合搜索和传统搜索系统。
该重排序模型仅适用于文本,支持总计 131,000 个 token 的输入,包括查询及所有待重排序的候选文档。
ReaderLM-v2 是一款小型生成式 语言模型 ,可根据用户提供的输出模式定义和自然语言指令,将 HTML(包括网页 DOM 树的转储内容)转换为 Markdown 或 JSON。该工具将 AI 引入数据预处理,能够智能处理网页抓取数据中杂乱的结构。在其专门针对的数据转换任务中,这款紧凑模型的表现优于 GPT-4。
入门指南
访问 Jina AI 网站,获取模型,以及有关调用 Web API 或自行下载和使用模型的说明。
教程与 Notebook
以下教程使用的是较早版本的 Jina AI 模型,新教程即将推出。