银行营销看板练习:四项指标、完整代码与交付边界
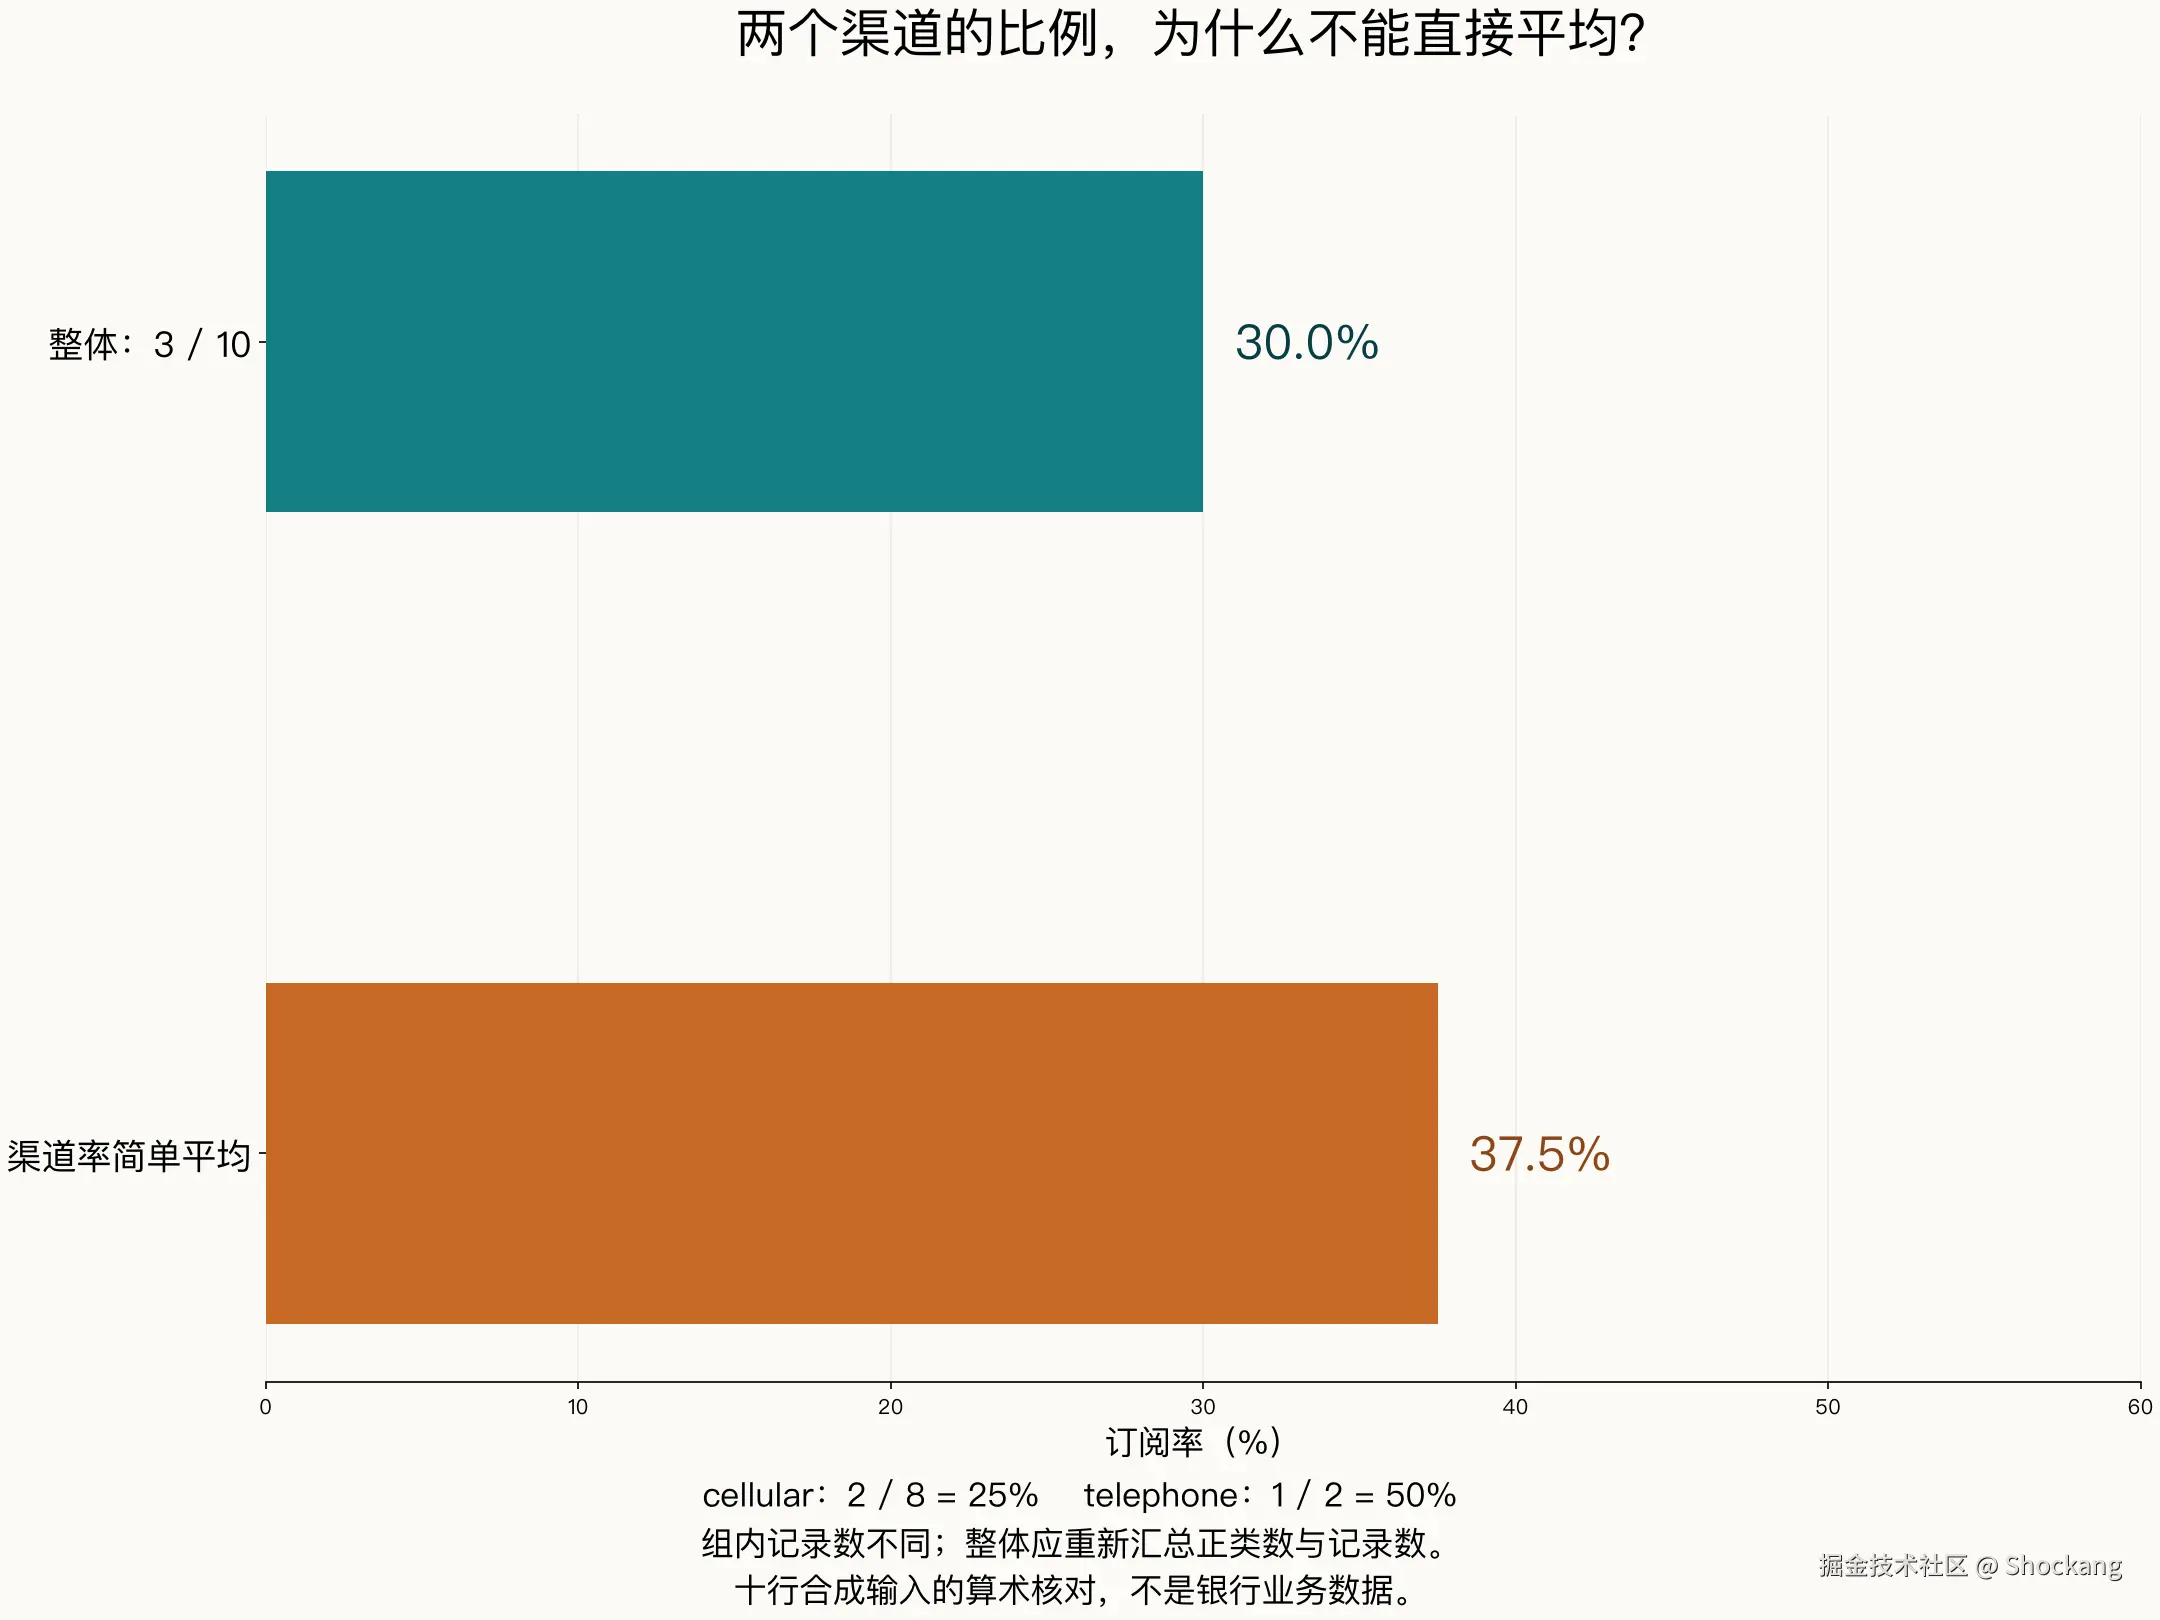
银行营销看板的四项指标,先要算对分母。cellular 渠道八条记录中有两条订阅,telephone 渠道两条记录中有一条订阅。把两组比例直接平均,会得到 37.5%;逐行统计的整体比例却是 30%。一个页面即使看起来完整,也可能从分母开始回答错问题。
下面从这组可手算的合成数据出发,给出完整 CSV、四指标共享计算、统一筛选、Node 回归和自包含 HTML 生成器。按第 2 节保存数据,第 5 节保存核心与生成器,第 6 节保存回归脚本,即可先检查计算与构建;第 7 节是尚未执行的可选托管方法。示例不下载银行数据,也不代表银行业务结果。
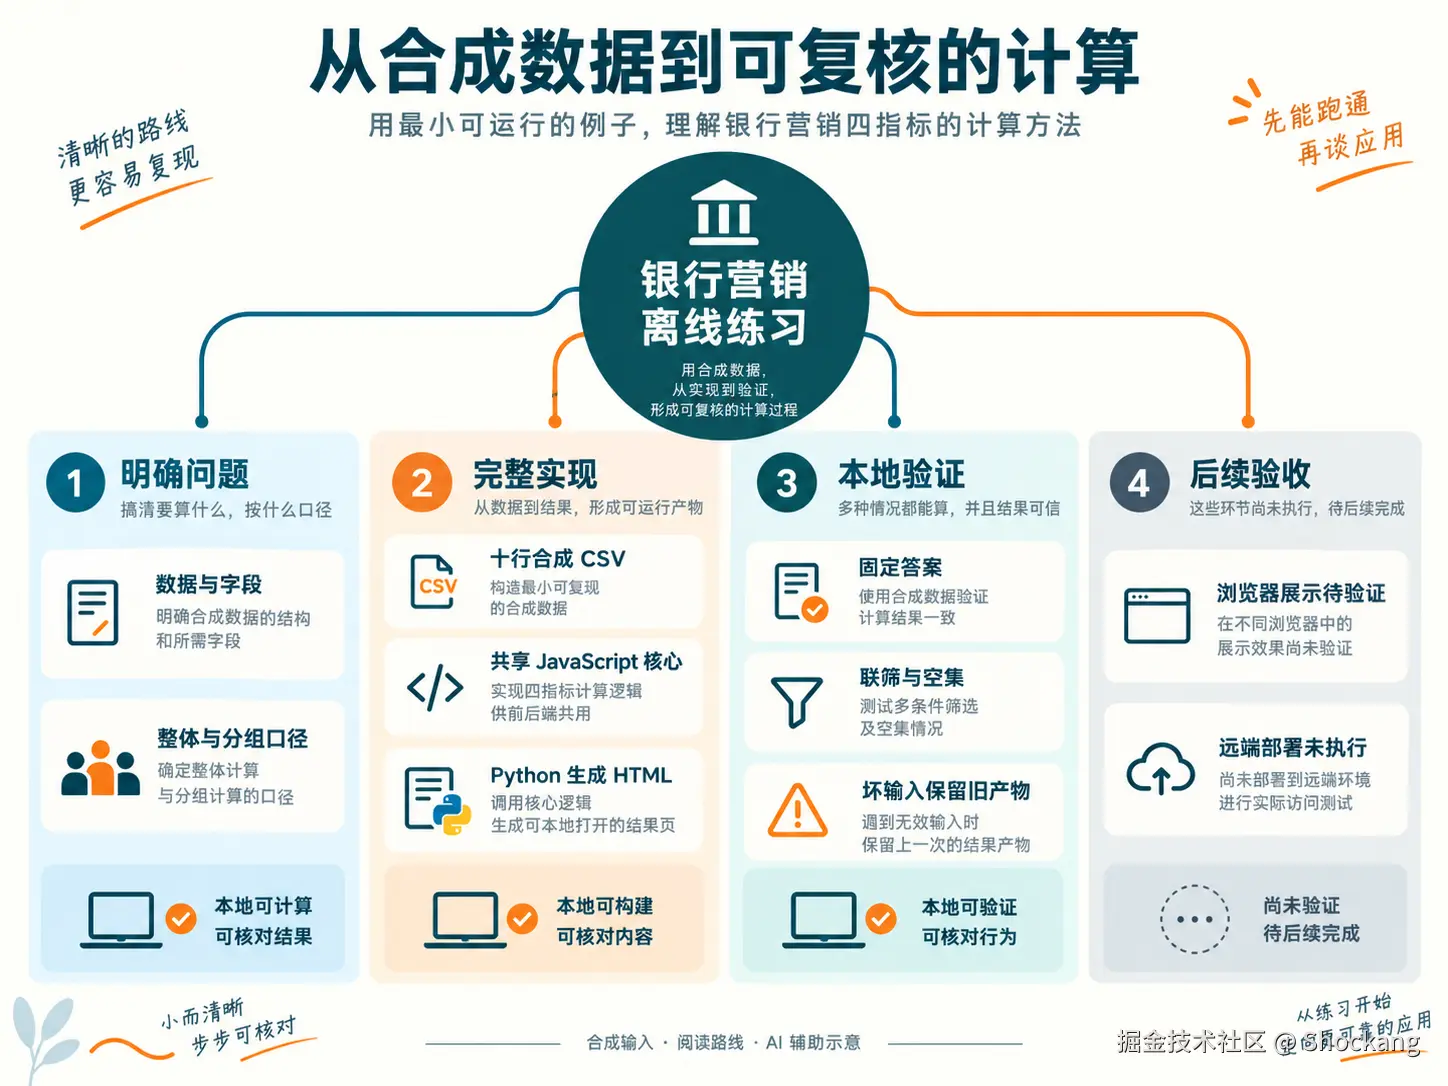
封面和阅读路线由 AI 辅助绘制,属于概念示意。两张数值图取自本文合成 CSV 与共享计算核心的实际输出;它们都不是银行业务结果或浏览器截图。
一、先决定看板交付什么,再决定让 Agent 做什么
拿到一份银行营销数据,业务同事常常提出一个合理却不够具体的要求:分析一下营销效果,做个能给团队看的页面。编程 Agent 可以很快生成页面,但"能打开"和"能据此讨论下一轮活动"之间还隔着指标定义、数据来源与解释边界。若先生成界面再补这些约束,返工往往从图表延伸到计算过程。
对照 UCI 的任务说明 与 Hub 的当前字段预览,可以确认结果围绕定期存款订阅,不能据此命名为保险投保或利润看板。这是资料核对得到的范围判断,不是应用运行结果。
本文的目标是一个探索性分析看板:帮助分析师检查已记录活动中的订阅结果、比较分组差异,并提出值得继续验证的问题。它不直接决定谁应收到营销电话,也不把历史相关性包装成下一轮收益承诺。这样的范围能把验证任务控制在一套明确的数据与计算之内。
把编程 Agent 放进流程之后,分析师仍要承担问题定义与结论审查。Agent 适合读取字段说明、整理计算、编写界面和执行检查;业务人员负责确认"订阅"究竟指什么、一条记录代表什么,以及看板受众可以看到哪些内容。这些职责应在开工前写清。
建议先写一张交付卡:面向谁、回答什么问题、使用哪份数据、允许做哪些操作、什么证据算完成。以本文为例,受众是营销分析团队,核心问题是不同历史分组的订阅结果有何差异;数据采用后文注明的合成夹具;操作限于读取、聚合和本地预览,私有部署单独经过审批。
一个常见误区是要求 Agent 一次解决全部问题:既做数据清洗,又预测客户,再设计视觉、上线应用并总结业务建议。更稳妥的拆法是让每一步提供下一步需要的最小材料:字段报告进入指标定义,指标契约进入聚合函数,聚合结果进入页面,验证记录进入审批材料。
本文交付四指标计算与离线看板原型:保存合成 CSV、共享计算脚本、生成器与回归脚本,得到自包含的 HTML。第 6 节集中列出这次实际验证的范围和仍需检查的项目。
| 交付对象 | 至少包含什么 | 谁确认 |
|---|---|---|
| 数据说明 | 版本、列名、标签、统计单位 | 分析师 |
| 指标契约 | 问题、公式、分母、筛选、限制 | 业务负责人 |
| 看板页面 | 指标、图表、样本数、筛选状态 | 使用者 |
| 验证材料 | 计算检查、页面检查、权限检查 | 工程与审批人 |
四指标的口径在第 4 节给出,合成夹具以 CSV 形式贴在第 2 节正文里,计算脚本在第 5 节,回归脚本在第 6 节;本节只描述交付卡应当包含哪些字段以及谁负责确认。
二、锁定同一份数据,先处理类别编码和版本差异
本轮主线不下载远端仓库,使用本文完整给出的合成夹具 bank-demo-v1.csv。它借用 UCI Bank Marketing 的电话直销与定期存款订阅主题,六列均为教学构造,不含真实客户记录,类别直接使用可读文本。原数据作者为 S. Moro、P. Rita 与 P. Cortez ,来源见 UCI Bank Marketing 页面,DOI 为 10.24432/C5K306。合成数值不来自该数据集的抽样或计算。
Hub 上的 cestwc/bank-marketing 数据预览 展示了 ClassLabel 类别编码;这是整理后仓库的表示方式,不能反推 UCI 原 CSV 也采用相同编码。整数代表类别编号,不代表业务大小。若代码把整数与 "yes" 直接比较,订阅记录会被算成否;若把学历编号当连续变量求平均,结果看似精确却没有业务含义。具体接口见 Datasets 特征说明。本轮合成夹具已直接使用可读字符串,省去这层解码;但在切换到真实仓库时仍要写一段映射,把整数编号按 feature.int2str 翻译回原始标签。
合成夹具的字段合同如下:
| 字段 | 取值 | 含义与首要检查 |
|---|---|---|
record_id |
r01--r10 等短字符串 |
合成行标识,仅用于排查夹具重复;不是原始 UCI 客户主键,不能据此声称跨记录去重 |
contact |
cellular、telephone、unknown |
联系渠道分组键;unknown 是业务语义类别,不是缺失值 |
campaign |
正安全整数 | 本轮活动联系次数;1/2/3+ 是本练习的展示分箱 |
job |
非空文本,如 admin.、technician、unknown |
职业分组键;未知职业作为可见分组保留 |
education |
secondary、unknown 等 |
保留的学历字段;本练习不按学历细分 |
y |
yes、no |
正类名称;空标签或新值需要阻断计算 |
夹具正文如下,正好十行,便于读者手算复核:
bash
record_id,contact,campaign,job,education,y
r01,cellular,1,admin.,secondary,yes
r02,cellular,1,technician,secondary,no
r03,cellular,2,admin.,secondary,no
r04,cellular,2,technician,secondary,no
r05,cellular,3,admin.,secondary,no
r06,cellular,4,technician,unknown,yes
r07,cellular,1,admin.,secondary,no
r08,cellular,3,unknown,secondary,no
r09,telephone,1,admin.,secondary,yes
r10,telephone,2,technician,secondary,no
生成器直接读取这份 CSV,回归脚本则内置了与它逐行一致的固定夹具副本,不会自动读取修改后的 CSV。若更改记录或标签,需要同步核对回归夹具与预期值,不能把旧夹具的通过日志当作新输入的验收记录。完整期望值集中在第 4 节,读者可以直接按行计数,再与第 6 节脚本比较。
真实数据版本里,pdays 的哨兵值和 day、month 的日期含义需要分开核对。已查看的 Hub 仓库 README 记载过 pdays 从 -1 改为 999 的转换,并合并另一版本的类别词表;它们不能直接套用原 CSV 的解释。页面预览只能提示需要核查,不能代替转换记录。本轮合成夹具不包含 pdays,因此不引入"未联系"这类歧义;若后续切换到真实仓库,应单独记录哨兵值含义,再决定是否进入核心指标。把月份和日号排到横轴上,并不会自动让数据获得时间序列的完整性。缺少年份时,不能据此构造同比、环比或跨年连续趋势;月份分组只能按其实际含义解释。
字段版本也必须逐列核对。本轮夹具只有上表六列,不含 balance、day、age,更没有就业或物价指标。已观察到的 Hub 提交为 79f9e4af31ff6ab9868cc57a0bec513a9d84b26a,可作为另行接入时的固定参考;本次没有下载它,也没有读取其运行时 .features。接入者仍须实际加载并核对 schema、类别映射与转换记录。数据名称相似,不能替代结构检查。缺列时应停止并报告,不能从记忆里补出一套"常见银行字段"。
另外,记录数不应直接改名为"独立客户数"。即使字段说明涉及客户,本夹具也没有提供足以支撑跨记录去重的稳定客户标识。看板应使用"记录数"或"当前样本数",直到业务方给出明确主键及去重规则。命名上的一个字,可能改变使用者对覆盖规模的理解。
Data Studio 适合先检查字段分布和类别,SQL Console 则可查看聚合查询,官方说明支持浏览器中的表格探索与查询,见 Data Studio 文档 和 SQL Console 文档。本轮主线不使用远端浏览器工作流,但保留这两条入口的说明,便于后续切换到真实仓库时直接走 Hub 自带的工具链。
| 字段组 | 本节使用的列 | 首要检查 |
|---|---|---|
| 客户属性 | record_id、job、education |
单位、类别映射、未知类别 |
| 账户与贷款 | 本练习未引入 balance、housing、loan |
余额含义、类别表达 |
| 联系情况 | contact、campaign |
当前活动与历史活动是否区分 |
| 结果 | y |
正类名称、编码、空值与异常值 |
unknown 不应被悄悄丢弃。它在本例中是字段合同允许的未知类别值,不等同于程序缺失值。删除这类记录会改变对应分母;比例可能升高、降低,或因分组为空而未定义,取决于被删记录的构成。合成夹具保留了 job=unknown 和 education=unknown:前者进入职业分组,后者保留在输入中,不用于四项指标分组。第 6 节的具名回归检查未知职业和构造的未知渠道;未设置学历分组用例。
三、本地环境先核对,远端接入另列
本地练习只需要 Python 标准库和已有 Node,无需登录平台。本次计算与构建使用 Python 3.13.12、Node 22.22.3,未安装额外包,也未启动 HTTP 服务;展示则另需允许打开本地 HTML 的浏览器。先在 CSV 所在目录检查输入与运行环境:
bash
# 在 bank-demo-v1.csv 所在目录执行
python -c "import csv,sys;print(sum(1 for _ in csv.DictReader(open('bank-demo-v1.csv',encoding='utf-8'))))"
node --version
第一条命令读取 CSV 并计数,第二条查询 Node 版本,都不请求远端。它们还不能验证字段与指标合同。
只复现离线计算时,可跳过以下远端接入说明,直接阅读指标定义。以后接入真实 Hub 仓库时,再按下表检查工具与权限。客户端出现集成名称或终端存在命令,都不能代替这些检查。
| 层次 | 检查方式 | 证据范围与边界 |
|---|---|---|
| 工具 | CLI 先运行 hf --help;MCP 另核服务地址与工具清单 |
CLI 安装不会自动启动 MCP;命令行或图形界面不决定读写能力 |
| 身份 | hf auth whoami |
仅确认当前账户,不能证明目标私有仓库可读 |
| 读取 | 对指定资源做只读访问与解析 | 只证明该目标可读,不证明具备写权限;读私有数据时限定最小权限 |
| 写入 | 另列创建、上传、修改可见性的目标和操作,确认命名空间与写入范围 | 远程变更须先获授权;创建后再删除仓库也属于外部变更 |
需要登录时,按 HF CLI 文档 所列浏览器授权或访问令牌流程操作,不把一种交互当成所有账户的唯一通路。CLI 与 MCP 的授权需各自核对;令牌权限类型见 访问令牌说明,还须结合团队账户设置确认。探索公开数据不必先创建私有 Space,本地生成页面也不需要组织管理权限。
给 Agent 的约束可以直接写成:"报告当前身份和可访问目标,不打印令牌;本轮只读取与本地验证,创建仓库、修改可见性和上传另列。"故障也按层定位:命令不存在查安装与路径,身份不符查认证,资源不可见查归属与授权,下载后解析失败查格式与依赖。本地示例没有远端请求,先从文件和脚本输出排查。
计算仍由版本化的共享核心负责:Node 通过 require 加载,HTML 内嵌同一份源码,不另写界面公式。把读取的版本、聚合结果与修改记录一起保存,并记下命令、解释器及依赖版本;远端身份检查另记结果,配置变更后重查。凭证缓存和完整环境变量不进入交付包。
四、把业务要求收敛成四项有分母的指标
银行营销看板的首轮指标可以保持简单:整体订阅率、渠道分组订阅率、联系次数分组订阅率,以及职业细分。四项都围绕同一个结果标签 y 展开,避免一开始引入没有金额、成本或客户标识支撑的收益率、资产增长与覆盖率。没有相应字段的指标,不应靠名字听起来合理就进入看板。
整体订阅率的分子是正类记录数,分母是当前筛选条件下的有效记录数。这里的"当前"很关键:页面加入筛选器以后,顶部数字到底随筛选变化,还是固定显示全量基准,必须提前决定。本轮看板同时展示两者,但用不同位置和标签区分:"当前样本"显示被筛选后的分子分母,"全量基准"保留未筛选的 10 条记录、3 条正类。两者都可以存在,但不能一个叫总计、另一个也叫总计,让用户自己猜。
渠道分组订阅率使用相同计算,只把记录按 contact 分组。每一组同时保留记录数、正类数和率,并保留 unknown 渠道。它回答"历史记录中不同渠道组的结果有什么差异",不回答"改用某渠道会带来多少提升"。渠道选择可能与客户、时间和活动策略有关,单张分组表不能隔离这些因素。
联系次数指标按 campaign 分组时,需要说明它表示本轮活动中的联系次数,并在映射版本核实后再解释取值。为了阅读,可以合并较高次数,但分组边界应固定并显示。本轮看板固定为 1、2、3+ 三个分箱,等同于把 campaign >= 3 的行折叠到一桶。不能每轮为了让曲线更平滑就改变分箱,然后继续使用相同图名;那实际上已经改变了问题。
职业细分可以帮助寻找下一步分析线索。建议首版只选一个主要维度,避免把多个类别交叉后产生大量小样本。高订阅率和高订阅数量是不同视角:一个很小的群体可能比例较高,但不代表对整体结果贡献最大。因此应让率与规模并排出现,而非只按率排序后直接贴上"最有价值客户"的标签。本轮夹具里 admin.、technician、unknown 三个职业各保留为可见分组,读者可以直接对照 CSV 检查每组数字。
| 指标 | 分子与分母 | 输出方式 | 主要限制 |
|---|---|---|---|
| 整体订阅率 | 正类记录/有效记录 | 总数、正类数、比例 | 仅描述当前样本 |
| 渠道差异 | 各渠道正类/各渠道记录 | 分组表,后续可加柱图 | 不能解释渠道因果效果 |
| 联系次数差异 | 各次数组正类/各组记录 | 固定分箱表及样本数 | 多次联系可能有选择偏差 |
| 客群细分 | 各职业正类/各职业记录 | 排序表及规模对照 | 小组比例可能不稳定 |
整体应把分子和分母分别相加,得到 3/10,即 30%;两项比例的简单平均 37.5% 给了两个规模不同的渠道相同权重。
按联系次数 1、2、3+ 分组后:1 次联系 4 条记录、2 条订阅(r01 与 r09),比例 50%;2 次联系 3 条记录、0 条订阅(r03、r04、r10),比例 0;3+ 次联系 3 条记录、1 条订阅(r05 3 次、r06 4 次、r08 3 次,仅 r06=yes),比例约 33.3%。三组相加:4+3+3=10 条、2+0+1=3 条,与整体的 10 条记录、3 条正类一致。
按职业细分:admin. 5 条记录、2 条订阅(r01、r09),比例 40%;technician 4 条记录、1 条订阅(r06),比例 25%;unknown 1 条记录、0 条订阅(r08),比例 0%。三组记录数 5+4+1=10,正类数 2+1+0=3,与整体一致。
第 5 节的共享核心应得到上述固定答案;第 6 节直接用这些答案作断言,避免另抄一份统计公式。
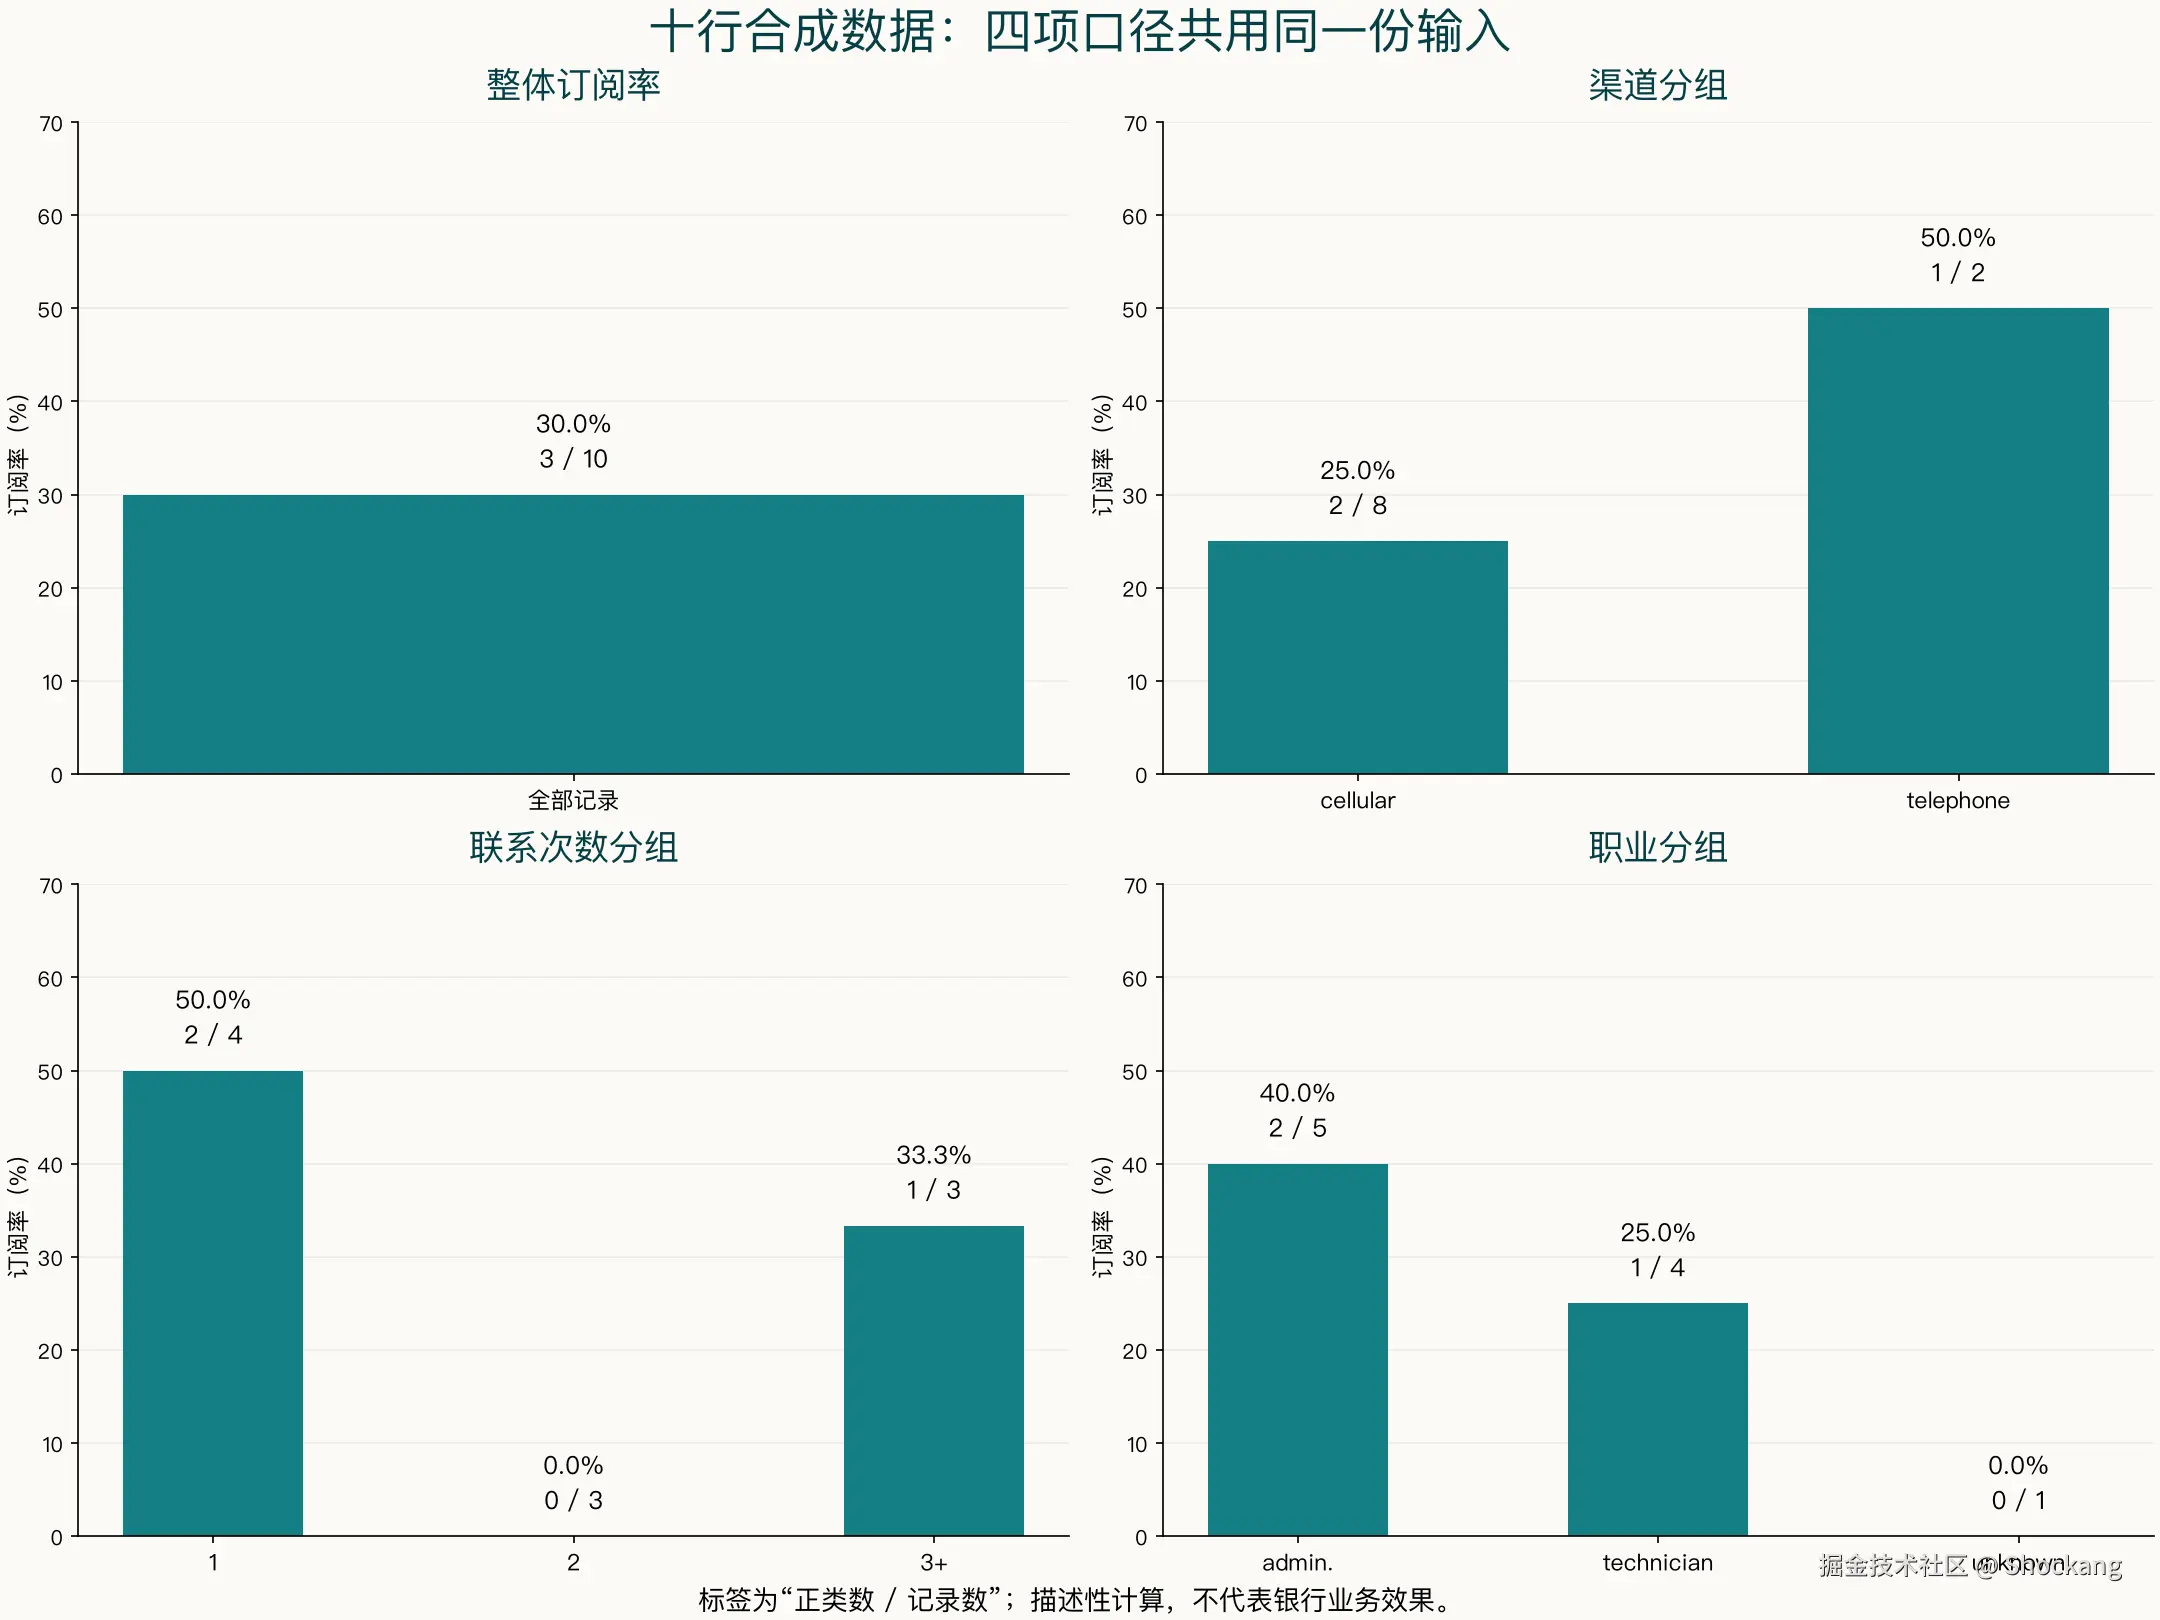
图中的"正类数/记录数"保留了每组分母;零比例组也有记录,和筛选后没有记录不同。
根据 UCI 的字段解释,campaign 与 previous 分属本轮和此前活动;结合 Datasets 的类别特征说明,分组前既要核业务时间范围,也要解码类别。把两个整数列直接放进同一个"联系次数"控件,会改变指标含义。这是字段审查结论,并非测得的转化差异。
每项指标还需要一段可执行的文字契约。例如:"渠道图使用当前筛选后的有效记录,按解码后的渠道名分组;未知渠道单列,空标签阻断计算;每组显示记录数与正类数;没有记录时显示无数据,不显示零订阅率。"这段话足够具体,Agent 才能把它转成计算与页面行为。
"没有数据"和"结果为零"尤其不能合并。若筛选后没有任何记录,订阅率是未定义;若存在记录但没有正类,订阅率才是零。用统一的零值填充会让用户误以为某个客群确实尝试过且完全失败。空状态应有一句说明,并提供恢复筛选的入口,而非生成一张空白图。本轮原型的"恢复默认"按钮将三个条件重置为空筛选,预期回到 10 条记录、3 条正类;这与筛选后没有记录是两种状态。第 6 节用回归核对重置的计算语义。
对于小样本,不必在教程里凭空规定一个通用可信门限。可以展示样本数、提醒不要只按率排序,并由业务方决定最低展示规模。若后续加入置信区间或显著性比较,需要明确统计方法和假设,不应让 Agent 把"率更高"自动改写成"显著更高"。指标契约可以先覆盖描述性分析,把推断任务作为单独工作。
另一个容易误加的指标是投资回报。数据里没有完整的营销成本、产品收益和资金留存,就不能计算业务意义上的回报率;余额也不能直接替代客户新增资产。同理,贷款字段不是保险类型,教育程度不是营销渠道,历史活动结果也不是当前结果。审查指标时,先查字段能否支撑业务名词,再检查公式是否算对。本节只保留四种描述性指标,收益率、覆盖率、回报率均不进入看板。
五、先得到可信的聚合表,再给它加界面
实现时把数据读取、标签解码、指标计算和页面渲染分开。第一个能验收的产物应是一张聚合表,而非截图。聚合表里至少有分组名、记录数、正类数和订阅率;页面只是它的另一个呈现方式。这样发现数字不对时,可以直接检查数据和计算,不必先拆界面代码。
下面的练习把这条原则落在离线文件上:同一份 dashboard-core.js 既被 Node 直接 require 跑回归,也被浏览器作为普通脚本加载,承担全部四指标计算与筛选。Python 只负责按标准库 csv 读 UTF-8 夹具,调用一次 Node 校验同一合同,然后生成一个完全自包含的 index.html。没有 pip install、没有 npm install、没有本地 HTTP 服务,也不连 Hub 或其他远端。第 7 节再讨论 Streamlit 与托管部署的可选路径,本节先验证无额外依赖的本地产物。
dashboard-core.js 是单一权威:四个指标(整体订阅率、渠道差异、联系次数差异、职业细分)都从同一份 selected 行集合重算;当前样本卡片与全量基准卡片分别持有自己的分子分母;筛选条件是 contact、job、campaign 三下拉的 AND 组合,分箱只由核心的 campaignBucket 定义。Node 端用 module.exports 暴露,浏览器端用同一脚本挂到 window,因此两组共用同一份公式,而不是再抄一份图表专用实现。
bash
// dashboard-core.js  Node 与浏览器共用同一份计算
(function (root, factory) {
  const api = factory();
  if (typeof module !== 'undefined' && module.exports) {
    module.exports = api;
  }
  if (typeof window !== 'undefined') {
    root.DashboardCore = api;
  }
}(typeof self !== 'undefined' ? self : this, function () {
  'use strict';
  const CONTACT_VALUES = ['cellular', 'telephone', 'unknown'];
  const Y_VALUES = ['yes', 'no'];
  const HEADER = ['record_id', 'contact', 'campaign', 'job', 'education', 'y'];
  const MAX_SAFE = Number.MAX_SAFE_INTEGER;

  function campaignBucket(value) {
    return value >= 3 ? '3+' : String(value);
  }

  function validateRows(rows) {
    if (!Array.isArray(rows)) throw new Error('rows must be an array');
    const seen = new Set();
    for (let i = 0; i < rows.length; i += 1) {
      const row = rows[i];
      if (row === null || typeof row !== 'object' || Array.isArray(row)) {
        throw new Error('row ' + i + ' is not an object');
      }
      const keys = Object.keys(row).sort().join(',');
      if (keys !== HEADER.slice().sort().join(',')) throw new Error('row ' + i + ' has unexpected fields');
      for (const field of ['record_id', 'contact', 'education', 'job', 'y']) {
        const v = row[field];
        if (typeof v !== 'string' || v.length === 0 || v !== v.trim()) {
          throw new Error('row ' + i + ' field ' + field + ' is blank or not canonical');
        }
      }
      if (seen.has(row.record_id)) throw new Error('duplicate synthetic row id: ' + row.record_id);
      seen.add(row.record_id);
      if (!CONTACT_VALUES.includes(row.contact)) throw new Error('row ' + i + ' unknown contact code');
      if (!Y_VALUES.includes(row.y)) throw new Error('row ' + i + ' unknown y label');
      const c = row.campaign;
      if (!Number.isInteger(c) || c < 1 || c > MAX_SAFE) {
        throw new Error('row ' + i + ' campaign is not a safe positive integer');
      }
      // unknown 是允许保留的语义类别,不在这里过滤。
    }
    return rows;
  }

  function count(rows) {
    const records = rows.length;
    if (records === 0) return {records: 0, positives: 0, rate: null};
    let positives = 0;
    for (const row of rows) if (row.y === 'yes') positives += 1;
    return {records: records, positives: positives, rate: positives / records};
  }

  function group(rows, keyFn) {
    const buckets = new Map();
    for (const row of rows) {
      const name = keyFn(row);
      if (!buckets.has(name)) buckets.set(name, []);
      buckets.get(name).push(row);
    }
    const out = [];
    for (const [name, values] of buckets) out.push(Object.assign({name: name}, count(values)));
    return out;
  }

  function compute(rows, filters) {
    validateRows(rows);
    const f = filters === undefined ? {} : filters;
    if (f === null || typeof f !== 'object' || Array.isArray(f)) {
      throw new Error('filters must be an object');
    }
    for (const k of Object.keys(f)) {
      if (!['contact', 'job', 'campaign'].includes(k)) throw new Error('unknown filter key: ' + k);
      if (typeof f[k] !== 'string') throw new Error('filter ' + k + ' must be string');
    }
    const selected = rows.filter(function (row) {
      if (f.contact && row.contact !== f.contact) return false;
      if (f.job && row.job !== f.job) return false;
      if (f.campaign && campaignBucket(row.campaign) !== f.campaign) return false;
      return true;
    });
    const baseline = count(rows);
    const total = count(selected);
    return {
      baseline: baseline,
      total: total,
      channels: group(selected, function (r) { return r.contact; }),
      campaigns: group(selected, function (r) { return campaignBucket(r.campaign); }),
      jobs: group(selected, function (r) { return r.job; }),
    };
  }

  return {validateRows: validateRows, compute: compute, count: count, group: group, campaignBucket: campaignBucket, HEADER: HEADER};
}));
生成器是单文件 Python 脚本,使用 csv.DictReader 与 json.dumps,不引入第三方依赖。CSV 不会替应用自动确认业务类型,因此先核对完整表头、每行列数与整数文本,再交给共享核心校验类别和安全整数范围。它先把夹具读成行对象,规范化 campaign 字段为正整数;接着通过标准输入传入 JSON,启动 Node 子进程调用 dashboard-core.js 的 validateRows 进行独立校验;只有 Node 校验通过,才允许覆盖 index.html,校验失败保留旧文件并以非零退出码报错。这样 Python 端不做裁决计算,Node 端不做 HTML 拼装,两个职责各管一段。
bash
#!/usr/bin/env python3
# build_dashboard.py: parse local CSV, validate with the shared JS, then emit one HTML.
import argparse
import csv
import json
from pathlib import Path
import re
import subprocess
import sys
import tempfile

ROOT = Path(__file__).resolve().parent
HEADER = ['record_id', 'contact', 'campaign', 'job', 'education', 'y']
NODE_CHECK = r"""
const fs = require('node:fs');
const core = require(process.argv[1]);
const rows = JSON.parse(fs.readFileSync(0, 'utf8'));
core.validateRows(rows);
console.log(JSON.stringify(core.compute(rows, {})));
"""

HTML_TEMPLATE = r"""<!doctype html>
<html lang="zh-Hans">
<head>
<meta charset="utf-8">
<title>银行营销看板 · 离线练习</title>
<style>
body{font-family:-apple-system,Segoe UI,Roboto,Helvetica,Arial,sans-serif;margin:24px;color:#222;background:#fafafa}
h1{margin:0 0 8px}
small#caption{color:#666;display:block;margin-bottom:16px}
section.cards{display:flex;gap:16px;flex-wrap:wrap;margin-bottom:24px}
.card{background:#fff;border:1px solid #e0e0e0;border-radius:6px;padding:12px 16px;min-width:180px}
.card h3{margin:0 0 4px;font-size:14px;color:#555}
.card .value{font-size:20px;font-weight:600}
.card .sub{font-size:12px;color:#777}
.filterbar{display:flex;gap:12px;flex-wrap:wrap;margin-bottom:24px;align-items:end}
.filterbar label{display:flex;flex-direction:column;font-size:12px;color:#444}
.filterbar select, .filterbar button{font-size:14px;padding:4px 8px}
table{border-collapse:collapse;background:#fff;width:100%;margin-bottom:24px}
th,td{border:1px solid #e0e0e0;padding:6px 10px;text-align:left;font-size:14px}
th{background:#f0f0f0}
.empty{color:#b00;background:#fff3f3;border:1px dashed #c66;padding:8px 12px;border-radius:4px;margin-bottom:12px}
.note{color:#666;font-size:12px;margin-top:8px}
</style>
</head>
<body>
<h1>银行营销看板 · 离线练习</h1>
<small id="caption">合成夹具 bank-demo-v1.csv · 描述性离线练习;不是银行实测结果。</small>
<section class="cards">
<div class="card"><h3>当前样本 · 记录数</h3><div class="value" id="total-records">-</div><div class="sub" id="total-positives">正类 0</div></div>
<div class="card"><h3>当前样本 · 订阅率</h3><div class="value" id="total-rate">-</div><div class="sub">仅描述当前选中行</div></div>
<div class="card"><h3>全量基准 · 记录数</h3><div class="value" id="baseline-records">-</div><div class="sub" id="baseline-positives">正类 0</div></div>
<div class="card"><h3>全量基准 · 订阅率</h3><div class="value" id="baseline-rate">-</div><div class="sub">生成时 CSV 的全部有效记录</div></div>
</section>
<div class="filterbar">
<label>渠道 contact<select id="filter-contact"><option value="">全部</option></select></label>
<label>职业 job<select id="filter-job"><option value="">全部</option></select></label>
<label>联系次数 campaign<select id="filter-campaign"><option value="">全部</option></select></label>
<button id="filter-reset" type="button">恢复默认</button>
<span id="filter-empty" class="empty" style="display:none">当前筛选无数据,订阅率未定义。</span>
</div>
<h2>渠道差异</h2>
<table id="table-channels"><thead><tr><th>contact</th><th>记录数</th><th>正类数</th><th>订阅率</th></tr></thead><tbody></tbody></table>
<h2>联系次数差异(campaign 分箱)</h2>
<table id="table-campaigns"><thead><tr><th>campaign 桶</th><th>记录数</th><th>正类数</th><th>订阅率</th></tr></thead><tbody></tbody></table>
<h2>客群细分 · job</h2>
<table id="table-jobs"><thead><tr><th>job</th><th>记录数</th><th>正类数</th><th>订阅率</th></tr></thead><tbody></tbody></table>
<script id="embedded-rows" type="application/json">__ROWS_JSON__</script>
<script>
__CORE_JS__
</script>
<script>
(function () {
  'use strict';
  const rows = JSON.parse(document.getElementById('embedded-rows').textContent);
  const core = window.DashboardCore;
  core.validateRows(rows);
  const distinct = function (key, bucket) {
    const set = new Set();
    for (const r of rows) set.add(bucket ? bucket(r[key]) : r[key]);
    return Array.from(set).sort();
  };
  const selectContact = document.getElementById('filter-contact');
  const selectJob = document.getElementById('filter-job');
  const selectCampaign = document.getElementById('filter-campaign');
  const emptyNote = document.getElementById('filter-empty');
  const resetBtn = document.getElementById('filter-reset');
  function fillSelect(sel, values) {
    for (const v of values) {
      const opt = document.createElement('option');
      opt.value = v;
      opt.textContent = v;
      sel.appendChild(opt);
    }
  }
  fillSelect(selectContact, distinct('contact'));
  fillSelect(selectJob, distinct('job'));
  fillSelect(selectCampaign, distinct('campaign', core.campaignBucket));
  function fmtRate(rate) {
    return rate === null ? '未定义' : (rate * 100).toFixed(1) + '%';
  }
  function fillTable(tbody, rows) {
    while (tbody.firstChild) tbody.removeChild(tbody.firstChild);
    if (rows.length === 0) {
      const tr = document.createElement('tr');
      const td = document.createElement('td');
      td.colSpan = 4;
      td.textContent = '无数据';
      tr.appendChild(td);
      tbody.appendChild(tr);
      return;
    }
    for (const row of rows) {
      const tr = document.createElement('tr');
      for (const cell of [row.name, row.records, row.positives, fmtRate(row.rate)]) {
        const td = document.createElement('td');
        td.textContent = String(cell);
        tr.appendChild(td);
      }
      tbody.appendChild(tr);
    }
  }
  function render() {
    const filters = {
      contact: selectContact.value,
      job: selectJob.value,
      campaign: selectCampaign.value,
    };
    const result = core.compute(rows, filters);
    document.getElementById('total-records').textContent = String(result.total.records);
    document.getElementById('total-positives').textContent = '正类 ' + result.total.positives;
    document.getElementById('total-rate').textContent = fmtRate(result.total.rate);
    document.getElementById('baseline-records').textContent = String(result.baseline.records);
    document.getElementById('baseline-positives').textContent = '正类 ' + result.baseline.positives;
    document.getElementById('baseline-rate').textContent = fmtRate(result.baseline.rate);
    emptyNote.style.display = result.total.records === 0 ? 'block' : 'none';
    fillTable(document.querySelector('#table-channels tbody'), result.channels);
    fillTable(document.querySelector('#table-campaigns tbody'), result.campaigns);
    fillTable(document.querySelector('#table-jobs tbody'), result.jobs);
  }
  selectContact.addEventListener('change', render);
  selectJob.addEventListener('change', render);
  selectCampaign.addEventListener('change', render);
  resetBtn.addEventListener('click', function () {
    selectContact.value = '';
    selectJob.value = '';
    selectCampaign.value = '';
    render();
  });
  render();
})();
</script>
</body>
</html>
"""


def read_rows(path):
    with path.open('r', encoding='utf-8', newline='') as stream:
        reader = csv.DictReader(stream, strict=True)
        if reader.fieldnames != HEADER:
            raise ValueError('CSV 表头必须为 ' + ','.join(HEADER))
        rows = []
        for raw in reader:
            if None in raw or any(value is None for value in raw.values()):
                raise ValueError('CSV 第 {} 行列数不匹配'.format(reader.line_num))
            value = raw['campaign']
            if not re.fullmatch(r'[1-9][0-9]*', value):
                raise ValueError('campaign 必须为无符号十进制正整数')
            campaign = int(value)
            if campaign > 2 ** 53 - 1:
                raise ValueError('campaign 超出 JavaScript 安全整数范围')
            rows.append({**raw, 'campaign': campaign})
    return rows


def validate_with_shared_core(rows, core_path):
    data = json.dumps(rows, ensure_ascii=False, allow_nan=False)
    result = subprocess.run(
        ['node', '-e', NODE_CHECK, str(core_path)], input=data,
        capture_output=True, text=True, timeout=15, check=False,
    )
    if result.returncode != 0:
        raise ValueError('共享 JS 校验失败:' + result.stderr.strip())
    return json.loads(result.stdout)


def write_html(rows, core_text, path):
    if '</script' in core_text.lower():
        raise ValueError('计算核心含 HTML 结束标签,拒绝直接内嵌')
    rows_json = json.dumps(rows, ensure_ascii=False, allow_nan=False).replace('<', '\\u003c')
    html = HTML_TEMPLATE.replace('__CORE_JS__', core_text, 1).replace('__ROWS_JSON__', rows_json, 1)
    temporary = None
    try:
        with tempfile.NamedTemporaryFile('w', encoding='utf-8', dir=path.parent,
                                         prefix='.dashboard-', suffix='.html', delete=False) as stream:
            temporary = Path(stream.name)
            stream.write(html)
        temporary.replace(path)
    finally:
        if temporary is not None and temporary.exists():
            temporary.unlink()


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument('--csv', type=Path, default=ROOT / 'bank-demo-v1.csv')
    parser.add_argument('--out', type=Path, default=ROOT / 'index.html')
    args = parser.parse_args()
    try:
        core_path = ROOT / 'dashboard-core.js'
        rows = read_rows(args.csv)
        summary = validate_with_shared_core(rows, core_path)
        write_html(rows, core_path.read_text(encoding='utf-8'), args.out)
    except (OSError, UnicodeError, ValueError, csv.Error, subprocess.SubprocessError) as error:
        print('生成失败,原输出未替换:' + str(error), file=sys.stderr)
        return 2
    print('已生成 {};记录数 {},正类数 {}'.format(
        args.out.name, summary['total']['records'], summary['total']['positives']))
    return 0


if __name__ == '__main__':
    raise SystemExit(main())
下面三步分别是准备夹具、生成 HTML 和查看文件。生成使用已有 Python 与 Node;查看另需允许打开本地 HTML 的浏览器:
bash
# 1. 准备夹具:把第 2 节公开的 10 行 bank-demo-v1.csv 放入同目录
# 2. 生成自包含 HTML
python3 build_dashboard.py
# 3. 浏览器本地 file:// 打开 index.html,不要起本地 HTTP 服务
生成器把核心原文放在页面脚本之前,数据通过内嵌 JSON 读取,动态文本用 textContent 设置;没有 fetch、CDN 或外部脚本。Node 回归与 HTML 内嵌核心可以逐字对照,CSV 校验失败时则保留旧 HTML。
如果改用其他展示框架,也要保留明确的数据入口:第 7 节讨论的 Streamlit 路径需要独立应用入口,但当前主线生成的 index.html 不能用 streamlit run 启动;同样,原 Datasets 路径仍可作为另一份适配,但本文正文不把它写成主线。切换时需显式导入加载与计算函数,在启动时处理异常。
回到不变量:所有 contact 分组的记录数之和等于当前样本记录数;各渠道正类数之和等于当前样本正类数;每组正类数不大于组内记录数;非空组比例处于 [0, 1]。compute 函数返回的结构里没有缓存过的"上一次结果",因此重置筛选后不会出现旧数残留。baseline 与 total 是两块独立的卡片,compute 先得到 selected 行集合,再从它生成 total 和三组分组表;result.total.records 是这个集合的记录数,不是另一个筛选入口。
unknown 列的保留与拒绝由契约显式决定:validateRows 允许 contact=unknown 与 job=unknown,因为这是合法的语义类别;同时拒绝集合外的渠道名、非正安全整数的 campaign 和重复的 record_id;布尔值也不能充当联系次数。对于字段合同以外的值,本例选择停止构建,不自动补空或补零。若切换到整数编码的 Hub 数据,应在转换前核对类别编号范围,并区分读取、解码与计算错误;日志保留字段名和异常类型,不打印凭证或敏感原始表。
把字段说明与聚合结果一起保存,页面检查完成后再补对应记录。下一节用回归场景核对共享核心的筛选语义。
六、用可复核的问题推动迭代,避免只改配色
筛选控件存在,不代表所有输出使用了相同输入。这里直接检查共享核心:同一组筛选条件必须同时影响当前样本、渠道表、次数表与职业表;全量基准则不随筛选改变。
首版完成后,评审应从业务问题开始,而不是先讨论哪个颜色更有科技感。请使用者按交付卡逐项寻找答案:整体结果在哪里,某渠道的样本规模是什么,联系次数分组如何定义,筛选之后哪些数会变化。如果找不到,就把缺失项转成具体的页面任务。
一轮反馈最好只覆盖一个主要目标。例如"让渠道比较更容易复核",可以拆成增加分母、固定排序、让图表与表格使用相同筛选、给未知渠道加说明。这些修改都服务于同一个问题,完成后可以对照验证。若同时要求换主题、加预测、改部署、优化性能,Agent 很难知道哪些原有行为必须保持。
针对本例,推荐的反馈顺序是数字一致性、阅读顺序、筛选行为、视觉细节。先让顶部卡片与表格对得上,再考虑柱图的颜色。只有确定统计逻辑稳定后,视觉反馈才不会在下一轮计算修正中作废。每轮变更都留下一个短记录:改了什么、为什么改、用哪项证据确认。
读者需要同时理解比例与数量。一个实用排版是上方显示比例图,下方保留对应表,并在图注注明"当前筛选样本"。离线版先用表格,让分子分母直接可见;如果后续加入双轴或多重视觉编码,应先确认受众能读懂,否则拆成相邻视图。空间占用不是唯一成本,误读和无法复核同样会消耗使用者时间。
筛选器必须有统一语义。选择某一职业后,整体订阅率表示该职业样本的结果,三张分组表也在同一子集上重算;若还要保留全量对照,就单独标注全量基准。跨图联动不是"控件能点"就完成,而是所有受影响图表都使用相同的过滤条件,并能恢复默认状态。
bash
本轮目标:让渠道比较可复核。
保持已确认的数据版本、正类映射和指标公式。
为每个渠道同时展示记录数、正类数和订阅率。
卡片、总览与三张表使用同一份筛选结果;全量基准另行标注。
补查:无筛选、单一渠道、空结果、未知类别、恢复默认。
交付:变更说明、复核数字与 Node 回归日志;不上传、不公开发布。
数字、异常展示与可读性都要检查。配色偏好可留待后续;分母、标签映射或权限出错时,则回到对应阶段修复并重验。
下一段把上面的检查场景落成一段 Node 回归脚本。它直接 require('./dashboard-core.js'),不复制任何分组公式,因此"页面改了,回归没过"能锁定到真实的代码改动,而不是另一份悄悄漂移的实现。脚本检查四指标的固定期望值、三维联筛、空集、恢复默认、未知类别和非法输入,并输出每个具名检查的结果。期望值直接来自第 2 节 CSV 的逐行计数;没有另写一套统计公式。
bash
// test_dashboard.cjs  Node 回归:直接 require 同一份 core,不复制公式
const assert = require('node:assert/strict');
const core = require('./dashboard-core.js');

const rows = [
  {record_id: 'r01', contact: 'cellular', campaign: 1, job: 'admin.',     education: 'secondary', y: 'yes'},
  {record_id: 'r02', contact: 'cellular', campaign: 1, job: 'technician', education: 'secondary', y: 'no'},
  {record_id: 'r03', contact: 'cellular', campaign: 2, job: 'admin.',     education: 'secondary', y: 'no'},
  {record_id: 'r04', contact: 'cellular', campaign: 2, job: 'technician', education: 'secondary', y: 'no'},
  {record_id: 'r05', contact: 'cellular', campaign: 3, job: 'admin.',     education: 'secondary', y: 'no'},
  {record_id: 'r06', contact: 'cellular', campaign: 4, job: 'technician', education: 'unknown',   y: 'yes'},
  {record_id: 'r07', contact: 'cellular', campaign: 1, job: 'admin.',     education: 'secondary', y: 'no'},
  {record_id: 'r08', contact: 'cellular', campaign: 3, job: 'unknown',    education: 'secondary', y: 'no'},
  {record_id: 'r09', contact: 'telephone', campaign: 1, job: 'admin.',    education: 'secondary', y: 'yes'},
  {record_id: 'r10', contact: 'telephone', campaign: 2, job: 'technician',education: 'secondary', y: 'no'},
];

const cases = [];
let passed = 0;
let failed = 0;
function check(name, fn) {
  cases.push({name: name, run: fn});
}
function expectThrows(fn, matcher) {
  let thrown = null;
  try { fn(); } catch (e) { thrown = e; }
  if (!thrown) throw new Error('expected throw, got none');
  if (matcher && !matcher.test(thrown.message)) {
    throw new Error('expected message matching ' + matcher + ', got ' + thrown.message);
  }
}

check('全量:整体订阅率与两渠道计数', function () {
  const out = core.compute(rows, {});
  assert.equal(out.baseline.records, 10);
  assert.equal(out.baseline.positives, 3);
  assert.equal(out.baseline.rate, 0.3);
  assert.equal(out.total.records, 10);
  const cellular = out.channels.find(function (c) { return c.name === 'cellular'; });
  const telephone = out.channels.find(function (c) { return c.name === 'telephone'; });
  assert.equal(cellular.records, 8);
  assert.equal(cellular.positives, 2);
  assert.equal(telephone.records, 2);
  assert.equal(telephone.positives, 1);
});

check('单组:只选 telephone → 1/2 = 50%', function () {
  const out = core.compute(rows, {contact: 'telephone'});
  assert.equal(out.total.records, 2);
  assert.equal(out.total.positives, 1);
  assert.equal(out.total.rate, 0.5);
  assert.equal(out.channels.length, 1);
  assert.equal(out.channels[0].name, 'telephone');
});

check('联筛:admin. & telephone → 1/1 = 100%', function () {
  const out = core.compute(rows, {contact: 'telephone', job: 'admin.'});
  assert.equal(out.total.records, 1);
  assert.equal(out.total.positives, 1);
  assert.equal(out.total.rate, 1);
});

check('联筛为空:job=retired → 0条记录,rate=null', function () {
  const out = core.compute(rows, {job: 'retired'});
  assert.equal(out.total.records, 0);
  assert.equal(out.total.positives, 0);
  assert.equal(out.total.rate, null);
  assert.equal(out.channels.length, 0);
  assert.equal(out.campaigns.length, 0);
  assert.equal(out.jobs.length, 0);
});

check('恢复默认:空筛选与原始全量一致', function () {
  const a = core.compute(rows, {});
  const b = core.compute(rows, {contact: 'telephone', job: 'admin.'});
  const c = core.compute(rows, {});
  assert.deepEqual(a.baseline, c.baseline);
  assert.equal(b.total.records, 1);
  assert.equal(c.total.records, a.total.records);
});

check('unknown 保留:job=unknown 单组', function () {
  const out = core.compute(rows, {job: 'unknown'});
  assert.equal(out.total.records, 1);
  assert.equal(out.total.positives, 0);
  assert.equal(out.total.rate, 0);
});

check('次数分组固定答案:1、2、3+', function () {
  const out = core.compute(rows, {});
  const byName = Object.fromEntries(out.campaigns.map(g => [g.name, g]));
  assert.deepEqual(byName['1'], {name: '1', records: 4, positives: 2, rate: 0.5});
  assert.deepEqual(byName['2'], {name: '2', records: 3, positives: 0, rate: 0});
  assert.deepEqual(byName['3+'], {name: '3+', records: 3, positives: 1, rate: 1 / 3});
});

check('职业分组固定答案:admin.、technician、unknown', function () {
  const out = core.compute(rows, {});
  const byName = Object.fromEntries(out.jobs.map(g => [g.name, g]));
  assert.deepEqual(byName['admin.'], {name: 'admin.', records: 5, positives: 2, rate: 0.4});
  assert.deepEqual(byName.technician, {name: 'technician', records: 4, positives: 1, rate: 0.25});
  assert.deepEqual(byName.unknown, {name: 'unknown', records: 1, positives: 0, rate: 0});
});

check('三维联筛与全量基准分离', function () {
  const out = core.compute(rows, {contact: 'cellular', job: 'admin.', campaign: '1'});
  assert.deepEqual(out.total, {records: 2, positives: 1, rate: 0.5});
  assert.deepEqual(out.baseline, {records: 10, positives: 3, rate: 0.3});
  assert.deepEqual(out.jobs, [{name: 'admin.', records: 2, positives: 1, rate: 0.5}]);
});

check('unknown 渠道保留', function () {
  const sample = rows.map(r => ({...r}));
  sample[0].contact = 'unknown';
  const out = core.compute(sample, {contact: 'unknown'});
  assert.deepEqual(out.total, {records: 1, positives: 1, rate: 1});
  assert.equal(out.channels[0].name, 'unknown');
});

check('所有分组保全当前记录数和正类数', function () {
  for (const filters of [{}, {contact: 'cellular'}, {job: 'retired'}, {campaign: '3+'}]) {
    const out = core.compute(rows, filters);
    for (const key of ['channels', 'campaigns', 'jobs']) {
      assert.equal(out[key].reduce((n, g) => n + g.records, 0), out.total.records);
      assert.equal(out[key].reduce((n, g) => n + g.positives, 0), out.total.positives);
      for (const g of out[key]) {
        assert.ok(g.positives <= g.records);
        assert.ok(g.rate >= 0 && g.rate <= 1);
      }
    }
  }
});

check('非法 y 标签拒绝', function () {
  expectThrows(function () {
    core.validateRows([{record_id: 'b01', contact: 'cellular', campaign: 1, job: 'admin.', education: 'secondary', y: 'maybe'}]);
  }, /unknown y label/);
});

check('重复 record_id 拒绝', function () {
  expectThrows(function () {
    core.validateRows([
      {record_id: 'dup', contact: 'cellular', campaign: 1, job: 'admin.', education: 'secondary', y: 'yes'},
      {record_id: 'dup', contact: 'telephone', campaign: 1, job: 'admin.', education: 'secondary', y: 'no'},
    ]);
  }, /duplicate synthetic row id/);
});

check('campaign 非正安全整数拒绝', function () {
  expectThrows(function () {
    core.validateRows([{record_id: 'b02', contact: 'cellular', campaign: Number.MAX_SAFE_INTEGER + 2, job: 'admin.', education: 'secondary', y: 'no'}]);
  }, /safe positive integer/);
});

check('campaign 为布尔拒绝', function () {
  expectThrows(function () {
    core.validateRows([{record_id: 'b03', contact: 'cellular', campaign: true, job: 'admin.', education: 'secondary', y: 'no'}]);
  }, /safe positive integer/);
});

check('contact 非法编码拒绝', function () {
  expectThrows(function () {
    core.validateRows([{record_id: 'b04', contact: 'email', campaign: 1, job: 'admin.', education: 'secondary', y: 'no'}]);
  }, /unknown contact code/);
});

for (const c of cases) {
  try {
    c.run();
    passed += 1;
    console.log('ok  ', c.name);
  } catch (e) {
    failed += 1;
    console.log('FAIL', c.name, '-', e.message);
  }
}
console.log('---');
console.log('passed=' + passed, 'failed=' + failed, 'total=' + cases.length);
process.exit(failed === 0 ? 0 : 1);
执行命令与第 5 节共用同一份 dashboard-core.js,不另起一份镜像实现:
bash
node test_dashboard.cjs
# 期望看到 passed=16 failed=0 total=16
本次本地复现记录。 我在 Python 3.13.12 与 Node 22.22.3 下运行了正文中的生成器与回归脚本。生成器输出 已生成 index.html;记录数 10,正类数 3,公开回归输出 passed=16 failed=0 total=16;这是具名检查数,不是浏览器测试数。另用错误表头、缺列、额外列、重复行标识、非法标签与联系次数等输入检查构建拒绝,退出码为 2,预先保存的旧输出保持不变。只有表头而无数据行是合法空输入,会生成空数据产物。静态检查还核对了脚本加载先后、引用的元素 ID 和动态文字写入方式。
下面是这次运行的可解析摘要。文件校验值对应上面公开的四个输入和源码文件,读者保存时应保留围栏内原始空格与行末换行,再核对是否为同一版本;校验值用于比对内容,不能证明运行者身份。
bash
{
  "captured_on": "2026-10-16",
  "python": "Python 3.13.12",
  "node": "v22.22.3",
  "source_files_sha256": {
    "bank-demo-v1.csv": "6da73eca85f3b0e3c723036a2c2102cc5edeae25ec67a9684b8454f39b68c0fc",
    "dashboard-core.js": "a5a09c9f13e3a27dbb2c9137dca0cef28d08f1a3695432b36d136356193370f9",
    "build_dashboard.py": "bc2bb521eb11ca9888c41bbb4d7962afb46cdc6414dac41cb344ebedc1396b04",
    "test_dashboard.cjs": "00ee26180c68ac30dfe17414851b271aad5b309103d9434630e782a5376016c9"
  },
  "builder": {
    "returncode": 0,
    "stdout": "已生成 index.html;记录数 10,正类数 3\n",
    "stderr": ""
  },
  "named_node_checks": {
    "returncode": 0,
    "stdout": "ok   全量:整体订阅率与两渠道计数\nok   单组:只选 telephone → 1/2 = 50%\nok   联筛:admin. & telephone → 1/1 = 100%\nok   联筛为空:job=retired → 0条记录,rate=null\nok   恢复默认:空筛选与原始全量一致\nok   unknown 保留:job=unknown 单组\nok   次数分组固定答案:1、2、3+\nok   职业分组固定答案:admin.、technician、unknown\nok   三维联筛与全量基准分离\nok   unknown 渠道保留\nok   所有分组保全当前记录数和正类数\nok   非法 y 标签拒绝\nok   重复 record_id 拒绝\nok   campaign 非正安全整数拒绝\nok   campaign 为布尔拒绝\nok   contact 非法编码拒绝\n---\npassed=16 failed=0 total=16\n",
    "stderr": ""
  },
  "scope": "Node计算与CSV构建;不含浏览器、远端部署或真实银行数据运行。"
}
本次验证范围集中列在这里。计算、构建与静态接线检查有实际记录;页面展示及远端运行各有独立的验收要求。
| 对象 | 本次状态 | 仍须区分什么 |
|---|---|---|
| Node 计算、CSV 构建与静态接线 | 已本地执行 | 公开文件、输入与运行摘要对应同一版本 |
| 浏览器渲染、点击、键盘、窄屏布局及本地文件权限 | 未验证 | 计算通过不能代替界面验收;没有页面截图或点击记录 |
| 真实银行数据、远端登录、构建、部署及访问权限 | 未执行 | 文档参考和配置片段不能代替真实数据或服务结果 |
回归失败时,先对照 CSV、指标契约和实际输出定位原因:可能是输入错误,也可能是计算或测试本身有误。修复后重新生成 HTML 并执行回归;只有指标契约确实改变,才应相应修改预期值,不能为了让测试变绿而跟着错误实现改答案。
下表把反馈卡约定的五种场景与回归断言对应,逐项核对计算层。
| 场景 | 当前样本应如何变化 | 对应回归断言 |
|---|---|---|
| 选择 telephone | 2 条记录、1 条正类,50% | 单组:只选 telephone → 1/2 = 50% |
| 同时选择 telephone 与 admin. | 1 条记录、1 条正类,100% | 联筛:admin. & telephone → 1/1 = 100% |
| 空结果 | 0 条记录,订阅率未定义 | 联筛为空:job=retired → 0条记录,rate=null |
| 恢复默认 | 10 条记录、3 条正类,30% | 恢复默认:空筛选与原始全量一致 |
| 未知类别保留 | job=unknown:1 条记录、0 条正类 | unknown 保留:job=unknown 单组 |
图表选择也跟着问题走:比较渠道或职业组可以使用柱图,但需要清楚展示排序依据;联系次数可以使用有序分组,避免把类别按字符排序。离线版先用表格承担比较与排序,等统计稳定再决定是否换图。饼图并不是结果标签的必选项,类别较少也不意味着它一定比带数字的条形图更容易比较。
分享前先检查产物中究竟放了什么。HTML 内嵌完整输入行,收到文件的人可以直接读取它们;页面筛选只是展示条件,不是行级授权。因此这里只放合成数据,不能把私有数据嵌入文件后依赖下拉框隐藏。构建器会拒绝不符合字段合同的输入,但格式合法不等于业务数据获得了分享授权。
这一节留下 test_dashboard.cjs 与日志,与第 5 节生成的 index.html 组成同一版本的材料。下一节讨论可选托管方案,第 8 节列出完整文件和复现顺序。
七、准备私有部署时,分别核对代码、应用与数据权限
私有部署这一步要做三件事:把代码、运行中的应用、应用读取的数据三层权限区分清楚;参照 Hugging Face 当前的官方文档选择运行时形态;在动手前明确停下审批。本文的合成数据与本地计算可以离线复现;下面按官方文档列出可选部署方案,创建远端资源前仍需取得团队授权。
7.1 运行时形态:官方建议已从 sdk: streamlit 切换到 Docker
Hugging Face 已弃用 Spaces 内置的 Streamlit SDK,新建 Streamlit 项目应采用 Docker SDK 与 Streamlit 模板,见 Streamlit Spaces 说明。新项目不应再沿用 sdk: streamlit 入口。
采用 Docker 路径时,运行时的依赖与启动都要放进仓库:包括 requirements.txt、Dockerfile、应用入口脚本以及与启动命令匹配的端口。托管平台不会替项目自动安装看板所需的所有依赖,主程序之外的库需要自己写清单并验证版本。下面 Dockerfile 的最小片段给出端口、UID 1000 运行用户和入口命令的一致要求,可作为起点,但不应当成生产安全模板,更多规则见 Docker Spaces 配置。
bash
---
title: Bank Marketing Dashboard
sdk: docker
app_port: 7860
---
bash
FROM python:3.11-slim
RUN useradd -m -u 1000 appuser
USER appuser
ENV PATH="/home/appuser/.local/bin:${PATH}"
WORKDIR /home/appuser/app
COPY --chown=appuser:appuser requirements.txt .
RUN pip install --no-cache-dir --user -r requirements.txt
COPY --chown=appuser:appuser . .
CMD ["streamlit", "run", "app.py", "--server.address=0.0.0.0", "--server.port=7860"]
这份片段面向另行编写的 Streamlit 应用,需提供 app.py 与经过验证的 requirements.txt。两条路径的环境身份如下,不能用其中一条的记录证明另一条已跑通。
| 路径 | Python 与依赖 | 本文证据范围 |
|---|---|---|
| 本地 CSV 与 HTML | Python 3.13.12 标准库、Node 22.22.3 | 计算、构建与回归已执行 |
| Docker/Streamlit 参考 | python:3.11-slim,另行准备和验证 requirements.txt |
未构建镜像,未安装该依赖,未部署 |
端口、运行用户与监听地址须一致;依赖锁定、健康检查、构建缓存和镜像扫描按团队基线补全。已有容器基线时沿用基线,只调整应用入口。
本文的 index.html 内嵌 HTML/CSS/JS,托管时可另选 Static Spaces:使用 sdk: static 提供 index.html。它与上面的 Docker/Streamlit 是两套方案;当前文件不需要 Python 服务来展示。
7.2 把权限拆成三层分别核对
部署前需要把三层权限在表里写清:Space 源码仓库谁能读、运行中的应用谁能打开、应用读取的数据仓库谁能访问。它们不是同一个问题,下面表格是对照的起点。
| 权限层 | 需要核对的项 | 失败模式 |
|---|---|---|
| Space 源码 | 仓库可见性、协作者列表、提交权限 | 仅凭"代码看不到"误判应用私密 |
| 运行应用 | Space 可见性、构建状态、监听端口、健康检查 | 误把构建成功当作访问控制到位 |
| 数据访问 | 数据仓库可见性、令牌范围、最小权限、Secrets 配置 | 进程拥有读取权限就以为每个访问者都能看全量 |
公开演示可以采用公开数据来简化接入,但真实业务数据进入应用前必须单独审批;即使后台进程拥有读取权限,也不意味着每个打开页面的人都应该看到全部数据。对于有服务端的应用,凭证应通过 Secrets 等受控配置注入,非敏感设置可使用 Variables;两者都不能替代具体访问控制。对于 Static Spaces,客户端拿到的代码、变量与内嵌数据应按可被访问者读取处理,不能放保密 CSV 或令牌。把令牌另抄进 Dockerfile、README、截图或构建日志会泄露那份副本,即使原先正确使用了 Secrets。
7.3 private 与 protected 是两套不同的可见性
判别可见性时,要分别看源码仓库和运行应用两栏,因为 protected 与 private 的处理方式不同。Spaces 可见性说明 给出三种状态:public 公开所有;protected 的源码仅所有者及协作者可见,但运行应用仍公开可访问;private 同时把源码和应用限制给所有者与协作者。本文不创建任何 Space,下面表格是按官方说明摘出的对照,便于在创建前逐项勾选。
| 可见性 | 源码 | 运行应用 | 适用场景 |
|---|---|---|---|
| public | 所有人可见 | 公开可访问 | 演示和公开看板 |
| protected | 所有者与协作者 | 仍可公开访问 | 想隐藏源码但仍让外部使用 |
| private | 所有者与协作者 | 仅所有者与协作者 | 内部 Beta 或数据敏感场景 |
验收私有部署时,除核对仓库列表,还须使用未授权账号检查应用访问是否被拒绝;不能仅以"代码看不到"推断应用也已私有。
7.4 资源、计费、说明文档会变,不要把价格当结论
账号档位、可用运行资源、计费条件会随时间变化,部署前应打开官方页面确认当前账户和组织是否满足要求。看板方案里保留"需核实资源和费用"一项即可,不要把某个历史价格或档位写成永久结论,更不要替团队承诺一定可以开通。
7.5 验证不只在构建,还要看运行
构建成功还不算完成验收。还应在部署完成之后检查应用启动、页面加载、数据版本、筛选计算、访问限制:用拥有权限的账号核验应用对协作者呈现的内容,用没有权限的账号核对访问被拒绝后的行为,把这两份证据分别保留。任一项无法检查就写明未验证,不能拿一个可打开的链接替代全部验收。
7.6 本轮的停止点:部署准备完成,不是私有服务已上线
远端操作止于本节配置参考。提交审批时附上具体代码版本、依赖清单、目标可见性与尚待完成的访问检查,再由团队决定是否推进。
取得授权后,再按选定方案创建远端资源、上传产物、配置凭证与可见性,并保存实际构建和访问检查结果。
八、把验证材料与正文一起交付,保留方法的适用边界
交付物的可信度来自能否被复核:页面要展示的数字能在聚合表找到,聚合表能追到计算函数,函数又能追到固定版本的合成数据与字段映射。若做不到这一点,正文和代码只是叙述,不构成可参考的工程示例。下面把交付物拆成四个相互衔接的部分:产物清单、复现步骤、回归证据、边界说明。
8.1 产物清单与版本绑定
复制保存四个源码与数据文件,运行生成器后得到 index.html;交付时合在一起,共五个文件:
| 路径 | 角色 | 主要内容 |
|---|---|---|
bank-demo-v1.csv |
数据夹具 | 10 行合成记录,6 列表头固定,无客户标识 |
dashboard-core.js |
计算核心 | validateRows、compute、campaignBucket 等函数 |
build_dashboard.py |
生成脚本 | Python 标准库解析 CSV,Node 子进程校验,渲染 index.html |
test_dashboard.cjs |
回归脚本 | Node 直接 require('./dashboard-core.js'),核对固定期望、筛选与拒绝边界 |
index.html |
自包含产物 | 内嵌 CSS/JS/合成数据,单文件浏览器 file:// 打开 |
每个制品都要绑定到一组标识:CSV 头与字段映射、dashboard-core.js 的版本、Python 脚本调用的 Node 命令、Node 实际版本与操作系统。修改分母或类别映射属于计算变更,需要重新生成 index.html 并重跑回归;只改一句标题文案属于表现层变更,不必再次下载数据。
8.2 复现步骤与依赖范围
复现所需的全部命令按顺序列出,便于在没有安装额外依赖的环境下逐行核对:
bash
# 1. 准备产物
python3 build_dashboard.py # 写入 index.html;失败保留旧文件
node test_dashboard.cjs # 期望输出全部 pass

# 2. 浏览器本地打开(不需要 HTTP 服务)
open index.html # macOS
xdg-open index.html # Linux
start index.html # Windows
生成器只调用已有 Python 标准库与 Node,产物内嵌合成数据和共享核心。查看文件的步骤如上;若选择托管,再按第 7 节核对运行时、资源与访问权限。
8.3 三个验证层次与六类最低场景
验证不只看一份截图。建议把验证分成三个层次,它们相互衔接,前一层不通过后一层的漂亮截图不能替它作证。
| 层次 | 范围 | 失败处置 |
|---|---|---|
| 数据层 | 字段、类型、标签、特殊值、实际行数 | 不进入计算层,回到夹具修正 |
| 计算层 | 分子分母、分组求和、空集处理、筛选一致性 | 不进入交付层,回到核心函数修正 |
| 交付层 | 页面展示的版本、权限、审批材料与最后一次修改的对应 | 把未通过项写进待审材料 |
下面的清单区分应检查的情形与应保存的证据;它不是本次全部通过的声明。代码或输入变化后,要重核受影响部分。
| 检查场景 | 预期行为 | 需要保留的证据 |
|---|---|---|
| 正常输入 | 四项指标可计算并互相核对 | 聚合表与检查结果 |
| 标签或字段变化 | 明确停止,不默默补值 | 错误类型与字段报告 |
| 筛选为空 | 显示无数据,不生成零比例结论 | 页面与过滤条件 |
| 未知类别出现 | 按契约保留或报告 | 类别统计与映射 |
| 修改后再生成 | 数字与版本仍能对应 | 变更记录与复核证据 |
| 未获审批 | 仅保留待审制品 | 待审状态与绑定版本 |
8.4 描述、预测、决策要分清
对结果的口径要保持克制。dashboard-core.js 在筛选后的样本上输出一组描述性指标:当前样本记录数、正类数、订阅率,以及按渠道、联系次数分桶、职业分组的细分。这些指标描述的是合成数据上的历史样本。预测用户下一轮订阅概率需要另行设计训练、验证与评估;营销投放决策需要考虑成本、策略与业务约束,一个看板无法承担后两项的口径。
duration 是一个清楚的边界例子。UCI 字段说明把通话时长定义为最后一次联系的持续时间(见 UCI 字段说明),在通话结束之前通常无法知道本次通话时长。如果问题换成"拨打前预测谁会订阅",就必须重新审查特征可用时间;不能把事后特征放进事前特征。多次联系组的订阅率较低也不能直接建议"减少联系一定提高转化",因为可能是较难转化的对象被继续联系。
提出下一步要研究的问题与作出业务建议之间的差别也要写明。dashboard-core.js 能够支撑"不同组的联系策略存在差异,需要进一步检查"这一问句;要回答"这个策略是否有效",还需额外的研究设计和数据。
8.5 工程边界与隐私边界
数据进入应用之后,可能落到多个位置:内存、缓存、日志、外部模型调用。每条通路都要按团队规则评估。私有仓库提供的是访问限制,不等于所有数据处理问题都已解决。探索阶段优先使用公开或脱敏数据;真实客户数据是否允许进入某个服务,应由已有授权决定,不由 Agent 临时推断。
8.6 这一轮的边界声明
先保存四个源码与数据文件,执行构建和回归,核对分子、分母及空集结果,再检查生成页面的实际展示。换成业务数据前,重新核对字段、特征可用时间与分享权限。读者带走的应是这条可复核的计算路径,而非一张看起来像结论的图。
参考来源
以下按用途列出官方资料与数据维护者页面。它们支持字段、接口与托管选项;合成数值和本地运行摘要另与公开输入及程序核对。
数据原作者与原始数据集
- UCI Bank Marketing 数据及署名:定期存款订阅数据,原作者 S. Moro、P. Rita、P. Cortez,DOI
10.24432/C5K306;CC BY 4.0 授权条款在 UCI 页面写明。本文的合成值不取自该数据集;该条只说明 UCI 原始数据页的条款,镜像仓库的许可声明需另行核对。 - cestwc/bank-marketing Hub 预览:经整理的镜像仓库,本文引用的字段预览与约 45.2k 行的
train分割数据来自此处预览。另已查看 固定提交;它不等于本机实际加载记录,合成夹具也不来自该提交抽样。
Datasets 库 API 与版本
- Datasets 特征与类别编码:说明
ClassLabel以整数存储并提供int2str等映射方法。本文主线不依赖此 API,仅作为类别编码的对照参考。 - Datasets 加载与版本选择:说明
revision参数支持 tag、branch、commit。本文未按本指南下载远程数据集,固定提交仅作为另行接入的参考。
命令行与令牌
- HF CLI 与认证:
hf auth whoami仅输出当前身份,不证明任意目标资源可读;hf auth login支持浏览器流程与访问令牌。本文未实际登录或访问私有资源,命令只作前置检查。 - Hub 访问令牌:权限粒度说明。本文不存储或展示任何令牌,所有远程操作均需走审批并使用团队 Secrets。
Hugging Face Spaces 部署
- Streamlit SDK 弃用提示:新项目应改用 Docker SDK + Streamlit 模板。本文第 7 节按此建议给出最小
Dockerfile示例,但未在远端创建 Streamlit Space。 - Docker Spaces 配置:
sdk: docker、app_port、UID 1000等规则。本文照此列出最小片段,不替代团队容器基线。 - Spaces 概述与可见性:区分 public / protected / private 三种可见性,并说明 Variables 与 Secrets 的差异。本文第 7 节按此区分源码与应用是否同时私有。
- Static Spaces:
sdk: static、index.html、可选app_file/app_build_command,前端变量会暴露给 JavaScript。本文生成的自包含index.html可按此路径托管,但不在此处证明已上传。
Streamlit 官方文档
- Streamlit 数据表接口:表格渲染 API。本文主线使用浏览器原生表格,不依赖此接口;它提供表格展示能力,分子分母的业务定义仍由应用决定。
- Streamlit 控件行为:控件在用户交互时更新状态、执行回调并按需重跑。本文主线使用浏览器原生
<select>,不依赖 Streamlit 的回调模型;保留引用是为了与官方描述的运行时语义作对照。 - Streamlit 缓存:缓存用于复用函数结果,键与失效规则需随实际输入设计。本文主线不使用任何额外缓存,结果随筛选状态直接重算;保留引用是为了提醒未来切到 Streamlit 时仍需随版本刷新缓存键。
本地实现所用接口
- Python 3.13 CSV:
DictReader读取与列数异常处理。 - DOM Node.textContent:以文本设置内容;本文据此避免把类别字符串拼进 HTML。
资料以外的可核对产物
- 合成夹具:
bank-demo-v1.csv(10 行 6 列表头固定,纯文本,可在文本编辑器中打开核对)。 - 计算核心:
dashboard-core.js(validateRows、compute、campaignBucket等函数,不依赖外部包)。 - 生成器:
build_dashboard.py(仅使用 Python 3 标准库)。 - 回归脚本:
test_dashboard.cjs(使用 Node 已存在的可执行版本)。 - 单文件产物:
index.html(完全自包含,不发起网络请求,不包含密钥或私有仓库数据)。
以上文档用于核对数据含义、API 和部署选项;合成数值及本地执行结果应按正文的输入、程序与验证范围复核。