引言
学生时期,我曾写过一篇关于 Go 密码哈希算法的技术文章。当时将 MD5、PBKDF2、bcrypt、scrypt 和 Argon2 放在一起进行 Benchmark,试图通过性能对比寻找合适的密码存储方案。
现在回头看,实验本身没有太大问题,但关注点有些偏了。
对于普通哈希算法,快通常是优点;而对于用户密码存储,太快反而可能成为安全问题。
一旦用户数据库泄露,攻击者便可以绕过登录接口,在本地批量猜测密码。此时真正重要的不是谁计算得更快,而是如何在正常用户可以接受的验证延迟内,尽可能提高攻击者的离线猜测成本。
这次我重新参考 OWASP、NIST 和 RFC 9106 的安全建议,使用自己的 Go 开源库 easyhash,在 Windows 和 Linux 两种环境下完成了正确性、算法性能、Argon2id 参数与并发资源开销实验。
本文将结合实际代码与测试数据,讨论密码哈希算法应该如何选择、成本参数如何确定,以及安全性与服务器资源之间的工程取舍。
1. 为什么不能直接用 MD5 / SHA-256?
先假设一件不愉快的事:某个网站的用户数据库泄露了。
如果数据库保存明文密码,攻击者直接拿到了答案。如果保存的是 SHA256(password),攻击者虽然不能直接"解密"哈希,却可以在自己机器上不断猜测候选密码,计算 SHA-256,与泄露的结果比对。
更麻烦的是,这种离线猜测不经过登录接口。验证码、API 限流和账号锁定都无法直接约束已经拿到哈希文件的攻击者。
MD5、SHA-256 是高性能的通用哈希函数;速度是它们在文件完整性检查等场景中的优点,却不适合直接保护通常熵值有限的人工设置密码。即使为 SHA-256 加上随机 Salt,也只是阻碍预计算和相同密码的哈希关联,并不会让每次猜测本身变得足够昂贵。此外,MD5 还有已知的碰撞安全缺陷,但密码存储里最直接的问题是它的计算成本太低。
密码存储需要的恰恰是另一种设计:让合法用户偶尔验证一次的代价可接受,让攻击者验证海量候选密码的代价尽可能高。
2. 应该选择哪种密码哈希?
技术选型可以从主流算法的工程定位出发:
| 算法 | 特点 | 使用建议 |
|---|---|---|
| Argon2id | 可调节内存、迭代次数和并行度,具备内存硬化特性 | 新系统优先评估 |
| scrypt | 具备内存硬化特性 | Argon2id 不可用时考虑 |
| bcrypt | 使用 Cost 调节计算成本,生态成熟,但存在 72 字节输入限制 | 既有系统兼容及迁移 |
| PBKDF2-HMAC-SHA256 | 主要通过迭代次数提高计算成本 | 需要相应合规或兼容性时考虑 |
| MD5 / 单轮 SHA-256 | 计算速度快,不是专用密码哈希方案 | 不用于新密码存储 |
具体参数不应该只凭直觉设置:
- OWASP 提供面向工程实践的参考下限,例如 Argon2id
m=19 MiB, t=2, p=1;scryptN=2^17, r=8, p=1;bcrypt 最低 Cost 10;PBKDF2-HMAC-SHA256 至少 600,000 次。 - NIST SP 800-63B-4 强调抗离线攻击的密码存储、独立 Salt、保存算法及成本信息,并建议在不损害服务性能的前提下尽可能提高成本,随计算能力发展进行升级。它没有规定一个适用于所有算法的统一迭代轮数。
- RFC 9106 为 Argon2id 提供了不同资源预算下的推荐配置,例如内存受限时的
64 MiB, t=3, p=4。
这些建议面向的资源预算与合规目标并不完全相同。t=3 也不意味着跨算法比 600,000 次 PBKDF2 更弱;迭代次数脱离具体算法没有比较意义。
3. 用 Go 实现密码生成与验证
Go 的 golang.org/x/crypto/argon2 提供 argon2.IDKey。但生产使用不能只计算一段字节数组,还需要安全随机 Salt、参数校验、编码存储、正确验证以及未来的参数迁移。
我的 easyhash v1.2.0 封装了这些步骤。这里明确选择 Argon2id,而不是使用 Hash() 的默认算法------easyhash 当前默认是 bcrypt Cost 12。
go
package main

import (
    "fmt"
    "log"

    "github.com/gofurry/easyhash"
)

func main() {
    cfg := easyhash.Argon2{
        TimeCost: 2, MemoryKiB: 19 * 1024,
        Threads: 1, KeyLen: 32, SaltLen: 16,
    }
    password := "example-password-for-demo"

    stored, err := easyhash.Hash(password, easyhash.WithArgon2idConfig(cfg))
    if err != nil {
        log.Fatal(err)
    }

    ok, err := easyhash.Verify(password, stored)
    if err != nil {
        log.Fatal(err)
    }
    fmt.Println("verified:", ok)
}
库内部使用 crypto/rand 为每条密码记录生成独立的随机 Salt,并在验证时取出已有 Salt 和成本参数重新计算。密码本身不需要、也不能通过"解密哈希"取回。
easyhash 使用自描述的 $easyhash$v=1$... 存储格式,包含算法、参数、Salt 和派生结果。它不是标准 Argon2 PHC 格式,跨库迁移时必须注意兼容性。把参数和版本与哈希一起保存,是为了以后能够识别旧配置并升级,而不是把成本写死在业务代码里。
4. 实验:计算成本究竟相差多少?
实验使用相同的测试密码、固定的库版本 easyhash v1.2.0 和 Go 1.27.1。两套环境分别是:
- Windows 10:Ryzen 7 5800H,8 核 16 线程,
GOMAXPROCS=16。 - Linux 沙箱:EPYC 虚拟 CPU,约 4 核 CPU 配额,
GOMAXPROCS=4,4 GiB 容器内存上限。
Linux 二进制由 Windows 交叉编译,两套使用相同 Go 源码和 easyhash 版本。操作系统、CPU 配额及虚拟化环境不同,因此这不是严格控制变量的硬件排行榜。
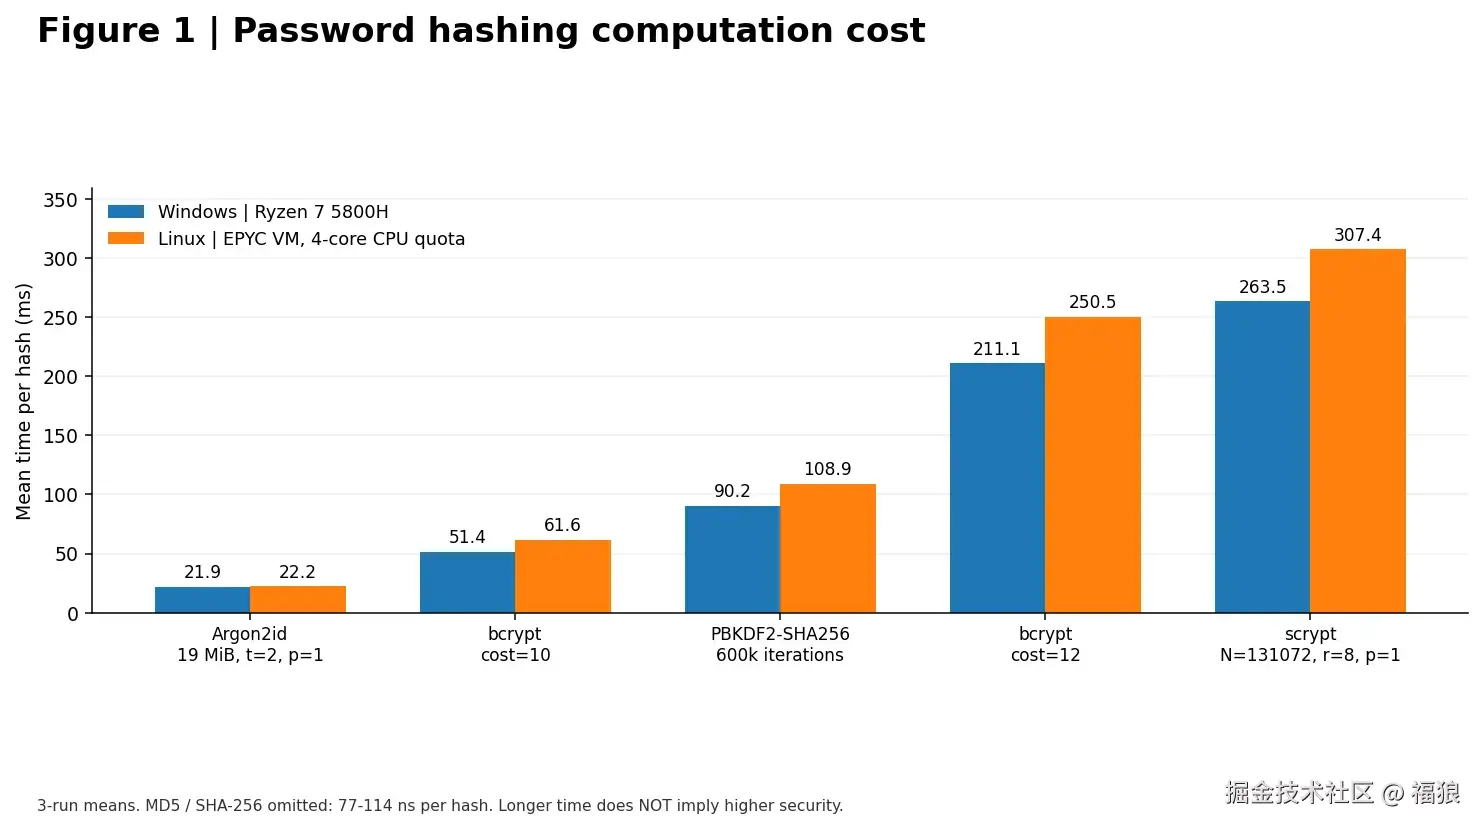
图注:三轮 Benchmark 的平均单次生成耗时,包含生成 Salt 与编码开销。不同算法采用明确但并不等强的参考参数,不能以耗时给安全性排名。
在 Windows 上,裸 SHA-256 的平均耗时约 77.6 ns ,Argon2id(19 MiB / t2 / p1)约 21.95 ms ,相差约 28 万倍。Linux 上分别为 93.4 ns 和 22.17 ms,同样相差多个数量级。
bcrypt Cost 10 与 Cost 12 在 Windows 上分别约为 51.4 ms 和 211.1 ms,后者约为前者的四倍,符合 Cost 每增加一级、工作量约翻倍的特征。
但要小心:图中的 Argon2id 看起来最快,不等于它"安全性最低";scrypt 最慢,也不等于它"最安全"。这些配置的内存成本与抵抗大规模并行猜测的机制并不相同。我们没有测试 GPU / ASIC 破解成本,也不能从 CPU 耗时直接推导密码破解速度。
5. Argon2id:内存、迭代和并行度的取舍
Argon2id 的三个核心参数是:m(总内存成本,KiB)、t(遍历内存的次数)、p(并行通道数)。它们不是三个相互独立的"安全等级旋钮",而是共同影响运行成本。
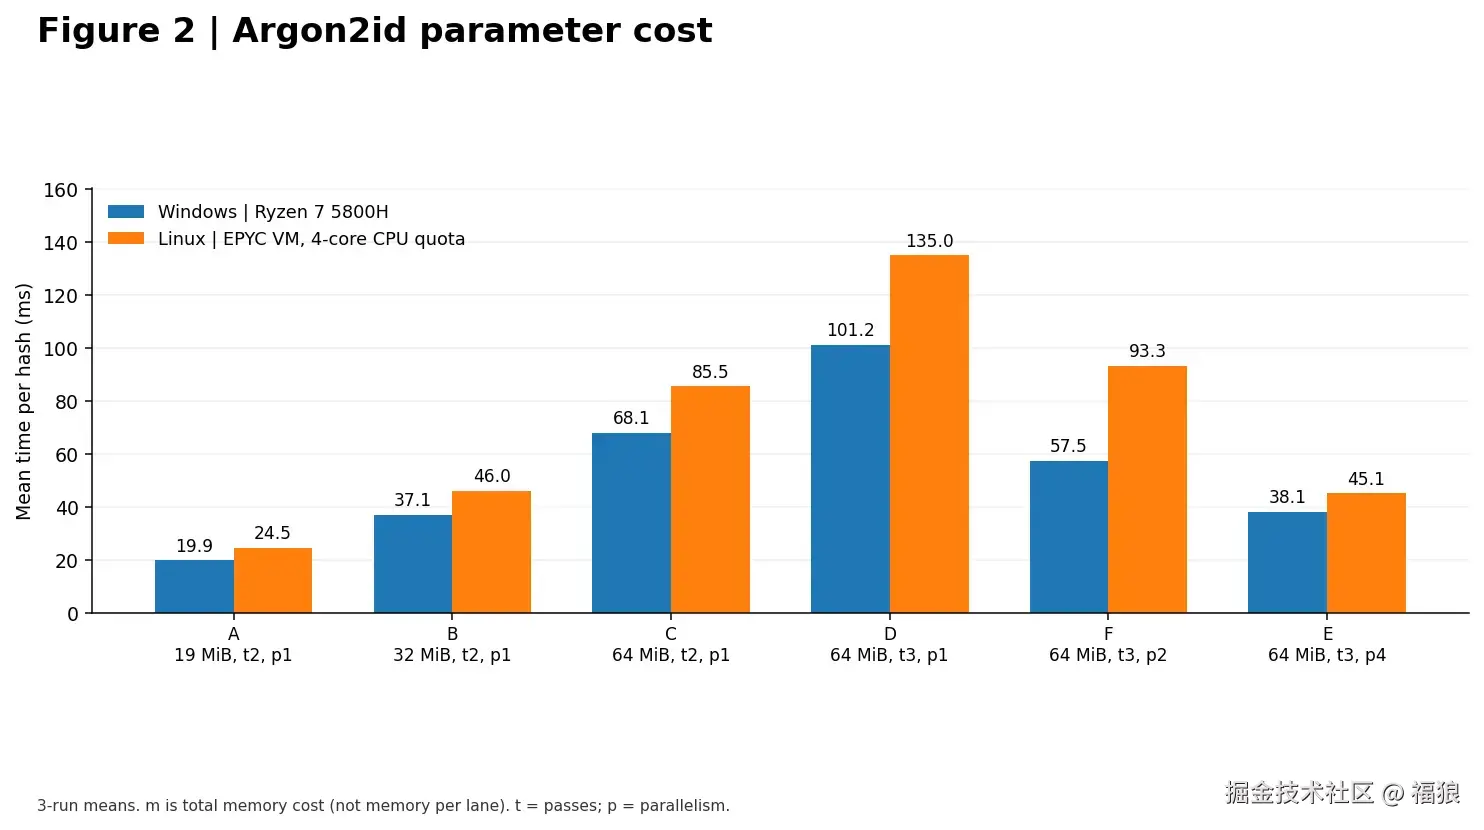
图注:六组参数在两套环境下各重复三轮的平均值,实验使用相同密码及输出长度。
在 Windows 上,把 m 从 19 MiB 增加到 64 MiB,保持 t=2, p=1,耗时从 19.85 ms 上升到 68.05 ms ;将 t 从 2 提高到 3,又上升到 101.20 ms。
相同的 64 MiB, t=3 下,p=1 / 2 / 4 的耗时分别约为 101.2 / 57.5 / 38.1 ms 。更高并行度缩短了单次等待时间,但并不会把总内存参数从 64 MiB 变成 64×4 MiB。
这组结果很好地说明了:参数调整是计算时间、内存预算和 CPU 并行能力之间的取舍,不能简单地盲目增加迭代次数。
6. 单次更快,不代表并发容量更大
真实登录服务还有另一个问题:如果许多用户同时验证密码,会发生什么?
我们使用固定工作线程数模拟并发验证,在两套环境里分别测试 1、2、4、8 并发。这里没有 HTTP、数据库与实际登录链路,每组约 10 秒,而且只运行了一轮,所以这是一组探索性压力样本,不是生产 SLA。
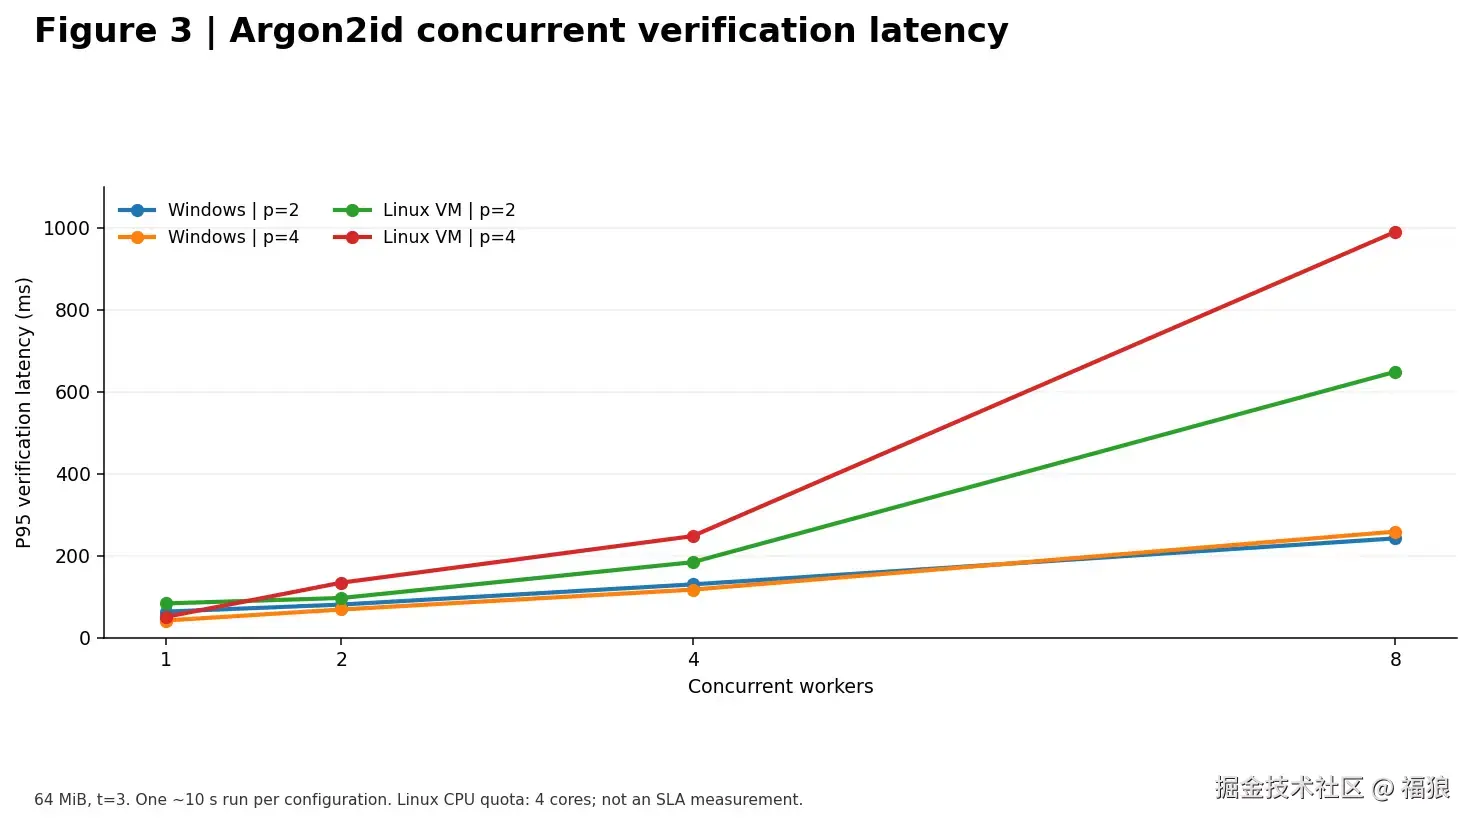
图注:固定
m=64 MiB, t=3,对比 p=2 与 p=4;Linux 沙箱约 4 核 CPU 配额,存在 CPU 节流。
以 8 并发为例:
| 环境 | 参数 | 验证吞吐(次/s) | P95 延迟 |
|---|---|---|---|
| Windows | p=2 | 35.7 | 242 ms |
| Windows | p=4 | 36.3 | 259 ms |
| Linux 沙箱 | p=2 | 24.6 | 649 ms |
| Linux 沙箱 | p=4 | 23.5 | 990 ms |
在单次 Benchmark 中,p=4 明显加快了完成速度;到了 8 并发,Linux 沙箱上的整体吞吐反而略低,尾延迟则明显恶化。原因需要结合 CPU 配额、调度和资源竞争来看,而不能认定所有 Linux 服务器都会这样。
内存也值得注意:Windows 这两组在 8 并发时采集到的进程峰值工作集约为 1.16 GiB 与 1.34 GiB 。这不是 64 MiB × 8 就能精确推算的数字;Go 的堆分配、内存回收、并行执行和操作系统统计口径都会影响观测值。
一套密码哈希配置在单次测试里表现优秀,并不意味着它适合你的登录并发量。
7. 真正上线前,还要考虑什么?
密码存储不是调用一次 Hash() 就结束。还有几项边界不能省略:
- Salt 与 Pepper:Salt 应独立随机生成,可以与哈希一起存储;Pepper 是可选的额外秘密,需要与数据库分离保管,不能代替 Salt。
- 参数升级 :保存算法和成本信息,在旧密码验证成功后逐步 Rehash。
easyhash.VerifyAndUpgrade可以帮助完成验证和重新生成,但写回数据库时仍要考虑并发更新,避免覆盖更晚的密码修改。 - 旧算法迁移:如果历史系统保存了 MD5 或旧 bcrypt,应明确限定旧记录的验证入口,在成功登录后升级;不要把兼容旧算法当成新系统的默认策略。
- 资源保护:限制用户可触发的并发验证数量,并对来自存储或外部的成本参数做上限校验。高成本哈希本身也可能放大拒绝服务风险。
- 认证仍是完整系统:密码强度、TLS、账号限流、多因素认证、泄露密码检查与安全的重置流程,不能由密码哈希算法替代。
结语
回头看那篇学生时期的博客,我最大的修正不是换了一种"更快"或"更慢"的算法,而是换了一个问题:我们到底想让谁付出计算成本?
对用户来说,一次合理耗时的密码验证应该足够自然;对拿到泄露数据库的攻击者来说,每次猜测都应该昂贵。而对于服务端工程师,还要确保这种防护成本不会先把自己的认证服务压垮。
这也是此次四组实验最想说明的事:密码哈希的安全性与工程成本需要一起设计,不能只看 Benchmark 排名。