一、引言
很多团队的第一代数据治理是"表中心"的:补元数据、补 owner、补字段说明、补血缘、补质量规则。这个阶段能解决"数据资产看不见"的问题,却不一定能解决"数据每天都在不可控地产生"的问题。
在工程实践里,数据生产更像一条流水线。代码、任务、调度、队列、资源、重试、告警、SLA 每一个环节都可能制造数据问题。
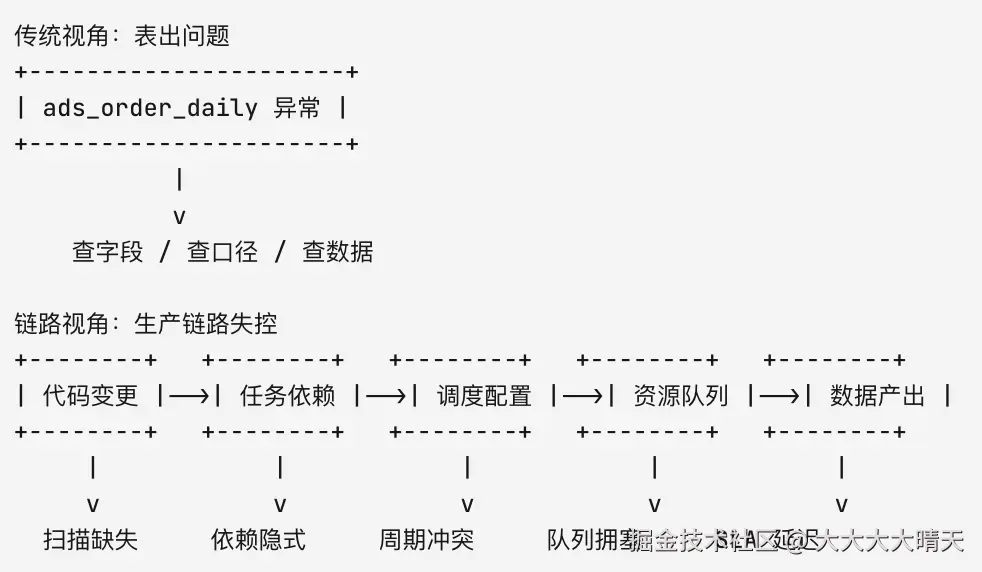
所以,数据治理要前移。不是等表坏了再加质量规则,而是在任务进入生产前就约束代码、命名、依赖和资源配置;在任务运行中持续观测状态、队列、耗时和失败模式;在数据延迟前就能解释 SLA 风险。
二、开发规范
大数据开发规范不是"代码风格洁癖",而是降低链路不确定性的第一道门槛。SQL、Spark、Flink、Hive、Python 脚本、调度 DAG,如果没有统一规范,后续很难做自动扫描、血缘解析、变更评估和故障定位。
规范至少要覆盖四类内容:命名规范、分层规范、参数规范和运行边界。命名规范让任务、表、队列、脚本、包路径能够被平台识别;分层规范让 ODS、DWD、DWS、ADS 等加工关系稳定;参数规范让业务日期、分区、环境变量、资源配置可以被调度系统统一注入;运行边界则约束任务最长运行时间、最大扫描分区、最大并发、可重试异常和不可重试异常。
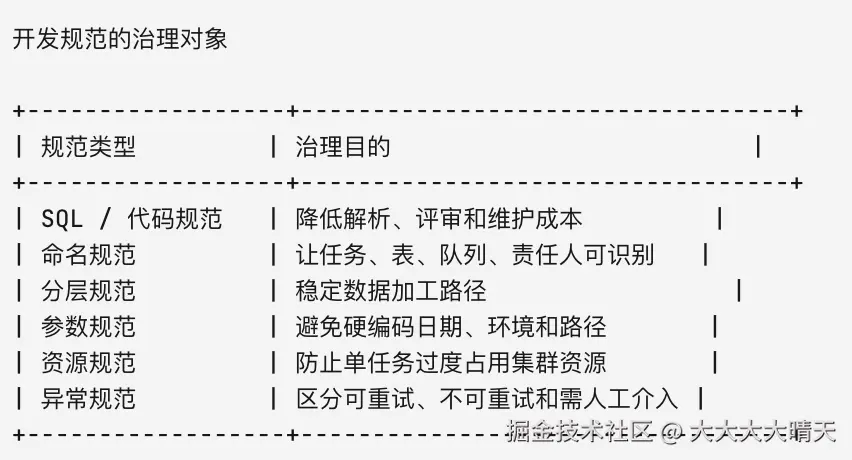
一个可落地的原则是:所有能被机器检查的规范,都不要只靠人工评审。比如 SQL 格式、禁用select * 、分区条件、扫描范围、表命名、任务 ID 命名、owner 标签、资源参数,都应该进入提交前检查或 CI 流水线。
三、代码扫描
代码扫描的目标不是"挑毛病",而是把风险拦在上线前。SQLFluff 定位为可用于开发者工具和 CI/CD 流水线的 SQL Linter,并支持通过退出码让流水线识别"无问题""存在 lint 问题"和"执行错误"等状态。这类工具适合承担 SQL 规范扫描、增量变更检查和 PR 注释反馈。
对大数据任务来说,代码扫描可以分成三层:
lua
提交前扫描
  |
  +-- 语法层:SQL 是否可解析、模板是否可渲染、Python 是否可导入
  |
  +-- 规范层:命名、分区条件、禁用语法、资源参数、注释和 owner
  |
  +-- 风险层:全表扫描、笛卡尔积、动态分区过宽、覆盖写高风险表
在实践中,扫描规则不要一开始就追求"大而全"。更有效的路径是先抓高风险规则:生产表覆盖写、无分区条件扫描、临时表写入正式库、任务缺少 owner、任务缺少资源队列、SQL 无法解析。等基础规则稳定后,再逐步引入复杂规则,如血缘解析、字段级影响分析、成本估算和数据质量规则自动推荐。
需要注意的是,SQL 扫描并非完全无风险。SQLFluff 虽然它本身不执行 SQL,但在模板渲染过程中,Jinja 或 dbt 宏可能具备执行 SQL 或引入代码的能力,因此安全环境中要限制库路径等配置。因此扫描平台本身也要治理,尤其是模板、宏、UDF、远程依赖和动态参数。
四、任务命名
任务命名是生产链路治理的索引系统。命名混乱时,平台无法从任务名快速判断业务域、层级、产出表、周期、优先级和责任人,故障处理就会退化成"问人"。
一个任务名至少应该表达五件事:
{业务域}.{数据层}.{产出对象}.{加工周期}.{任务类型}

示例:
trade.dwd.order_detail.di.spark
trade.dws.user_trade_summary.di.sql
risk.ads.fraud_score_hi.flink
命名不是越长越好,而是要稳定、可解析、可聚合。比如:
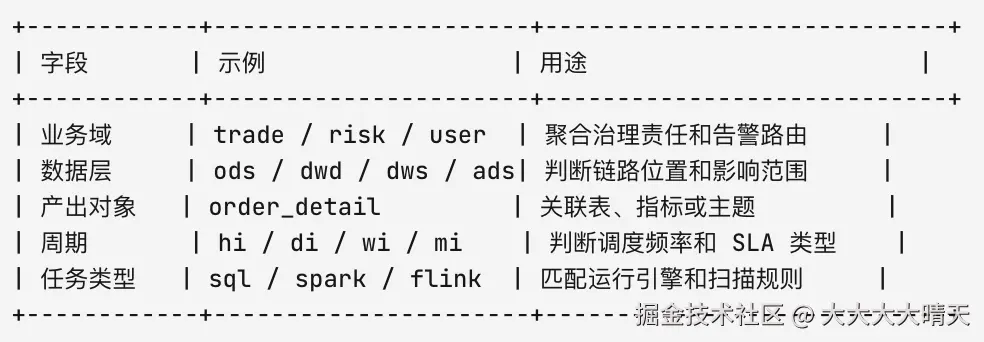
任务命名一旦标准化,就可以反向驱动平台能力:自动路由告警、自动匹配资源队列、自动标注业务域、自动生成链路视图、自动识别跨层依赖。反过来,如果命名只靠开发者自由发挥,后续所有治理动作都要依赖额外配置,成本会越来越高。
五、依赖管理
依赖管理决定了数据生产链路能否被解释,依赖必须显式化,调度系统才能正确判断运行顺序和失败传播。在大数据场景里,依赖通常有三种:
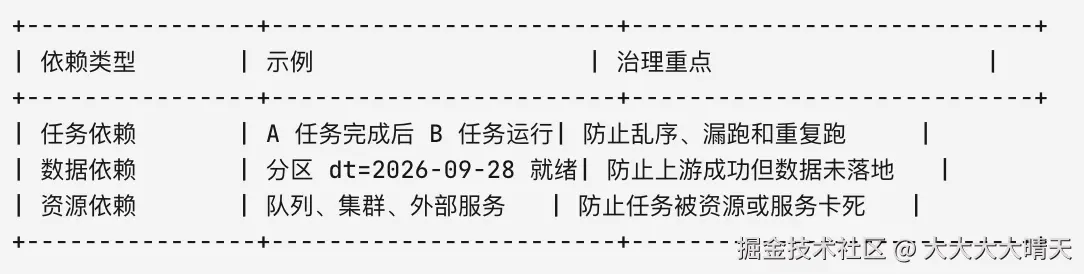
很多链路问题来自"隐式依赖"。比如 B 任务读取 A 任务产出的表,但调度上没有配置 A -> B;或者 B 任务依赖上游某个分区完成,但只配置了定时触发。这样的链路在平稳时期看不出问题,一旦上游延迟、补数或资源拥塞,下游就会读到旧数据、空数据或半成品数据。
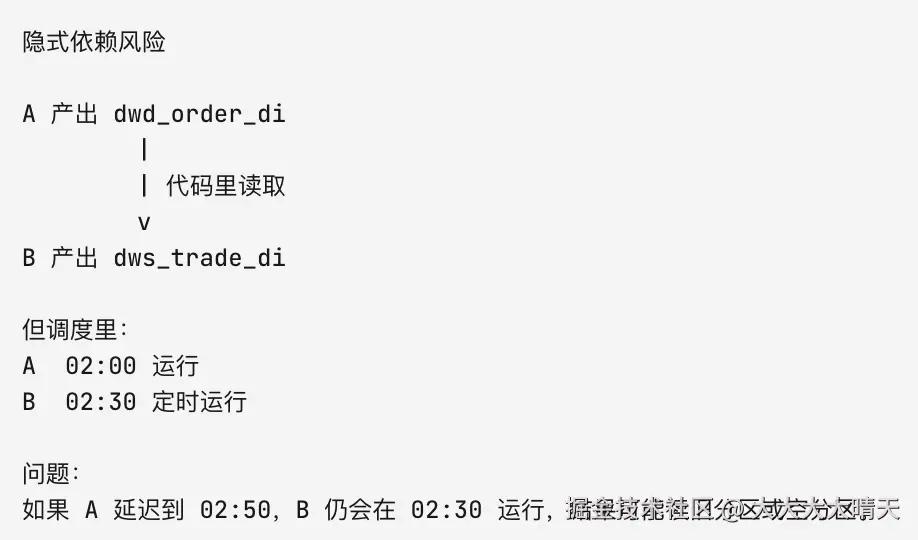
好的依赖治理要把"代码依赖"和"调度依赖"对齐。可以通过 SQL 解析、元数据血缘、OpenLineage 事件、DataHub 血缘能力等方式补足依赖视图。
六、调度治理
调度治理要解决的不是"任务能不能跑",而是"任务是否按正确顺序、正确周期、正确条件、正确优先级运行"。调度系统天然是数据生产链路的控制面,如果调度配置散乱,链路治理就会失去抓手。
调度治理可以从四个维度展开:
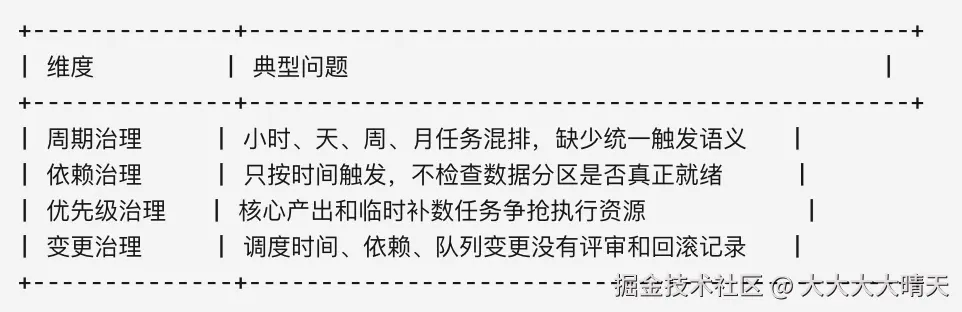
一个常见误区是把所有稳定性问题都交给重试。调度治理的第一原则应该是减少不必要的失败,而不是盲目增加失败后的恢复次数。比如上游文件未到达时,下游不应该先失败再重试,而应该使用数据就绪检测、传感器或事件触发;资源队列拥塞时,不应该让所有任务同时排队,而应该按业务优先级和 SLA 分层调度。
七、资源队列
资源队列是数据生产链路的"交通系统"。任务依赖写得再清楚,如果所有任务都挤在一个队列里,核心链路仍然可能被临时查询、补数任务、低优先级批处理拖垮。
Hadoop YARN CapacityScheduler 通过队列让多租户共享集群,同时给不同组织或队列提供容量保障;队列是 CapacityScheduler 的核心抽象,支持层级队列、容量保证、弹性使用、ACL、安全限制和多租户控制。资源治理不能只看单任务参数,还要看任务所在队列、队列容量、最大容量、用户限制和优先级策略。
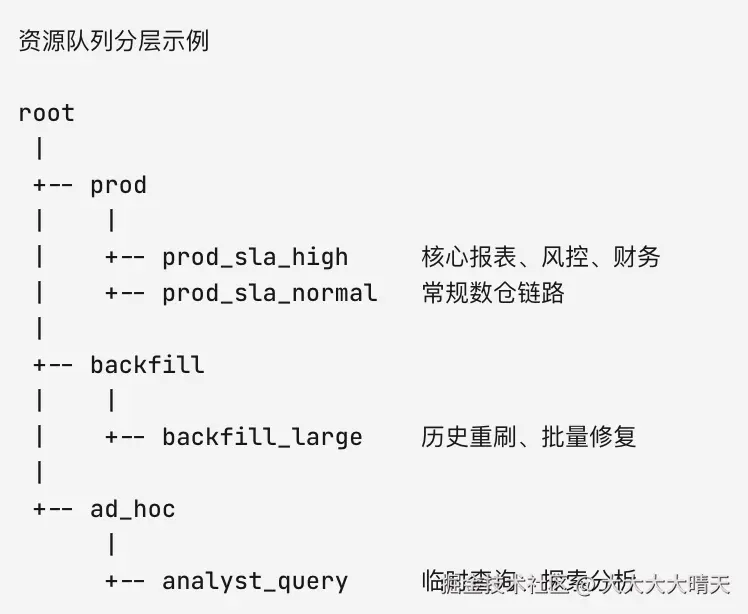
队列治理通常要回答三个问题:
markdown
1. 谁可以提交到这个队列?
2. 这个队列最低能拿到多少资源,最多能吃到多少资源?
3. 当资源紧张时,哪些任务先运行,哪些任务让路?Spark的动态资源分配可以根据工作负载动态增减应用占用的资源,适合多个应用共享集群的场景,但需要先启用spark.dynamicAllocation.enabled ,并配合外部 shuffle 服务、shuffle tracking 或其他可靠 shuffle 存储机制,以避免 executor 移除后 shuffle 数据不可用。Spark 还支持应用内的 fair scheduler pools,通过schedulingMode 、weight 、minShare 等属性控制不同池的资源份额。
资源治理应同时覆盖"集群队列"和"应用内部调度"。前者决定应用能否拿到资源,后者决定同一应用内部多个 job 如何共享资源。
八、失败重试
失败重试不是越多越好。粗放重试会掩盖真实问题、放大资源浪费,甚至制造重复写入和脏数据。治理重试的关键,是把失败分类。
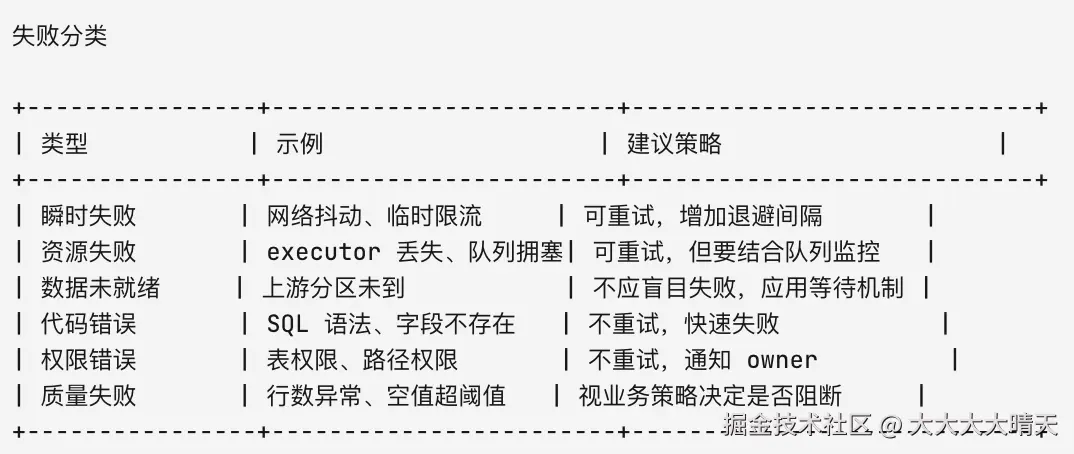
Airflow 的任务可以设置execution_timeout 限制单次执行最大运行时间,超时会抛出AirflowTaskTimeout ;失败任务如果还有重试次数,会进入up_for_retry 状态。默认重试通常按固定次数和延迟处理,而 retry policy 可以按异常类型配置重试、失败或使用默认策略,并且策略不能突破任务配置的最大重试次数。
因此,重试治理要从"次数配置"升级到"异常语义"。例如:
rust
HTTP 429 / 5xx      -> 重试,退避
连接超时            -> 重试,短间隔
字段不存在          -> 失败,不重试
权限不足            -> 失败,不重试
上游分区未就绪      -> 等待或跳过,不直接重试业务逻辑
数据质量强规则失败  -> 阻断并告警
大数据任务还要特别关注幂等性。一个任务如果会覆盖分区,重试相对安全;如果会追加写入,重试可能导致重复数据;如果会调用外部接口或写入消息队列,重试必须带去重键、事务边界或补偿逻辑。否则,"自动恢复"会变成"自动制造二次事故"。
九、SLA 保障
SLA 不只是"几点之前产出",而是对生产链路可用性的承诺。一个健康的 SLA 体系至少包括:承诺时间、上游依赖、关键路径、资源保障、失败恢复时间、告警升级和降级策略。
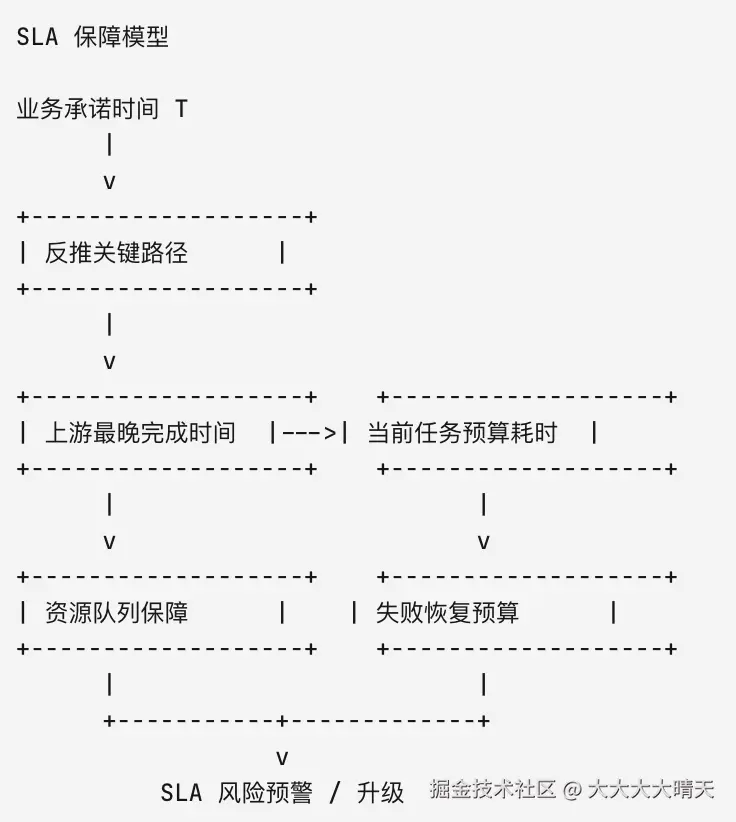
SLA 治理最容易犯的错误,是只在最终产出表上设置告警。等最终任务超时,留给工程师的恢复窗口可能已经很短。更好的方式是把 SLA 拆到关键路径节点上:
ads 核心报表 08:00 前产出

关键路径:
ods 入湖完成        <= 01:00
dwd 清洗完成        <= 02:30
dws 聚合完成        <= 04:30
ads 报表层完成      <= 06:30
校验与发布完成      <= 07:30
业务可见            <= 08:00
这样一来,SLA 不再是一个终点告警,而是链路上的多个风险闸口。任何一个节点超出预算,都可以提前触发资源扩容、任务重跑、降级产出或人工介入。
十、血缘和质量反馈
生产链路治理不能停在任务运行成功。任务成功只表示程序跑完,不代表数据正确。
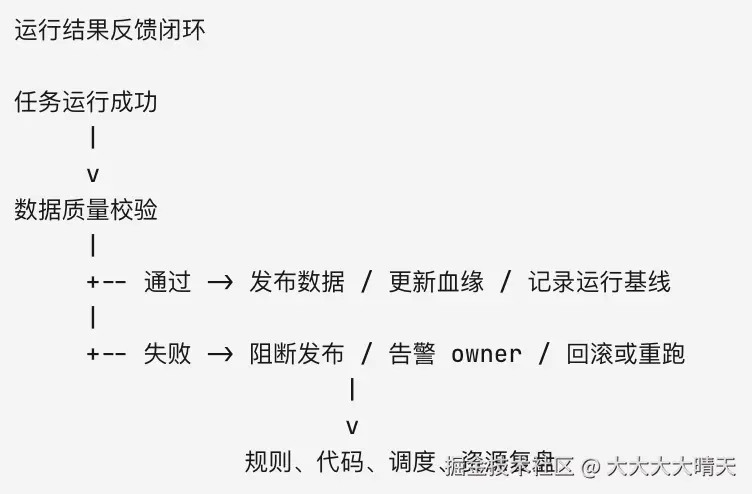
最终,数据生产治理应该形成一个闭环:代码变更被扫描,任务依赖被声明,运行过程被观测,数据产出被校验,血缘影响可追踪,质量问题能反向定位到具体任务、代码版本和运行实例。
十一、落地建议
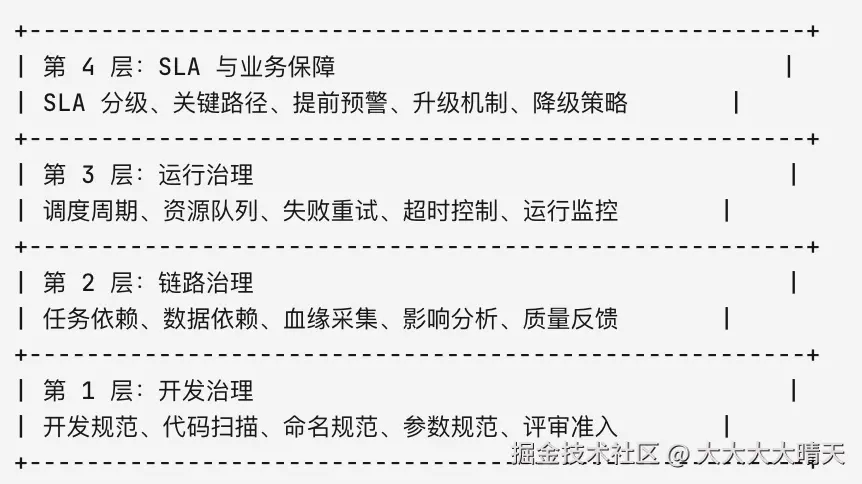
可以采用"先准入、再观测、后优化"的节奏:
markdown
阶段一:准入
  - 统一任务命名
  - SQL / DAG / Spark 参数扫描
  - owner、队列、周期、产出表必填
  - 高风险 SQL 阻断上线

阶段二:观测
  - 采集任务运行状态
  - 采集输入输出数据集
  - 建立任务级和表级血缘
  - 建立耗时、失败率、重试率基线

阶段三:优化
  - SLA 关键路径拆解
  - 队列容量和优先级治理
  - 异常分类重试
  - 质量规则与调度联动
这里的关键不是工具选型,而是治理对象建模。只要平台能稳定回答下面几个问题,工具可以是 Airflow、DolphinScheduler、DataHub、OpenLineage、SQLFluff、Atlas、自研平台或组合方案:
markdown
1. 这个任务是谁负责的?
2. 它产出什么数据?
3. 它依赖哪些任务和数据?
4. 它什么时候该运行,什么时候必须完成?
5. 它运行在哪个队列,资源上限是多少?
6. 它失败后应该重试、等待、跳过还是快速失败?
7. 它影响哪些下游表、指标、报表和业务 SLA?
8. 它最近的耗时、失败率、重试率是否偏离基线?