项目驱动的 Python 入门
先看交付物
- 在终端完成三个练习:分账金额、术语猜词、点歌队列;代码均只用标准库。
- Pay Up 明确四个输入和费用基数,并将舍入后的总额分到每个人,避免逐人舍入后合计不符。
- 列表支持按位置修改;元组不能重绑槽位。二者都能解包,元组包含可变成员时也不能承诺深度不可变。
while检查条件,for消费可迭代对象,break与continue只作用于最近一层循环。- 函数分开输入、计算与状态更新;用返回值让调用者决定何时退出。
- 小型点歌练习可以用列表实现队列;频繁从两端增删时再评估
deque。
Python 练习的交付范围:脚本、输入与退出
先把下文的 pay_up.py、jargon_jumble.py、sing_out.py 分别保存,运行后输入一组有效数据,再试一次空输入或错误命令。三个程序分别练数值解析、抽题状态和队列更新;前面的短示例解释它们需要的语法,完整程序负责把入口、错误处理和退出路径接起来。
分账脚本从文本输入得到总额与逐人份额;猜词脚本把抽题、尝试次数和得分接成一局;点歌脚本用命令更新名单。三个练习都要交付能启动、处理坏输入并正常退出的完整程序。核验使用本机 CPython 3.13.12 和标准库;下文给出可重放的输入、预期输出和错误场景。不需要模型账号、联网接口或第三方包。各节先写清金额规则、游戏玩法和队列命令,再让读者把预期结果与函数返回值逐项对照。
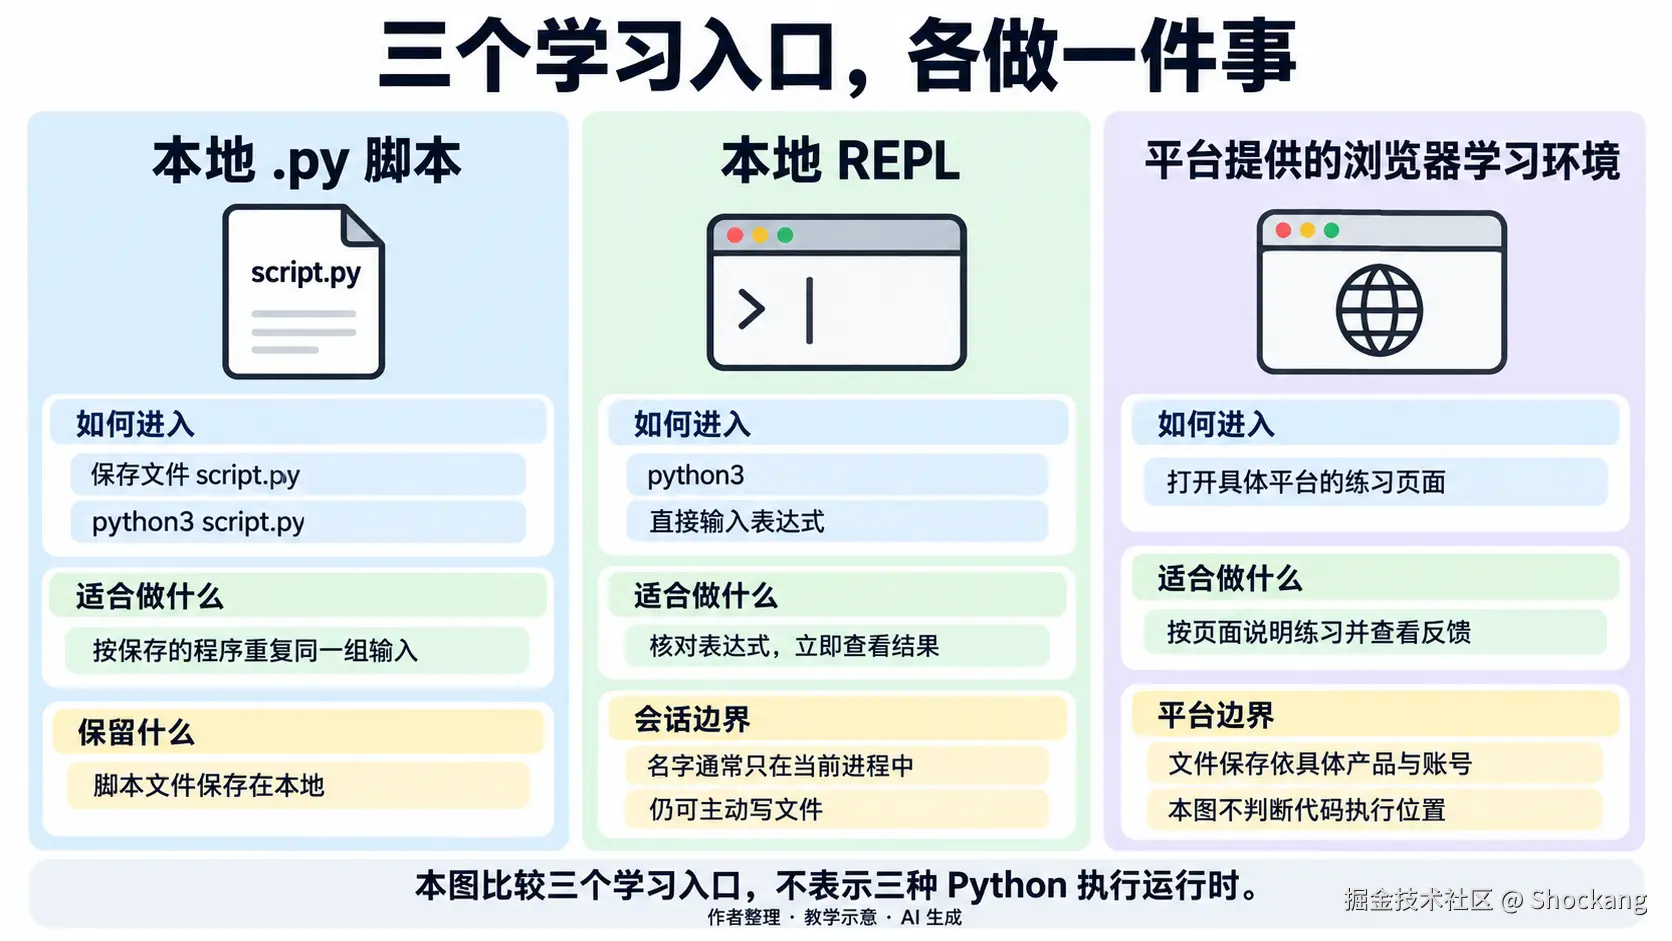
学习入口可以分成三类:浏览器编辑器便于跟着练;直接输入 python3 进入交互式解释器,适合核对表达式;python3 文件名.py 运行已保存脚本,适合重复同一组输入。python3 -i 文件名.py 则先运行脚本,再留下交互会话,不等同于从空会话启动。浏览器编辑器是否保存文件取决于具体产品与账号;REPL 中的名字通常只存在于当前进程,但程序仍然能够写文件。下面分别保留这三类入口,交付以可重新保存和执行的脚本为准。
函数和变量通常用 snake_case,模块级常量通常用大写加下划线,类名通常用 CapWords。这是 PEP 8 的风格建议,不是解释器强制的语法规则。本文将 ROUNDS 这类配置放在模块顶部,把 parse_people 这类动作写进函数名;名字应说明输入和用途。
Python 提供 %、str.format() 与 f-string 等格式化方式。本例先用短表达式说明显示两位小数,再在完整分账程序中单独处理金额与分摊规则:
python
bill = 120.0
tip_rate = 0.15
people = 3
summary = f"账单 {bill:.2f} 元,小费比例 {tip_rate:.2f},人均 {(bill * (1 + tip_rate)) / people:.2f} 元"
print(summary)  # 账单 120.00 元,小费比例 0.15,人均 46.00 元
上例选择 f-string 是因为变量和格式放在同一位置,容易核对。它在 Python 3.6 引入;本文未比较这些写法的运行速度。:.2f 表示显示两位小数,不能保证业务金额精确。保留 % 或 .format() 的既有代码,也不等于代码不合格;占位模板、日志延迟格式化与兼容要求可能影响选择。
print 与 input 可以组成一个可观察的终端循环:打印提示、读取一行、处理后输出。先用下面的 echo 练习退出命令和输入结束:
python
while True:
    try:
        user_input = input(">>> ")
    except EOFError:
        break
    if user_input == "exit":
        break
print(f"echo: {user_input}")这个循环把读取、分支和输出放在同一处,便于看清一次输入如何改变流程。exit 是本例的退出约定;文件结束也应结束会话,所以代码另外捕获 EOFError。完整项目会进一步把可测试的计算函数与交互函数分开。print 和 input 只是本例采用的终端接口,不是所有程序唯一的状态与指令入口。
| 运行环境 | 启动方式 | 主要用途 | 持久化 |
|---|---|---|---|
| 浏览器编辑器 | 打开具体产品页面 | 教学反馈 | 依产品与账号设置 |
| REPL | python3 |
即时验证表达式 | 名字通常只在进程内;仍可主动写文件 |
| 本地脚本 | python3 script.py |
可复现交付 | 落盘文件 |
格式化与命名可以随项目约定统一:这里用 f-string 写展示文本,用清楚的函数名分隔读取、解析和计算。不要为了风格把既有 % 或 .format() 全部替换;先看模板来源和调用场景。snake_case、大写常量和 CapWords 是便于协作的约定,违反约定时应说明原因,不能把命名差异等同于运行错误。
Pay Up 解构:变量、字符串与输入输出契约
Pay Up 的输入输出契约:总额与逐人份额
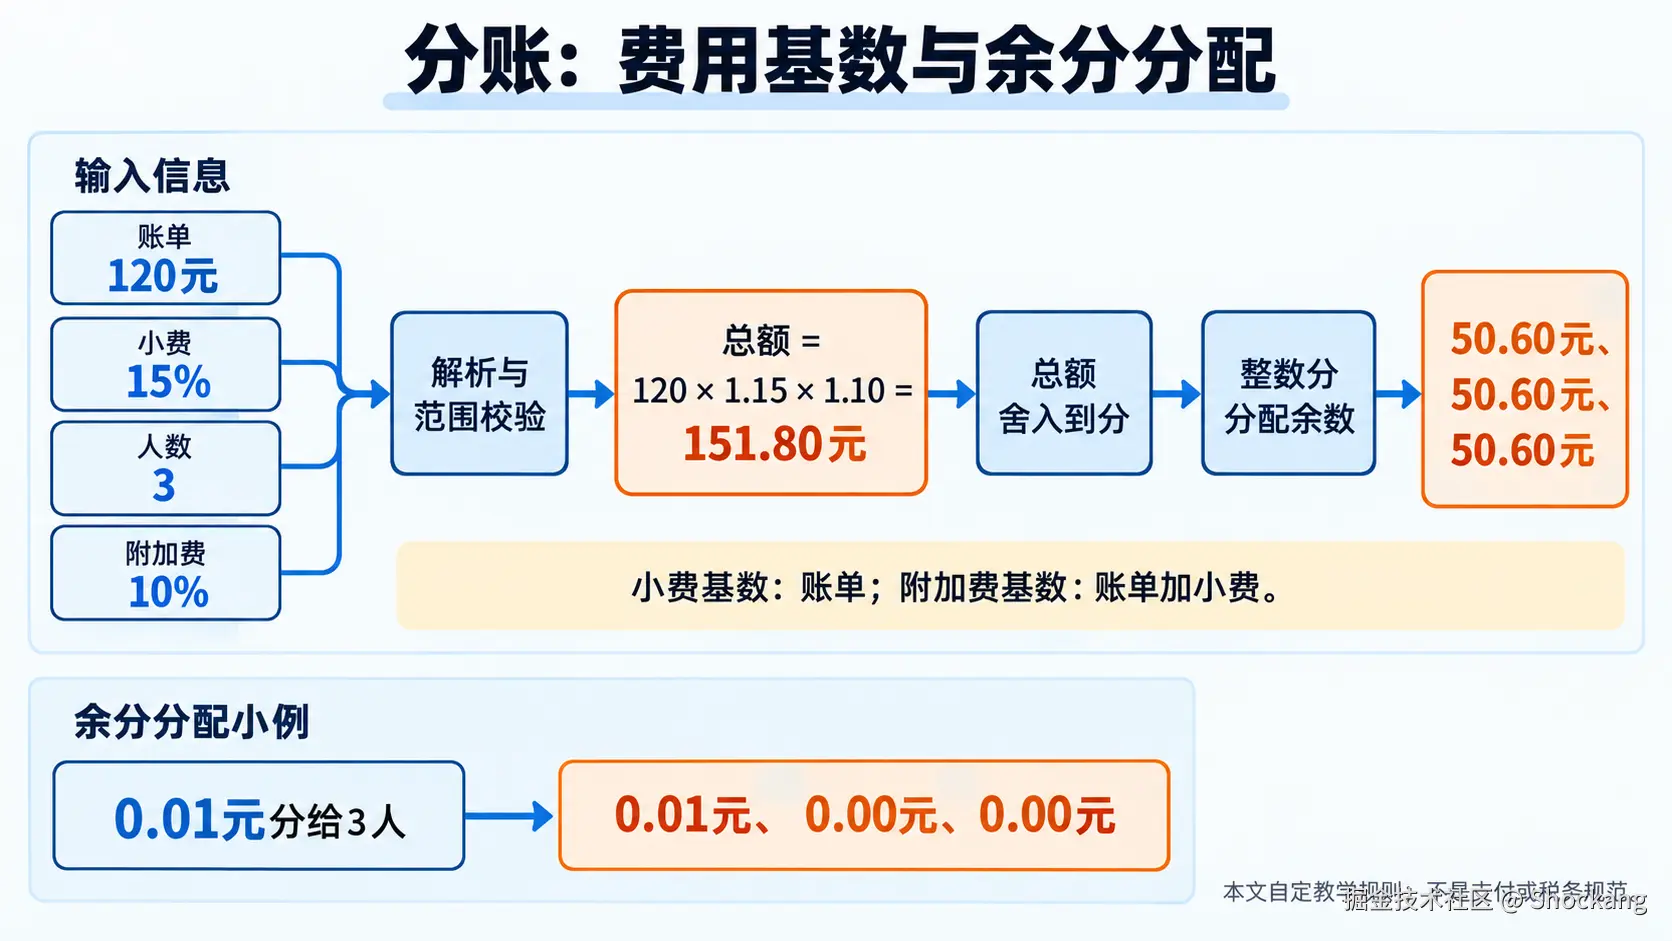
Pay Up 用四个输入确定应付总额与逐人分配:账单金额、小费比例、人数和附加费比例。先明确每种费用的计算基数,再把金额解析、计算和显示分开;不能只看到一个"人均金额"就忽略逐人金额相加是否等于总额。
本例的计算接口是 split_bill(bill_text, tip_text, people_text, surcharge_text),返回 total, shares:前者是舍入后的应付总额,后者是逐人份额元组。调用方可以检查 sum(shares) == total,再按人数逐行显示。这里传入的是待解析文本,不是已验证的金额对象;费用规则和错误处理都由下方实现明确约定。
先确定费用规则,再写表达式。本练习选择复合计费规则:小费按账单金额计算,附加费按"账单加小费"计算,因此总额为 bill * (1 + tip_rate) * (1 + surcharge_rate)。例如账单 120、小费 15%、附加费 10%、3 人,对应总额 151.80 元、每人 50.60 元。这是教学假设,现实场景须先确认费用基数,不能由脚本替商家或法规决定。完整程序将总额按分舍入,再分配余分,保证每人金额相加等于总额。
从 input() 字符串到数值
input() 返回字符串,不会把数字外观的输入自动变成数值。把字符串直接与浮点数相乘会触发类型错误;先解析再计算,能让输入契约在代码中看得见。
内置函数文档 说明 input() 返回字符串,遇到输入结束会抛出 EOFError。因此先检查文本,再显式解析。int("12.5") 会失败,但 int(" 3 ") 可以接受空白;允许哪些写法是程序自己的约定。下面完整程序对人数限定 ASCII 十进制数字,对金额限定最多两位小数,对比例接受 0.15 或 15%,不悄悄把任意带符号的文本"清洗"成合法输入。
python
# 保存为 pay_up.py;只使用Python标准库。
from decimal import Decimal, ROUND_HALF_UP, localcontext
import re


def parse_decimal(raw, label, maximum, places):
    text = raw.strip()
    pattern = rf"[0-9]+(?:\.[0-9]{{1,{places}}})?"
    if len(text) > 24 or re.fullmatch(pattern, text) is None:
        raise ValueError(f"{label}须为非负十进制数,最多{places}位小数")
    value = Decimal(text)
    if not value.is_finite() or value > maximum:
        raise ValueError(f"{label}超出本练习允许范围")
    return value


def parse_rate(raw, label):
    text = raw.strip()
    if text.endswith("%"):
        return parse_decimal(text[:-1], label, Decimal("100"), 4) / 100
    return parse_decimal(text, label, Decimal("1"), 6)


def parse_people(raw):
    text = raw.strip()
    if not text.isascii() or not text.isdecimal() or len(text) > 4:
        raise ValueError("人数须为1到1000的ASCII整数")
    people = int(text)
    if not 1 <= people <= 1000:
        raise ValueError("人数须为1到1000")
    return people


def split_bill(bill_text, tip_text, people_text, surcharge_text):
    # 本文教学规则:附加费的基数包含小费;总额先四舍五入到分。
    bill = parse_decimal(bill_text, "账单", Decimal("1000000"), 2)
    tip = parse_rate(tip_text, "小费比例")
    people = parse_people(people_text)
    surcharge = parse_rate(surcharge_text, "附加费比例")
    with localcontext() as ctx:
        ctx.prec = 28
        total = (bill * (1 + tip) * (1 + surcharge)).quantize(
            Decimal("0.01"), rounding=ROUND_HALF_UP)
        cents = int(total * 100)
        base, extra = divmod(cents, people)
        shares = tuple(Decimal(base + (i < extra)) / 100 for i in range(people))
    return total, shares


def main():
    try:
        bill = input("账单总额(元): ")
        tip = input("小费比例(0.15或15%): ")
        people = input("人数: ")
        surcharge = input("附加费比例(0.10或10%): ")
        total, shares = split_bill(bill, tip, people, surcharge)
    except (ValueError, EOFError) as error:
        print(f"输入错误:{error}")
        return 2
    print(f"应付总额:{total:.2f}元")
    for index, amount in enumerate(shares, 1):
        print(f"第{index}人:{amount:.2f}元")
    return 0


if __name__ == "__main__":
    raise SystemExit(main())
把上面完整程序保存为 pay_up.py 后执行 python3 pay_up.py,依次输入 120、15%、3、10%,可检查总额和逐人分配。再试人数 0、金额 NaN 或比例 15%%:程序应提示输入错误并返回非零退出码,不输出看似有效的账单。这里将异常输入视作一次计算失败,不自动重试全部问题,以免读者分不清哪些字段仍有效。
货币格式化:f-string 与 round 的取舍
f"{value:.2f}" 只控制显示位数,不能消除浮点表示误差;round 对内置数值的中点采用趋偶舍入,而 round(2.675, 2) 得到 2.67,是二进制近似导致的常见例子。本文的金额程序从字符串构造 Decimal,显式使用 ROUND_HALF_UP 将总额量化到分,再用整数分分摊。换舍入规则就可能换最终结果,必须在输入输出契约里写清。
| 方案 | 调用链 | 适用场景 | 取舍 |
|---|---|---|---|
round(v, 2) 后输出 |
先改变数值再输出文本 | 需要舍入数值的场景 | 未必固定显示尾数零,规则需明确 |
f"{v:.2f}" |
控制文本显示位数 | 展示已有结果 | 不修复算术或分摊误差 |
decimal.Decimal |
十进制算术与可配置上下文 | 需要显式十进制规则的计算 | 仍需精度、范围和舍入约定 |
格式化、计算和分摊分开检查:计算函数返回可复核的十进制总额与每人金额,输出层再加单位并显示两位小数。若只有一个总额却要求每人支付同样的两位小数,除不尽时就无法同时保全总额;本文明确让前若干人多付一分,而不是隐藏差额。该规则适合本练习,不能代替真实结算、退款和审计设计。
容错清洗:先清洗后强转的纪律
strip() 默认处理两端空白,不会自动修正全角百分号、逗号或中间的单位。strip("%") 反复去掉两端的百分号字符,并不是"恰好移除一个合法后缀";15%% 可能被误收。这里用 endswith("%") 检查一个后缀,再验证剩余数字,拒绝多个百分号。清洗只处理明确允许的格式噪声,try/except 仍用于表达解析失败,两者不能相互替代。
用 type() 核对解析前后的值
在分账输入处打印 repr(raw)、type(raw),可以看清空白和字符串类型;这比猜测表达式哪里出了问题更直接。调试完成后删除或受控输出这些内容,避免把真实账单和其他敏感输入长期记录到日志。
排错时先复现最小输入,再查看类型与值:"10%" 在转换前是字符串,是否接受它应由解析函数说明。团队文档可以记录这些可重复步骤,不能预先承诺它比任何检查工具都更有效。静态检查、运行测试和人工阅读分别解决不同问题。
三类典型失败模式
可以直接回放三类失败:字符串乘浮点触发 TypeError,没有解析百分号的 float("10%") 触发 ValueError,int("12.5") 也触发 ValueError。这些例子说明具体操作的输入要求;并不是所有字符串运算都会失败,例如字符串可以与整数相乘。完整程序拒绝坏输入并给出字段提示,而不是让堆栈替读者解释规则。
这三类失败提示同一件事:先为每个字段定义允许的文本,再验证解析结果与业务边界。金额不能为非有限值,人数不能为 0,比例也不能无限增大。本例设置账单不超过一百万元、人数不超过 1000、每种比例不超过 100%,只是为了让教学程序的范围明确;修改这些上限需要连同失败用例一起修改。
Jargon Jumble 数据骨架:列表、元组与随机模块
序列家族的最小语法切面
Jargon Jumble 让玩家根据提示复原被打乱的术语。词库记录需要一起传递术语与提示,抽到的题目要按轮次保存,字符列表则交给洗牌函数修改。列表、元组和字符串在这里各自承担具体操作,不能仅靠容器名称推断游戏是否正确。
列表 [] 与元组 () 的最小对照
列表用方括号创建,支持零索引和负索引;非空列表的 words[-1] 读取末项,空列表会抛 IndexError。元组的关键语法是逗号,单元素元组需写成 ("python",),只有括号没有逗号并不能创建单元素元组。下面先演示列表追加与元组槽位不可赋值,再在捕获预期异常后继续解包。
python
words = ["python", "tuple", "shuffle"]
record = ("python", "a large snake")
words.append("matrix")
try:
    record[1] = "small snake"
except TypeError:
    print("元组槽位不能赋值")
term, hint = record
assert words[-1] == "matrix" and term == "python"
print(term, hint)序列解包把右侧的元素分别绑定到左侧名字:term, hint = record。普通解包要求数量匹配,不限于元组;列表也可以解包。带星号目标能接收剩余元素,但本练习固定两个字段,不需要引入它。词库记录用两个字符串组成的元组,便于表达"术语与提示是一条记录",并不意味着所有记录都只能用元组。
字符串与列表的互转语法
Jargon Jumble 把一个术语打乱顺序,本质上是把字符串变成字符列表、洗牌、再拼回字符串。Python 把这两个方向都压缩成了最短语法:list('cat') 一次性拆出 ['c', 'a', 't'];''.join(['c', 'a', 't']) 一次性拼回 'cat'。中间的洗牌动作交给 random.shuffle(),整个关卡生成逻辑可以压缩到几行:
python
import random
term, hint = ("tuple", "an immutable sequence")
chars = list(term)                           # 字符串 -> 列表
random.shuffle(chars)                        # 原地打乱
scrambled = ''.join(chars)                   # 列表 -> 字符串
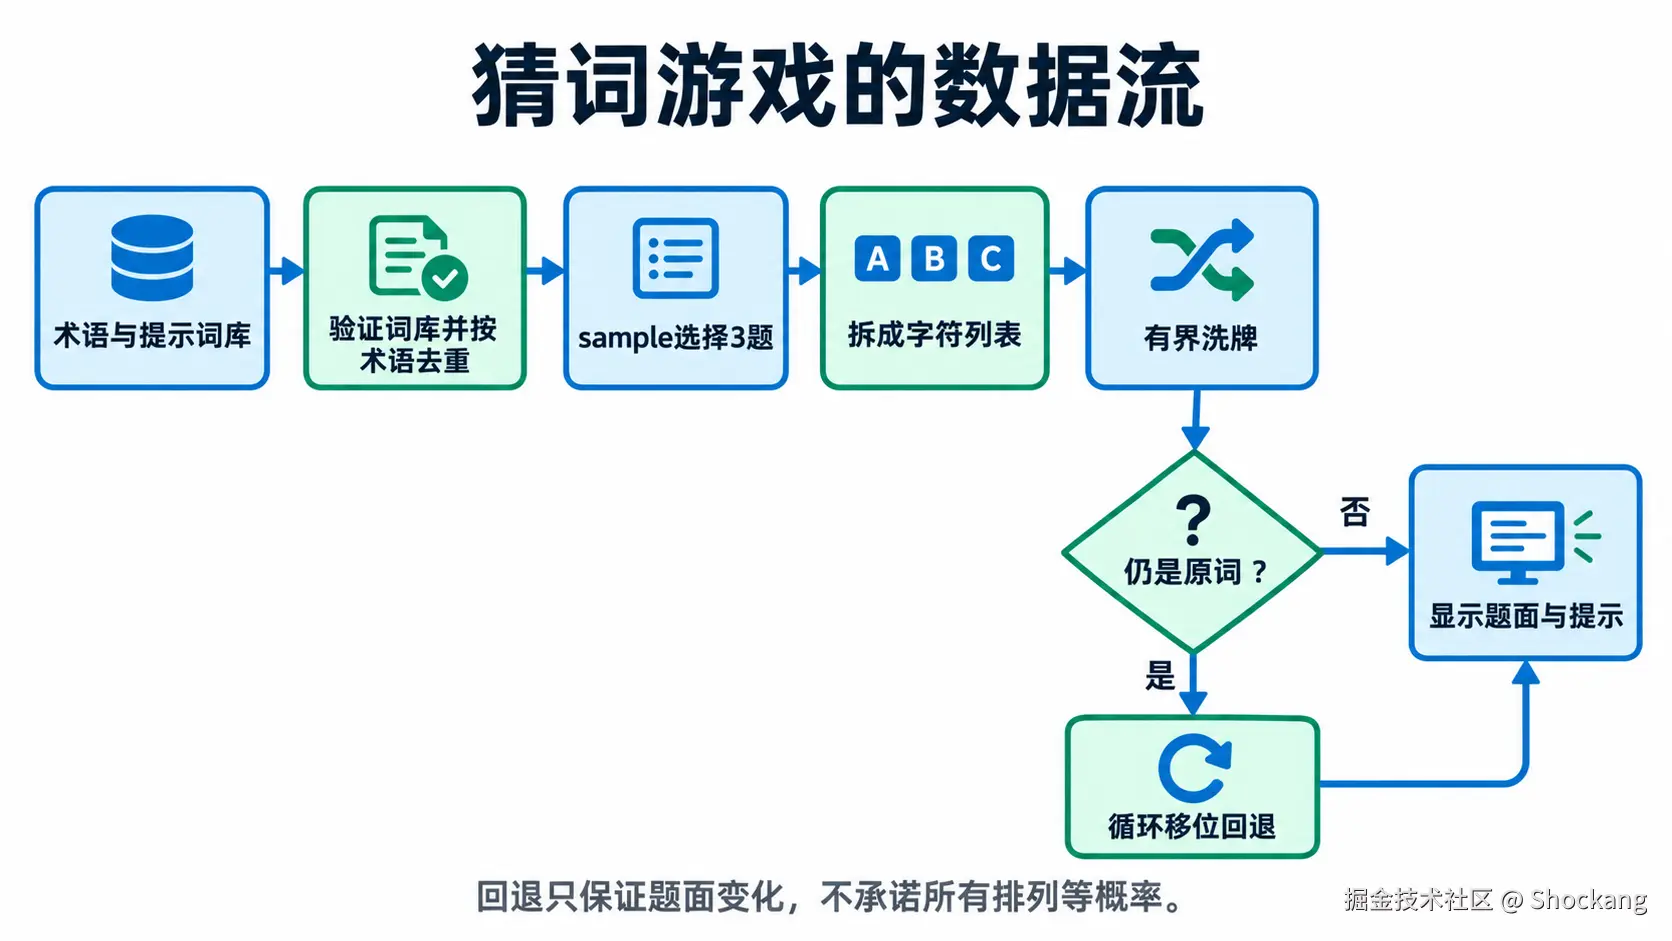
shuffle 原地修改列表,并返回 None。若把返回值重新绑定给 chars,这个名字就不再指向字母列表。一次洗牌也可能得到原字符串;字母重复或只有一种字符时尤其需要明确玩法。完整游戏最多尝试有限次洗牌,仍相同时使用循环移位;这只是避免题面原样显示的教学策略,不宣称所有有效排列仍然等概率。
random.choice 与 random.shuffle 的语义差
random.choice(seq) 从非空序列取出一个元素,不修改该序列;random.shuffle(seq) 原地改变可变序列,返回 None。前者可以用于选择一题,后者可以用于改变字母顺序。完整游戏另用 sample 选择有限题集,并检查去重后的题数,避免把 choice 误当作无放回抽样。
用 (word, hint) 元组保存词库记录
Jargon Jumble 的词库可以表示为一组"术语与提示"记录。把两个字段放进一个二元元组,再嵌套进外层列表,是本练习采用的容器组合;读者可以分别检查单条记录的两个字段,以及整份词库中术语是否重复、题数是否足够。
python
jargon_bank = [
    ("tuple",     "an immutable sequence"),
    ("shuffle",   "randomize order in place"),
    ("hashable",  "usable as a dict key"),
]
这里的元组只包含字符串,槽位和成员都不会被本例原地修改;若元组包含列表,列表内容仍可变,所以不能把元组称为深度不可变保险柜。词库外层也可以用元组表示固定配置。后续程序先检查术语的非空、重复和可打乱性,再抽题;不能仅因记录采用元组就推断输入已经安全。
列表 vs 元组的取舍矩阵
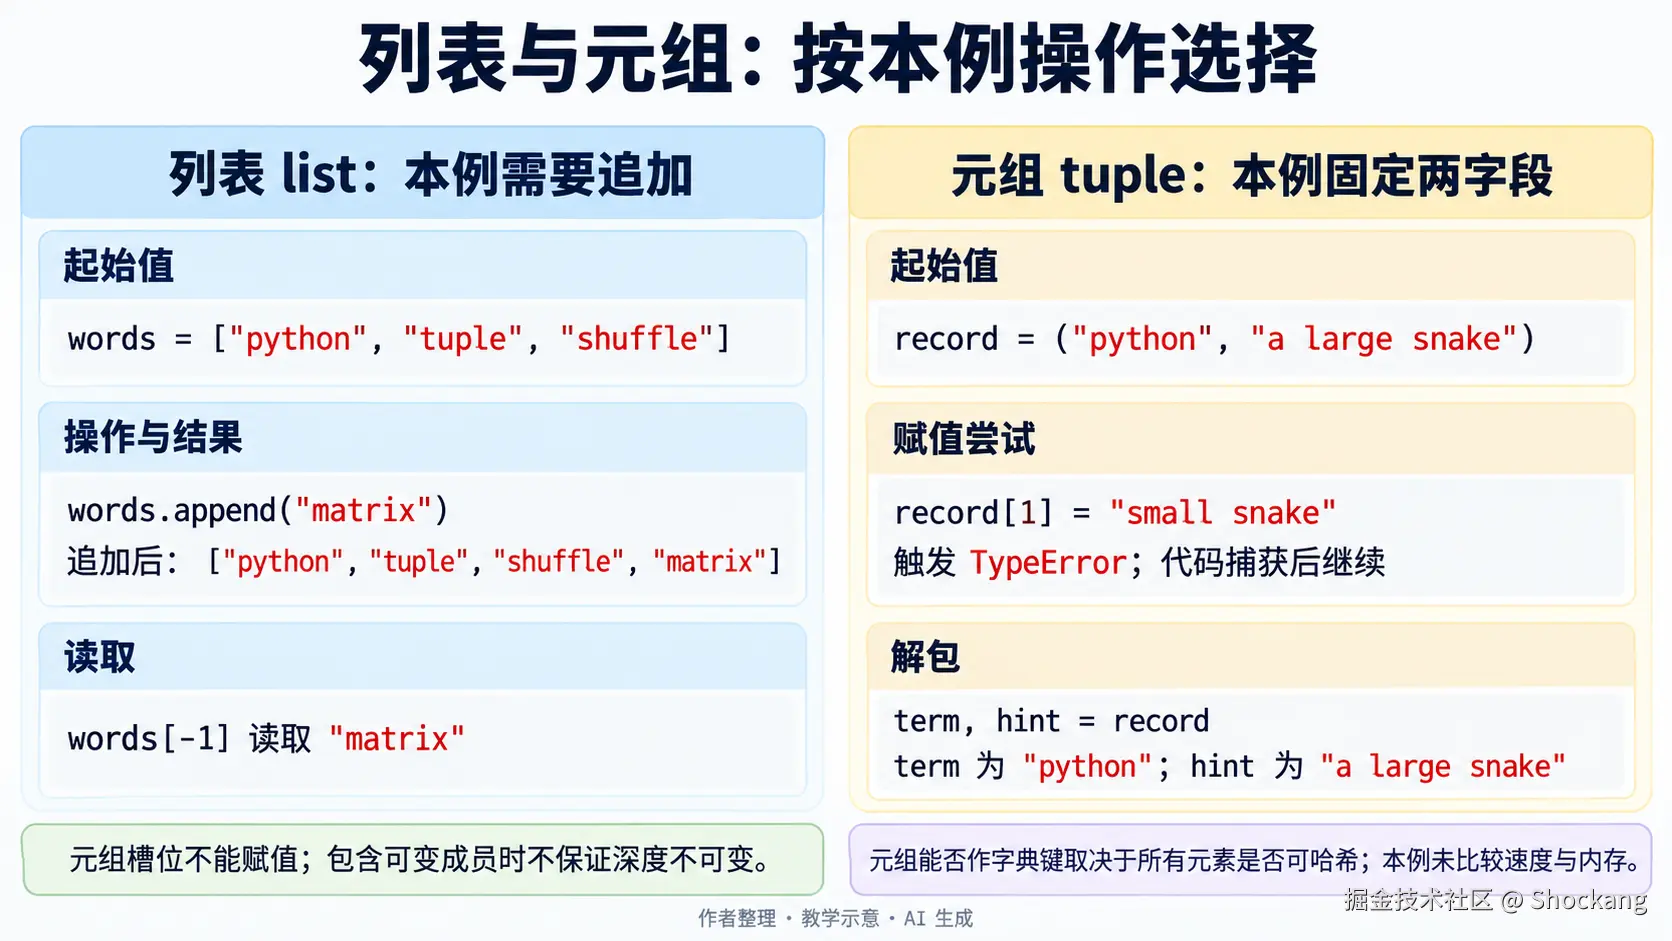
作者根据本文示例整理。两列展示现有代码中的操作与结果;元组槽位不可赋值不代表成员深度不可变。配图由 AI 生成,作者核对。
| 维度 | 列表 list |
元组 tuple |
|---|---|---|
| 可变性 | 可以追加、扩展或重新绑定槽位 | 不能给已有槽位赋值;变量名仍可绑定新元组 |
| 语义 | 有序、可变的集合 | 异构字段的轻量记录 |
| 可哈希性 | 不可哈希 | 仅所有元素均可哈希时可作字典键 |
| 内存与实现 | 取决于实现、元素和扩容状态 | 需在固定实现与输入下测量,本文未比较 |
| 典型用途 | 关卡队列、字母序列 | 词库记录、函数多返回值 |
何时选哪个
选择容器先看操作:需要增删字母时用列表,需要表达固定两字段记录时可用元组;字典、命名元组或数据类也能表达记录。函数返回多个值常以元组打包,但并不禁止返回列表或对象。字典键可以是任何可哈希对象,不只元组。下面保留列表与元组作入门对照,避免把教学选择写成语言限制。
元组和列表的具体内存布局属于实现细节,不能从"元组不可变"直接推出所有负载都更省内存或更快。若将来确实遇到大量记录,先固定解释器、记录内容与测量方法,再比较整体内存和耗时。本练习没有这类测量,容器选择依据可变性和所需操作,而不是未复现的微优化收益。
参考文档:
猜词游戏的循环、分支与完整程序
每道题怎样推进到下一步
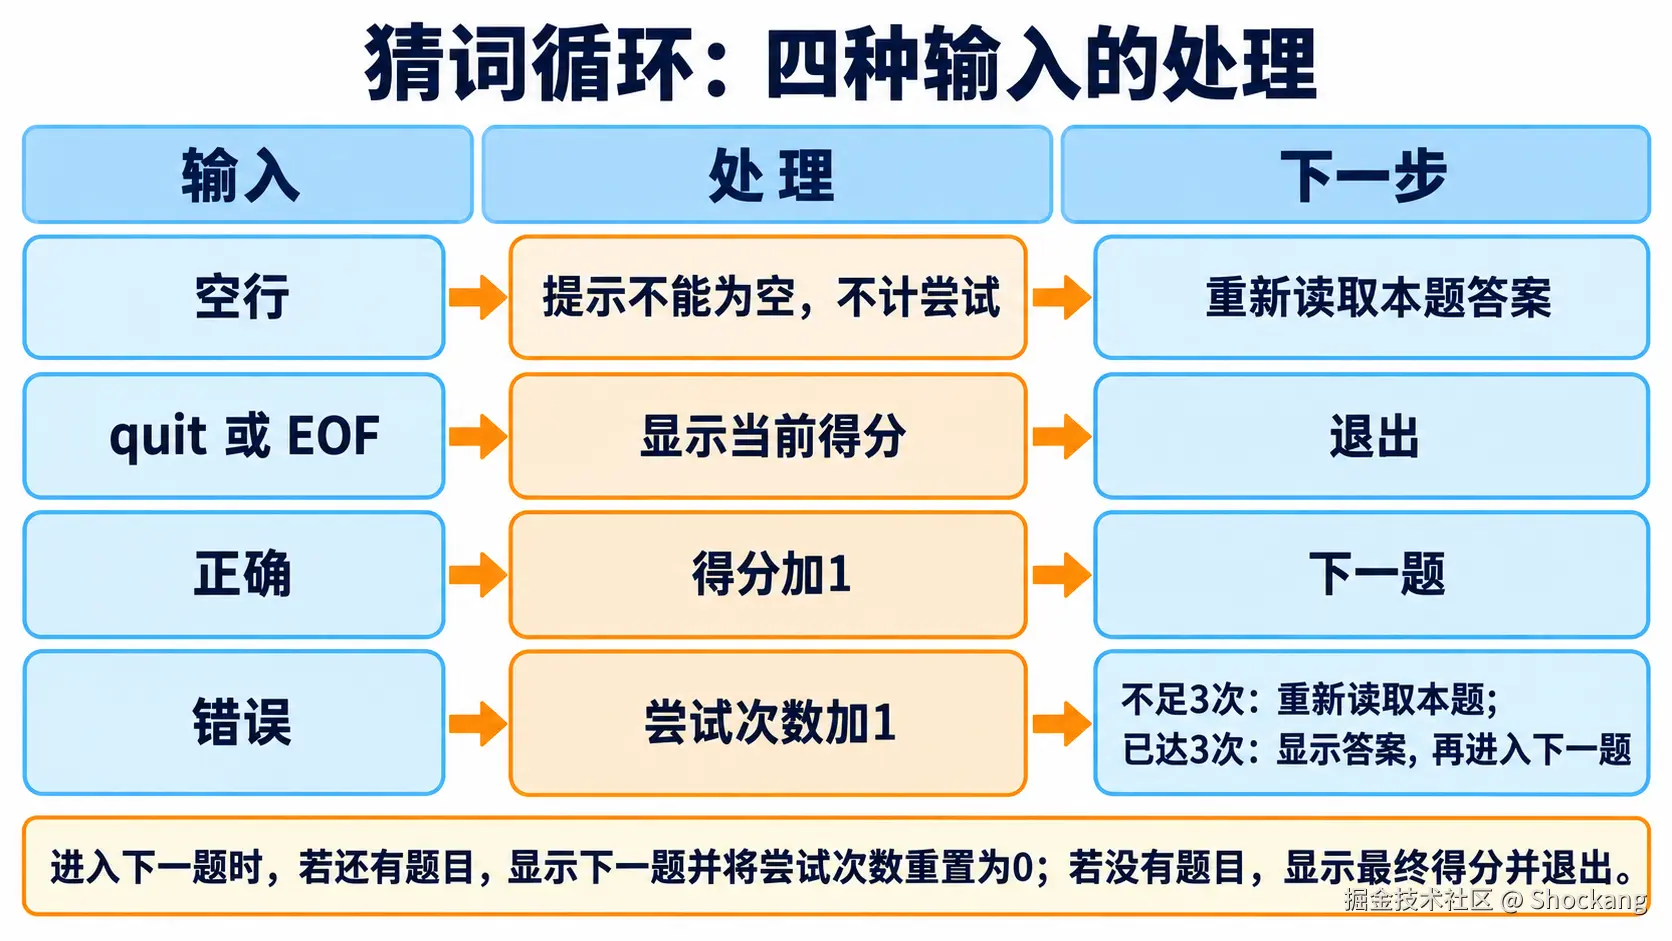
完整猜词程序先抽出有限题集,再逐题读取答案。非空猜测会消耗一次尝试,猜对时增加得分并结束当前题,猜错达到上限则显示答案;空行、主动退出和输入结束另走各自分支。把这些动作分开,才能检查轮次、尝试次数和得分是否在正确的位置变化。
while 与 for 的驱动源差异
while 每轮先检查条件,条件为真才运行循环体;for 逐项消费可迭代对象,直到迭代结束。知道需要五轮时用 for range(5) 通常更直接;需要等玩家输入退出命令时,while 也很自然。break 结束最近一层循环,continue 跳过当前轮剩余部分;在 while 中它会回到条件检查,不会自动推进你自定义的计数器。
| 控制语句 | 作用范围 | 典型用途 |
|---|---|---|
break |
跳出最近一层循环 | 玩家输入正确立即结算 |
continue |
跳过本轮剩余语句 | 空输入重新询问;是否计数由代码决定 |
用 enumerate() 显示编号
旧式写法要在 for 外面先声明 i = 0,然后循环体里 i += 1,既冗长又容易漏写。enumerate() 把「索引 + 元素」打包成一个元组一起返回,等效于把计数器内建进语言里:
python
words = ["python", "tuple", "shuffle"]
for idx, w in enumerate(words, start=1):
print(f"{idx}. {w}")这里依次输出三行编号,start=1 使显示从 1 开始。若在代码里访问原列表,仍需使用它的零索引;显示编号和存储索引是两个约定,不能因为显示从 1 开始就直接用编号访问列表。
if、elif、else 的四个空格约定
Python 用缩进层级划分代码块;PEP 8 推荐每级四个空格。解释器关注一致的缩进关系,并不把"四个"写成唯一合法宽度;混用制表符和空格可能触发错误。if/elif/else 按条件顺序选择分支,命中后不会再执行后续分支。下面用目标词 term 比较答案,而不是把打乱后的题面误当标准答案。
python
term = "tuple"
scrambled = "pelut"
guess = input(f"{scrambled}(提示:不可变序列): ").strip().casefold()
if not guess:
    print("不能为空")
elif guess == term:
    print("正确!")
else:
    print("差一点点,再想想")
将编辑器设为缩进时插入四个空格,可让示例与 PEP 8 风格一致。语法检查能发现部分缩进错误;即使代码合法,缩进把语句放错分支也需要运行场景检查。风格建议与词法规则分别见 PEP 8 和 Python 语言参考。
字符串按字母顺序比较的陷阱
字符串按 Unicode 码点逐项进行词典序比较,不按自然语言的地区排序规则处理。例如 sorted(["ant", "Bee", "cat"]) 得到 ["Bee", "ant", "cat"]。若游戏约定忽略大小写,可以对两边都用 casefold() 后比较;按词排序则可显式写 sorted(words, key=str.casefold)。不要把普通字符串大小比较解释成单词难度或语义顺序。
在 ASCII 范围内,大写字母 A--Z 的码点是 65--90,小写 a--z 是 97--122,两者之间整整隔着 6 个非字母字符。要做不区分大小写的比较,统一走 str.casefold()(比 lower() 更激进,能处理德语 ß 等特殊字符)再比较,或直接转成小写再排序,不要在 if 里依赖默认的字典序直觉。
计数器模式:固定局数的标准写法
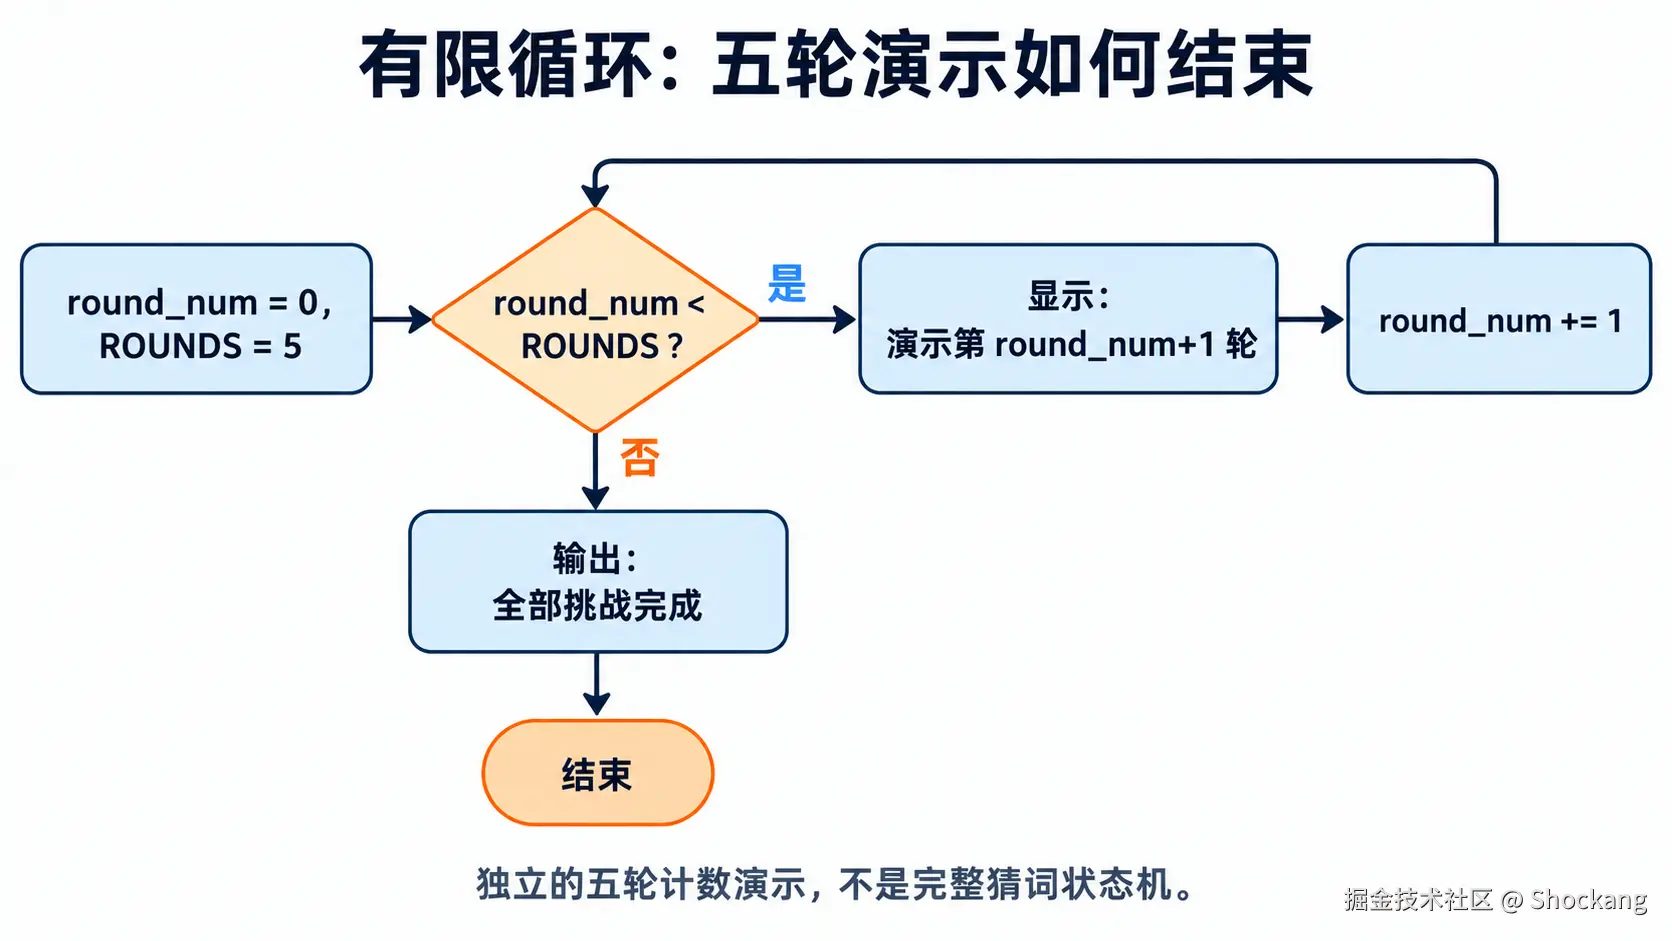
「玩 N 局就结束」是回合制游戏的常见需求。教科书式的写法是把局数声明为模块级常量,循环体内逐局递增:
python
ROUNDS = 5

def play_one_round(number):
    print(f"演示第 {number} 轮")

round_num = 0
while round_num < ROUNDS:
    play_one_round(round_num + 1)
    round_num += 1
print("全部挑战完成")
把 ROUNDS 放在顶部便于核对上限,但大写常量属于 PEP 8 建议,不会阻止再次赋值。这个独立演示先检查 round_num < ROUNDS,显示从 1 开始的轮号,再递增计数器;第五轮后条件为假,输出"全部挑战完成"。完整猜词程序改用已抽出的题集驱动外层循环,不把演示轮号当作得分。
抽题前先去重,再保存本轮题集
重复题会影响练习体验,可以记录已使用的术语。但"抽到重复就重抽"在要求题数超过不同术语数时根本无法完成,未超过时也没有确定的重抽次数上限。这里先显式去重,再核对需要的题数,用 random.sample 一次取得有限题集;状态仍在循环外,却不再依赖无限重抽。
python
import random
pool = ["tuple", "shuffle", "tuple", "hashable"]
unique_pool = list(dict.fromkeys(pool))
total = 3
if not 0 <= total <= len(unique_pool):
    raise ValueError("题数超出不同术语数")
used = []
for pick in random.Random(7).sample(unique_pool, total):
    used.append(pick)
assert len(used) == len(set(used)) == total
print("本局题目:", used)
used 放在会话层,能够在循环结束后检查出题记录;这份状态应与一次游戏的生命周期一致。示例没有把状态藏进全局共享列表,也没有修改原题池。需要"回顾出题"时读 used;需要"撤销"时还要另外定义分数和轮次如何回滚,不能只删除列表末项就声称所有状态都恢复。
取舍矩阵:去重放在哪里
| 方案 | 实现位置 | 优点 | 缺点 |
|---|---|---|---|
抽到重复就 continue 重抽 |
抽题循环内 | 逻辑直观,代码量少 | 没有确定的重抽次数上限,要求过多时不能完成 |
先去重,再 random.sample(pool, k) |
抽题循环外 | 题数有界,不改原题池 | 需要保存抽样结果;先核对 k 不超过不同术语数 |
抽出后从 pool 里 remove |
抽题循环内 | 题池递减,不会再次取到已删除位置 | 按值查找并移除第一个匹配项;原池有重复值时仍须先去重 |
本练习的三个词不需要复杂优化,选择一次性抽样是为了保证结束边界清楚。sample 按元素出现位置无放回抽样,原题池如果有重复值,结果仍可能出现相同值,因此去重与抽样是两个步骤。大量题目是否需要流式抽样,应另行明确需求。
下面把已选题集、题内尝试次数与整局得分接进一个完整程序。读写函数与随机数实例都从参数传入,测试时可以给出固定输入;随后"函数与作用域"一节再解释这些接口为何这样划分。
把下段保存为 jargon_jumble.py,执行 python3 jargon_jumble.py。三题分别从去重后的固定词库中无放回抽出,每题最多三次非空猜测;空行不消耗猜测次数,quit 或输入结束退出。玩家也可以一直输入空行,因此有限题数和有限有效猜测次数并不限制整段会话的时间。
python
# 保存为 jargon_jumble.py;固定词库,只练习ASCII术语。
import random

BANK = (("tuple", "不可变序列"), ("shuffle", "原地洗牌"),
        ("hashable", "可作字典键的性质"))
ROUNDS = 3
MAX_ATTEMPTS = 3


def make_questions(bank, rounds, rng):
    seen = set()
    unique = []
    for term, hint in bank:
        if (not isinstance(term, str) or not term.isascii()
                or not term.isalpha() or not term.islower() or len(set(term)) < 2
                or not isinstance(hint, str) or not hint.strip()):
            raise ValueError("词库须为可打乱的小写ASCII单词与非空提示")
        if term in seen:
            continue
        seen.add(term)
        unique.append((term, hint))
    if type(rounds) is not int or not 0 <= rounds <= len(unique):
        raise ValueError("轮数超出不同术语数")
    return rng.sample(unique, rounds)


def scramble(term, rng):
    chars = list(term)
    for _ in range(8):
        rng.shuffle(chars)
        result = "".join(chars)
        if result != term:
            return result
    # 有界回退保证题面发生变化;这不是均匀随机排列承诺。
    return term[1:] + term[:1]


def play(bank=BANK, rounds=ROUNDS, rng=None, read=input, write=print):
    rng = random.Random() if rng is None else rng
    questions = make_questions(bank, rounds, rng)
    score = 0
    for number, (term, hint) in enumerate(questions, 1):
        write(f"第{number}题:{scramble(term, rng)};提示:{hint}")
        attempts = 0
        while attempts < MAX_ATTEMPTS:
            try:
                guess = read("答案(quit退出): ").strip().casefold()
            except EOFError:
                write(f"输入结束,得分{score}/{len(questions)}")
                return score
            if guess == "quit":
                write(f"提前退出,得分{score}/{len(questions)}")
                return score
            if not guess:
                write("不能为空,本次不计尝试")
                continue
            attempts += 1
            if guess == term:
                score += 1
                write("正确")
                break
            write(f"未猜中,剩余{MAX_ATTEMPTS-attempts}次")
        else:
            write(f"本题答案:{term}")
    write(f"完成,得分{score}/{len(questions)}")
    return score


if __name__ == "__main__":
    play()
正常完成后核对得分不超过题数,错误猜测三次后显示答案;用测试传入固定的 random.Random 与可记录的读写函数,可以检查题集而不依赖屏幕上某个随机顺序。
函数与作用域:分开输入、计算与状态
把词库验证、抽题和答题循环分开后,测试可以直接调用各函数。函数在这里承担命名和接口边界:它接收什么、返回什么、失败时是否改变状态,比是否用了某个抽象术语更具体。下面沿着参数、返回值、文档与作用域说明这种分工。
函数三件套:def、参数、return
def 定义函数对象,调用时把实参绑定到局部名字。return 将值和控制权交给调用者,没有显式返回值时返回 None;返回多个值通常通过元组打包。函数返回不保证相关对象立即销毁,例如闭包仍可保留被捕获的状态。下面的得分函数明确拒绝分母为 0、负数和得分越界,才与"归一化到 0 到 1"的说明一致。
python
def normalize_score(raw: int, max_value: int = 100) -> float:
    """将合法整数得分归一化到0到1;非法类型或范围抛ValueError。"""
    if type(raw) is not int or type(max_value) is not int:
        raise ValueError("得分与满分须为整数")
    if max_value <= 0 or not 0 <= raw <= max_value:
        raise ValueError("满分须为正数,得分须在0到满分之间")
    return round(raw / max_value, 4)

assert normalize_score(3, 5) == 0.6
print(normalize_score(3, 5))
类型注解记录期望的输入输出,但 Python 不会据此自动检查值。IDE 或静态检查器可以使用这些信息,是否在 CI 里执行取决于项目配置。这里仍在函数中验证普通整数与范围,并用断言实际调用;语言约定见 Python 的函数注解文档。
docstring:函数的「用户手册」
函数体的首条语句若是字符串字面量,它会成为 docstring;三重引号适合多行,但不是唯一写法。上一个例子用单行文档说明计算合同,这个例子改用参数、返回与异常说明,并实际读取 __doc__。
python
def normalize_score(raw: int, max_value: int = 100) -> float:
    """将整数得分归一化。

    Args:
        raw: 从0到满分的整数得分。
        max_value: 正整数满分,默认100。
    Returns:
        保留四位小数的0到1之间的浮点结果。
    Raises:
        ValueError: 参数不是普通整数或超出约定范围。
    """
    if type(raw) is not int or type(max_value) is not int:
        raise ValueError("得分与满分须为整数")
    if max_value <= 0 or not 0 <= raw <= max_value:
        raise ValueError("满分须为正数,得分须在0到满分之间")
    return round(raw / max_value, 4)

assert normalize_score(3, 5) == 0.6
doc = normalize_score.__doc__
assert doc is not None and "Args:" in doc and "ValueError" in doc
print(doc.splitlines()[0])
文档的重点是让调用者在执行前看清参数范围、成功返回值和预期异常。这里的 ValueError 对应前置的类型与范围检查:参数无效就不进入归一化计算,调用者可以据此安排错误提示。简单函数可以一行说明,边界多的函数再分别列出参数、返回和异常。
作用域边界:LEGB 规则
普通函数里的名字查找可以用 LEGB 记忆:局部、外层函数、模块全局、内置。读取外层名字不需要声明;重新绑定外层函数的名字要用 nonlocal,重新绑定模块全局名字要用 global。修改已引用列表的内容与重新绑定名字不同,前者并不因此自动需要这两个声明。类作用域等还有专门规则,这个记忆法不应替代完整执行模型。
python
counter = 0

def make_accumulator():
    state = 0
    def add(n: int) -> int:
        nonlocal state
        state += n
        return state
    return add

add = make_accumulator()
assert add(2) == 2 and add(3) == 5 and counter == 0
print("闭包累计:", add(0))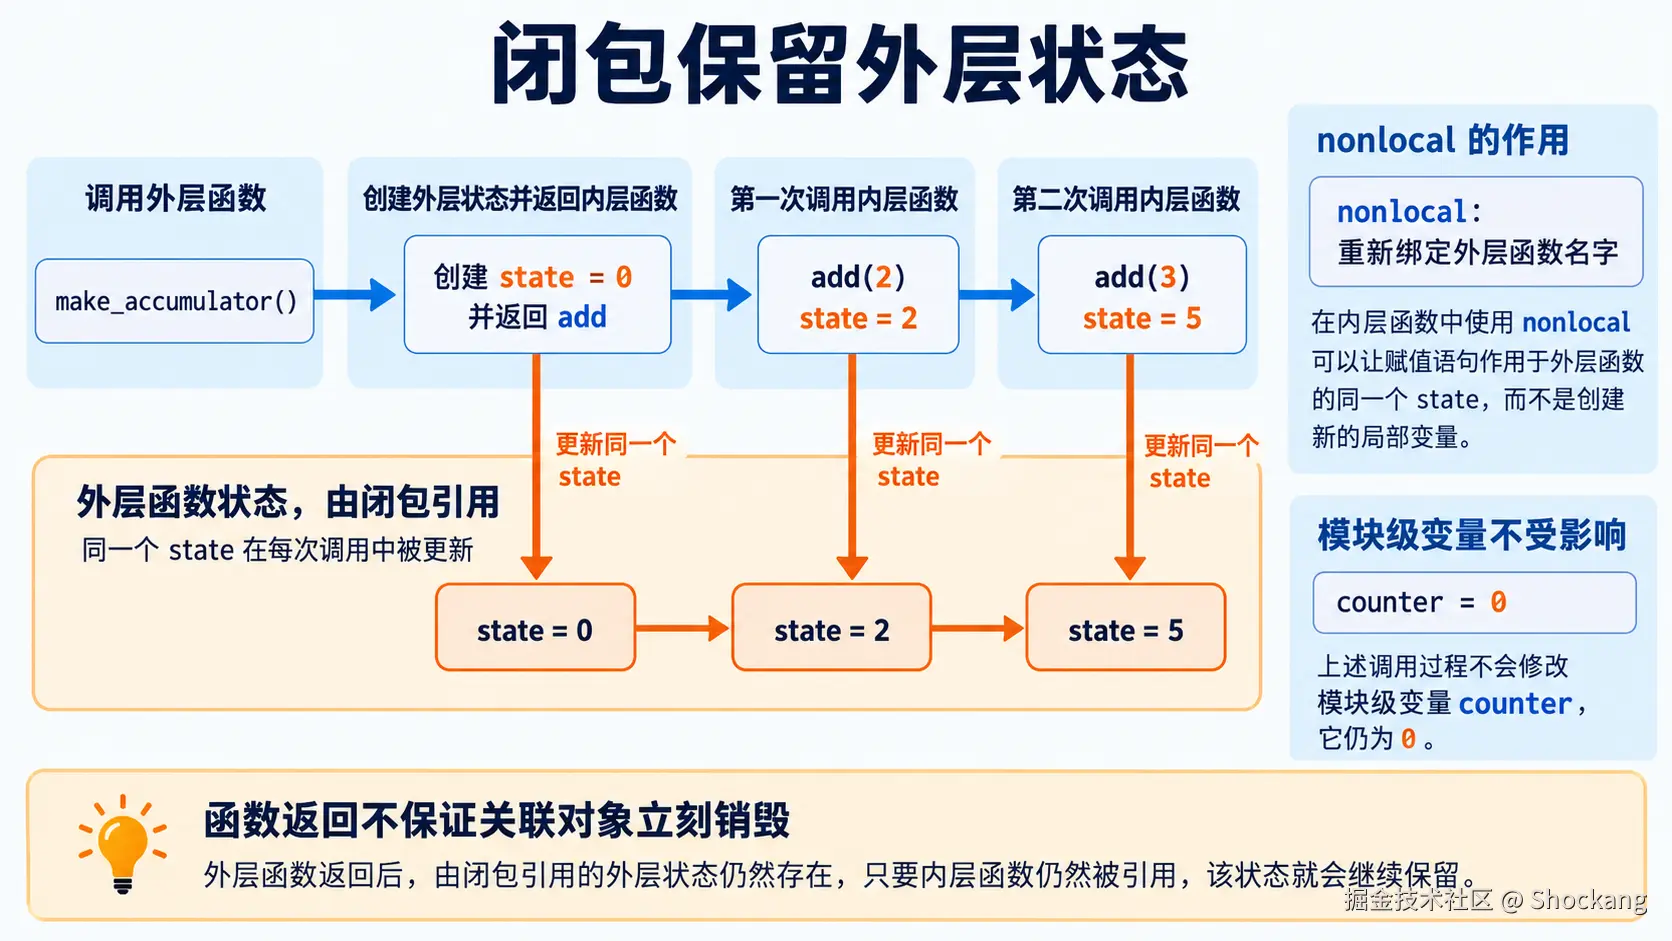
下表比较普通函数中的名字查找与重新绑定,不是权限隔离机制。容器内部的修改还要按对象本身的可变性判断。
| 名字查找层级 | 重新绑定的条件 | 读取方式 | 需要注意 |
|---|---|---|---|
| 局部 Local | 函数中的赋值通常绑定局部名字 | 按作用域规则查找 | 赋值前读取局部名可能触发 UnboundLocalError |
| 外层函数 Enclosing | 使用 nonlocal,且外层函数已有该名字的绑定 |
可以读取可见的外层名字 | 修改容器内容与重新绑定名字不同 |
| 模块全局 Global | 函数内重新绑定模块名字需 global |
按全局规则查找 | 同名局部绑定会遮蔽外层名字 |
| 内置 Built-in | 可能被当前作用域的同名名字遮蔽 | 更近作用域未找到名字时再查询 | 遮蔽 print 不等于修改了内置函数对象 |
Python 官方文档在 docs.python.org/3/reference... 把这套规则称作「execution model」。新手最常踩的坑是 UnboundLocalError:函数体内引用了外层变量又对其赋值,解释器在编译期就把该名认定为局部,赋值之前的读取直接报错,而不是悄悄改写外层值。
按输入、计算与状态划分函数
函数边界可以按职责判断:解析函数把文本转成数值,计算函数不读取终端,主函数处理交互与退出。行数可以提醒读者审视复杂度;一个清楚的函数是否拆分,还要看状态、重复和测试能否独立。新增一个函数名并不会自动降低复杂度。
单一职责 vs 多职责函数的工程取舍
| 维度 | 按职责拆分 | 在一个函数中组合 |
|---|---|---|
| 可读性 | 清楚命名与接口有利阅读;过度拆分也增加跳转 | 简单流程集中呈现,复杂后需重新划界 |
| 可测试性 | 输入输出明确时便于独立测试 | 可结合场景测试,也可逐步抽出纯计算 |
| 调用层次 | 可能增加调用,开销须在具体负载测量 | 可能减少跳转,仍须看整体设计 |
| 复用性 | 明确接口便于组合,但仍取决于依赖与状态 | 也可以复用整段流程;职责混杂时难以单独替换 |
| 适用场景 | 业务逻辑、工具函数 | 启动器、强耦合脚本 |
字典派发:让处理函数返回是否继续
字典派发可以把命令字符串映射到函数。这个独立练习使用 play/replay/pause/favorite/quit:四个动作函数打印示意文本并返回 True,退出函数返回 False,主循环将返回值绑定到 is_running。它演示函数如何把控制权交回调用者;后续完整队列程序使用另一组命令,不应把两组接口拼接使用。
python
def play_song():
    print("示意动作:播放")
    return True

def replay_last():
    print("示意动作:重放")
    return True

def pause_playback():
    print("示意动作:暂停")
    return True

def mark_favorite():
    print("示意动作:收藏")
    return True

def quit_app():
    return False

commands = {"play": play_song, "replay": replay_last,
            "pause": pause_playback, "favorite": mark_favorite, "quit": quit_app}

def main_loop():
    is_running = True
    while is_running:
        try:
            raw = input("> ").strip().lower()
        except EOFError:
            break
        handler = commands.get(raw)
        if handler is None:
            print("可用 play / replay / pause / favorite / quit")
            continue
        is_running = handler()

if __name__ == "__main__":
    main_loop()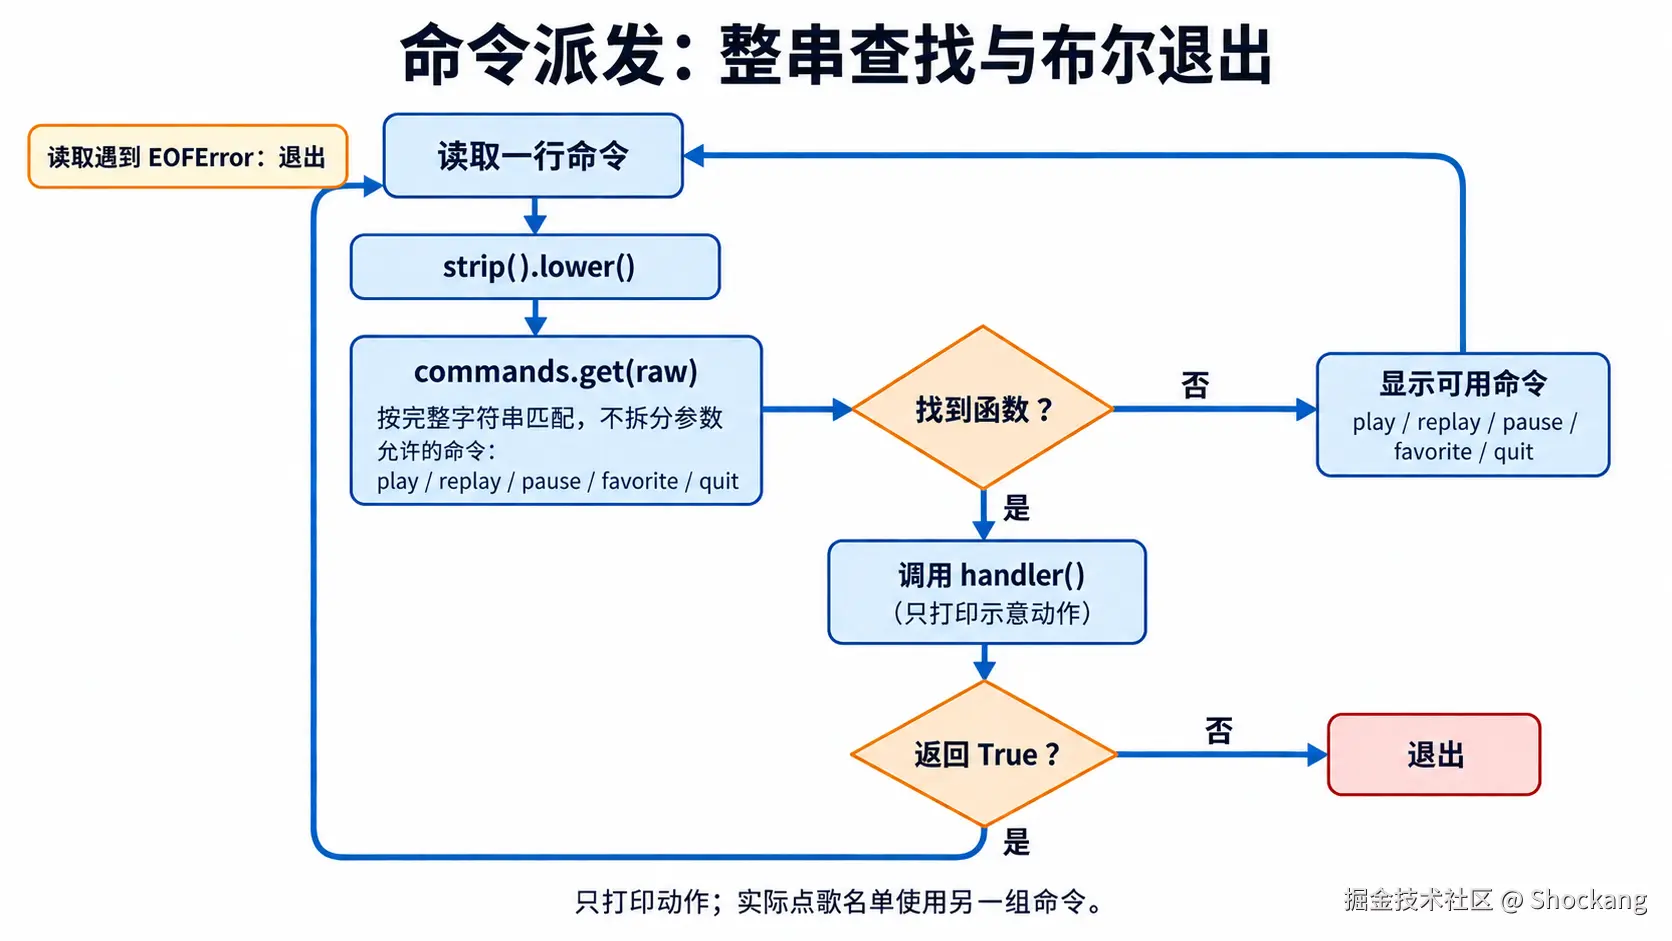
先对整行执行 strip().lower(),再用 commands.get(raw) 查找函数;没有命中就提示可用命令并继续读取。命中后执行 handler(),返回值决定下一轮是否继续,EOFError 则直接结束输入循环。这段代码没有分词;后面的点歌名单程序才拆分命令与参数。
布尔条件与 break 的取舍
让处理函数返回布尔值,适合所有处理函数都遵守同一返回合同的情况;直接在退出分支写 break 也可以。前者的调用方需要检查返回值,后者把退出判断留在循环内。命令分支也可以用 if/elif 表达;处理函数若可能抛出错误,还需单独约定恢复方式。
Sing Out 实战:队列、守卫子句与异常处理
Sing Out 的目标是管理一份终端点歌名单:添加名字、取走队首、移动位置、显示队列和退出,不实际连接播放器。下面先看列表的基本动作,再把这些动作收进完整程序。
用列表表达队列操作
列表可以按所需操作实现先进先出的队列:尾部 append,头部 pop(0);insert(0, item) 则是明确的插队,不属于严格 FIFO 规则。空列表弹出会失败,所以完整程序先检查是否为空。下面先用列表把位置、增删和失败后的名单状态接起来。
python
queue = []
queue.append("python")     # 入队
queue.append("function")   # 入队
queue.insert(0, "guard")   # 插队到头部
head = queue.pop(0)        # 出队,得到 "guard"
完整程序会返回成功操作后的新名单。先把显示位置换算、参数校验与状态更新接起来,再用具体命令检查一次错误会不会改变名单。
显示位置与列表索引
Sing Out 的位置选择是典型 1-based 暴露面:屏幕打印「第 3 位歌手」,用户大脑形成 1-based 坐标;但 queue[3] 实际访问的是第四个元素。用户的「3」必须先减一,才能进入程序的 0-based 世界。
| 用户视角 | 程序视角 | 转换 |
|---|---|---|
| 第 1 位 | 索引 0 | idx = n - 1 |
| 第 5 位 | 索引 4 | idx = n - 1 |
| 第 0 位 | - | 视为非法输入 |
位置接口至少检查 1、当前队列长度以及长度加 1,另外检查 0、空队列和非整数文本。非空队列的两个端点应合法,其余越界或格式错误应返回提示。下面的 select_singer 负责已经解析的普通整数;完整程序的 read_index 负责终端文本到位置的转换。
守卫子句:边界条件前置
守卫子句把失败条件放在正常路径之前。下面先拒绝非整数,再拒绝越界位置,最后读取队列元素;每个返回点都对应一种可检查的结果。它减少了这个函数的嵌套层次,是否用于更复杂的流程仍要看具体分支。
python
def select_singer(choice, queue):
    if type(choice) is not int:
        return None, "请输入整数位置"
    if choice < 1 or choice > len(queue):
        return None, "位置超出范围"
    return queue[choice - 1], None

assert select_singer(1, ["甲", "乙"]) == ("甲", None)
assert select_singer(True, ["甲"])[0] is None
assert select_singer(0, ["甲"])[0] is None
assert select_singer(1, [])[0] is None
print(select_singer(2, ["甲", "乙"]))
守卫子句把非法类型和位置范围放在函数前部,合法路径就能直接返回选中名字。这里明确拒绝 bool,因为它是 int 的子类,不能只写 isinstance(choice, int) 就认为输入是普通整数。终端字符串解析仍是另一层责任,不在这个函数里偷偷转成数值。
用 ValueError 表示解析失败
int("abc") 会抛 ValueError,可以将解析失败转换成输入提示。下面的 parse_integer 接受 int 所支持的整数文本,例如两端空白或正负号;它只做转换,不验证位置必须为正或是否小于名单长度。与前面的 select_singer 相比,它承担的是文本入口这一层责任。
python
def parse_integer(raw):
    try:
        choice = int(raw)
    except ValueError:
        return None, "请输入整数"
    return choice, None

assert parse_integer("3") == (3, None)
assert parse_integer("abc")[0] is None
print(parse_integer("12.5"))
例如 parse_integer("-1") 能成功转换,但不是合法队列位置。转换成功与业务上合法是两项判断;本例用返回元组表达失败,完整程序的 read_index 则抛出 ValueError 交给主循环处理。两种接口都能成立,调用方必须与被调用方使用同一种约定。
这个小函数只捕获 int(raw) 的 ValueError,把转换失败变成提示。后面的完整程序采用另一种输入错误协议:read_index 和 apply_command 对非法位置、命令参数抛出预期的 ValueError,由 main 在调用边界统一显示提示并继续。apply_command 调用周围只捕获 ValueError,其他异常继续向外传播;这依赖函数把预期输入错误与内部逻辑错误分开,后者应暴露并修复,不能也包装成输入提示。
完整队列程序:命令、状态更新与退出
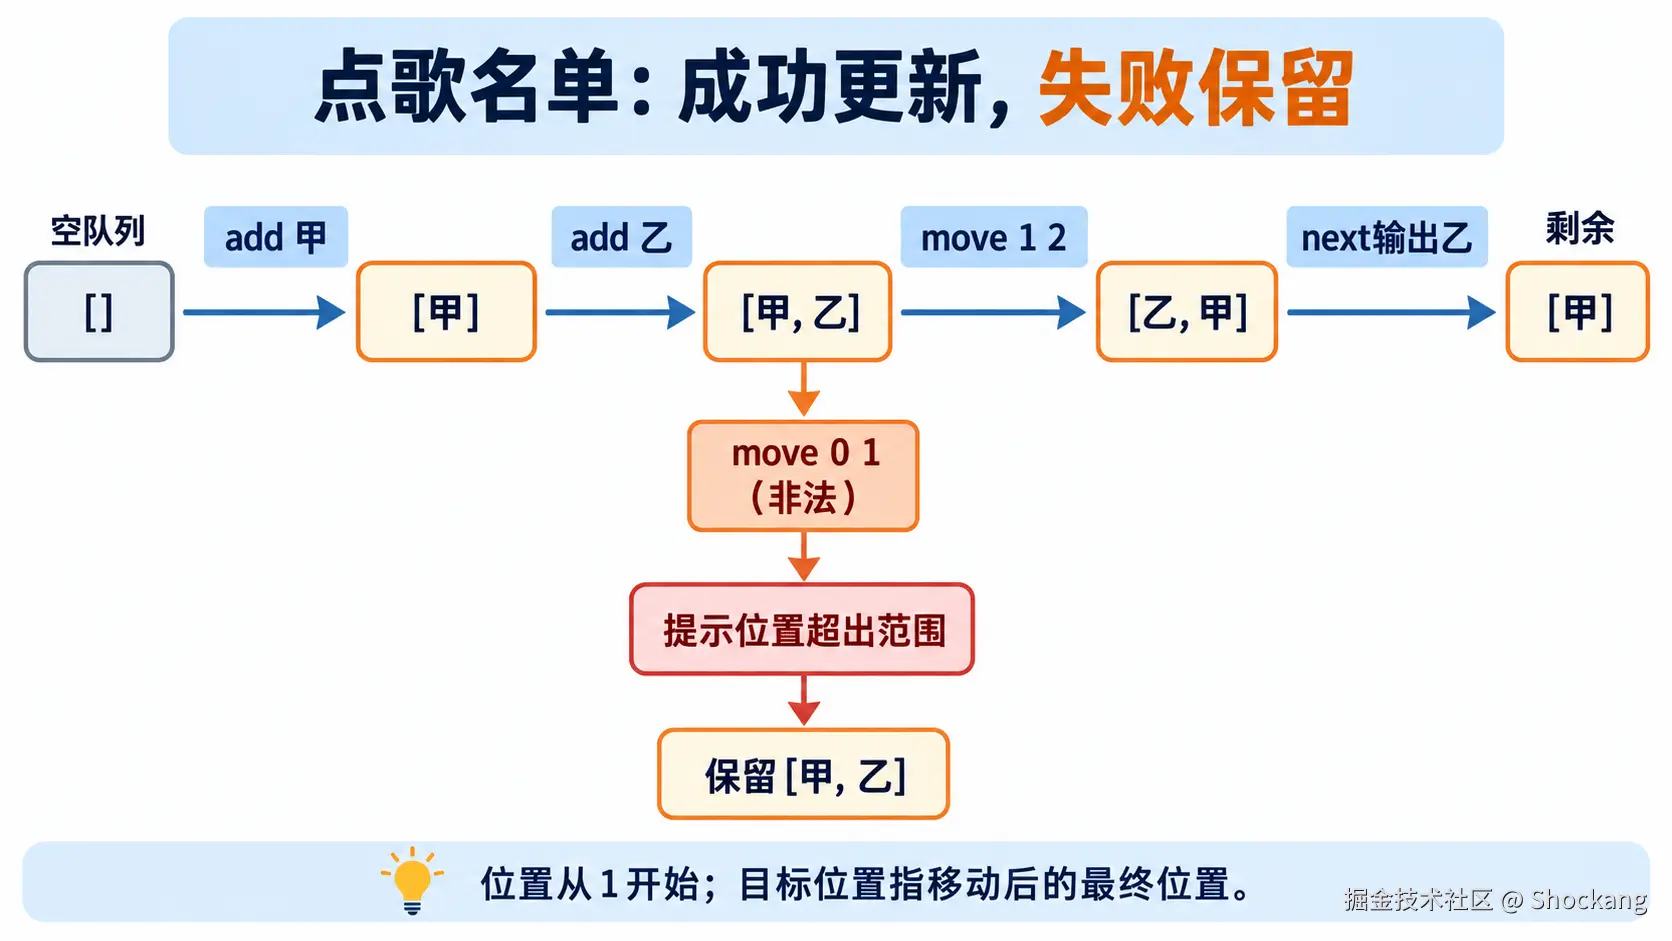
完整程序使用 add 名字 / next / move 原位置 目标位置 / list / quit。位置从 1 开始;move 1 3 的含义是将原第 1 位放到最终第 3 位,原队列中的其他元素保持相对顺序。先校验两个位置,成功后才修改复制出来的列表。下面整段保存为 sing_out.py,执行后可以按顺序输入 add 甲、add 乙、list、move 1 2、next、quit。
python
# 保存为 sing_out.py;只管理终端名单,不播放音频。
def read_index(raw, size):
    value = raw.strip()
    if (not value.isascii() or not value.isdecimal() or len(value) > 6):
        raise ValueError("位置须为ASCII正整数")
    index = int(value) - 1
    if not 0 <= index < size:
        raise ValueError("位置超出范围")
    return index


def apply_command(queue, line):
    # 使用新列表承接成功操作;失败时调用方保留原列表。
    parts = line.strip().split(maxsplit=1)
    if not parts:
        return queue[:], "请输入命令", True
    command = parts[0].lower()
    rest = parts[1] if len(parts) == 2 else ""
    if command == "quit":
        if rest:
            raise ValueError("quit不接受参数")
        return queue[:], "已退出", False
    if command == "list":
        if rest:
            raise ValueError("list不接受参数")
        return queue[:], ";".join(f"{i}. {name}" for i, name in enumerate(queue, 1)) or "队列为空", True
    if command == "add":
        name = rest.strip()
        if not name or len(name) > 80:
            raise ValueError("名字须为1到80个字符")
        return queue + [name], f"已加入:{name}", True
    if command == "next":
        if rest:
            raise ValueError("next不接受参数")
        if not queue:
            return [], "队列为空", True
        return queue[1:], f"下一位:{queue[0]}", True
    if command == "move":
        positions = rest.split()
        if len(positions) != 2:
            raise ValueError("用法:move 原位置 目标位置")
        source = read_index(positions[0], len(queue))
        target = read_index(positions[1], len(queue))
        result = queue[:]
        person = result.pop(source)
        result.insert(target, person)
        return result, f"已移到第{target+1}位:{person}", True
    return queue[:], "可用 add 名字 / next / move 原位置 目标位置 / list / quit", True


def main(read=input, write=print):
    queue = []
    running = True
    while running:
        try:
            line = read("> ")
        except EOFError:
            write("输入结束")
            break
        try:
            queue, message, running = apply_command(queue, line)
        except ValueError as error:
            write(f"输入错误:{error}")
            continue
        write(message)
    return queue


if __name__ == "__main__":
    main()
完整队列程序只接受公开列出的五个命令。空行和未知命令得到提示,输入结束正常退出;有效的 quit 则直接退出。名单只保存在 main 的局部列表中,关闭进程后消失;若需要保存,下次启动时怎样恢复就是新的接口要求。
守卫子句与异常处理的分工
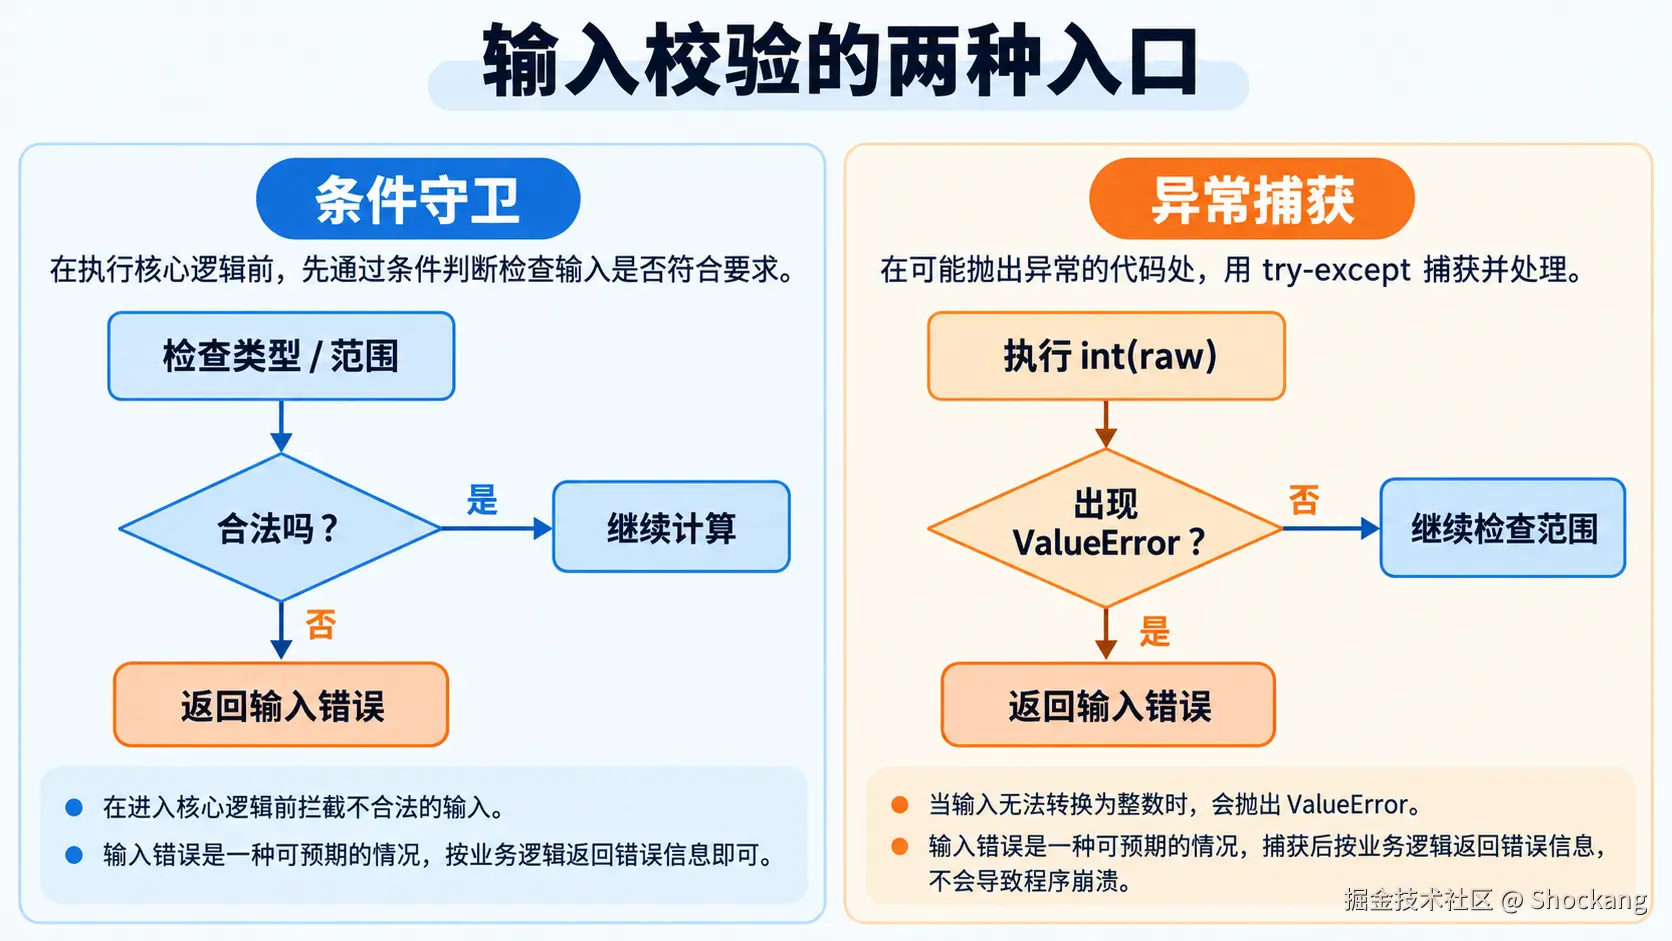
在完整队列程序中,read_index 先检查文本格式,再转换为零索引并核对范围;失败时抛出 ValueError。main 捕获它、输出原因并继续读取命令。守卫因此负责识别已知无效条件,异常则把失败传给调用方,两者协作而不互相排斥。
| 维度 | 守卫子句 | try/except |
|---|---|---|
| 处理对象 | 可直接检查的条件 | 操作抛出的约定错误,包含预期失败 |
| 触发时机 | 函数顶部 | 任意调用点 |
| 代码位置 | 主体前 | 包裹可疑调用 |
| 风格倾向 | 显式校验 | EAFP 先试后捕 |
| 典型用例 | 参数范围、类型 | IO、解析、外部依赖 |
检查状态提交点时,留意 queue, message, running = apply_command(queue, line):右侧成功返回后才绑定左侧名字。位置错误在复制并修改名单之前抛出异常,调用方因此仍持有原队列。这个顺序比仅仅看到 try/except 更能解释为何一次坏输入不会改掉名单。
跑完队列程序后,再检查容量与容器选择
先用刚才的 sing_out.py 核对状态:依次添加"甲""乙""丙",执行 move 1 3,名单应变成"乙、丙、甲";对这份三人名单执行 move 1 4,应得到位置错误,名单仍为"乙、丙、甲";接着执行 next,取走"乙",剩下"丙、甲"。这串输入同时检查移动后的最终位置、失败后保留状态,以及下一条合法命令能否继续。换容器时,这些结果应继续成立。
再看一个当前程序尚未实现的需求:满员时拒绝新名字,已排队的人不能消失。CPython v3.13.12 的 TestBasic.test_maxlen 使用容量为三的双端队列,断言追加后保留的是最近三项;满员时追加会淘汰另一端的旧项。同一文件的 test_insert_bug_26194 则断言满员队列执行 insert 会抛出 IndexError。这两条上游测试对应 Python 的 collections 文档 中不同的满员行为。因此,直接给点歌名单套上 deque(maxlen=人数上限),不会自动得到"拒绝新名字"的规则。需要在返回新状态前检查人数,并按现有 ValueError 协议报告;若使用 insert,也要在明确的状态边界处理预期的 IndexError,让主循环收到约定的输入错误。
接口也要逐项对照。列表头部 pop(0) 需要移动后续元素;deque 两端插入和弹出近似为 O(1),中部索引访问为 O(n)。它有 insert(i, x)、remove(value) 和 rotate(n),却没有列表 pop(i) 那样的按索引弹出接口。Sing Out 的 move 要处理任意位置,还要保持其他名字的相对顺序;只把队首弹出换成更快的两端操作,并没有完成这条命令的迁移。
最后看整条命令怎样提交状态。当前 next 返回切片,move 先复制再按位置移动,调用方在函数成功返回后才接收新名单。改成原地修改的双端队列后,也要保留前面回放的失败结果;继续复制可以隔离原状态,但复制元素的成本仍在,不能据一个两端操作就把整条命令记为 O(1)。判断是否迁移时,先确认实际耗时集中在两端操作,再补齐满员、移动和失败后继续操作的检查。允许丢弃旧项、只留最近若干条记录的任务可以采用有界队列;完整保留等待名单则需要显式拒绝规则。这里的依据是上游用例、文档合同和当前程序的状态变化,不是性能测量。
三项目复盘与后续扩展
三个项目如何管理状态
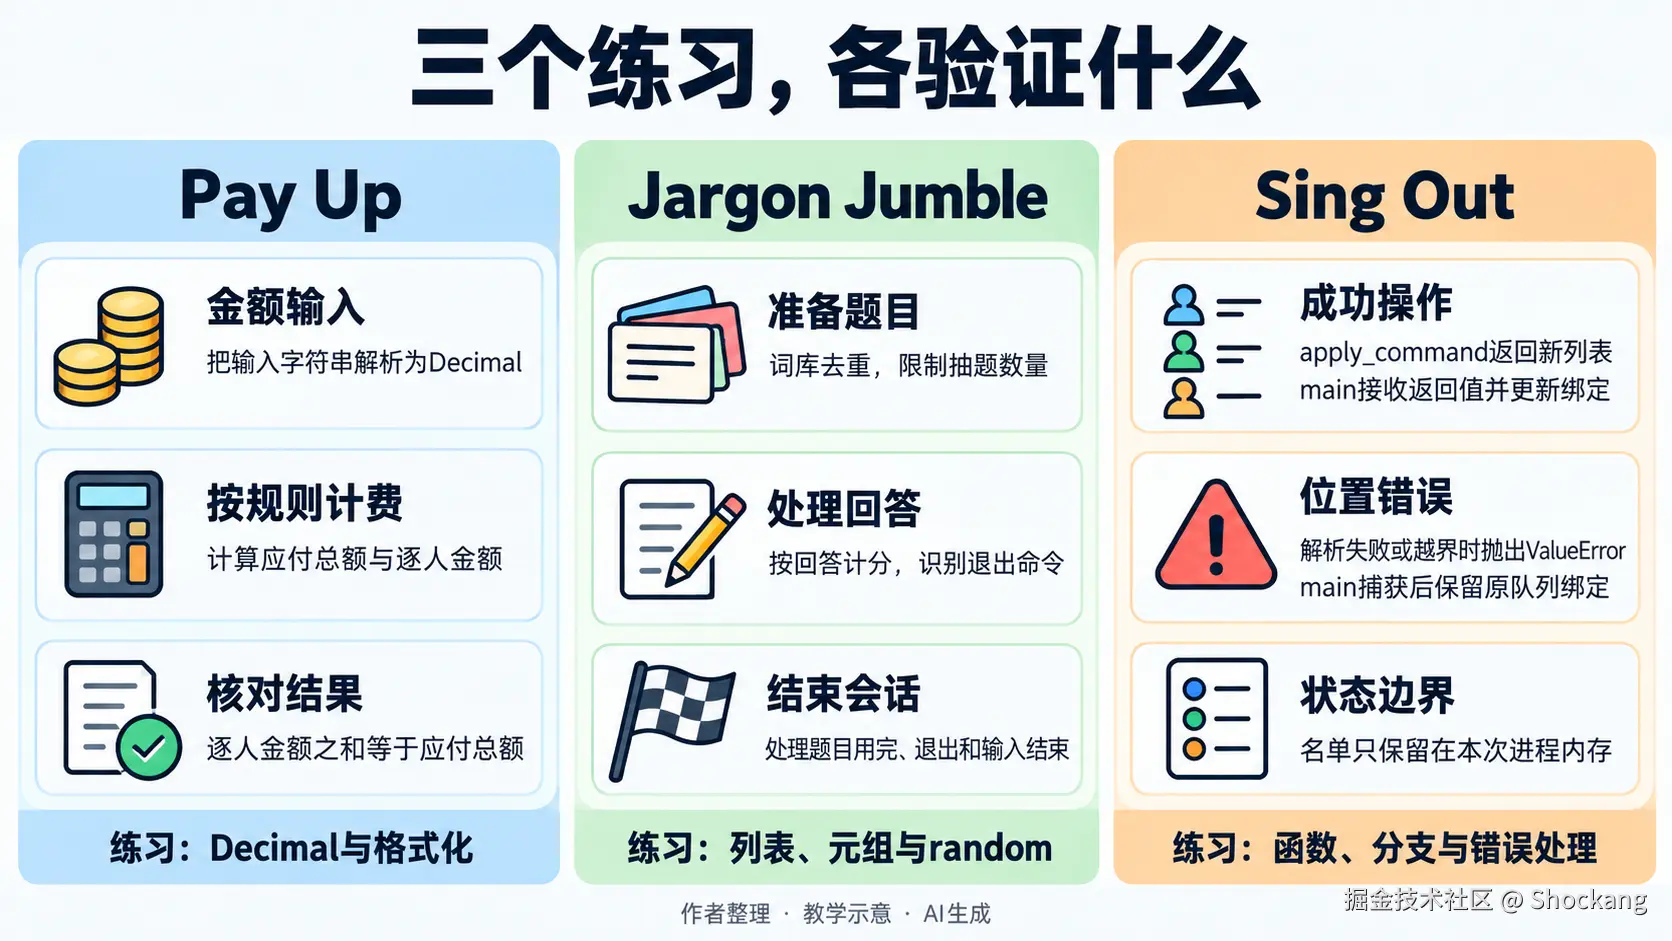
分账练习的状态在一次计算中结束,猜词练习在一局中保存题集与得分,队列练习则由连续命令更新名单。下表把数据结构、控制流和状态寿命放在一起,便于决定测试需要比较哪个时刻的值。
| 项目 | 核心数据结构 | 控制流 | 主要检查 | 状态寿命 |
|---|---|---|---|---|
| Pay Up | Decimal 与逐人份额元组 |
解析、计费、舍入与分配 | 逐人份额合计等于总额 | 一次计算 |
| Jargon Jumble | 列表、元组与 random |
有限题集与有效猜测次数 | 题数、题内尝试与整局得分 | 一局游戏 |
| Sing Out | 列表表达队列与位置移动 | 命令分支、守卫与 try/except |
显示位置换算、移动顺序与队首移除 | 一个进程中的命令会话 |
测试范围由状态寿命决定:分账可以直接比较一次调用的两个返回结果;猜词要固定题集并回放多次回答;队列则要先保存初始名单,再连续应用命令并比较中间状态。文末分别给出可重放输入。
命名规范:全大写常量与 snake_case 变量
PEP 8 建议模块级常量用大写加下划线,但 Python 没有因此禁止赋值。下面的 ROUNDS 与 TOTAL_LAPS 只演示集中配置及有限循环;常量取值属于玩法,要与循环条件一起核对。函数在同段中定义,复制保存后可以独立运行。
python
ROUNDS = 5
TOTAL_LAPS = 10

def play_one_round():
    return "一次教学动作"

results = []
for round_num in range(ROUNDS):
    results.append(play_one_round())
assert len(results) == ROUNDS
print(f"共执行{len(results)}轮,另一玩法上限配置为{TOTAL_LAPS}")
配置可放在当前模块顶部,也可在项目增大后移到专门模块;不必为三个小程序先创建一套配置框架。将配置集中后,要检查导入关系和谁能修改它,而不是仅靠大写名称保证不变。命名规范是风格约定,不是语法强制。
后续选项:用 argparse 声明命令行参数
三个完整程序都可以用 python3 文件名.py 直接运行。若以后需要默认轮数或容量参数,可以用标准库 argparse 声明选项和帮助;这属于后续扩展,本文没有实现它。把命令行解析结果传给现有函数即可复用计算和状态逻辑,不需要为参数化重写项目。
| 维度 | 直接运行脚本 | 使用 argparse 解析参数 |
|---|---|---|
| 参数传递 | 取决于程序是否读取输入或参数 | 声明参数与选项后统一解析 |
| 帮助信息 | 取决于作者实现,脚本也可以提供 | 按参数定义生成 --help |
| 默认值管理 | 可以集中配置,也可以分散定义 | 可以在解析器定义默认值 |
| 可测试性 | 可直接调用函数,或注入标准输入执行子进程 | 还可给 parse_args 传入显式参数列表 |
argparse 是标准库的命令行解析工具,支持参数、选项和子命令,见官方文档。是否选择其他库,应由项目依赖与交互需求决定;本教程不安装额外库。此处只说明下一步怎样让接口自描述,不把未写出的 CLI 选项记成已验证功能。
容器的边界:什么时候该换数据结构
容器是否需要更换,应由访问方式与实测瓶颈决定。按列聚合、按键查询与从队首弹出是不同任务,不能用某个固定记录数概括。下面保留"逐个求词长"和"按词保存长度"两个示例:后者对重复词只保留一个键,也不是自动更快的缓存。它们的输出形状不同,先核对结果再谈速度。
python
words = ["tuple", "shuffle", "tuple"]
scores = [len(w) for w in words]
lengths = {}
for w in words:
    lengths[w] = len(w)
assert scores == [5, 7, 5]
assert lengths == {"tuple": 5, "shuffle": 7}
print(scores, lengths)
优先选择能清楚表达操作的容器;需要优化时再说明输入规模、复杂度和测量方法。列表按值删除或头部弹出需要移动或查找元素,而字典按键查询与两端队列是不同接口。熟悉这些差别有助于选型,但复杂度本身不能替代当前程序的性能测试。
对照练习:把整数转换收紧为正整数合同
前面的 parse_integer 允许 int 支持的多种整数文本;下面的 parse_position 将合同收紧为两端可有空白的 ASCII 正整数。它仍返回"成功值、错误信息"元组,不读取名单,因此不能验证上界。保留这个对照,是为了看清格式限制、返回约定与业务范围三者怎样分别改变接口。
python
def parse_position(raw):
    cleaned = raw.strip()
    if not cleaned:
        return None, "不能为空"
    if not cleaned.isascii() or not cleaned.isdecimal():
        return None, "请输入ASCII正整数"
    try:
        position = int(cleaned)
    except ValueError:
        return None, "请输入可解析的整数"
    if position < 1:
        return None, "位置须从1开始"
    return position, None

assert parse_position(" 2 ") == (2, None)
assert parse_position("0")[0] is None
assert parse_position("2%")[0] is None
print(parse_position("abc"))| 接口 | 接收内容 | 成功结果 | 失败表达与上界 |
|---|---|---|---|
parse_integer |
int 接受的整数文本 |
整数与 None |
返回错误元组;不核对正数或名单长度 |
parse_position |
去掉两端空白后的 ASCII 数字 | 从 1 开始的正整数与 None |
返回错误元组;不核对名单长度 |
read_index |
最多六位 ASCII 数字及当前名单长度 | 从 0 开始的有效索引 | 抛出 ValueError;同时核对名单上下界 |
可以用 "-1"、"+2"、"0" 和 " 2 " 比较前两个函数:前者都能转换,后者只接受最后一个。再把 "2" 交给 read_index,长度为 1 的名单会报错,长度为 2 时返回索引 1。两个短例负责演示不同合同,完整程序同时落实文本规则和当时的名单范围。
交付前的共同检查
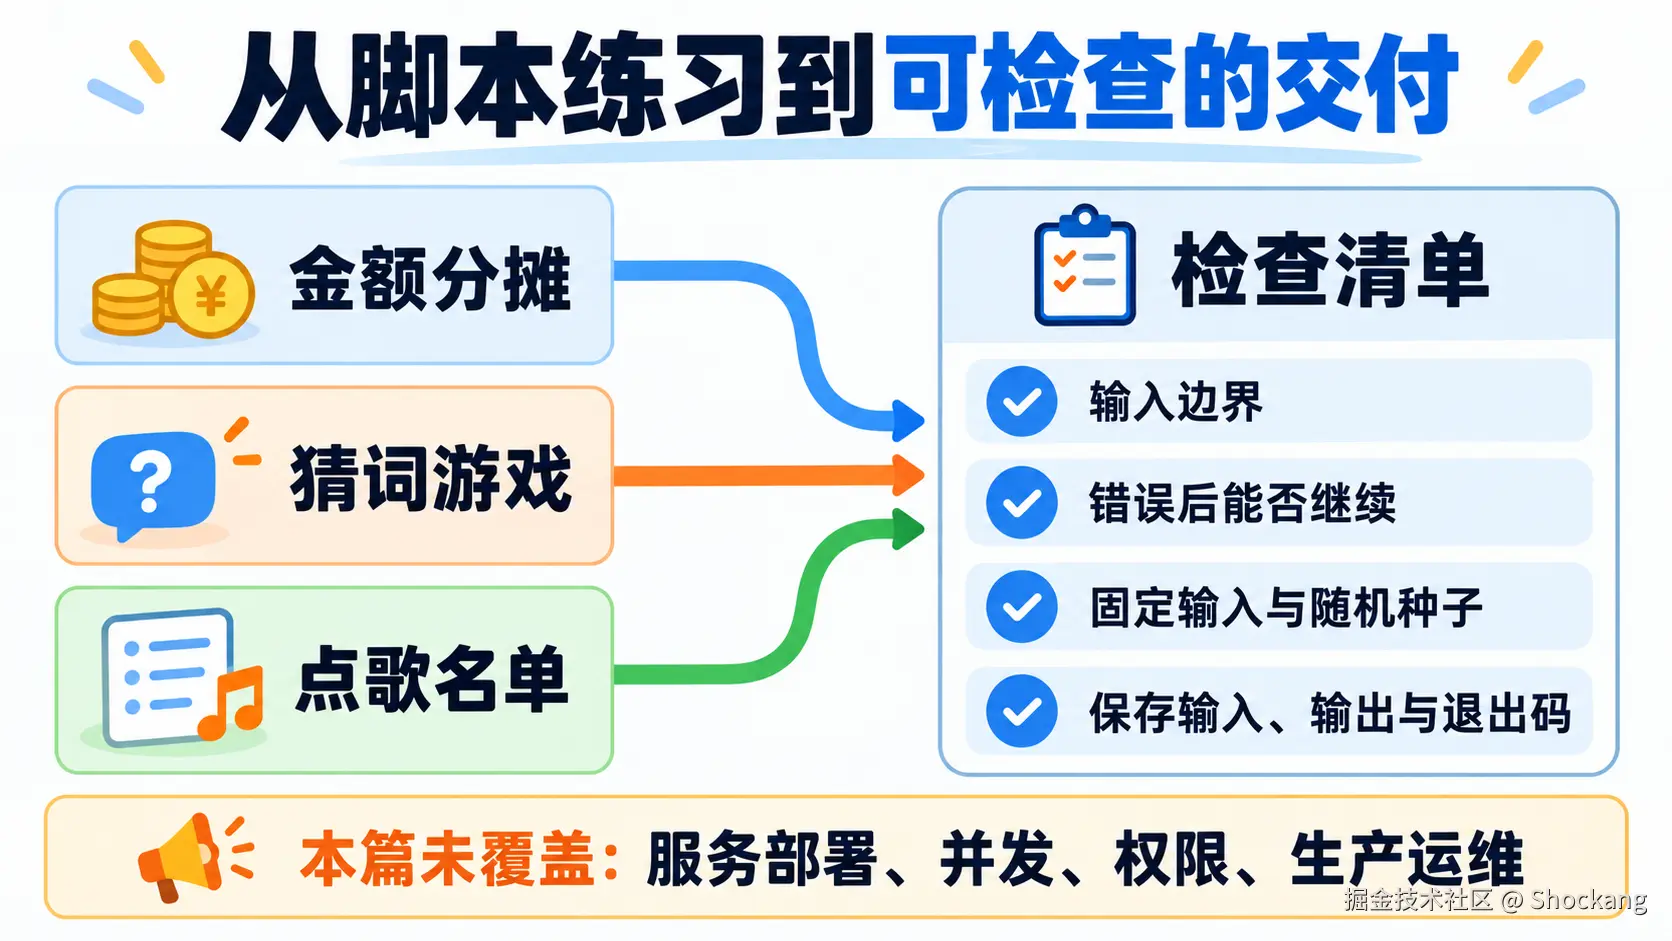
交付前把检查分成四项:输入边界、错误后能否继续、固定输入与随机种子、运行记录。记录至少包含输入、预期输出、实际输出和退出码;随机练习还应记录 Python 小版本与种子,不把一次固定环境下的重放解释成所有版本都会生成相同题集。服务部署、并发、权限和生产运维属于下一阶段,需要另定接口与验收。
怎样复核三个完整程序
这三个项目把语法放到具体结果里检查:输入数值不合法就无法分账,词库或回合状态不清楚就可能重复出题,位置不合法就可能改错队列。保留失败输入与提示,比把错误当成偶然的运行中断更容易复核。
三个脚本都只操作内存和终端。分账程序的有效输入例是 120 / 15% / 3 / 10%,应付总额 151.80 元,每人 50.60 元;0.01 / 0 / 3 / 0 则分成 0.01、0.00、0.00 元。猜词测试检查固定种子下题数、词库去重、猜测次数和主动退出,不以固定显示顺序定义玩法。队列测试覆盖从空队列添加、移动首尾、next、未知命令与空行;错误位置后接一条有效命令,核对提示和后续操作结果。仅打印派发动作的示例不代表已经播放音频。
核验执行了本机标准库脚本、注入终端输入与函数断言,未操作真实付款、播放器或远程服务。改变舍入、词库或位置合同后,应重新运行相应失败场景,不能沿用旧结果。
参考来源
官方与一手资料
- Python 官方文档 docs.python.org/3
- Python 教程 docs.python.org/3/tutorial
- Python 数据结构教程 docs.python.org/3/tutorial/...
- Python 输入与输出教程 docs.python.org/3/tutorial/...
- Python 错误与异常教程 docs.python.org/3/tutorial/...
- Python 模块教程 docs.python.org/3/tutorial/...
- Python 语言参考 词法分析与缩进 docs.python.org/3/reference...
random模块官方文档 docs.python.org/3/library/r...collections.deque官方文档 docs.python.org/3/library/c...argparse官方文档 docs.python.org/3/library/a...- PEP 8 风格建议 peps.python.org/pep-0008/
CPython 开源回归用例
TestBasic.test_maxlen,CPython v3.13.12,观察有界队列追加后的保留结果 github.com/python/cpyt...TestBasic.test_insert_bug_26194,同一版本,观察满员时的插入异常 github.com/python/cpyt...