你有没有想过:以前要进机房、签云账单、排队抢GPU配额才能摸到的「千亿级模型」,现在有人告诉你------两台摆在桌上的 Mac Studio,就能把整套开源权重塞进本地跑起来?
听起来像科幻广告。但如果你是产品经理,真正该紧张的不是「能不能跑」,而是:这事突然从「极客周末项目」跨进了「要不要写进选型文档」的区间。跨过去之后,拍脑袋买机器、拍脑袋上本地、拍脑袋说「我们要私有化」,都会变成真实的钱和时间黑洞。
2026年10月中旬,这条新闻几乎同一周砸到桌上:Meta 放出 Muse Spark Open 开放权重;苹果侧公开站台;国内腾讯混元则把「记忆模型 + 框架 + 应用」三层一起开源。热闹归热闹,这篇文章只做一件事------把账算清楚,把门槛写明白,把该碰和不该碰的场景分开。
一、开篇:桌面上突然能「摸到」千亿级开源权重
过去两年,本地模型的舆论曲线大致是这样的:
- 第一波:能聊天了。装个客户端,跑个 7B、14B,写周报、翻译、总结,够用。
- 第二波:能写点代码了。量化一下,32B、70B 往消费级显卡里塞,像在拼乐高。
第三波(现在):有人开始认真讨论------复杂工程、长程 Agent、多模态工作流,能不能在「自己看得见摸得着的机器」上扛一段时间?
这次 Muse Spark Open 把第三波推到了台前。不是因为它「又刷了一个榜」,而是因为它把叙事改成了:开放权重 + 桌面可部署 + 面向 coding/agentic。对折腾党,这是新玩具;对产品经理,这是新变量------选型表上多了一列「桌面/近端私有化」,而且这一列不再只能填「玩具级」。
但先泼冷水:「能摸到」不等于「该买」;「能跑」不等于「能当生产主链路」。后面每一节都在拆这句话。
二、发生了什么:Muse Spark Open、Meta×Apple,以及硬件门槛真相
2.1 模型本身:公开材料写明了什么
根据 Meta AI Research 官方博客(2026-10-15)与 Hugging Face 模型卡,Muse Spark Open 的核心公开信息可以核对为:
| 维度 | 公开表述(摘要) | 来源 |
|---|---|---|
| 定位 | 称其为迄今「最强的美国开源权重模型之一 / to date」;面向 coding 与 agentic | Meta blog |
| 规模 | 总参数约 816B,激活约 42B(MoE) | Meta blog;HF 模型页 |
| 模态与上下文 | 原生多模态;推理上下文 1M tokens | 同上 |
| 桌面叙事 | 称其是该类中首个可用 两台 Apple M5 Ultra Mac Studio + 最新 MLX 在桌面跑起来的模型 | Meta blog;The Verge |
| 权重分发 | Hugging Face、Amazon SageMaker AI、Google Cloud Model Garden、Microsoft Foundry Models 等 | Meta blog |
| API 合作方 | Baseten、Fireworks AI、Groq、Modal、Nebius、OpenRouter、Together AI 等 | Meta blog |
| 推理栈 | SGLang、vLLM、TensorRT-LLM、Transformers、Apple MLX、llama.cpp、Unsloth 等 | Meta blog;HF |
| 许可 | Muse Model License(含有限商业条款;对大规模「Model as a Service」有额外约定) | HF 模型页全文 |
HF 模型卡还写明:自建 GPU 侧,NVFP4 量级约需至少 700GB VRAM,BF16 约需2TB------这已经不是「一张消费卡」的世界。桌面 Mac 路径是另一条优化路线,不是「随便一台笔记本」。
模型卡强调的能力方向包括:多步推理、端到端 agentic 任务、编码 Agent、工具调用、多模态推理、合成数据、LLM-as-a-judge 等。Meta 也称其做过面向开源权重发布的额外安全后训练,并建议作为更大系统的一部分部署、搭配场景护栏------细节以模型卡与后续评估报告为准。
可核实链接:
Meta 官方博客:research.meta.ai/blog/muse-s...
HF 权重与模型卡:huggingface.co/meta-models...
The Verge 报道:www.theverge.com/news/101229...
2.2 Meta 与 Apple:公开互贺,不是「随便蹭热点」
The Verge(2026-10-15)写明:Meta 与 Apple 在此次发布上公开互相站台。Mark Zuckerberg 在 X 上提到 Muse Spark Open 权重发布,并感谢与 John Ternus / Apple 的合作,使其在新 Mac Studio 上跑得好;John Ternus 回复祝贺,强调能在桌上高效跑到该量级。Axios 侧,Meta 首席 AI 官 Alexandr Wang 提到双方合作已持续数月,并用轻松口吻形容「父母又开始好好相处」。
这对产品经理的含义很直白:桌面跑通不是社区偶然魔改,而是「模型方 + 芯片/框架方」对齐过的发布叙事。但叙事对齐,仍然不等于你的采购预算对齐------门槛写在文档里。
2.3 Mac 部署门槛:公开文档写明了什么(勿夸大)
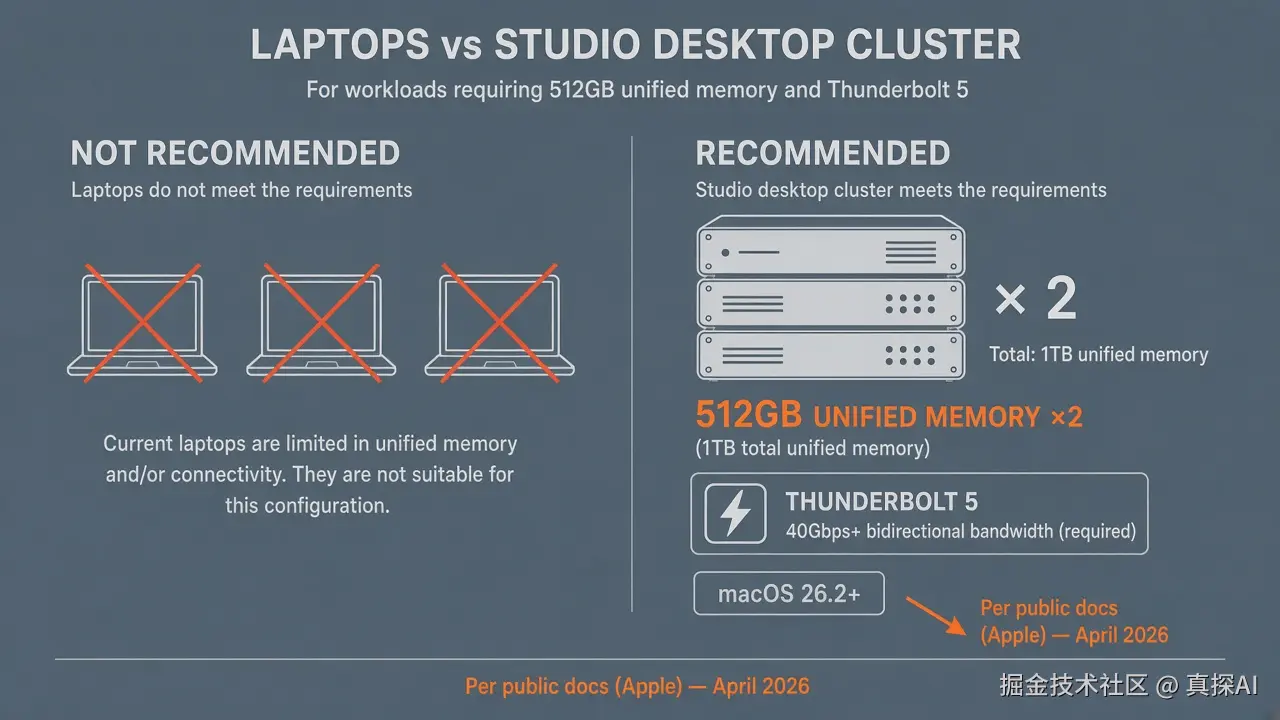
Meta 开发者文档《Muse Spark Open on Mac》写明的前置条件(原文级要点,勿解读成「买两台普通 MacBook 就行」):
机器
:两台各512GB 统一内存的M5 Ultra Mac Studio;或四台各 256GB的同系列配置。
系统
:macOS 26.2 或更高(文档写明该版本提供 RDMA-over-Thunderbolt 驱动,供 jaccl 使用)。
互联
:机器两两之间需直连 Thunderbolt 5;文档建议每对用两根线以加倍带宽;四机时每台连其他三台。
软件
:MLX 0.30.1+,用 mlx-lm / mlx.launch,后端 jaccl,示例加载NVFP4 checkpoint(如 meta-models/Muse-Spark-Open-816B-A42B-NVFP4)。
磁盘
:每台都要有完整 NVFP4 checkpoint 的空间。
运维细节
:主节点到其他机器免密 SSH;可起 OpenAI 兼容 API(示例端口 8080)。文档估「跑通」量级约~4 小时(指按教程走完,不是指训练)。
性能备注
:文档写四机服务更快;两机是可行配置,不是「随便两台消费本」。
来源(以公开文档为准):dev.meta.ai/docs/cookbo...
再泼一盆水:哪怕你买得起两台顶配 Mac Studio,你买的是「近端推理节点」,不是「无限弹性集群」。吞吐、排队、故障切换、夜间散热与噪音、固件/系统升级、权重版本回滚------这些都会进入运维清单。桌面能跑,是能力边界上移;不是运维成本归零。
2.4 同一周的国内对照:腾讯混元 Hy-Memory 2.0------不是每条「本地」故事都要 816B
就在相近时间窗口(官网标注开源发布2026.10.16),腾讯混元把Hy-Memory 2.0以「模型 + 框架 + 应用」三层开源的方式推到前台:
官网:memory.hunyuan.tencent.com/
框架仓库:github.com/Tencent-Hun...
记忆写入模型(HF):huggingface.co/tencent/Hy-...
应用侧:MemHub(官网与仓库说明其为面向 AI 工具用户的本地优先记忆中枢;具体安装产物以仓库/发布页为准)
公开材料描述的分层大致是:
模型层
:Hy-Memory-30B-A3B------约 30B 总参、约 3B 激活,专为记忆读写/更新训练,可接入多套记忆系统做 writer。
框架层
:Hy-Memory SDK------管理存储、更新、召回;覆盖聊天记忆、工作记忆、代码记忆等场景。
应用层
:MemHub------把记忆带进正在用的 AI 工具(历史导入、持续同步、插件化召回等叙事)。
HF 模型卡与官网给出的评测叙事是:在固定评测设定下,该 writer 在多套记忆 harness 上的宏平均可与部分强闭源/开源通用模型对照(官网与模型卡均给出总体均分等数字;引用时请以页面原文与论文为准,勿外推到「全面超过所有通用大模型」)。论文链接见官网列出的arxiv.org/pdf/2610.22...。
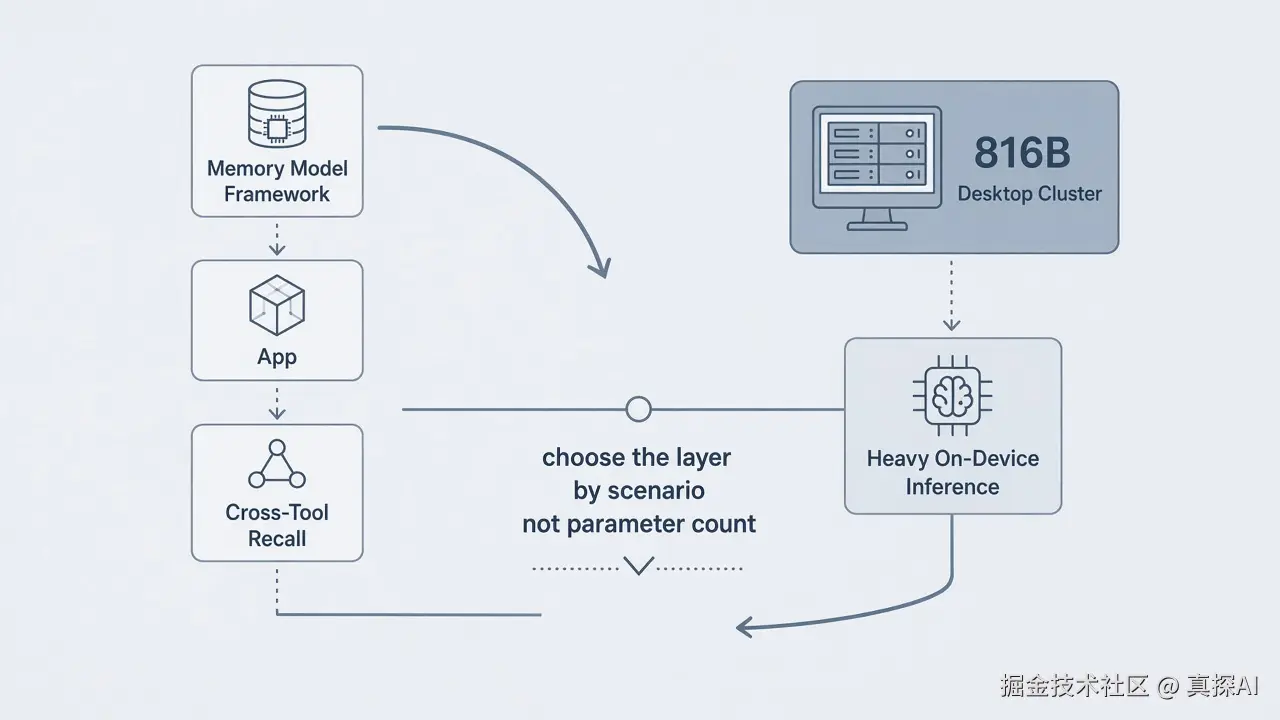
对国内产品团队,这条线的意义往往比「两台 Mac 跑 816B」更贴地气:
很多「本地/私有化」痛点,其实不是「缺一个千亿脑」,而是缺一套可审计、可迁移、可跨工具的记忆与上下文治理。
30B-A3B 量级的专用模型 + SDK,硬件门槛与工程集成成本,通常远低于桌面双机 816B。
「本地」可以是:数据与记忆落本地、推理仍走内网/云端 API;也可以是:关键链路全离线。二者成本差一个数量级很正常。
一句话对照:Meta 这条新闻抬高了「桌面能扛多大开源权重」的天花板;混元这条新闻提醒你------产品落地经常赢在「记得住、调得回、管得住」,而不只是「参数堆得高」。
三、真正变化:从「能聊天」到「能私有化扛复杂任务」?别急着下结论
3.1 能力叙事变了,验收标准也必须变
以前本地模型验收很简单:能不能流畅对话、中文是否体面、会不会瞎编日程。现在若有人提议「上桌面级开源大模型扛 Agent」,验收至少要拆成五层:
任务完成率
:给定真实仓库/真实工单,端到端做完的比例。
长程一致性
:跨小时、跨多工具调用,是否还记得约束与目标。
工具失败恢复
:API 超时、权限不足、编译失败时,会不会死循环。
多模态输入质量
:截图、录屏、文档扫描在真实分辨率下的稳定性(HF 模型卡也提示过极短/极低分辨率视频等边界情况)。
安全与审计
:开源权重在本地,不等于「无责任」;许可证、使用政策、二次分发与对外 API 服务条款都要法务过一眼(Muse Model License 对 Maas 场景有额外门槛描述,见 HF 页面)。
Benchmark 可以当参考,不能当验收。公开榜单是「实验室条件下的相对位置」;你的产品是「脏数据、破权限、半吊子文档」条件下的绝对结果。
3.2 「私有化」常被说成一种道德优势,其实是一种成本结构
本地/近端的真实收益,通常集中在这几类------说出来并不浪漫:
数据主权与合规
:源码、病历、合同、未公告财报、客户通话原文,出域成本高于算力成本。
稳定离线或弱网
:产线、车载实验室、涉密园区、差旅断网。
延迟与可控
:内网毫秒级往返、可预期的队列,而不是公共 API 的限流与区域波动。
定制与蒸馏闭环
:用自有数据继续训/蒸,权重在自己磁盘上。
除此之外的「我们想本地一下试试」------多数时候是兴趣项目。兴趣项目可以做,但不要写进年度关键路径,除非你已经用云端把需求跑明白了。
3.3 别把「两台 Mac 能跑」翻译成「团队标配」
公开文档写的是顶配 Mac Studio 集群式桌面部署,不是 MacBook Air 狂欢。对大多数国内互联网/ToB 团队,更现实的近端形态往往是:
机房/办公室里的GPU 推理节点(vLLM/SGLang 等)+ 内网网关;或
云上专有实例
(权重自管、流量不出 VPC);或
混合
:敏感检索与记忆本地,重推理走合规云;或
小模型本地 + 大模型云端路由
(简单请求本地,复杂请求上云)。
Muse Spark Open 的价值,对很多人是「证明桌面统一内存路线能吃下这个量级」;对采购来说,仍要和 NVIDIA/AMD 集群、云厂商专有部署放在同一张表里比 TCO。
3.4 许可证不是小事
HF 页展示的 Muse Model License 要点包括(请以原文为准):允许广泛使用与修改,但要求显著展示 "Built with Muse Spark Open";并对年收入超过约 2000 万美元且以 API/类似接口对外提供模型服务(Model as a Service)的主体,要求另行通知 Meta 并签署书面协议;内部使用、非 Maas 的产品内嵌等场景有除外描述。还有使用政策与禁止用途清单。
产品经理动作建议:把许可证 PDF/页面丢给法务,问三句------我们是产品内嵌还是对外卖推理?收入是否可能触发条款?二次分发与「Built with」展示如何落地?
四、产品经理怎么算账:云端 vs 本地 vs 混合
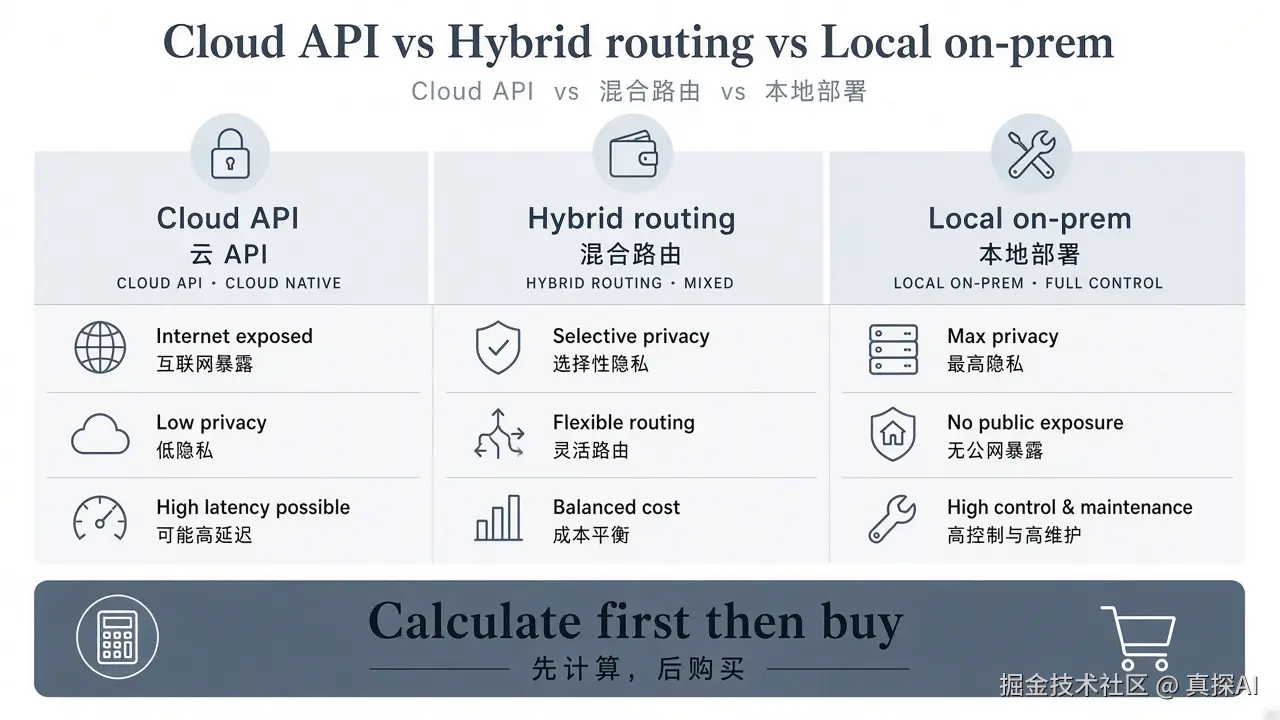
下面三张表,建议直接复制进你的选型评审材料。数字用「量级与结构」思考;具体报价以你们采购与云账单为准,本文不捏造未核实的人民币单价。
4.1 表一:隐私与合规
| 问题 | 云端公有 API | 云上专有/VPC | 桌面/机房本地 |
|---|---|---|---|
| 提示词与日志默认出域? | 通常是(看合同与零保留选项) | 可控,仍依赖云厂商运维边界 | 默认不出办公网 |
| 是否满足「训练数据不用于改进模型」? | 看企业条款 | 通常可合同化 | 权重与日志都在你侧 |
| 审计追踪谁来做? | 厂商 + 你的网关 | 你的网关 + 云审计 | 你全包 |
| 适合的硬场景 | 低敏感、可脱敏 | 中高敏感、要弹性 | 高敏感、强离线、强可控 |
判断口诀:只有当「出域的合规成本/业务风险」显著高于「自建推理的工程成本」时,本地才从感情变成理性。
4.2 表二:成本结构(怎么算,而不是报假价)
把成本拆成五块,避免只盯「显卡多贵」:
资本开支(CapEx)
:机器、交换机/雷电线缆、机柜UPS、备用盘。双顶配 Mac Studio 是一笔清晰的 CapEx;GPU 服务器是另一笔。
人力(OpEx)
:谁会装 MLX/vLLM、谁值夜班、谁负责权重与系统升级。桌面双机看起来「简单」,分布式 RDMA + SSH + 主机文件仍需要会的人。
利用率
:本地机器晚上闲着也在折旧;云按量在低谷可缩。
Token/任务成本
:用「每个成功闭环任务的钱」比「每百万 token 标价」更诚实------Agent 会刷工具调用。
失败成本
:一次误改生产配置、一次源码泄露、一次合规罚则,可能高过三年云账单。
粗算流程(可执行):
列出未来 90 天真实任务:每天 N 个 coding agent 会话、平均工具轮次、平均输入输出长度。
分别用:公有 API 报价、云上 GPU 租用、本地折旧(按 24--36 个月)三条线估算。
加上「必须本地」的合规溢价(没有溢价就别硬上本地)。
看单位成功任务成本与P95 延迟,不要只看平均值。
4.3 表三:运维与产品化
| 维度 | 云端 API | 混合 | 本地桌面/近端 |
|---|---|---|---|
| 扩容 | 申请配额 | 路由策略 | 买机器/加节点 |
| 版本升级 | 厂商发版 | 双轨灰度 | 你自己验证 checkpoint |
| 可观测性 | 有限 | 网关统一 | 自建全套 |
| 单点故障 | 区域故障 | 可降级 | 桌面断电=停服 |
| 对产品形态影响 | 适合 SaaS 主路径 | 适合「敏感旁路」 | 适合专用工作站/小团队堡垒 |
4.4 混合架构:大多数团队的老实答案
一个可落地的默认架构:
默认路径
:云端强模型(或开源模型的托管 API,例如 Meta 列出的多方 Inference)。
敏感路径
:内网检索 + 本地/专有部署小中杯模型;必要时再升到近端大杯。
记忆路径
:优先评估开源记忆栈(如 Hy-Memory)是否先解决「跨工具忘事」------这往往比先上 816B 更能提升 Agent 体验。
路由策略
:按数据分级与任务难度分流;做开关,不做宗教信仰。
五、国内团队落地:什么场景值得碰桌面/私有化,什么场景别碰
5.1 值得认真评估的场景(举例,需你们自己举证)
源码与研发数据不出域的编码 Agent
:企业代码库、未发布设计稿、内部包名与密钥扫描规则严格。
金融/医疗/政务内网助手
:合同与监管明确限制出域,且已有内网机房与等保基础。
媒资/工业现场的多模态质检与剪辑辅助
:大文件上云贵且慢;Meta 博客提到过设备端 agentic 工作流与专业软件联动的演示方向------这是「可能性」,落地仍要按你们编解码与权限模型验证。
高定制蒸馏母舰
:需要强开源权重做教师模型,在隔离环境生成合成数据或蒸馏学生模型。
个人/小团队「工作站级」超级助手
:预算允许、人会运维、任务确实重------两台 Studio 的故事才开始接近现实。
5.2 大概率别碰(或先别买顶配)的场景
普通内容运营改写、客服话术、营销文案
:云端更便宜,迭代更快。
还没跑通 Prompt/工具协议就谈私有化
:先把 Agent 流程在云端跑稳。
以为「本地=免审查=可违法」
:法律红线不因权重在本地而消失;许可证使用政策同样在。
把「两台 Mac」写进全员标配
:财务会问你为什么不租专有云实例。
只为了演示 PPT 里的「我们拥有千亿本地模型」
:演示可以用短期租用或 API;别为了面子锁死三年折旧。
5.3 国内特有的务实路径
先记忆、后超大杯
:用 Hy-Memory 这类开源记忆方案,把「跨会话、跨工具、代码为何这样改」的上下文治理做起来;推理模型按需选通义、DeepSeek、Kimi、混元或其他云/开源杯。
先专有云、后桌面
:国内上架、发票、维保、值班体系往往更熟 GPU 机房与云厂商;Mac 桌面集群适合设计工作室、小型堡垒、研究小组。
先量化验收集
:准备 30--50 个内部真实任务(带敏感数据脱敏版),同一套题打:公有 API / 专有部署 / 本地候选。谁赢谁上,拒绝「我感觉」。
许可证与开源治理入门
:HF/GitHub 下载不等于商业无忧;镜像源、漏洞扫描、SBOM、权重哈希校验要有人签字。
5.4 硬件现实:显存/统一内存仍是第一性原理
社区里长期有效的常识并没有被一条新闻废除:装得下,才谈智商;带宽,才谈速度;预留系统内存,才谈别卡成PPT。统一内存的 Mac 路线,优势是大容量共享;短板是单机上限、生态与集群工具链仍与数据中心 GPU 不同。选边时问自己:
我们是「少数工位要极致本地」还是「百人并发要弹性」?
我们的人更会 MLX 还是更会 Kubernetes + vLLM?
失败时降级到哪条云路径?有没有一键切换?
六、30 天选型与试点清单(可直接排期)
第 1--3 天:定问题,不定设备
写清 3 个必须本地/近端的业务理由(合规条款编号、客户合同原文、离线场景描述)。写不出来,就停。
列出 20 个真实任务样本(输入、工具、成功标准、敏感级别)。
定成功指标:任务成功率、人工接管率、P95 时延、单位任务成本、事故次数。
第 4--10 天:云端基线与记忆层
用现有云端强模型把 Agent 主流程跑通(工具协议、权限、日志)。
并行 POC:Hy-Memory SDK / MemHub 是否降低「忘上下文」类失败(官网与 GitHub 为入口)。
建立数据分级:可上云 / 需脱敏 / 禁止出域。
第 11--20 天:开源大杯对照(能租则租,慎买)
通过托管 API(Meta 公布的 Inference 伙伴)或云上 GPU 拉起 Muse Spark Open 同类任务对照。
若评估桌面路径:按Mac 文档做场地与预算预研(机器型号、内存档、雷电线、系统版本),先出采购评估,不先下单全员设备。
法务审 Muse Model License 与使用政策;同步审 Hy-Memory / MemHub 许可证。
第 21--30 天:决策与灰度
输出一页纸决策:主路径 / 敏感旁路 / 不做什么。
若上近端:先1 个小队、1 类任务、1 个降级开关;跑满两周再谈扩容。
写运维手册:权重校验、重启、磁盘、Thunderbolt/网卡、值班、回滚。
复盘:单位成功任务成本是否优于云端基线;若否,本地降级为「研究/演示」,不要硬撑。
选型矩阵(填空模板)
| 候选 | 隐私匹配 | 任务成功率 | P95 延迟 | 30 天成本 | 运维人数 | 许可证风险 | 总评 |
|---|---|---|---|---|---|---|---|
| 公有 API | |||||||
| 云上专有开源部署 | |||||||
| 桌面 MLX 双机/四机 | |||||||
| 小中杯本地 + 云端大杯 | |||||||
| 记忆栈增强(Hy-Memory 等)+ 现有模型 |
打分建议:隐私与任务成功率权重大;没有运维owner 的选项直接淘汰。
七、结语:天花板抬高了,账单不会替你做决定
8160 亿参数的开源权重能被「两台顶配 Mac Studio + MLX」在公开文档意义上搬上桌面,这确实改变了想象边界:本地不再天然等于「小模型玩具」。Meta 与 Apple 的公开互贺、多方 API 与云平台上的权重分发,也说明这不是一次孤立的极客秀。
但产品经理的工作,从来不是为新闻喝彩,而是回答更土的问题:
我们的数据是否真的不能出域?
我们的任务是否真的吃得下这个量级的工程与金钱?
我们是否其实缺的是记忆与工具治理,而不是另一头巨兽?
同一周的混元 Hy-Memory 开源,像是一句提醒:本地化是一条光谱------从「记忆落本地」到「千亿权重落桌面」,每一格都有价格。先算账,再动手;先试点,再采购;先验收集,再信仰。
桌面摸得到千亿开源权重的时代开始了。你的选型表,也该换一页更冷静的了。