"
静默换代之后,便宜模型开始接更多活,关键不只是价格,而是可靠性。
------ 子昕
昨天 DeepSeek 又换了一版模型。
但有意思的是,你可能已经用上了,自己却不知道。
如果你代码里、插件里填的还是 deepseek-flash,一行配置都不用改------从 10 月 17 日开始,背后跑的已经是新的 DeepSeek-V4.1-Flash-1017。
甚至之前的旧名字 deepseek-v4-flash,现在也会被转到这一版。
「这个我一直拿来跑"便宜碎活"的模型,现在能不能接更多活了?」
我拿自己平时真的在跑的流程试了一圈,也顺便把这次更新里几个容易忽略的地方研究了一下。
📌 本文看点
01
模型到底变了什么
02
哪些任务适合交给 Flash
03
今晚可以做的检查
01
CHECK
先确认:你是不是已经在用了
其实很简单,看模型名就行。
● deepseek-flash
已经是 1017。
● deepseek-v4-flash
目前同样会转到 1017。
● DeepSeek 网页和 App
也已经同步切过去了。
不用在模型列表里找一个单独叫「1017」的新选项。
这次属于一次静默换代。
你手里的按钮没变,API 名字没变,价格也没变,但按钮背后的模型已经不是 9 月那一版了。
如果你平时只用 DeepSeek 网页或者 App,知道这一点其实就够了。
后面 Claude Code、API 配置那些内容,不感兴趣可以直接跳。
02
UPDATE
这次到底变了什么
先说结论:
它不是新一代大模型,而是给 Flash 这档做了一次比较明显的能力升级。
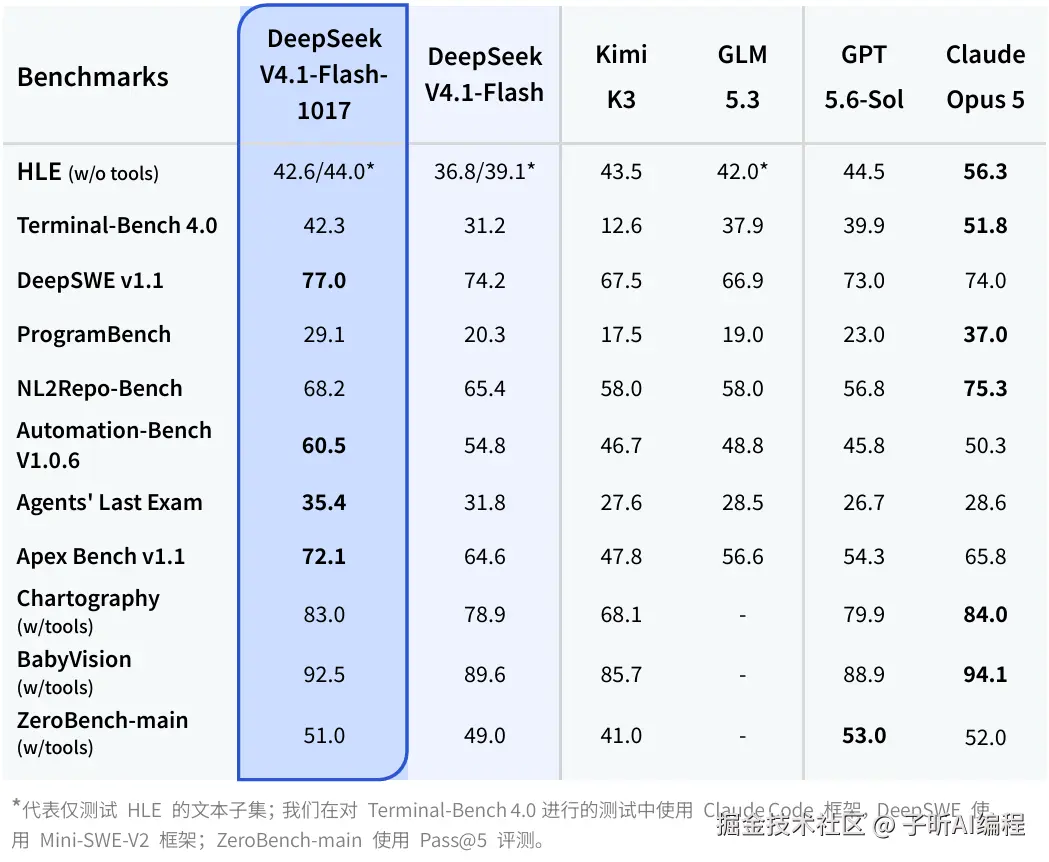
这张图不用每一行都研究。
我自己比较关注的是 Terminal-Bench、Automation-Bench、DeepSWE 这类项目。
这几项,简单理解就是:
看一个模型能不能自己操作工具、连续判断、连续做几步事情,最后把任务真正做完。
比如其中:
Terminal-Bench 4.0:从 31.2 → 42.3。
Automation-Bench:从 54.8 → 60.5。
DeepSWE:从 74.2 → 77.0。
尤其第一项,变化还是挺明显的。
这版除了能力提升,任务运行时间和输出长度也缩短了。
这点对我反而很重要。
因为便宜模型拿来批量跑任务的时候,决定成本的不只是单价:
一次任务要跑多久、输出多少字、中间返工几次,最后都会变成钱。
至于网上如果有人拿一张图就说它"全面吊打最贵模型",我觉得没必要这么看。
同一张表里本来就有赢有输,而且拿来对比的也不一定是别人最新的顶配。
对我来说,更有用的问题始终是:
什么活可以继续往便宜模型身上扔,什么活我还是愿意多花钱。
03
WORKFLOW
我为什么一直没把 DeepSeek 换掉
写代码,我之前主要是 GPT,上篇文章说过,我现在又订阅了 Grok,这两货现在是我写代码的主要模型。
尤其是复杂逻辑、大改代码、需要反复推理的任务,我暂时不会使用 DeepSeek。
但 DeepSeek 我一直留着。
原因很简单:便宜,而且快。
有一类活特别适合它:
单次其实不难,但特别碎,一天可能要跑很多很多次。
比如我最近一直在做出海外链自动化。
整个流程拆下来,大概就四步:
1.认页面: 这是博客文章、产品页、目录页,还是其他页面?
2.找位置: 有没有评论区?哪里能正常填写链接?
3.填写提交: 插件自动生成内容、填写、提交。
4.回看结果: 评论到底发出去没有?有没有被拦、被吞、进入审核?
包括网站介绍、产品描述这些内容,我也会顺手让它根据网页生成。
这里面真正浪费钱的,其实不是"一次 AI 调用"。
第一步一旦判断错了,后面全是白跑。
比如一个目录页被认成普通文章,后面模型还在认真找评论框、生成评论、准备提交。
每一步看起来都没花多少钱。
但全部都是无效调用。
所以这次 1017 我最关心的是:
这种"先看一下 → 做判断 → 再决定下一步"的任务,能不能少走一点弯路。
我昨天已经把自己的流程重新跑了一轮。
第一轮看下来,像页面识别、找位置这种环节,确实比之前少了一些无效返工。
不过新模型毕竟才上线一天,我还没办法给出确定性的结论,这种东西再跑几天,看看效果,比看一张跑分图靠谱得多。
04
JUDGMENT
我现在判断一个活要不要丢给 Flash,只看三件事
这也是我觉得这次更新之后,普通用户真正可以带走的东西。
我现在基本看三个条件:量大不大、单次难不难、做错以后能不能校验。
如果一个任务:
一天要做几十、几百甚至几千次;
每次都不算特别复杂;
最后还有办法判断它到底做对没有。
我会优先考虑 Flash 这种便宜模型。
反过来:一次任务就很复杂,或者做错一次代价很高,我还是会直接上 GPT、Grok 这类更强的模型。
所以这个思路其实不只是写代码能用。
比如:
产品拿它批量整理用户反馈、分类需求;
设计拿它看大量素材、打标签、做初步筛选;
测试拿它归类日志、分析失败原因;
运营、跨境拿它识别页面、整理商品信息、批量生成描述;
做内容的,也可以拿它先做信息分类、素材清洗。
它们本质上都是同一种任务:
量很大,单次不难,需要先判断再做下一步,而且最后最好还能验一下结果。
这种活,没必要每一步都请"最贵的脑子"。
05
COST
钱这件事,只记几个真正有用的
1.批量任务,真的可以挑时间跑
DeepSeek Flash 现在依然分高峰和低谷。
工作日北京时间:
9:00--12:00;
14:00--18:00。
属于高峰时段。
高峰价格就是低谷的 2 倍。
其他时间是低谷价,周末和中国法定节假日全天也是低谷。
像我这种一次扫很多页面、批量生成描述的任务,如果并不急,完全没必要非挤在工作日下午跑。
尤其一天调用量上来以后,错个峰就是实打实的钱。
2.别只盯着软件窗口里的美元数字
如果你是用 Claude Code 这类第三方工具接 DeepSeek,可能会碰到一个挺吓人的情况:窗口里显示"这次任务花了好几美元"。
但那个数字不一定就是 DeepSeek 最后真正扣掉的钱。
有些客户端展示的是自己按照模型价格算出来的估值,尤其模型映射、价格配置没跟上的时候,数字会更离谱。
所以我自己验账有个很简单的办法:
跑任务前看一次 DeepSeek 后台余额,跑完再看一次。
别猜。也别因为终端里跳出来一个很大的 $ 数字就先心疼半天。
你真正付了多少,以后台的实际用量和余额变化为准。
3.11 月 1 日前,还有个联网搜索的小窗口
这次 DeepSeek 还把自己的 Search / Fetch 搜索能力开放出来了。
如果你通过 DeepSeek Harness、Claude Code、Codex 这类工具调用 DeepSeek,现在还有一个临时窗口:
北京时间 11 月 1 日 0 点之前,服务端 Search / Fetch 本身暂时不收按次调用费。
注意,这里说的是搜索调用本身。
模型拿到搜索结果之后,还要阅读、整理、回答,这部分产生的 Token 还是正常收费的。
11 月 1 日之后,Search / Fetch 也会开始按次收费。
所以最近刚好有大量需要联网查资料的任务,可以趁这个窗口跑一跑。
06
BACKUP
还有一个容易被忽略的问题:便宜模型也得留后路
15 号的时候,DeepSeek 网页和 API 刚出现过一次持续数小时的部分中断。
如果你只是偶尔聊天,其实无所谓。等恢复就行。
但如果跟我一样,把模型接进了一条自动化流水线里,事情就完全不一样了:
第一步模型挂了,后面第二、第三、第四步全停。
便宜模型可以当主力,但重要流程一定要有重试;再重要一点的,就留一个备用模型。
这也是很多人做 AI 自动化以后才会发现的问题。
模型准确率 95% 看起来很高。
但如果你的流程一天跑 1000 次,那剩下的 5% 怎么处理,才是真正决定这套东西能不能用起来的地方。
用 Claude Code 的人,再多看这一段
不用 Claude Code 的可以直接跳过。
如果你是把 DeepSeek 接进 Claude Code,有一个地方最好检查一下:
Claude Code 里面不只存在一个"主模型"。
Opus、Sonnet、Haiku,包括 Subagent,都可能分别指定模型。
而 DeepSeek 对 Claude 的模型名会做映射:
claude-sonnet* → deepseek-flash
claude-haiku* → deepseek-flash
claude-opus* → deepseek-v4-pro
也就是说,如果某一个地方还偷偷走了 Opus,最后可能就跑到价格更高的 Pro 上去了。
DeepSeek 官方现在给 Claude Code 的推荐配置里,几个位置都直接指向了 Flash:
...bash
ANTHROPIC_MODEL=deepseek-flash1m
ANTHROPIC_DEFAULT_OPUS_MODEL=deepseek-flash1m
ANTHROPIC_DEFAULT_SONNET_MODEL=deepseek-flash1m
ANTHROPIC_DEFAULT_HAIKU_MODEL=deepseek-flash
CLAUDE_CODE_SUBAGENT_MODEL=deepseek-flash
所以如果你明明是冲着 Flash 的价格去的,最好检查一下,别只改了最上面那一个模型名。
另外,这次官方明确建议升级的是 DeepSeek Harness 0.2.1-rc.1 及以上版本。
如果你用的是 DeepSeek Harness,记得升。
Claude Code 本身不用因为 1017 专门去找一个所谓"支持新版 DeepSeek"的版本,模型已经在服务端切掉了。
今晚就能做完的一轮检查
不用研究半天。
真正在用 DeepSeek 的话,我建议直接拿自己的一件真实任务跑一遍:
☐ 看模型是不是 deepseek-flash,或者旧的 deepseek-v4-flash。
☐ Claude Code 用户检查 Opus/Sonnet/Haiku/Subagent 有没有漏到别的模型。
☐ 找一件你平时真的会做的任务,不要专门出一道测试题。
☐ 记录一次任务花了多久,有没有一次成功。
☐ 跑之前、跑之后分别看一眼后台余额,算一下真实成本。
☐ 批量任务尽量避开工作日 9--12 点、14--18 点。
☐ 自动化流程至少加重试,重要任务最好还有备用模型。
如果条件允许,再拿旧日志对一下:
以前 100 次任务要人工救回来多少次,现在是多少次。
这个数字,比"某某榜提升了几个点"对你有用得多。
这次更新以后,我确实愿意把更多这种:
"先看一下、判断一下,然后连续做几步"
的碎活交给 Flash。
对我来说,1017 最大的价值并不是让 DeepSeek 去取代最强模型。
以前有些活,我觉得它不够稳,不敢完全自动跑;现在值得重新拿出来试一次。
便宜模型真正省的钱,也不只是 Token 单价。
而是当它足够靠谱以后,又有一批原本需要人盯着的活,可以开始自己跑了。
你平时主要拿 DeepSeek 干什么?写代码、做运营、写内容,还是已经接进自己的自动化流程了?
如果你也拿它跑大量重复任务,我更想知道一个数据:
你有没有认真对过,工具里显示的"花费"和 DeepSeek 后台真正扣的钱,到底差多少?
END
我是子昕,专注AI工具,Al编程、Al提效等技术分享。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。