上一篇聊 MCP 和 Skill 时,我把 Tool 比作 Agent 伸出去的"手"。这篇接着往下挖------这双手最容易出问题的地方。
如果你在生产环境跑过 Agent,大概率见过这样的日志:工具选得明明白白是 set_priority,但参数 priority 传回来的不是 "high",而是 "urgent"、"P1"、"top",甚至一句 "the highest one";本该是整数的字段传了个字符串;下游接口直接报 500。
你怀疑模型不行,换了更强的模型,发现还是翻车。这背后有个反直觉的结论:生产环境里 Agent 失败,多数不是模型能力问题,而是"工具调用"这座桥没搭好------而且大部分时候,工具选对了,错在参数。
这篇就把这件事从根上讲清楚:模型到底是怎么"生成"参数的,为什么会错,从 JSON Mode 到 Structured Outputs 这一路在解决什么、又没解决什么,以及工程上怎么把工具调用做到接近 99% 可靠。
先搞清楚:模型根本没有"调用"函数
第一件要纠正的事:Function Calling 这个名字有点误导。模型在那一刻并没有执行任何函数 ,它只是在生成一段文本------一段长得像 JSON、用来表达"我想调哪个函数、参数是什么"的文本。
我们平时让模型自由对话,它生成的是自然语言;开启 Function Calling 后,它被微调过,知道在需要工具时切换到一种结构化的输出格式,吐出一个 tool_call:工具名 + 一段 JSON 字符串。真正解析这段 JSON、执行函数、把结果塞回去的,是你的应用。
问题就出在这:没有约束时,模型在每一步都可以从整个词表里自由挑 token。 它可以在任意位置输出一个花括号,可以少写一个引号,可以在你以为是枚举的地方自由发挥。这种"自由"正是出错的根源------它不是在填一个被严格校验的表单,而是在"猜"一段像 JSON 的文本。
翻车现场:模型最常犯的五类错
把生产日志翻多了,工具调用参数出错的模式其实就那么几类,而且每一类都能在 schema 设计上提前堵死:
- 该用枚举的地方,给了自由文本。 最常见的一种。
priority你不限制,它这次给"high",下次给"P1"、"urgent"、"critical",每一个下游都解析不了。 - 漏字段、类型错位。 标了 required 的字段没给,整数传成字符串,深层嵌套的 schema 写到一半把字段丢了------嵌套越深,中途丢字段越常见。
- 参数名对不上。 schema 里叫
order_id,模型按它"猜"的命名习惯写成了orderId。 - 幻觉标识符。 结构完全合法,
order_id也是个字符串,但这个 ID 压根不存在,是模型编的。 - 非法 JSON。 截断、转义错误、多了个逗号,导致解析阶段就直接崩------这种在高负载、复杂 schema 下更频繁。
有团队对生产日志做过粗略统计:工具调用失败里约 30% 是"选错了工具",剩下约 65% 是"工具选对了、参数 JSON 出了问题"。 而后者恰恰是最能通过工程手段解决的------它不依赖你换一个更强的模型。
那为什么这些错现在听起来这么"低级"?因为业界花了两年,才把"让模型输出合法结构"这件事,从靠运气做成了有保证。这中间有一条清晰的演进线。
四代演进:从"靠提示词求它"到"数学上不可能错"
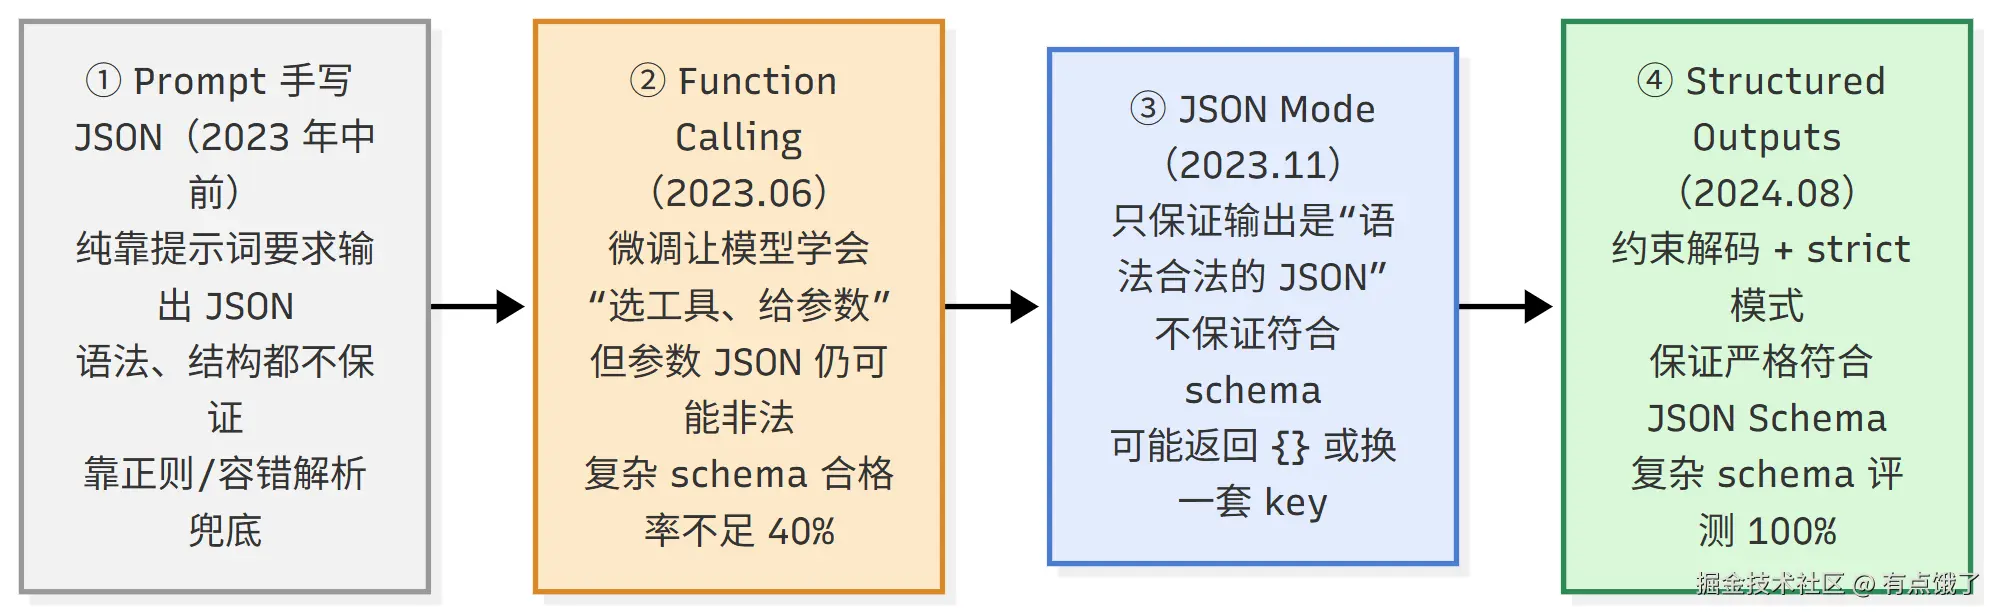 ① Prompt 手写 JSON(2023 年中以前) 最初的做法很朴素:在 prompt 里写"请以 JSON 格式输出,包含 xxx 字段"。这等于没有任何保证,模型心情好就给你对的,心情不好就多句话、少个括号。工程上只能靠正则、写容错解析器、反复重试去赌。
② Function Calling(2023 年 6 月) OpenAI 通过专门的微调,让模型学会了"什么时候该调工具、怎么把意图翻译成参数"。这是能力上的大跨越,但要注意:它提升的是"会调"的概率,并没有从机制上保证参数 JSON 一定合法。 用 OpenAI 自己的评测数据,在复杂 JSON schema 上,早期的 gpt-4-0613 合格率不到 40%。
③ JSON Mode(2023 年 11 月) 开发者被非法 JSON 折磨了半年,OpenAI 推出 JSON Mode,response_format: {"type": "json_object"}。它保证的是输出一定是语法上合法的 JSON ------你 JSON.parse 不会报错。但它不保证符合你的 schema :模型可以返回一个 {},或者换一套完全不同的 key,照样满足"是合法 JSON"。"能 parse"和"是我要的结构"之间,还隔着一道沟。
④ Structured Outputs(2024 年 8 月) 这才是质变:开启 strict: true 后,模型输出保证严格符合你给的 JSON Schema 。OpenAI 同一份复杂 schema 评测里,gpt-4o-2024-08-06 配合它拿到了 100%,而老模型不到 40%。从"大概率对"到"必然对",靠的不是模型变聪明了,而是下面这套机制。
约束解码:在 token 生成的每一步"设卡"
Structured Outputs 保证结构合法的核心技术叫约束解码(Constrained Decoding),开源圈也叫 guided decoding。理解它,你就理解了"保证"两个字到底是怎么来的。
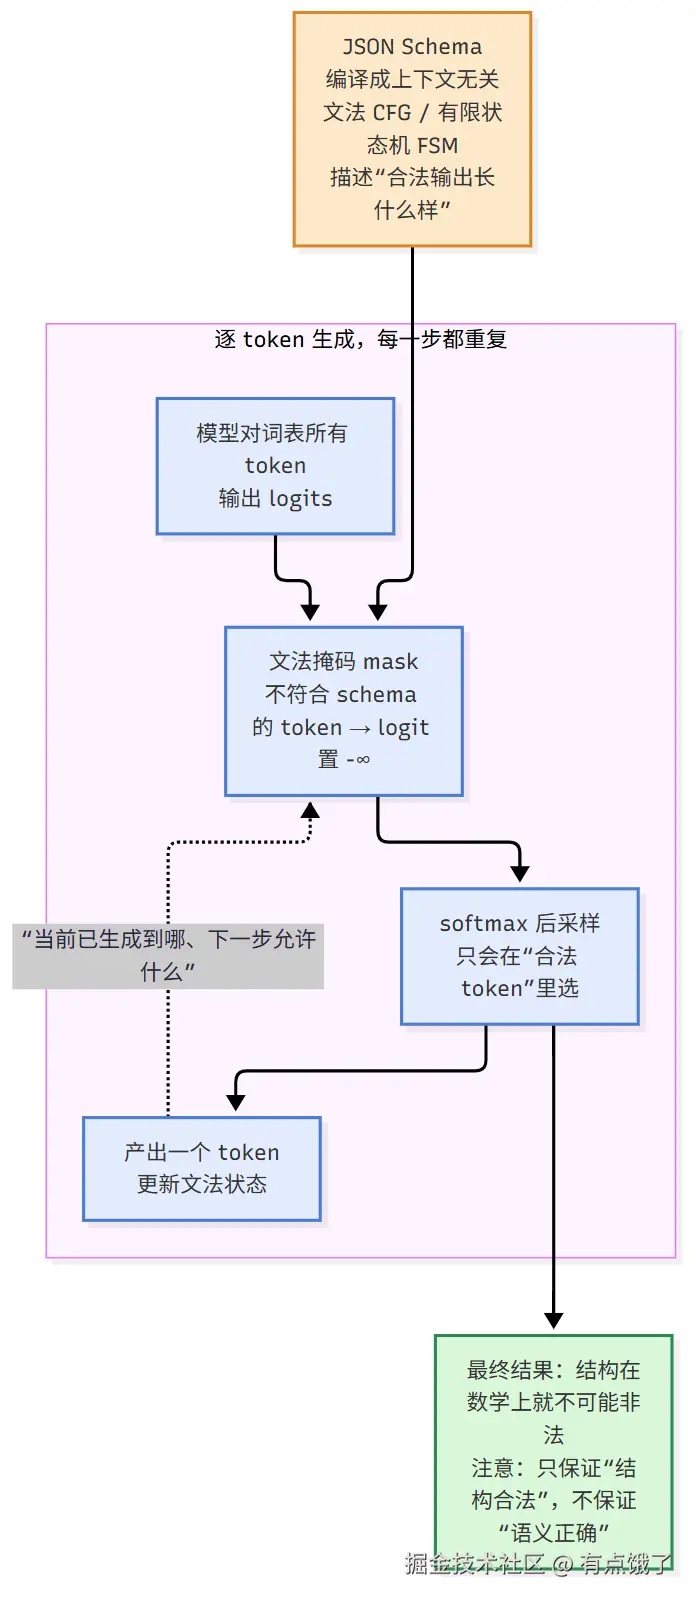 模型生成文本是逐 token 进行的,每一步它都会对词表里所有 token 算一个 logit(可以理解成"出场倾向分"),然后 softmax、采样。正常情况下谁都可能被选中。
约束解码在采样前插了一道"掩码" :把你的 JSON Schema 先编译成一个文法(OpenAI 用的是上下文无关文法 CFG,开源方案常用有限状态机 FSM),然后每生成一个 token,就根据"已经生成了什么"和"文法允许下一步是什么",把所有会让输出非法的 token 的 logit 直接置为负无穷。这样一来,非法 token 根本进不了采样池,模型只能在合法 token 里挑。
关键在于它是动态 的。比如合法的下一步在开头可以是 {、{",但当模型已经输出了 {"val 之后,{ 就不再合法了,掩码会实时更新。最终效果是:输出在数学上就不可能非法------不是"99.9% 合法",而是构造上没有非法路径。你不需要再为"解析失败"写重试,也不需要兜底解析器。
这里有个工程细节值得一提:CFG 比 FSM 表达力更强,FSM 一般表达不了递归类型(比如深层嵌套 JSON 里的括号匹配),所以带 $ref 自引用的递归 schema 用 CFG 才能处理。开源生态里这套能力已经很成熟:vLLM 提供 guided_json/guided_regex/guided_grammar,llama.cpp 用 GBNF 文法,还有 Outlines、Guidance、XGrammar 等库。自部署开源模型时,你自己就能拿到同样的保证。
但是!它保证的是"结构合法",不是"语义正确"
这是最容易被人误解、也最容易因此裸奔翻车的地方,必须单独说:
Structured Outputs 能保证的,仅仅是"格式/结构"这一层。它管不了"值对不对"。
- 它能保证
priority一定是low/medium/high之一,但保证不了这单到底该选 high 还是 low; - 它能保证
order_id是个字符串、格式像 UUID,但保证不了这个 ID 真实存在、不是模型编的; - 它甚至能保证数学题的字段齐全,但 OpenAI 官方文档明说:模型依然可能在 JSON 的"值"里犯错(比如算错一步)。
换句话说,约束解码消灭的是"解析不通过、类型对不上、枚举越界"这类语法/结构错误 ;但"选错了枚举值、幻觉了一个 ID、业务上不合理"这类语义错误,它一个都管不了。
这也解释了为什么 strict 模式不是免死金牌,更不能替代服务端校验。真正的生产可靠性,是"结构层用约束解码堵死"加上"语义层用校验和兜底兜住",两道防线缺一不可。
工程上怎么做到 99%:一条可落地的闭环
我把生产里真正管用的做法串成一条闭环。先说一个让你重视它的理由:工具调用的可靠性是会复利的。 单步 95% 成功率,一个 5 步任务的完成率是 0.95⁵ ≈ 77%;单步提到 99%,5 步任务就能到 95%。这就是"感觉还行"和"真敢上生产"的分水岭。
 第一步:把 schema 当成给"认真但没经验的新人"设计的 API。
- 凡闭集合,必写 enum,而且要当真。 状态、地区、环境、语言、币种、时间单位,凡是取值有限的,全用
enum锁死。同理,整数用minimum/maximum,字符串用pattern正则,数组用minItems/maxItems。 required只放真正必填、模型能从上下文推断的字段。 它无法从对话里知道的字段,设成可空["string","null"],别逼它硬编。- 嵌套尽量压到 3 层以内。 越深越容易丢字段,能扁平化就扁平化。
- 描述写"何时用、何时别用、有什么副作用",而不是重复参数列表。 别写"priority 是 low/medium/high"(那是 enum 该干的事),要写"仅当用户明确要求加急时才用 high,新建工单不要调这个接口"。
第二步:把工具面当成 API 来收敛。 如果你有 find_user、lookup_customer、search_account 三个本质查同一批数据的工具,模型基本是在随机选。该删的删、该合并的合并,名字取得具体一点(find_user_by_email_or_id),让人光看名字就能预判它会选哪个。工具不是越多越好,上一篇聊过的"工具爆炸"在这里同样适用。
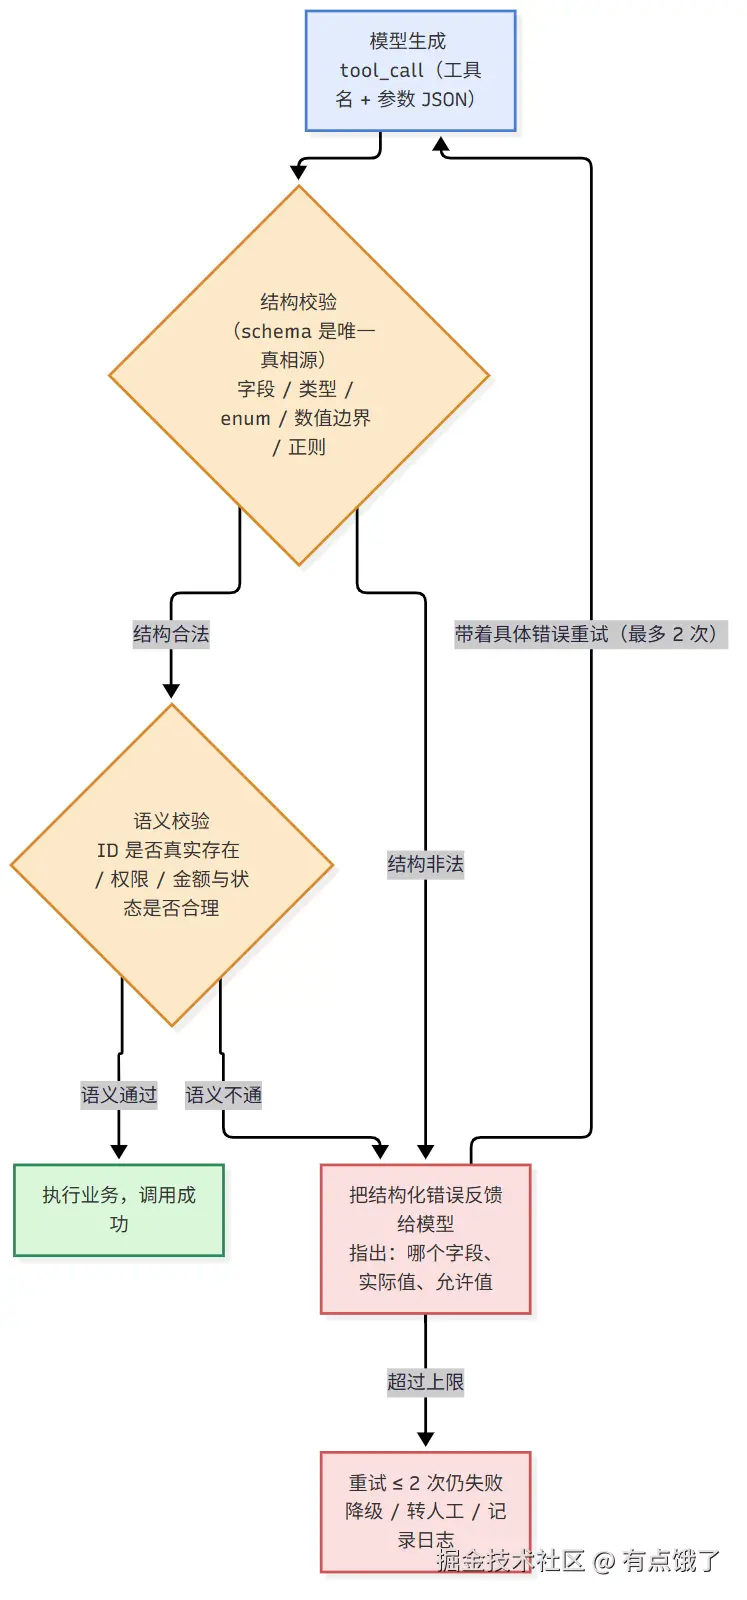
第三步:服务端校验,schema 是唯一真相源。 模型产出的 JSON,在执行任何真实业务(尤其涉及钱、发消息、改数据)之前,必须先过一遍校验。Python 用 Pydantic、Node 用 Zod/ajv,Java 用 JSON Schema 校验器配合 Jackson 和 Bean Validation 都可以。更重要的是让 schema 成为唯一的事实来源,别让 OpenAPI 文档一套、工具定义又是一套;后端契约变了,schema 先改,模型立刻产出新结构------这能避免那种上线几个月后、后端悄悄改成 UUID 却没人更新工具定义的"静默 schema 漂移"。
第四步:失败要反馈具体错误,重试设上限。 校验失败时,别让模型无头无脑地重试,那只会烧 token 还得到同样的错。要把结构化的错误信息 喂回去:字段 priority 的值 "urgent" 不在允许枚举 [low, medium, high] 内,模型带着这条信息基本一次就能改对。同时重试上限设在 2 次------两次还修不好,说明问题不是偶然的,再重试也是徒劳,这时应该降级或转人工,并记日志。
第五步:语义校验和 gold set 别省。 结构合法之后,还要查 ID 是否存在、用户有没有权限、金额和状态是否合理(这部分是结构化输出替代不了的)。另外攒十几条典型用户请求 → 期望的工具调用,放进 CI 当回归用例,每次改 schema 先跑一遍,把可靠性变成测试能守住的属性,而不是靠线上祈祷。
什么时候用什么?严格模式也有代价
最后说点务实的,别看到 strict 就无脑全开,它是有约束的:
- Structured Outputs 只支持 JSON Schema 的一个子集,严格模式下所有字段都得进
required、必须additionalProperties: false,schema 表达力受限; - 它和并行函数调用不兼容,开了要把
parallel_tool_calls设成 false; - 一个新 schema 的第一次请求会有编译文法的延迟(典型几秒,复杂的可能到一分钟),之后才缓存复用;
- 如果你某个字段本就想让模型自由发挥(比如写一段开放文案),硬套强约束反而别扭。
所以选型上可以这样把握:
- 内部调用、工具少、schema 简单:Function Calling + 服务端校验就够了,不必上重型约束;
- 对外、关键路径、复杂嵌套结构 :能开
strict就开,把结构错误消灭在生成阶段; - 自部署开源模型:vLLM 的 guided decoding、llama.cpp 的 GBNF 都能给你同样的保证;
- 无论哪种,服务端的结构校验 + 语义校验 + 有限重试都不能省,因为约束解码从来不替你判断值对不对。
写在最后
回头看这条路,行业其实是在一层层地把"不确定性"往后退:Prompt 求 JSON 靠运气,Function Calling 让模型学会调工具,JSON Mode 保住语法,Structured Outputs 用约束解码把"结构出错"从概率问题变成不可能事件------但再强的格式约束,也只守住了边界,值的正确性、业务的合理性,仍然要靠你自己的校验、权限和兜底。
一句话记住:Function Calling 让模型"会伸手",Structured Outputs 让它"递过来的东西形状一定对",而你要做的,是在它松手前确认"这东西是不是真的该交给你"。
你们在工具调用上踩过最离谱的参数错误是什么?枚举、类型还是幻觉 ID?评论区聊聊。