LangChain 智能体治理实战:预算、权限与故障恢复
设想一条客服 Agent 任务链:先查订单,再写工单,最后发通知。通知超时后重新执行整条链,可能写出重复工单;恢复会话时若混用了用户身份,还可能读到错误的历史。模型回答是否通顺,只覆盖了这个问题的一小部分。团队还要知道任务花了多少、谁能调用工具、从哪里恢复,以及谁确认修复可以上线。
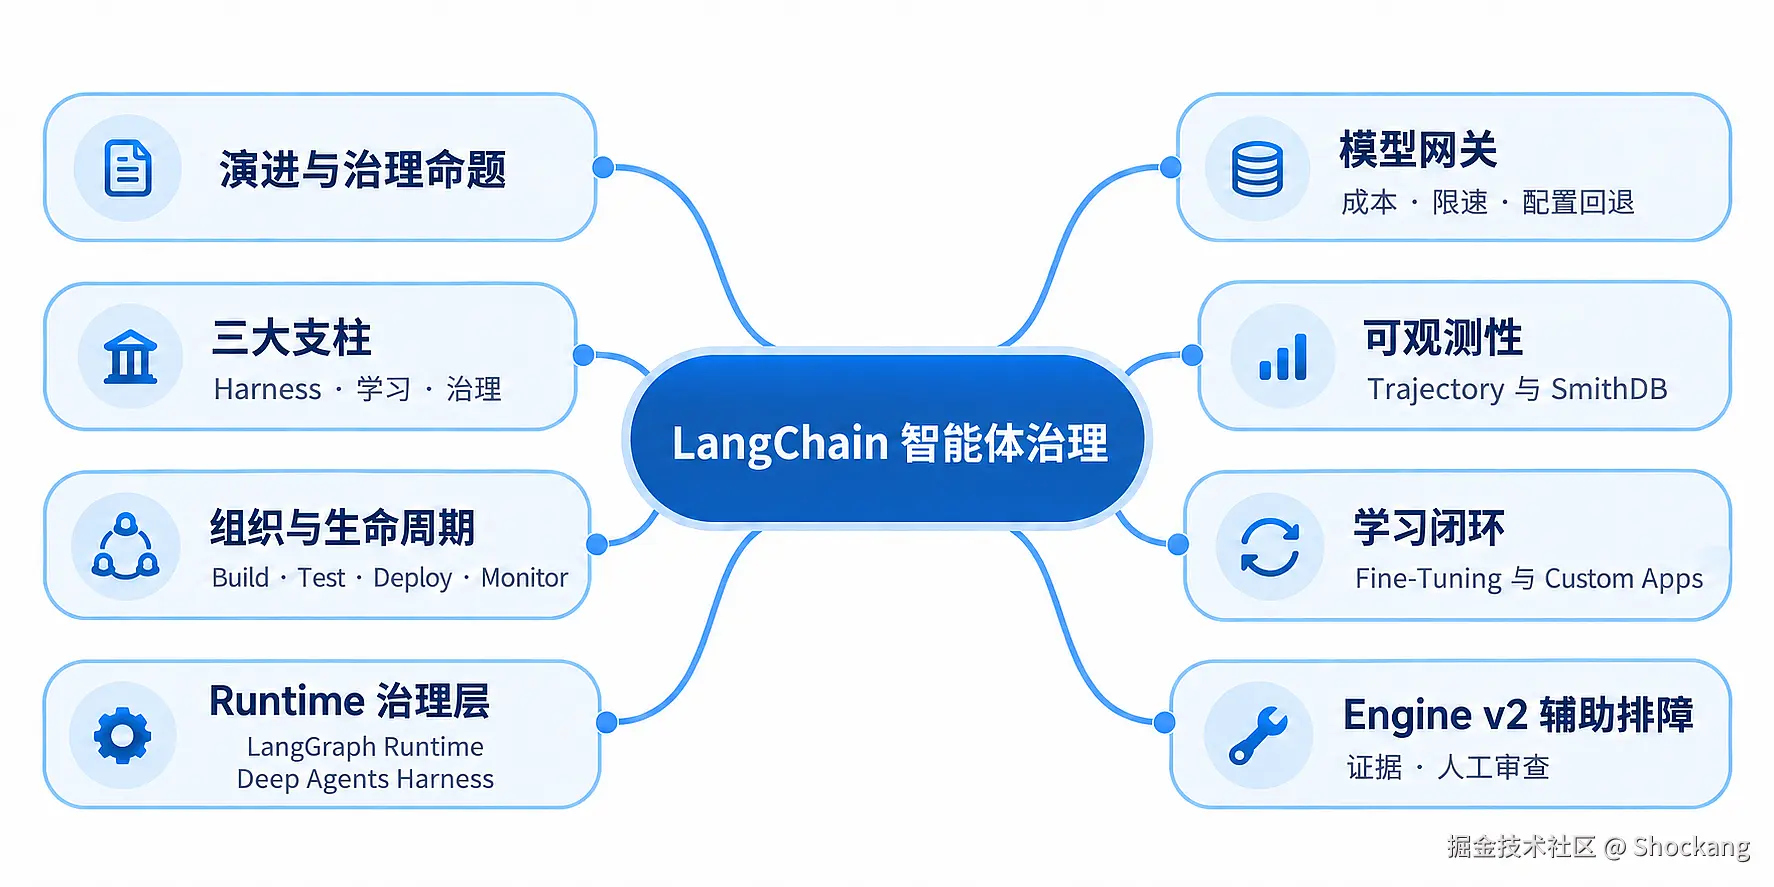
本文沿这些故障点拆解执行、数据与发布责任,区分 LangGraph、Deep Agents 和 LangSmith 各层的作用。网关章节提供一份已在本地执行的离线预算实验:先验证精确额度与业务键分组,再把同样的正反用例带入自己的接入测试;后面的会话视图、反馈与 Engine 章节则说明如何留下可供人工复核的证据。
Key Takeaways
- 从单次 LLM 调用走向多步骤 Agent,治理对象随执行链扩展
- 用中立 harness 组织执行,用反馈修订用例,用治理约束成本与权限
- 平台工程师、Agent 工程师、领域专家是本文建议的职责划分
- LangGraph 是运行时;Deep Agents 是建立在其上的 harness
- LLM Gateway 以 LangSmith 身份和配置的模型标识接入兼容客户端
- Trajectory 是从底层 traces/thread 整理的可读时序视图
先从执行过程看治理对象的变化。
演进与治理命题:为何 Agent 时代必须谈治理
应用形态跃迁:从单次调用到多步骤 Agent
从一次 HTTP 请求、一个 prompt、一段返回,到需要多步骤工具调用、状态与会话记忆的 Agent,工程治理对象发生了变化。单次调用和多步骤执行仍会长期并存。官方产品概念文档区分框架、运行时和 harness:组合这些能力可以构建 Agent,但不能因此把各产品的职责混为一谈。本文随后讨论的"思考→工具调用→观察→继续执行"是理解执行循环的概念图,不是任意产品默认启用的生产策略。
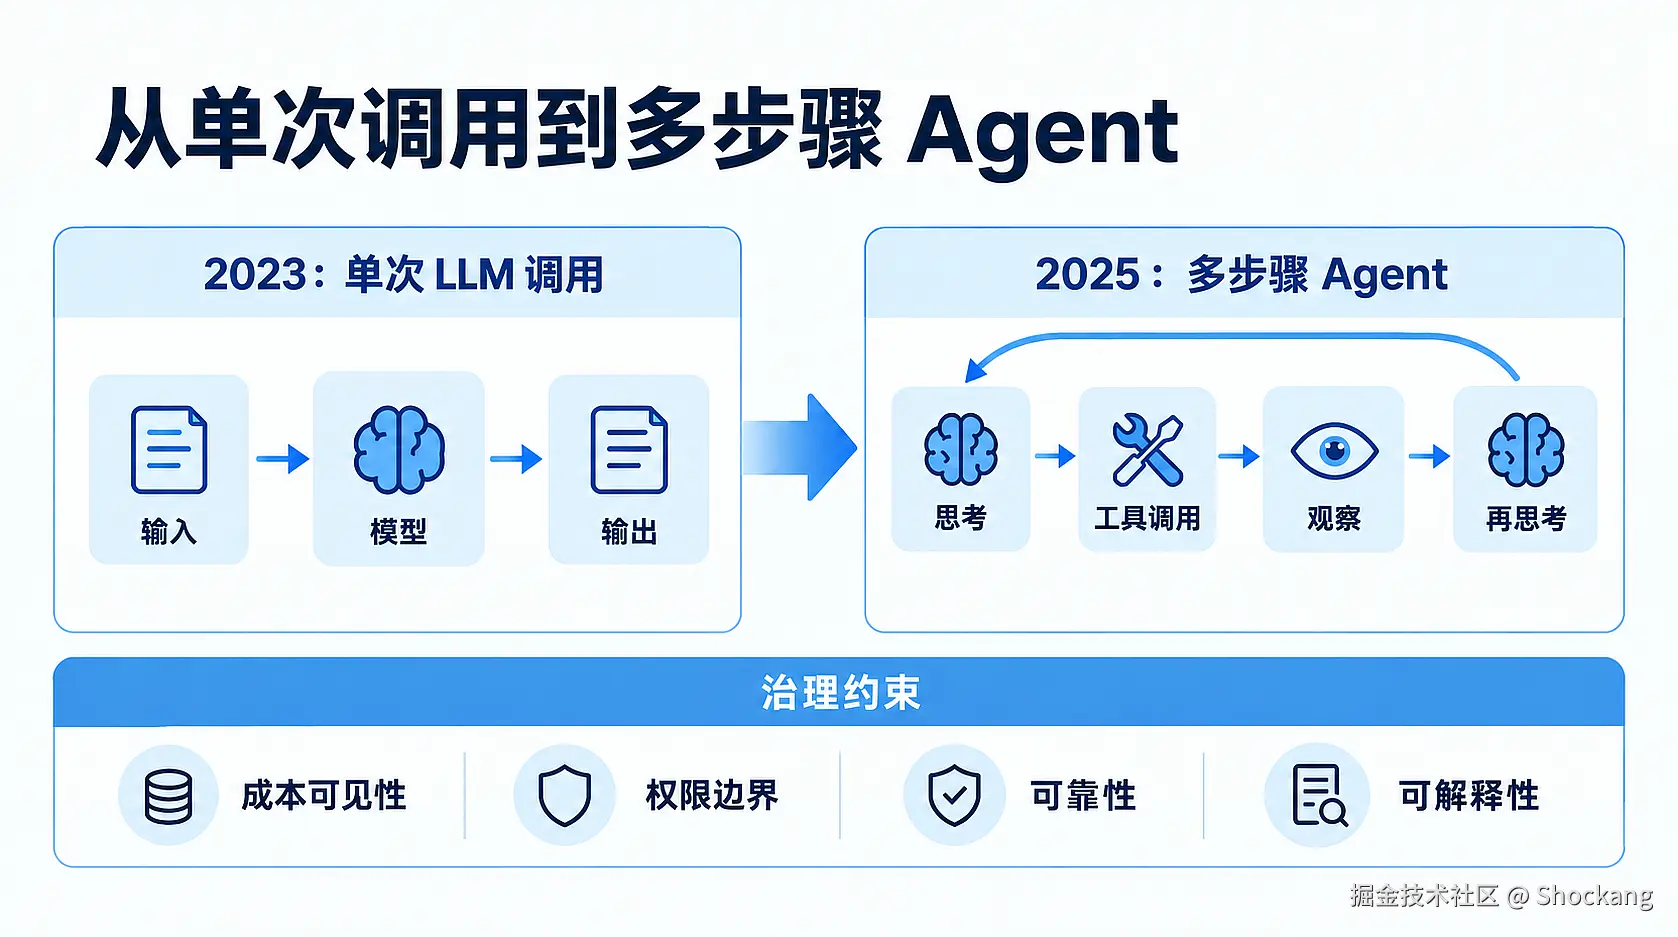
单次调用也需要鉴权、超时、成本与输出校验;多步骤 Agent 还要处理工具重试、子任务状态隔离、长上下文漂移与循环终止,并协调已经发生的外部副作用。当应用形态跨过这条线,治理就从「上线后再补的护栏」升级为「落地前就必须设计的运行时约束」。
三大力量推动 Owning Your Intelligence
为什么企业现在愿意为治理买单?因为有三股力量同时抬高了入场门槛,也让「拥有自己的智能」从口号变成工程现实。
| 力量 | 现象 | 治理含义 |
|---|---|---|
| 任务调用量增加 | 输入/输出计费叠加多步骤调用,单次任务成本难以预估 | 必须做 spend limit 与成本可见性 |
| 开放权重可部署 | 按所选模型版本与许可证部署权重 | 可自建推理;外部调用仍需单独核对数据流向 |
| 模型商品化 | 同一能力多家可选,模型本身不再稀缺 | 差异化落在 harness 与数据 |
预算演练时,应把一次任务中每轮输入历史、输出和工具结果的重复传递都算入总量。团队应记录自己的调用次数、输入/输出 token、重试和工具费用,再建立成本基线;Agent 数量增长之后,单次调用价格不能替代整条任务链的预算。
选型时同时看模型能力、数据边界与执行控制面。模型可以更换,业务上下文、工具权限、失败样本和评测资产仍需要团队维护。本文把这些可控制的部分视为工程投入的重点,而不把"模型商品化"解释成所有模型已经等价。工具协议可参考 MCP 规范,LangGraph、LangChain 与 Deep Agents 的职责则以当前官方产品分类为准。
治理的四件核心事
如果把治理拆解到工程动作,可以归纳为四件事:成本可见性、权限边界、可靠性、可解释性。
python
# 本文应用伪代码:依赖均由应用注入,非 LangChain SDK;未执行。
class GovernedAgent:
    def invoke(self, request):
        if not self.permission.check(request.tool):
            raise PermissionError("tool not allowed")
        if not self.spend_gate.allow(user=request.user):
            raise RuntimeError("budget_exceeded")
        result = self.core_agent.run(request)
        return result
成本可见性回答"任务和团队实际花了多少";权限边界回答"哪些身份能调哪些工具";可靠性回答"请求失败后如何恢复或转交人工";可解释性回答"关键判断依据能否追溯"。设计时可为它们分别准备任务账本、工具授权表、恢复记录和可定位的执行证据,再安排到构建、测试、部署与监控中。后文网关章节集中说明模型流量入口的能力和边界。
从可选项到工业化前置条件
| 阶段 | 治理角色 | 典型产物 |
|---|---|---|
| PoC 阶段 | 可选项 | 日志、临时限速 |
| 试点上线 | 补丁式 | spend cap、人工审批 |
| 规模化运行 | 前置条件 | cost visibility + spend limits(按团队/用户/API key 分档)+ rate limiting + fallbacks |
上表按验证范围安排治理工作:PoC 先验证一条业务路径,试点明确成本和权限边界,规模化之前再用真实故障和评测数据决定发布门禁。领域专家参与标注与评估,平台工程师负责接入权限和运行条件;上线决定应落到具名负责人及其确认的证据。
Agent 数量跃迁后的硬约束命题
多步骤 Agent 会把 token、工具调用和持久化状态组织成一个持续运行的系统。随着任务和租户增加,成本、越权、失败恢复与审计问题更难靠人工记忆处理。本文将其归纳为治理前置的理由,而不声称某个 Agent 数量阈值一到就必然发生事故。具体约束应来自业务风险、任务运行记录与访问控制测试;部署方式本身也不是合规结论。
把治理当作构建-测试-部署-监控每一步的内置能力,而非事后补丁,是 Agent 工业化落地的前提。这一命题在工程上如何落地,正是后续章节要展开的内容。
三大支柱中的治理定位:Harness、学习与治理如何咬合
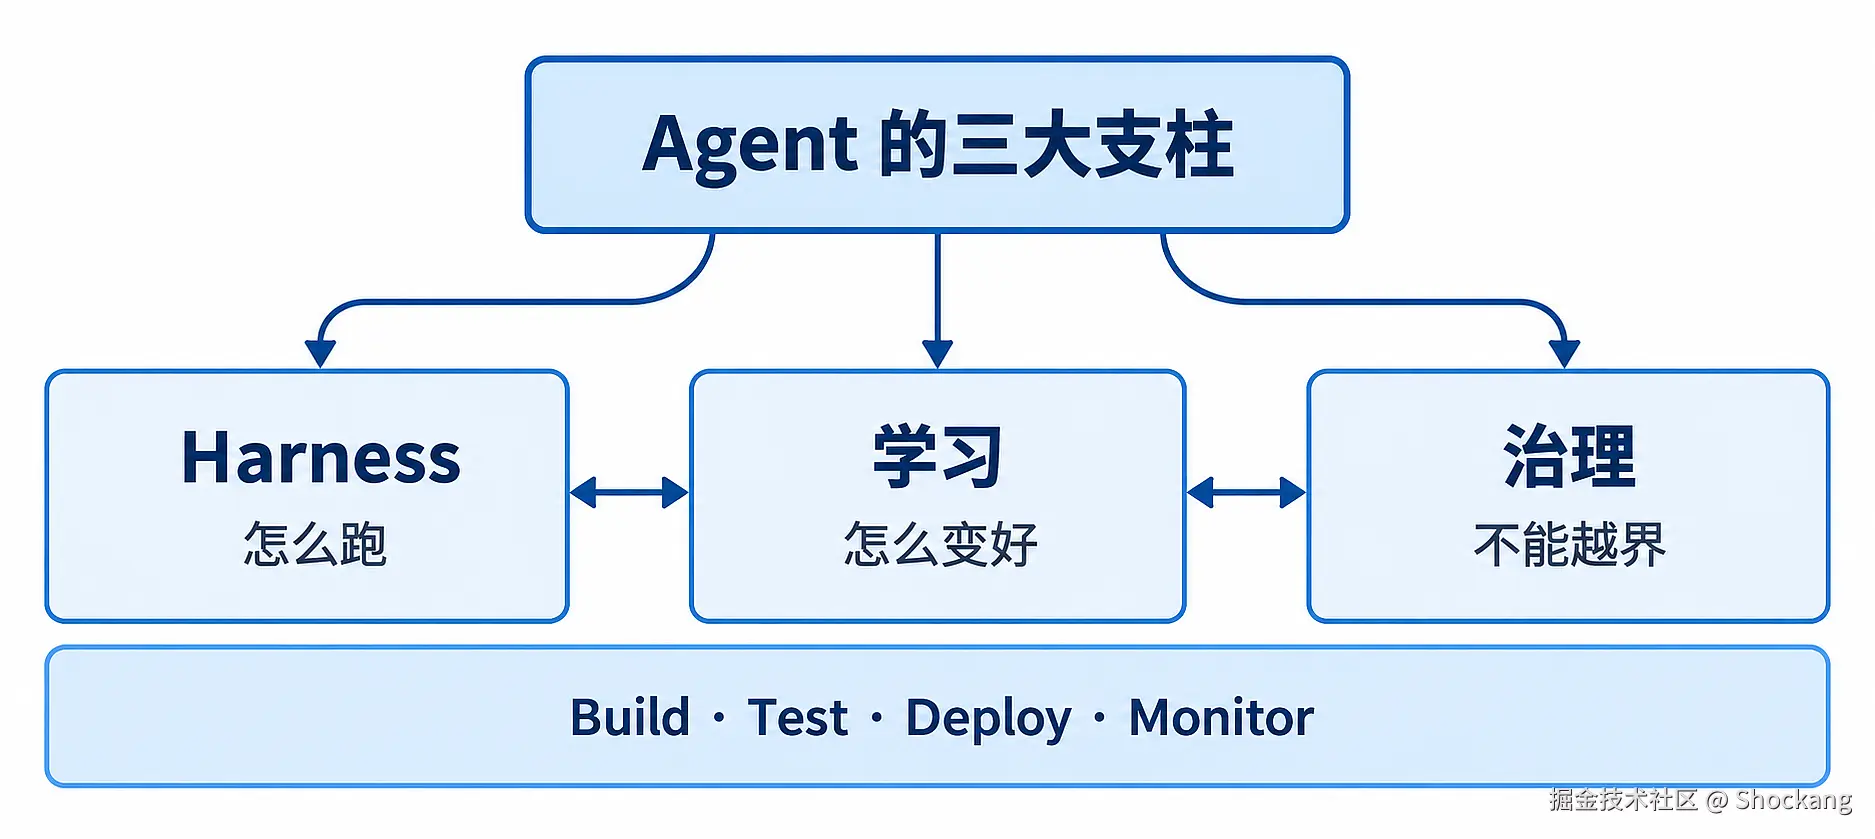
本文用三大支柱整理架构关系:Harness 负责执行组织,学习闭环负责利用反馈,治理负责成本与权限边界。这是作者的解释框架,不是官方三个互斥产品类别。官方产品分类另行区分 LangGraph 运行时、LangChain 抽象和 Deep Agents harness;下文的职责图不能替代这个分类。三条线需要通过明确的数据和控制接口协作,平台功能也不会自动成为团队的全部治理流程。
Harness 的中立性:可替换的「大脑插槽」
Harness 应尽量将业务逻辑与模型接入细节分开。Deep Agents是在 LangChain 基础上、利用 LangGraph 执行和持久化能力的 harness;这不等于切换任意模型都不需要改动。消息格式、工具 schema、上下文长度和行为差异仍需兼容性测试。接入支持的时间与迁移周期取决于版本和任务,本文不作统一时限承诺。
中立不等于无约束。作者建议让应用明确 system prompt 的注入位置、端用户信息的传递边界和工具可见性。下面用"模型注册表、提示词注册表、工具注册表"表达这个分层思路;这些名称属于本文伪代码,不是对 Deep Agents 或 LangGraph 的公开 API 复述。切换模型后仍要验证工具参数、失败处理与评测结果,不能只更改一个 registry 项就认定兼容。
python
# 本文应用伪代码:注册表接口不是产品 SDK,未执行。
class Harness:
    def __init__(self, model_registry, prompt_registry, tool_registry):
        self.models = model_registry   # 可热替换的多模型池
        self.prompts = prompt_registry # 按阶段注入的 system prompt
        self.tools = tool_registry     # 工具/MCP server 的可见性表

    def invoke(self, agent_state, step):
        model = self.models.pick(agent_state.tier)         # 按成本/可靠性档位选模型
        ctx = self.prompts.for_step(step)                  # 按阶段注入上下文
        visible = self.tools.visible(agent_state.identity) # 按身份过滤工具可见性
        return model.run(ctx, agent_state, visible)
复合式学习:把监控数据送回 Build
Monitor 阶段积累的 traces、评分和用户反馈,应成为下一轮问题整理与评测的输入。当前 Engine 文档描述了分析生产 traces、结合反馈整理问题与提出修复的能力;把这些建议接入 Build、安排回归、审阅 PR,仍是需要配置和人员负责的工程流程。"复合式学习"在本文指这种持续利用反馈的工作方式,不意味着产品已经自动改变工具、路由或生产提示词。
不只统计采集了多少 trace,还应统计有多少问题经人工确认、多少变更通过回归并被接受。工作量目标应与团队实际处理能力一起制定。质量指标、误报率与修复接受率要一起看,避免把"自动生成建议更多"误当成业务效果已经改善。
治理的四道边界
下面用实例数量、成本、身份与权限四个维度安排治理责任。它们分别需要容量测试、任务账本、身份映射和工具服务端校验;先确认控制点和负责人,再选择平台配置。
| 约束维度 | 治理对象 | 典型策略 |
|---|---|---|
| Agent 数量 | 并发运行的 agent 实例上限 | 租户隔离、并发上限 |
| 成本 | 按团队 / 用户 / API key 归集的花费 | cost visibility + spend limits 分维度设置 |
| 身份认证 | 调用者及其可访问的资源 | Identity 验证调用者;Connections 处理外部服务授权;Channels 处理消息接入 |
| 权限边界 | Agent 能调哪些工具/数据 | MCP server 接入白名单、工具粒度 RBAC |
这些控制点需要联动:预算检查不能替代数据权限;按租户设置并发上限时,也要先确定请求属于哪个租户。
把调用者映射到租户、用户、线程与外部凭据,再分别验证模型请求、工具执行和持久化状态的边界。例如,换一个端用户后,既要检查可读线程是否变化,也要检查工具实际使用的凭据是否变化;只有界面上隐藏工具还不够,服务端应有拒绝证据。本文用这些测试结果衡量 harness 的可控性。
三大支柱的全周期咬合
将这份检查清单放入 Build/Test/Deploy/Monitor 全周期,每一项都指定负责实现和验收的人:
- Build:prompt / 工具 / 路由在提交时就要带治理标签(成本档、权限范围、合规等级)
- Test:评估不仅要打质量分,还要打「这一改动会不会突破 spend cap」
- Deploy:灰度发布要按治理维度切流(先开低风险租户)
- Monitor:trace 上要带治理上下文(哪个 key、哪个 user、哪条 policy 被命中)
架构对比:通用平台 + 单一模型 vs 中立 harness + 多模型
下面是本文用于讨论取舍的架构对比。它比较设计责任,不提供迁移耗时、费用或组织成熟度的普遍保证:
| 维度 | 通用平台 + 单一模型 | 中立 harness + 多模型 |
|---|---|---|
| 模型迁移 | 团队维护适配与兼容性测试 | 注册表便于集中管理,仍需逐模型验证 |
| 成本分档 | 可以自行记录归属与设置预算 | 接入所选 Gateway 后集中使用其支持的策略 |
| 治理落点 | 取决于平台与应用的控制面 | harness 配合身份、工具服务及运行时约束 |
| 复合学习 | 团队自行组织反馈与回归 | Engine 可辅助整理问题,修复仍经团队审核 |
| 适用场景 | 内部工具、低风险 POCs | 多租户生产、合规要求高的业务 |
取舍取决于团队已有系统和维护能力。单模型方案可以直接满足明确任务;中立 harness 与集中策略能减少部分重复接入,也会增加配置、适配和回归成本。作者建议先列出未来治理需求,再决定哪些接口值得抽象,而不是为了未来"可以热替换"提前承诺零业务改动。模型迁移要有相同任务集和权限边界下的前后对照。
这三大支柱因此是本文的责任划分:Harness 组织执行,学习闭环整理反馈,治理决定允许哪些行为。它们帮助团队找控制点,不是名为 Governed Agents 的单一公开 SDK,也不要求每个组织采用相同的人员编制。
组织与生命周期:治理落地的载体
三层团队:平台、Agent、领域专家
作者建议把职责分成三类:平台工程师维护运行条件、接入和可观测性;Agent 工程师维护提示词、工具和工作流;领域专家定义质量与业务边界。同一人可以承担多类职责,也可以由多个团队协作。划分的目的在于明确谁确认问题、谁修改实现、谁批准上线,不是断言行业已存在统一的三层组织结构。
采用 LLM Gateway时,团队在它支持的配置面管理模型流量策略;采用 LangGraph 时,团队组织执行图和持久化后端;领域专家可以参与评测样本和标注。界面协作减少部分开发工作,却不保证复杂评估完全无需代码,也不意味着 Gateway 替代沙盒、工具服务认证或全部部署基础设施。
闭环:Build → Test → Deploy → Monitor → Build
本文建议按以下循环安排责任;自动门禁需要团队在自己的交付系统中实现和验证:
- Build:领域专家提供样例和期望行为,Agent 工程师把它们整理成可复用用例。
- Test:使用评测工具比较质量、延迟和成本,明确样本和基线版本。
- Deploy:团队决定发布门槛与批准人;指标通过并不替代权限和安全检查。
- Monitor:从真实 traces 和反馈中确认问题,再人工选择哪些问题进入下一轮样本与修复。
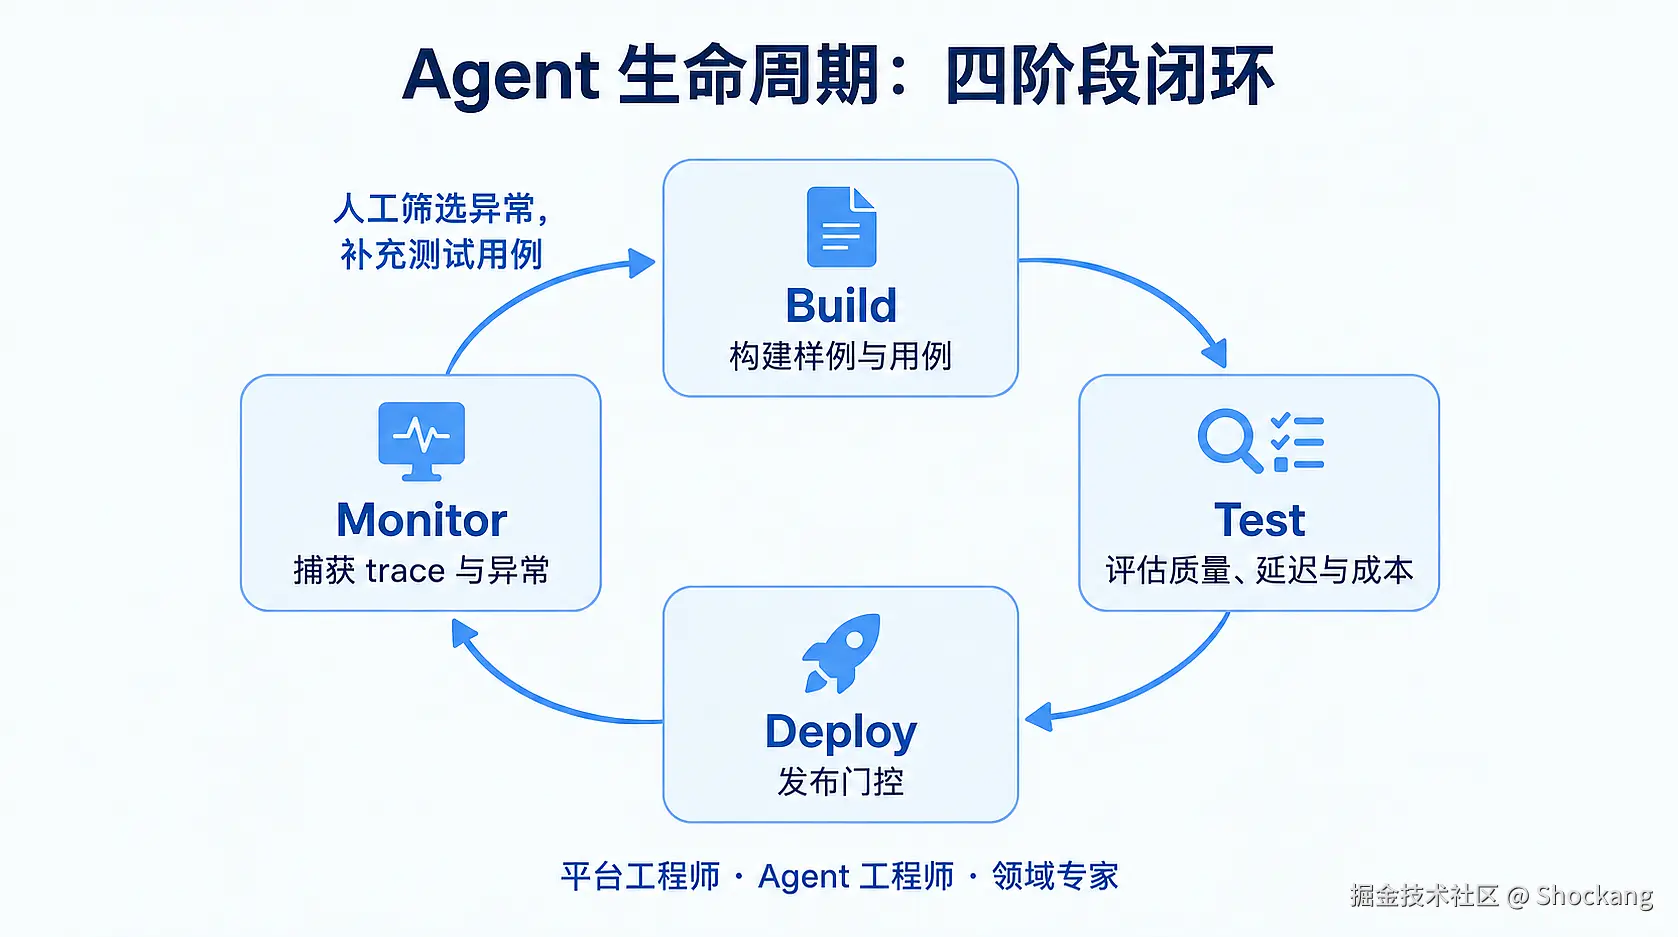
每一步都不能失控
每个阶段必须同时满足:可观测 、可评估 、可回滚。缺一即形成单点失控。
python
# 本文治理策略示意,非官方配置文件;未执行。
lifecycle_policy = {
    "build": {"required": ["eval_dataset", "trace_sample"]},
    "test": {"metrics": ["accuracy", "latency_p95", "cost_per_call"],
             "baseline_required": True},
    "deploy": {"gate": "team-defined checks", "human_approval": True},
    "monitor": {"alert_on": ["cost_overrun", "error_rate", "tool_failure"],
                "rollback_requires_human_approval": True},
}
作者建议将 Monitor→Build 的反馈纳入常规评审,记录哪些问题被接受、拒绝或延后。策略文件只是责任约定;是否真正阻止未授权发布,要通过交付系统和权限测试确认。团队工具再完整,也不能把"有一份 policy"当成门禁已经运行。
两种成熟度对比
| 维度 | 纯研发团队 | 平台+领域专家共治 |
|---|---|---|
| 迭代节奏 | 团队主动安排 | 可配置评测与监控辅助,发布仍经批准 |
| 故障定位 | 依赖个人经验 | trace + eval 双链路 |
| 边界定义 | 隐式,散落在注释 | 显式,policy 可审计 |
| 知识沉淀 | 散落在工程师记忆 | eval dataset + sample trace |
| 方案 vs 方案 | 适用阶段 | 关键权衡 |
|---|---|---|
| 纯研发团队 | 原型期、低流量、合规弱 | 启动快 vs 增长后治理成本非线性上升 |
| 平台+领域专家共治 | 多团队协作、合规硬约束 | 初期投入大 vs 闭环自我强化,适合长期运营 |
技术栈与责任边界要一起设计。只有工具、没有问题确认与发布责任,面板上的建议难以变成可靠改进;只有角色分工、没有可追溯的数据,也难以复核一次修改。同一人可以兼任多个角色,但问题确认与上线责任应明确。
把限额策略、备用目标选择、任务恢复和人工处置分别交给明确的负责人。演练时保存触发条件、故障前状态和处置结果,再检查它们是否对应同一个任务与版本;这比用"stateful"概括整条恢复链更便于交接。模型请求回退与工具副作用恢复的区别,集中在网关章节展开。
组织与生命周期为治理提供责任载体。平台、Agent 与领域专家沿同一份问题和评测记录协作,可以减少交接中的信息损失;是否改善了效率,应由实际迭代数据检验。
Runtime 治理层:从业务逻辑到托管基础设施
Runtime 的三要素:业务逻辑、Harness、基础设施
本文为讨论责任,将应用拆为业务逻辑、Harness 和基础设施三部分;这不是官方运行时产品分类。按当前产品文档,LangGraph 提供底层执行与持久化能力,Deep Agents 是建立在 LangChain/LangGraph 之上的 harness。业务逻辑、模型/工具组织和运行后端需要配合,但不能把 LangGraph 与 Deep Agents 当作两个可互换的 harness。
python
# 本文责任分层示意,非 SDK;未执行。
class AgentRuntime:
    def __init__(self, business_logic, harness, infrastructure):
        self.logic = business_logic
        self.harness = harness  # 例如建立在 LangGraph 上的 Deep Agents
        self.infra = infrastructure  # 持久化后端、隔离及接入由部署决定
LangGraph 与持久化后端负责线程运行和恢复所需的基础能力,Deep Agents 增加较完整的 Agent 组织方式;Managed Deep Agents进一步运营 harness 与 Agent Server 基础设施。自建团队主要配置、部署和维护持久化实现,不是必须从零开发新的持久化引擎。检查点与 store 的作用域不同,内存实现也不保证进程重启后可恢复。模型、工具和生命周期 middleware 是可显式加入的钩子层,不能代替持久化、沙盒或 Gateway 本身。
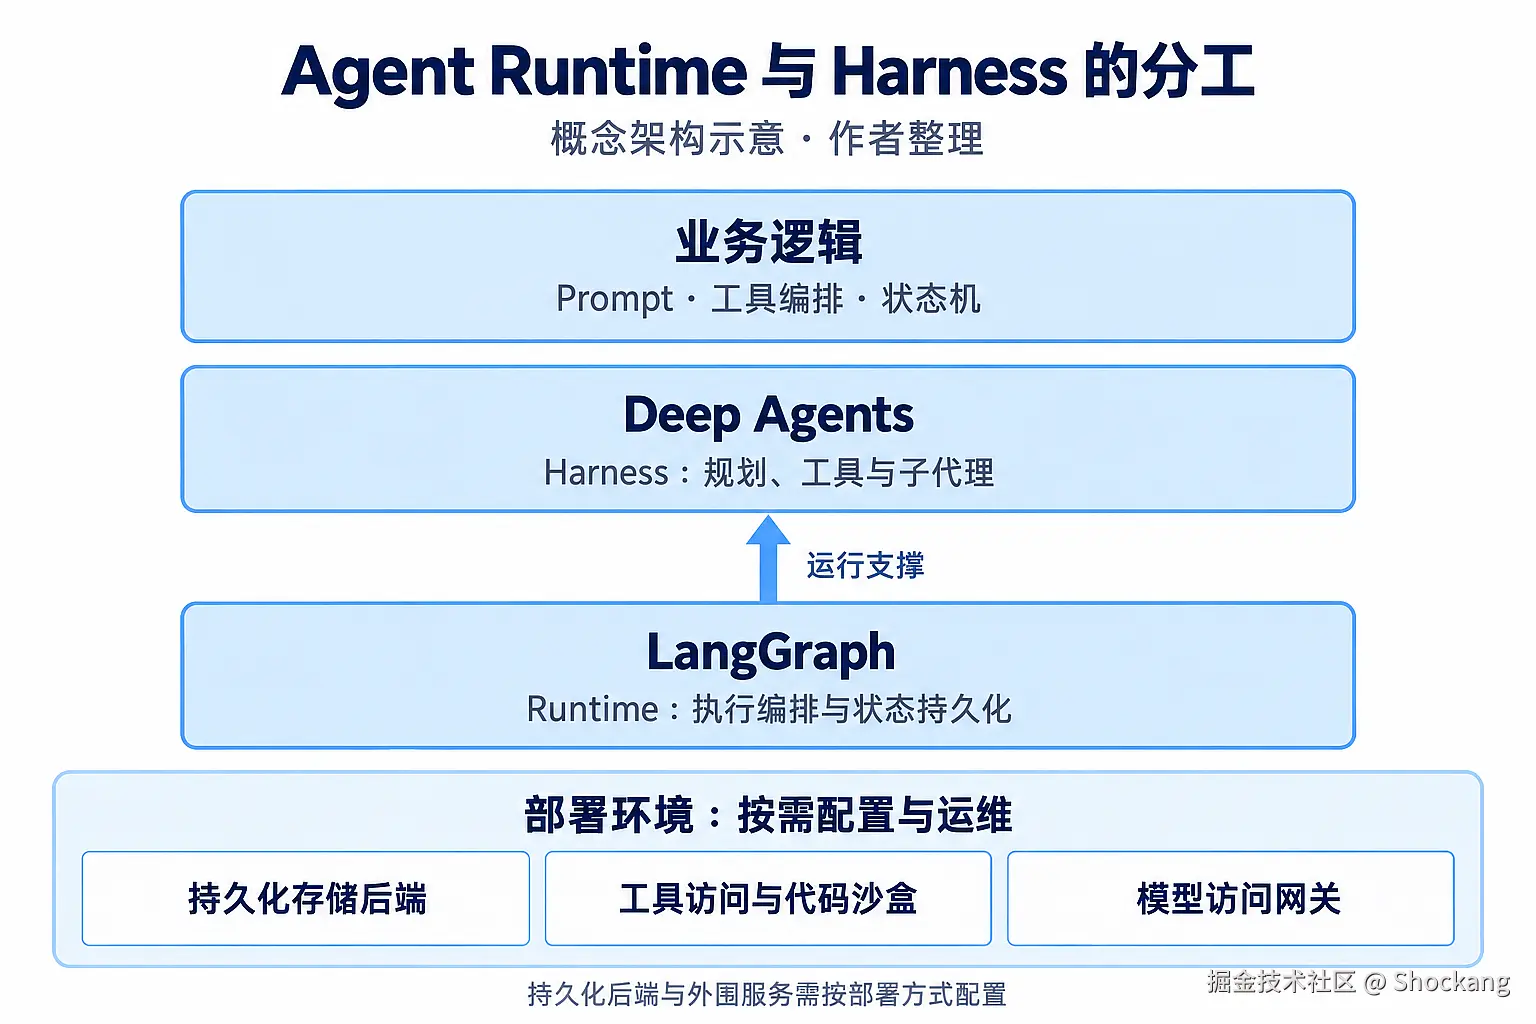
从自建到托管:摩擦力曲线
| 治理维度 | 自建 Runtime | Managed Deep Agents |
|---|---|---|
| durable execution | 配置并运维适当的检查点/存储后端 | 使用平台运营的 Agent Server 能力,仍核对配置与限制 |
| 工具安全接入 | 实现调用者和外部服务授权边界 | 配置 Connections 等能力,并验证实际权限 |
| 沙盒隔离 | 选择并运维隔离方案 | 按项目配置所需沙盒能力 |
| 网关策略 | 可自建接入或选用现有 Gateway | 按实际接入和项目配置使用相关能力 |
| 搭建与治理配置 | 团队维护各层配置和升级 | 平台减少部分运维责任,应用授权仍由团队核对 |
对比的核心是责任转移与可配置范围。托管可以减少重复运行设施,却不保证事故自动从 P0 降为 P3,也不会替团队决定所有工具授权。作者建议在上线前验证长任务重启、凭据撤销和资源限制:记录操作前的身份与状态,施加故障,再核对恢复结果和越权拒绝证据。这样的验收比"开箱即用"标签更能说明当前配置是否满足任务。
身份、外部授权与消息接入:Connections、Identity、Channels
当前 Managed Deep Agents 文档区分调用者身份、外部服务接入和消息渠道,三者不能互相替代:
- Connections:管理对外部服务的访问授权。具体使用 OAuth 或其他凭据的方式取决于集成配置,不据此推导所有服务都统一签发短期 token。
- Identity:验证调用者或端用户,并在相应身份模式下约束其可访问的线程、memory 与凭据;它不是"Agent 的稳定 ID"。工作区 API 访问的读取范围也可能更广,不能默认所有访问方式都实现了端用户隔离。
- Channels:将 Agent 接入消息渠道。渠道身份与调用授权需要映射和验证,不等于一次注册就自动取得外部工具的全部权限。
作者建议分别测试"谁发起请求""能读哪个线程""用谁的外部凭据"。撤销 Connections、切换端用户或移除消息渠道时,都应复核实际资源访问结果;概念分开只是起点,不是隔离已成立的证据。
User-level memory 与 Built-in tools
User-level memory 可以帮助应用保留跨任务信息,但存什么、以哪个身份访问、何时检索,需要结合项目 memory 与身份配置。作者建议把用户私有内容和共享知识分开,并核对工作区访问方式与端用户访问方式的差异;仅使用同一个字符串 ID,不足以证明线程、记忆和凭据已经隔离。持久化能力也不等于每次请求都会自动注入全部历史。
内置或集成工具可以减少重复接入代码。验收时按项目工具、Connections 与权限配置逐项记录:哪些能力启用、凭据属于谁、失败由谁处理、费用归属何处;随后用允许与拒绝两类请求核对记录和实际结果。
观察 治理摩擦力:跨层耦合带来的复杂度
业务逻辑、harness 与基础设施互相影响,但本文没有测得一条数学意义的"指数增长"曲线。作者关心的是跨层约束:工具输出扩大上下文会影响成本,调用者变更会影响可读 memory,恢复任务时还要维持正确的权限。将运行设施托管可改变维护分工,却不会消除这些耦合。团队应以故障场景和控制点检验设计,而不是从层数直接推导风险倍数。
示意 消除的是重复工程量
Managed Deep Agents 将 harness 与 Agent Server 周边能力组合运营,能减少团队重复维护部分运行设施的工作。它不是将 N 套任意治理策略自动合并成 1 套,也不取消应用侧的身份和业务授权。作者建议先列清交给平台的责任,再列出仍需维护的提示词、工具权限、memory 范围、预算与回归用例,避免把"少写部署代码"误当成"无需安全设计"。
yaml
# 本文配置清单示意,非可执行 MDA 部署 schema;未执行。
application_requirements:
  runtime: "选择运行时与持久化部署方式"
  harness: "选择 Deep Agents 或自定义组织方式"
  identity: "验证调用者,并核对端用户/工作区访问范围"
  connections: "核对外部服务凭据与授权范围"
  channels: "核对消息渠道与调用者的映射"
  memory: "区分用户私有内容与共享知识"
  model_policy: "按实际接入配置 Gateway 与预算策略"
  release: "人工确认测试结果和发布责任"
自建 vs 托管的取舍矩阵
取舍应围绕数据边界、调用量、运维能力与定制深度,而不是仅按行业名称选自建或托管。自建需要运维和升级,托管需要理解项目权限、供应商处理范围和服务限制;混合部署还要明确边界处的数据与凭据流动。部署在自有 VPC 并不意味着所有推理都留在其中,选择外部模型供应商仍可能传出任务内容。
可沿产品分类、持久化和 Managed Deep Agents文档核对各层职责。作者建议将"谁运营、谁授权、谁批准、数据发往哪里"写成可复核清单;具体合规结论仍依赖所选部署、推理供应商与协议。
网关与决策模型:流量侧的成本与路由治理
网关层:把多供应商、多端点收敛到一个入口
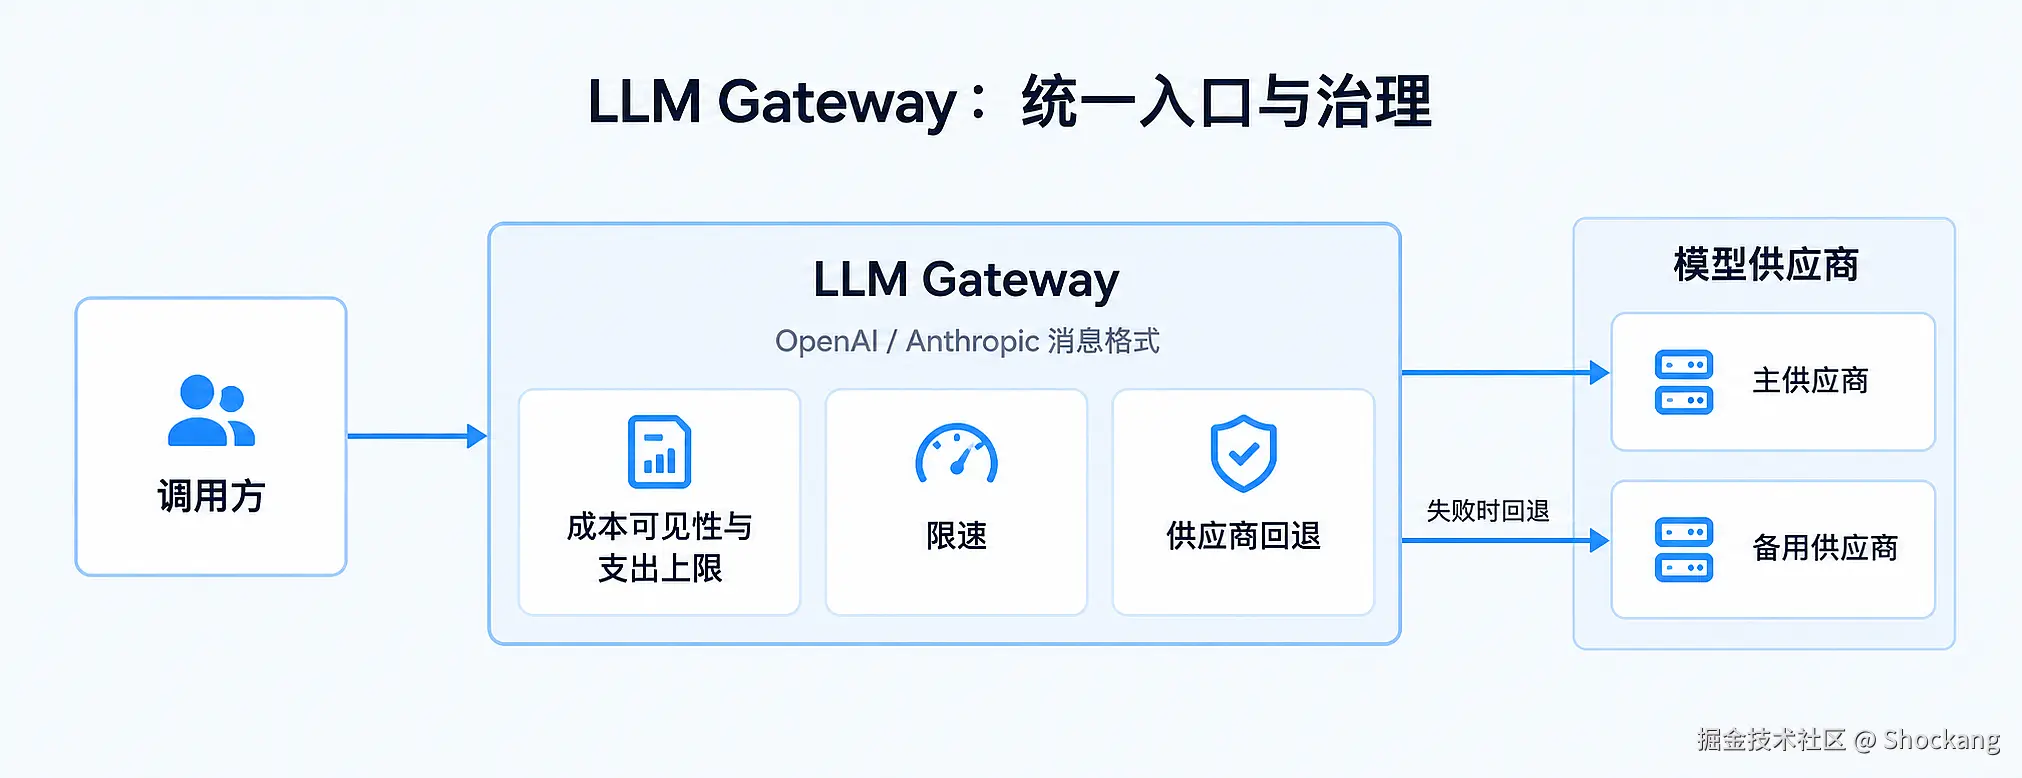
当前 LLM Gateway 文档描述兼容的客户端请求格式、LangSmith 身份验证以及配置的模型访问。接入时从项目配置复制 endpoint 与 provider/model 或配置标识,使用 LangSmith API key,再核对消息字段、工具参数与返回行为。模型标识由配置决定,密钥字符串不承担路由声明。
Gateway 治理实际经过该入口的模型请求;工具与 MCP 服务授权、长期任务恢复和业务审批各有控制点。LangSmith tracing 不以全部调用过网关为前提。LLM Gateway 发布说明还列出后续方向,接入时应以当前项目开放的能力为准。
下面使用兼容 OpenAI 客户端展示接入责任,未发起请求。GATEWAY_BASE_URL、GATEWAY_MODEL_ID 是本文的环境变量名,应从项目实际 Gateway 配置复制 endpoint 和带供应商/配置范围的模型 ID;不要照抄一个猜测地址。认证使用 LangSmith API key,供应商凭据由所选 Gateway 配置管理。
python
# 兼容客户端用法示意;环境值须按官方 Gateway 文档填写;未执行。
import os
from openai import OpenAI

client = OpenAI(
    base_url=os.environ["GATEWAY_BASE_URL"],
    api_key=os.environ["LANGSMITH_API_KEY"],
)
response = client.chat.completions.create(
    model=os.environ["GATEWAY_MODEL_ID"],
    messages=[{"role": "user", "content": "请概括这次任务的边界"}],
    max_tokens=128,
)
成本可视化与多档支出护栏
做成本审计,可以先从一条任务链开始:列出调用者、任务、每次请求和应用当前记录的用量,再核对平台实际提供的成本记录。业务侧为缺失的租户、用户或线程关系补上自己的关联账本;记录取自何处、采用什么单位、哪些费用尚未纳入,比先画一个总额看板更有用。
官方产品说明列出成本/支出控制、限速与模型供应商回退。配置时选定项目支持的策略对象,写清触发条件和备用目标,再分别观察正常请求、触限请求与恢复后的请求。比较应用账本和平台记录时,先确认归属与统计时间范围一致。
| 治理能力 | 作用对象 | 典型用途 |
|---|---|---|
| cost visibility + spend limits | 文档和项目支持的策略对象 | 团队核对归属标签并设置预算 |
| rate limiting | 接入 Gateway 的模型请求 | 按配置限制流量,观察拒绝与重试 |
| configured fallbacks | 配置的供应商/模型 | 请求失败时按支持的策略选择备用目标 |
本地离线实验:先把额度边界与业务键算清楚
下面是本文自行实现的规则实验。这份代码与模拟输入于 2026-10-18 在本地 Python 中执行,22 个用例断言通过,进程退出码为 0。它没有连接 LangSmith、Gateway 或模型供应商;代码中的字段属于本地账本,额度是无量纲的模拟单位,不是供应商价格或实际 token 费用。
实验只测两件事:累计额度恰好等于上限时允许,超过时拒绝;租户、用户、线程三元组分别记账。金额输入限定为普通非负十进制字符串,整数部分最多九位,小数部分最多六位;浮点值、负数、科学计数、非有限值和多余空白都拒绝。Python Decimal 文档说明十进制表示与可配置精度;本例另行收窄输入格式,并在局部上下文里设定精度与非精确运算异常。
把下列代码保存为 governance_budget.py:
python
"""Offline synthetic quota example. No SDK, credentials, network or real billing."""
from decimal import Decimal, Inexact, localcontext
import json
import re
import sys

AMOUNT = re.compile(r"(?:0|[1-9][0-9]{0,8})(?:\.[0-9]{1,6})?\Z")
IDENTIFIER = re.compile(r"[A-Za-z0-9_-]{1,32}\Z")


def amount(value):
    if type(value) is not str or AMOUNT.fullmatch(value) is None:
        raise ValueError("invalid_amount")
    return Decimal(value)


def reserve(ledger, identity, cost, limit):
    if (type(identity) not in (list, tuple) or len(identity) != 3
            or any(type(x) is not str or IDENTIFIER.fullmatch(x) is None
                   for x in identity)):
        raise ValueError("invalid_identity")
    key = tuple(identity)
    used, increment, ceiling = map(amount, (ledger.get(key, "0"), cost, limit))
    with localcontext() as context:
        context.prec = 28
        context.traps[Inexact] = True
        total = used + increment
    if total > ceiling:
        raise PermissionError("budget_exceeded")
    return {**ledger, key: format(total, "f")}


def run(data):
    receipts = []
    key = ("tenant-a", "user-a", "thread-a")
    for case in data["budget_cases"]:
        ledger = {key: case["used"]}
        snapshot = dict(ledger)
        try:
            updated = reserve(ledger, key, case["cost"], case["limit"])
            actual = {"status": "allow", "balance": updated[key]}
        except (ValueError, PermissionError) as exc:
            actual = {"status": "reject", "error": str(exc)}
        assert actual == case["expected"], case["name"]
        assert ledger == snapshot, "input ledger mutated"
        receipts.append({"name": case["name"], "input": case,
                         "actual": actual, "passed": True,
                         "input_ledger_unchanged": True})
    for case in data["scope_cases"]:
        ledger = {key: "0.10"}
        updated = reserve(ledger, case["identity"], "0.02", "0.30")
        actual = {"original_balance": updated[key],
                  "new_scope_balance": updated[tuple(case["identity"])]}
        assert actual == case["expected"], case["name"]
        assert ledger == {key: "0.10"}, "input ledger mutated"
        receipts.append({"name": case["name"], "input": case,
                         "actual": actual, "passed": True,
                         "input_ledger_unchanged": True})
    return {"passed": len(receipts), "failed": 0,
            "scope": "offline_synthetic_local_rules_only", "receipts": receipts}


if __name__ == "__main__":
    print(json.dumps(run(json.load(sys.stdin)), ensure_ascii=False, indent=2))
将输入保存为 cases.json。其中 used、cost、limit 都是本地规则的字段;expected 是用例预先写好的期望,不是执行器回填的结论。
json
{
  "budget_cases": [
    {"name": "under_limit", "used": "0.10", "cost": "0.10", "limit": "0.30", "expected": {"status": "allow", "balance": "0.20"}},
    {"name": "exact_decimal_limit", "used": "0.10", "cost": "0.20", "limit": "0.30", "expected": {"status": "allow", "balance": "0.30"}},
    {"name": "zero_at_zero_limit", "used": "0", "cost": "0", "limit": "0", "expected": {"status": "allow", "balance": "0"}},
    {"name": "one_micro_unit_over", "used": "0.30", "cost": "0.000001", "limit": "0.30", "expected": {"status": "reject", "error": "budget_exceeded"}},
    {"name": "already_above_limit", "used": "0.40", "cost": "0", "limit": "0.30", "expected": {"status": "reject", "error": "budget_exceeded"}},
    {"name": "negative", "used": "0", "cost": "-0.01", "limit": "0.30", "expected": {"status": "reject", "error": "invalid_amount"}},
    {"name": "nan", "used": "0", "cost": "NaN", "limit": "0.30", "expected": {"status": "reject", "error": "invalid_amount"}},
    {"name": "infinity", "used": "0", "cost": "Infinity", "limit": "0.30", "expected": {"status": "reject", "error": "invalid_amount"}},
    {"name": "negative_infinity", "used": "0", "cost": "-Infinity", "limit": "0.30", "expected": {"status": "reject", "error": "invalid_amount"}},
    {"name": "scientific", "used": "0", "cost": "1e-3", "limit": "0.30", "expected": {"status": "reject", "error": "invalid_amount"}},
    {"name": "float", "used": "0", "cost": 0.1, "limit": "0.30", "expected": {"status": "reject", "error": "invalid_amount"}},
    {"name": "boolean", "used": "0", "cost": true, "limit": "0.30", "expected": {"status": "reject", "error": "invalid_amount"}},
    {"name": "seven_fraction_digits", "used": "0", "cost": "0.0000001", "limit": "0.30", "expected": {"status": "reject", "error": "invalid_amount"}},
    {"name": "ten_integer_digits", "used": "0", "cost": "1000000000", "limit": "0.30", "expected": {"status": "reject", "error": "invalid_amount"}},
    {"name": "leading_zero", "used": "0", "cost": "01", "limit": "0.30", "expected": {"status": "reject", "error": "invalid_amount"}},
    {"name": "whitespace", "used": "0", "cost": " 0.1", "limit": "0.30", "expected": {"status": "reject", "error": "invalid_amount"}},
    {"name": "null", "used": "0", "cost": null, "limit": "0.30", "expected": {"status": "reject", "error": "invalid_amount"}},
    {"name": "invalid_existing_balance", "used": "-0.01", "cost": "0", "limit": "0.30", "expected": {"status": "reject", "error": "invalid_amount"}},
    {"name": "invalid_limit", "used": "0", "cost": "0", "limit": "NaN", "expected": {"status": "reject", "error": "invalid_amount"}}
  ],
  "scope_cases": [
    {"name": "different_tenant", "identity": ["tenant-b", "user-a", "thread-a"], "expected": {"original_balance": "0.10", "new_scope_balance": "0.02"}},
    {"name": "different_user", "identity": ["tenant-a", "user-b", "thread-a"], "expected": {"original_balance": "0.10", "new_scope_balance": "0.02"}},
    {"name": "different_thread", "identity": ["tenant-a", "user-a", "thread-b"], "expected": {"original_balance": "0.10", "new_scope_balance": "0.02"}}
  ]
}
在保存两个文件的目录运行:
sh
python3 -I governance_budget.py < cases.json实际输出前四行如下;后续 receipts 数组逐项列出输入、实际决定及断言结果:
text
{
  "passed": 22,
  "failed": 0,
"scope": "offline_synthetic_local_rules_only",等号用例中,0.10 + 0.20 得到 0.30,没有因二进制浮点误差拒绝;在 0.30 上再加入 0.000001 会被拒绝。负数和 NaN 等输入在相加前失败;更换租户、用户或线程时,新键从 0 开始,原键仍为 0.10。拒绝后输入账本不变,也不会改写原记录。
这次运行留下的经验很小但明确:先定义允许的数字表示、计量单位和业务键,才能解释一次额度拒绝。三元组分开记账只验证本地键的选择,不构成身份认证或跨租户安全证明;示例也没有并发预留、持久化、重试幂等或外部计费核对。接入真实系统前,应先补这些用例,再在自己的授权测试环境核对平台策略与任务账本。
Fallback:明确请求回退与状态恢复的边界
配置的模型/供应商回退处理请求失败与备用目标选择。429、5xx 或超时可能是需要测试的失败场景,但实际触发条件与协议支持要以配置为准。不能由此声称 Gateway 会把半段生成文本、未完成工具调用或任意 Agent 状态自动迁移到另一供应商。作者建议把三类问题分开验收:模型请求的 fallback、供应商故障的熔断/记忆、harness 的检查点和工具副作用恢复。重复执行工具尤其需要幂等与人工处置设计;传递相同消息历史不等于恢复了外部世界的状态。
决策模型:把 guardrail 与路由从通用 LLM 拆出来
Jev 是一个可选的决策模型例子。2026-09-25 的官方介绍描述其带类型的概率输出,以及利用 LangGraph 组织决策的方式。它可以用于分类、打分或路由等较窄任务;厂商在特定基准下报告的速度和成本,不能写成所有业务都具有毫秒级和低价的保证,也不能据此把 Jev/SemIf 当成 Gateway 自动启用的内部组件。
对明确的分类或风险判断,可以比较一个独立决策层与直接使用生成模型的效果;对开放任务则不必强行拆层。测试要同时记录误判、延迟、费用和人工接管条件。类型输出只是接口约束,不能证明判断必然正确;应用是否采用决策模型,应由自己的任务集和风险预算决定。
| 决策模型 vs 通用大模型 | 决策模型(如 Jev) | 通用大模型 |
|---|---|---|
| 输出形态 | 侧重带类型的概率、分数和分类 | 文本或按任务约束的结构化内容 |
| 延迟 | 取决于模型、请求与厂商特定基准 | 取决于模型和生成长度,需实测 |
| 单位成本 | 按实际计费与误判代价评估 | 同时考虑生成费用和失败重试 |
| 适用场景 | 可验证的分类、guardrail 或路由候选 | 开放生成及其他合适任务 |
直连供应商 vs 走网关:可观测性差距
直连供应商并非必然"黑盒":团队也可以自行实现用量记录、归属标签和备用路由。采用 Gateway 的价值在于集中部分接入与策略责任,代价则是增加一层配置和依赖。作者建议比较两种方案的实际维护成本、策略一致性和故障隔离,而不是宣布任何多人协作场景都具有压倒性的 ROI。
迁移时先选定一条可对照的任务路径,记录迁移前后的模型标识、消息与工具参数、用量归属以及失败处置结果。再分别检查新调用是否进入预期入口、旧数据与新标签从何处分界。按这些记录决定下一批迁移范围,避免把接入完成等同于历史归属已经补全。
网关策略与可选决策层如何配合,应由任务中的实际失败决定:先定位是模型请求失败、判断错误,还是工具执行失败,再选择对应控制点和复核方式。
可观测性治理:用 Trajectory 阅读会话,用 SmithDB 支撑数据层
Trajectory:从 traces 整理可读会话视图
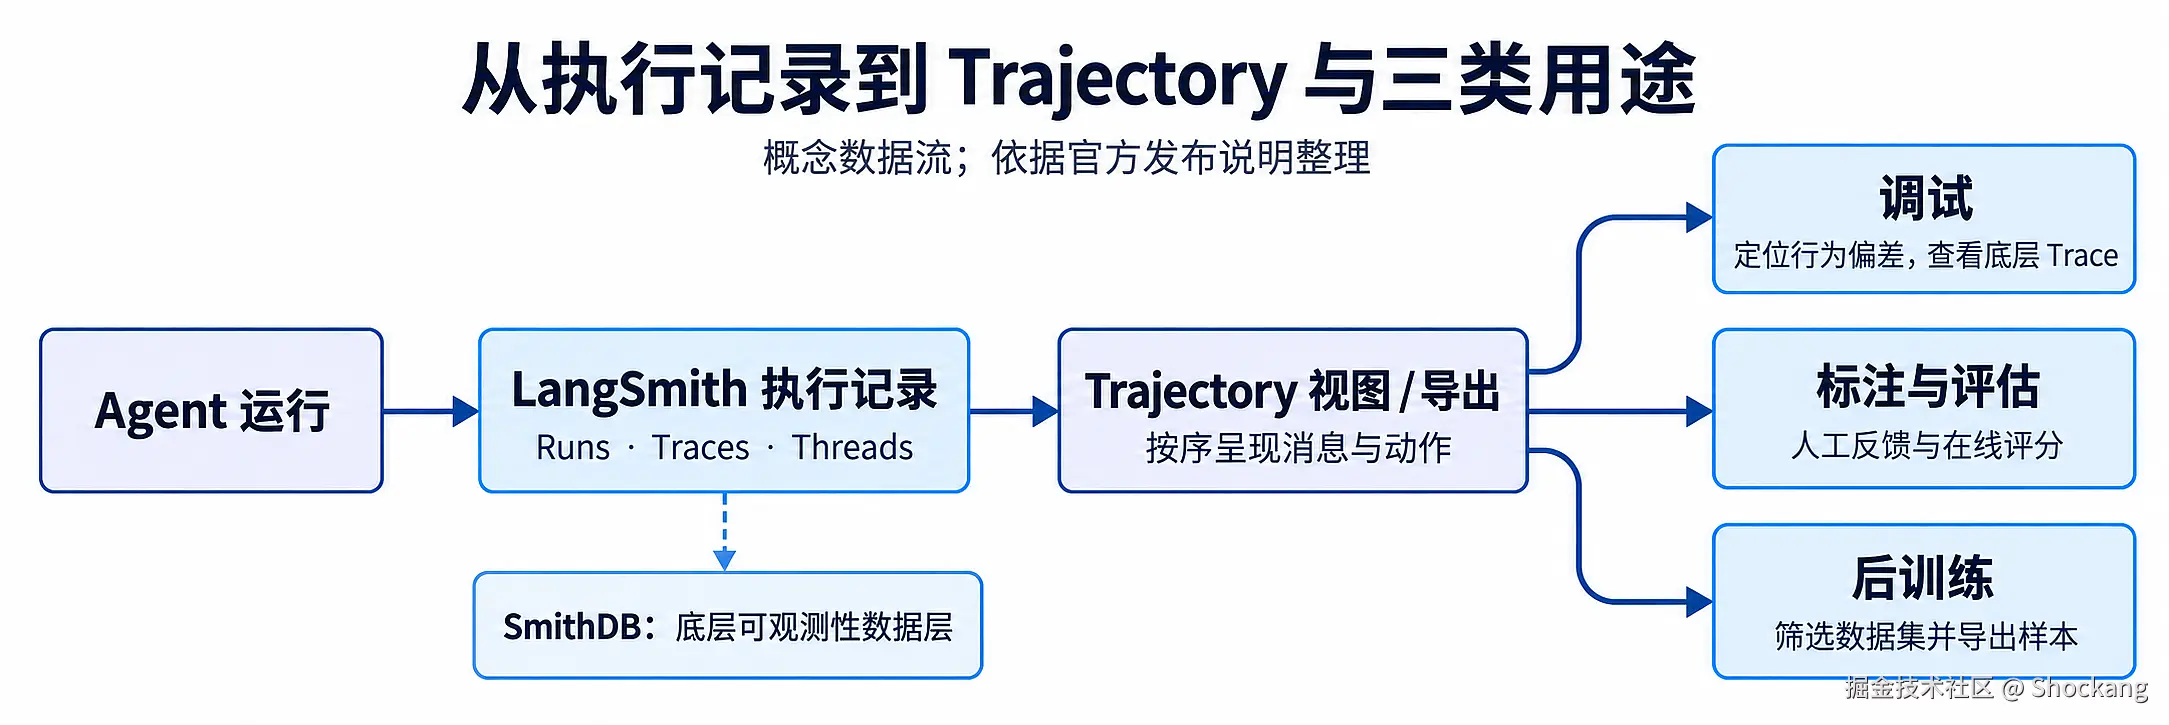
2026-09-24 的 Trajectories 公告提供的是跨一次会话理解 Agent 行为的可读视角:从 thread 中的底层 traces 整理按时间排列、去重的消息和动作,方便查看多轮模型与工具交互。底层 traces 仍保存详细执行树;Trajectory 不是一种把所有 Run/Trace/Thread 都替换掉的唯一存储模型。
这个区别影响排查方式。阅读会话时可以先沿 Trajectory 看消息和动作,再进入关联 trace/run 检查具体调用与反馈。接入不同 SDK 或编程工具仍需符合采集与展示支持范围,不能推导成所有客户端已经统一按同一消息列表直接上报。展示、采集和存储属于不同层次;让它们关联起来有助于治理,但不等于它们已经折叠成一个接口。
UI 升级:面向编程 Agent 长链路的扫描体验
可读的会话视图减少在多轮调用之间来回寻找上下文的负担。当前资料支持调试、人工标注、在线评分和后训练导出等用途;本文不将某一种左右分栏、某个 step 树布局或"任意 50 步任务都能立即定位"的描述当成稳定 UI 合同。具体字段和链接应在所用版本中核对,显示出来的信息还受实际采集内容影响。
调试者先定位失败会话,再沿关联 trace/run 找到需要评分或修复的执行单元。标注者记录业务判断与依据,工程师记录实现变化和实验结果。统一入口能够减少交接成本,但不自动消除数据缺失、隐私处理和误标问题。
标注界面的双向反馈
标注与反馈需要绑定真实可寻址的执行对象。Client.create_feedback 参考面向 run、trace 或 project;若要评分某次工具执行,应选择对应子 run 或按文档使用可映射的对象。不能把任意消息序号或一个编造的 traj-... 字符串当作 run ID,也不能说评分一提交就自动变成数据集 ground truth。
下面仅展示对一个已有 run 写反馈的 SDK 调用形态,未连接服务、未提交评分。LANGSMITH_RUN_ID 是本文用于读取真实目标的环境变量名;应由操作者先核对目标归属和权限。示例 0.8 只是展示数值字段,不是本文对某次真实执行的评价。
python
import os
from langsmith import Client

client = Client()
run = client.read_run(run_id=os.environ["LANGSMITH_RUN_ID"])
client.create_feedback(
    run_id=run.id,
    key="tool_call_correctness",
    score=0.8,
    comment="示例说明:实际评分由标注者依据真实执行填写",
    trace_id=run.trace_id,
)
这条反馈通路帮助团队将观察与具体执行关联。把反馈整理成评测样本,还需要选择、复核和数据集管理步骤;原始评分、业务裁决与训练标签不应混为一类。作者建议保留标注者、目标 run、判定依据与数据集版本的关系,避免将临时意见直接当作训练真值。
SmithDB:面向 Agent 工作负载的自研存储后端
Agent 可观测性会同时面对大量写入和不同粒度查询:按会话阅读、按 trace/run 排查、按元数据过滤以及导出分析。数据量和消息大小取决于实际任务;本文没有通用 trace 后端与 SmithDB 的对照测量,不能声称前者普遍吞吐不足或成本必然更高。
2026-05-13 的 SmithDB 架构说明给出了可核实的实现:Rust,DataFusion 查询能力,Vortex 数据格式,以对象存储为基础的 LSM 组织,Postgres 保存 segment 元数据,并将 ingestion、query 与 compaction 等服务设计为无状态。这些公开组成说明数据层如何分工;不能据此推导专用 thread 页结构、固定相对成本或对外导出接口。
| 公开组成 | 文档描述的职责 | 本文不作的推断 |
|---|---|---|
| Rust / DataFusion | 实现与查询处理能力 | 不据语言推导固定吞吐或延迟 |
| Vortex | 数据格式相关能力 | 不承诺任何消息完全不重复 |
| 对象存储与 LSM | 数据组织与持久存储 | 不等于任意部署无需运维 |
| Postgres segment 元数据 | 管理数据段的元数据 | 不臆造专用 thread 页结构 |
| 无状态 ingestion/query/compaction 服务 | 分开服务职责与运行资源 | 不等于提供直接 Trajectory 写入或训练 API |
同一份数据,三类治理场景
从使用角度,底层 traces/thread 与其 Trajectory 视图可以服务三类工作:工程师调试失败行为;人员对运行结果进行标注与评估;团队选择合适数据进入后训练流程。这些用途由 Trajectories 公告支持,但不应被画成"Trajectory 直接写入 SmithDB,然后零转换进入任意训练器"的官方接口。
导出前检查消息是否完整、是否含敏感信息、哪些反馈经过复核,以及训练端实际需要什么 schema。保存原始 run/trace 的关联,再记录筛选、转换和 train/eval 划分。消息结构有助于复用,不代表省去了脱敏、格式准备或训练目标选择;同一份 JSONL 是否能直接使用,需要按所选训练工具和任务验证。
传统 Trace vs Trajectory:后训练可用性的取舍矩阵
下面按阅读与使用目的比较两种视角,不宣称测得了全生态性能或消息完整性排名:
| 取舍维度 | 底层 Trace/Run 视角 | Trajectory 视角 |
|---|---|---|
| 执行结构 | 保留调用树与执行单元关系 | 整理会话中的时序消息与动作 |
| 消息完整性 | 依赖实际采集和数据处理配置 | 同样依赖底层采集,不补造缺失内容 |
| 调试阅读 | 适合追到具体调用及其元数据 | 适合跨多轮阅读会话行为 |
| 后训练准备 | 需要选择和整理合适执行数据 | 提供便利视角/导出,仍需训练数据准备 |
| 跨工具使用 | 依赖各接入与采集支持 | 不能据统一展示推导所有 SDK 统一上报 |
如果团队需要与既有监控体系协作,应先核对采集和查询边界;如果重点是理解多轮 Agent 行为,可以利用 Trajectory 的时序视角。二者是互补用途,不需要宣布某一种模型完全取代另一种。用于治理的关键是能从视图回到真实执行,并将人工判断与后续数据集版本关联。
本文将这种使用关系整理为"底层 traces/thread → 可读 Trajectory 视图或导出 → 调试、标注/评估、后训练准备"三类消费方向。这是用途示意,不是 SmithDB 对外写入 API 或自动训练管线合同:
数据契约作为治理的一等公民
回到治理视角,Trajectory 改善会话阅读,SmithDB 为可观测性提供底层数据能力,标注与反馈则把人的判断关联到执行。三者各有职责,不能据此声称所有工具已经共用唯一数据契约,或任意反馈和导出都无需转换。作者建议核对数据从采集到视图、从标注到样本的每个边界,记录哪些步骤自动完成、哪些步骤仍由人确认。
学习闭环治理:Fine-Tuning 与 Custom Apps
从 Trajectory 到 Fine-Tuning 的闭环
当前 Smithtune 文档将其标为 beta,基本流程是整理和准备数据、选择支持的提供方训练、比较基础与微调模型,然后按需要部署。Trajectory 导出可以作为准备数据的来源之一,不代表每次完整 Agent 运行都能直接作为训练样本。工具调用、消息脱敏、目标格式及 train/eval 划分仍需核对;训练结果也不能只凭数据来自生产就认定适合上线。
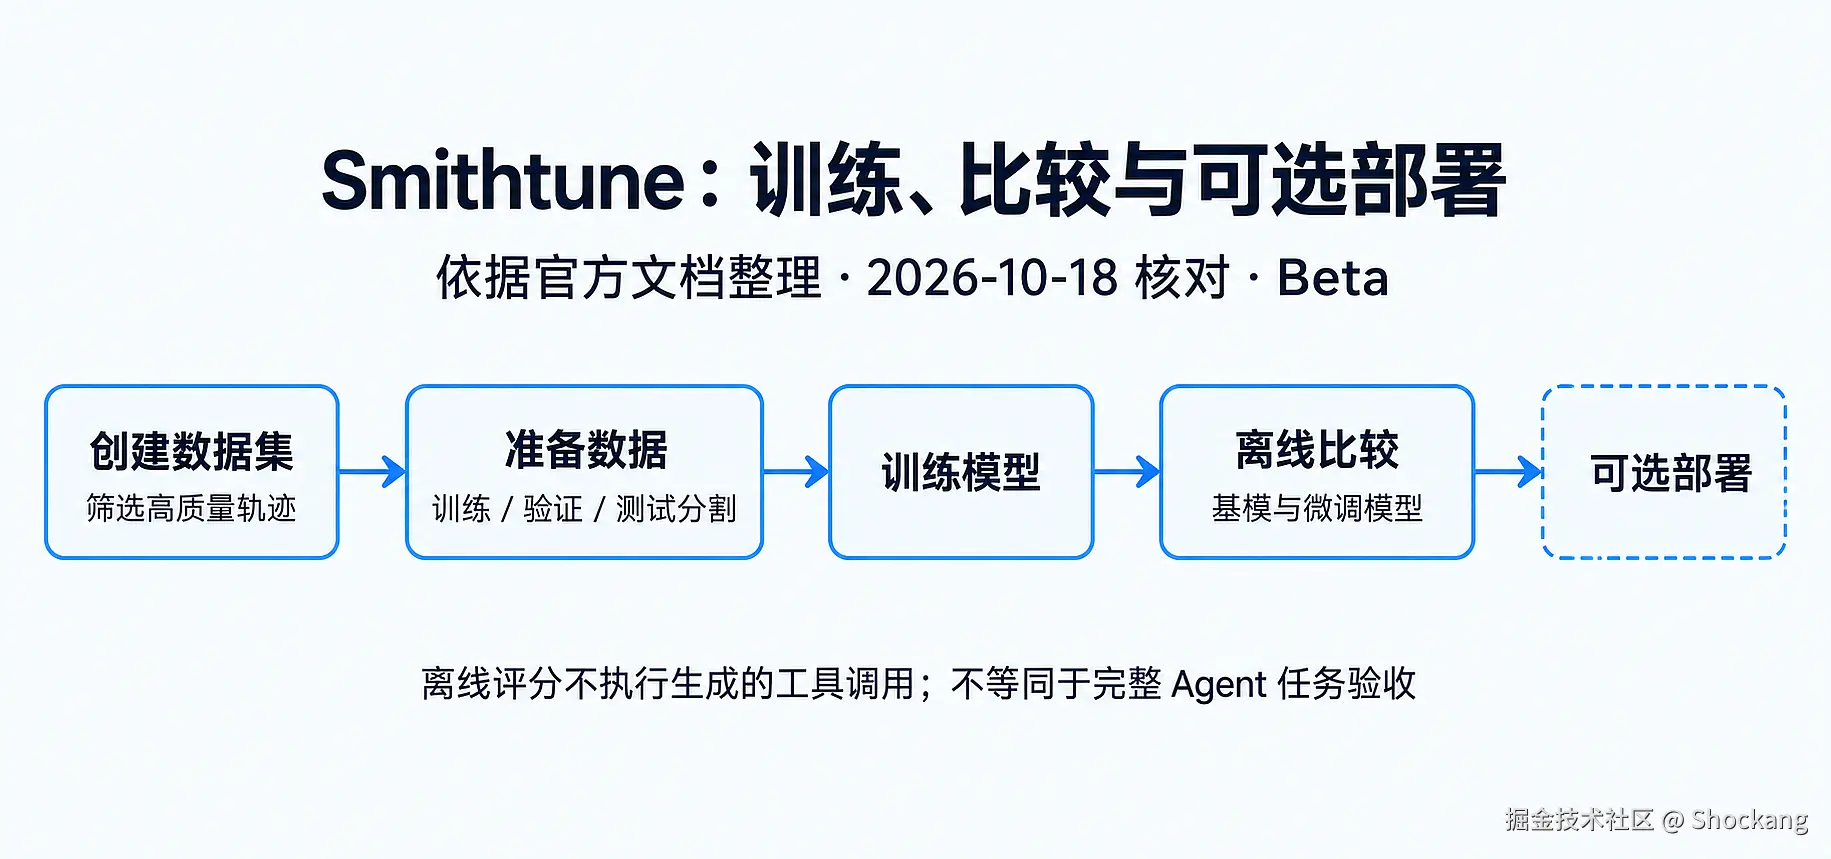
下面使用官方 smithtune 仓库的命令族说明责任顺序。实际参数需按所用版本和训练提供方填写;这份流程图不是可直接复制执行的 CLI 脚本。
text
本文流程示意,非可执行脚本;未执行:
1. dataset pull/push:选择并记录数据集版本
2. prepare:按目标训练格式准备数据,保留 train/eval 分离
3. plan/train:按所选提供方和配置建立训练运行
4. evaluate:比较基础模型与微调模型的离线表现
5. 可选 deploy:依据保存的训练运行目录及提供方要求部署
这个顺序把离线比较放在可选部署之前。Smithtune 的评估并不执行模型生成的工具调用,因此不能据评分宣称完整 Agent 工具链已端到端跑通。提供方特定部署与已保存训练运行相关;支持哪些导出或跨提供方路径,需要逐项核对,不能从同时出现 Fireworks 和 Baseten 的名称推导出权重可以任意直接迁移。
Custom Apps:让 LangSmith 数据反哺应用层
2026-09-24 的 Custom Apps 公告介绍面向 LangSmith 数据构建和共享自定义界面的能力,提供托管、认证与权限支持。它不是模型训练或推理运行时,也没有据此证明"自动挂载所有 Evaluator"或免去每种资源的数据访问设计。
应用访问范围需要遵循实际工作区和资源权限。托管认证与权限支持并不等于所有 App 自动继承相同的细粒度授权。作者建议分别核对 App 用户、可读 traces、数据集写权限和可调用操作,尤其要测试权限撤销后是否仍能访问旧数据。
学习闭环应追求数据和配置可追溯、实验可对比,而不承诺"同样轨迹+同样 CLI 参数必然得到逐位相同权重"。训练中存在实现和环境因素;团队应记录数据划分、配置、运行产物和基础/微调模型的比较结果。离线行为评分与真实工具执行是不同验证范围,后者需要额外的任务环境与权限测试。
手工导出数据时,采集、筛选、训练和结果记录容易产生交接损耗,工具可以减少部分重复操作。但 Trajectory、Smithtune 与 Custom Apps 不组成自动完成全部步骤的一键合同;没有文档支持"所有中间产物不出平台"或数据血缘永远无需额外维护。作者建议保留来源 run/trace、数据集版本、训练运行目录和发布决定之间的关系。
下面按本文建议的数据治理清单比较责任,不宣称平台自动保证每个结果:
| 治理维度 | 手工组织时的责任 | 使用相关工具后仍需核对 | 取舍要点 |
|---|---|---|---|
| 数据血缘 | 保存来源与筛选记录 | run/trace 与数据集版本是否关联 | 追溯成本与集成深度 |
| 权限模型 | 分别配置所用系统 | 工作区、App、提供方的实际权限 | 明确边界与维护成本 |
| 复现性 | 记录环境与配置 | 数据划分和训练运行是否可追溯 | 不以相同参数保证相同权重 |
| 效果对比 | 选择独立评测集 | 基础与微调模型离线比较 | 不替代真实工具任务测试 |
| 追溯链 | 串起数据与变更记录 | 部署产物与人工决定是否保留 | 审计需要与工具依赖 |
手工流程灵活,集成工具能减少部分搬运;二者都需要验证数据处理和责任边界。作者建议按任务选择路径,先完成离线对比,再决定是否部署,而不是将"自动闭环""一键回灌"当成已经成立的保证。
治理贯穿「采集→训练→部署→回归」
本文建议的责任线是"采集→数据准备→训练→离线比较→可选部署→生产回归"。每一步需要保留自己的输入、输出和批准范围;这里的生产回归是团队额外设计的流程,不是 Smithtune 离线评分自动执行工具,也不是 Custom Apps 自动同步所有部署权限。Engine 的问题分析与修复建议同样不能推导为自动把异常写入训练集。
这些工具分别帮助观察运行、组织训练和构建数据界面。把它们组合起来的价值,取决于团队是否记录样本选择、评测范围、资源权限和发布决定。作者建议先确定哪些结果足以触发人工复核,再设计自动化;不以工具数量、团队人数或一份漂亮的数据流图代替真实验证。
Engine v2 智能治理层:用证据辅助 AI 工程师
Engine v2 的位置:生命周期之上的"另一个工程师"
2026-09-24 的 Engine v2 公告介绍基于生产 traces 发现问题、提出经测试的修复建议,并由人审核的方向。当前 Engine 文档还描述按配置分析 traces、利用反馈整理优先级与提出 PR 或数据集示例。本文不把这些能力解释成固定订阅 Trace/Evaluation/Deploy 三类事件总线,也不承诺任意指标越线就自动诊断、部署、回滚或写 runbook。人的发布决定仍是边界。
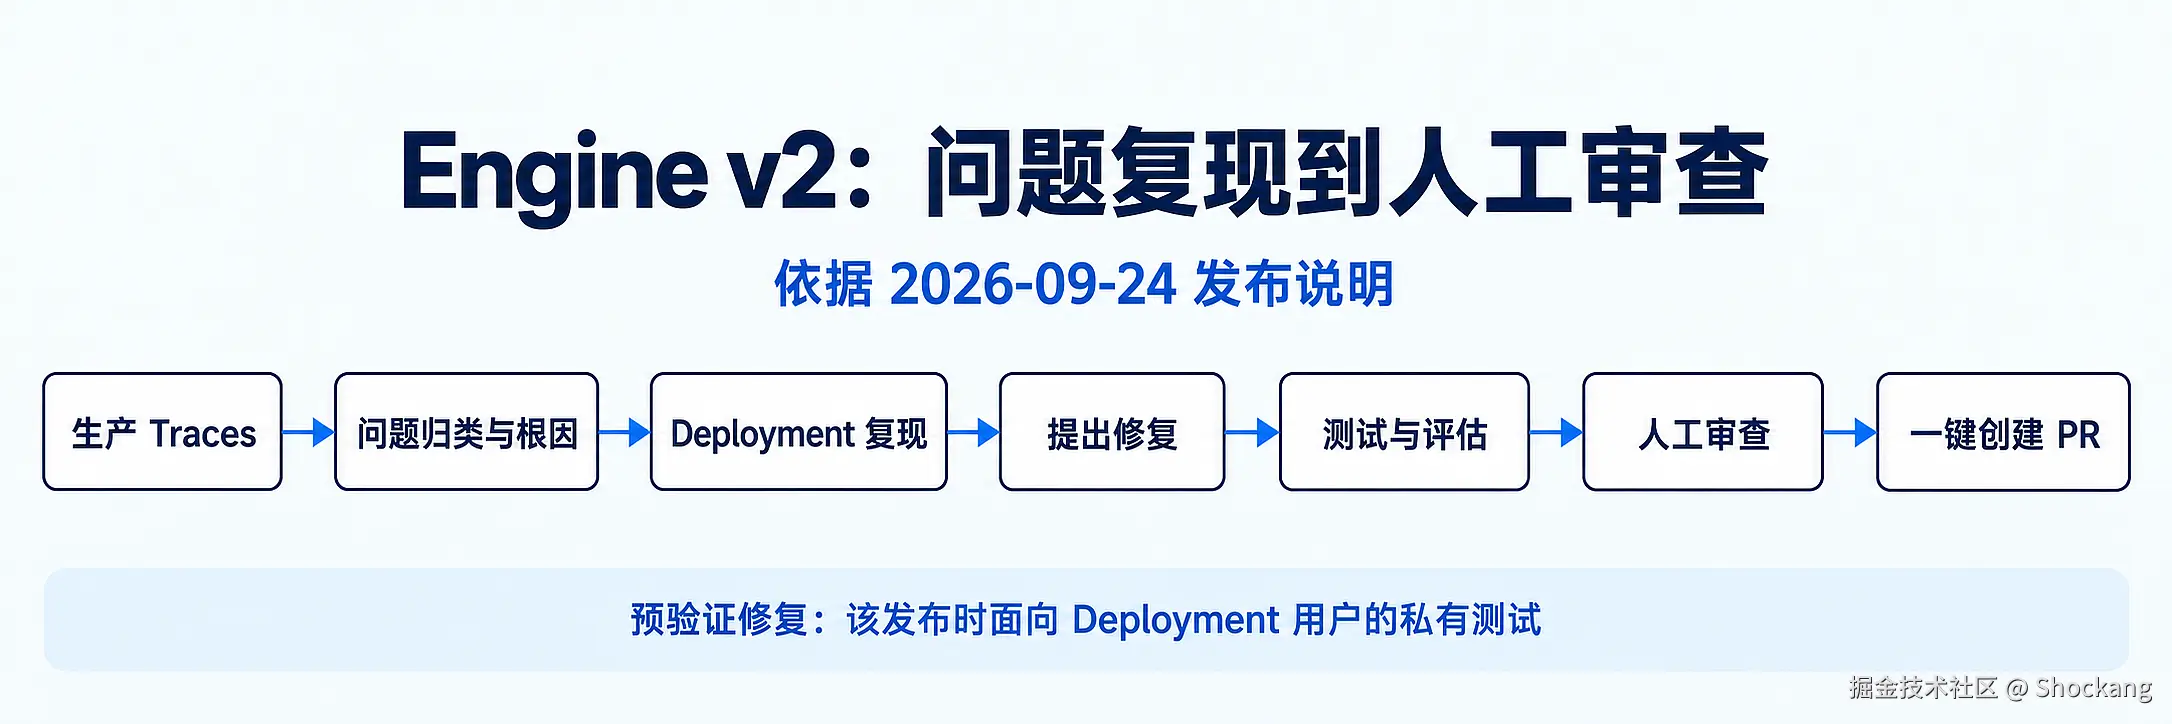
Gateway 与 Engine 可以分别帮助调用前的流量控制和调用后的问题改进,但它们不组成无需人工判断的"自愈"承诺。经过 Gateway 的模型请求按实际配置受控;Engine 对问题和修复提供辅助;测试范围、PR 审阅与是否上线仍由团队确认。某个修复在特定 trace 回放中通过,也不等于它对所有生产输入和权限场景都正确。
主动测试修复:从识别到提交完整证据
按当前文档,可将修复验证理解为下面的有限流程。自动验证是受限的 private beta,需要相应的 LangSmith Cloud 组织与 Cloud deployment 条件;不能当作任意自托管环境默认开放的能力:
- 识别问题:从生产 traces 和反馈中整理需要处理的问题与关联执行。
- 建立基线:选择问题关联 traces,在 baseline deployment 上回放并记录实验。
- 提出修复:准备候选变更及对应 preview deployment,保留问题和版本关系。
- 比较回放:对相同关联 traces 比较基线与候选修复实验;结论限定在实际样本。
- 人工审核:由人检查 PR、实验结果和风险,决定是否合并或部署;不自动写生产状态。
下面是本文步骤示意,不是 SDK、CLI 或可执行脚本,未执行。真实接入应使用当前 Engine 文档描述的产品界面与启用条件;图中的操作名称不代表存在同名 Python 方法或全量历史回放接口。
text
问题与关联 traces
    → baseline deployment 回放实验
    → 候选变更与 preview deployment 回放实验
    → 比较实际样本中的结果和风险
    → 人工审核 PR 与上线决定
# private beta / 已启用 LangSmith Cloud 条件依当前文档
# 不包含自动 merge、deploy、rollback 或 runbook 改写
工程师可以把部分注意力从手工整理问题移到审阅问题与候选变更,但仍需确认问题是否成立、样本是否覆盖风险,以及修改是否需要额外权限或业务批准。Engine 的建议并不替代这些判断。
PR 附带基线与候选实验链接、复现范围和人工结论,有助于追溯;这些是本文建议的评审材料,不是官方规定的 replay+eval+Guardrail 三项不可分割附件合同。无法复现的问题应明确标记证据范围,不用补写一个"通过"来完成流程。
Red Teaming:把对抗性输入当作治理起点
当前 Red Teaming 文档描述的是需要显式启动的 private-beta 测试,面向已启用的 LangSmith Cloud 组织和 Cloud deployments。它通过探测目标 Agent 寻找问题,结果记录在 red-team report 中;并非 Engine 一上线就无条件自动启动。具体探测范围应按当前文档和项目配置核对。
这一运行不会自动写入 Engine issues、datasets、evaluators 或 feedback。团队可以在审阅报告后,另外设计人工筛选、去敏和整理用例的步骤,但不能把"报告里有合成输入"当成"首批评测数据集已经自动创建"。对没有生产 traces 的新 Agent,作者建议明确初始用例从何而来、谁确认期望行为;后续入库与治理是独立的工作流和授权。
规模数字与自托管路径
衡量 Engine 使用效果,应区分扫描量、经确认的问题数、修复建议接受率与实际生产结果。采用效果需要团队自己的统计与可追溯依据,不能仅凭一组未说明口径的规模数字判断。统计若要使用,应注明来源、截止日期和口径;体量不能证明任意具体问题已被修复。
自托管 BYOK 的时间口径也要区分:2026-09-24 公告将其放在路线图中,而当前 self-hosted/BYOC 提供方配置文档已经描述使用保存凭据或配置的 workload identity 选择客户推理供应商。不能因旧公告就说今天不可用;同样不能声称 Engine 不处理 trace 原文、不持有任何凭据,或只向 VPC 外发送 diff。安全文档说明推理会处理任务内容,向所选供应商发送的内容受客户与该供应商协议及部署配置约束。
人工 review 与 Engine v2 辅助闭环
自动化可以减少部分问题整理和实验操作,但不能在没有对照数据时保证"分钟修复"或数量级提升。本文按责任比较两种方式:
| 治理动作 | 主要由人组织 | Engine 可辅助的部分 | 取舍边界 |
|---|---|---|---|
| 异常发现 | 查看 traces、反馈与告警 | 按配置整理生产 traces 中的问题 | 确认误报与证据范围 |
| 复现问题 | 选择样本与复现环境 | 受限 beta 中回放问题关联 traces | Cloud/启用条件与样本覆盖 |
| 修复验证 | 设计测试与判断业务风险 | 比较基线与候选 preview 实验 | 不保证全量历史 eval 都覆盖 |
| 提交 PR | 解释变更并审核权限 | 提出修复与实验相关材料 | 合并和上线仍经人工决定 |
| 时间到修复 | 受问题与协作条件影响 | 应记录实际任务耗时 | 不提供普遍时限或事故降级保证 |
人工 review 对业务策略、权限变化和无法复现的问题尤其重要。对可复现任务,Engine 的建议和回放材料可以帮助工程师判断;它们仍不证明修复已经对所有用户生效。作者建议将误报、拒绝建议、补充测试和最终接受结果都纳入改进记录。
把这些章节落到一次验收,可以按下面的顺序走:
- 选一条多步骤任务,画出模型、工具和状态的实际经过路径,给每个控制点指定负责人。
- 先运行上面的离线额度用例,确认等号、超限、非法数值和业务键分组的预期;再补持久化、并发与重试用例。
- 在自己的授权测试环境核对实际模型标识、策略对象、用量归属与触限响应,把应用账本与平台记录对照。
- 对工具失败与任务中断分别演练,保存副作用和检查点结果;沿会话视图回到具体 run,记录人工判断的目标。
- 选择经复核的失败样本比较基线与候选变更,最后由负责人确认权限、证据范围及是否发布。
Governed Agents 在本文中是一种工程目标:让执行边界、反馈和发布责任可追溯。先把一条任务链的边界测清,再扩大样本、并发和接入范围;Gateway、可观测性、训练工具和 Engine 的价值,最终要由这些可复核的结果和明确的发布决定来体现。
参考来源
以下为产品能力与实现细节的一手参考。代码旁已区分离线可运行实验、SDK 调用示例与架构伪代码。
官方与一手资料
- Runtimes, frameworks, and harnesses:docs.langchain.com/oss/python/...
- Deep Agents overview:docs.langchain.com/oss/python/...
- Persistence:docs.langchain.com/oss/python/...
- Managed Deep Agents:docs.langchain.com/langsmith/p...
- Add custom middleware to Managed Deep Agents:docs.langchain.com/langsmith/p...
- Add identity to Managed Deep Agents:docs.langchain.com/langsmith/p...
- Manage connections:docs.langchain.com/langsmith/p...
- LLM Gateway:docs.langchain.com/langsmith/l...
- LangSmith LLM Gateway product page:www.langchain.com/langsmith/l...
- LangSmith LLM Gateway: runtime governance built into the agent lifecycle:www.langchain.com/blog/introd... 2026-05-13
- Trajectories now in LangSmith: A readable view of every agent session:www.langchain.com/blog/langsm... 2026-09-24
- We built SmithDB, the data layer for agent observability:www.langchain.com/blog/introd... 2026-05-13
- Fine-tune models with Smithtune:docs.langchain.com/langsmith/s...
- LangSmith Post-Training CLI official repository:github.com/langchain-a...
- Introducing LangSmith Custom Apps:www.langchain.com/blog/langsm... 2026-09-24
- LangSmith Engine v2: Red teaming and automated testing:www.langchain.com/blog/langsm... 2026-09-24
- LangSmith Engine:docs.langchain.com/langsmith/e...
- Validate fixes automatically:docs.langchain.com/langsmith/e...
- Proactively identify issues with Red Teaming:docs.langchain.com/langsmith/e...
- Configure model providers for Engine on self-hosted and BYOC:docs.langchain.com/langsmith/e...
- LangSmith Engine security:docs.langchain.com/langsmith/e...
- Client.create_feedback API reference:reference.langchain.com/python/lang...
- Building Prod with Jev and LangGraph:www.langchain.com/blog/buildi... 2026-09-25
- Python Decimal 标准库文档:docs.python.org/3/library/d...