DeepSeek 又偷偷升级了:我实测了 V4.1-Flash-1017,一句话生成可玩游戏,但有个坑会吃掉你 90% 的预算
结论先放前面。 这次升级是真的,但不是全面变强,是"更会用工具、更少废话"。基础代码能力没退化,长上下文和多模态稳,许愿式编程确实能跑通。代价是------它会把大量 token 烧在思考上,你不给足输出预算,代码会在第 1738 个 token 处被硬生生截断。
一、没有发布会,周六傍晚直接上架
10 月 17 日 18:07,DeepSeek 把 V4.1 Flash 更新到了 V4.1-Flash-1017。网页端、App、API 三端同步切换,没有发布会,没有预热,只有一个版本号。
API 名字没变,还是 deepseek-flash。价格也没变:峰时输入 0.30/输出1.20 每百万 tokens,谷时减半。换句话说,你什么都没做,模型已经被换掉了。
官方的说法是"性能---费用的帕累托改进":分数涨了,任务运行时间和输出长度反而降了。
从官方模型卡看,涨幅确实是系统性的:
| 基准测试 | 1017 | 上一版 | 变化 |
|---|---|---|---|
| Terminal-Bench 4.0 | 42.3 | 31.2 | +11.1 |
| ProgramBench | 29.1 | 20.3 | +8.8 |
| Apex Bench v1.1 | 72.1 | 64.6 | +7.5 |
| Automation-Bench v1.0.6 | 60.5 | 54.8 | +5.7 |
| HLE(无工具) | 42.6 | 36.8 | +5.8 |
| Agents' Last Exam | 35.4 | 31.8 | +3.6 |
| DeepSWE v1.1 | 77.0 | 74.2 | +2.8 |
| NL2Repo-Bench | 68.2 | 65.4 | +2.8 |
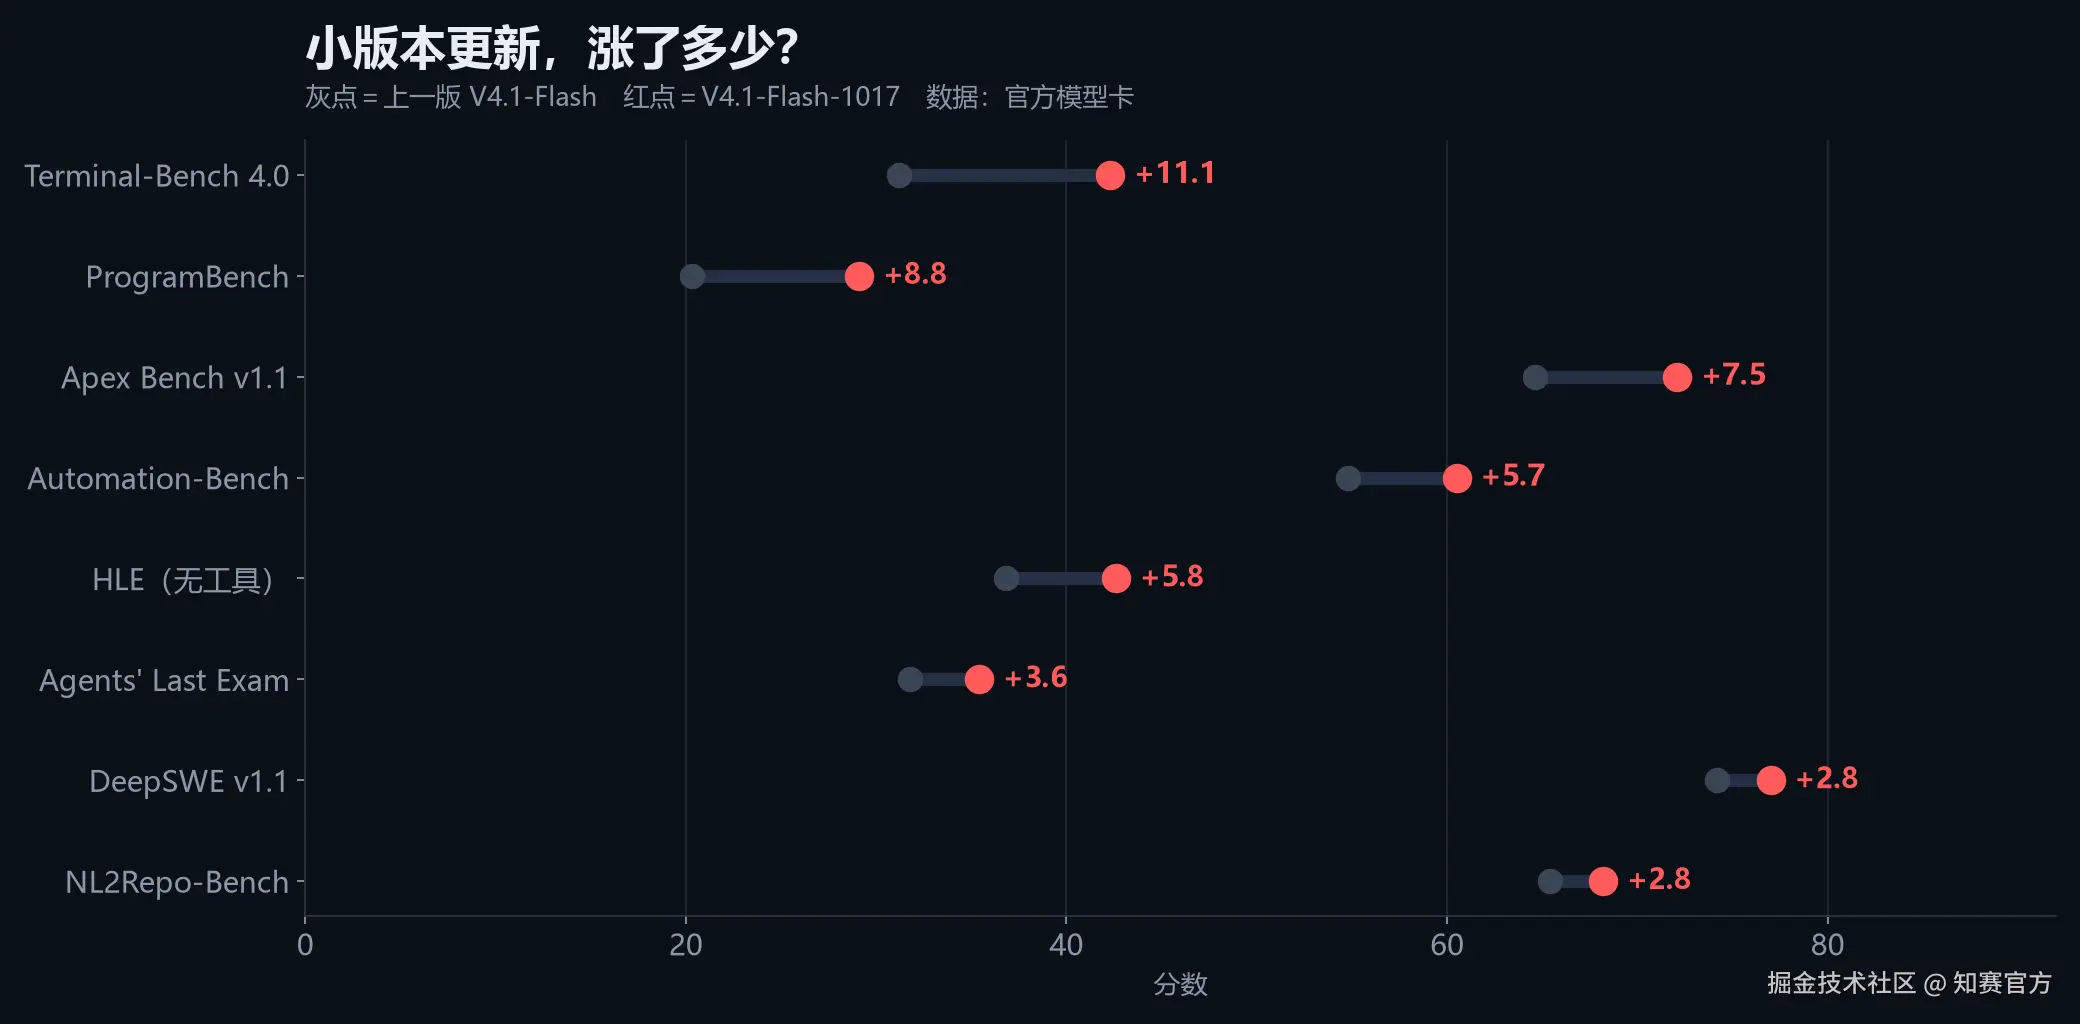 注意两件事。
第一,这些全是 DeepSeek 自报,用自己选的 harness 跑的,没有第三方复核。Terminal-Bench 4.0 用的是 Claude Code 的框架,DeepSWE 用的是 mini-swe-v2。换个框架,数字会变。
第二,它在部分项目上确实超过了 Claude Opus 5(DeepSWE 77.0 vs 74.0、Automation-Bench 60.5 vs 50.3),但在 Terminal-Bench 4.0(42.3 vs 51.8)、ProgramBench(29.1 vs 37.0)、HLE(42.6 vs 56.3)上还差得远。所谓"超越旗舰",是挑着项目说的。
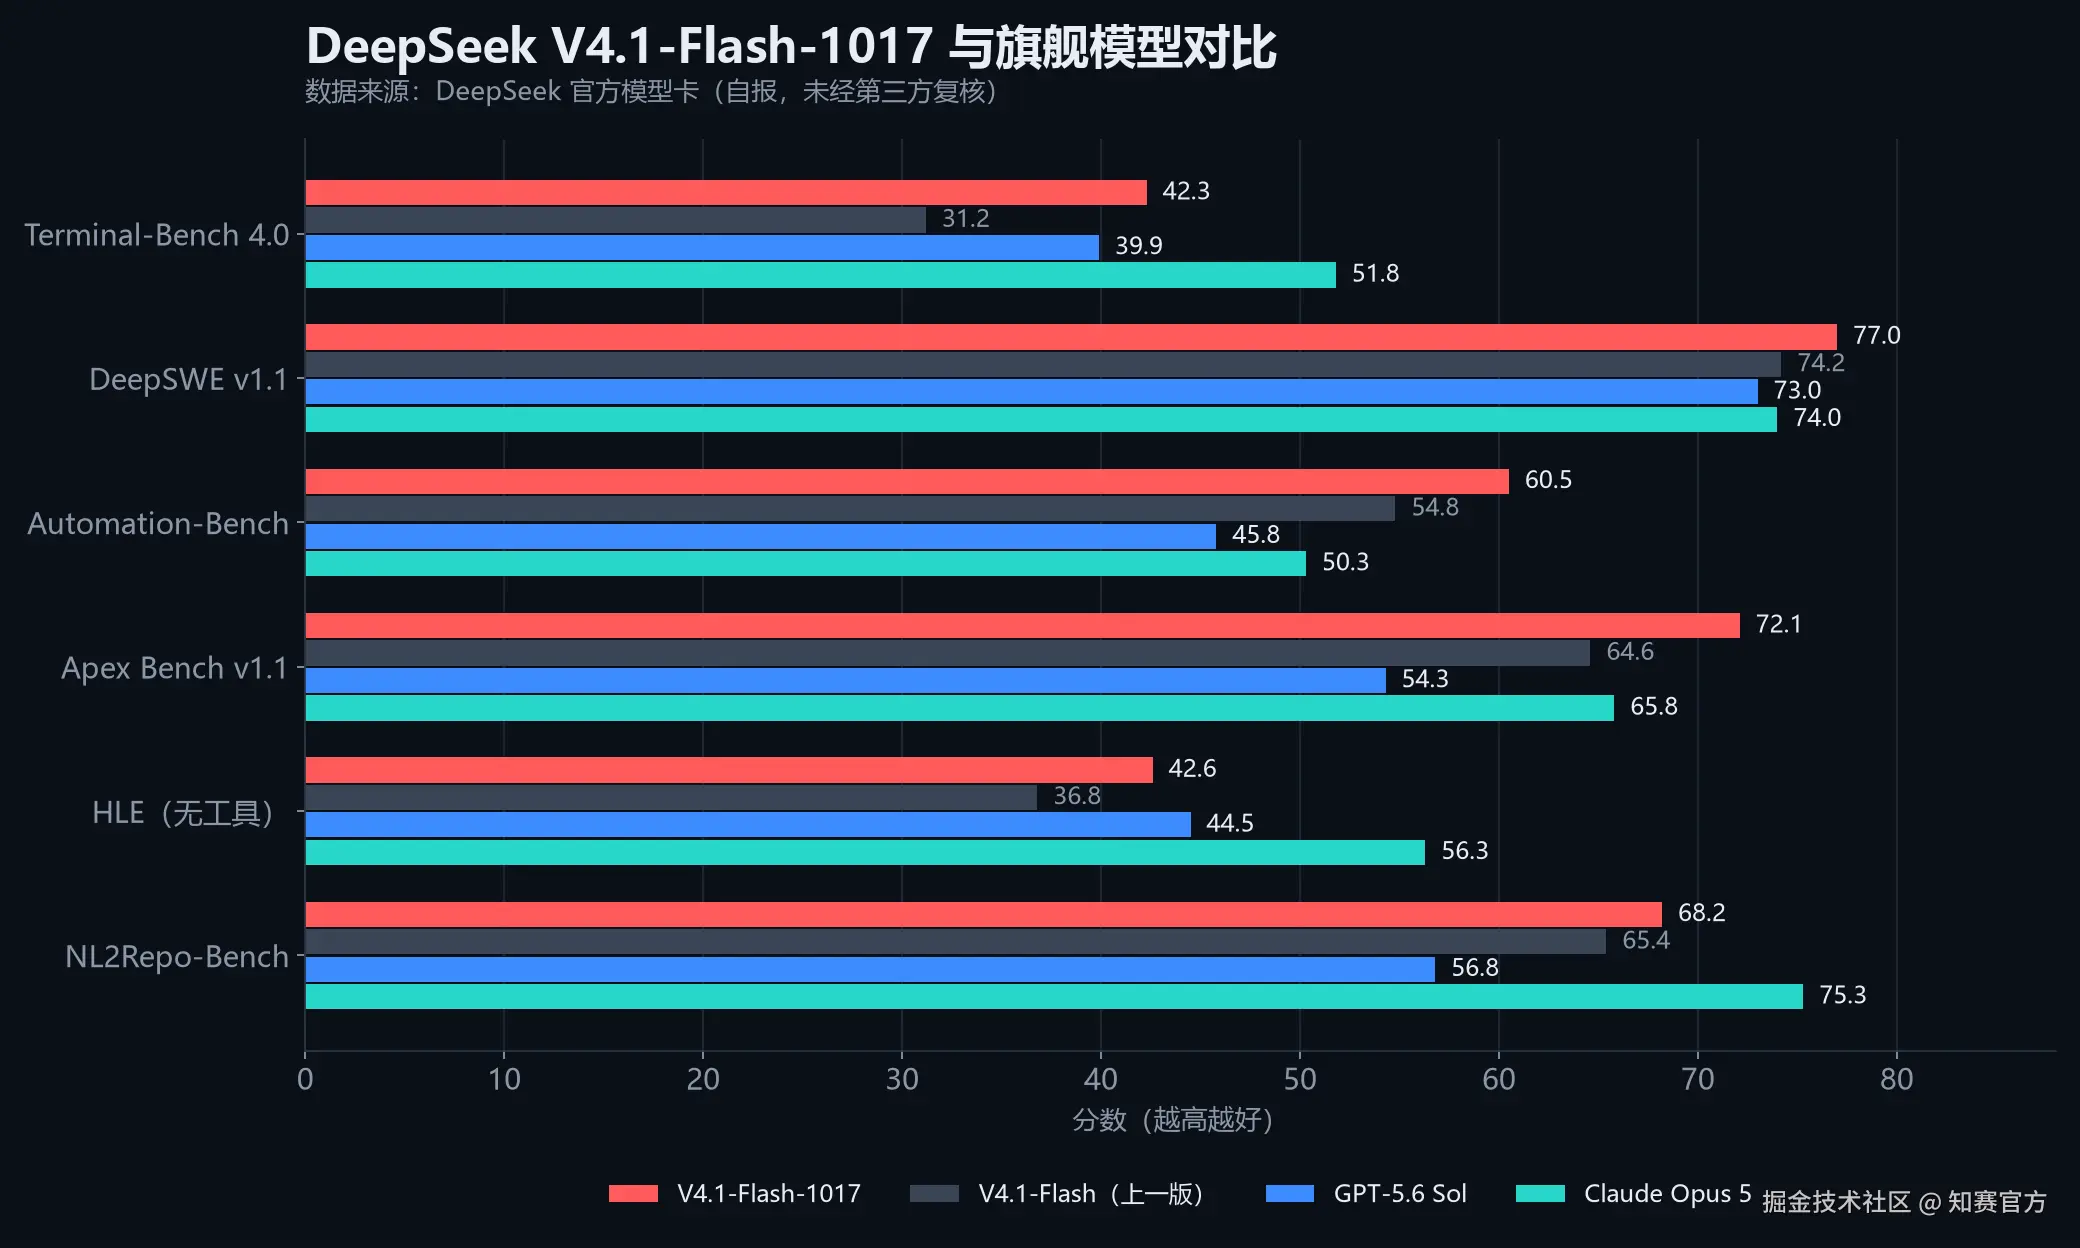 DeepSeek V4.1-Flash-1017与旗舰模型对比
二、我的测试环境(先说清楚,免得你误解)
所有测试跑在本地机器上,通过一个本地网关调用 cn:deepseek-v4.1-flash。官方在 10 月 17 日已把 API 全量切到 1017,所以这个通道拿到的应该是新版本------但我要诚实说明:响应体里没有版本号字段,我无法从技术层面 100% 确认。
对照组是 cn:deepseek-v4-pro,同网关、同参数、同温度。
测试条件:
- 推理档位统一
high,温度 0.1--0.3 - 单机单请求,没有做并发压测
- 长上下文只压到约 7 万 token,没压到官方标称的 100 万极限
- 计费字段是网关返回的 credit,不等于官方人民币账单,我只用它做相对比较
一句话:这是一次单机、可复现、有明确边界的实测。不是大规模基准。
三、实测一:一句话让它写个游戏,它真写出来了
这是这次更新最核心的卖点,官方叫"许愿式编程"。
我给的提示词很短,一共 6 条要求:
单文件 HTML 打砖块游戏,canvas 实现。方向键和鼠标都能控制挡板,空格发射,砖块有不同分值,清空进入下一关且球速递增,显示得分/关卡/生命,P 键暂停。不引用任何外部资源。只输出 HTML。
它一次生成,16,735 字节,纯手写 canvas,没有任何外部依赖。
然后用无头浏览器真的打开跑:
- Canvas 800×600,绘制区域非空率 100%
- 控制台 0 条报错
- 按空格发射、按方向键移动后,球在飞、砖块被打掉、得分从 0 涨到 120
- 配色、圆角、粒子效果、底部操作提示,全都有
截图在这里------右侧那排缺口就是被球打掉的砖块,右下角是响应了方向键的挡板:
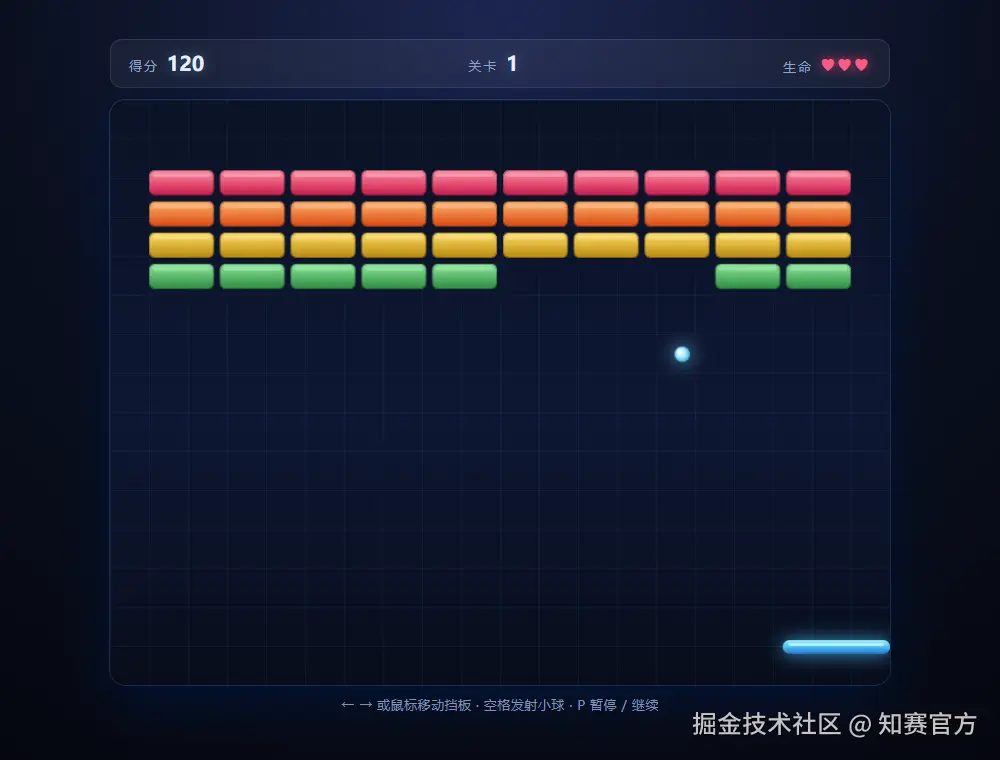 整个过程耗时 71.7 秒,消耗 21,333 tokens,其中 15,349 是思考。
同一个 prompt 我也丢给了 V4-Pro,它也能跑通,但差距一眼能看出来:
| Flash-1017 | V4-Pro | |
|---|---|---|
| 生成体积 | 16,735 字节 | 9,906 字节 |
| 耗时 | 71.7 s | 118.3 s |
| 计费(credit) | 1.22 | 6.29 |
| 控制台报错 | 0 | 0 |
| 视觉 | 圆角砖块、发光球、粒子、底部操作提示 | 纯色方块、无圆角、无提示 |
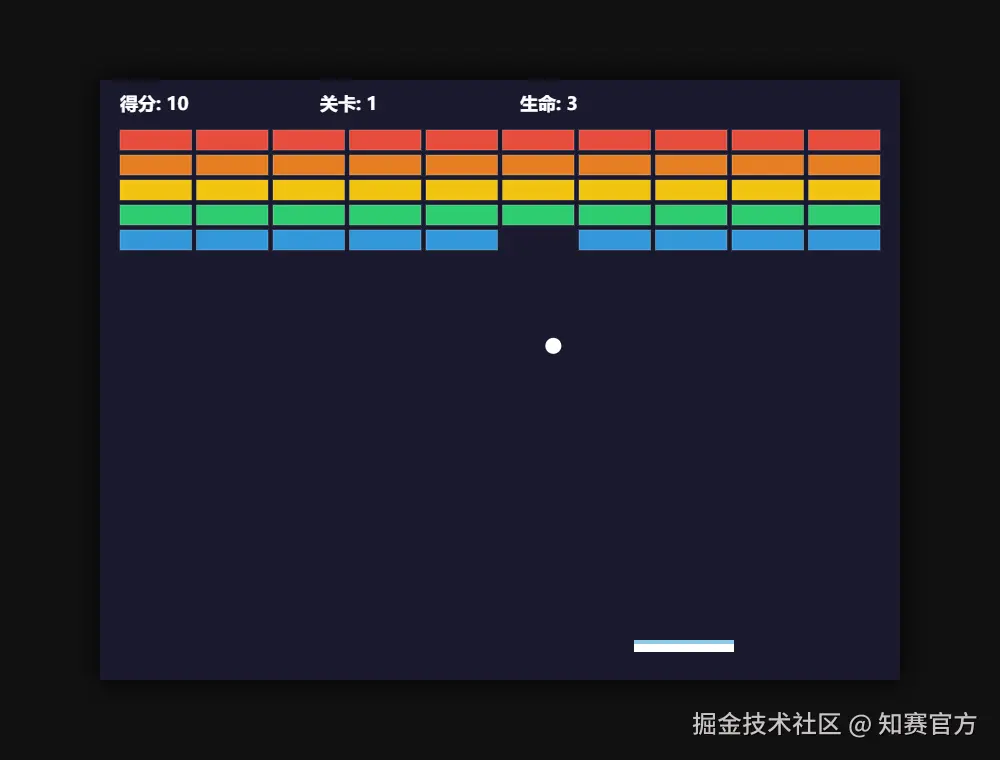 Pro 版本能玩,得分能涨,砖块能消,但长得像 2010 年的教学 demo;Flash 版本直接是个能截图发朋友圈的产品。
同样一句"许愿",Flash 交得更快、更便宜、还更好看。
这个结果说明什么?
说明"单 prompt 出一个能玩的小游戏"这件事,对 Flash 档位已经成立了。不是 demo 级别的成立,是你打开浏览器就能玩的那种成立。而且它不是在"能跑"这条及格线上勉强通过------它是把 UI、动效、提示都做全了。
但注意那个 15,349。
四、那个吃掉 90% 预算的坑
第一次跑这个测试,我给的输出上限是 16,000 tokens。
结果:14,262 个 token 花在 reasoning 上,只剩 1,738 个 token 写代码。HTML 写到 4,771 字节就被截断了,页面打开一片空白,canvas 是默认的 300×150,什么都没画。
finish_reason: length。
这不是模型的错,是我预算给少了。但这是一个非常容易踩的坑:
在 high/max 推理档下做代码生成,实际可用输出预算大约只有你设定值的 10%--15%。
社区里说的"别用 max,想得越多幻觉越多",在我这里得到了另一种印证------不是幻觉变多,是思考把预算吃光了,交付物直接断在半截。
改成 48,000 上限之后,同样的 prompt,同样的模型,21,333 tokens 输出、finish_reason: stop、代码完整、游戏可玩。
实操建议:做代码生成或 Agent 任务,max_tokens 至少给 32,000,别按"我只要 500 行代码"去估。
五、实测二:基础能力没有退化
上一版 V4.1 Flash 被骂得最狠的是"变笨"。这一版至少在基础项上是稳的。
代码正确性:15 个隐藏单测,全过。
三道题:区间合并(6 个用例,含相邻、包含、空输入)、频率 Top-K(5 个用例,含并列排序)、订单结算(4 个用例,含不足 3 笔、同金额字典序)。Flash 15/15,Pro 15/15。
多轮 Bug 修复:一轮通过。
给一个有 3 个 bug 的 parse_size 函数(s[:-2] 切错单位、'3 KB' 带空格崩、单位大小写),7 个用例全挂。Flash 看完失败信息,一次改对,7/7。Pro 也是 7/7。
指令遵循:全过,但风格差异极大。
严格 JSON 输出(4 字段、枚举、20 字摘要、3 个不含数字的关键词、严格以 { 开头 } 结尾):
- Flash:353 tokens 完成,一次过
- Pro:800 tokens 全烧在思考上,正文一个字没出 (
finish_reason: length)。给到 4,000 上限后才交付,用了 1,096 tokens
同一道题,Flash 用三分之一的量交卷,Pro 想了三轮才动笔。
否定约束测试(120 字内、禁用"非常/极致/领先"、必须含"实测"、结尾必须是问句):两个模型都 4/4 全过,Flash 写了 48 字,Pro 写了 66 字。
六、实测三:7 万字文档,4 个问题,全对
我造了一份 100,834 字符(约 69,540 tokens) 的内部周报汇编,800 期,埋了 4 个需要跨段检索的事实,其中 1 个是文档里根本不存在的信息,专门测幻觉。
四个问题:
| 问题 | 结果 |
|---|---|
| 服务器采购预算最终多少万? | ✅ 87.5 万元,第 47 期 |
| 王工离职后交接给谁? | ✅ 李工,第 138 期 |
| 数据库主从切换失败的根因? | ✅ DNS TTL 3600 秒,第 613 期 |
| 客户 B 的年度合同金额? | ✅ 明确回答"文档未提及" |
4/4,零幻觉。
更值得注意的是速度:4 次调用总共 23 秒,单次 7 万 token 的检索问答大约 5 秒。这个 prefill 效率是这一代架构(KV Cache 压到 890 字节/token)真正兑现的地方。
局限也要说:我没压到 100 万 token。7 万 token 属于"长",不属于"极限"。官方标称的 1M 上下文在我这里没有被验证。
七、实测四:原生多模态,读数准确
生成一张四季度营收柱状图(Q1 1280、Q2 1640、Q3 1190、Q4 2050,Q4 用红色标注),直接以 base64 塞进去问三个问题:
- 哪个季度最高、数值多少 → Q4,2050 万元 ✅
- Q1 和 Q3 差多少 → 90 万元 ✅
- 最高值用什么颜色标注 → 红色 ✅
3/3。这是 9 月 V4.1 Flash 就把视觉原生训进主干的能力,1017 没退步。
Pro 这边没法比------deepseek-v4-pro 的 input_modalities 只有 text。
八、实测五:效率差距是数量级的
固定两个任务(写 500 字评测开头 / 从日志里归类 ERROR),各跑 2 次取均值。
| 指标 | V4.1-Flash-1017 | V4-Pro | 差距 |
|---|---|---|---|
| 写作 总耗时 | 9.16 s | 19.63 s | Flash 快 2.1 倍 |
| 写作 输出 tokens | 1,243 | 1,886 | Flash 少 34% |
| 写作 计费(credit) | 0.07 | 0.74 | Flash 省 10.6 倍 |
| 日志分析 总耗时 | 8.58 s | 15.47 s | Flash 快 1.8 倍 |
| 日志分析 计费 | 0.095 | 0.66 | Flash 省 6.9 倍 |
| 吞吐(tok/s) | 134--189 | 93--107 | Flash 高 40--80% |
首 token 延迟两者都在 1.5 秒左右,没有明显差别------瓶颈在网关和排队,不在模型。
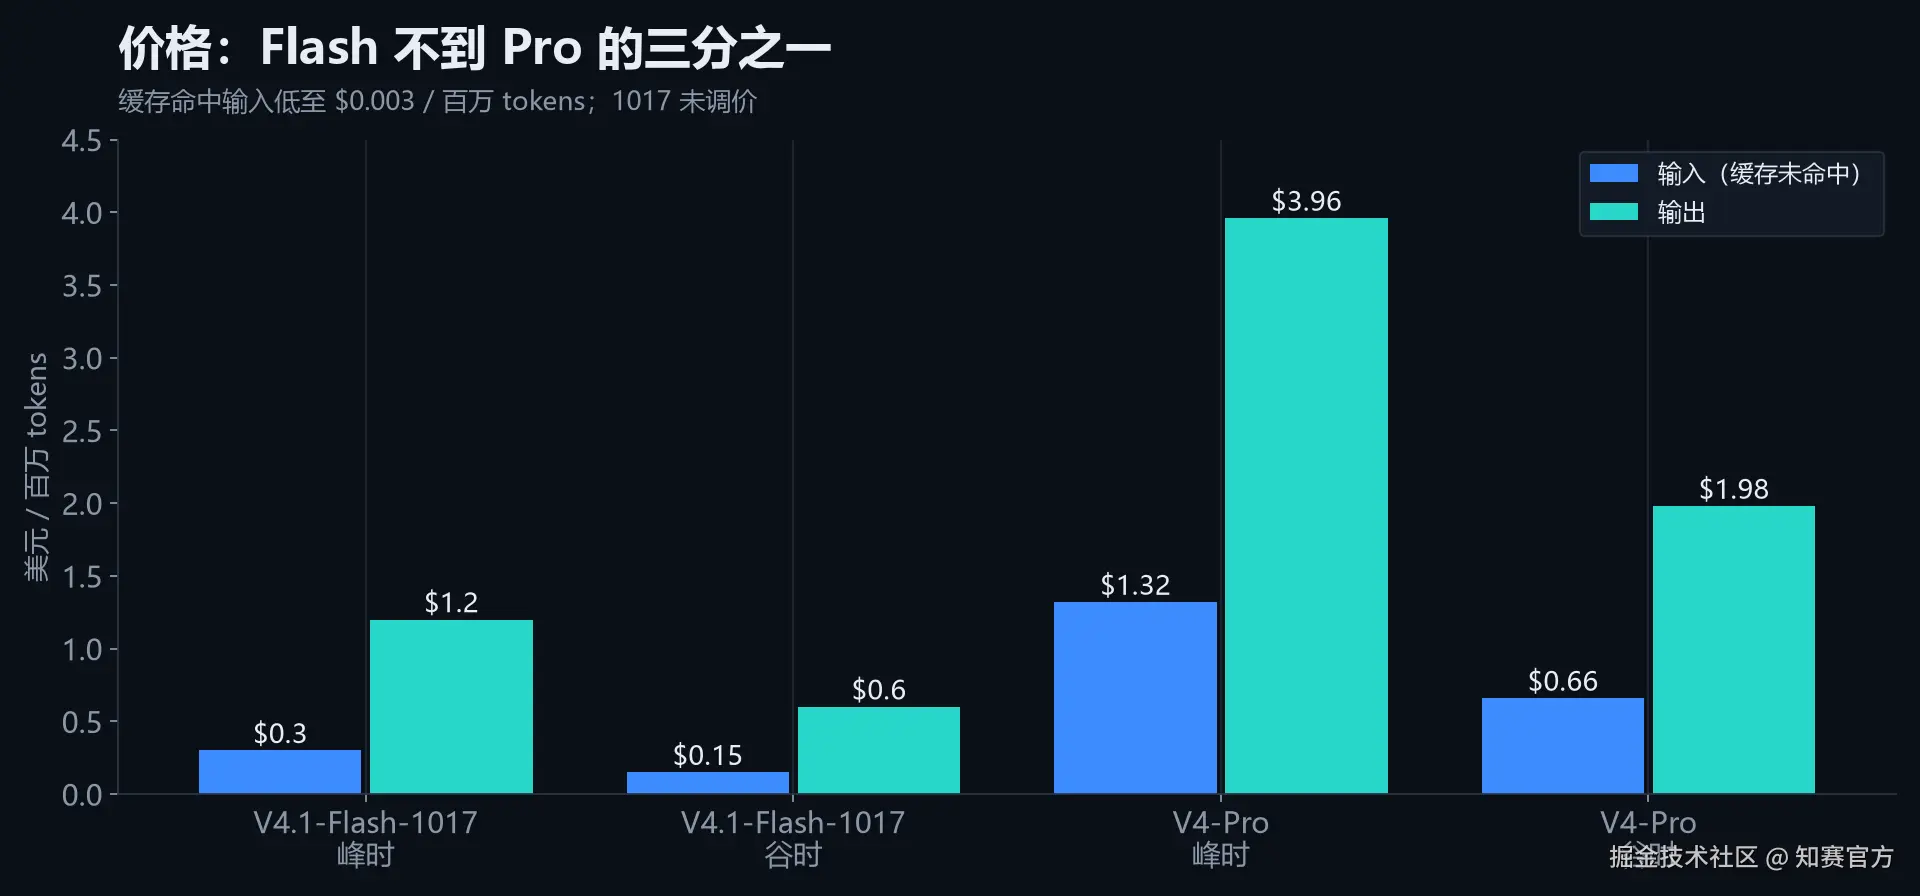 按官方价换算,写 500 字(输出约 1,200 tokens、输入 50 tokens)的理论成本是 ¥0.005,谷时。这个价位,你可以拿它做几乎所有"高频但不值钱"的活:批量改写、结构化抽取、日志归类、检索后处理。
但速度没到官方宣传的 300+ tok/s。 我测到的峰值 189 tok/s,均值 150 上下。原因很可能是单请求 + 网关排队,不是模型本身。这一点我必须说清楚:你看到的 tok/s,很大程度上取决于你走哪条通道。
九、最值得说的一件事:Pro 会编数据
这个发现比跑分有意思。
同一个"写 500 字评测开头"的 prompt,Pro 输出更长(772 字 vs Flash 的 599 字),看起来更专业。但它写了这么一段:
"代码补全用 120 个内部 Python/TypeScript 片段,通过率 81%,比 V4 标准版低 6 个百分点;但首 token 延迟中位数 180ms,P95 210ms......32 并发压测时,这类错误率从单并发的 4% 升到 11%,可复现。"
它一个测试都没跑。这些数字全是编的。
而 Flash 在同一题下写的是:
"这次评测会围绕真实开发场景展开:代码补全与 diff 生成、函数调用参数合法性、JSON 结构化输出、长上下文检索......我们不会只报平均延迟,而会看 P50、P95 和超时率。"
它描述方法,不编结果。
这不是说 Flash 更聪明。这是说:输出更长、语气更自信,和"更可信"是两件事。 你让模型写"评测",它很容易给你一篇看起来很专业的假报告。要数字,就得自己跑。
十、怎么用,怎么别踩坑
值得用的场景:
- 高频、短路径、对成本敏感的调用:结构化抽取、批量改写、日志归类、检索后处理
- 单 prompt 出原型:小游戏、单页工具、演示页面,一次能出可运行的版本
- 长文档检索:7 万 token 级别,5 秒出答案,4/4 准确率
- 带图的任务:图表读数、截图理解,原生支持,Pro 反而不行
别指望它的场景:
- 高难度终端任务、超长链路 Agent(Terminal-Bench 42.3 对比 Opus 5 的 51.8,差距是实打实的)
- 需要严格一次成型的大型重构
- 任何你不打算复核数字的"分析报告"------它会编
三条实操建议:
max_tokens给足。 代码生成至少 32,000,否则思考会把预算吃光,交付物截断。- 结构化输出必须自己校验。 别信"它说它输出了 JSON",
json.loads失败就是失败。 - 要数字,自己跑。 模型写的评测数据,一律当虚构处理。
附:复现方式
测试脚本、原始响应、生成物都在项目目录里:
bash
deepseek-v41-1017-review/
├── eval/           # 6 组测试脚本,可直接跑
├── data/           # 原始 JSON 响应与判分结果
├── assets/         # 图表、生成的游戏、截图
└── video/          # 评测视频
复现只需要改一个环境变量,指向你自己的端点:
bash
export DS_BASE="http://你的端点/v1/chat/completions"
export DS_KEY="你的 key"
python eval/test_basics.py
代码题、Bug 修复、长上下文、多模态、效率对比都能独立跑,不依赖特定平台。
一句话总结:
V4.1-Flash-1017 是一次扎实的工程迭代------它把"少说废话、多干活"做进了模型里,价格没涨,能力有涨。但它不是全能选手,而且它比上一代更愿意把预算花在思考上。给足空间,它很好用;按老习惯卡着 token 上限,你会收到半截代码。
测试时间:2026 年 10 月 17 日--18 日 测试模型:V4.1-Flash-1017(对照组 V4-Pro) 单机单请求,未做并发压测,长上下文未压至 1M 极限
信息来源
官方
- DeepSeek 官方公告(V4.1-Flash 发布):www.deepseek.com/zh/news/dee...
- DeepSeek API 文档(1017 更新说明):api-docs.deepseek.com/news/news10...
- 模型权重与技术报告:huggingface.co/deepseek-ai...
媒体报道
- 澎湃新闻《"许愿式"编程能力升级!DeepSeek 上新:开放自研搜索 API,千次调用仅 5 元》:www.thepaper.cn/newsDetail_...
- 中国证券网《DeepSeek 新模型:更聪明,还更省钱》:www.cnstock.com/commonDetai...
说明:官方基准数据均为 DeepSeek 自报,未经第三方独立复核;本文的实测数据为本地单机结果,测试脚本与原始响应已保留。