一、引言
离线数仓治理解决的是"数据是否规范、口径是否统一、结果是否可信"的问题,但在实时数仓中,治理难度被进一步放大:数据持续到达、事件可能乱序、任务可能失败重启、指标需要秒级更新,任何一个环节处理不当,都可能导致"快但不准、准但不可追"。
Kafka 将事件流定义为实时捕获、存储、处理、回放和路由事件的实践,Kafka 本身提供发布订阅、持久存储和流处理能力,并强调事件可以被持久保存、反复读取。这意味着实时链路并不是"数据过了就没了",而是可以围绕事件日志建立可追溯治理体系。
实时治理的核心目标可以概括为三句话:
| 目标 | 离线场景 | 实时场景 |
|---|---|---|
| 准确 | 批量校验、重跑修复 | 乱序、迟到、重复、失败恢复下仍保持正确 |
| 及时 | T+1、小时级 | 秒级、分钟级 |
| 可追 | 查批次、查分区、查任务日志 | 查事件、查 offset、查 checkpoint、查水位、查旁路 |
实时数仓的难点不在于"算得快",而在于"快的同时还能解释为什么是这个结果"。
二、实时治理架构总览
一个典型的实时数据治理链路如下:
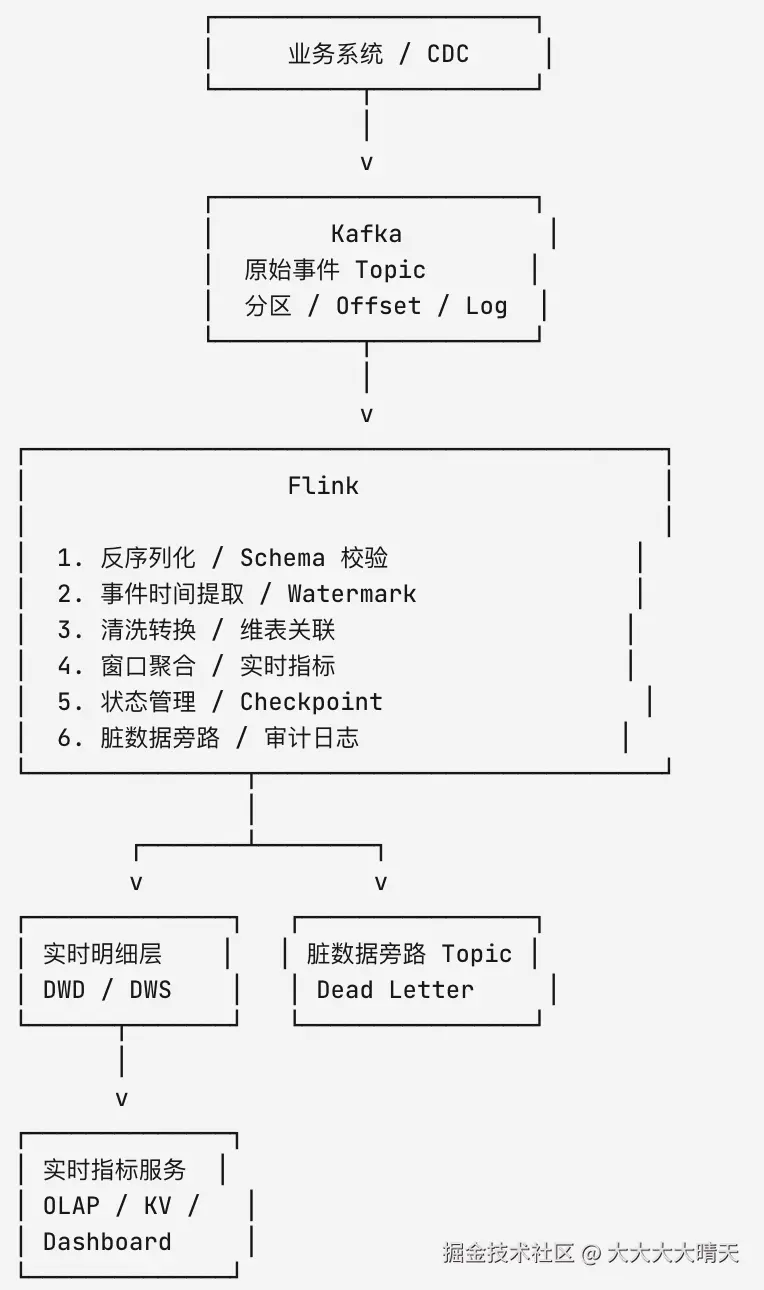
这条链路中,Kafka 负责提供可回放、可分区、可追溯的事件日志;Flink 负责在事件时间语义下完成状态计算、窗口计算和容错恢复。事件时间处理基于事件自身携带的时间戳,而非机器处理时间,因此在处理乱序、迟到或历史回放数据时,可以得到更一致的结果。
三、Kafka 治理:实时链路的事实日志
Kafka 在实时治理中的角色,不只是一个消息队列,而是实时链路的"事实日志"。事件写入 Kafka 后,会被组织到 topic 中,并按 partition 存储;相同 key 的事件会进入同一分区,Kafka 保证消费者读取某个 topic-partition 时,会按照写入顺序读取该分区内事件。因此,Kafka 层治理重点不是"只要能消费就行",而是要治理以下几个对象:
| 治理对象 | 关键问题 | 工程手段 |
|---|---|---|
| Topic | 是否按业务域、数据层级、生命周期命名 | 命名规范、分层 topic、权限控制 |
| Partition | 是否支撑吞吐与 key 局部有序 | 合理分区数、稳定分区键 |
| Offset | 是否能定位消费进度 | 消费组监控、offset 审计 |
| Schema | 数据结构是否可演进 | Schema Registry 或兼容性检查 |
| Retention | 是否能支撑回放与追溯 | 按 SLA 设置保留周期 |
| Header / Metadata | 是否能追踪来源 | 写入 trace_id、source、event_time |
一个建议的 Topic 分层如下:
ods_order_raw
   │
   │ 原始事件,尽量不改字段,只补采集元信息
   v
dwd_order_clean
   │
   │ 清洗、类型转换、脏数据剔除、维度补齐
   v
dws_order_window_1min
   │
   │ 窗口聚合、实时指标中间层
   v
ads_order_realtime_metric
   │
   │ 面向看板、告警、接口服务
实时治理中,原始层 topic 尽量保持"原貌可回放",不要在最早阶段就丢弃无法解析的数据。否则一旦后续发现规则错误,就失去了修复和追责依据。
四、Flink 治理:让流计算可恢复、可解释
Flink 的核心优势在于有状态流处理、事件时间、水位线、checkpoint 和端到端一致性,Flink 的 checkpoint 机制会保存状态和流中位置,使应用在恢复后可以获得与无故障执行相同的语义。
Flink 任务中的治理对象通常包括:
| 治理对象 | 典型风险 | 治理方式 |
|---|---|---|
| Source | 消费重复、offset 不可追 | 记录 topic、partition、offset |
| Time | 处理时间与事件时间混用 | 统一事件时间语义 |
| Watermark | 水位过快丢数据,过慢增延迟 | 依据业务乱序分布配置 |
| State | 状态膨胀、恢复缓慢 | TTL、状态后端、checkpoint 调优 |
| Sink | 写出重复、事务不一致 | 幂等写、事务写、两阶段提交 |
| Metric | 指标口径漂移 | 指标定义中心、SQL 版本化 |
| Dirty Data | 解析失败直接丢弃 | 旁路 topic、错误码、原始载荷 |
Flink 任务不是一个"计算黑盒",而应该被治理为一条有输入、有状态、有输出、有审计的实时数据生产线。
五、实时指标:先治理口径,再治理延迟
实时指标治理最容易犯的错误,是只关注"延迟是否足够低",却忽视"指标口径是否稳定"。例如 GMV、支付订单数、活跃用户数这些指标,如果离线口径与实时口径不一致,那么秒级刷新只会放大错误。
实时指标至少需要定义以下内容:
ini
指标名称:pay_order_cnt_1min
业务含义:每 1 分钟支付成功订单数
事件时间:order_pay_time
统计口径:status = 'PAID'
去重键:order_id
窗口类型:TUMBLE 1 minute
迟到策略:允许迟到 5 minutes
输出模式:窗口关闭后输出,迟到修正单独输出
一致性要求:与离线 dwd_order_pay 表同口径
实时指标治理可以拆成四层:
| 层次 | 治理内容 | 目标 |
|---|---|---|
| 数据层 | 字段、类型、事件时间、主键 | 保证输入可信 |
| 计算层 | 窗口、去重、聚合、关联 | 保证算法稳定 |
| 口径层 | 过滤条件、业务状态、维度定义 | 保证业务一致 |
| 服务层 | 刷新频率、延迟、修正机制 | 保证使用可解释 |
实时指标不是"把 SQL 跑在流上"这么简单。它本质上是一套持续更新的物化视图,需要治理更新语义、状态边界和结果修正机制。
六、延迟水位:准确性与实时性的调节阀
Watermark 是实时治理中最关键、也最容易被误解的概念之一。Watermark 是流中携带时间戳t 的标记,表示该流的事件时间已经到达t ,通常意味着时间戳小于等于t 的事件不应再出现。
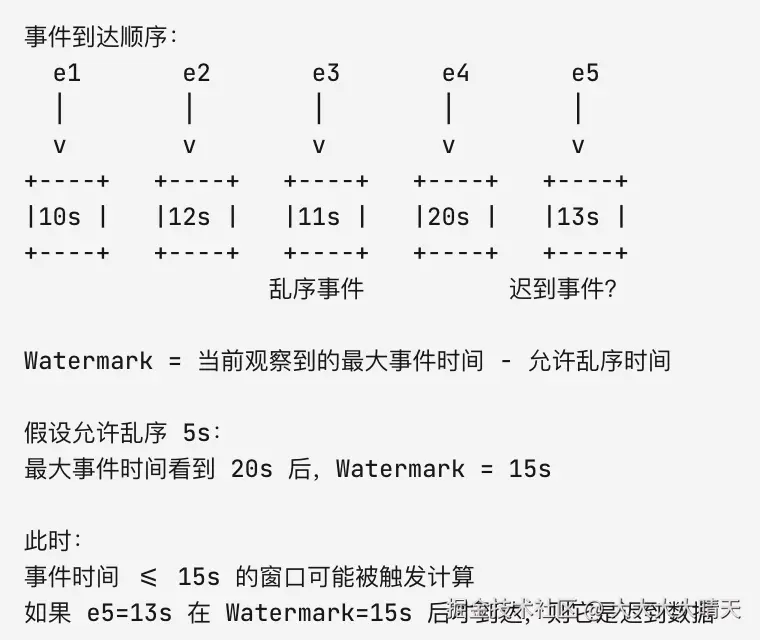
Watermark 本质上是在回答一个问题: 我愿意等多久,来换取更完整的数据?
允许乱序时间小
  │
  ├─ 优点:结果更快输出
  └─ 缺点:迟到数据更多,修正成本更高

允许乱序时间大
  │
  ├─ 优点:结果更完整,误差更小
  └─ 缺点:窗口关闭更晚,端到端延迟更高
Watermark 是在事件时间应用中权衡延迟与结果完整性的机制,因此,Watermark 不应该拍脑袋配置,而应该基于业务数据的乱序分布来确定,例如 P95、P99 到达延迟。
一个实践建议:
| 场景 | Watermark 策略 |
|---|---|
| 交易支付 | 保守一些,优先准确 |
| 用户行为看板 | 可激进一些,优先低延迟 |
| 风控告警 | 低延迟优先,但保留后续修正 |
| 财务结算 | 不建议只依赖实时结果,应以离线或最终一致层为准 |
七、脏数据旁路:不要让错误数据消失
实时任务中常见脏数据包括:
| 类型 | 示例 | 风险 |
|---|---|---|
| 格式错误 | JSON 解析失败 | 任务失败或数据丢失 |
| 类型错误 | amount = "abc" | 指标计算异常 |
| 枚举非法 | status = "UNKNOWN" | 业务口径污染 |
| 时间异常 | event_time 为空或未来时间 | 水位异常 |
| 主键缺失 | order_id 为空 | 无法去重 |
| 维表缺失 | user_id 无匹配维度 | 维度统计偏差 |
错误做法是直接filter 掉这些数据。正确做法是建立脏数据旁路:
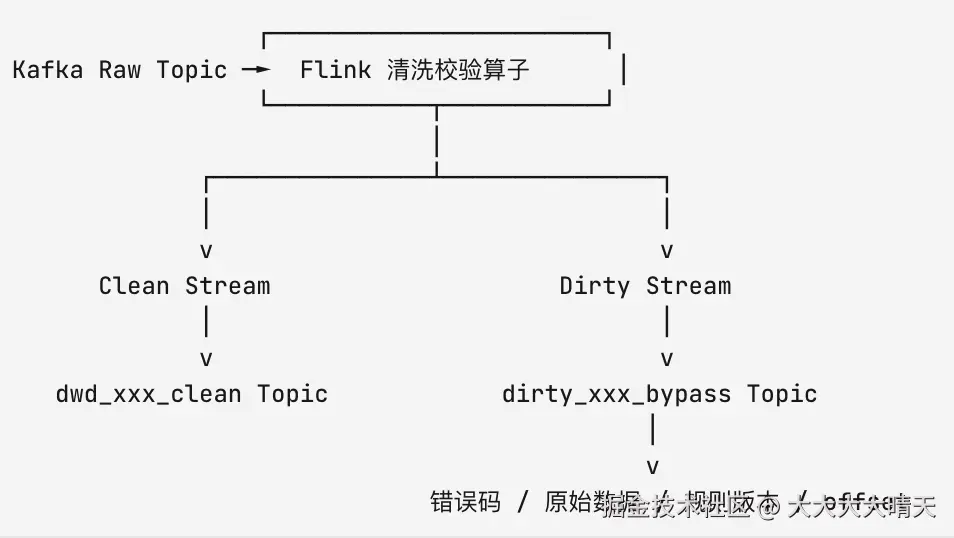
脏数据旁路至少应包含这些字段:
json
{
  "raw_payload": "...",
  "source_topic": "ods_order_raw",
  "partition": 3,
  "offset": 1029384,
  "event_time": "2026-09-28 10:01:23",
  "ingest_time": "2026-09-28 10:01:25",
  "error_code": "INVALID_AMOUNT_TYPE",
  "error_message": "amount cannot be parsed as decimal",
  "rule_version": "v2026.09.28",
  "trace_id": "..."
}
旁路的意义不是"把坏数据扔到另一个地方",而是把错误显性化、可统计、可回放、可修复。对于治理体系而言,脏数据率、错误类型分布、来源系统分布,本身就是重要的数据质量指标。
八、Exactly-once:不是一句配置,而是一条链路
Exactly-once 是实时数据治理中最容易被误用的词。从 Kafka 0.11 开始,Producer 支持幂等生产者和事务生产者;幂等生产者可以避免 producer retry 引入重复,事务生产者可以将消息原子写入多个分区或 topic。
但 Exactly-once 不能只看 Kafka 或 Flink 的单点能力,而要看端到端链路:
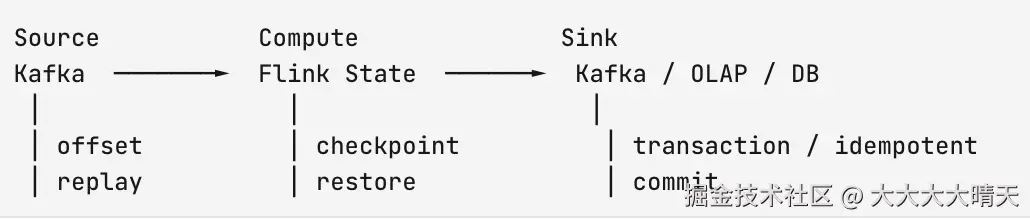
Flink checkpoint 需要可持久化、可重放的数据源,以及用于状态持久化的存储;在失败恢复时,Flink 可以从最近一次成功 checkpoint 恢复状态和流位置。Exactly-once 的基础不是"永不失败",而是"失败后能回到一致位置继续处理"。
Exactly-once 可以分为三层理解:
| 层次 | 含义 | 常见误区 |
|---|---|---|
| Source Exactly-once | 读取位置可恢复 | 以为不重复消费就是 Exactly-once |
| State Exactly-once | 状态恢复后一致 | 忽略 checkpoint 成功率 |
| Sink Exactly-once | 外部写出不重复、不丢失 | 普通数据库 insert 导致重复 |
一个更工程化的判断标准是:
markdown
如果任务在任意时刻失败:
  1. Kafka offset 能否回到一致位置?
  2. Flink state 能否回到同一 checkpoint?
  3. Sink 中已经写出的结果是否与恢复后的重放一致?
  4. 外部系统是否支持事务、幂等或可覆盖写?
如果第 3、4 点无法保证,那么最多只能说 Flink 内部状态具备 exactly-once 语义,不能宣称端到端 Exactly-once。
九、流批口径一致性:实时数仓治理的最终考题
实时数仓不是离线数仓的替代品,而是离线体系的补充。实时链路解决"快"的问题,离线链路通常解决"全量校准、复杂修正、最终一致"的问题。治理目标不是让两套系统完全相同,而是让两套系统在同一业务口径下可解释地一致。
动态表是 Flink Table API 和 SQL 支持流数据的核心概念;连续查询会持续更新结果表,并且在任意时间点,连续查询在语义上等价于对输入表快照执行同一查询。这为流批口径一致提供了一个重要思路:用统一的关系模型和 SQL 语义描述指标,而不是让实时与离线各写一套逻辑。
流批一致性治理建议如下:
| 治理点 | 实时链路 | 离线链路 | 一致性要求 |
|---|---|---|---|
| 数据源 | Kafka / CDC | Hive / Iceberg / Hudi | 来源事件一致 |
| 时间字段 | event_time | event_time | 禁止实时用处理时间、离线用业务时间 |
| 过滤条件 | status = PAID | status = PAID | 条件一致 |
| 去重键 | order_id | order_id | 主键一致 |
| 维度版本 | 实时维表 | 离线维表快照 | 版本可解释 |
| 迟到处理 | allowed lateness | T+1 修正 | 差异可回补 |
| 输出结果 | 秒级 / 分钟级 | 小时级 / 天级 | 允许短期差异,要求最终可对账 |
一个推荐的指标治理流程:
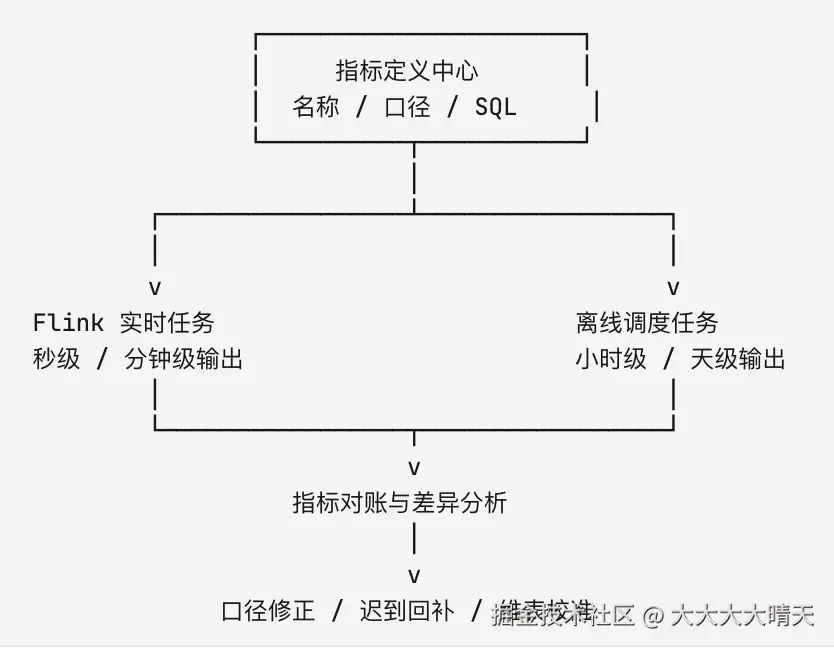
实时结果允许"暂时不完整",但不允许"口径不清楚"。如果一个实时指标与离线指标不一致,系统必须能回答:是迟到数据导致、维表版本导致、去重策略导致,还是计算逻辑本身不一致。
十、实时治理监控指标
实时治理不能只监控任务是否运行,还要监控数据是否可信。建议至少建立以下指标体系:
| 类别 | 指标 | 说明 |
|---|---|---|
| Kafka | Consumer lag | 消费延迟是否持续增长 |
| Kafka | 写入速率 | Source 是否异常波动 |
| Flink | Checkpoint 成功率 | 判断状态一致性基础是否稳定 |
| Flink | Checkpoint 时长 | 判断恢复成本与状态压力 |
| Flink | Watermark 延迟 | 判断事件时间推进是否正常 |
| Flink | Backpressure | 判断链路是否拥塞 |
| 数据质量 | 脏数据率 | 判断源头数据质量 |
| 数据质量 | 空值率 / 枚举异常率 | 判断字段质量 |
| 指标质量 | 实时离线差异率 | 判断口径一致性 |
| 可追溯 | trace_id 覆盖率 | 判断链路追踪能力 |
一个简单的实时治理告警规则示例:
erlang
IF checkpoint_failed_count > 3 within 10 minutes
THEN alert: "Flink checkpoint 连续失败,Exactly-once 保障存在风险"

IF dirty_data_rate > 1% for 5 minutes
THEN alert: "脏数据率异常,检查上游 schema 或枚举变更"

IF watermark_delay > 10 minutes
THEN alert: "Watermark 推进异常,可能存在分区空闲或乱序突增"

IF realtime_batch_diff_rate > 0.5%
THEN alert: "实时离线指标差异超阈值,进入对账流程"
十一、落地建议
css
[数据接入]
  [ ] Kafka topic 是否有命名规范?
  [ ] 是否保留原始数据 topic?
  [ ] 是否记录 source、event_time、trace_id?
  [ ] 是否有 schema 兼容性策略?

[实时计算]
  [ ] 是否统一使用事件时间?
  [ ] Watermark 是否基于业务乱序分布配置?
  [ ] 是否启用 checkpoint?
  [ ] checkpoint 存储是否使用高可用持久化存储?
  [ ] 状态是否设置 TTL 或清理策略?

[质量治理]
  [ ] 是否有脏数据旁路?
  [ ] 脏数据是否保留原始 payload?
  [ ] 是否记录错误码、规则版本、offset?
  [ ] 是否有脏数据率监控?

[一致性治理]
  [ ] Source offset 是否可恢复?
  [ ] Sink 是否幂等或事务化?
  [ ] 实时指标与离线指标是否共用口径定义?
  [ ] 是否有实时离线对账任务?
  [ ] 是否能解释差异来源?

[可观测性]
  [ ] 是否监控 consumer lag?
  [ ] 是否监控 watermark delay?
  [ ] 是否监控 checkpoint duration?
  [ ] 是否监控 backpressure?
  [ ] 是否监控端到端延迟?