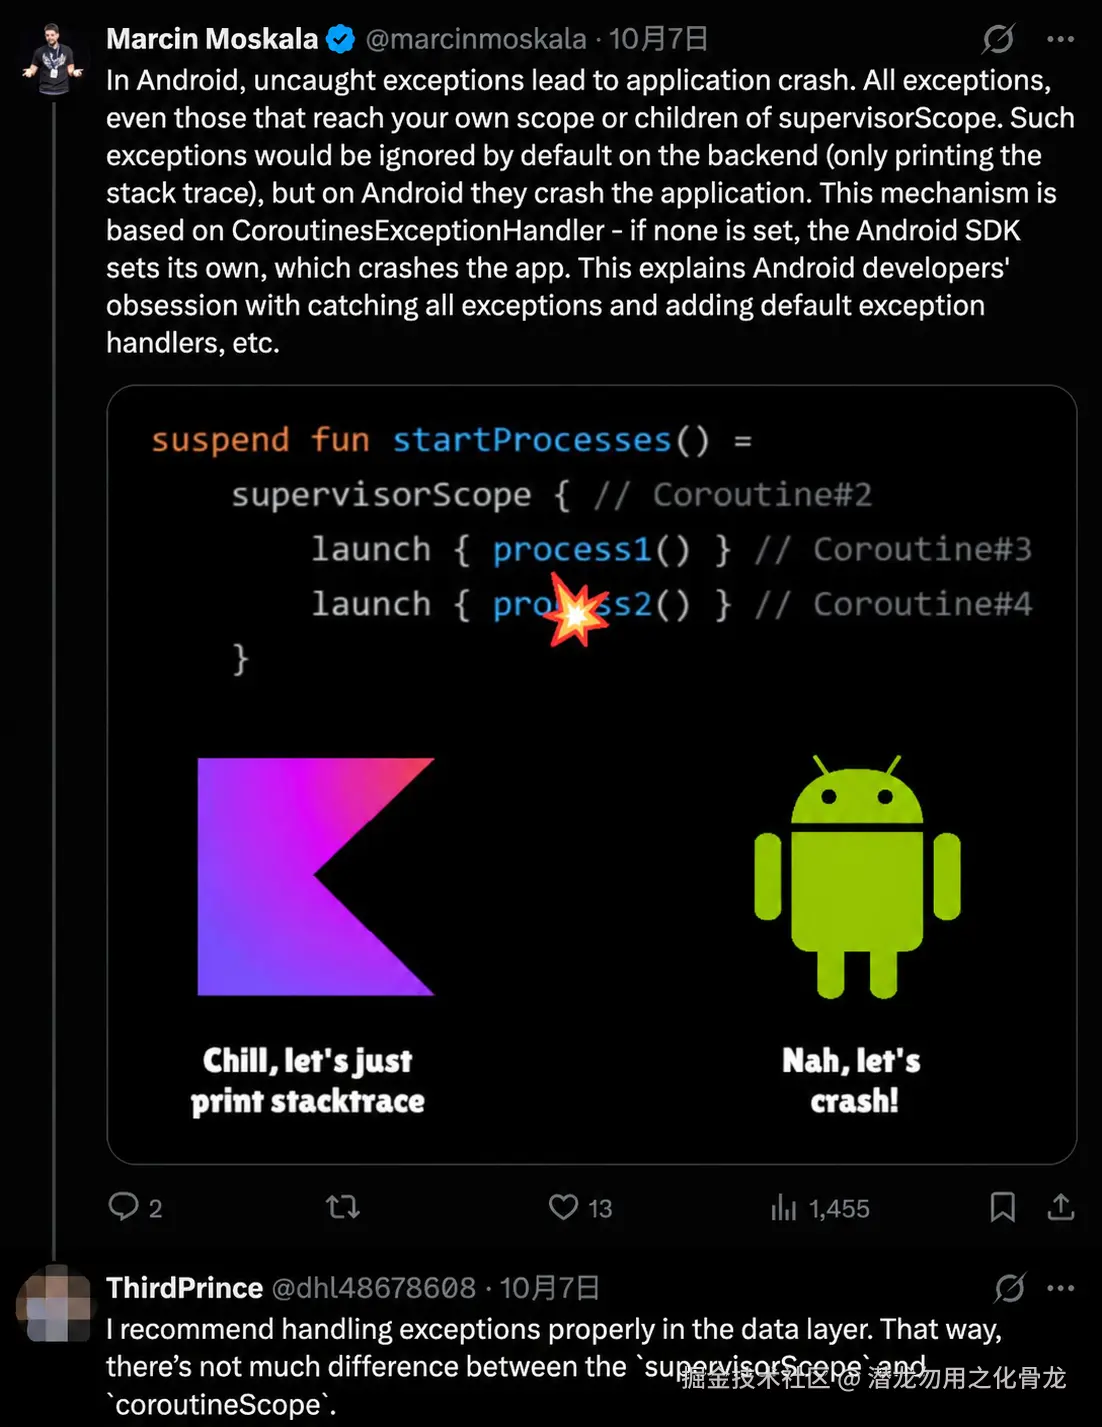
在 Android 项目中,supervisorScope 常被用于避免"一个子任务失败,取消其他子任务"的情况。它看似能提升并发任务的容错能力,但如果被作为默认方案,容易掩盖项目中异常边界不清、失败处理分散等问题。
本文的核心观点是:
不应将
supervisorScope作为 Android 业务代码中的常规异常处理或防崩方案。
更合理的做法是:在 Repository 数据边界消化并标准化可预期异常,让上层通过显式结果处理成功与失败。
1. supervisorScope 的真实作用
普通的 coroutineScope 遵循结构化并发的失败传播规则:
-
一个子协程失败;
-
父协程被取消;
-
其他子协程被取消;
-
异常继续向上传播。
Kotlin
scss
coroutineScope {
    launch { loadProfile() }
    launch { loadRecommendations() }
}
如果 loadRecommendations() 抛出异常,loadProfile() 也会被取消,异常最终由父协程处理。
而 supervisorScope 改变的是子协程之间的取消关系:
Kotlin
scss
supervisorScope {
    launch { loadProfile() }
    launch { loadRecommendations() }
}
其中一个子协程失败时,不会自动取消兄弟协程。
因此,supervisorScope 的作用是:
隔离子协程之间的失败取消,而不是处理异常,也不是保证应用不会 crash。
2. supervisorScope 并不能避免 crash(附真实陷阱分析)
与某些后端或 Java 服务端环境不同,Android 程序有着严苛的稳定性铁律:只要有未捕获的异常冒泡到根节点,应用就会毫不留情地 Crash。
很多开发者以为在外面加一层 try/catch,或者套上 supervisorScope 就万事大吉了。来看一个极具迷惑性的常见写法:
Kotlin
scss
val handler = CoroutineExceptionHandler { _, throwable ->
    addLog("【捕获到异常】: ${throwable.message}")
}

viewModelScope.launch(handler) {
    try {
        supervisorScope {
            launch {
                delay(500)
                addLog("子协程 1: 发生错误")
                throw RuntimeException("子协程 1 崩溃")
            }
            launch {
                try {
                    addLog("子协程 2: 正在运行...")
                    delay(2000)
                    addLog("子协程 2: 任务完成 (我没受影响 ✅)")
                } catch (e: CancellationException) {
                    addLog("子协程 2: 被取消")
                    throw e
                }
            }
        }
    } catch (e: Exception){
        e.printStackTrace()
    }

    addLog(">>> supervisorScope 调度块结束")
}
这段代码揭示了几个残酷的现实:
-
外层的
try/catch形同虚设 :try/catch无法捕获独立子协程(launch)内部抛出的未处理异常。异常向上冒泡时,外层try/catch根本感知不到。 -
supervisorScope只能隔离取消,不能隔离异常 :虽然子协程 1崩溃时没有取消子协程 2(子协程 2 顺利跑完了),但这不代表异常消失了。 -
必须注入
CoroutineExceptionHandler才能兜底 :如果去掉外层的handler,即使套了supervisorScope且子协程 2 没受影响,子协程 1的未处理异常依然会一路向上冲破防线,最终导致整个 Android 应用 Crash。
因此,不能把 supervisorScope 当作以下问题的解决方案:
-
防止异常向上传播;
-
防止应用 crash;
-
避免编写错误处理;
3. 问题根源:数据层异常直接穿透上层
网络超时、服务端异常、数据解析失败、数据库读取失败、文件访问失败、系统服务不可用等,都是应用运行中可预期的失败。
如果 Repository 直接把这些技术异常抛给上层:
Kotlin
kotlin
suspend fun loadContent(): Content {
    return api.getContent()
}
那么每一个调用方都必须处理异常:
Kotlin
ini
viewModelScope.launch {
    try {
        val content = repository.loadContent()
        _uiState.value = UiState.Content(content)
    } catch (exception: Exception) {
        _uiState.value = UiState.Error
    }
}
这种设计会带来几个问题:
-
异常处理分散 :每个调用点都需要写
try/catch。 -
容易遗漏:新增调用方若忘记处理,异常就可能穿透协程边界。
-
遗漏必然导致 Crash:在 Android 主线程上下文中,未处理异常会直接终止应用进程。
-
失败语义不清晰:网络错误、权限错误、服务不可用、空数据等都会退化成普通异常。
-
UI 层感知了底层实现细节 :ViewModel 不应直接依赖
IOException、HTTP 异常或数据库异常。 -
开发者容易误用
supervisorScope:用失败隔离规避异常传播,而不是在正确边界处理失败。
4. Repository 应作为异常归一化边界
更合理的职责划分是:
-
DataSource:执行网络、数据库,、文件、系统服务或第三方 SDK 调用;
-
Repository:捕获并转换可预期技术异常;
-
UseCase:组合 Repository 结果,表达业务规则;
-
ViewModel:将业务结果映射为 UI 状态;
-
UI:展示状态并发送用户事件。
DataSource 可以抛出底层技术异常:
Kotlin
kotlin
class RemoteContentDataSource(
    private val api: ContentApi,
) {
    suspend fun getContent(): Content {
        return api.getContent()
    }
}
Repository 则应提供稳定、显式的结果:
当然这里你也可以用Result
Kotlin
kotlin
sealed interface ContentResult {
    data class Success(val content: Content) : ContentResult
    data object NetworkError : ContentResult
    data object ServiceUnavailable : ContentResult
    data object UnknownError : ContentResult
}
Kotlin
kotlin
class ContentRepository(
    private val remoteDataSource: RemoteContentDataSource,
) {
    suspend fun getContent(): ContentResult =
        try {
            ContentResult.Success(remoteDataSource.getContent())
        } catch (exception: CancellationException) {
            throw exception
        } catch (exception: IOException) {
            ContentResult.NetworkError
        } catch (exception: ServiceUnavailableException) {
            ContentResult.ServiceUnavailable
        } catch (exception: Exception) {
            ContentResult.UnknownError
        }
}
Repository 对上层表达的是业务可理解的结果,而不是具体实现使用了什么网络库、数据库或系统 API。
5. 为什么必须重新抛出 CancellationException
采用"Repository 不向上抛出可预期异常"的策略时,有一个重要例外:
Kotlin
csharp
catch (exception: CancellationException) {
    throw exception
}
CancellationException 不是业务失败,通常代表:
-
页面退出;
-
ViewModel 被清理;
-
父协程取消;
-
用户主动取消请求;
-
生命周期结束;
-
超时取消。
如果把它吞掉并转换为普通失败:
Kotlin
php
catch (exception: Exception) {
    ContentResult.UnknownError
}
可能产生以下后果:
-
页面销毁后任务仍继续执行;
-
已取消的请求仍尝试更新状态;
-
网络、文件或系统资源无法及时释放;
-
结构化并发的取消语义被破坏。
因此,应明确约束:
可以转换可预期的数据和平台异常,但不得吞掉
CancellationException。
6. 上层应消费结果,而不是依赖异常控制流程
UseCase 可以继续返回 Repository 的结果,或根据业务规则转换为更适合上层的领域结果:
Kotlin
kotlin
class GetContentUseCase(
    private val repository: ContentRepository,
) {
    suspend operator fun invoke(): ContentResult {
        return repository.getContent()
    }
}
ViewModel 根据结果更新 UI 状态:
Kotlin
ini
viewModelScope.launch {
    _uiState.value = UiState.Loading
    _uiState.value = when (val result = getContentUseCase()) {
        is ContentResult.Success -> UiState.Content(result.content)
        ContentResult.NetworkError -> UiState.NetworkError
        ContentResult.ServiceUnavailable -> UiState.ServiceUnavailable
        ContentResult.UnknownError -> UiState.Error
    }
}
这种方式有以下优点:
-
ViewModel 不需要为了常规网络失败到处编写
try/catch; -
UI 可以针对不同失败类型展示不同状态;
-
失败处理路径明确且容易测试;
-
Repository 的对外契约稳定;
-
上层不依赖底层技术异常类型;
-
彻底杜绝了因漏写异常处理而引发的 Android 崩溃。
7. 并发加载也不必默认使用 supervisorScope
假设首页需并发加载用户信息和推荐内容。
如果两个 UseCase 都返回明确结果:
Kotlin
kotlin
suspend fun getProfile(): ProfileResult

suspend fun getRecommendations(): RecommendationResult
可以直接使用普通的 coroutineScope:
Kotlin
ini
suspend fun loadHome(): HomeUiState = coroutineScope {
    val profileDeferred = async {
        getProfileUseCase()
    }
    val recommendationsDeferred = async {
        getRecommendationsUseCase()
    }
    HomeUiState(
        profile = profileDeferred.await(),
        recommendations = recommendationsDeferred.await(),
    )
}
即使某一个请求网络失败,它也返回相应的失败结果,而非抛出异常。因此:
-
不会因为预期失败触发级联取消;
-
可以自然实现部分成功和局部降级;
-
不必使用
supervisorScope; -
每一个失败都有明确、可测试的业务语义。
换言之:
实现局部降级的关键是显式失败结果,而不是
supervisorScope。
8. 不建议把 supervisorScope 作为默认工具
若数据层把可预期失败当作异常向上抛,上层就必须在每个并发入口显式捕获;一旦遗漏,未处理异常仍会导致 crash。此时 supervisorScope 虽然能让其他子协程多跑一会儿,但无法阻止进程终止,也无法自动把失败变成 UI 状态,其"避免连带取消"的优势在 crash 路径上形同虚设。
9. 推荐团队规范
可以将以下内容沉淀为 Android 协程与分层规范:
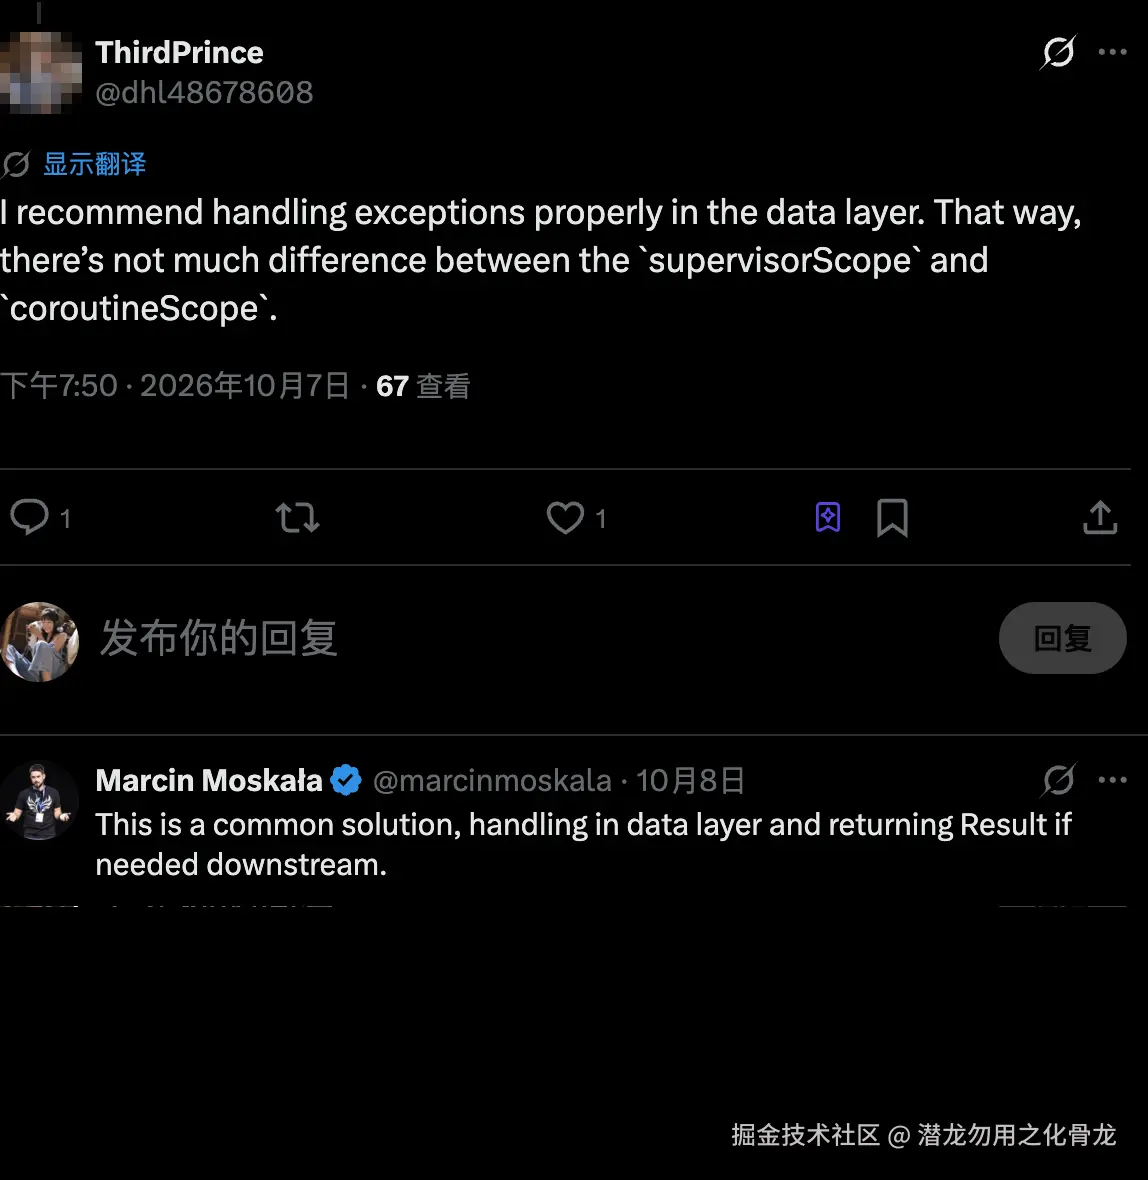
Repository 是可预期异常的归一化边界。
网络、存储、文件、系统服务和外部 SDK 等可预期失败,应转换为
Result<T>或密封结果类型。不应把可预期技术异常作为 UseCase、ViewModel 或 UI 的常规控制流程。
CancellationException必须继续向上传播,不得转换为普通业务失败。默认使用
coroutineScope保持结构化并发和失败传播语义。不将
supervisorScope用作防 crash、吞异常或实现业务降级的常规方案。数据层处理好异常,是 Android 程序保持稳定、远离 Crash 的基石。
对未知异常应有统一且不含敏感数据的日志与监控策略,但不能将编程错误伪装成普通网络错误。
10. 结论
supervisorScope 的价值在于隔离并发任务之间的取消关系,而不是解决 Android 应用的异常治理问题。
如果数据层把可预期异常直接抛给上层,上层必须频繁使用 try/catch;一旦遗漏,就可能产生未处理异常甚至导致应用崩溃。此时使用 supervisorScope 通常只是改变了异常扩散路径,并没有解决根本问题。
更稳健的架构应当是:
Repository 统一转换可预期异常;UseCase 组织业务结果;ViewModel 映射 UI 状态;UI 仅展示状态和触发操作。
在这种模式下,失败是显式、可测试、可恢复的状态------把异常消灭在数据层,才是保证 Android 应用稳定的终极基石。
参考1:
参考2: Marcin Moskala 大神的回复