先问一个扎心的问题:如果把同一个评审请求、连同同一批文档,原封不动发给你的 LLM 两次,你敢保证两次回答一字不差吗?大部分人不敢保证,也不觉得这是个问题------模型嘛,有点随机很正常。但在医疗器械行业,这件事是致命的:合规判断要写进质量记录,保存至少十年,审计员要拿着记录去核对「当时专家看到的证据到底是什么」。如果系统今天说「满足」、明天说「不满足」,引用的证据还换了地方,那任何一次变更之后的差异,你都无法分辨是「改动造成的」还是「模型自己抖了一下」。
GFLOPS 公司的 Ryosuke Suzuki 在 arXiv 上发的这篇论文,就是把这个问题量到了极致:把同一批医疗器械合规评估请求,发给 7 个模型、3 家提供方、6 条调用路径共 14 个商业部署,连续两天、每天 5 遍。结果是全军覆没------14 个部署没有一个能复现自己的全部回答,其中 12 个连「满足 / 不满足」的标签都变过,而这一切发生在各自接受的「确定性采样」设置下。
💡 一句话总结:temperature 0、seed 0 拦不住商业 API 的输出漂移------引用证据比标签变得还勤;而作者自建的一条从 OCR 到判定的流水线,在换机器、并发、中断重启、跨天等各种折腾下做到了全链路字节级一致。复现性不是模型的属性,是部署方式的属性。
📄 论文:Making every stage of medical device document assessment with large language models deterministic(arXiv 2610.21300)
痛点:合规场景里,「大概稳定」约等于没有稳定
医疗器械合规是怎么用 LLM 的?论文设定得很克制:哪些法规适用、要证明什么,仍然是专家的活;LLM 只负责对专家定义的每条评估项(assessment item,比如指南里一句「至少包含两台血糖仪、每台每个血糖水平至少测 10 次」),从文档里找证据,给出一个初步评估------标签(满足 / 不满足 / 无法判定)、一段理由、外加逐字引用的原文出处。最终的判断和责任都在人类专家手里。
这个设定听起来已经很保守了,为什么还要较真「每次输出一模一样」?因为质量记录建立在专家看到的内容之上。法规(ISO 13485、21 CFR Part 11、EU MDR)反复要求的是:记录下来的结论要有可核查的证据,系统要「性能一致、能辨别无效或被篡改的记录」。一个输出会漂移的系统,意味着换了个文档、换了个模型、换了块显卡之后观察到的一次差异,没法和日常波动区分开------除非你把所有测试都重跑 N 遍,那成本就上去了。
那让商业 API 「确定」不就行了吗?事情恰恰卡在这里。浮点运算的结果取决于请求怎么被分批(batch,也就是服务器把多少请求凑成一坨一起算),嵌入和检索会随精度和数据库插入而漂移,而商业部署跑在用户根本看不见的硬件和软件上。之前有预印本测过五家 API 提供商:temperature 0 下重复请求,两个被测模型平均只有 22% 的时候输出字符级相同。供应商自己的文档也直说了:seed 是「尽力而为」,temperature 0 不等于「完全确定」。
作者要回答的问题因此非常具体:一条完整的评估流水线------提取、OCR、分块、嵌入、检索、推理,能不能端到端复现到字节级?以及,一个商业部署的真实用户,在评估记录的各个字段上到底会观察到什么?
🛠️ 思路:把「问一遍」变成「问 70 × 14 × 10 遍」
实验设计值得细看,因为它把「赖账」的空间压到了最小。作者从公开的 FDA 血糖仪 510(k) 文档(美国医疗器械上市前通报的公开材料)构造了 70 个评估 prompt,按文档长度分三档------短的 1.2 万字符、长的 50 万字符------然后以字节完全相同的请求发给 14 个部署,要求 temperature 0、seed 0、JSON schema 约束输出(凡是提供方接受这些参数的);连续两天、每天每个 prompt 发 5 次。整个实验花了 1,291 美元。
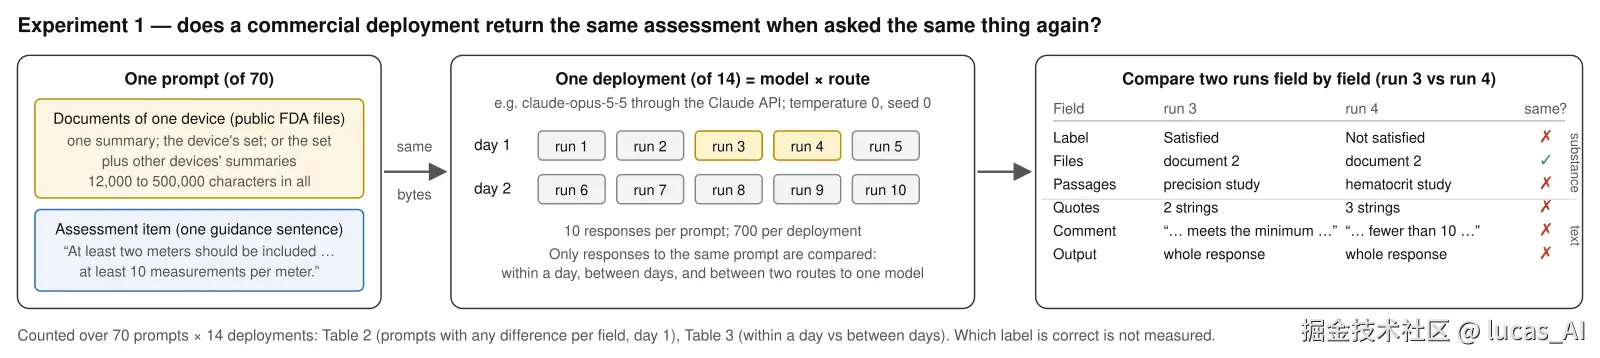
比较的粒度是关键:同一 prompt 的多次回答被拆成六个字段、两层来比。实质层 是专家真正依赖的东西------标签、引用了哪些文件、引用了文档中哪些段落(两段引文只要落在同一文档同一位置就算一致,判定很宽松);文本层是记录系统实际存储的东西------引文原文字符串、理由全文、整个响应逐字节比对。这套分层让「标签没变但证据变了」这种最阴险的情况无处遁形。
商业部署之外,作者搭了一个正控制组:开源权重模型 Gemma 4 31B(FP8 量化),用 vLLM 的 batch-invariant 模式(批处理不变推理------一种让输出与请求怎么分批无关的内核技术)自己服务,跑在一张 RTX PRO 6000 上。最后是一条完整的六阶段流水线:文本提取(扫描页走自托管 OCR)→ 1400 字符分块 + 逐条嵌入 → 设备范围内精确检索 top 6 → LLM 判定 → 引用逐条回源核验 → 写入哈希链账本,每个阶段的输出都算 SHA-256 哈希。语料是 337 个 FDA PDF、83 个设备、776 个「设备 × 评估项」对,外加一组输液泵文档做第二验证集。
📈 效果:商业部署全军覆没,自建流水线全绿
先看坏消息有多坏。14 个部署,每一个都至少在一个请求上返回了不一致的评估;12 个的标签变过。同一天之内,就有 10 个部署改过至少一个 prompt 的标签,最夸张的 gpt-6-luna 走 Azure OpenAI 在 70 个 prompt 里改了 18 个。两次请求标签不同的概率,各部署从 0 一直排到 13.7%(gpt-6-luna via Azure,95% 置信区间 8.6%--19.7%)。
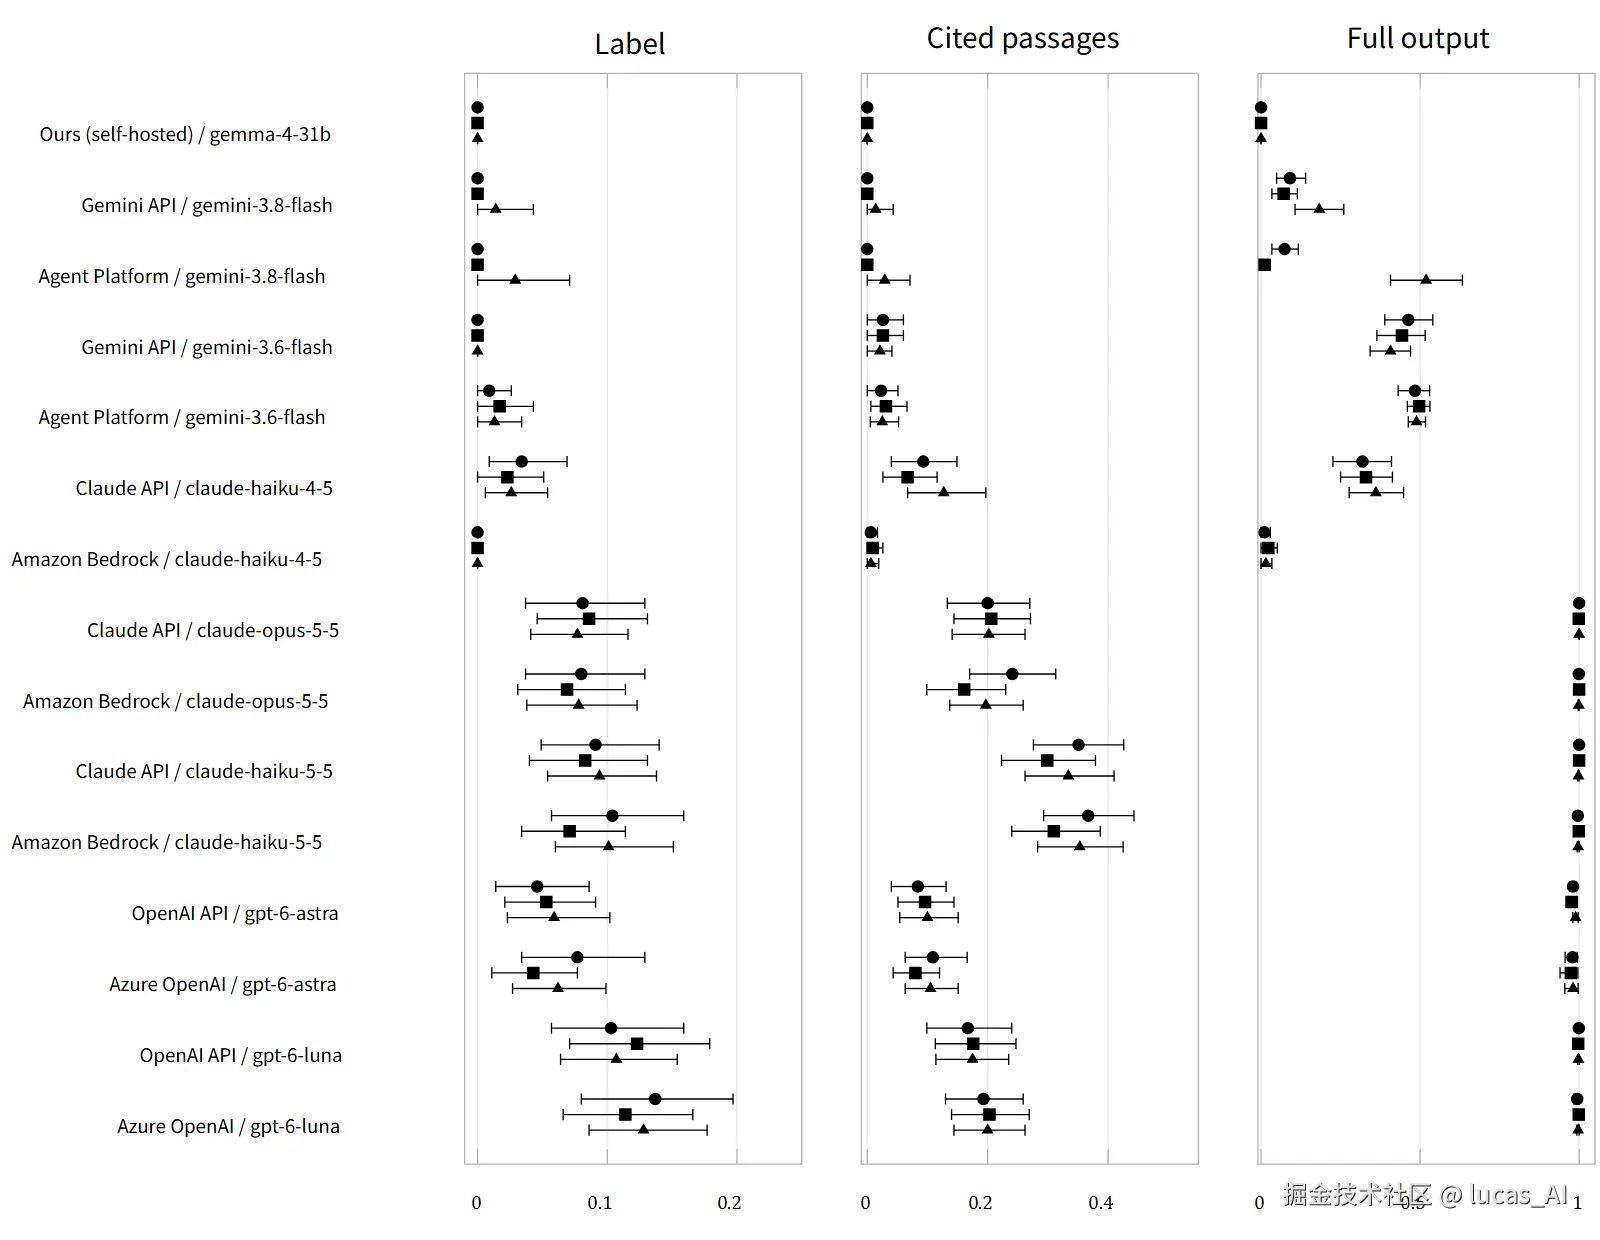
这张点图怎么读:三列横轴量程不同(0--0.2 / 0--0.4 / 0--1),圆点是标签、方块是引用段落、三角是完整输出。看第三列「Full output」几乎全线顶到最右边------没有任何一个商业部署能逐字节复现自己的完整回答;而第二列普遍比第一列靠右,说明引用段落的漂移比标签翻转更常见。唯一的全零行,是作者自托管的那台 gemma-4-31b。
几个细节比总数字更有信息量。其一是证据比标签更不稳 :14 个部署里,引用段落出现差异的 prompt 数全部不低于标签差异数,12 个部署里更多、最多差到 3 倍------claude-opus-5-5 走 Claude API,标签在 11 个 prompt 上变过,引用的段落却在 23 个上变过。标签看起来稳定,专家核对的证据却已经换了地方,这对审计是最难受的组合。其二是同一家模型换条路就是另一个物种 :claude-haiku-4-5 是唯一真正跑在 temperature 0 且无推理 token 的模型,它走 Claude API 时 4/70 个 prompt 标签变化,走 Amazon Bedrock 时是 0(统计检验显著)。验证记录上只写模型名不写路由,等于没说清验证的是什么。其三是有一种失败只在跨天时出现:gemini-3.8-flash 两个路由同一天内 5 次全同,但第二天有 1--2 个 prompt 的标签与第一天不同,模型 ID 没有任何变化------只做单日验证的系统会直接放它过关。
你可能想替厂商说句话:是不是推理 token 在捣乱?作者把 8 个允许调低推理的部署重新设到最低档再测一遍------7 个的标签变化数不降反升,gpt-6-luna 从 14/70 涨到 42/70。那是不是 prompt 太长太难?换成流水线用的短 prompt(六段检索内容、七八千字符),9 个部署仍然在 49 个 prompt 里 48--49 个上输出不同。temperature 0、seed 0、降推理、缩 prompt,四条路都堵死了。
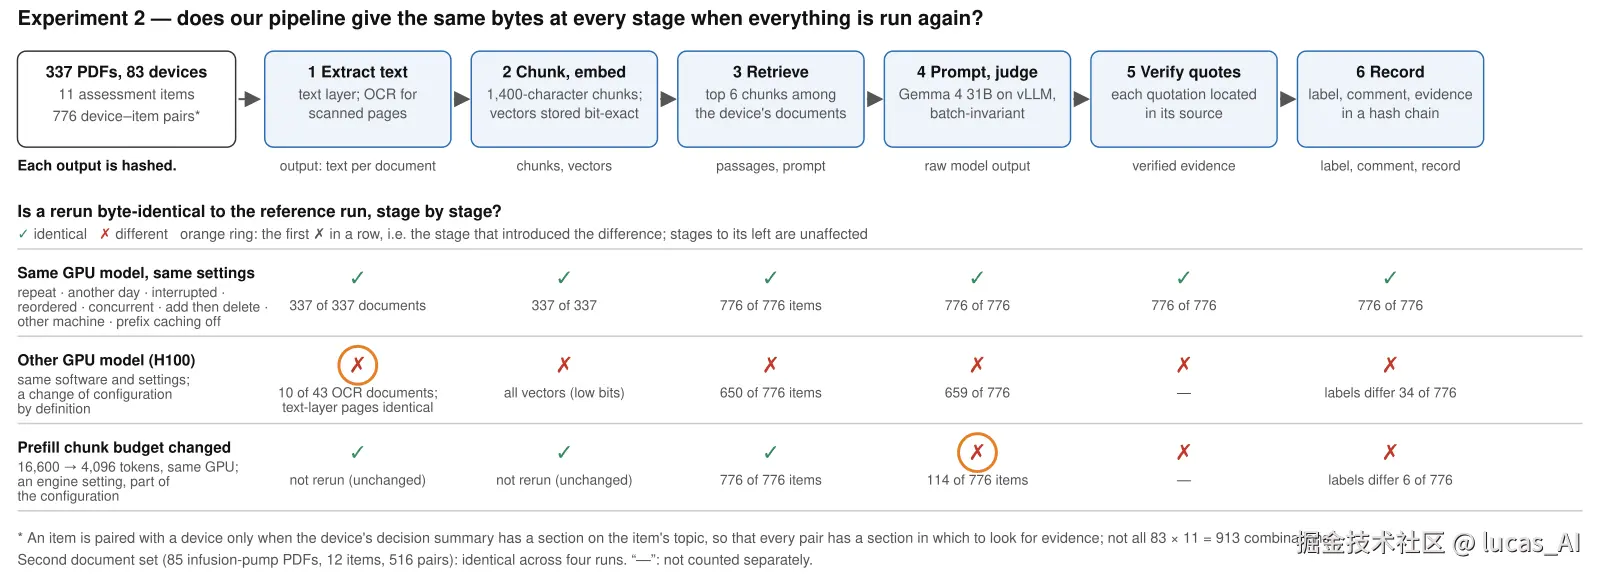
再看好消息。上面这张图是自建流水线的成绩单:上半部分,「不该改变结果的折腾」------重复运行、隔天再跑、中断后断点续传、推理服务器杀掉重启、文档乱序、1 到 16 路并发、加一份文档评估完再删、换一台同型号 GPU 的机器------776 个评估、337 份文档的每一个阶段哈希都和参考运行完全一致;输液泵第二语料四次运行同样全绿。下半部分是故意的扰动:换成 H100 显卡(软件设置全同),第一阶段就引入了差异------嵌入向量全变、126/776 个评估的检索和 prompt 变了、30/650 个 prompt 完全相同的评估标签翻转;把预填充块预算从 16,600 砍到 4,096 token,单条判定不受影响,一旦 8 路并发就有 114--122 个评估的原始输出变了。橙色圈标出的就是差异引入点,定位精确到阶段。
特别值得记住的是消融实验的结论:每个 GPU 阶段都要自己保证不变性。关掉 OCR 的批处理不变性,42 个扫描页文档里 13 个提取文本变了;关掉嵌入的,337 份文档里 332--336 份的向量变了;用默认配置的近似检索索引(hnswlib、Elasticsearch),要么只在单线程定序下可复现,要么重建索引就有 3/33 个查询结果变化。批处理不变性不是免费的:并发场景下多花 18% 墙钟时间------对判定环节来说,这大概是全流水线里性价比最高的 18%。
🔧 怎么用:一份可以直接抄的确定性清单
这篇论文最实用的部分,是把「确定性」从一个口号拆成了可执行的工程条件。如果你在做任何要留档、要审计、要变更管理的 LLM 应用(合规、评审、风控、司法、财务,不止医疗器械),可以直接对照下面的清单:
- 体检先从重发开始:把同一 prompt 原样重发 N 次、连续两天,先盯引用证据、再看标签。引用漂移比标签翻转更早出现,单日验证会漏掉跨天漂移(gemini-3.8-flash 就是现成反例)。
- 配置记录到「硬件类」粒度:模型、路由、采样设置、推理档位之外,还要记引擎版本、预填充块预算、并发上限、GPU 型号 + 驱动 + CUDA 版本。论文证明了这些每一项都能独立改变输出。
- 自托管要确定性,配方是固定的:batch-invariant 推理 + 贪心解码 + 语法约束输出 + 嵌入逐条算(确定性 kernel)+ 精确范围检索(别用默认近似索引)+ 全链路内容寻址(SHA-256)+ 每阶段哈希账本。
- 用哈希做变更影响分析:配置不动时重跑流水线,逐阶段比对哈希,哪些评估项、在哪个阶段被换硬件或改配置影响,机器直接告诉你------论文里 H100 那次「差异定位」就是这套机制的实战演示。
- 利用确定性省钱:输入不变的评估输出也不变,所以文档更新后,只有检索证据变了的项目才需要重新过模型;检索便宜、推理贵,这笔账在语料大的时候很可观。
医疗器械行业的合规判断必须留档十年以上,而 GPU 型号的服役期未必有十年,托管模型的版本更是几个月就能退役------所以论文也提醒:容器镜像、模型权重、驱动要跟记录一起归档,硬件退役后在新型号上以「变更清单」的方式重建参考输出。这也是作者倾向于自托管开源权重模型的理由之一。
🧊 泼冷水:复现不等于正确,这篇论文的边界要说清
第一条也是最重要的一条:确定性不是正确性。一个能精确复现错误评估的系统,复现的仍然是错误。论文从头到尾没有测量这 776 个评估判得对不对------「满足 / 不满足」的准确率、引用证据是否是专家会引的那段、机器初审会不会让专家偷懒,全都悬而未决。作者自己把这点写在讨论里,算是诚实。
第二条,测量本身有权效边界。每个部署只测了两天、一个客户端区域、按量付费档;5 次重复在统计上只能排除「单次变化概率高于 45%」的情况,表里的 0 严格说是「没观察到」,不是「稳定」;8 个部署跑在提供方默认采样上,「各自接受的确定性采样」这个说法本身就是打折的------厂商连 temperature 0 都不让你设,谈何确定性。另外,70 个 prompt 来自 49 个设备-评估项对,评估项是从 FDA 指南里按「含数字下限」规则挑出的 11 句话,跟真实厂商内部的合规清单差距多大,不好说。
第三条,利益结构值得点破:这是单作者论文,作者受雇于 GFLOPS,被测的正控制组 AskDona Assessment 就是自家产品,还有覆盖该流水线的临时专利申请。代码是专有的,公司外还没有第三方复现过这套结果;batch-invariant 是 vLLM 0.29.0 的 beta 特性,论文里 Qwen3.8-27B 就压根无法以该模式服务------这套配方的普适性有待更多引擎和模型验证。作者承诺期刊版会放出六属性的最小参考实现和哈希校验脚本,到时候值得盯一眼。
第四条,反方最强论证也得摆出来:字节级复现可能是过度工程。质量体系的底线是记录可追溯、变更可审计------每次输出都存档加审计轨迹也能满足审计需求;而 run 之间的不一致本身可以作为不确定性信号来用。把 GPU 型号、调度参数全部锁进配置,意味着换一次硬件就触发一轮再验证,18% 的延迟代价加上硬件绑定的维护成本,在模型迭代以月计的当下并不轻松。欧盟 GMP Annex 22 草案甚至明确只对「确定性输出模型」要求输出一致,并把 LLM 排除在关键用途之外。作者的回应是:没有确定性,变更后的单次差异无法与波动区分,变更影响无法归因;而不确定性信号完全可以在确定性流水线上用「故意换配置」的方式获得------两件事并不冲突。这个回合,我认为作者占理,但「占理」的前提是你的场景真的需要逐条归因,如果只是统计口径的研究,统计一致性就够了。
💡 理性看待
这篇论文最有价值的不是一个数字,而是一个视角的翻转:复现性不是模型的属性,是部署的属性。同一个模型名,换个路由、换块显卡、改个调度参数,就是不同的系统------「我们用的是 XX 模型」这句话在验证记录里是不完整的。商业 API 在 temperature 0 下也会漂,短期内大概率不会改变;但确定性这件事并非只能仰仗厂商发善心,从 OCR 到判定的每一层都有现成的工程手段,代价是 18% 的延迟和把硬件写进配置的自觉。
对大多数应用,「重发 N 次 + 记录路由 + 盯紧引用证据」这个最低配置已经能挡掉大部分坑;对要把 LLM 判断写进质量记录的场景,这篇论文给出的是一张可以直接照着验收的图纸。至于模型判得准不准------那是另一篇论文的事,别让「每次都错得一模一样」给你带来虚假的安全感。