导语:描述数据的「长度通胀」
给多模态大模型造过训练数据的同学,大概率被「写详细点」这个需求折磨过。稠密描述(dense caption,用长文本把一张图里的物体、属性、关系尽量讲全的描述)是视觉信息变成语言监督的管道------描述里没有的信息,模型基本学不到。于是各家数据管线都在加长度:四千字不够就八千,一段不够就十段。
但长度是个会骗人的指标。一次长输出照样漏掉小物体、图片里的文字、「谁在谁左边」这类空间关系;更糟的是,模型会把拿不准的观察写成笃定的断言------长是长了,信息密度反而在稀释。做细粒度描述、视觉定位(grounding,把语言短语锚到图中具体区域)的同学对此应该不陌生:图一分辨率高起来,模型就开始「看图编话」。
蚂蚁集团与浙江大学的工作 ZoomCap(arXiv 2610.21320)把这个老问题换了个问法:别先问「怎么把描述写长」,先问「在有限的观察预算内,图里还缺哪些证据、去哪儿补、补完怎么筛」。下面这张对比图里,同样五个目标,两个知名描述方案(ScaleCap 与 Gemini-3.1-Pro)只保住了部分,ZoomCap 全部留住。
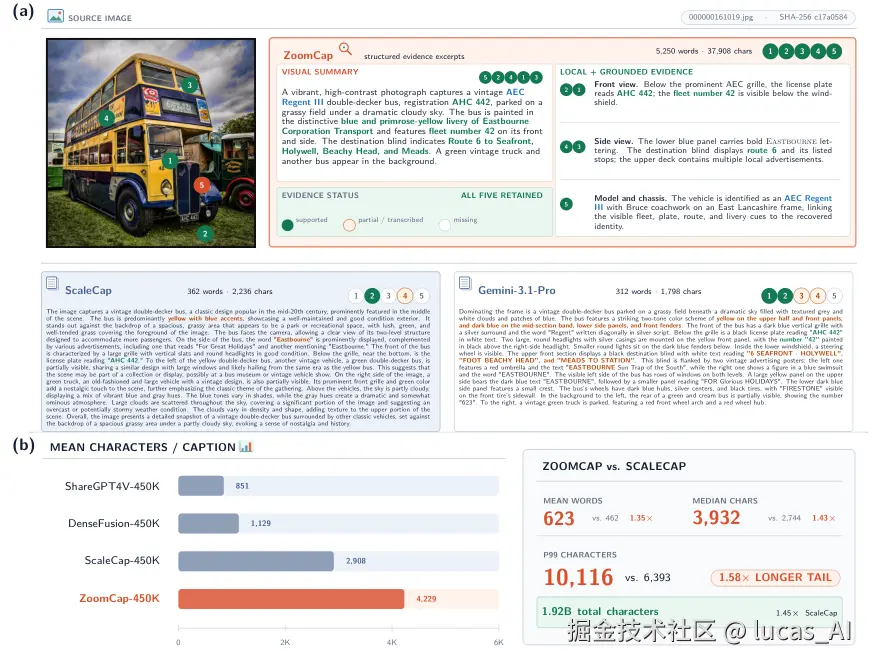
先给赶时间的同学一句话版本------
💡 一句话总结:ZoomCap 把一份草稿描述当路由器------缺世界知识去检索、文字图表走 OCR、没讲到的区域定向回补、只对最复杂的一块做二次放大;候选句子要过「新颖、与图一致、不重复」三道门才能进正文。评测端配套的 FactCycle 给每条原子断言盖两个章:源图里为真吗?只凭文字能重画出来吗?结果:每张图 52.4 条可回放事实,是最强基线 ScaleCap 的 1.7 倍;一个比对手小 10 倍的教师,在人类盲评里拿到 81.9% 的偏好分。
📄 论文:arXiv 2610.21320🗂️ 数据集:ZoomCap-450K(Hugging Face)------论文脚注声明的公开受控语料;官方代码仓截至成文快照未见
🛠️ 思路:先写草稿,再按缺口补证据
为什么不让模型直接一次看 4K 分辨率?论文给的答案是:单次全局生成会稀释注意力,小而偏的证据根本进不了视野;固定高分辨率裁切又把预算平均撒在空背景上。检索、视觉搜索能找回漏掉的区域,但「每个源都对每张图用一遍」太浪费------更多 token、更多工具、更多裁切,不必然带来更可信的信息。
ZoomCap 的做法是把「采集什么证据」和「怎么组织成文」拆开。整体管线如下面这张框架图:一份草稿描述驱动三路证据获取,最后多源融合成正式描述。
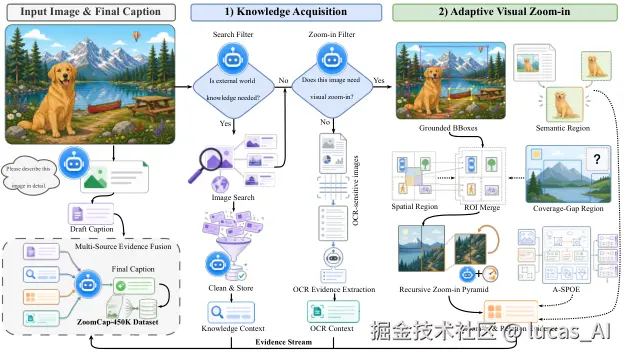
第一步是草稿当脚手架。第一次调用照常生成全图草稿,但它不再是成品,而是地图:记录哪些场景、实体、文字已经讲清楚,更重要的是暴露哪些区域没被覆盖。这一步的思路转变在于------草稿的价值不在写得好,而在「知道自己哪里没讲到」。
接着是三路证据流按需路由,各修各的缺口:
- 知识流:遇到产品、地标、艺术品、logo 这类「像素里看不出名字」的对象,触发图像检索补世界知识;检索结果只做参考,融合时不许覆盖视觉证据。
- OCR 流:文字、图表、文档、界面类图像走整图识别再摘要------特意不做任意裁切,因为裁切会破坏阅读顺序,读出一堆错乱碎片。
- 放大流:只对物体密集、属性局部化、空间结构化的图像追加观察,把预算花在草稿大概率没讲全的地方。
三路流不是并行全开,而是草稿说了算:缺什么,路由什么。
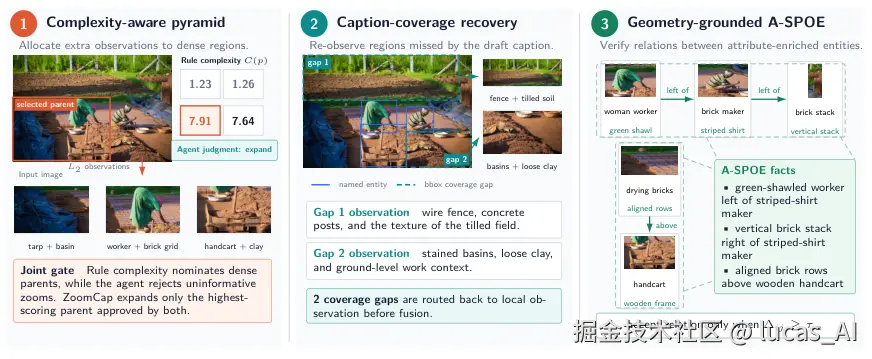
放大流内部还有一套值得细看的预算控制。覆盖感知裁切先用四个象限做粗覆盖(显著内容不与象限对齐时加一个语义区域),再把草稿里已接地的实体框并成「已解释集合」,专挑未覆盖比例最大的缺口矩形定向回补。注意这里的「缺口」是相对草稿已讲内容定义的,不是像素显著性------这一手让回补天然对准真正的盲区。
复杂度门控递归放大决定「要不要再深一层」。每个一级裁切块各自描述后按复杂度打分(实体数、小物体数、被裁切实体密度、面积占比加权),一个 agent 再行使否决权毙掉没信息量的提名;最后只有得分最高且被双重放行的那一个父块获得二次放大。这道门把总裁切输入省了 20.2%,二级输入省了 39.8%。
空间关系最容易「看图编话」,ZoomCap 用几何接地的 A-SPOE 关系(属性增强的主-谓-宾-环境图)兜底:左右、上下只从实体框的几何位置推导------间距要够、主方向要清晰、重叠不能过大,条件全过才收,一张图最多留 8 条。空间短语在进入自由文本之前,就先过了审计。
最后一步草稿锚定门控融合:任何一路产出的候选句子,要同时满足「相对已表述内容新颖、与草稿视觉一致、与已收句子不重复」三道门才能进正文。三道门全部在提示词层实现、零训练,却堵住了最阴险的失败模式------把一次模糊的局部观察,升格成一句笃定的全局断言。
📈 效果:从断言到账单的三层证据
方法说得热闹,怎么证明「信息真的变全了」而不是「写得更长了」?论文的评测设计本身就是一个贡献,值得先讲。
FactCycle:给每条断言盖两个章。 流程是:一个看不见图的文本抽取器把描述拆成原子断言(实体、属性、关系、计数、小物体、动作);一个固定文生图模型只凭描述把图重画一遍;然后两组互不通气的评委,分别对着「源图」和「重画图」给同一批断言打分。两条线索交叉,每条断言落进四个格子:真且可回放(transferred)、编的但画得出来(specious)、编的且画不出、真但画不出------最后一格的账记在生成器头上,不冤枉描述。
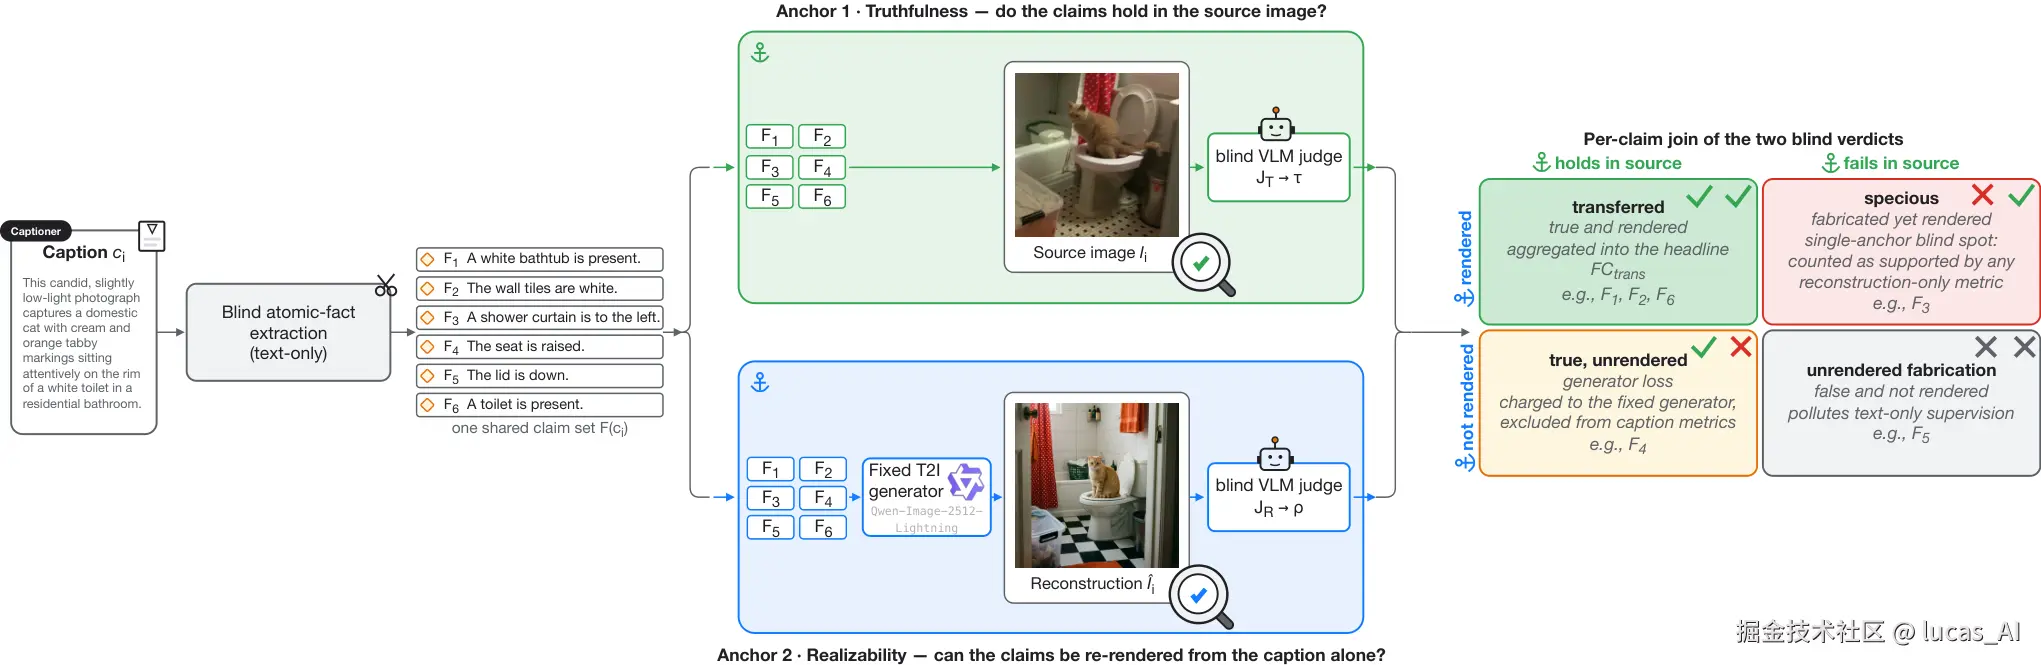
在 250 张评测图上,三套描述语料的对比是:每图事实数 67.1 对 41.9(ScaleCap)和 20.7(ShareGPT4V);真值率 93.8% 对 88.9% 和 81.4%;specious 比例 3.4% 对 7.4% 和 16.6%------最后一项值得多看一眼,那正是「自信地胡说」的部分。折算成每图可回放事实数(FC_trans):52.4 对 31.5 和 14.8。判读方向:看「transferred 高、specious 低」这个组合才作数,单看任何一项都可能被「少说少错」骗到。
两个细节能堵住「是不是只是写长了」的质疑。其一,长度确实涨了------ZoomCap 语料总字符是 ScaleCap 的 1.45 倍、P99 长度 1.58 倍,但所有质量比率列不降反升,数量随长度涨、比率没随长度跌。其二,还有一个不依赖 VLM 评委的旁证:源图与重建图的 DINOv3 相似度(一种通用视觉特征的全局比对)为 0.696 对 0.620 和 0.566,方向与 fact 级结论一致。
再一个反直觉的发现:单看「可实现性」(描述内容能被画出来的比例),ZoomCap 反而垫底------说得少的人「句句能画」。如果评测只看重建相似度,排名会整个倒挂。这也解释了为什么之前的循环一致评测总测不准:它们把「编得能画」和「说得真」混在一锅算。
眼见为实:同一张源图、同一个生成器,只换描述文本,重建结果的差别如下------ZoomCap 版明显保留了更多构图与细节。
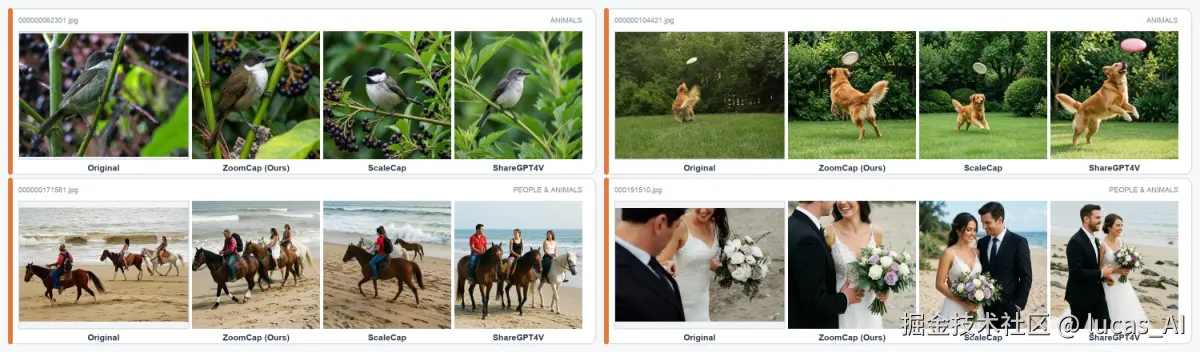
第二层证据是人。 在 456 张内部业务图的盲评里(对手是 Qwen3.5-397B-A17B 单次旗舰产出的描述),ZoomCap 用一个 35B 的教师拿到人类平票折算偏好 81.9%------平票折算即赢算 1 分、平局算半分;三位 VLM 评委的分数在 76.4% 到 92.2% 之间,全部站在 ZoomCap 一边。分维度看,优势最大的是知识丰富度(85.0--93.5%),信息覆盖次之,指令遵循是相对短板(人类维度 63.1%)。小 10 倍的教师赢下单次旗舰,每图成本还在同一量级( 0.0077对0.0067)。
消融实验回答「增益从哪来」。 固定对手后:纯草稿只能拿 55.9(覆盖率 41.6 是硬伤);加局部观察反而掉到 53.0------覆盖率升到 62.4,但局部观察自带幻觉风险;再把检索知识加上,总分跳到 74.2,知识丰富度从 46.7 拉到 92.3。放大策略的正面对决更干脆:复杂度门控 71.2 对全量二级金字塔 28.8------省钱的那版赢了,说明门控砍掉的是噪声而不是证据。
第三层证据是下游训练。 描述写得再好,最后要回答「喂给模型有没有用」,论文给了三组对照:
- 受控对照:三个 backbone 各用 45 万条不同来源描述做继续预训练(CPT,在基座上继续训练吸收知识),11 项基准均值比最强竞品语料高 1.31 到 2.38 分。
- 通用生产:Ling-Tiny-VL-v3 的 600 亿 token 对照训练里,把 20% 描述组换成 1600 万条 ZoomCap 描述,文档/OCR 套件均值 +1.4(OmniDocBench +9.8),感知套件 +1.5(MMVet +11.8);也有小幅回撤------TableVQA -0.7、MMStar -0.6。
- 医疗生产:同一批 264 万张医学图、同一算力配方,ZoomCap 描述比 Gemini-3.1-Pro 描述在五项医疗 VQA 上平均多涨 1.28 分(+3.04 对 +1.76)。
顺带把账单摊开:ZoomCap 每图约 9 次调用、29 秒、 0.0077;ScaleCap官方配方约70次调用、123秒、0.0274。按图算便宜 3.6 倍,按「每条可回放证据」算便宜约 5.9 倍。用「单位证据成本」而非「单图成本」披露效率------这个做法本身就值得抄走。
怎么用:三套现成的搬法
如果你在造自己的描述语料,最值钱的是「草稿路由」这个骨架:先用便宜的一遍当地图,再决定预算往哪花。不必照抄全部六件套------检索、OCR、放大三路可插拔,按你的数据形态选配,文档多的优先 OCR,知识密集的优先检索。
如果你只想白嫖评测:FactCycle 的双锚点协议不依赖 ZoomCap 本体,只要能调一个文生图模型加两个 VLM 评委,就能给自己的描述数据做 fact 级体检。记住那条记账规则------「真但画不出」算生成器的损失,别拿来扣描述的分。
如果你做的是 agent 感知管线(不限于描述):「复杂度门控 + agent 否决 + 只放行一个」的预算模式、三道门的融合准入,都是即插即用的工程范式。做医疗数据的同学还可以留意那个同图同算力的对照设计------它把「描述质量」从「数据配比」里干净地剥了出来。
🧊 泼冷水:这套尺子并非无懈可击
先说评测。FactCycle 的「可回放」内嵌了一个特定文生图生成器的能力,而文生图画不好文字是出了名的------文字类断言可能被系统性低估;评测池又特意排除了截图、文档、图表,也就是说 OCR 这条分支在主实验里没被测到(论文自己承认了)。按类别拆解还有一处微妙的失分:七类断言里 ZoomCap 的 specious 份额全部最低、可回放份额六类最高,唯一没拿下的小物体类,恰是它主打要补的对象(正文未展开解释)。重建提示截断到 3000 字符,对 ZoomCap 绑定的图更多(250 张里 108 张);作者用未截断子集证明排序不变,但这个操作本身说明指标对工程细节是敏感的。
再说方法与尺子的关系。FactCycle 由提出 ZoomCap 的同一批作者设计,方法与评测同源------怀疑者完全可以说:ZoomCap 优化的是「VLM 评委认可 + 文生图可渲染」的描述。对冲证据是下游训练涨分和同图 Gemini 医疗对照,这两条链路相对独立于那把尺子;但「第三方独立复刻」这一关,目前还没人过。
另外几个别急着激动的点:
- 知识丰富度的大涨主要靠检索:46.7 到 92.3 的跳变来自外挂检索,不是更强的视觉观察。「查到 logo 是什么」和「看清 2% 大小的小字」是两种能力,看总分时别混着夸。
- 人工盲评规模有限:456 张图来自内部业务池,人工评委 6 人;1600 万条生产语料不公开,公开的只有 45 万条受控子集。
- 工程不是免费的:每图约 9 次调用、29 秒延迟,还要维护并发服务;相比「一次调用打天下」,这是一套需要运维的管线。
- 医疗结果是 benchmark 数字:作者原话声明,不可用于诊断或治疗决策。
清单念完,公道话也说在前头:论文对截断敏感性做了自证、登了负结果(TableVQA、MMStar 等小幅回撤),比多数「全绿表格」的诚实度高出一截。
💡 理性看待
ZoomCap 真正的贡献不是「又一套描述生成管线」,而是把两个长期被混为一谈的东西拆开了:写得多 和搬进去的信息多。前者是字符数,后者是「每条断言在源图里为真、且只凭文字能还原」------一旦用后者当 KPI,「草稿路由、按缺口花预算、逐条验收」就成了自然解,而不是炫技。
对做数据合成的人,这是一个范式提醒:先定义「什么算一条被搬运的证据」,再设计采集流程,最后用能拆账的指标验收------顺序反了,就只能在长度和幻觉之间反复横跳。FactCycle 这把尺子由作者自产自用,确实需要社区独立复刻;但「双锚点、fact 级、按单元计价」这套思路,现在就能搬进你自己的数据验收流程。
毕竟,「写得长」从来不是目的。图里的小字、小物和左右关系,才是模型真正没见过的东西。