如果你做过 OCR(光学字符识别)或者多模态文档模型的效果评测,你几乎一定背过 CER(Character Error Rate,字符错误率,越低越好)这个数字。两个模型 CER 都是 2%,你会默认它们一样好,然后顺手把便宜的选上。
但新论文的开篇例子值得每个评测人后背一凉。两个系统在同一行英文上各犯一个错:一个把 strategically 写成 strategicallv,读者瞟一眼就能修好;另一个把机构缩写 AGFD 认成 ACFD,名字悄悄变了,没有任何信号提醒你这里有错。而 CER 给这两个错误记的分一模一样:1。
💡 一句话总结:CER 是「统一价」,错个手误和丢个名字同罪;semCER 保持 CER 的对齐和分母不变,只把每个字符编辑的代价换成 LLM 评判的严重度(0 到 1),在 16 种语言、6100 万个编辑上标定。英中读者在两指标打架的样本上七到八成站 semCER 一边------它不取代 CER 打总分,而是给错误清单标价:先修哪个,一眼可见。
📄 论文 Equal CER, Unequal Damage: Severity-Weighted Character Error Rate for OCR(arXiv 2610.20461)💻 代码与模型 github.com/nguyenx2t/s...(pip install semcer,本地可跑)
账错在哪:CER 的统一价
先说清楚 CER 的算法本身没毛病:把识别结果和标准答案做编辑对齐,数出替换、删除、插入各多少处,除以答案长度。毛病出在计价------每处编辑一律记 1,不管它伤害了什么。相当于超市所有商品一个价,矿泉水和茅台同柜同价。
伤害不均这件事,论文给了组很直观的对照。越南语里同一处替换 ấ→á 出现在两行文字中:第一行读者从上下文就能救回来;第二行换掉的却是经典民间故事女主角 Tấm 名字里的字母,好端端的人名成了另一个名字 Tám。两处编辑,CER 同分,读者眼里天壤之别。
更麻烦的是 VLM(视觉语言模型)时代的新故障模式。VLM 解码时带着很强的语言先验,容易写出「流利的错词」------不是 bv 这种一眼假的乱码,而是把 had 写成 has 这种语法通顺、意义跑偏的输出。CER 给它的记分,和一个普通手误没有任何区别。
给错误分级这件事并非无先例:语音识别界已经试过按词向量折扣替换错误、按实体和情感词给词错误加权,OCR 界此前也有效果类似的 LLM 整行评分。semCER 的差异点在于死守 CER 的框架------只换单价,不动对齐、不动分母、不引入分词,让老管线能无损升级。
有人会说:评测基准都有归一化(normalization,先把大小写、空格、标点折叠掉再数错)兜底。但归一化只决定「数哪些编辑」,对幸存下来的编辑依然每处记 1。该按伤害计费的地方,它一分没让。
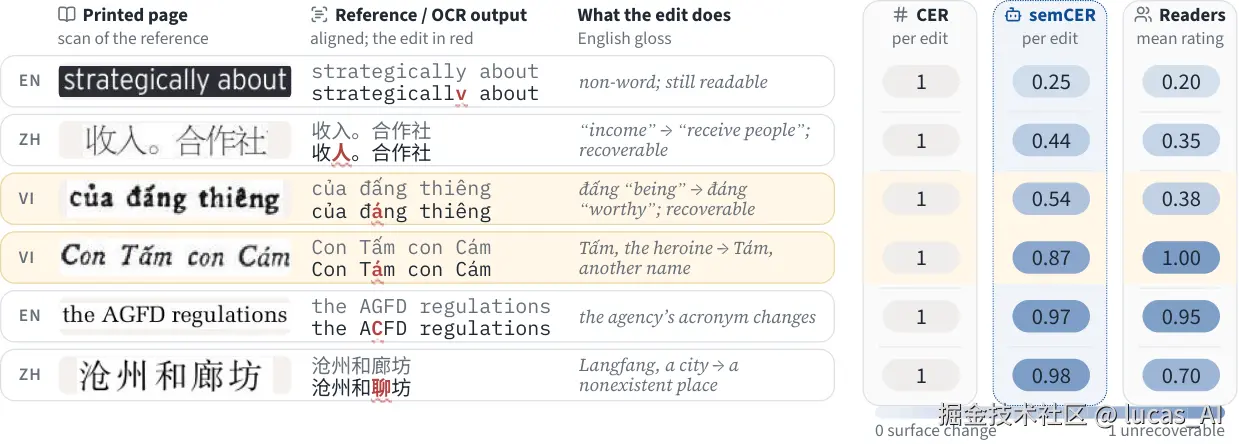
论文首图值得细看:六处错误的 CER 清一色是 1,但读者眼里的伤害从 0.20 一路排到 1.00。中文的例子尤其扎心------「收入。合作社」被认成「收人。合作社」还能靠上下文抢救;「沧州和廊坊」变成「沧州和聊坊」,地图上从此多了一座不存在的城市。
🛠️ 思路:不动对齐,只换价目表
semCER 的克制程度出乎意料:它不改 CER 的任何骨架。对齐还是原来那套 Levenshtein 对齐(最小编辑距离,数最少几步能把一个串改成另一个),分母还是参考文本长度,唯一的改动是把每处编辑的代价从 1 换成严重度 s,取值 0 到 1。所有编辑都记 1 时它就退化成 CER 本尊,且任何情况下都不会超过 CER。
那一个「编辑」到底怎么数?中文没有词边界,泰语连空格都不写,按词计费就得先分词,而分词器的错误会传染进分数。作者的答案是字素簇(grapheme cluster,Unicode 标准里「读者眼中的一个字符」):带声调的字母算一个,天城文的辅音加元音符号算一个,汉字天然就是一个。同一套定义覆盖各书写系统,完全绕开分词。
严重度从哪来?一个 LLM judge(评审模型,本文用 DeepSeek-V4-Flash Preview)读完整的参考行和识别行,盯着标出的那一处编辑,按五级量表打分:
- 0 分:化妆性改动,完全可恢复(大小写、多余空格);
- 0.25 分:明显错误但上下文能救(strategicallv);
- 0.5 分:读得通的另一个词,读者可能察觉;
- 0.75 分:救不回来,但至少看得出出了错;
- 1 分:读起来完美、内容却是错的、毫无信号(AGFD→ACFD)。
一个关键细节:judge 不取「最可能的那一档」,而是读它在五个数字上的概率分布算期望。这样同一档里的两个错误也能分出高下------只取众数的话,同频带内的编辑对会有七到八成打成平手,排名全靠并列。兜底规则也朝着宁重勿轻设计:judge 拒绝作答,或者五个数字的概率加起来不到一半,就再问一次;还不行就按最重的 1 记账------评测工具宁可错杀,不可放过。
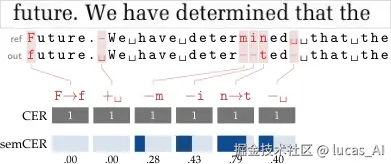
看这张记账示例就明白了:同一行文字 CER 算出 0.171,semCER 只有 0.054。大小写、空格这些化妆性改动记 0,真正的伤害集中在被拆成三处编辑的错词上。分数不是变好了,而是变「可解释」了:每一分钱都知道花在哪。
📈 效果:读者用脚投票
度量研究最怕自说自话,所以作者请英、越、中三语的母语或流利读者做了三轮人工评测:每语言约 85 个单编辑逐个打分、约 180 条整行转写打分、约 175 组「二选一」偏好对决。judge 本身跑了 7 个系统、25 个公开数据集、16 种语言,共 6100 万个编辑。规模摆在这儿,下面看四个问题。
第一问:严重度和读者的打分对得上吗? 对得上。单编辑上严重度与读者均分的相关性达到英 0.81、越 0.66、中 0.82;控制住编辑类型后三语都显著为正,再控制归一化标签后英中两语的区间仍在零之上。同一个 y→v 替换,查历史均值的「类型表」记 0.59,judge 读完整行记 0.25,读者打 0.20------伤害信息在上下文里,不在替换类型里。
第二问:能告诉我们先查哪个错吗? 这是 semCER 最实用的能力。把一摞编辑按严重度排序,前 10% 的清单能捕获读者认定伤害的 81-92%;按 CER 的逐编辑代价排序则约等于随机乱排,不花 judge 钱的启发式排序只能做到一半左右。
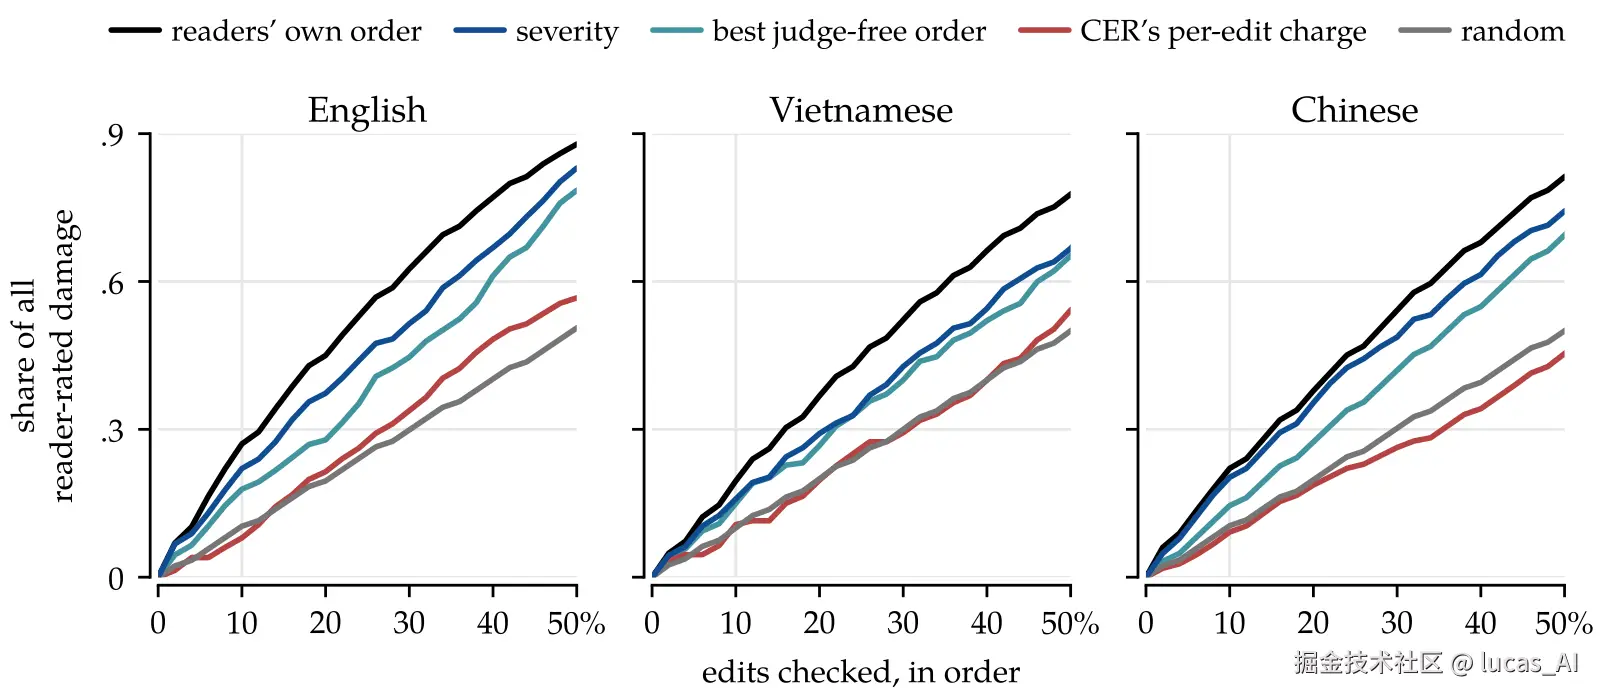
三条语言面板一个模样:蓝线(semCER)追着黑线(读者自己的排序)跑,红线(CER 排序)和灰线(随机)难分彼此。对每天要人工抽查转写质量的团队来说,这张图就是「抽查优先级」的定价依据。
第三问:CER 和 semCER 打架时听谁的? 作者专挑两指标排序相反的样本对让读者裁决:英文读者 71%、中文读者 78% 站 semCER,站归一化 CER(更强的基线)的只有 58% 和 60%;越南语两边打平(79% 对 80%)。
值得注意的是,整行总分的对决 semCER 本来就没想赢:归一化 CER 与读者的秩相关是 0.925、0.902、0.757,semCER 是 0.890、0.873、0.763,持平或略逊------它的战场只在两指标给出相反结论的地方。
最狠的是「归一化也救不了」的子集:在这些对上归一化 CER 跟 CER 选了同一边,而英文读者只有 9% 的对站在归一化 CER 一边,semCER 拿下 77%;中文 83% 对 47%。归一化把能修的都修完之后,剩下的分歧正是语义计费的专属领地。
顺带回答「三档够不够」:不够。同一个 judge 换成 OK/轻/重三档计费,三语言全部显著输给五级分布期望;整行只打一次分再乘 CER 也输。伤害计价的颗粒度,粗了真不行。
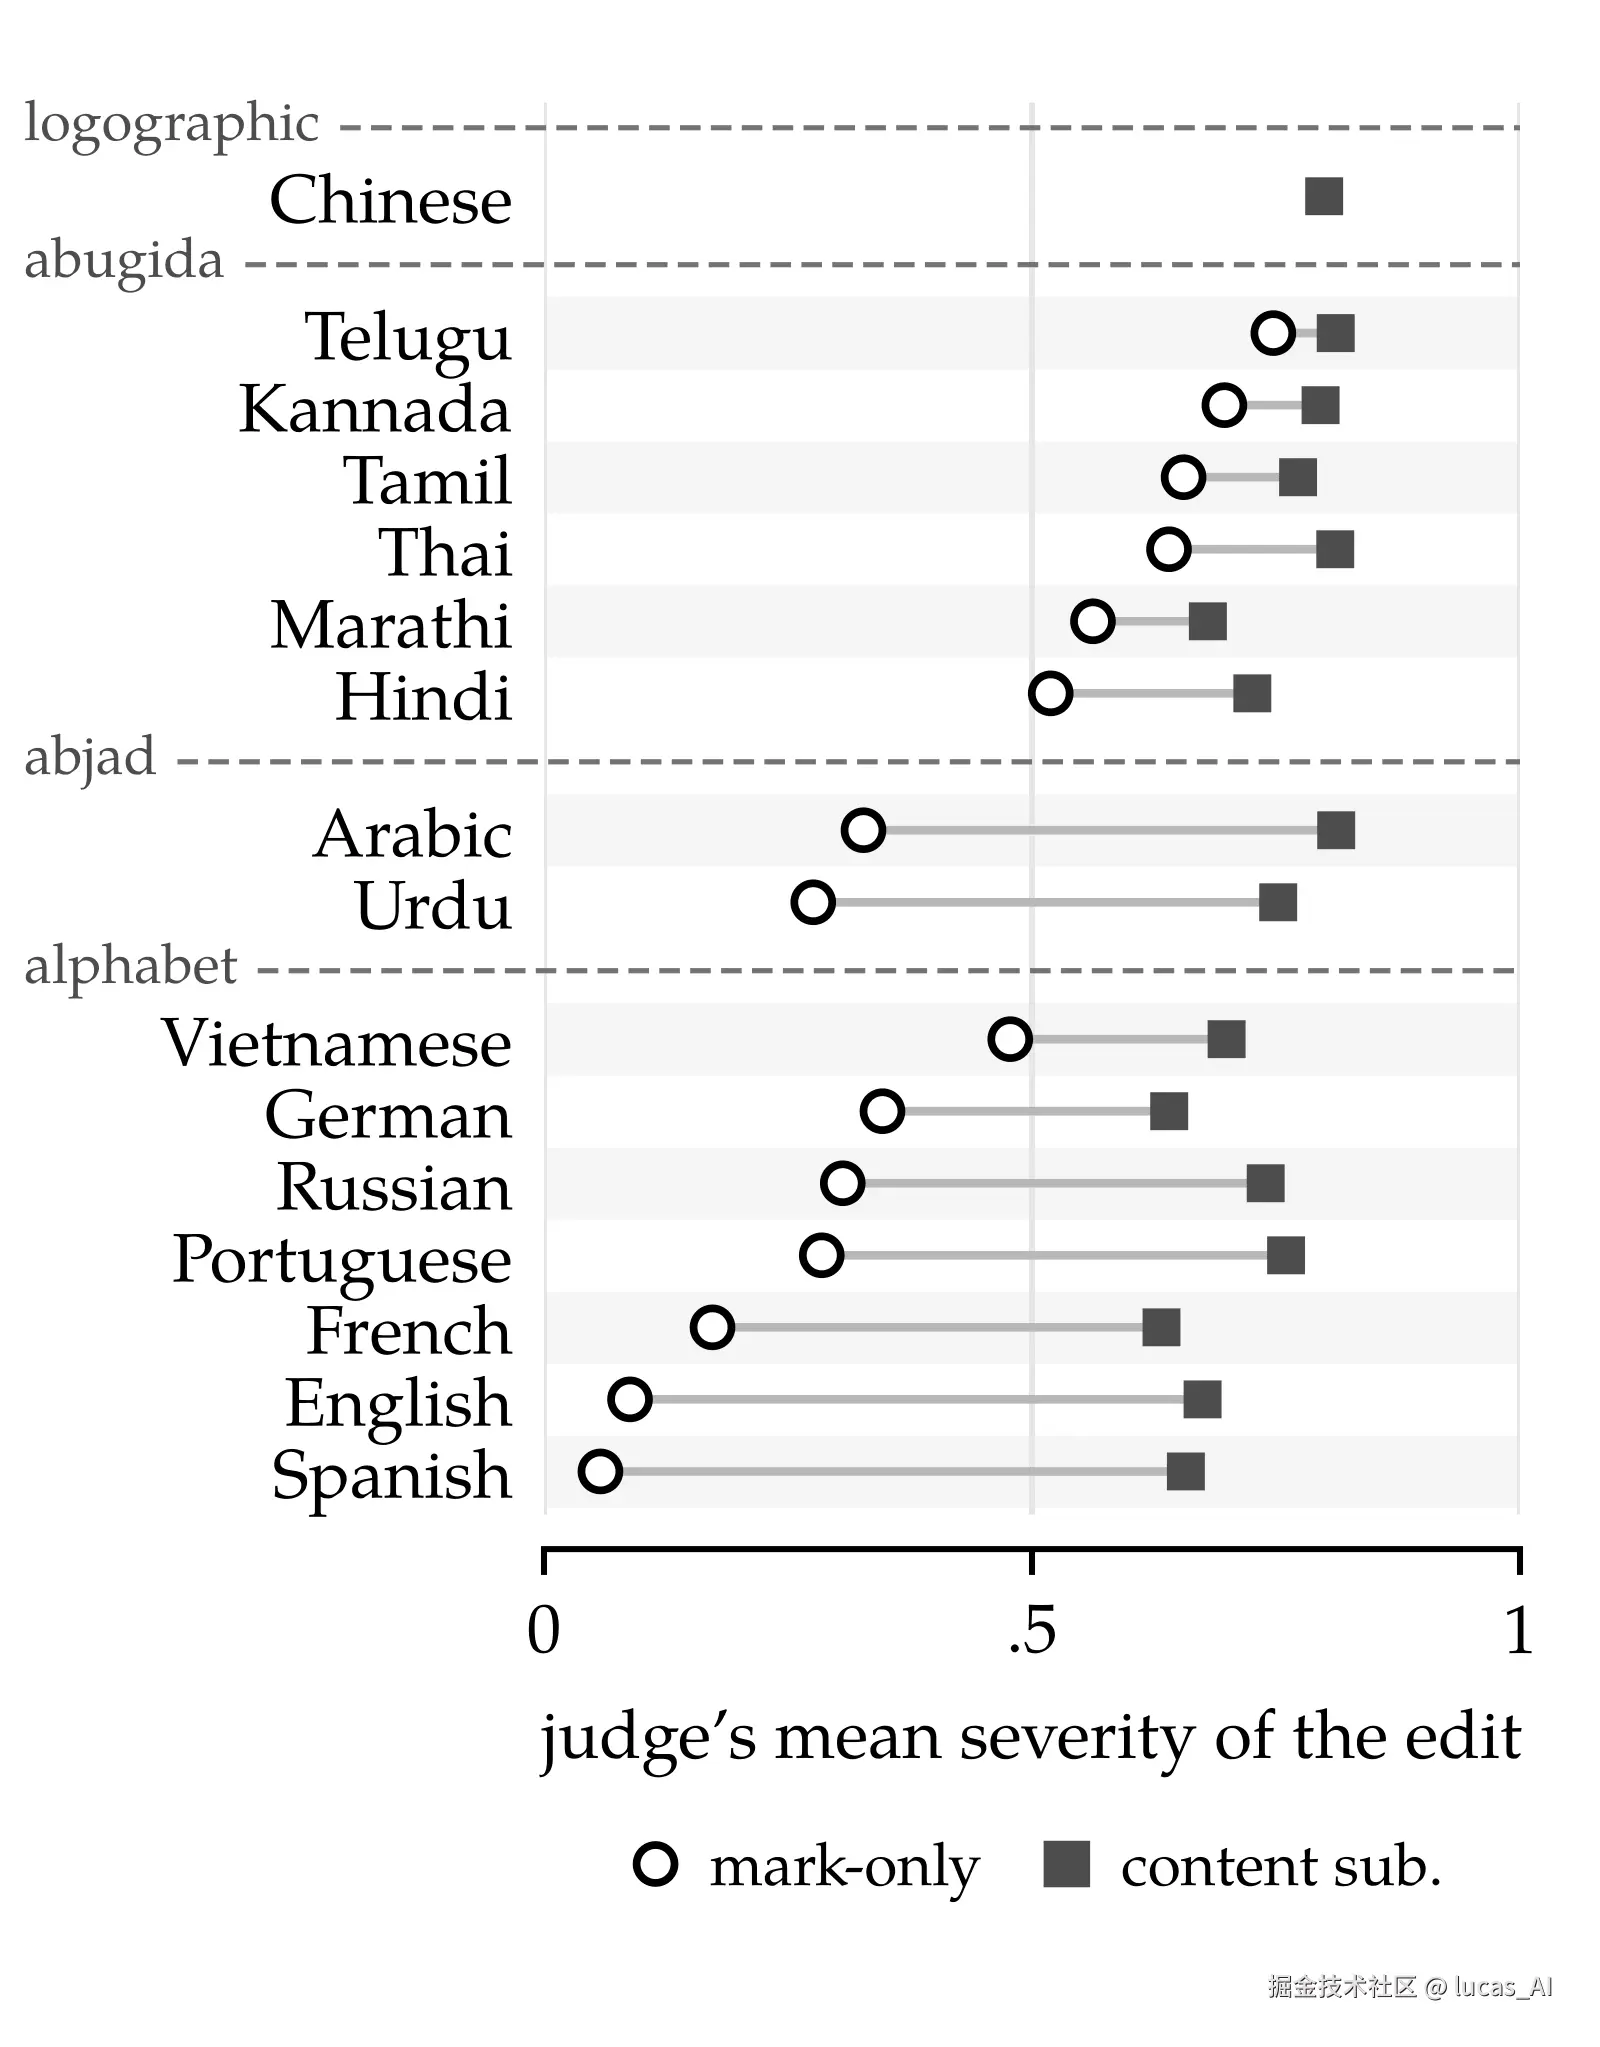
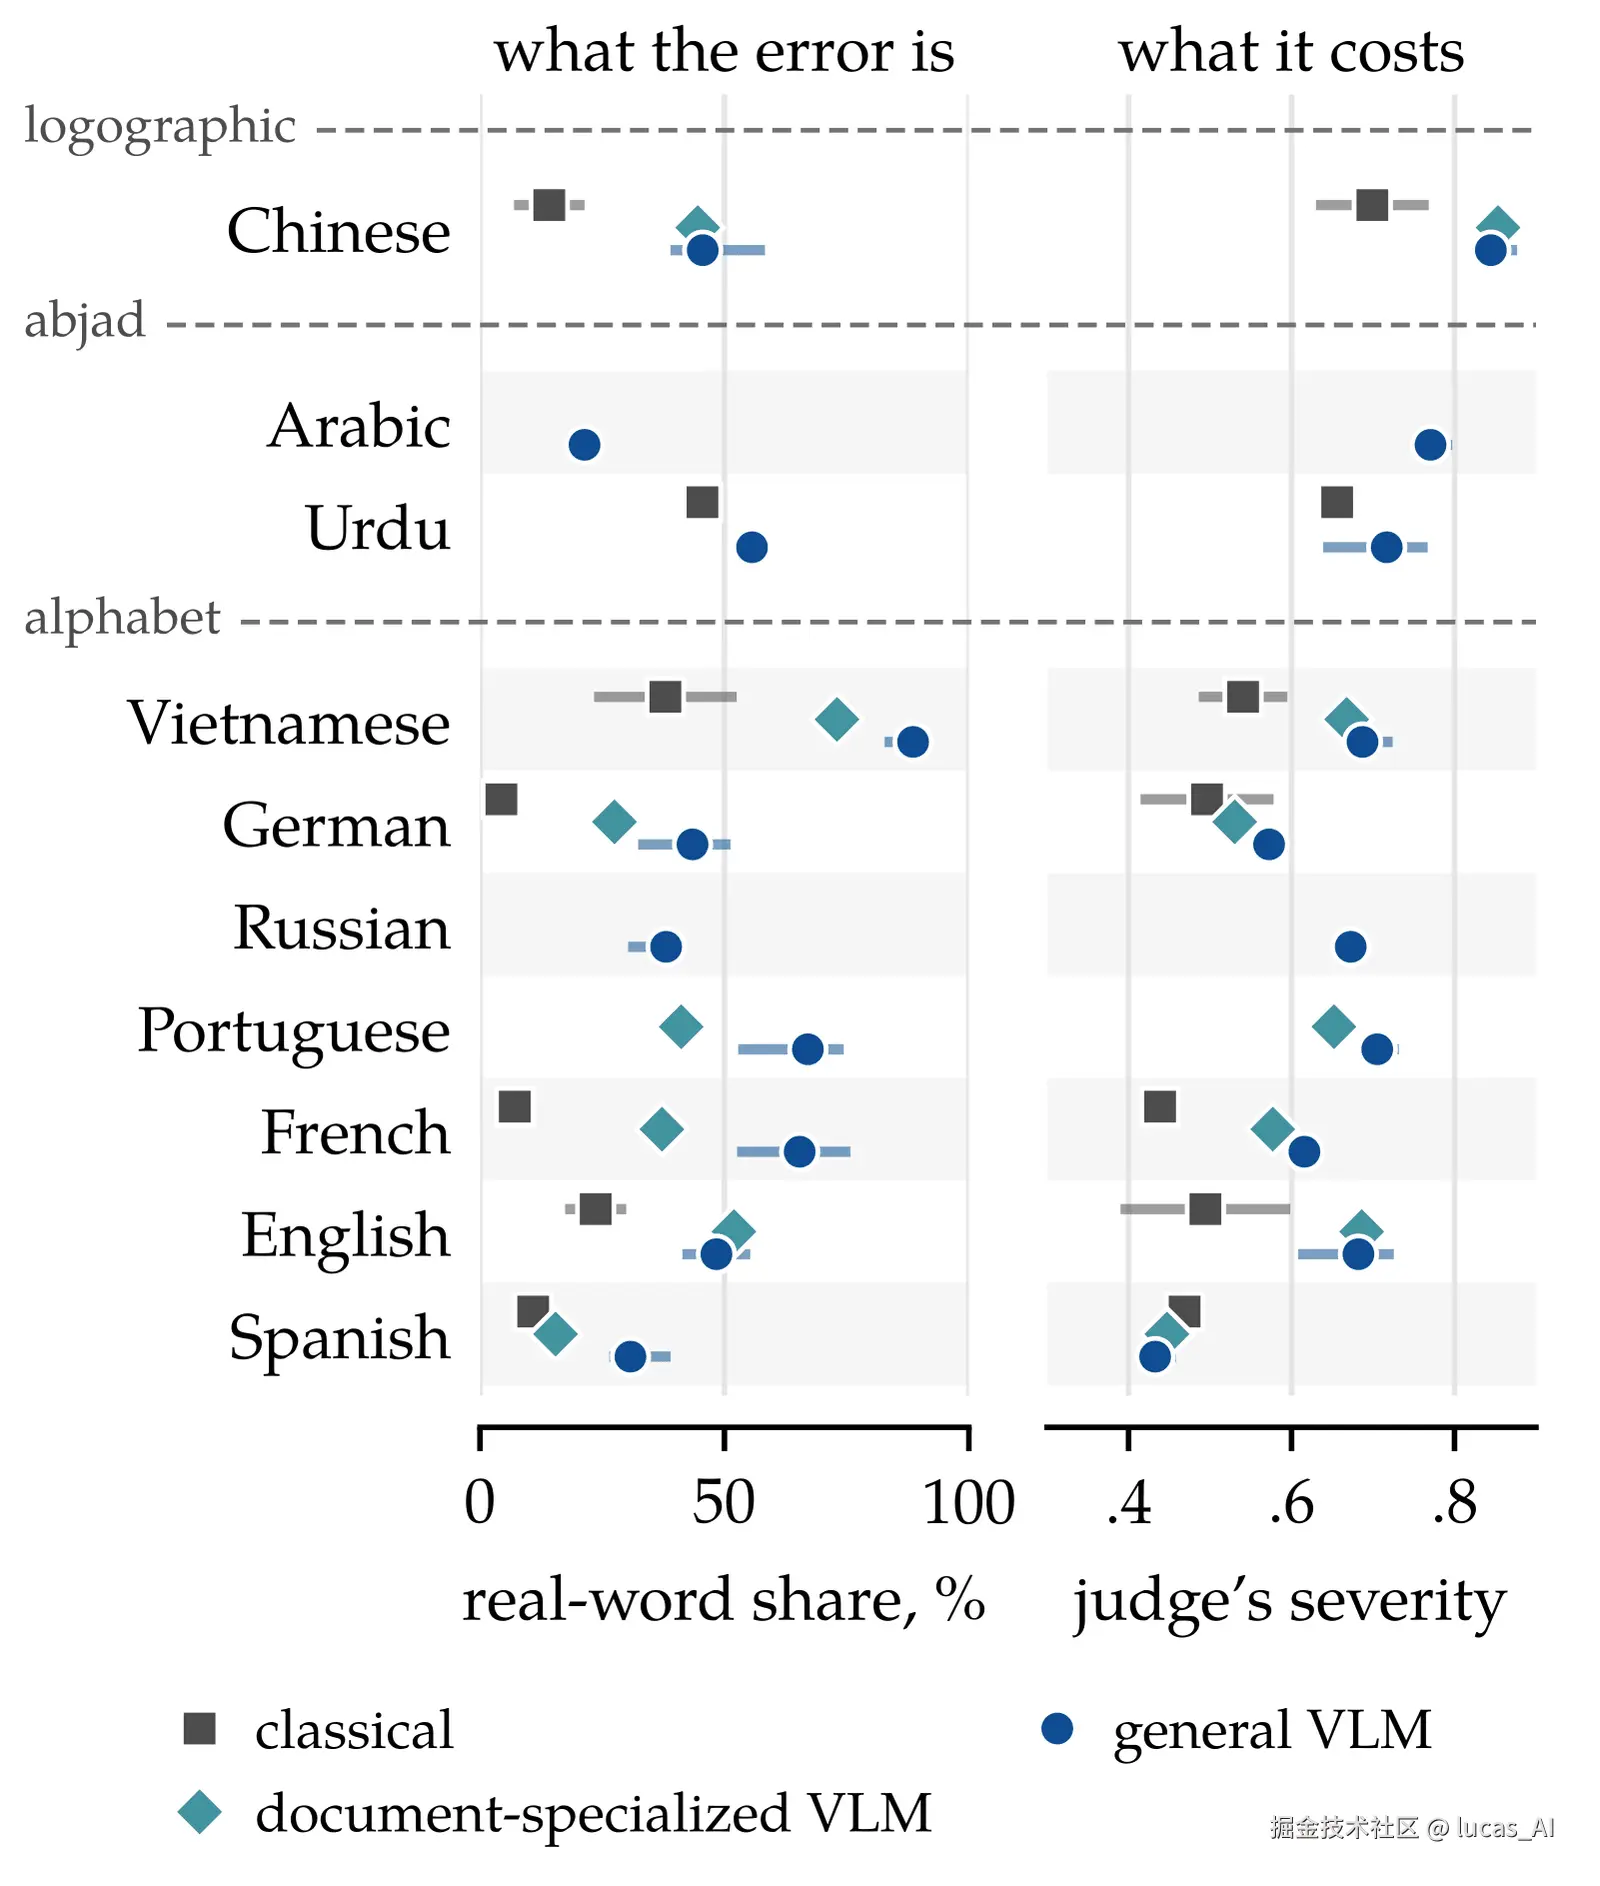
第四问:大规模语料上能看到什么? 两个结构性发现。语言侧,「最小错误」的代价随书写系统剧烈变化:在西语里错一个重音符号几乎免费(0.06),在泰卢固语里却接近错一整个字母(0.75);内容替换倒是各语言都贵(0.63-0.81),跨语言比较模型分数时这是隐藏变量。还有个反直觉的细节:带声调符号的越南语在负载榜上紧挨着印地语------负载跟着「文字写多少符号」走,而不是跟着文字类型走。
系统侧更有意思。通用 VLM 的字母错误「恰好拼成另一个真词」的比例远超随机基线------越南语手写体上高达 93%,随机只有 17%;经典管线贴着随机线走。这意味着词表检查这道老防线对 VLM 基本失效:它犯的错都在词典里。而 judge 对这些流利错词确实要价更高:除西语外所有可测语言里,VLM 字母错误的严重度都超过经典管线。
怎么用:先当解释器,再当裁判
作者顺手把 judge 蒸馏成一个 0.8B 的小模型(Qwen3.5-0.8B 底座,只用 judge 的分布训练,没碰任何人工标注):与读者的相关性比 judge 低不到 0.03,九成以上的清晰对比对排序与 judge 一致,单编辑严重度平均只差 0.04。pip install semcer 装完本地就能跑,不烧 API 钱。
仓库自带的例子很说明问题:账单金额「15 dollars」被认成「75 dollars」,CER 只有 0.0417,看起来无伤大雅;semCER 在给出总分之外还标注这一处替换严重度 0.99------钱数错了,而且错得毫无破绽,放以前这类错误要等对完账才发现。开源也够大方:6100 万个判分编辑和逐项聚合的读者评分按 CC BY 4.0 放出,蒸馏模型的代码与权重走 Apache-2.0,源文本按各自数据集的许可处理------想自己复算、复现或者接着微调,原料都齐了。
我的使用建议(以下是推测,供参考):总分继续用归一化 CER,论文自己就是这个结论------整行打分上它与读者的相关性持平或更好。semCER 用在三件事上:给错误清单排序,先查最贵的;在 CER 打平或打架的两版转写之间当裁判;盯 VLM 的流利错词。榜单排名它暂时帮不上,但验收自己的文档管线时,「最贵的 10% 错误在哪」比一个总 CER 有用得多。
🧊 泼冷水:价目表的免责条款
方法本身扎实,但把 semCER 当基建用之前,这几盆水得先浇清楚:
- 只有三种语言过人工验证。英越中之外的 13 种语言,字素负载全靠 judge 一家之言,而 judge 可能偏向高资源语言;低资源语言恰好全是非拉丁文字,资源水平与文字系统完全混杂。
- 构念可能有循环。judge 按五级量表训练,读者也按同一量表打分,验证的是「大家会不会用同一把尺子」;「可恢复性」这把尺子本身对不对,论文没证,也坦白了。
- 量表带真词偏见。五级判定依赖「输出是否为真词」,所以 VLM 的高价有一部分是量表自带的,不全是测出来的。
- 工程小字条款。judge 中途被供应商换过 checkpoint,跨版本分数不可比;一个错词被对齐拆成几处编辑就付几次钱;没有读者在「一行多处错」的场景里评过单编辑严重度。
- 低分不是免检标志。低 semCER 只说明读者理论上能救回来,该抽查的还是要抽查;judge 若系统性低估某类错误,这类错误就集体隐身。
统计上还有个注脚:等编辑数对比的 24 组里只有 8 组过了显著性校正,「VLM 在中越更贵」目前是方向一致的证据,还算不上定论。
💡 理性看待:指标就是一张计费表
说到底,评测指标是一张价目表:它告诉优化器和看报表的人「什么算损失、什么不算」。CER 的价目表是统一价,简单、便宜、几十年好用;但当你用 VLM 在档案、合同、票据上批量识字时,错误的价格差异就是业务差异------错个标点和错个名字,赔偿额度不一样。
semCER 的聪明之处是没想推翻谁:对齐不动、分母不动,只把每格账的金额改成「这一处会让读者多疼」。归一化 CER 继续当总分,semCER 当出纳和审计------分数背后第一次有了带名字、带价签的明细,外加一张按伤害排序的检查清单。对每天盯着 CER 做选型的人来说,这大概是最务实的一种进步:不换考卷,只把阅卷标准从「错了几处」换成「错了多重」。而价目表一旦换掉,优化器盯着的东西,也会慢慢跟着变。