本文译自「Scaling Android Search: Room @Fts4 vs SQL LIKE」,原文链接proandroiddev.com/scaling-and...,由Oğuzhan Aslan发布于2026年10月11日。
本文将深入探讨如何使用 Android Jetpack Room 实现全文搜索索引、倒排索引和微秒级查询基准测试。
在为 Android 应用程序构建搜索功能时------无论是查询离线优先的收件箱、笔记目录、文档缓存还是电子商务目录------几乎所有开发者都从相同的查询开始:
sql
SELECT * FROM mails
WHERE subject LIKE '%' || :query || '%'
   OR body LIKE '%' || :query || '%'
它直观易用,无需修改任何表结构,开箱即用。在早期开发阶段,即使本地数据库只包含 25 行虚拟数据,搜索查询也能立即返回结果。测试通过,用户界面流畅,该功能顺利发布。
然后,现实给了我们当头一棒。
随着用户积累数月的多行电子邮件、笔记或缓存数据(从数百条记录攀升至数千条记录),投诉开始纷至沓来:
- 在搜索框中输入文字时出现按键延迟。
- 画面出现丢帧和主线程微卡顿。
- 进行大量搜索操作时,电池电量消耗明显。
为什么在开发阶段感觉运行速度极快的操作,在真实数据量下却会不堪重负?要理解这一点,我们必须深入了解 SQLite 的查询规划器。
为什么 SQL LIKE 在大规模场景下会失效
在关系数据库中,开发人员依靠索引(B 树)来将查找时间复杂度控制在 O(log N) 以内。例如,如果你查询:
sql
WHERE sender LIKE 'alice%'SQLite _可以_在 sender 上使用标准的 B 树索引,因为它知道前缀。
然而,用户很少只使用前缀进行搜索。实际的全文搜索需要子字符串匹配:在主题或段落中查找任意单词。这迫使查询语句以通配符开头:
sql
WHERE body LIKE '%architecture%'警告:一旦查询语句包含前导通配符(%query%),标准 B 树索引将被完全绕过。SQLite 将被迫执行顺序全表扫描,时间复杂度为 O(N)。
在全表扫描中:
- SQLite 将存储层中的每一行数据都读入内存。
- 查询引擎按顺序遍历文本的每个字节,逐个字符地比较,查找目标子字符串。
- 如果一封电子邮件正文包含 1500 个单词,而你有 2000 封电子邮件,那么 SQLite 会对每次击键操作逐字节地检查多达 300 万个单词!
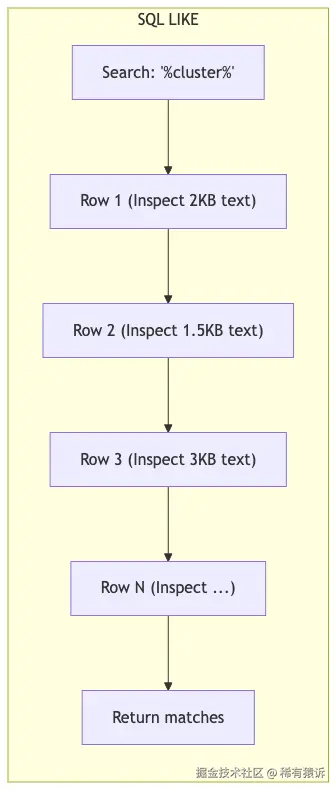
此外,标准的 SQL LIKE 语句是"愚蠢的":
- **未进行分词:**它无法识别单词边界。搜索"cat"会错误地匹配到"catalog"、"scatter"和"vacation"。
- **未进行词干提取:**搜索"optimize"会遗漏"optimizing"、"optimizer"或"optimized"。
- **未进行相关性排序:**搜索结果未加权;标题中的匹配项与第四段中的匹配项权重相同。
而 SQLite 的 FTS4(全文搜索 4) 引擎则改变了这一切。
解决方案:FTS4 和倒排索引的工作原理
SQLite 包含专用的全文搜索扩展(FTS3/FTS4 和 FTS5)。在 Android 的 Room 持久化库中,通过 @Fts4 和 @Fts3 注解原生支持这些扩展。
倒排索引:从 O(N) 到 O(1)
FTS4 不是在查询时扫描行,而是在插入时进行繁重的工作。
当 FTS4 对文本列进行索引时,分词器 会将文本分解成单个单词(词元),规范化它们的大小写,去除标点符号,并构建一个倒排索引。
倒排索引本质上是一个词到文档的词典:
scss
+--------------+-----------------------+
| Token        | DocIDs (Posting List) |
+--------------+-----------------------+
| architecture | [1, 14, 108, 492]     |
| benchmark    | [1, 7, 22, 108, 305]  |
| database     | [1, 4, 18, 92, 108]   |
| security     | [2, 6, 11, 45, 99]    |
+--------------+-----------------------+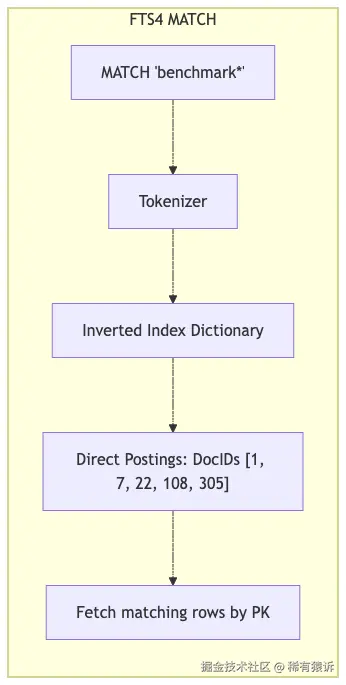
当你发出类似 MATCH 'benchmark*' 的搜索查询时,FTS4:
- 对搜索字符串进行分词。
- 在词元词典中执行即时查找。
- 获取包含该单词的完整文档 ID 列表。
- 返回记录,不扫描任何无关文本字节。
无论有 100 行还是 10 万行,查找操作都在不到一毫秒内完成。
在 Android Room 中的实现
一个常见的误解是,使用 FTS 需要复制数据,导致数据库大小翻倍。而 Room 的 contentEntity 模式则完全避免了这个问题。
让我们来看看 Mail Showcase 应用中的生产级实现。
首先,创建包含所有原始字段的基础表。这是你的唯一可信数据源:
kotlin
// MailEntity.kt
import androidx.room.Entity
import androidx.room.PrimaryKey
@Entity(tableName = "mails")
data class MailEntity(
    @PrimaryKey(autoGenerate = true)
    val id: Long = 0,
    val sender: String,
    val recipient: String,
    val subject: String,
    val body: String,
    val timestamp: Long = System.currentTimeMillis()
)
接下来,定义虚拟 FTS 实体。通过声明 contentEntity = MailEntity::class,Room 指示 SQLite 使用外部内容表。
FTS 表仅维护索引结构和词元倒排记录。文本本身按需从基础 mails 表中获取,从而避免了存储重复:
kotlin
import androidx.room.Entity
import androidx.room.Fts4
@Entity(tableName = "mails_fts")
@Fts4(contentEntity = MailEntity::class)
data class MailFtsEntity(
    val sender: String,
    val subject: String,
    val body: String
)
提示:Room 会在后台自动为 mails 表创建 SQLite 数据库触发器(AFTER INSERT、AFTER UPDATE、AFTER DELETE)。每当你插入或更新 MailEntity 时,mails_fts 索引都会自动更新!
在 @Database 声明中注册这两个类:
kotlin
@Database(
    entities = [MailEntity::class, MailFtsEntity::class],
    version = 1,
    exportSchema = false
)
abstract class MailDatabase : RoomDatabase() {
    abstract fun mailDao(): MailDao
}
现在我们可以在 MailDao 中比较这两个查询。
请注意 FTS 查询是如何将 mails.id 与 mails_fts.docid 连接起来的:
kotlin
@Dao
interface MailDao {
    @Insert(onConflict = OnConflictStrategy.REPLACE)
    suspend fun insertMails(mails: List<MailEntity>): List<Long>
    /**
     * Standard SQL LIKE operator search.
     * Triggers an O(N) sequential scan across every row.
     */
    @Query(
        """
        SELECT * FROM mails
        WHERE subject LIKE '%' || :query || '%'
           OR body LIKE '%' || :query || '%'
           OR sender LIKE '%' || :query || '%'
        ORDER BY timestamp DESC
        LIMIT :limit
        """
    )
    suspend fun searchMailsLike(query: String, limit: Int = 200): List<MailEntity>
    /**
     * SQLite FTS4 (Full Text Search) MATCH query.
     * Uses inverted index token lookups.
     */
    @Query(
        """
        SELECT mails.* FROM mails
        JOIN mails_fts ON mails.id = mails_fts.docid
        WHERE mails_fts MATCH :query
        ORDER BY mails.timestamp DESC
        LIMIT :limit
        """
    )
    suspend fun searchMailsFts(query: String, limit: Int = 200): List<MailEntity>
}
为了提供"边输入边搜索"的体验,请对输入进行清理,并在每个词元后附加通配符 *,以便输入 arch 时匹配"architecture":
kotlin
private fun sanitizeFtsQuery(query: String): String {
    val sanitized = query.replace("\"", "").replace("'", "").trim()
    val tokens = sanitized.split("\\s+".toRegex()).filter { it.isNotEmpty() }
    if (tokens.isEmpty()) return ""
    // Appending '*' enables fast token prefix matching in FTS
    return tokens.joinToString(" ") { "$it*" }
}为了衡量实际性能,我们在展示应用程序中构建了一个基准测试套件,该套件可以测量数据库在相同数据集上的执行时间,精确到微秒级(measureNanoTime)。
我们向数据库中填充了多行电子邮件,并测量了不同数据集规模下的搜索延迟:
sql
+--------------+-------------------------+-------------------------+----------------+
| Dataset      | SQL LIKE Latency        | Room @Fts4 MATCH        | Speedup Factor |
+--------------+-------------------------+-------------------------+----------------+
| 100 mails    |  2.840 ms (39 matches)  |  1.800 ms (39 matches)  | 1.6x faster    |
| 500 mails    |  8.114 ms (179 matches) |  3.892 ms (179 matches) | 2.1x faster    |
| 2,000 mails  | 30.181 ms (200 matches) | 13.071 ms (200 matches) | 2.3x faster    |
| 5,000 mails  | 63.762 ms (200 matches) |  6.811 ms (200 matches) | 9.4x faster    |
+--------------+-------------------------+-------------------------+----------------+
scss
Query Execution Time vs Dataset Size
Latency (ms)
  70 ┼                                                  ● SQL LIKE (63.8 ms)
  60 ┼
  50 ┼
  40 ┼
  30 ┼                                  ● (30.2 ms)
  20 ┼
  10 ┼                    ● (8.1 ms)             ● FTS4 (6.8 ms)
   0 ┼───● (2.8 ms)───────● (3.9 ms)────● (13.1 ms)──────
     └──────┬─────────────────┬──────────────┬──────────────┬────────
          100               500           2,000          5,000
                                 Email Records
主要观察结果
- 16 毫秒帧预算限制 :处理 2000 封邮件时,SQL LIKE 查询耗时约 30.18 毫秒,超过了 60Hz 显示器约 16.6 毫秒的帧目标(120Hz 显示器约 8.3 毫秒)。处理 5000 封邮件时(约 63.76 毫秒),在 UI 线程或其附近执行
LIKE会导致丢帧和明显的 UI 卡顿。 - 规模化下的性能分化 :虽然 FTS4 在中小型数据集上能提供稳定的 1.6--2.3 倍加速,但到 5000 条记录时优势急剧扩大,执行速度比 LIKE 快 9.4 倍(约 6.81 毫秒对约 63.76 毫秒)。
- 前缀支持 :FTS4 能够即时处理
arch*查询,因为词元前缀可以直接在索引结构中遍历。
何时使用哪个
sql
| Feature                   | SQL LIKE '%query%'                | Room @Fts4 (MATCH)                           |
+---------------------------+-----------------------------------+----------------------------------------------+
| Algorithmic Complexity    | O(N) Sequential full table scan   | O(1) / Sublinear Inverted index lookup       |
| Execution Time at Scale   | Degrades linearly with row count  | Remains consistently in low single-digit ms  |
| Word Boundary Awareness   | No (matches substrings blindly)   | Yes (tokenized at word boundaries)           |
| Stemming Support          | No                                | Yes (Porter stemmer available)               |
| Prefix Matching           | Wildcards break B-Tree index      | Native (MATCH 'token*')                      |
| Storage Impact            | Zero overhead                     | Minimal index metadata (via contentEntity)   |
| Insert Overhead           | Minimal                           | Slight cost during insert to update index    |
+---------------------------+-----------------------------------+----------------------------------------------+
结论
SQL LIKE 是一个很棒的工具,可以用来创建原型或查询离散的编码列(例如状态码或简短标识符)。但是,一旦你的应用程序处理人类文本------消息、文档、笔记、产品目录------依赖 LIKE '%...%' 就会成为一个迫在眉睫的性能瓶颈。
通过将 Room 的 @Fts4 与 contentEntity 模式结合使用:
- 你保留了清晰的关系型实体作为唯一可信数据源。
- 你可以获得高性能的倒排索引查找,轻松扩展到数万条记录。
- 你的用户界面依然流畅,充分尊重了用户的帧预算和电池续航。
如果你的 Android 应用包含用于查询文本字段的搜索栏,请不要等到生产环境中的数据集膨胀后才行动。立即迁移到 Room FTS,为用户带来他们喜爱的即时搜索体验。
参考
爱你们所有人。
敬请期待后续博客。
保重。
欢迎搜索并关注 公众号「稀有猿诉」 获取更多的优质文章!
保护原创,请勿转载!