一句话看懂
项目地址:github.com/OpenMOSS/MO... 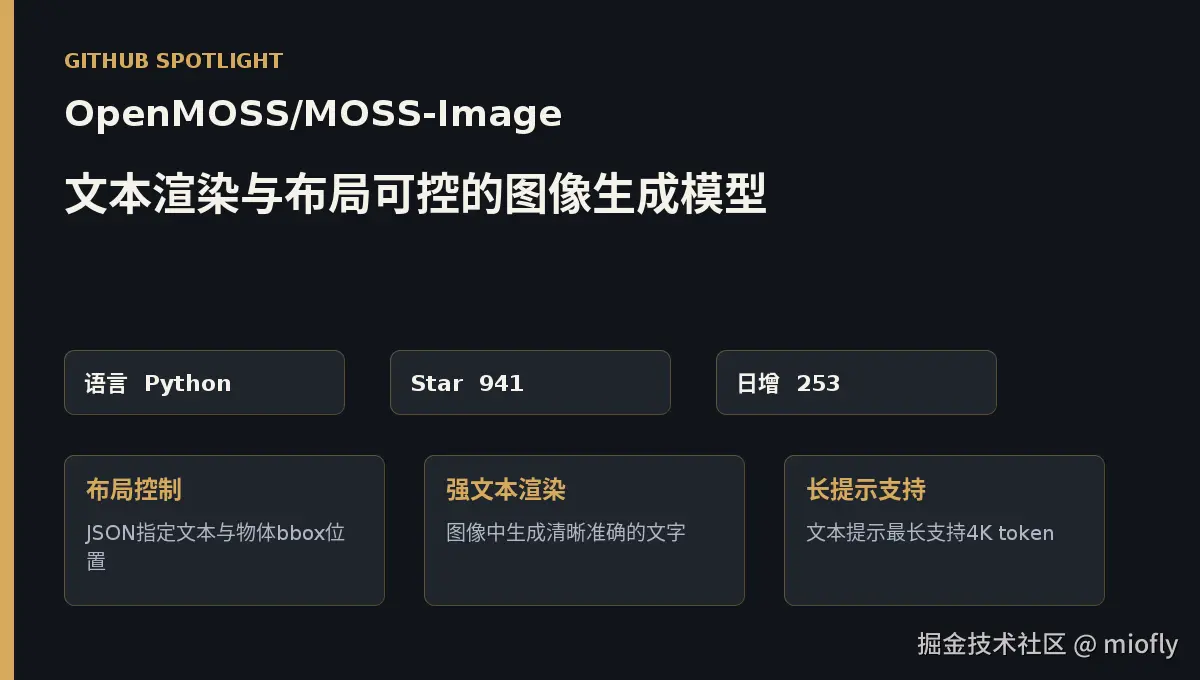
MOSS-Image 是一个专门优化文字渲染和布局控制的图像生成模型,骨干网络是 5B 参数的 DiT(用 transformer 做扩散模型主干的结构),生成图像里的文字时用坐标框明确告诉模型文字该放哪、物体该摆哪,不再靠运气。项目提供 MOSS-Image-Base 和 MOSS-Image-SFT 两个模型,代码以 Apache-2.0 协议开源,README 里写了 day-0 支持 SGLang、vLLM-Omni、ComfyUI 三种推理方案。
它解决什么问题
常见的文生图模型在生成图像里的文字时经常出问题,比如笔画缺失、字形扭曲、位置随机漂移。大多数扩散模型只靠一段自然语言描述去猜文字和布局该怎么摆,模型对"这行字应该出现在左上角、那个图标该在右下角"这类空间关系没有显式约束。
MOSS-Image 引入 layout JSON,用坐标框(bbox)直接描述文本和物体的位置,再配合强化过的文字渲染能力生成清晰准确的字形。文本提示本身支持最长 4K token,复杂场景(比如一整张带多段文字的海报)可以用很长的描述一次性说清楚,不用靠多轮生成拼凑。
核心概念速览
- DiT(Diffusion Transformer) :把扩散模型的主干从卷积网络换成 transformer。在 MOSS-Image 里对应
MOSSImageTransformer的 42 层结构,负责逐步把噪声图像还原成目标图像。 - RoPE(旋转位置编码) :给序列里的每个位置算出一个带方向信息的相位,让模型知道"谁在前谁在后、谁离谁近"。项目里的
_RoPE类会按图像的高、宽和文本长度分别生成相位,再把图像序列和文本序列拼在一起统一编码。 - Layout JSON :用
summary、items、bbox这几个字段描述画面里每个元素该出现在什么位置。这是 MOSS-Image 区别于普通文生图模型的核心机制,相当于给模型一张带坐标的草图,而不是一句模糊的文字描述。 - CFG offload(分类器自由引导的显存卸载) :生成图像时模型通常要同时跑一次"有条件"和一次"无条件"的前向计算,显存吃得多。
configure_pipeline提供model和sequential两种卸载模式,把部分权重挪到 CPU 上,换显存省着用。
架构拆解
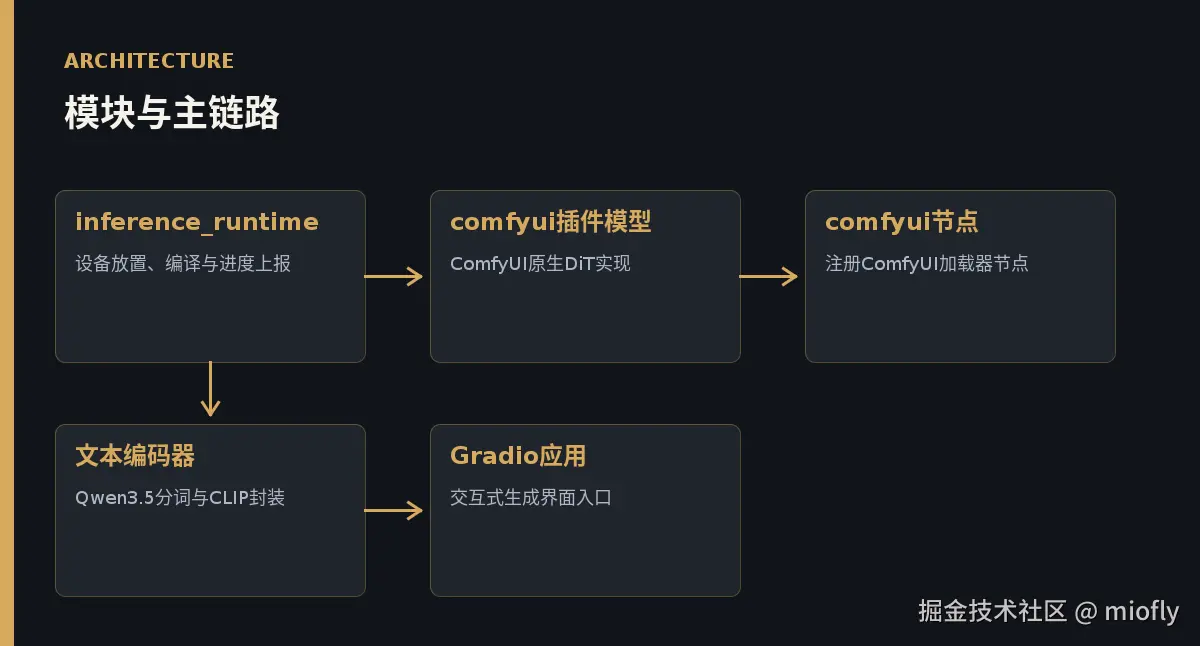
整个推理链路从加载模型开始,经过设备配置,最后带进度条跑生成:
inference_runtime.py的load_pipeline负责从预训练仓库构建DiffusionPipeline,这是整条链路的入口。set_scheduler按 shift 参数重建调度器配置,调度器决定了扩散过程每一步怎么走。configure_pipeline决定用哪种 offload 模式,并把各个子模块放到合适的设备上,显存紧张时靠它来权衡速度和占用。generate_with_progress把实际生成过程包一层进度条,方便 Gradio 界面实时显示生成阶段。
ComfyUI 插件是独立的一套实现,不直接复用 inference_runtime,而是在 comfyui/moss-image/model.py 里重写了原生 DiT 结构,再通过 comfyui/moss-image/nodes.py 注册加载器节点,供 ComfyUI 工作流调用。文本编码部分放在 comfyui/moss-image/text_encoder.py,用 Qwen3.5 分词器配合 CLIP 封装做文本特征提取。节点加载模型时会同时触发模型加载和 CLIP 文本编码器加载,两条路径最后汇合到同一个生成管线里。Gradio 应用走的是另一条路,直接调用 inference_runtime 完成从加载到生成的全过程,是最简单的上手方式。
关键实现走读
python
    def forward(self, height, width, text_length, device):
        bands = self._default_bands(device)
        # Coordinates: (r, f, h, w); sequence order is image followed by text.
        h, w = torch.meshgrid(
            torch.arange(height, device=device), torch.arange(width, device=device), indexing="ij"
        )
        image = (
            torch.stack((torch.zeros_like(h), torch.full_like(h, text_length), h, w), -1)
            .flatten(0, 1)
            .float()
        )
        image[:, 2] -= (height - 1) / 2
        image[:, 3] -= (width - 1) / 2
        text = torch.zeros(text_length, 4, device=device, dtype=torch.float32)
        text[:, 1] = torch.arange(text_length, device=device)
        phase = torch.cat((image, text), 0).unsqueeze(-1) * bands
        return torch.cat((phase.sin(), phase.cos()), -2).flatten(-2).unsqueeze(0)
做了什么:这段代码给图像序列和文本序列算出一套统一的位置编码。图像部分用 meshgrid 生成每个像素点的行列坐标,再减去中心偏移让坐标以图像中心为原点;文本部分用递增的序号表示在文本序列里的先后顺序。最后把图像坐标和文本坐标拼在一起,乘上频率带 bands,取正弦和余弦拼接成最终的相位编码。
为什么这样写:MOSS-Image 要同时处理图像 token 和文本 token 混合的序列,两种 token 各用一套独立的位置编码时,模型很难判断"这段文字应该对应图像里的哪个区域"。这里用四维坐标 (r, f, h, w) 把图像和文本统一放进同一个坐标系,图像 token 的 r 维固定为 0,文本 token 的 f 维固定为自己的序列位置,模型在做注意力计算时能直接感知到图文之间的相对空间关系,这是 layout JSON 能够生效的底层基础。
没有它会怎样:如果图像和文本各用独立的位置编码体系,模型只能通过训练数据里的统计规律去猜测文字大概该出现在图像的什么区域,遇到 layout JSON 里指定的精确坐标时就缺乏对应的位置信号,文字渲染的位置精度会明显下降,容易出现指定在左上角的文字跑到图像中间这类偏差。
动手上手
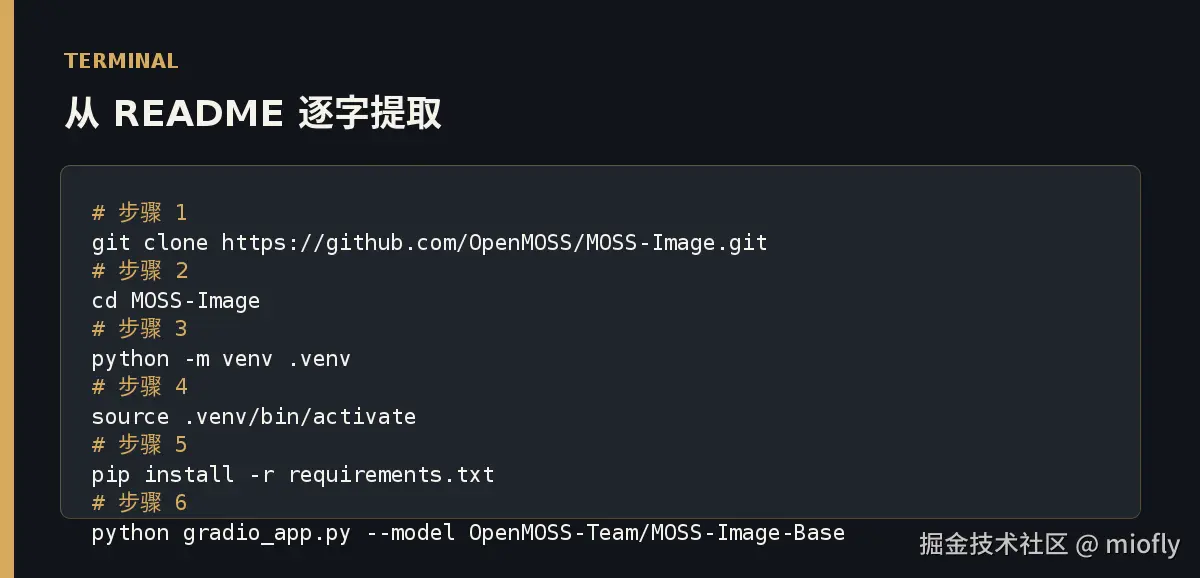
先克隆仓库并装好环境:
bash
git clone https://github.com/OpenMOSS/MOSS-Image.git
cd MOSS-Image
python -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
执行完这几步,终端里能看到虚拟环境 .venv 被激活(命令行提示符前会出现 (.venv) 标记),pip install 结束后不报错即说明依赖装好。
然后启动 Gradio 界面:
bash
python gradio_app.py --model OpenMOSS-Team/MOSS-Image-Base命令跑起来后终端会打印一个本地访问地址,用浏览器打开能看到交互式生成界面,这是验证环境配置是否成功最直接的方式。首次运行会从模型仓库下载 MOSS-Image-Base 权重,网络和磁盘空间要提前留够。
应用场景
- 海报标题渲染:用 layout JSON 指定文字的 bbox 和具体文案(caption),让标题、副标题各自落在设计稿要求的位置。bbox 坐标必须和最终生成图像的宽高保持一致,否则位置会错位。
- 命令行 Python 推理 :直接用
from_pretrained加载pipeline_moss_image做批量生成,适合集成进已有的图像生成服务。调用时需要开启trust_remote_code=True,因为模型用了自定义的 pipeline 代码。 - ComfyUI 工作流:装上官方插件后用示例 workflow json 跑通文字渲染节点,适合习惯可视化拖拽搭建流程的用户。README 里提到这部分集成还在推进,遇到节点缺失或报错属于正常现象。
独立分析
README 的 highlights 把文字渲染和布局控制放在最前面,优先级明显高于通用图像美学的泛化能力。MOSS-Image 的设计目标更偏向精确执行指令,而不是自由发挥画出好看的图,这类模型往往在设计类、工具类场景里比纯艺术创作场景更好用。
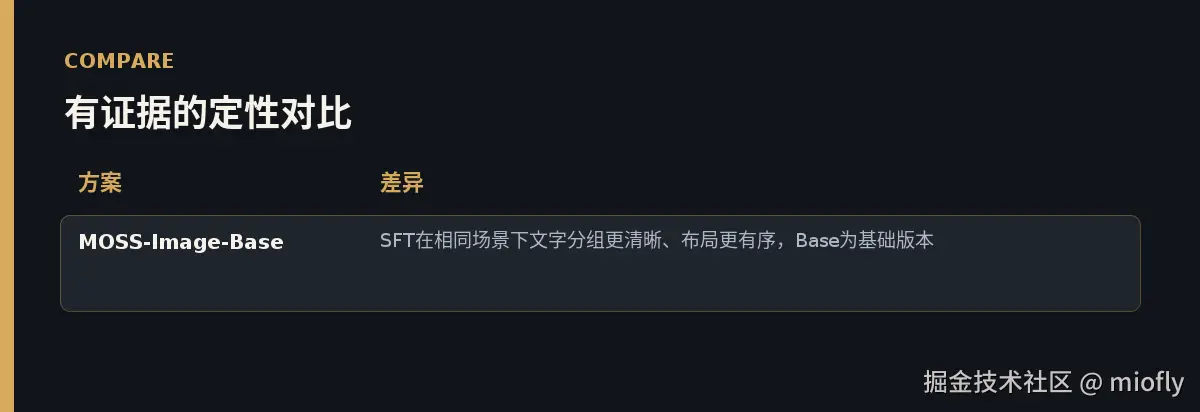
Base 和 SFT 两个版本的差异也值得关注。相同场景下,SFT 版本生成的文字分组更清晰、布局更有序,Base 版本是基础预训练结果,没有经过针对指令遵循的精调。任务涉及多段文字混排时,优先选 SFT 能减少后期调整的工作量。
局限与风险
- README 没有说明训练数据的来源和版权限制,企业用户在商用前需要自行评估合规风险。
- Compile DiT(把模型编译加速)这项优化在 Sequential offload 模式下不可用,显存紧张到必须用 Sequential 卸载的场景下,没法同时享受编译加速带来的速度提升,两者需要二选一。
- 微调的具体方法和最佳实践目前要查阅官方的 user guide,仓库本身的说明还比较简略,刚接触这类 DiT 微调的开发者可能需要额外花时间摸索参数设置。
- 模型规模是 5B 参数,部署时显卡显存和算力都要提前规划,个人电脑上跑完整的 Base 或 SFT 模型压力不小。
结论卡片
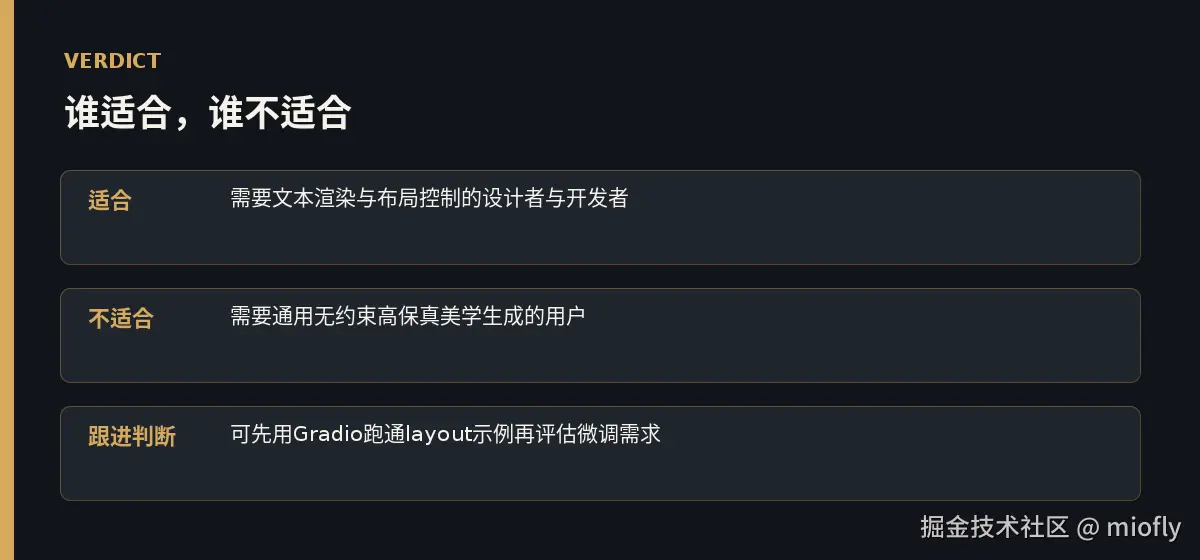
适合谁:需要在图像里精确控制文字内容和位置的设计者、做图文生成工具的开发者,以及关注文本与图像生成交叉方向的研究人员。
不适合谁:只想要通用、不受约束、追求极致美学泛化效果的用户,这类需求上 MOSS-Image 的布局约束反而会变成限制。
建议路径:先用 Gradio 跑通一个带 layout JSON 的示例,确认文字渲染和位置控制符合预期,再决定是否要为具体业务场景做微调。
项目地址:github.com/OpenMOSS/MO...
原文地址:tools.wflynn.cn/aitools/git...
关注公众号「YourTools」,每天推送 GitHub 趋势与开源工具速报: